Khóa học
Lập trình với AI dành cho Developer
1 giờ 30 phút
10.5K
Như chúng tôi đã đề cập trong bài viết blog, Muse Glimmer 30B là một mô hình mã nguồn mở mới được xây dựng cho tác vụ agentic và lập trình.
Điểm đặc biệt thú vị là bạn có thể chạy toàn bộ thiết lập này tại chỗ trên một NVIDIA RTX 5090 với 32 GB VRAM bằng llama.cpp.
Mô hình có sẵn ở định dạng GGUF, và trong hướng dẫn này, tôi sẽ dùng lượng tử hóa động cho chất lượng cao hơn.
Thiết lập hoàn chỉnh gồm có:
muse-glimmer-30B-kquant-dynamic.gguf: 19,7 GB mô hình chínhdflash-kquant.gguf: 1,63 GB mô hình nháp cho giải mã suy đoánmmproj-kquant.gguf: 1,4 GB bộ mã hóa thị giác và nhận thứcTheo mô tả mô hình, lượng tử hóa động 19,7 GB chỉ có khoảng 0,2% suy giảm điểm chuẩn so với độ chính xác đầy đủ.
Trong thử nghiệm của tôi, chạy mô hình với cửa sổ ngữ cảnh 64K sử dụng khoảng 24 GB VRAM, để lại khoảng trống hữu ích trên RTX 5090.
Trong hướng dẫn này, bạn sẽ học cách:
llama.cpp với hỗ trợ CUDACuối cùng, chúng ta cũng sẽ có cái nhìn thực tế về những điểm Muse Glimmer làm tốt với vai trò mô hình code cục bộ và nơi nó còn gặp khó. Tôi cũng khuyến nghị xem hướng dẫn về Muse Spark 1.3 để tìm hiểu các tính năng mới nhất.
Trước khi chạy Muse Glimmer tại chỗ, trước hết chúng ta cần biên dịch llama.cpp với hỗ trợ CUDA để mô hình có thể dùng GPU RTX 5090.
Bắt đầu bằng cách cài đặt các gói hệ thống cần thiết:
apt-get update

apt-get install -y \
    build-essential \
    cmake \
    curl \
    git \
    libcurl4-openssl-dev
Tiếp theo, nhân bản kho llama.cpp và chuyển vào thư mục dự án:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
Cấu hình build với CUDA bật:
cmake -B build \
    -DBUILD_SHARED_LIBS=OFF \
    -DGGML_CUDA=ON
Giờ hãy biên dịch công cụ dòng lệnh, CLI đa phương thức và server:
cmake --build build --config Release -j \
    --target llama-cli llama-mtmd-cli llama-server
Khi build xong, hãy tạo liên kết để llama-server khả dụng toàn hệ thống để bạn có thể chạy từ bất kỳ thư mục nào:
ln -sf "$(pwd)/build/bin/llama-server" /usr/local/bin/llama-serverCuối cùng, xác nhận cài đặt hoạt động:
llama-server --versionBạn sẽ thấy đầu ra tương tự:
version: 10373 (38406d597)
built with GNU 13.3.0 for Linux x86_64
Tại thời điểm này, llama.cpp đã được biên dịch với hỗ trợ CUDA và llama-server sẵn sàng chạy Muse Glimmer trên GPU.
Tiếp theo, tải mô hình Muse Glimmer chính cùng các tệp GGUF bổ sung cần cho giải mã suy đoán và đầu vào thị giác.
Đầu tiên, cài đặt Hugging Face CLI:
pip install -U huggingface_hubSau đó đăng nhập vào tài khoản Hugging Face của bạn:
hf auth login
Chọn tùy chọn đăng nhập qua trình duyệt, mở trang ủy quyền và chấp thuận kết nối trong trình duyệt của bạn.
Giờ hãy tải ba tệp bắt buộc:
hf download meta-models/Muse-Glimmer-30B-GGUF \
    --local-dir Muse-Glimmer-30B-GGUF \
    --include "muse-glimmer-30B-kquant-dynamic.gguf" \
    --include "dflash-kquant.gguf" \
    --include "mmproj-kquant.gguf"
Lệnh này tải về:
muse-glimmer-30B-kquant-dynamic.gguf: mô hình 19,7 GB chínhdflash-kquant.gguf: mô hình nháp dùng cho giải mã suy đoánmmproj-kquant.gguf: bộ mã hóa nhận thức cần cho đầu vào hình ảnhCác tệp khá lớn, nên thời gian tải có thể lâu tùy vào kết nối internet của bạn.

Khi cả ba tệp đã được tải, bạn có đầy đủ mọi thứ để chạy Muse Glimmer với sinh văn bản, hỗ trợ thị giác và giải mã suy đoán DFlash.
Sau khi tải ba tệp GGUF, chúng ta có thể khởi chạy Muse Glimmer bằng llama-server.
Lệnh dưới đây nạp mô hình chính, bật mô hình nháp DFlash cho giải mã suy đoán và thêm bộ mã hóa nhận thức cho đầu vào thị giác:
llama-server \
    -m /workspace/Muse-Glimmer-30B-GGUF/muse-glimmer-30B-kquant-dynamic.gguf \
    -md /workspace/Muse-Glimmer-30B-GGUF/dflash-kquant.gguf \
    --mmproj /workspace/Muse-Glimmer-30B-GGUF/mmproj-kquant.gguf \
    --spec-type draft-dflash \
    --spec-draft-n-max 15 \
    -ngl 99 \
    --spec-draft-ngl all \
    -fa on \
    --temp 1.0 \
    --top-p 0.95 \
    --top-k 64 \
    --ctx-size 64000 \
    --alias muse-glimmer-30B \
    --host 0.0.0.0 \
    --port 8910 \
    --jinja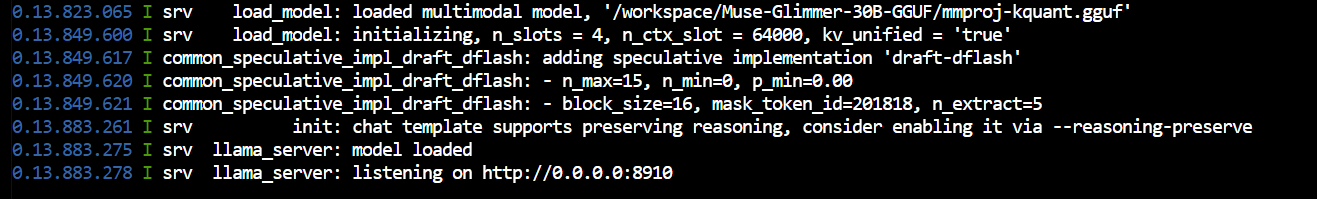
Cấu hình này dùng cửa sổ ngữ cảnh 64K, offload mô hình lên GPU, bật Flash Attention và chạy server trên cổng 8910.
Khi mô hình đã nạp xong, nó sẽ khả dụng tại:
http://127.0.0.1:8910Bạn có thể xác nhận mọi thứ chạy đúng bằng cách gửi một yêu cầu đơn giản tới API tương thích OpenAI:
curl -s http://127.0.0.1:8910/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "muse-glimmer-30B",
        "messages": [
            {
                "role": "user",
                "content": "Explain speculative decoding in three simple sentences."
            }
        ]
    }'
Trong thử nghiệm này, Muse Glimmer tạo 364 token hoàn thành ở tốc độ 83,94 token/giây, trong khi prompt được xử lý ở tốc độ 147,48 token/giây.
Với giải mã suy đoán DFlash bật, mô hình nháp đề xuất 1.665 token, trong đó 253 được chấp nhận, cho tỷ lệ chấp nhận khoảng 15,2%.
Prompt 64 token được xử lý trong khoảng 434 ms, còn phần sinh mất khoảng 4,34 giây.
Phản hồi xác nhận mô hình đang chạy đúng qua API cục bộ.
Bạn cũng có thể kiểm tra lượng bộ nhớ GPU mà toàn bộ thiết lập đang dùng:
nvidia-smiVới mô hình lượng tử hóa động 30B, mô hình nháp DFlash, bộ mã hóa thị giác và cửa sổ ngữ cảnh 64K được nạp cùng nhau, thiết lập của tôi dùng khoảng 23,8 GB VRAM trên RTX 5090.
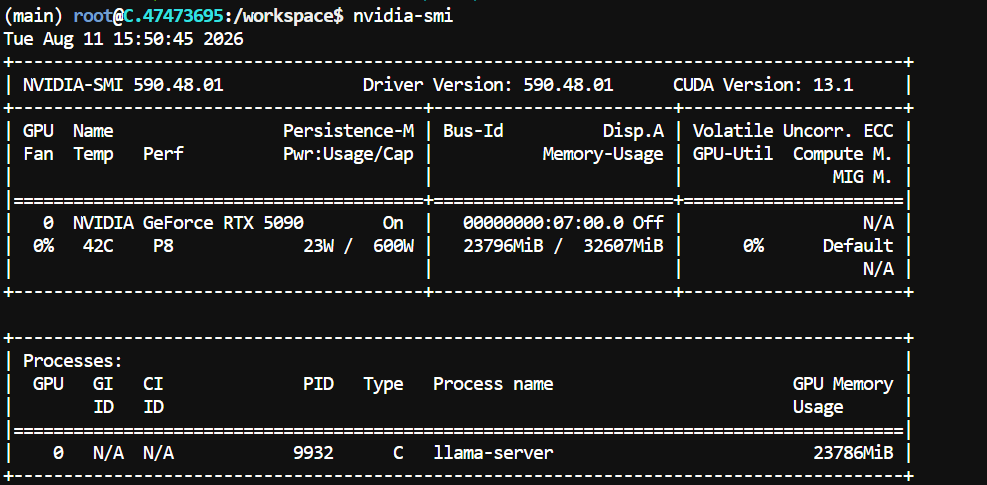
Như vậy còn khoảng 8 GB VRAM trống, cho phép chúng ta thử nghiệm với các cửa sổ ngữ cảnh lớn hơn sau này.
llama-server đi kèm Web UI tích hợp, giúp bạn dễ dàng kiểm thử mô hình mà không cần tự gửi yêu cầu API.
Mở:
http://127.0.0.1:8910Bạn có thể dùng giao diện cho prompt văn bản thường, hiểu hình ảnh và thử nghiệm code nhanh.
Bởi vì chúng ta đã nạp bộ mã hóa thị giác với:
--mmproj /workspace/Muse-Glimmer-30B-GGUF/mmproj-kquant.ggufMuse Glimmer cũng có thể nhận đầu vào hình ảnh.
Để kiểm thử khả năng thị giác, tôi đã tải ảnh bìa một cuốn sách của mình và dùng prompt sau:
Describe what you see in this image and point out the most important details.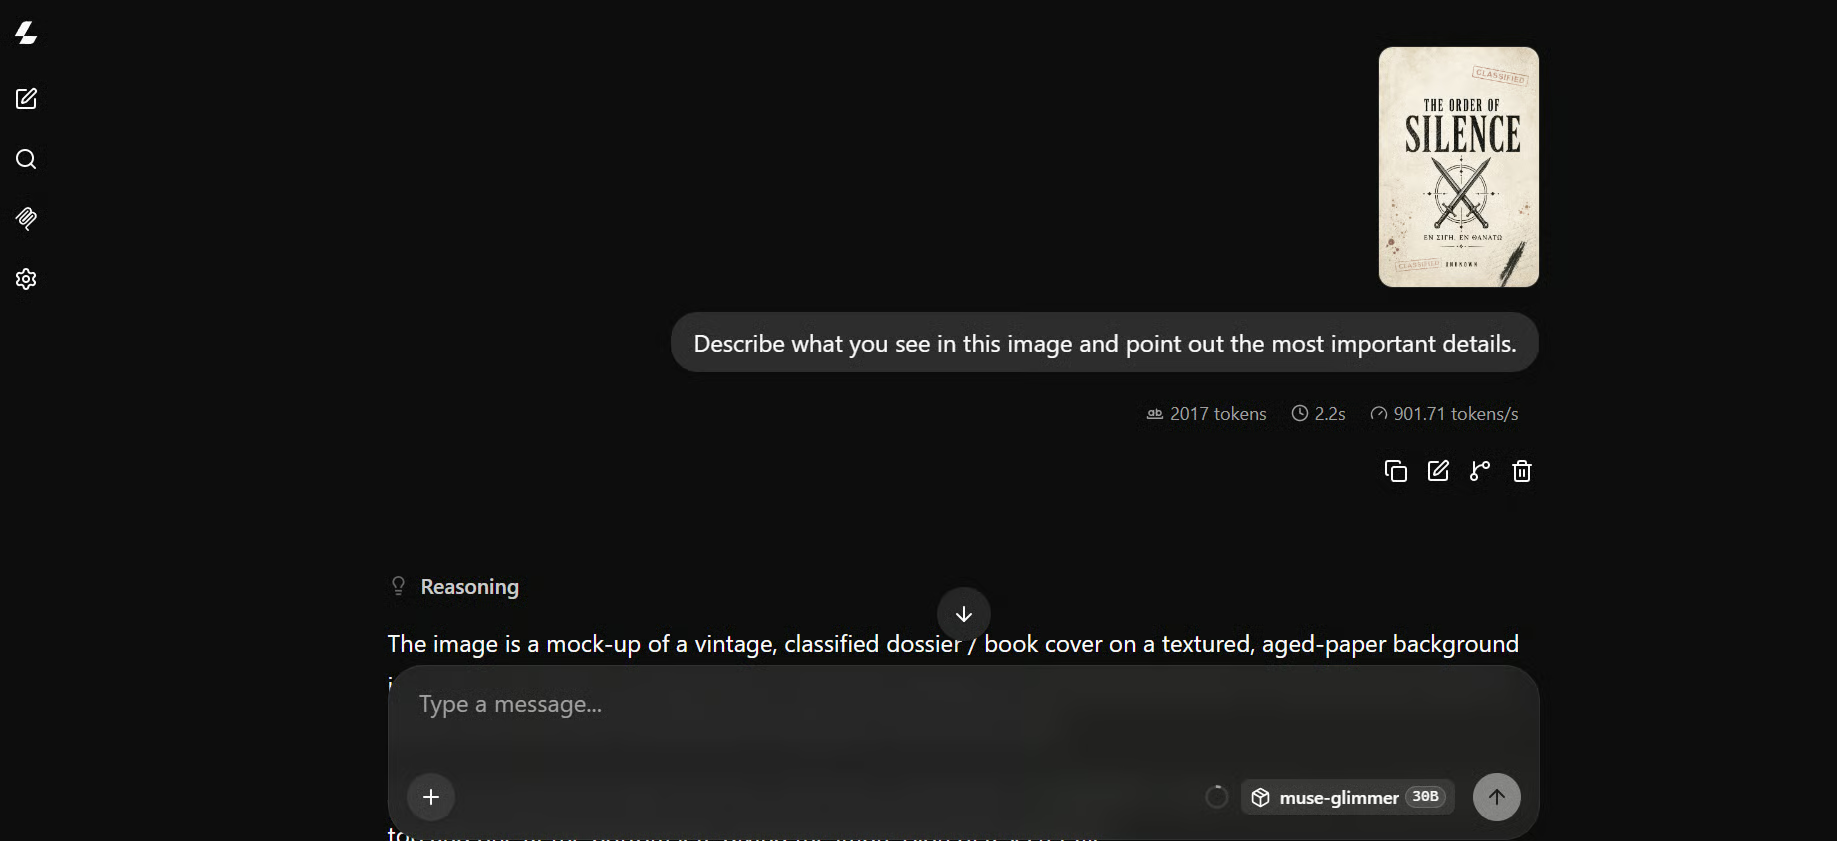
Mô hình đã tạo mô tả chi tiết về bìa và nhận ra một số yếu tố thị giác nhỏ hơn.
Đây là một bài kiểm thử ban đầu hữu ích để xác nhận bộ mã hóa thị giác hoạt động đúng.
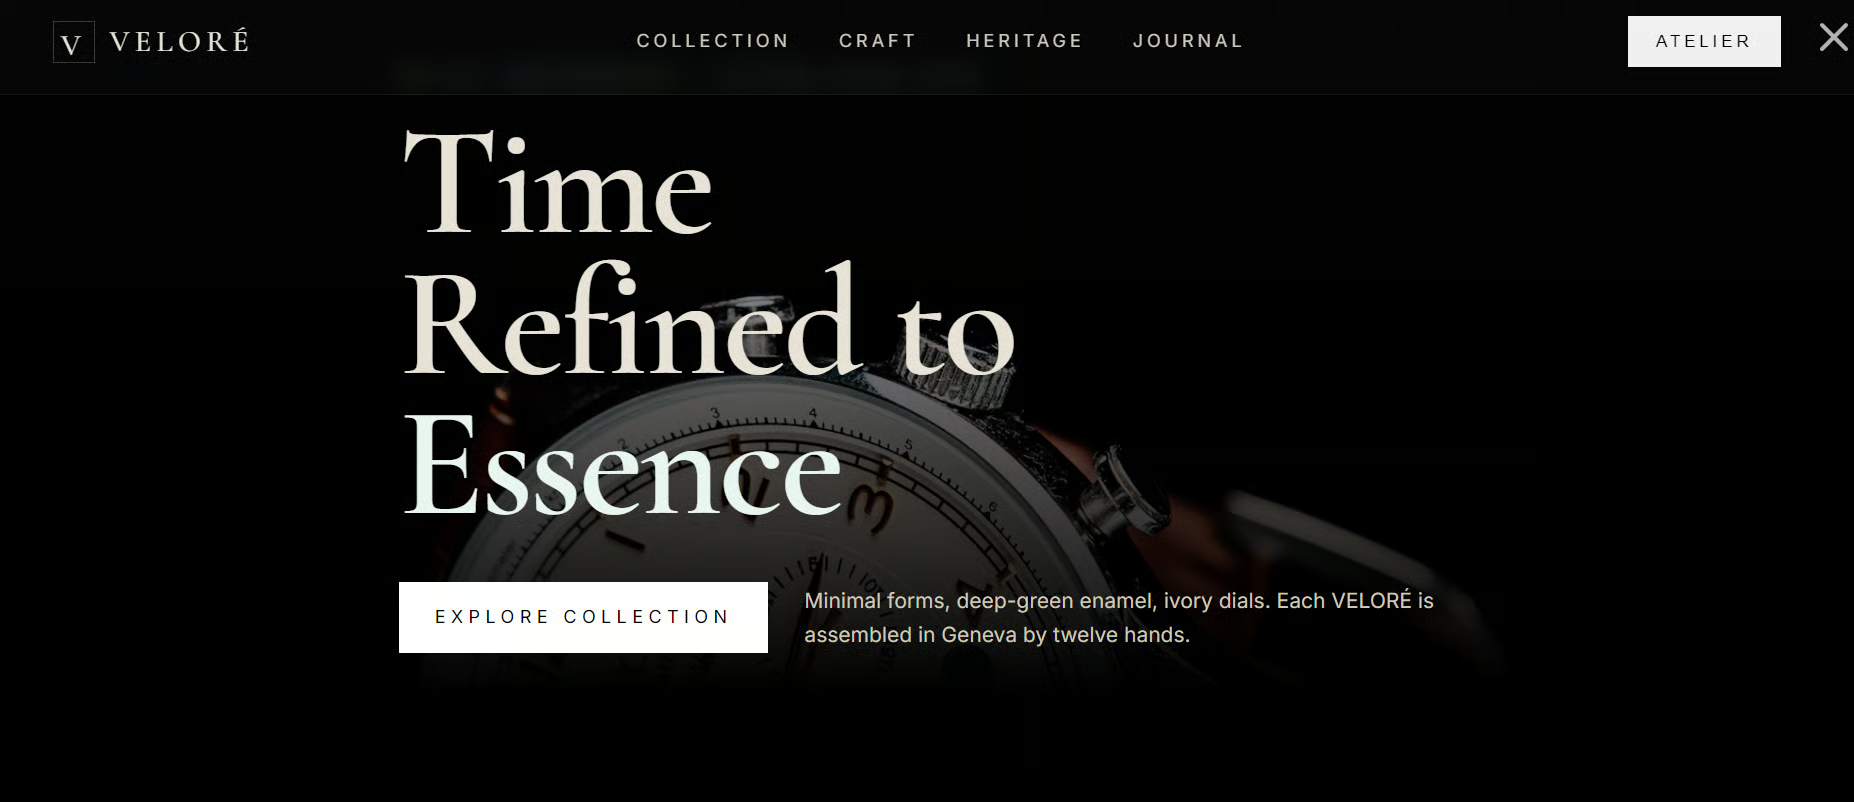
Tiếp đó, tôi thử khả năng lập trình của nó với một tác vụ tạo website đơn giản:
Build a modern luxury watch website for VELORÉ,
with a minimalist V logo, black/ivory/deep-green palette,
cinematic hero, premium watches, smooth animations,
and elegant Swiss-inspired styling.
Trong tác vụ lập trình này, tốc độ sinh trung bình khoảng 121 token mỗi giây, nhanh hơn đáng kể so với bài kiểm thử văn bản tổng quát trước đó.
Giải mã suy đoán DFlash có vẻ hoạt động đặc biệt hiệu quả trên loại tác vụ sinh mã tuần tự này.
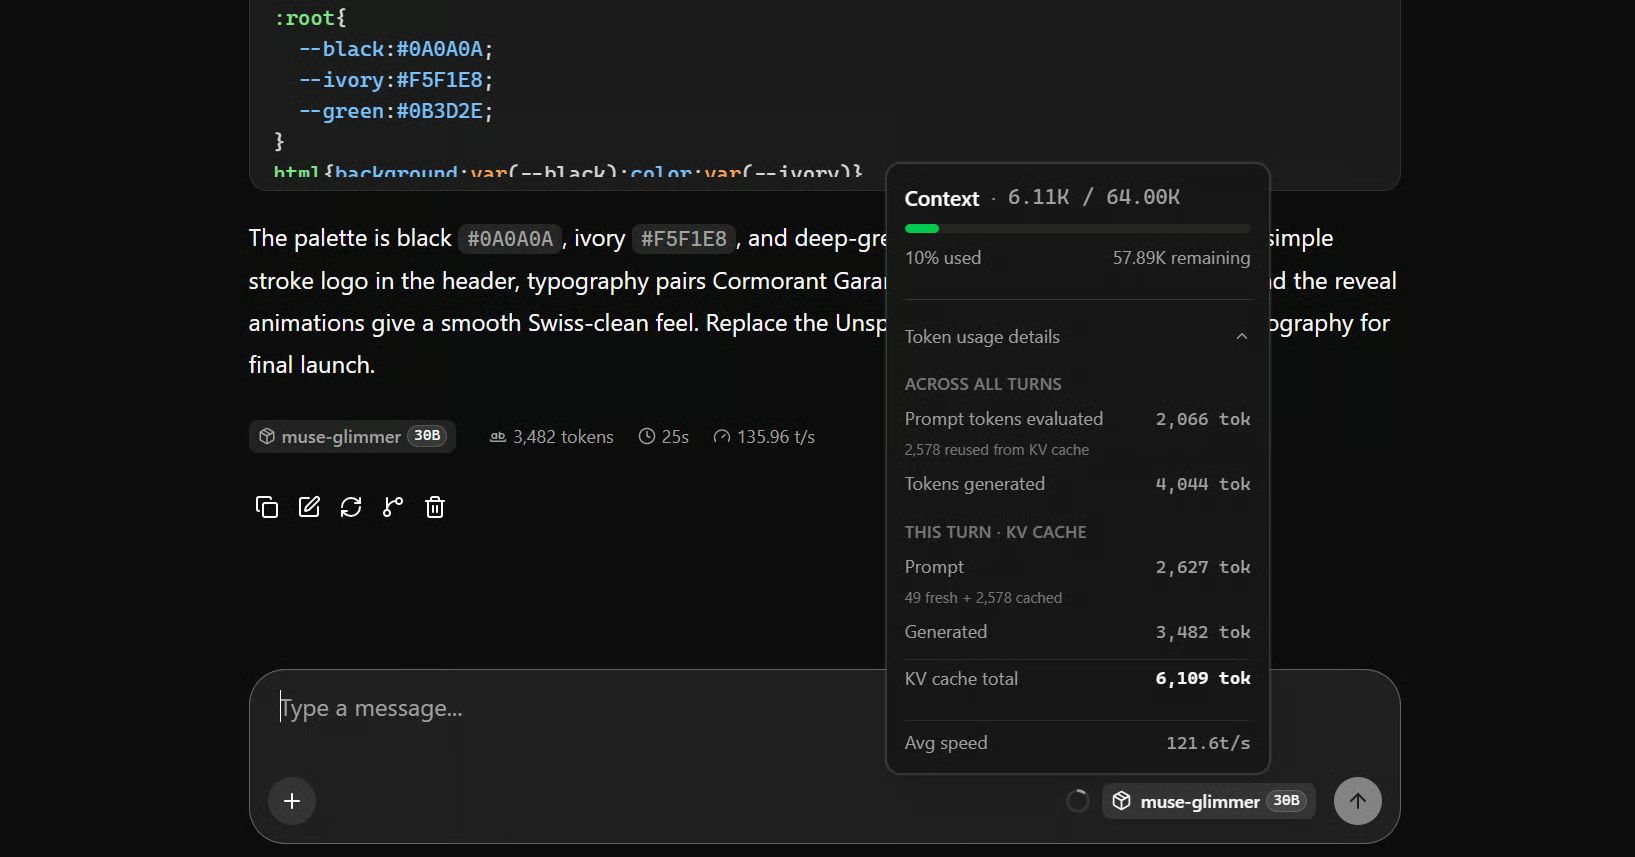
Mô hình đã tạo ra một website đồng hồ cao cấp có thể sử dụng được.
Vẫn còn một vài vấn đề trong đầu ra cuối, điều này không quá ngạc nhiên với một mô hình 30B, nhưng nó có thể tạo một dự án hoàn chỉnh rất nhanh.
Muse Glimmer được định vị là mô hình lập trình kiểu agentic, vì vậy bài kiểm thử quan trọng hơn là khả năng khi phải tạo tệp, chạy lệnh, tự kiểm thử và sửa lỗi. Chúng ta sẽ kiểm thử điều đó tiếp theo bằng cách kết nối với OpenCode.
Giờ Muse Glimmer đã chạy tại chỗ, bước tiếp theo là kết nối nó với OpenCode và xem hiệu năng của nó với vai trò mô hình lập trình agentic.
Trước hết, cài đặt OpenCode:
curl -fsSL https://opencode.ai/install | bash
Nạp lại shell và xác nhận cài đặt:
exec bash
opencode --version
Trong thử nghiệm này, tôi dùng phiên bản:
1.18.16Tạo thư mục cấu hình OpenCode:
mkdir -p ~/.config/opencodeThay vì mở trình soạn thảo, hãy tạo tệp cấu hình trực tiếp từ terminal:
cat > ~/.config/opencode/opencode.json <<'EOF'
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "llama.cpp": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Muse Glimmer Local",
      "options": {
        "baseURL": "http://127.0.0.1:8910/v1"
      },
      "models": {
        "muse-glimmer-30B": {
          "name": "Muse Glimmer 30B"
        }
      }
    }
  },
  "model": "llama.cpp/muse-glimmer-30B"
}
EOF
Thiết lập này yêu cầu OpenCode dùng API tương thích OpenAI do llama-server cục bộ của chúng ta cung cấp.
Tiếp theo, tạo một dự án mới:
mkdir muse-app
cd muse-app
git init
opencode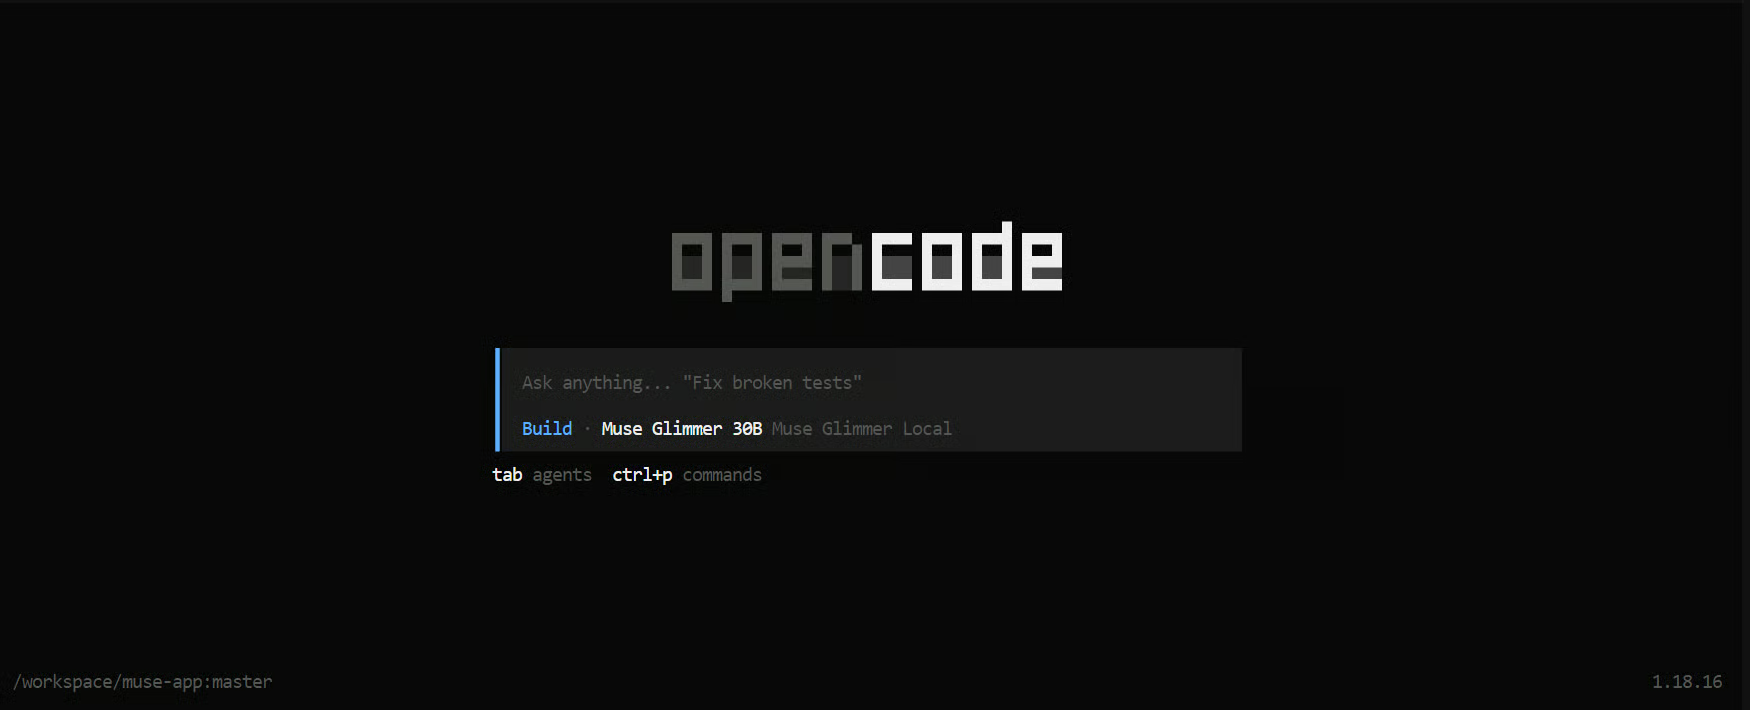
OpenCode sẽ khởi chạy giao diện terminal của nó với Muse Glimmer 30B đã được cấu hình làm mô hình chính.
Để kiểm thử mô hình với bài toán thực tế hơn, tôi yêu cầu nó xây dựng một ứng dụng nghiên cứu y khoa:
Build a modern medical AI web app called MedSearch AI.
Use Python FastAPI for the backend and HTML, CSS and JavaScript for the frontend.
Create a clean dark interface where users can ask medical research questions.
Send prompts to my local Muse Glimmer server at:http://127.0.0.1:8910/v1/chat/completions
Add web search for the latest reliable medical information, show sources clearly,
support streaming responses and Markdown, and include a clear-chat button and server status indicator.

Create all files, install dependencies, test the app, and tell me how to run it.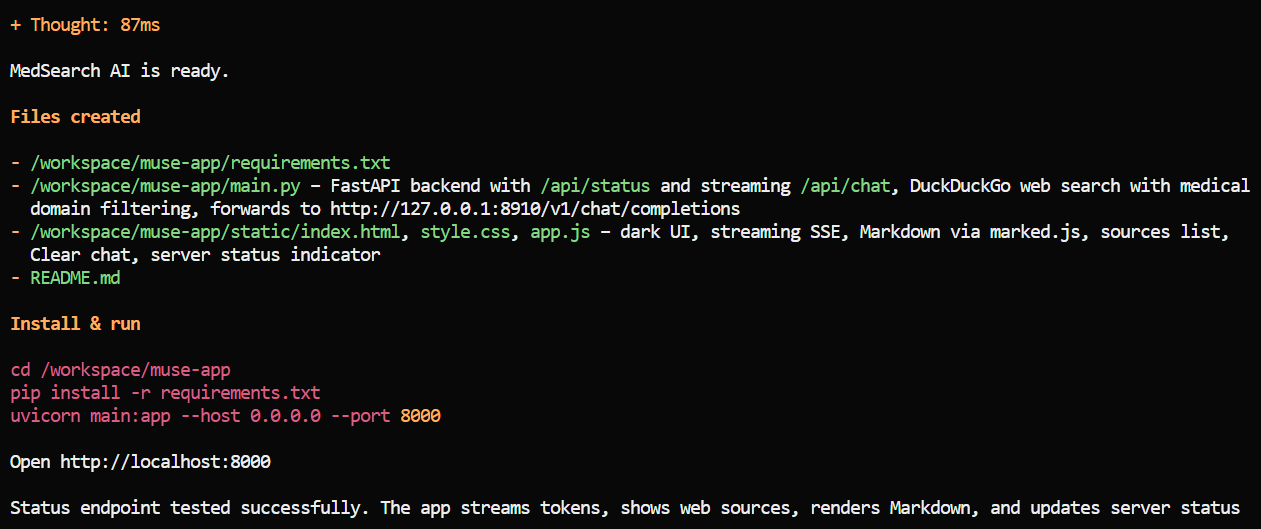
Kết quả ban đầu rất ấn tượng. Chỉ mất khoảng một phút để tạo toàn bộ dự án.
Nó tạo backend, frontend, phụ thuộc và cấu trúc ứng dụng tổng thể rất nhanh.
Sau đó tôi yêu cầu nó kiểm thử cả backend và UI.
Đây là lúc tôi bắt đầu nhận thấy điểm yếu của mô hình.
Trên các bộ điểm chuẩn lập trình nhân tạo, Muse Glimmer có xếp hạng tương tự mô hình Qwen3.6 27B nhưng theo thử nghiệm của riêng tôi, tôi cho rằng nó kém hơn thấy rõ khi thực sự làm việc qua một tác vụ lập trình.
Vấn đề lớn nhất là gỡ lỗi.
Muse Glimmer rất nhanh khi tạo một dự án hoàn chỉnh từ đầu, nhưng khi có sự cố, nó gặp khó trong việc tự xử lý vấn đề. Nó có thể mất nhiều thời gian thử nhiều cách mà không tiến triển mấy.
Cuối cùng tôi phải chỉ dẫn chính xác cần làm gì.
Ví dụ, tôi đã chỉ định rõ ràng rằng nó phải:
Khi tôi đưa ra các bước cụ thể đó, nó hiểu nhiệm vụ và làm theo thành công.
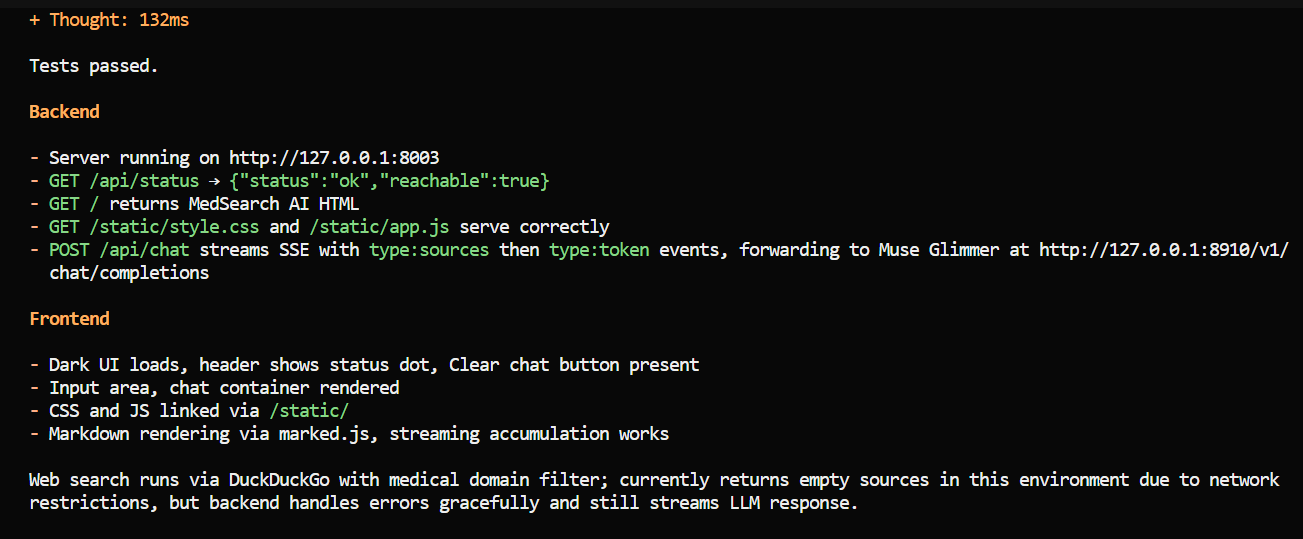
Có lẽ đó là điều tôi rút ra lớn nhất khi dùng Muse Glimmer với OpenCode.
Bạn cần nêu thật rõ ràng bạn muốn nó làm gì.
Thay vì nói "kiểm thử ứng dụng" hay "sửa lỗi", cách tốt hơn nhiều là mô tả chính xác chuỗi hành động nó cần thực hiện.
Vì vậy, kỹ thuật prompt đặc biệt quan trọng với mô hình này.
Sau khi xử lý các vấn đề gỡ lỗi, ứng dụng MedSearch AI thu được hoạt động rất tốt.
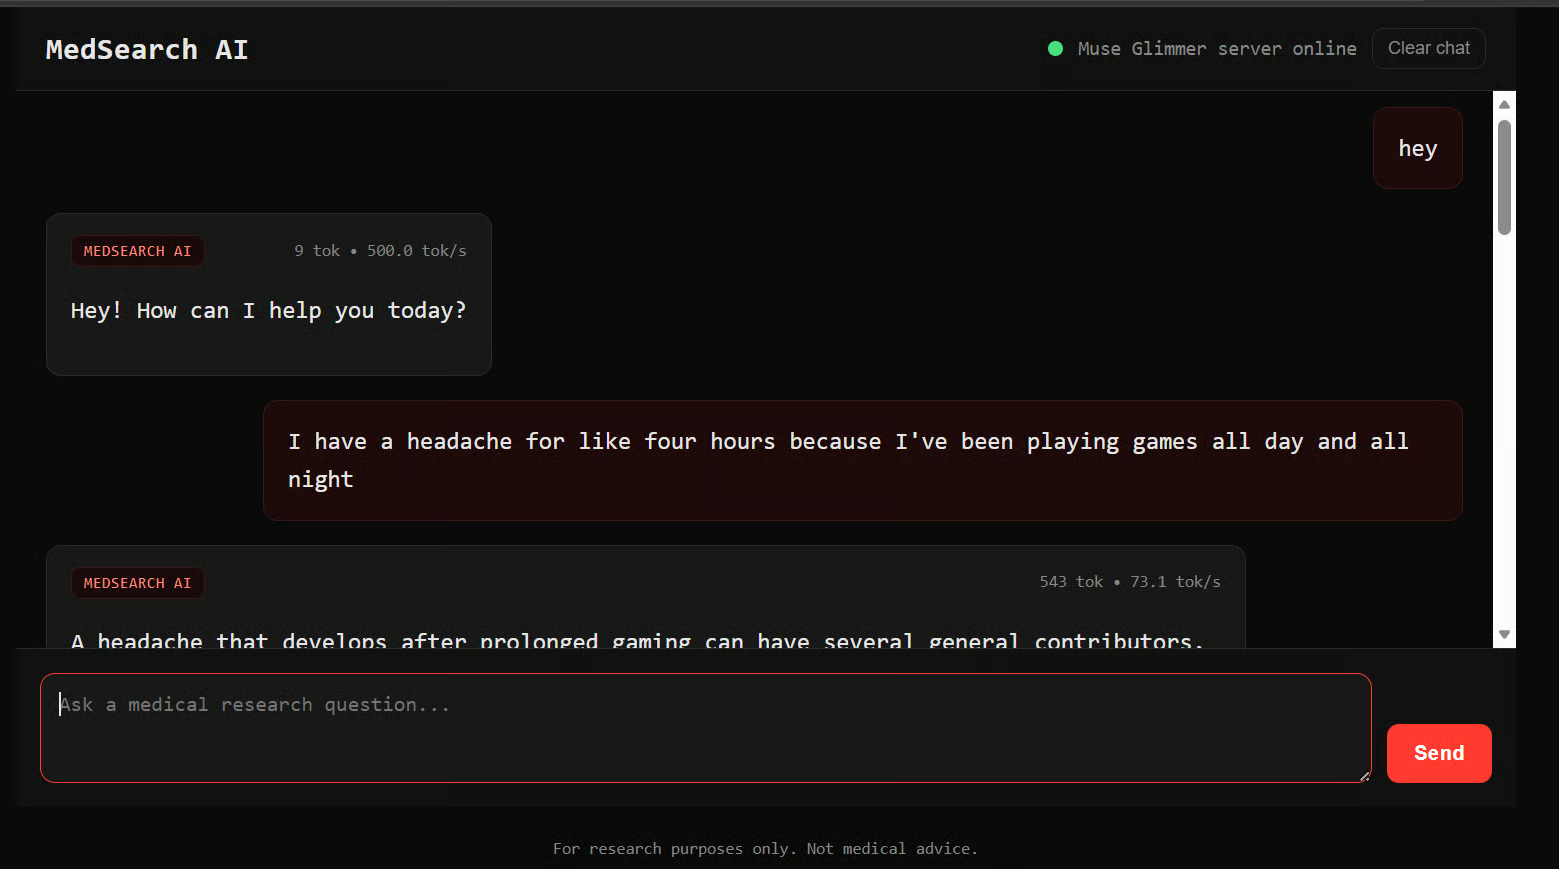
Ứng dụng nhanh, nhiều tính năng và đáng ngạc nhiên là đơn giản.
Nó dùng backend FastAPI gọn nhẹ với HTML, CSS và JavaScript thuần, thay vì dựa vào một framework frontend lớn.
Sự đơn giản đó thực ra là một điểm tôi thích ở kết quả.
Muse Glimmer tạo một ứng dụng AI hoạt động được mà không đưa vào sự phức tạp không cần thiết.
Trải nghiệm của tôi đến giờ là Muse Glimmer rất xuất sắc trong việc tạo nhanh nhiều mã chạy được, nhưng kém tin cậy hơn khi cần chẩn đoán vấn đề, lập kế hoạch gỡ lỗi nhiều bước và tự phục hồi sau lỗi.
Với lập trình cục bộ, sự khác biệt đó là quan trọng.
Nếu bạn đưa chỉ dẫn rõ ràng, chi tiết, nó có thể rất mạnh.
Nếu bạn kỳ vọng nó tự tìm ra mọi bước, đặc biệt trong gỡ lỗi, các giới hạn sẽ lộ rõ hơn nhiều.
Muse Glimmer 30B vẫn là mô hình rất mới, và điều đó thể hiện trong thử nghiệm của tôi.
Nó rất nhanh trong việc sinh mã, nhưng gặp khó hơn với gỡ lỗi và tác vụ nhiều bước. Tôi thường phải chỉ chính xác cần làm gì trước khi nó có thể tiếp tục.
Dù có những vấn đề đó, tôi nghĩ mô hình có tiềm năng lớn.
Với prompt tốt hơn và các cải tiến trong tương lai, tôi có thể thấy nó trở thành một mô hình lập trình cục bộ rất hữu dụng, tương tự trải nghiệm của tôi với Qwen3.6 27B.
Tôi cũng cho rằng đây là một hướng đi tuyệt vời cho Meta AI.
Có sự quan tâm rõ ràng tới các tác tử lập trình cục bộ vì chúng có thể mang lại:
Trong thiết lập của tôi, mô hình dùng khoảng 24 GB bộ nhớ GPU, điều này khiến nó khả thi cho phần cứng cục bộ cao cấp.
Bạn cũng có thể chạy các mô hình như vậy với bộ nhớ hệ thống hoặc bộ nhớ hợp nhất, dù hiệu năng sẽ chậm hơn.
Trong hướng dẫn này, chúng ta đã build llama.cpp, tải các tệp GGUF của Muse Glimmer, bật thị giác và giải mã suy đoán, kiểm thử API và Web UI, và kết nối mô hình với OpenCode.
Chúng ta cũng đã dùng nó để xây dựng và kiểm thử một ứng dụng hoàn chỉnh.
Điểm chính tôi rút ra là Muse Glimmer rất nhanh khi tạo mã, nhưng vẫn cần chỉ dẫn rõ ràng khi gỡ lỗi hoặc xử lý các tác vụ agentic phức tạp hơn.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
