Di dunia yang digerakkan oleh data saat ini, kebutuhan akan basis data yang dapat diskalakan, berkinerja tinggi, dan sangat tersedia lebih besar dari sebelumnya. Amazon DynamoDB, layanan penyimpanan key-value kolom lebar yang sepenuhnya dikelola, tanpa server (serverless) dari AWS (Amazon Web Services), dirancang untuk memenuhi kebutuhan tersebut. Baik Anda membangun aplikasi web, aplikasi seluler, atau sistem apa pun yang memerlukan penyimpanan yang fleksibel dan andal, DynamoDB siap membantu.
Tutorial ini bertujuan memperkenalkan Anda pada dunia Amazon DynamoDB dan menunjukkan cara menggunakannya secara efektif dalam aplikasi Node.js. Baik Anda pemula yang baru mulai menggunakan basis data NoSQL atau pengembang berpengalaman yang ingin menambah keterampilan, panduan ini akan memandu Anda melalui hal-hal penting dan memberi contoh praktis untuk membantu Anda memulai.
Apa itu DynamoDB?
Amazon DynamoDB adalah basis data tanpa server (serverless) dengan model key-value dan dokumen yang menawarkan skalabilitas mulus dan performa latensi rendah. Berbeda dengan basis data relasional tradisional, DynamoDB tidak mengharuskan Anda menyediakan perangkat keras atau mengelola infrastruktur, sehingga ideal untuk aplikasi yang perlu meningkatkan atau menurunkan skala secara dinamis sesuai perubahan beban kerja.
Fitur utama DynamoDB meliputi:
Skalabilitas
DynamoDB dapat menangani jutaan permintaan per detik, sehingga cocok untuk aplikasi dengan tingkat trafik yang bervariasi.
Ketersediaan tinggi
Dirancang untuk ketersediaan tinggi dan ketahanan data dengan replikasi bawaan di beberapa zona ketersediaan.
Layanan terkelola
AWS menangani beban operasional, termasuk penyediaan perangkat keras, patching, dan pencadangan, sehingga Anda dapat fokus membangun aplikasi.
Model data yang fleksibel
DynamoDB mendukung model data key-value dan dokumen, memberi fleksibilitas dalam menyusun data Anda.
Keamanan
Integrasi AWS Identity and Access Management (IAM) memungkinkan kontrol akses aman yang terperinci ke sumber daya basis data Anda pada tingkat item dan atribut.
Penghematan biaya
Arsitektur serverless DynamoDB, dipadukan dengan kemampuan penskalaan otomatis, memungkinkan Anda mengoptimalkan biaya dengan hanya membayar sumber daya yang digunakan. Tidak ada biaya perangkat keras di muka atau komitmen jangka panjang, sehingga menjadi pilihan hemat biaya bagi startup maupun perusahaan.
Tipe data
Tipe data yang didukung di DynamoDB:
- Tipe skalar: Mencakup string, angka, biner, boolean, dan nilai null.
- Tipe dokumen: DynamoDB mengakomodasi struktur kompleks dengan atribut bertingkat, sehingga ideal untuk menangani data JSON.
- Tipe set: String set, number set, dan binary set memungkinkan Anda menyimpan koleksi nilai terkait secara efisien.
Mengapa menggunakan DynamoDB dengan Node.js?
Node.js adalah lingkungan runtime populer untuk membangun aplikasi sisi server, termasuk web server dan API. Arsitekturnya yang non-blocking dan event-driven sangat cocok dengan API asinkron DynamoDB, menjadikannya pilihan alami bagi pengembang Node.js.
Dalam tutorial ini, kita akan membahas topik-topik berikut:
1. Membuat tabel dan mendefinisikan skema di DynamoDB.
2. Melakukan operasi dasar CRUD (Create, Read, Update, Delete) menggunakan AWS SDK untuk Node.js.
3. Query tingkat lanjut dengan kepatuhan ACID.
Di akhir tutorial ini, Anda akan memiliki pemahaman yang kuat tentang Amazon DynamoDB dan cara memanfaatkan kemampuannya dalam aplikasi Node.js Anda. Mari kita mulai dan buka potensi basis data NoSQL yang serbaguna ini!
Persiapan
Sebelum mulai, Anda memerlukan sebuah akun AWS. Sebenarnya kita bisa melakukan semua ini tanpa akun AWS, tetapi agar lebih realistis, kita akan menggunakan terraform untuk membuat infrastruktur kita di AWS. Untuk informasi lebih lanjut tentang cara bekerja dengan layanan AWS secara lokal menggunakan Docker saya memiliki contoh demo localstack repositori github yang dapat Anda rujuk dan coba.
Sekarang saatnya juga untuk memasang terraform jika Anda belum memilikinya.
Sisa tutorial ini mengasumsikan Anda telah menyiapkan AWS CLI dengan kredensial dan berkas konfigurasi, serta telah memasang terraform.
Mulai
Untuk tutorial ini kita akan menggunakan TypeScript dan yarn. Kita akan mulai sederhana dengan menggunakan ts-node dan pada tutorial berikutnya kita akan beralih ke serverless dan mengembangkannya dengan menggunakan AWS Lambda.
Untuk menyiapkan proyek demo, buat folder baru lalu tambahkan dependensi dan penyiapan berikut dengan menjalankan:
yarn init
yarn add --dev typescript ts-node @types/node @types/ramda @types/uuid
yarn add @aws-sdk/client-dynamodb ramda uuid
npx tsc --init
mkdir src src/domain infra
touch ./src/index.ts ./src/client.ts ./infra/main.tf ./src/domain/student.ts
Selanjutnya tambahkan bagian scripts berikut ke package.json
  "scripts": {
    "dev": "ts-node src/index.ts"
  },
main.tf
provider "aws" {
  region = "eu-west-1"
}


resource "aws_dynamodb_table" "demo-table" {
  name = "demo-table"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }
}
Dari baris perintah cd ke direktori infra lalu jalankan terraform init && terraform apply -auto-approve kemudian buka konsol AWS dan lihat tabel DynamoDB Anda:
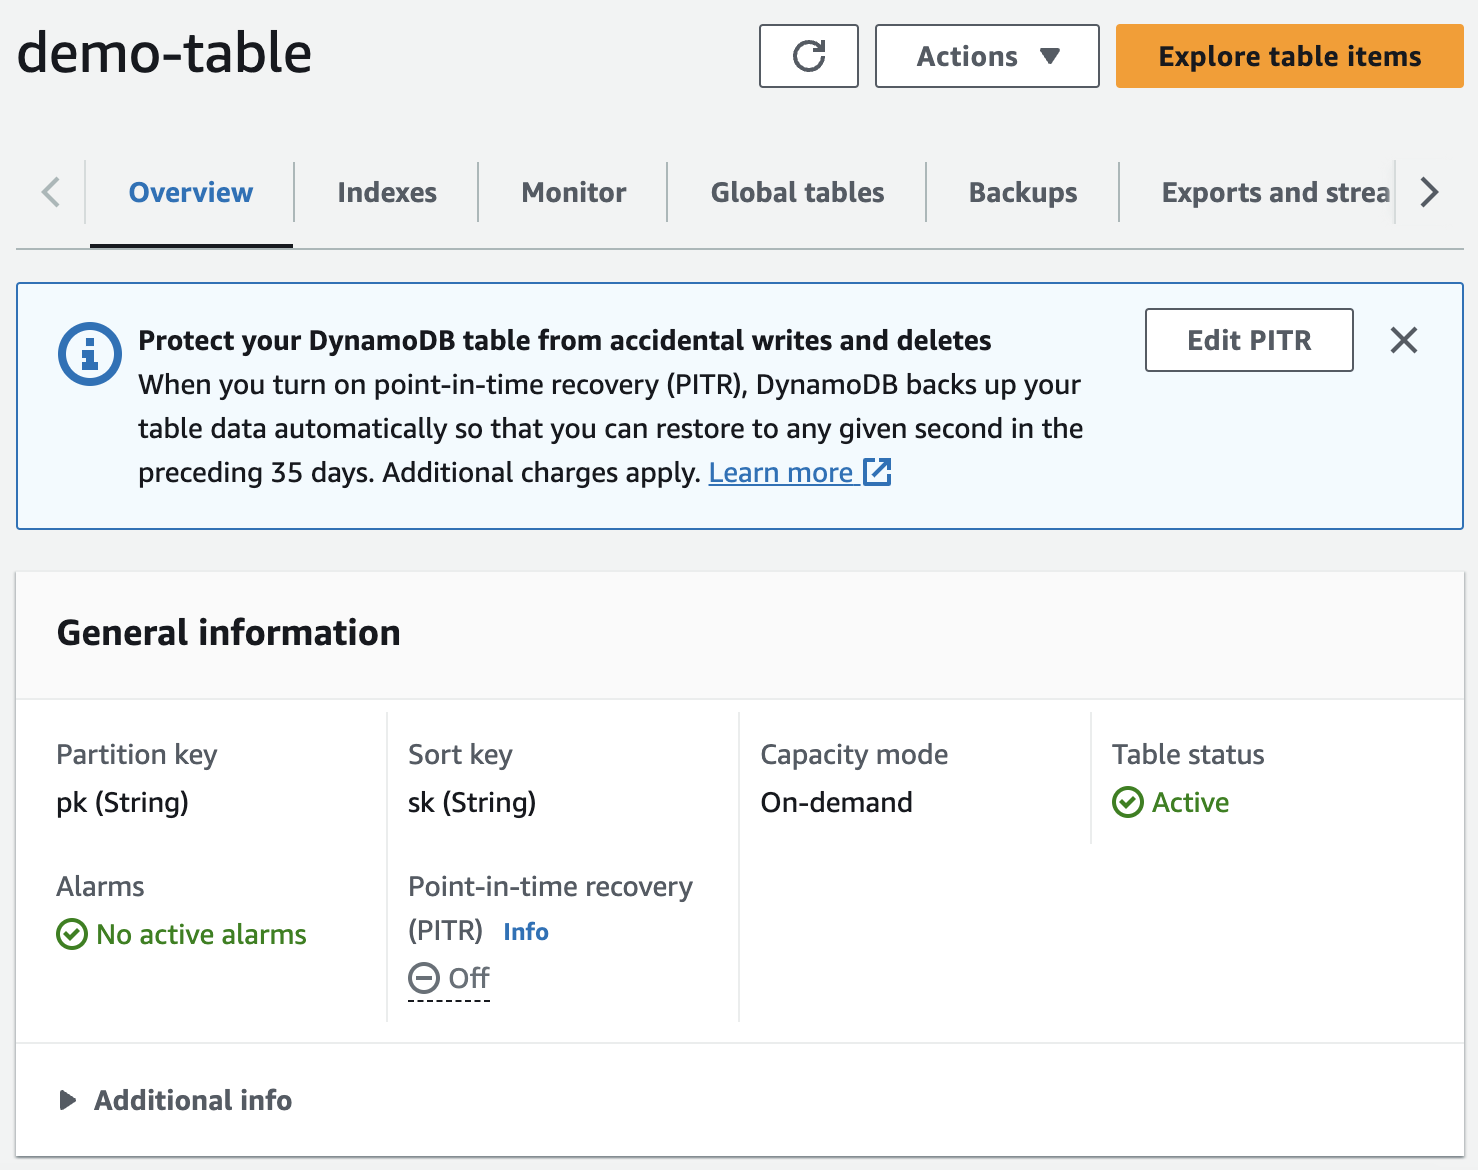
Saya akan membahas mode penagihan DynamoDB, WCU, RCU di artikel terpisah
client.ts
import { DynamoDB } from "@aws-sdk/client-dynamodb";


export const TABLE_NAME = "demo-table";
export const REGION = "eu-west-1";
export const dynamoClient = new DynamoDB({ region: REGION });


export const STUDENT_PREFIX = "student#";
Model Data
Sebelum melangkah lebih jauh, mari kita tetapkan model data yang dapat kita gunakan untuk cakupan tutorial ini. Agar tetap kontekstual saya memilih memodelkan sesuatu yang mendekati fitur inti DataCamp.
Tutorial ini tidak akan membahas semua entitas. Saya akan mengembangkan model ini di artikel berikutnya.
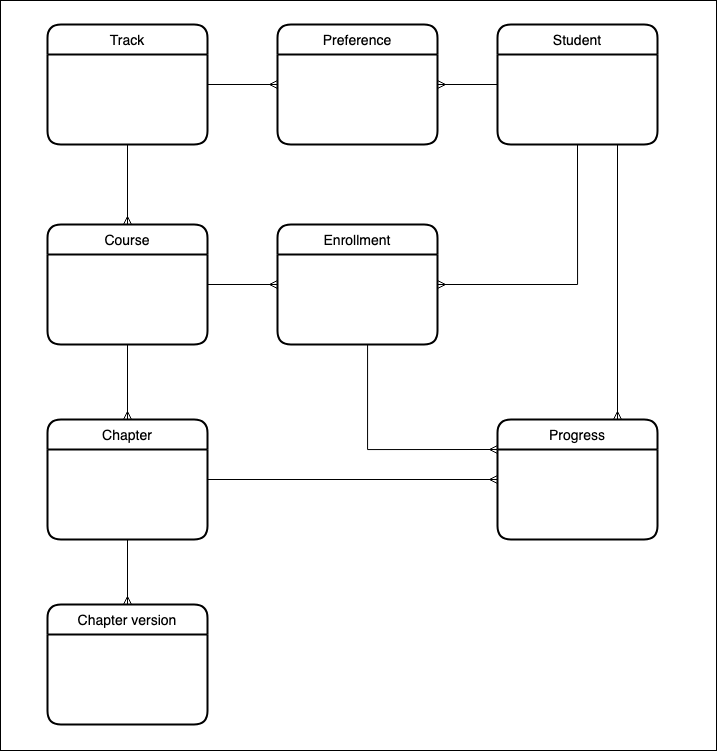
Operasi CRUD Dengan DynamoDB
Untuk pemahaman menyeluruh tentang cara merancang dan memodelkan data dengan DynamoDB lihat tutorial saya tentang desain tabel tunggal dengan DynamoDB. Dalam tutorial ini, saya akan berusaha meminimalkan penjelasan tentang cara kerja DynamoDB. Hal terpenting untuk diingat adalah bahwa DynamoDB menggunakan partition key dan sort key untuk manajemen data yang efisien.
Partition key
Partition key digunakan untuk mendistribusikan data ke beberapa server penyimpanan. Penting untuk memilih partition key yang mendistribusikan data secara merata guna menghindari "hot partition" (distribusi data tidak merata) yang dapat menyebabkan masalah performa.
Pilihan umum untuk partition key yang membantu mendistribusikan data secara merata meliputi atribut dengan kardinalitas tinggi seperti:
- ID unik
- ID pengguna
- nilai hash
- wilayah geografis
- kunci berbasis waktu
- kunci komposit
Pemilihan partition key sangat bergantung pada pola akses dan model data aplikasi.
Sort key
Sort key bersifat opsional dan memungkinkan Anda mengatur data dalam suatu partisi. Gunakan sort key untuk melakukan query dan pengurutan data secara efisien di dalam partisi.
Kunci komposit
Kunci komposit terdiri dari partition key dan sort key. Keduanya memungkinkan Anda membuat pola query yang kaya, seperti penyaringan berdasarkan rentang, waktu, atau atribut lainnya. Gunakan kunci komposit saat pola akses data Anda memerlukan query yang kompleks.
Hot partition
Untuk mengurangi hot partition, pertimbangkan strategi seperti sharding (menggunakan prefiks acak untuk partition key), partisi berbasis waktu, atau mendistribusikan penulisan secara merata. Pantau dan gunakan AWS Auto Scaling untuk menyesuaikan kapasitas secara dinamis.
student.ts
Kita akan menyederhanakan dengan menggunakan ID siswa sebagai partition key dan sort key. Ini mungkin tampak aneh, tetapi kita perlu menjaga skema tetap fleksibel dan siap mendukung berbagai relasi data dan pola akses. Saya akan mengembangkan model ini di artikel DynamoDB berikutnya.
import { head, omit, pathOr } from "ramda";
import { STUDENT_PREFIX, TABLE_NAME, dynamoClient as client } from "../client";
import { v4 as uuidv4 } from "uuid";
import {
  addPrefix,
  attributeMapToValues,
  attributeValueToValue,
  removePrefix,
  valueToAttributeValue,
} from "../utils";


const entityType = "student";


export const dynamoRecordToStudent = (record: any) => {
  const { pk, ...data } = record;


  return omit(["sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
  });
};


export const getStudentById = (id: string) =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
  })
  .then(({ Item }) => (Item ? dynamoRecordToStudent(Item) : undefined));


export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      email: valueToAttributeValue(_email),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
utils.ts
SDK DynamoDB terbaru dari AWS meningkatkan keamanan tipe untuk item yang disimpan di basis data tetapi membuatnya sedikit lebih sulit digunakan. Untuk mengurangi kesulitan ini mari buat beberapa fungsi pembantu. Nanti akan jelas mengapa kita membutuhkannya saat melihat bagaimana DynamoDB menyimpan data secara internal.
Buat berkas baru di root folder src bernama utils.ts.
import { AttributeValue } from "@aws-sdk/client-dynamodb";


export const valueToAttributeValue = <T>(value: T): AttributeValue => {
  switch (typeof value) {
    case "string":
      return { S: value };
    case "number":
      return { N: `${value}` };
    case "boolean":
      return { BOOL: value };
    case "object":
      if (Array.isArray(value)) {
        return { L: value.map((item) => valueToAttributeValue(item)) };
      }
      return {
        M: Object.entries(value as any).reduce(
          (acc, [key, item]) => ({
            ...acc,
            [key]: valueToAttributeValue(item),
          }),
          {}
        ),
      };
    default:
      throw new Error(`Unknown type ${typeof value}`);
  }
};


export const attributeValueToValue = <T>(value: AttributeValue): T => {
  switch (true) {
    case !!value.S:
      return value.S as T;
    case !!value.N:
      return Number(value.N) as T;
    case !!value.BOOL:
      return value.BOOL as T;
    case !!value.L:
      return value.L?.map((item) =>
        attributeValueToValue(item)
      ) as unknown as T;
    case !!value.M:
      return Object.entries(value.M || []).reduce(
        (acc, [key, item]) => ({ ...acc, [key]: attributeValueToValue(item) }),
        {}
      ) as unknown as T;
    default:
      throw new Error(`Unknown type ${JSON.stringify(value)}`);
  }
};


export const attributeMapToValues = (
  items: Record<string, AttributeValue>
): unknown[] =>
  Object.keys(items).reduce(
    (acc, key) => ({
      ...acc,
      [key]: attributeValueToValue(items[key]),
    }),
    []
  );


export const removePrefix = (id: string, prefix: string): string =>
  id.replace(prefix, "");


export const addPrefix = (id: string, prefix: string): string =>
  `${prefix}${removePrefix(id, prefix)}`;
Membuat siswa baru
Akhirnya kita siap mulai mengirim panggilan API operasi CRUD ke DynamoDB!
Buka berkas index.ts dan tempel kode berikut lalu dari cmd line jalankan yarn dev.
import { getStudentById, saveStudent } from "./domain/student";


Promise.resolve()
  .then(async () => {
    const id = await saveStudent({
      firstName: "John",
      lastName: "Smith",
      email: "john@datacamp.com",
    });


    const john = await getStudentById(id);


    console.log(john);
  })
  .catch((err) => {
    console.error(err);
    process.exit(1);
  })
  .then(() => {
    console.log("done");
    process.exit(0);
  });
Anda akan melihat keluaran seperti ini:
{
  "entityType": "student",
  "id": "dd4c2ee4-9422-4957-ae6f-f9fff748e5ab",
  "firstName": "John",
  "lastName": "Smith",
  "email": "john@datacamp.com",
  "xp": 0
}
Sekarang gunakan CLI untuk melakukan scan pada DynamoDB dengan menjalankan:
aws dynamodb scan --table-name demo-table --no-cli-pager
Dari output Anda bisa melihat bagaimana DynamoDB menyimpan dan memberi tipe data secara internal, di mana N merujuk ke tipe number dan S ke tipe string, yang semestinya menjawab pertanyaan yang mungkin Anda pikirkan tentang kode di utils.ts.
{
  "Items": [
    {
      "entityType": {
        "S": "student"
      },
      "lastName": {
        "S": "Smith"
      },
      "email": {
        "S": "john@datacamp.com"
      },
      "xp": {
        "N": "0"
      },
      "sk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "pk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "firstName": {
        "S": "John"
      }
    }
  ],
  "Count": 1,
  "ScannedCount": 1,
  "ConsumedCapacity": null
}
Mendapatkan siswa berdasarkan alamat email
Bagaimana jika kita hanya memiliki alamat email siswa untuk menemukan rekaman kita? Kita dapat mendukung pola akses ini dengan menambahkan global secondary index.
Pertama, kita perlu menghancurkan tabel asli (kita akan melewati langkah ini untuk perubahan terraform di masa depan dengan memperkenalkan fungsi truncate table):
terraform destroy
Selanjutnya, perbarui terraform dengan menambahkan GSI berikut ke demo-table kita:
attribute {
  name = "gsi1_pk"
  type = "S"
}


attribute {
  name = "gsi1_sk"
  type = "S"
}


global_secondary_index {
  name = "gsi1"
  hash_key = "gsi1_pk"
  range_key = "gsi1_sk"
  projection_type = "ALL"
}
Terapkan perubahan ini dengan:
terraform apply -auto-approve
Berikutnya kita perlu sedikit memodifikasi cara menyimpan data siswa:
export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      gsi1_pk: valueToAttributeValue(_email),
      gsi1_sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
Perhatikan bahwa kita tidak lagi secara eksplisit menyimpan email, melainkan menggunakannya sebagai nilai GSI PK.
Kita perlu sedikit menyesuaikan cara mentransformasi data siswa dari DynamoDB:
export const dynamoRecordToStudent = (record: any) => {
  const { pk, gsi1_pk, ...data } = record;


  return omit(["sk", "gsi1_sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
    email: attributeValueToValue<string>(gsi1_pk),
  });
};
Terakhir, kita dapat melakukan query menggunakan GSI gsi1 yang baru dibuat untuk mendapatkan data siswa berdasarkan alamat email:
export const getStudentByEmail = (email: string) =>
  client
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
      ExpressionAttributeNames: {
        "#gsi1_pk": "gsi1_pk",
      },
      ExpressionAttributeValues: {
        ":gsi1_pk": {
          S: email.toLocaleLowerCase(),
        },
      },
    })
    .then((res) => head(pathOr([], ["Items"], res).map(dynamoRecordToStudent)));
Memperbarui data siswa
Untuk memperbarui data siswa kita perlu menggunakan metode update dan memberikan partition key dan sort key untuk mengidentifikasi item yang ingin diperbarui secara unik.
export const updateStudent = async ({
  id,
  firstName,
  lastName,
  email,
}: {
  id: string;
  firstName?: string;
  lastName?: string;
  email?: string;
}) => {
  const updateExpressionParts = [];
  const ExpressionAttributeValues: Record<string, any> = {};


  if (firstName !== undefined) {
    updateExpressionParts.push("#firstName = :firstName");
    ExpressionAttributeValues[":firstName"] = valueToAttributeValue(firstName);
  }


  if (lastName !== undefined) {
    updateExpressionParts.push("#lastName = :lastName");
    ExpressionAttributeValues[":lastName"] = valueToAttributeValue(lastName);
  }


  if (email !== undefined) {
    updateExpressionParts.push("#gsi1_pk = :gsi1_pk");
    ExpressionAttributeValues[":gsi1_pk"] = valueToAttributeValue(email);
  }


  const UpdateExpression = `SET ${updateExpressionParts.join(", ")}`;


  const ExpressionAttributeNames = {
    ...(firstName && { "#firstName": "firstName" }),
    ...(lastName && { "#lastName": "lastName" }),
    ...(email && { "#gsi1_pk": "gsi1_pk" }),
  };


  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression,
    ExpressionAttributeNames,
    ExpressionAttributeValues,
  });
};
Menghapus data
Pertama mari mulai dengan fakta bahwa truncating tabel di DynamoDB tidak didukung secara native selain dengan menghapus seluruh tabel lalu membuatnya kembali (seperti yang kita lakukan sebelumnya untuk menambahkan GSI baru). Saya akan menambahkan metode truncate ke client.ts namun perlu ditekankan bahwa ini hanya untuk tujuan pengujian dan tidak boleh digunakan di produksi. Alasannya, untuk mengetahui apa yang harus dihapus, kita harus melakukan scan ke seluruh tabel, dan setiap operasi di DynamoDB akan menimbulkan biaya, jadi jika Anda memiliki tabel dengan sejuta item, akan lebih murah untuk menghapus tabel tersebut dan memulai lagi (dengan semacam proses migrasi data agar Anda tidak kehilangan data produksi). Berikut fungsi truncate kita:
type AttributeMap = Record<string, AttributeValue>;


const getItemKeyAndValue = (item: AttributeMap, key?: string) =>
  key ? { [`${key}`]: item[`${key}`] } : {};


export const truncateTable = async (
  client: DynamoDB,
  TableName: string,
  hash: string,
  range?: string
): Promise<void> => {
  const { Items } = await client.scan({ TableName });
  if (!Items) {
    return;
  }
  const keys = Items.map((item: AttributeMap) => ({
    ...getItemKeyAndValue(item, hash),
    ...getItemKeyAndValue(item, range),
  }));
  if (!keys.length) {
    return;
  }
  await Promise.all(keys?.map((Key) => client.deleteItem({ TableName, Key })));
};
Untuk mengosongkan demo-table:
await truncateTable(dynamoClient, TABLE_NAME, "pk", "sk");
Untuk menghapus seorang siswa tertentu kita sebetulnya tidak ingin menggunakan metode deleteItem dari SDK. Basis data NoSQL tidak memiliki konsep integritas referensial dan jika ada item lain di basis data yang merujuk ke siswa yang sudah tidak ada maka ini menjadi masalah, dan DynamoDB akan dengan senang hati menghapus item apa pun yang kita minta tanpa jaring pengaman untuk memastikan tidak ada referensi kunci asing seperti yang dilakukan basis data relasional (yang akan memunculkan galat untuk operasi penghapusan tersebut).
Agar aman kita akan menerapkan soft delete dan melakukan sedikit modifikasi pada dua fungsi baca.
export const deleteStudent = async (id: string) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "SET #deleted = :deleted",
    ExpressionAttributeNames: {
      "#deleted": "deleted",
    },
    ExpressionAttributeValues: {
      ":deleted": valueToAttributeValue(true),
    },
  });
};
Query untuk getStudentByEmail sekarang harus menyaring rekaman yang dihapus. Penting untuk dicatat bahwa “penyaringan” ini terjadi di sisi klien dan bukan di basis data, artinya query ini tetap menimbulkan biaya yang sama untuk mengambil rekaman yang dihapus.
{
  TableName: TABLE_NAME,
  IndexName: "gsi1",
  KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
  ExpressionAttributeNames: {
    "#gsi1_pk": "gsi1_pk",
  },
  ExpressionAttributeValues: {
    ":gsi1_pk": {
      S: email.toLocaleLowerCase(),
    },
    ":notDeleted": {
      BOOL: false,
    },
  },
  FilterExpression:
    "attribute_not_exists(deleted) OR deleted = :notDeleted",
 }
Fungsi getStudentById menggunakan getItem, sehingga kita tidak memiliki opsi untuk menerapkan filter expression, sebagai gantinya kita akan menuliskan logikanya secara eksplisit:
export const getStudentById = (id: string): Promise<Student | null> =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
        pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
        sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      },
    })
    .then(({ Item }) => {
      if (!Item) {
        return null;
      }
      const _item = dynamoRecordToStudent(Item);
      return _item.deleted ? null : _item;
    });
Pembaruan Atomik dengan Kepatuhan ACID
DataCamp mengumpulkan data XP untuk setiap siswa guna memberikan motivasi, rasa pencapaian, cara mudah melacak progres keseluruhan, dan sarana bagi siswa untuk mengukur diri terhadap rekan-rekannya. Pada basis data relasional, kita memiliki berbagai alat untuk memanipulasi dan mengagregasi data, tetapi ini tidak berlaku untuk basis data NoSQL. Meskipun beberapa basis data NoSQL seperti MongoDB menyediakan kerangka agregasi, alat tersebut cenderung tidak efektif saat basis data mencapai skala besar, dan alasan memilih NoSQL sering kali justru karena kita perlu mendukung volume data dan trafik yang sangat besar.
Di DynamoDB, pembaruan atomik mengacu pada kemampuan melakukan operasi pembaruan tertentu pada satu atribut item dengan cara yang menjamin atomicity, consistency, isolation, dan durability (properti ACID). Pembaruan atomik adalah operasi yang memodifikasi nilai atribut tertentu dengan jaminan keberhasilan operasi bahkan saat ada pembaruan bersamaan.
Dengan teknik ini kita dapat dengan mudah menambahkan XP ketika pengguna menyelesaikan tujuan belajar.
export const updateStudentXp = async ({
  id,
  xp,
}: {
  id: string;
  xp: number;
}) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "set xp = xp + :inc",
    ExpressionAttributeValues: {
      ":inc": valueToAttributeValue(xp),
    },
  });
};
Jika kode ini terasa familier itu karena kita sudah menggunakan pola ini untuk fungsi deleteStudent!
Kesimpulan
Dalam tutorial ini, kita telah mempelajari dasar-dasar Amazon DynamoDB, basis data serverless yang sangat dapat diskalakan dari AWS. Fitur utama DynamoDB, termasuk skalabilitas mulus, ketersediaan tinggi, dan pemodelan data yang fleksibel, menjadikannya pilihan unggul untuk aplikasi modern.
Kita membahas topik penting seperti membuat tabel, melakukan operasi CRUD menggunakan Node.js, dan membahas pentingnya pembaruan atomik untuk menjaga konsistensi data. Sepanjang tutorial, kita mengembangkan model data dan mengimplementasikan fungsi untuk berinteraksi dengan DynamoDB.
Saat Anda melanjutkan perjalanan dengan DynamoDB, pertimbangkan untuk mengeksplorasi topik lanjutan seperti desain tabel tunggal, optimasi performa, dan DynamoDB Streams untuk pemrosesan data real-time. Fleksibilitas dan skalabilitas DynamoDB memberdayakan Anda membangun aplikasi serverless berkinerja tinggi dalam ekosistem AWS.
Anda dapat menemukan kode sumber lengkap dari tutorial ini di Github. Selamat ngoding!
Materi Pembelajaran Tambahan
- Tutorial DataCamp: Desain tabel tunggal dengan DynamoDB
- Kursus DataCamp: Konsep NoSQL
- AWS re:Invent: Advanced Design Patterns for DynamoDB
- Rick Houlihan: Fundamentals of DynamoDB Single Table Design
- Alex DeBrie: Buku DynamoDB