Trong thế giới vận hành bằng dữ liệu ngày nay, nhu cầu về các cơ sở dữ liệu có khả năng mở rộng, hiệu năng cao và sẵn sàng cao lớn hơn bao giờ hết. Amazon DynamoDB, một kho khóa-giá trị cột rộng không máy chủ (serverless) được AWS (Amazon Web Services) cung cấp và quản lý toàn phần, được thiết kế để đáp ứng những yêu cầu đó. Dù bạn đang xây dựng ứng dụng web, ứng dụng di động hay bất kỳ hệ thống nào cần lưu trữ linh hoạt và đáng tin cậy, DynamoDB đều có thể đáp ứng.
Hướng dẫn này nhằm giới thiệu bạn với thế giới Amazon DynamoDB và cách sử dụng hiệu quả trong các ứng dụng Node.js. Dù bạn là người mới bắt đầu với cơ sở dữ liệu NoSQL hay nhà phát triển giàu kinh nghiệm muốn mở rộng bộ kỹ năng, tài liệu này sẽ dẫn bạn qua những điều cốt lõi và cung cấp ví dụ thực tiễn để bạn bắt đầu.
DynamoDB là gì?
Amazon DynamoDB là cơ sở dữ liệu không máy chủ theo mô hình khóa-giá trị và tài liệu, cung cấp khả năng mở rộng liền mạch và độ trễ thấp. Khác với cơ sở dữ liệu quan hệ truyền thống, DynamoDB không yêu cầu bạn cấp phát phần cứng hay quản lý hạ tầng, nhờ đó rất phù hợp cho các ứng dụng cần mở rộng linh hoạt theo tải công việc thay đổi.
Các tính năng chính của DynamoDB gồm:
Khả năng mở rộng
DynamoDB có thể xử lý hàng triệu yêu cầu mỗi giây, phù hợp với các ứng dụng có lưu lượng biến thiên.
Sẵn sàng cao
Được thiết kế cho tính sẵn sàng cao và độ bền dữ liệu với sao chép tích hợp trên nhiều vùng sẵn sàng.
Dịch vụ được quản lý
AWS xử lý chi phí vận hành, gồm cấp phát phần cứng, vá lỗi và sao lưu, giúp bạn tập trung xây dựng ứng dụng.
Mô hình dữ liệu linh hoạt
DynamoDB hỗ trợ cả mô hình khóa-giá trị và tài liệu, cho phép bạn linh hoạt trong cách cấu trúc dữ liệu.
Bảo mật
Tích hợp AWS Identity and Access Management (IAM) cho phép kiểm soát truy cập an toàn, chi tiết đến cấp mục và thuộc tính đối với tài nguyên cơ sở dữ liệu của bạn.
Tiết kiệm chi phí
Kiến trúc serverless của DynamoDB kết hợp khả năng tự động mở rộng cho phép bạn tối ưu chi phí bằng cách chỉ trả tiền cho tài nguyên sử dụng. Không có chi phí phần cứng trả trước hay cam kết dài hạn, là lựa chọn tiết kiệm cho cả startup và doanh nghiệp.
Kiểu dữ liệu
Các kiểu dữ liệu được hỗ trợ trong DynamoDB:
- Kiểu vô hướng: Bao gồm chuỗi, số, nhị phân, boolean và giá trị null.
- Kiểu tài liệu: DynamoDB hỗ trợ cấu trúc phức tạp với thuộc tính lồng nhau, lý tưởng để xử lý dữ liệu JSON.
- Kiểu tập hợp: Tập hợp chuỗi, số và nhị phân cho phép bạn lưu trữ hiệu quả các nhóm giá trị liên quan.
Vì sao dùng DynamoDB với Node.js?
Node.js là môi trường runtime phổ biến để xây dựng ứng dụng phía máy chủ, gồm web server và API. Kiến trúc không chặn, hướng sự kiện của Node.js rất ăn khớp với API bất đồng bộ của DynamoDB, trở thành lựa chọn tự nhiên cho nhà phát triển Node.js.
Trong hướng dẫn này, chúng ta sẽ đề cập các chủ đề sau:
1. Tạo bảng và định nghĩa lược đồ trong DynamoDB.
2. Thực hiện các thao tác CRUD (Tạo, Đọc, Cập nhật, Xóa) cơ bản bằng AWS SDK cho Node.js.
3. Truy vấn nâng cao với tuân thủ ACID.
Kết thúc hướng dẫn, bạn sẽ nắm vững Amazon DynamoDB và cách khai thác sức mạnh của nó trong ứng dụng Node.js của mình. Hãy cùng bắt đầu và khai mở tiềm năng của cơ sở dữ liệu NoSQL linh hoạt này!
Chuẩn bị
Trước khi bắt đầu, bạn sẽ cần một tài khoản AWS. Chúng ta có thể làm tất cả mà không cần tài khoản AWS, nhưng để ví dụ thực tế hơn, chúng ta sẽ dùng terraform để tạo hạ tầng trong AWS. Để biết thêm cách làm việc với các dịch vụ AWS cục bộ bằng Docker, tôi có một bản demo localstack và repository github bạn có thể tham khảo và thử nghiệm.
Bây giờ cũng là lúc cài đặt terraform nếu bạn chưa có.
Phần còn lại của hướng dẫn giả định bạn đã thiết lập AWS CLI với thông tin xác thực và tệp cấu hình, và đã cài terraform.
Bắt đầu
Trong hướng dẫn này chúng ta sẽ dùng typescript và yarn. Chúng ta sẽ bắt đầu đơn giản với ts-node và ở bài tiếp theo sẽ chuyển sang serverless và mở rộng bằng AWS Lambda.
Để thiết lập dự án demo, tạo một thư mục mới rồi thêm các phụ thuộc và cấu hình sau bằng cách chạy:
yarn init
yarn add --dev typescript ts-node @types/node @types/ramda @types/uuid
yarn add @aws-sdk/client-dynamodb ramda uuid
npx tsc --init
mkdir src src/domain infra
touch ./src/index.ts ./src/client.ts ./infra/main.tf ./src/domain/student.ts
Tiếp theo thêm phần scripts sau vào package.json
  "scripts": {
    "dev": "ts-node src/index.ts"
  },
main.tf
provider "aws" {
  region = "eu-west-1"
}


resource "aws_dynamodb_table" "demo-table" {
  name = "demo-table"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }
}
Từ dòng lệnh, cd vào thư mục infra và chạy terraform init && terraform apply -auto-approve rồi vào bảng điều khiển AWS để xem bảng DynamoDB của bạn:
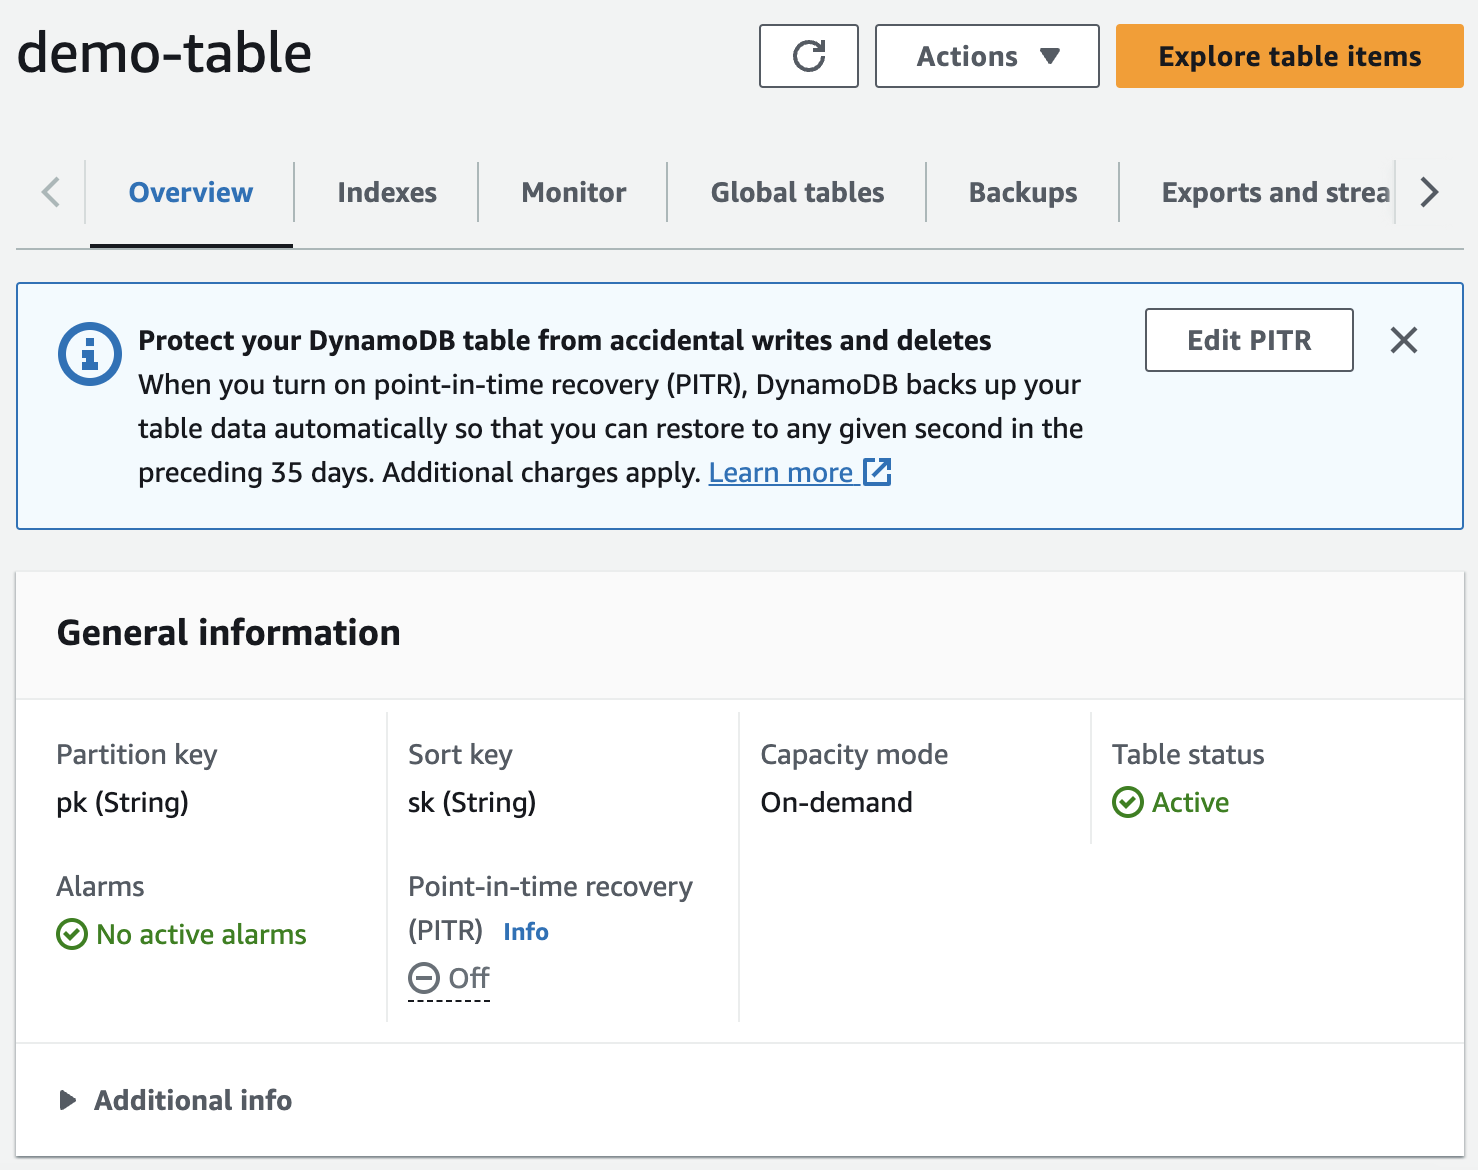
Tôi sẽ đề cập chế độ tính phí của DynamoDB, WCU, RCU trong một bài riêng
client.ts
import { DynamoDB } from "@aws-sdk/client-dynamodb";


export const TABLE_NAME = "demo-table";
export const REGION = "eu-west-1";
export const dynamoClient = new DynamoDB({ region: REGION });


export const STUDENT_PREFIX = "student#";
Mô hình dữ liệu
Trước khi đi tiếp, hãy định nghĩa một mô hình dữ liệu dùng trong phạm vi hướng dẫn này. Để giữ đúng ngữ cảnh, tôi chọn mô phỏng thứ gì đó gần với các tính năng cốt lõi của DataCamp.
Hướng dẫn này sẽ không bao quát tất cả thực thể. Tôi sẽ mở rộng mô hình này trong các bài tiếp theo.
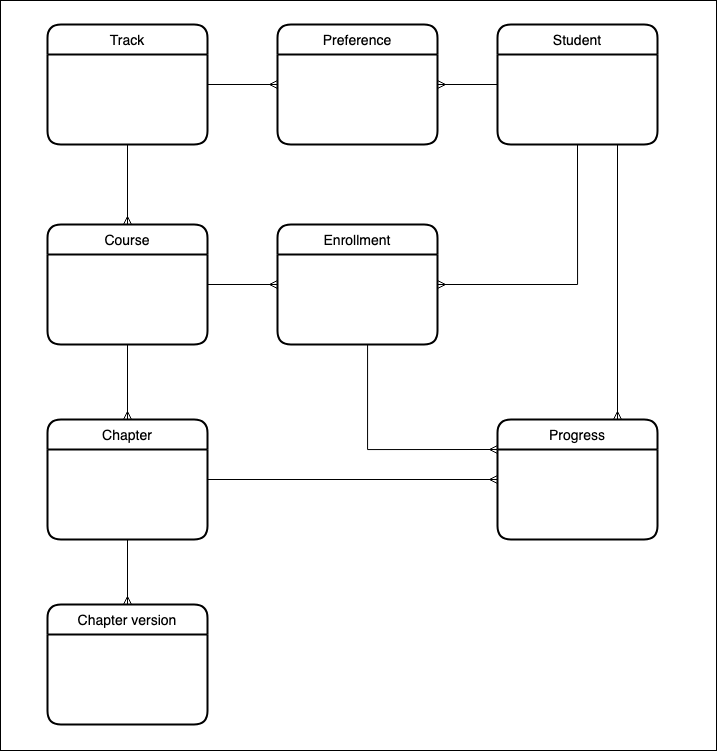
Thao tác CRUD với DynamoDB
Để hiểu đầy đủ cách thiết kế và mô hình hóa dữ liệu với DynamoDB, xem hướng dẫn về thiết kế một bảng với DynamoDB của tôi. Trong phạm vi bài này, tôi sẽ giữ phần giải thích về cách DynamoDB hoạt động ở mức tối thiểu. Điều quan trọng cần nhớ là DynamoDB dùng khóa phân vùng và khóa sắp xếp để quản lý dữ liệu hiệu quả.
Khóa phân vùng
Khóa phân vùng dùng để phân phối dữ liệu trên nhiều máy chủ lưu trữ. Việc chọn khóa phân vùng giúp phân phối dữ liệu đồng đều rất quan trọng để tránh "phân vùng nóng" (phân phối dữ liệu không đều) có thể dẫn đến vấn đề hiệu năng.
Các lựa chọn phổ biến cho khóa phân vùng giúp phân phối dữ liệu đều gồm các thuộc tính có độ phân biệt cao như:
- ID duy nhất
- ID người dùng
- Giá trị băm (hash)
- Khu vực địa lý
- Khóa theo thời gian
- Khóa tổng hợp (composite)
Việc chọn khóa phân vùng phụ thuộc nhiều vào mô hình dữ liệu và mẫu truy cập của ứng dụng.
Khóa sắp xếp
Khóa sắp xếp là tùy chọn và cho phép bạn tổ chức dữ liệu trong một phân vùng. Dùng khóa sắp xếp để truy vấn và sắp xếp dữ liệu hiệu quả trong một phân vùng.
Khóa tổng hợp
Khóa tổng hợp gồm cả khóa phân vùng và khóa sắp xếp. Chúng cho phép bạn tạo mẫu truy vấn phong phú như lọc theo khoảng, thời gian hoặc thuộc tính khác. Dùng khóa tổng hợp khi mẫu truy cập dữ liệu của bạn cần truy vấn phức tạp.
Phân vùng nóng
Để giảm phân vùng nóng, xem xét các chiến lược như sharding (dùng tiền tố ngẫu nhiên cho khóa phân vùng), phân vùng theo thời gian hoặc phân phối ghi đồng đều. Giám sát và dùng AWS Auto Scaling để điều chỉnh năng lực động.
student.ts
Chúng ta sẽ giữ mọi thứ đơn giản và dùng ID sinh viên làm cả khóa phân vùng và khóa sắp xếp. Nghe có vẻ lạ, nhưng chúng ta cần giữ lược đồ linh hoạt và sẵn sàng hỗ trợ nhiều mối quan hệ dữ liệu và mẫu truy cập khác nhau. Tôi sẽ mở rộng mô hình này trong các bài DynamoDB tiếp theo.
import { head, omit, pathOr } from "ramda";
import { STUDENT_PREFIX, TABLE_NAME, dynamoClient as client } from "../client";
import { v4 as uuidv4 } from "uuid";
import {
  addPrefix,
  attributeMapToValues,
  attributeValueToValue,
  removePrefix,
  valueToAttributeValue,
} from "../utils";


const entityType = "student";


export const dynamoRecordToStudent = (record: any) => {
  const { pk, ...data } = record;


  return omit(["sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
  });
};


export const getStudentById = (id: string) =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
  })
  .then(({ Item }) => (Item ? dynamoRecordToStudent(Item) : undefined));


export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      email: valueToAttributeValue(_email),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
utils.ts
Bản SDK DynamoDB mới nhất từ AWS tăng độ an toàn kiểu cho các mục lưu trong cơ sở dữ liệu nhưng vì thế việc thao tác trở nên khó hơn chút. Để giảm bớt, hãy tạo một số hàm trợ giúp. Lý do cần chúng sẽ rõ hơn khi ta xem DynamoDB lưu dữ liệu nội bộ như thế nào.
Tạo tệp mới trong thư mục gốc của src tên là utils.ts.
import { AttributeValue } from "@aws-sdk/client-dynamodb";


export const valueToAttributeValue = <T>(value: T): AttributeValue => {
  switch (typeof value) {
    case "string":
      return { S: value };
    case "number":
      return { N: `${value}` };
    case "boolean":
      return { BOOL: value };
    case "object":
      if (Array.isArray(value)) {
        return { L: value.map((item) => valueToAttributeValue(item)) };
      }
      return {
        M: Object.entries(value as any).reduce(
          (acc, [key, item]) => ({
            ...acc,
            [key]: valueToAttributeValue(item),
          }),
          {}
        ),
      };
    default:
      throw new Error(`Unknown type ${typeof value}`);
  }
};


export const attributeValueToValue = <T>(value: AttributeValue): T => {
  switch (true) {
    case !!value.S:
      return value.S as T;
    case !!value.N:
      return Number(value.N) as T;
    case !!value.BOOL:
      return value.BOOL as T;
    case !!value.L:
      return value.L?.map((item) =>
        attributeValueToValue(item)
      ) as unknown as T;
    case !!value.M:
      return Object.entries(value.M || []).reduce(
        (acc, [key, item]) => ({ ...acc, [key]: attributeValueToValue(item) }),
        {}
      ) as unknown as T;
    default:
      throw new Error(`Unknown type ${JSON.stringify(value)}`);
  }
};


export const attributeMapToValues = (
  items: Record<string, AttributeValue>
): unknown[] =>
  Object.keys(items).reduce(
    (acc, key) => ({
      ...acc,
      [key]: attributeValueToValue(items[key]),
    }),
    []
  );


export const removePrefix = (id: string, prefix: string): string =>
  id.replace(prefix, "");


export const addPrefix = (id: string, prefix: string): string =>
  `${prefix}${removePrefix(id, prefix)}`;
Tạo sinh viên mới
Cuối cùng chúng ta đã sẵn sàng gửi các lệnh API CRUD tới DynamoDB!
Mở tệp index.ts và dán đoạn mã sau rồi từ dòng lệnh chạy yarn dev.
import { getStudentById, saveStudent } from "./domain/student";


Promise.resolve()
  .then(async () => {
    const id = await saveStudent({
      firstName: "John",
      lastName: "Smith",
      email: "john@datacamp.com",
    });


    const john = await getStudentById(id);


    console.log(john);
  })
  .catch((err) => {
    console.error(err);
    process.exit(1);
  })
  .then(() => {
    console.log("done");
    process.exit(0);
  });
Bạn sẽ thấy kết quả tương tự như sau:
{
  "entityType": "student",
  "id": "dd4c2ee4-9422-4957-ae6f-f9fff748e5ab",
  "firstName": "John",
  "lastName": "Smith",
  "email": "john@datacamp.com",
  "xp": 0
}
Giờ hãy dùng CLI để quét DynamoDB bằng cách chạy:
aws dynamodb scan --table-name demo-table --no-cli-pager
Bạn có thể thấy từ đầu ra cách DynamoDB lưu trữ và gán kiểu dữ liệu nội bộ, trong đó N chỉ kiểu số và S chỉ kiểu chuỗi, điều này sẽ làm rõ các câu hỏi bạn có thể băn khoăn về mã trong utils.ts.
{
  "Items": [
    {
      "entityType": {
        "S": "student"
      },
      "lastName": {
        "S": "Smith"
      },
      "email": {
        "S": "john@datacamp.com"
      },
      "xp": {
        "N": "0"
      },
      "sk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "pk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "firstName": {
        "S": "John"
      }
    }
  ],
  "Count": 1,
  "ScannedCount": 1,
  "ConsumedCapacity": null
}
Lấy sinh viên theo địa chỉ email
Nếu chúng ta chỉ có địa chỉ email của sinh viên để tìm bản ghi thì sao? Ta có thể hỗ trợ mẫu truy cập này bằng cách thêm chỉ mục thứ cấp toàn cục.
Đầu tiên, chúng ta cần xóa bảng ban đầu (chúng ta sẽ bỏ qua bước này cho các thay đổi terraform sau bằng cách thêm hàm truncate bảng):
terraform destroy
Tiếp theo, cập nhật terraform bằng cách thêm GSI sau vào demo-table:
attribute {
  name = "gsi1_pk"
  type = "S"
}


attribute {
  name = "gsi1_sk"
  type = "S"
}


global_secondary_index {
  name = "gsi1"
  hash_key = "gsi1_pk"
  range_key = "gsi1_sk"
  projection_type = "ALL"
}
Áp dụng thay đổi này với:
terraform apply -auto-approve
Tiếp theo ta cần chỉnh nhẹ cách lưu sinh viên:
export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      gsi1_pk: valueToAttributeValue(_email),
      gsi1_sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
Lưu ý chúng ta không còn lưu email một cách tường minh, mà dùng nó làm giá trị PK của GSI.
Chúng ta cần chỉnh nhẹ cách chuyển đổi dữ liệu sinh viên từ DynamoDB:
export const dynamoRecordToStudent = (record: any) => {
  const { pk, gsi1_pk, ...data } = record;


  return omit(["sk", "gsi1_sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
    email: attributeValueToValue<string>(gsi1_pk),
  });
};
Cuối cùng, ta có thể truy vấn bằng GSI gsi1 vừa tạo để lấy bản ghi sinh viên theo email:
export const getStudentByEmail = (email: string) =>
  client
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
      ExpressionAttributeNames: {
        "#gsi1_pk": "gsi1_pk",
      },
      ExpressionAttributeValues: {
        ":gsi1_pk": {
          S: email.toLocaleLowerCase(),
        },
      },
    })
    .then((res) => head(pathOr([], ["Items"], res).map(dynamoRecordToStudent)));
Cập nhật sinh viên
Để cập nhật một sinh viên, chúng ta cần dùng phương thức update và cung cấp cả khóa phân vùng và khóa sắp xếp để định danh duy nhất mục cần cập nhật.
export const updateStudent = async ({
  id,
  firstName,
  lastName,
  email,
}: {
  id: string;
  firstName?: string;
  lastName?: string;
  email?: string;
}) => {
  const updateExpressionParts = [];
  const ExpressionAttributeValues: Record<string, any> = {};


  if (firstName !== undefined) {
    updateExpressionParts.push("#firstName = :firstName");
    ExpressionAttributeValues[":firstName"] = valueToAttributeValue(firstName);
  }


  if (lastName !== undefined) {
    updateExpressionParts.push("#lastName = :lastName");
    ExpressionAttributeValues[":lastName"] = valueToAttributeValue(lastName);
  }


  if (email !== undefined) {
    updateExpressionParts.push("#gsi1_pk = :gsi1_pk");
    ExpressionAttributeValues[":gsi1_pk"] = valueToAttributeValue(email);
  }


  const UpdateExpression = `SET ${updateExpressionParts.join(", ")}`;


  const ExpressionAttributeNames = {
    ...(firstName && { "#firstName": "firstName" }),
    ...(lastName && { "#lastName": "lastName" }),
    ...(email && { "#gsi1_pk": "gsi1_pk" }),
  };


  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression,
    ExpressionAttributeNames,
    ExpressionAttributeValues,
  });
};
Xóa dữ liệu
Trước hết, cần lưu ý rằng việc truncate một bảng trong DynamoDB không được hỗ trợ gốc ngoại trừ xóa toàn bộ bảng rồi tạo lại (như chúng ta đã làm để thêm GSI mới). Tôi sẽ thêm một phương thức truncate vào client.ts nhưng cần nhấn mạnh đây chỉ để kiểm thử và không nên dùng trong sản xuất. Lý do là để biết cần xóa gì, ta phải quét toàn bộ bảng, và mỗi thao tác trong DynamoDB đều tốn chi phí, nên nếu bạn có bảng với hàng triệu mục, sẽ rẻ hơn nếu xóa bảng và tạo lại (kèm quy trình di trú dữ liệu để không mất dữ liệu sản xuất). Đây là hàm truncate:
type AttributeMap = Record<string, AttributeValue>;


const getItemKeyAndValue = (item: AttributeMap, key?: string) =>
  key ? { [`${key}`]: item[`${key}`] } : {};


export const truncateTable = async (
  client: DynamoDB,
  TableName: string,
  hash: string,
  range?: string
): Promise<void> => {
  const { Items } = await client.scan({ TableName });
  if (!Items) {
    return;
  }
  const keys = Items.map((item: AttributeMap) => ({
    ...getItemKeyAndValue(item, hash),
    ...getItemKeyAndValue(item, range),
  }));
  if (!keys.length) {
    return;
  }
  await Promise.all(keys?.map((Key) => client.deleteItem({ TableName, Key })));
};
Để truncate demo-table:
await truncateTable(dynamoClient, TABLE_NAME, "pk", "sk");
Để xóa một sinh viên cụ thể, thực tế ta không nên dùng phương thức deleteItem từ SDK. Cơ sở dữ liệu NoSQL không có khái niệm toàn vẹn tham chiếu; nếu có mục khác tham chiếu đến một sinh viên không còn tồn tại, đó sẽ là vấn đề, và DynamoDB vẫn sẽ xóa mục theo yêu cầu mà không có lưới an toàn đảm bảo không có khóa ngoại như cơ sở dữ liệu quan hệ (và vì thế sẽ lỗi thao tác xóa).
Để an toàn, chúng ta sẽ triển khai xóa mềm và chỉnh nhẹ hai hàm đọc.
export const deleteStudent = async (id: string) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "SET #deleted = :deleted",
    ExpressionAttributeNames: {
      "#deleted": "deleted",
    },
    ExpressionAttributeValues: {
      ":deleted": valueToAttributeValue(true),
    },
  });
};
Truy vấn cho getStudentByEmail giờ nên lọc bỏ các bản ghi đã xóa. Lưu ý việc “lọc” này diễn ra phía client chứ không phải ở cơ sở dữ liệu, nghĩa là truy vấn này vẫn tốn chi phí như khi truy xuất các bản ghi đã xóa.
{
  TableName: TABLE_NAME,
  IndexName: "gsi1",
  KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
  ExpressionAttributeNames: {
    "#gsi1_pk": "gsi1_pk",
  },
  ExpressionAttributeValues: {
    ":gsi1_pk": {
      S: email.toLocaleLowerCase(),
    },
    ":notDeleted": {
      BOOL: false,
    },
  },
  FilterExpression:
    "attribute_not_exists(deleted) OR deleted = :notDeleted",
 }
Hàm getStudentById dùng getItem, nên chúng ta không thể áp dụng biểu thức lọc; thay vào đó sẽ viết logic tường minh:
export const getStudentById = (id: string): Promise<Student | null> =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
        pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
        sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      },
    })
    .then(({ Item }) => {
      if (!Item) {
        return null;
      }
      const _item = dynamoRecordToStudent(Item);
      return _item.deleted ? null : _item;
    });
Cập nhật nguyên tử với tuân thủ ACID
DataCamp thu thập dữ liệu XP cho từng sinh viên nhằm tạo động lực, cảm giác thành tựu, cách dễ dàng theo dõi tiến độ tổng thể và phương tiện để sinh viên tự so sánh với bạn bè. Trong cơ sở dữ liệu quan hệ, chúng ta có nhiều công cụ để thao tác và tổng hợp dữ liệu, nhưng điều này không đúng với cơ sở dữ liệu NoSQL. Dù một số CSDL NoSQL như MongoDB có khung tổng hợp, các công cụ này thường kém hiệu quả khi cơ sở dữ liệu đạt quy mô lớn, và lý do chọn NoSQL thường chính là để hỗ trợ khối lượng dữ liệu và lưu lượng rất lớn.
Trong DynamoDB, cập nhật nguyên tử đề cập khả năng thực hiện một số thao tác cập nhật trên một thuộc tính đơn lẻ của một mục theo cách đảm bảo tính nguyên tử, nhất quán, cô lập và bền vững (thuộc tính ACID). Cập nhật nguyên tử là các thao tác chỉnh sửa giá trị của một thuộc tính cụ thể theo cách đảm bảo thành công ngay cả khi có cập nhật đồng thời.
Dùng kỹ thuật này, chúng ta có thể dễ dàng cộng XP khi người dùng hoàn thành mục tiêu học tập.
export const updateStudentXp = async ({
  id,
  xp,
}: {
  id: string;
  xp: number;
}) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "set xp = xp + :inc",
    ExpressionAttributeValues: {
      ":inc": valueToAttributeValue(xp),
    },
  });
};
Nếu đoạn mã này trông quen thuộc, đó là vì chúng ta đã dùng mẫu này cho hàm deleteStudent!
Kết luận
Trong hướng dẫn này, chúng ta đã khám phá các nguyên lý cơ bản của Amazon DynamoDB, một cơ sở dữ liệu serverless có khả năng mở rộng cao do AWS cung cấp. Các tính năng chủ chốt của DynamoDB như khả năng mở rộng liền mạch, sẵn sàng cao và mô hình dữ liệu linh hoạt khiến nó trở thành lựa chọn tuyệt vời cho các ứng dụng hiện đại.
Chúng ta đã đề cập các chủ đề thiết yếu như tạo bảng, thực hiện thao tác CRUD bằng Node.js và bàn về tầm quan trọng của cập nhật nguyên tử để duy trì tính nhất quán dữ liệu. Xuyên suốt hướng dẫn, chúng ta đã xây dựng mô hình dữ liệu và triển khai các hàm tương tác với DynamoDB.
Khi tiếp tục hành trình với DynamoDB, hãy cân nhắc tìm hiểu sâu các chủ đề nâng cao như thiết kế một bảng, tối ưu hiệu năng và DynamoDB Streams cho xử lý dữ liệu thời gian thực. Tính linh hoạt và khả năng mở rộng của DynamoDB giúp bạn xây dựng các ứng dụng serverless hiệu năng cao trong hệ sinh thái AWS.
Bạn có thể tìm toàn bộ mã nguồn của hướng dẫn này trên Github. Chúc bạn viết code vui vẻ!
Tài liệu học thêm
- Hướng dẫn DataCamp: Thiết kế một bảng với DynamoDB
- Khóa học DataCamp: Các khái niệm NoSQL
- AWS re:Invent: Mẫu thiết kế nâng cao cho DynamoDB
- Rick Houlihan: Những điều căn bản của thiết kế một bảng DynamoDB
- Alex DeBrie: Sách DynamoDB