Nel mondo guidato dai dati di oggi, la necessità di database scalabili, ad alte prestazioni e ad alta disponibilità è più grande che mai. Amazon DynamoDB, un archivio chiave-valore wide-column completamente gestito e serverless fornito da AWS (Amazon Web Services), è progettato per soddisfare queste esigenze. Che tu stia creando un'applicazione web, un'app mobile o qualsiasi sistema che richieda uno storage flessibile e affidabile, DynamoDB fa al caso tuo.
Questo tutorial ha l'obiettivo di introdurti nel mondo di Amazon DynamoDB e mostrarti come usarlo in modo efficace nelle applicazioni Node.js. Che tu sia un principiante alle prese con i database NoSQL o uno sviluppatore esperto che vuole ampliare le proprie competenze, questa guida ti accompagnerà attraverso gli aspetti essenziali e ti fornirà esempi pratici per iniziare.
Che cos'è DynamoDB?
Amazon DynamoDB è un database serverless, key-value e documentale che offre scalabilità trasparente e prestazioni a bassa latenza. A differenza dei database relazionali tradizionali, DynamoDB non richiede il provisioning dell'hardware o la gestione dell'infrastruttura, rendendolo una scelta ideale per applicazioni che devono scalare dinamicamente in base al carico di lavoro.
Le caratteristiche principali di DynamoDB includono:
Scalabilità
DynamoDB può gestire milioni di richieste al secondo, risultando adatto per applicazioni con livelli di traffico variabili.
Alta disponibilità
Progettato per alta disponibilità e durabilità dei dati, con replica integrata su più zone di disponibilità.
Servizio gestito
AWS si occupa del carico operativo, inclusi provisioning dell'hardware, patch e backup, permettendoti di concentrarti sulla costruzione della tua applicazione.
Modello dati flessibile
DynamoDB supporta sia modelli dati key-value sia documentali, offrendo flessibilità nel modo in cui strutturi i tuoi dati.
Sicurezza
L'integrazione con AWS Identity and Access Management (IAM) consente un controllo degli accessi sicuro e granulare alle risorse del database a livello di item e attributo.
Risparmio sui costi
L'architettura serverless di DynamoDB, unita alle sue capacità di scaling automatico, ti permette di ottimizzare i costi pagando solo per le risorse che consumi. Non ci sono costi hardware iniziali o impegni a lungo termine, rendendolo una scelta conveniente sia per startup sia per grandi aziende.
Tipi di dati
Tipi di dati supportati in DynamoDB:
- Tipi scalari: includono stringhe, numeri, binari, booleani e valori null.
- Tipi documento: DynamoDB gestisce strutture complesse con attributi annidati, perfette per trattare dati JSON.
- Tipi set: set di stringhe, set di numeri e set binari ti permettono di memorizzare in modo efficiente collezioni di valori correlati.
Perché usare DynamoDB con Node.js?
Node.js è un runtime popolare per creare applicazioni lato server, inclusi web server e API. La sua architettura non bloccante ed event-driven si abbina bene all'API asincrona di DynamoDB, rendendolo una scelta naturale per gli sviluppatori Node.js.
In questo tutorial tratteremo i seguenti argomenti:
1. Creazione di tabelle e definizione di uno schema in DynamoDB.
2. Esecuzione di operazioni CRUD (Create, Read, Update, Delete) di base usando l'AWS SDK per Node.js.
3. Query avanzate con conformità ACID.
Alla fine di questo tutorial avrai una solida comprensione di Amazon DynamoDB e di come sfruttarne la potenza nelle tue applicazioni Node.js. Quindi, tuffiamoci e sblocchiamo il potenziale di questo versatile database NoSQL!
Preparazione
Prima di iniziare, ti servirà un account AWS. Potremmo fare tutto questo senza un account AWS, ma per un esempio più realistico useremo terraform per creare la nostra infrastruttura su AWS. Per maggiori informazioni su come lavorare con i servizi AWS in locale usando Docker ho un esempio demo localstack repository GitHub a cui puoi fare riferimento e con cui sperimentare.
Ora è anche il momento di installare terraform se non lo hai già.
Il resto di questo tutorial presume che tu abbia configurato l'AWS CLI con le tue credenziali e i file di configurazione, e che tu abbia installato terraform.
Primi passi
Per questo tutorial useremo TypeScript e Yarn. Partiremo in modo semplice usando ts-node e poi, nel prossimo tutorial, passeremo al serverless ampliando il tutto con AWS Lambda.
Per configurare il nostro progetto demo, crea una nuova cartella e aggiungi le seguenti dipendenze ed esegui il setup con:
yarn init
yarn add --dev typescript ts-node @types/node @types/ramda @types/uuid
yarn add @aws-sdk/client-dynamodb ramda uuid
npx tsc --init
mkdir src src/domain infra
touch ./src/index.ts ./src/client.ts ./infra/main.tf ./src/domain/student.ts
Poi aggiungi la seguente sezione scripts a package.json
  "scripts": {
    "dev": "ts-node src/index.ts"
  },
main.tf
provider "aws" {
  region = "eu-west-1"
}


resource "aws_dynamodb_table" "demo-table" {
  name = "demo-table"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }
}
Da riga di comando entra nella directory infra ed esegui terraform init && terraform apply -auto-approve e poi vai nella console AWS per vedere la tua tabella DynamoDB:
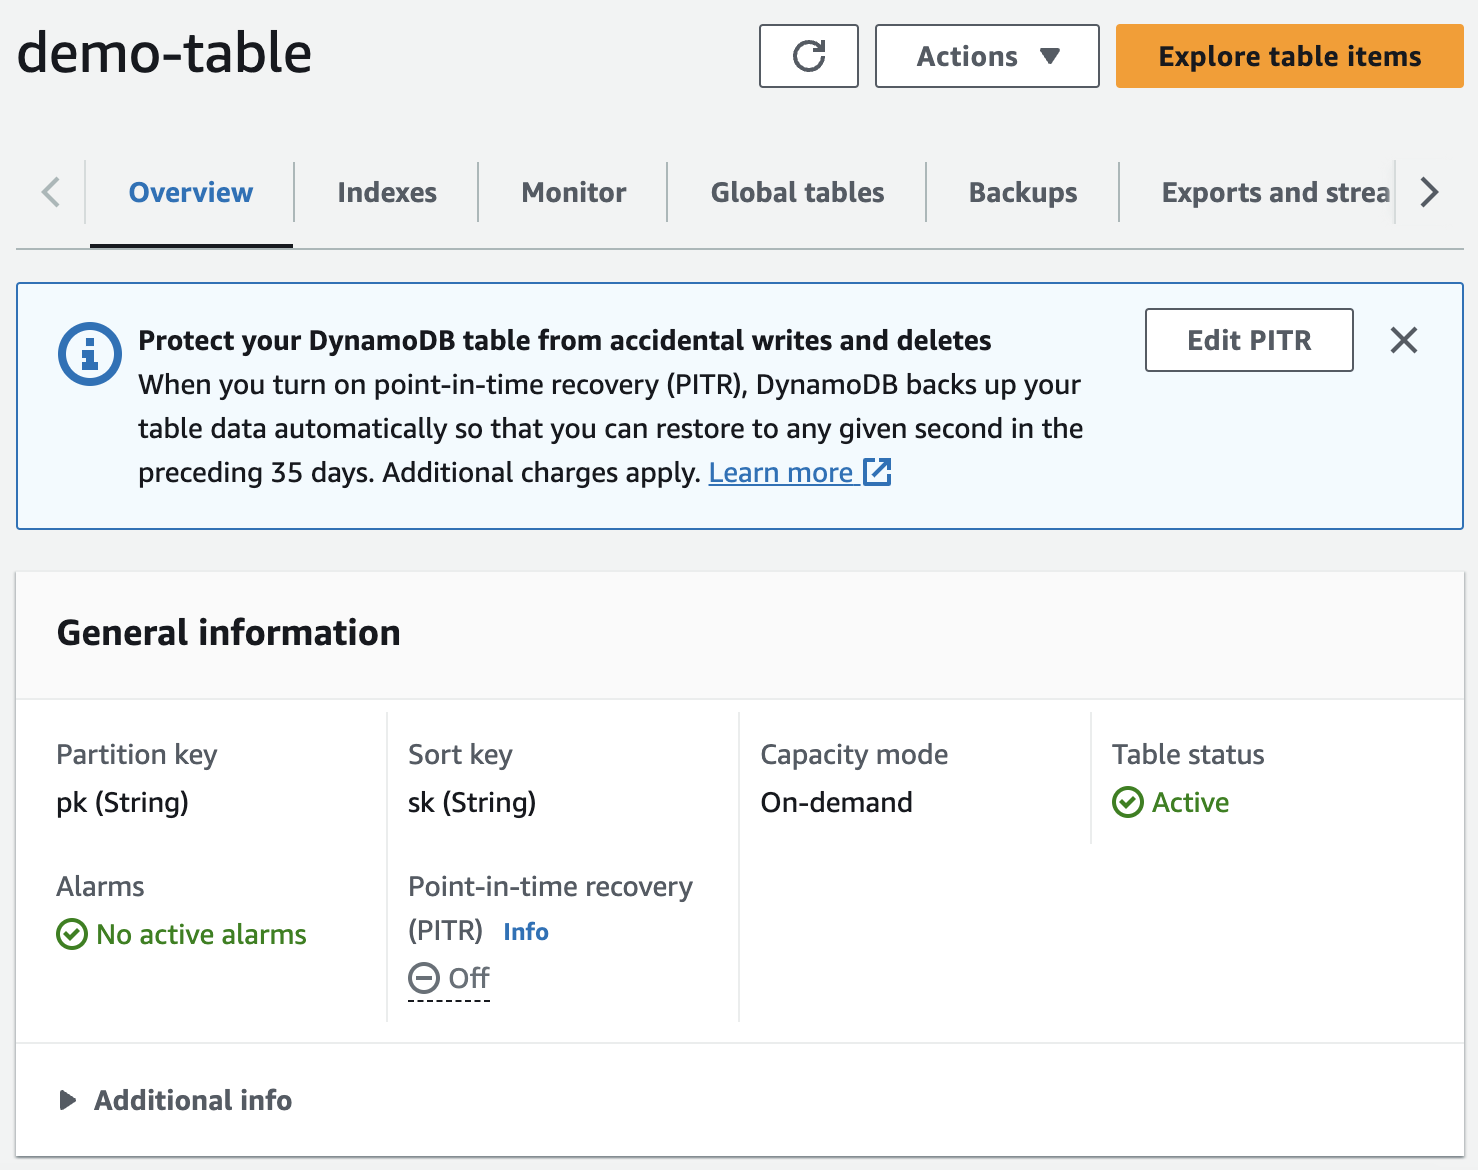
Tratterò le modalità di fatturazione DynamoDB, WCU e RCU in un articolo separato
client.ts
import { DynamoDB } from "@aws-sdk/client-dynamodb";


export const TABLE_NAME = "demo-table";
export const REGION = "eu-west-1";
export const dynamoClient = new DynamoDB({ region: REGION });


export const STUDENT_PREFIX = "student#";
Modello dati
Prima di procedere oltre, definiamo un modello dati che possiamo usare nell'ambito di questo tutorial. Per restare nel contesto ho scelto di modellare qualcosa vicino alle funzionalità core di DataCamp.
Questo tutorial non coprirà tutte le entità. Amplierò questo modello in articoli successivi.
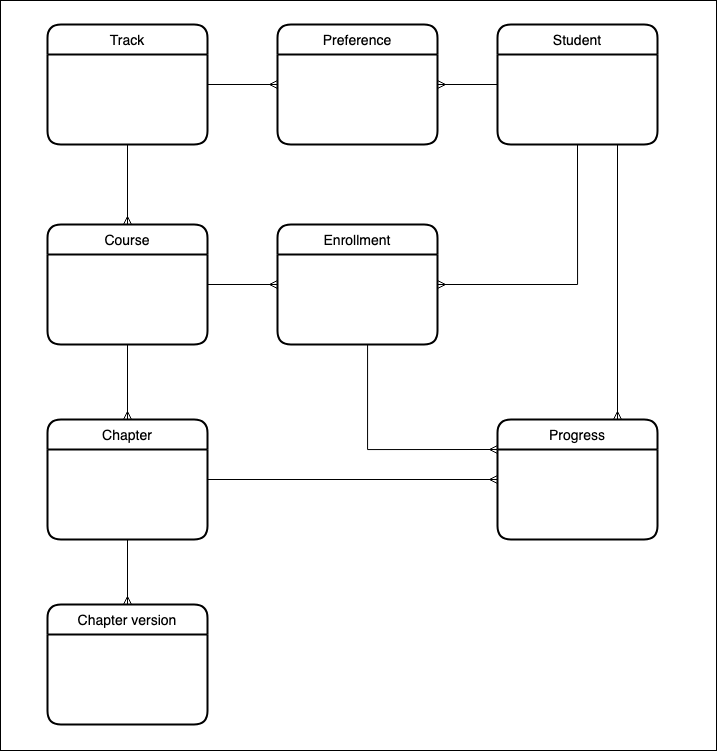
Operazioni CRUD con DynamoDB
Per comprendere appieno come progettare e modellare i dati con DynamoDB vedi il mio tutorial sul design a singola tabella con DynamoDB. In questo tutorial cercherò di ridurre al minimo la spiegazione di come funziona DynamoDB. La cosa fondamentale da ricordare è che DynamoDB usa chiavi di partizione e chiavi di ordinamento per una gestione efficiente dei dati.
Chiavi di partizione
Le chiavi di partizione vengono usate per distribuire i dati su più server di storage. È importante scegliere una chiave di partizione che distribuisca i dati in modo uniforme per evitare le "partizioni calde" (distribuzione non uniforme), che possono causare problemi di prestazioni.
Scelte comuni per le chiavi di partizione che aiutano a distribuire i dati in modo uniforme includono attributi ad alta cardinalità come:
- ID univoci
- ID utente
- valori hash
- regioni geografiche
- chiavi basate sul tempo
- chiavi composite
La scelta della chiave di partizione dipenderà molto dai pattern di accesso e dal modello dati dell'applicazione.
Chiavi di ordinamento
Le chiavi di ordinamento sono facoltative e ti permettono di organizzare i dati all'interno di una partizione. Usa le chiavi di ordinamento per query e ordinamenti efficienti dei dati nella partizione.
Chiavi composite
Le chiavi composite sono costituite sia dalla chiave di partizione sia da quella di ordinamento. Consentono di creare pattern di query ricchi, come il filtraggio per intervallo, tempo o altri attributi. Usa chiavi composite quando i tuoi pattern di accesso ai dati richiedono query complesse.
Partizioni calde
Per mitigare le partizioni calde, considera strategie come lo sharding (uso di prefissi casuali per le chiavi di partizione), il partitioning basato sul tempo o la distribuzione uniforme delle scritture. Monitora e usa AWS Auto Scaling per regolare dinamicamente la capacità.
student.ts
Terremo le cose semplici e useremo l'ID dello studente sia come chiave di partizione sia come chiave di ordinamento. Può sembrare una scelta strana ma dobbiamo mantenere lo schema flessibile e pronto a supportare varie relazioni tra dati e pattern di accesso. Amplierò questo modello in futuri articoli su DynamoDB.
import { head, omit, pathOr } from "ramda";
import { STUDENT_PREFIX, TABLE_NAME, dynamoClient as client } from "../client";
import { v4 as uuidv4 } from "uuid";
import {
  addPrefix,
  attributeMapToValues,
  attributeValueToValue,
  removePrefix,
  valueToAttributeValue,
} from "../utils";


const entityType = "student";


export const dynamoRecordToStudent = (record: any) => {
  const { pk, ...data } = record;


  return omit(["sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
  });
};


export const getStudentById = (id: string) =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
  })
  .then(({ Item }) => (Item ? dynamoRecordToStudent(Item) : undefined));


export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      email: valueToAttributeValue(_email),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
utils.ts
L'ultimo SDK DynamoDB di AWS ha aumentato la sicurezza dei tipi per gli item memorizzati nel database ma, nel farlo, ha reso il lavoro un po' più complesso. Per semplificare creiamo alcune funzioni helper. Sarà chiaro tra poco perché ci servono, quando vedremo come DynamoDB memorizza i dati internamente.
Crea un nuovo file nella root della cartella src chiamato utils.ts.
import { AttributeValue } from "@aws-sdk/client-dynamodb";


export const valueToAttributeValue = <T>(value: T): AttributeValue => {
  switch (typeof value) {
    case "string":
      return { S: value };
    case "number":
      return { N: `${value}` };
    case "boolean":
      return { BOOL: value };
    case "object":
      if (Array.isArray(value)) {
        return { L: value.map((item) => valueToAttributeValue(item)) };
      }
      return {
        M: Object.entries(value as any).reduce(
          (acc, [key, item]) => ({
            ...acc,
            [key]: valueToAttributeValue(item),
          }),
          {}
        ),
      };
    default:
      throw new Error(`Unknown type ${typeof value}`);
  }
};


export const attributeValueToValue = <T>(value: AttributeValue): T => {
  switch (true) {
    case !!value.S:
      return value.S as T;
    case !!value.N:
      return Number(value.N) as T;
    case !!value.BOOL:
      return value.BOOL as T;
    case !!value.L:
      return value.L?.map((item) =>
        attributeValueToValue(item)
      ) as unknown as T;
    case !!value.M:
      return Object.entries(value.M || []).reduce(
        (acc, [key, item]) => ({ ...acc, [key]: attributeValueToValue(item) }),
        {}
      ) as unknown as T;
    default:
      throw new Error(`Unknown type ${JSON.stringify(value)}`);
  }
};


export const attributeMapToValues = (
  items: Record<string, AttributeValue>
): unknown[] =>
  Object.keys(items).reduce(
    (acc, key) => ({
      ...acc,
      [key]: attributeValueToValue(items[key]),
    }),
    []
  );


export const removePrefix = (id: string, prefix: string): string =>
  id.replace(prefix, "");


export const addPrefix = (id: string, prefix: string): string =>
  `${prefix}${removePrefix(id, prefix)}`;
Creare un nuovo studente
Finalmente siamo pronti per iniziare a inviare chiamate API CRUD a DynamoDB!
Apri il file index.ts e incolla il seguente codice quindi, da riga di comando, esegui yarn dev.
import { getStudentById, saveStudent } from "./domain/student";


Promise.resolve()
  .then(async () => {
    const id = await saveStudent({
      firstName: "John",
      lastName: "Smith",
      email: "john@datacamp.com",
    });


    const john = await getStudentById(id);


    console.log(john);
  })
  .catch((err) => {
    console.error(err);
    process.exit(1);
  })
  .then(() => {
    console.log("done");
    process.exit(0);
  });
Dovresti vedere qualcosa di simile restituito:
{
  "entityType": "student",
  "id": "dd4c2ee4-9422-4957-ae6f-f9fff748e5ab",
  "firstName": "John",
  "lastName": "Smith",
  "email": "john@datacamp.com",
  "xp": 0
}
Ora usa la CLI per eseguire una scansione di DynamoDB eseguendo:
aws dynamodb scan --table-name demo-table --no-cli-pager
Dall'output puoi vedere come DynamoDB memorizza e tipizza internamente i dati, dove N si riferisce a un tipo numero e S a un tipo stringa, chiarendo eventuali dubbi sul codice in utils.ts.
{
  "Items": [
    {
      "entityType": {
        "S": "student"
      },
      "lastName": {
        "S": "Smith"
      },
      "email": {
        "S": "john@datacamp.com"
      },
      "xp": {
        "N": "0"
      },
      "sk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "pk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "firstName": {
        "S": "John"
      }
    }
  ],
  "Count": 1,
  "ScannedCount": 1,
  "ConsumedCapacity": null
}
Ottenere uno studente tramite indirizzo email
E se avessimo solo l'indirizzo email dello studente per trovare il nostro record? Possiamo supportare questo pattern di accesso aggiungendo un indice secondario globale.
Per prima cosa dobbiamo distruggere la tabella originale (aggireremo questo passaggio per le future modifiche terraform introducendo una funzione di troncamento della tabella):
terraform destroy
Poi aggiorna terraform aggiungendo il seguente GSI alla nostra demo-table:
attribute {
  name = "gsi1_pk"
  type = "S"
}


attribute {
  name = "gsi1_sk"
  type = "S"
}


global_secondary_index {
  name = "gsi1"
  hash_key = "gsi1_pk"
  range_key = "gsi1_sk"
  projection_type = "ALL"
}
Applica questa modifica con:
terraform apply -auto-approve
Poi dobbiamo apportare una piccola modifica a come salviamo uno studente:
export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      gsi1_pk: valueToAttributeValue(_email),
      gsi1_sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
Nota come non memorizziamo più esplicitamente l'email, usandola invece come valore di PK del nostro GSI.
Dobbiamo fare un piccolo aggiustamento a come trasformiamo i dati dello studente in DynamoDB:
export const dynamoRecordToStudent = (record: any) => {
  const { pk, gsi1_pk, ...data } = record;


  return omit(["sk", "gsi1_sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
    email: attributeValueToValue<string>(gsi1_pk),
  });
};
Infine, possiamo effettuare query usando il nuovo GSI gsi1 per ottenere un record studente tramite indirizzo email:
export const getStudentByEmail = (email: string) =>
  client
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
      ExpressionAttributeNames: {
        "#gsi1_pk": "gsi1_pk",
      },
      ExpressionAttributeValues: {
        ":gsi1_pk": {
          S: email.toLocaleLowerCase(),
        },
      },
    })
    .then((res) => head(pathOr([], ["Items"], res).map(dynamoRecordToStudent)));
Aggiornare uno studente
Per aggiornare uno studente dobbiamo usare il metodo update e fornire sia la chiave di partizione sia la chiave di ordinamento per identificare in modo univoco l'item che vogliamo aggiornare.
export const updateStudent = async ({
  id,
  firstName,
  lastName,
  email,
}: {
  id: string;
  firstName?: string;
  lastName?: string;
  email?: string;
}) => {
  const updateExpressionParts = [];
  const ExpressionAttributeValues: Record<string, any> = {};


  if (firstName !== undefined) {
    updateExpressionParts.push("#firstName = :firstName");
    ExpressionAttributeValues[":firstName"] = valueToAttributeValue(firstName);
  }


  if (lastName !== undefined) {
    updateExpressionParts.push("#lastName = :lastName");
    ExpressionAttributeValues[":lastName"] = valueToAttributeValue(lastName);
  }


  if (email !== undefined) {
    updateExpressionParts.push("#gsi1_pk = :gsi1_pk");
    ExpressionAttributeValues[":gsi1_pk"] = valueToAttributeValue(email);
  }


  const UpdateExpression = `SET ${updateExpressionParts.join(", ")}`;


  const ExpressionAttributeNames = {
    ...(firstName && { "#firstName": "firstName" }),
    ...(lastName && { "#lastName": "lastName" }),
    ...(email && { "#gsi1_pk": "gsi1_pk" }),
  };


  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression,
    ExpressionAttributeNames,
    ExpressionAttributeValues,
  });
};
Eliminazione dei dati
Partiamo dal fatto che troncare una tabella in DynamoDB non è supportato nativamente se non eliminando l'intera tabella e poi ricreandola (come abbiamo dovuto fare in precedenza per introdurre un nuovo GSI). Aggiungerò un metodo di troncamento al nostro client.ts ma voglio sottolineare che è solo per scopi di test e non va usato in produzione. Il motivo è che, per sapere cosa eliminare, dobbiamo scansionare l'intera tabella e ogni operazione in DynamoDB comporta dei costi, quindi se hai una tabella con un milione di item, ti conviene semplicemente rimuovere quella tabella e ricominciare (con qualche tipo di processo di migrazione dei dati per non perdere dati di produzione). Ecco la nostra funzione di troncamento:
type AttributeMap = Record<string, AttributeValue>;


const getItemKeyAndValue = (item: AttributeMap, key?: string) =>
  key ? { [`${key}`]: item[`${key}`] } : {};


export const truncateTable = async (
  client: DynamoDB,
  TableName: string,
  hash: string,
  range?: string
): Promise<void> => {
  const { Items } = await client.scan({ TableName });
  if (!Items) {
    return;
  }
  const keys = Items.map((item: AttributeMap) => ({
    ...getItemKeyAndValue(item, hash),
    ...getItemKeyAndValue(item, range),
  }));
  if (!keys.length) {
    return;
  }
  await Promise.all(keys?.map((Key) => client.deleteItem({ TableName, Key })));
};
Per troncare la demo-table:
await truncateTable(dynamoClient, TABLE_NAME, "pk", "sk");
Per eliminare uno studente specifico in realtà non vorremmo usare il metodo deleteItem dell'SDK. I database NoSQL non hanno il concetto di integrità referenziale e, se avessimo altri item nel database che fanno riferimento a uno studente non più esistente, sarebbe un problema: DynamoDB eliminerà volentieri qualsiasi item che gli indichiamo senza la rete di sicurezza che assicura l'assenza di riferimenti esterni come farebbe un database relazionale (che in quel caso genererebbe un errore per l'operazione di delete).
Per andare sul sicuro implementeremo una soft delete e apporteremo una piccola modifica alle nostre due funzioni di lettura.
export const deleteStudent = async (id: string) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "SET #deleted = :deleted",
    ExpressionAttributeNames: {
      "#deleted": "deleted",
    },
    ExpressionAttributeValues: {
      ":deleted": valueToAttributeValue(true),
    },
  });
};
La query per getStudentByEmail ora dovrebbe filtrare i record eliminati. È importante notare che questo "filtro" avviene lato client e non nel database, quindi questa query avrà comunque lo stesso costo per il recupero dei record eliminati.
{
  TableName: TABLE_NAME,
  IndexName: "gsi1",
  KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
  ExpressionAttributeNames: {
    "#gsi1_pk": "gsi1_pk",
  },
  ExpressionAttributeValues: {
    ":gsi1_pk": {
      S: email.toLocaleLowerCase(),
    },
    ":notDeleted": {
      BOOL: false,
    },
  },
  FilterExpression:
    "attribute_not_exists(deleted) OR deleted = :notDeleted",
 }
La funzione getStudentById usa getItem, quindi non abbiamo l'opzione di applicare una filter expression; al contrario scriveremo esplicitamente la logica:
export const getStudentById = (id: string): Promise<Student | null> =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
        pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
        sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      },
    })
    .then(({ Item }) => {
      if (!Item) {
        return null;
      }
      const _item = dynamoRecordToStudent(Item);
      return _item.deleted ? null : _item;
    });
Aggiornamenti atomici con conformità ACID
DataCamp raccoglie i dati XP per ogni studente fornendo motivazione, senso di realizzazione, un modo semplice per tracciare i progressi complessivi e un mezzo con cui gli studenti possono confrontarsi con i pari. In un database relazionale abbiamo vari strumenti a disposizione per manipolare e aggregare i dati, ma non è così per i database NoSQL. Sebbene alcuni database NoSQL come MongoDB forniscano un framework di aggregazione, questi strumenti tendono a cedere quando il database raggiunge grandi dimensioni e spesso si sceglie NoSQL proprio perché serve supportare volumi e traffico enormi.
In DynamoDB, gli aggiornamenti atomici si riferiscono alla possibilità di eseguire alcune operazioni di update su un singolo attributo di un item in modo da garantire atomicità, consistenza, isolamento e durabilità (proprietà ACID). Gli aggiornamenti atomici sono operazioni che modificano il valore di un attributo specifico garantendo il successo dell'operazione anche in presenza di aggiornamenti concorrenti.
Usando questa tecnica possiamo aggiungere facilmente XP quando un utente completa un obiettivo di apprendimento.
export const updateStudentXp = async ({
  id,
  xp,
}: {
  id: string;
  xp: number;
}) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "set xp = xp + :inc",
    ExpressionAttributeValues: {
      ":inc": valueToAttributeValue(xp),
    },
  });
};
Se questo codice ti sembra familiare è perché abbiamo già usato questo pattern nella funzione deleteStudent!
Conclusione
In questo tutorial abbiamo esplorato i fondamenti di Amazon DynamoDB, un database serverless e altamente scalabile offerto da AWS. Le caratteristiche chiave di DynamoDB, tra cui scalabilità trasparente, alta disponibilità e modellazione flessibile dei dati, lo rendono un'ottima scelta per le applicazioni moderne.
Abbiamo trattato argomenti essenziali come la creazione di tabelle, l'esecuzione di operazioni CRUD usando Node.js e l'importanza degli aggiornamenti atomici per mantenere la consistenza dei dati. Durante il tutorial, abbiamo sviluppato un modello dati e implementato funzioni per interagire con DynamoDB.
Proseguendo nel tuo percorso con DynamoDB, valuta di approfondire argomenti avanzati come il design a singola tabella, l'ottimizzazione delle prestazioni e DynamoDB Streams per l'elaborazione dei dati in tempo reale. La versatilità e scalabilità di DynamoDB ti consentono di creare applicazioni serverless ad alte prestazioni nell'ecosistema AWS.
Puoi trovare il codice sorgente completo di questo tutorial su GitHub. Buon coding!
Materiali di approfondimento
- Tutorial DataCamp: Design a singola tabella con DynamoDB
- Corso DataCamp: Concetti di NoSQL
- AWS re:Invent: Advanced Design Patterns for DynamoDB
- Rick Houlihan: Fondamenti del design a tabella singola di DynamoDB
- Alex DeBrie: Il libro su DynamoDB