50% off DataCamp Premium. 700+ courses, half price. Start learning today.
In de datagedreven wereld van vandaag is de behoefte aan schaalbare, krachtige en hoog-beschikbare databases groter dan ooit. Amazon DynamoDB, een volledig beheerde, serverloze wide-column key-value store van AWS (Amazon Web Services), is ontworpen om aan deze eisen te voldoen. Of je nu een webapplicatie, mobiele app of een ander systeem bouwt dat flexibele en betrouwbare opslag nodig heeft, met DynamoDB zit je goed.
Deze tutorial wil je introduceren in de wereld van Amazon DynamoDB en laten zien hoe je het effectief gebruikt in Node.js-applicaties. Of je nu een beginner bent met NoSQL-databases of een ervaren ontwikkelaar die zijn skillset wil uitbreiden, deze gids neemt je mee door de basis en biedt praktische voorbeelden om je op weg te helpen.
Amazon DynamoDB is een serverloze key-value- en documentdatabase die naadloze schaalbaarheid en prestaties met lage latency biedt. In tegenstelling tot traditionele relationele databases hoef je bij DynamoDB geen hardware te voorzien of infrastructuur te beheren, wat het een ideale keuze maakt voor applicaties die dynamisch moeten kunnen opschalen of afschalen afhankelijk van de werklast.
Belangrijke kenmerken van DynamoDB zijn onder meer:
DynamoDB kan miljoenen verzoeken per seconde verwerken en is daardoor geschikt voor applicaties met wisselende verkeersniveaus.
Ontworpen voor hoge beschikbaarheid en dataduurzaamheid, met ingebouwde replicatie over meerdere availability zones.
AWS neemt de operationele lasten uit handen, waaronder hardwarevoorziening, patching en back-ups, zodat jij je kunt richten op het bouwen van je applicatie.
DynamoDB ondersteunt zowel key-value- als documentdatamodellen, wat flexibiliteit biedt in hoe je je data structureert.
Integratie met AWS Identity and Access Management (IAM) maakt fijnmazige, veilige toegangscontrole mogelijk tot je databaseresources op item- en attributenniveau.
Dankzij de serverloze architectuur van DynamoDB en de automatische schaalmogelijkheden kun je kosten optimaliseren door alleen te betalen voor de resources die je verbruikt. Er zijn geen initiële hardwarekosten of langetermijnverplichtingen, waardoor het een kosteneffectieve keuze is voor zowel startups als enterprises.
Ondersteunde datatypen in DynamoDB:
Node.js is een populaire runtime-omgeving voor het bouwen van server-side applicaties, waaronder webservers en API's. De niet-blokkerende, eventgedreven architectuur sluit goed aan op de asynchrone API van DynamoDB, waardoor het een logische keuze is voor Node.js-ontwikkelaars.
In deze tutorial behandelen we de volgende onderwerpen:
1. Tabellen maken en een schema definiëren in DynamoDB.
2. Basis-CRUD (Create, Read, Update, Delete)-bewerkingen uitvoeren met de AWS SDK voor Node.js.
3. Geavanceerd query'en met ACID-compliance.
Aan het einde van deze tutorial heb je een solide begrip van Amazon DynamoDB en weet je hoe je de kracht ervan benut binnen je Node.js-applicaties. Laten we erin duiken en het potentieel van deze veelzijdige NoSQL-database ontsluiten!
Voordat we beginnen, heb je een AWS-account nodig. We zouden dit allemaal kunnen doen zonder een AWS-account, maar voor een realistischer voorbeeld gaan we terraform gebruiken om onze infrastructuur in AWS te creëren. Voor meer informatie over hoe je lokaal met AWS-services werkt met Docker heb ik een voorbeeld-demo localstack github-repository waar je naar kunt verwijzen en mee kunt experimenteren.
Nu is ook het moment om terraform te installeren als je dat nog niet hebt.
De rest van deze tutorial gaat ervan uit dat je de AWS CLI hebt ingesteld met je inloggegevens en configuratiebestanden, en dat je terraform hebt geïnstalleerd.
Voor deze tutorial gebruiken we TypeScript en Yarn. We beginnen eenvoudig met ts-node en in de volgende tutorial gaan we serverless en bouwen we hierop voort met AWS Lambda.
Om ons demoproject op te zetten, maak je een nieuwe map aan en voeg je vervolgens de volgende dependencies en setup toe door het volgende uit te voeren:
yarn init
yarn add --dev typescript ts-node @types/node @types/ramda @types/uuid
yarn add @aws-sdk/client-dynamodb ramda uuid
npx tsc --init
mkdir src src/domain infra
touch ./src/index.ts ./src/client.ts ./infra/main.tf ./src/domain/student.ts
Voeg vervolgens de volgende scripts-sectie toe aan package.json
  "scripts": {
    "dev": "ts-node src/index.ts"
  },
provider "aws" {
  region = "eu-west-1"
}


resource "aws_dynamodb_table" "demo-table" {
  name = "demo-table"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }
}
Ga vanaf de command line naar de map infra en voer terraform init && terraform apply -auto-approve uit en ga vervolgens naar de AWS-console om je DynamoDB-tabel te bekijken:
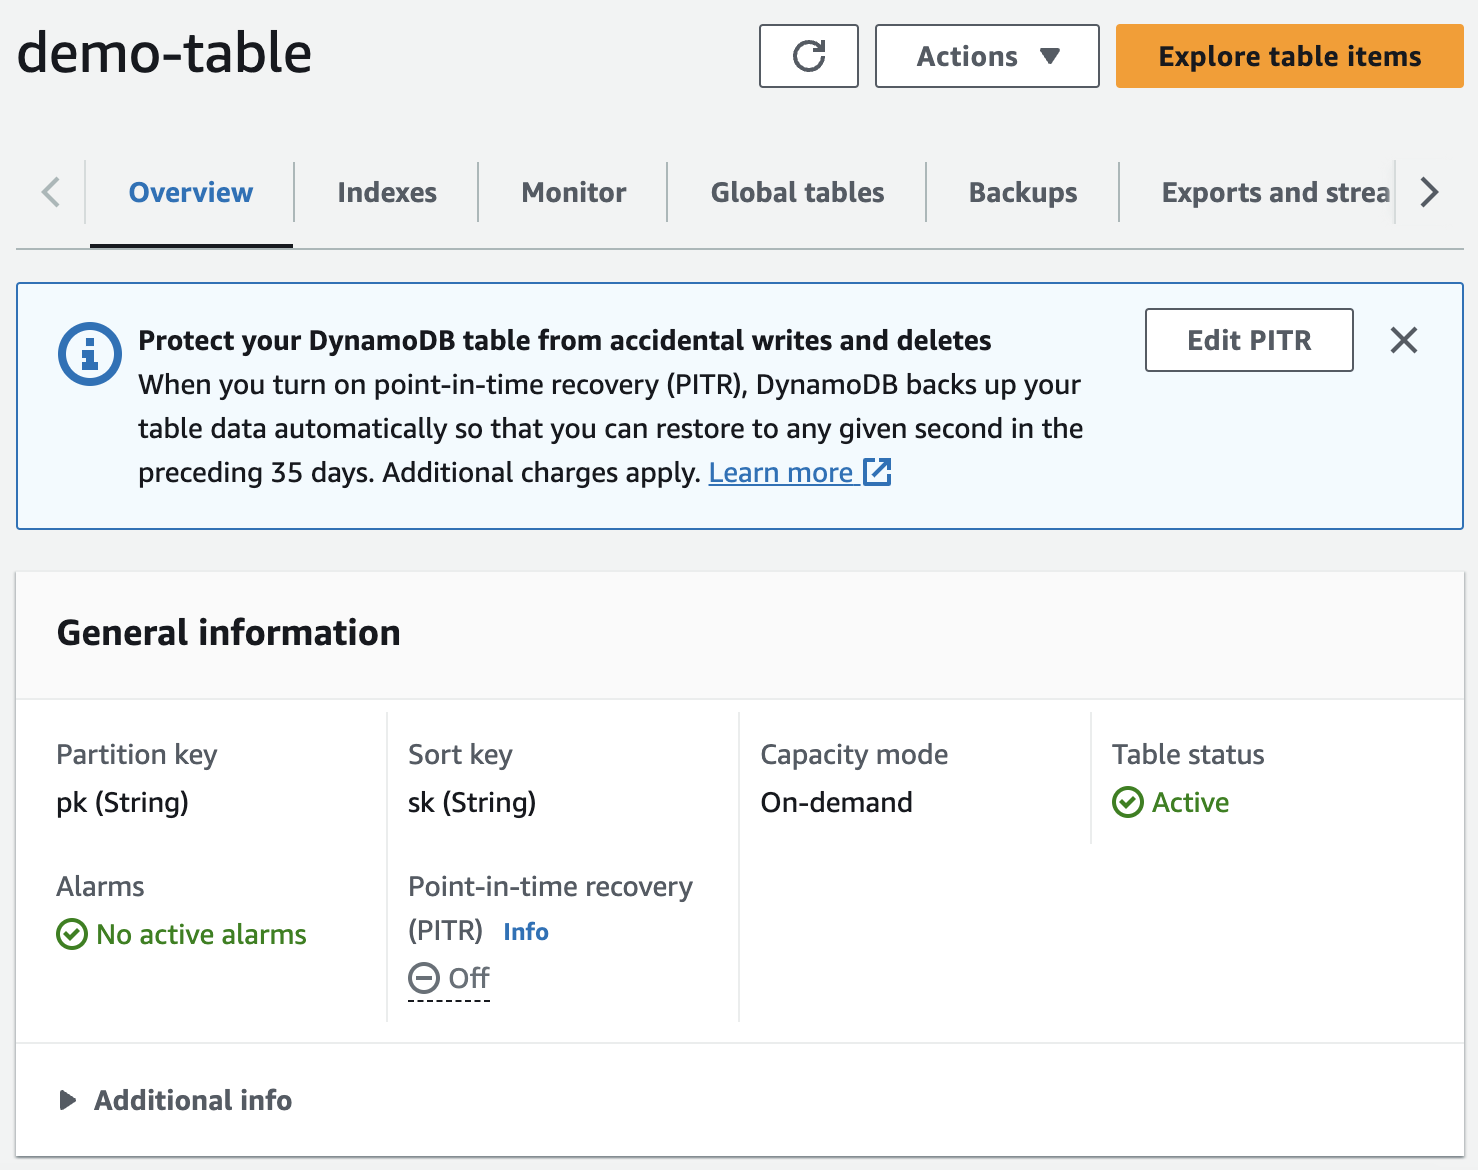
Ik behandel DynamoDB-billingmodes, WCU's en RCU's in een apart artikel
import { DynamoDB } from "@aws-sdk/client-dynamodb";


export const TABLE_NAME = "demo-table";
export const REGION = "eu-west-1";
export const dynamoClient = new DynamoDB({ region: REGION });


export const STUDENT_PREFIX = "student#";Voordat we verder gaan, definiëren we een datamodel dat we binnen de scope van deze tutorial kunnen gebruiken. Om het concreet te houden, heb ik ervoor gekozen iets te modelleren dat dicht bij de kernfunctionaliteit van DataCamp ligt.
Deze tutorial behandelt niet alle entiteiten. Ik breid dit model uit in volgende artikelen.
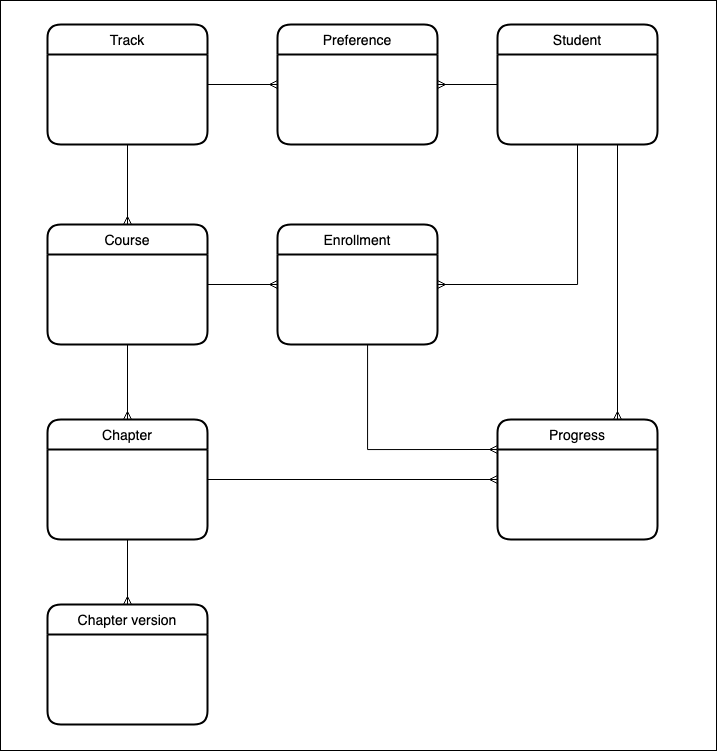
Voor een volledig begrip van hoe je data ontwerpt en modelleert met DynamoDB, zie mijn tutorial over single-table design met DynamoDB. In deze tutorial houd ik de uitleg over hoe DynamoDB werkt bewust beperkt. Het belangrijkste om te onthouden is dat DynamoDB partition keys en sort keys gebruikt voor efficiënte gegevensverwerking.
Partition keys worden gebruikt om data over meerdere opslagservers te verdelen. Het is belangrijk een partition key te kiezen die je data gelijkmatig verdeelt om "hot partitions" (oneven gegevensverdeling) te vermijden, wat tot prestatieproblemen kan leiden.
Veelgebruikte keuzes voor partition keys die helpen bij een gelijkmatige verdeling zijn attributen met een hoge cardinaliteit, zoals:
De keuze voor een partition key hangt sterk af van de toegangspatronen en het datamodel van de applicatie.
Sort keys zijn optioneel en stellen je in staat data binnen een partition te ordenen. Gebruik sort keys voor efficiënt query'en en sorteren van data binnen een partition.
Samengestelde sleutels bestaan uit zowel partition- als sort keys. Ze maken rijke querypatronen mogelijk, zoals filteren op bereik, tijd of andere attributen. Gebruik samengestelde sleutels wanneer je toegangspatronen complexe queries vereisen.
Om hot partitions te beperken, kun je strategieën overwegen zoals sharding (willekeurige prefixes voor partition keys), tijdgebaseerde partitionering of het gelijkmatig verdelen van writes. Monitor en gebruik AWS Auto Scaling om de capaciteit dynamisch aan te passen.
We houden het simpel en gebruiken de student-ID als zowel partition key als sort key. Dit lijkt misschien een vreemde keuze, maar we willen ons schema flexibel houden en klaar om verschillende dataverhoudingen en toegangspatronen te ondersteunen. Ik breid dit model uit in volgende DynamoDB-artikelen.
import { head, omit, pathOr } from "ramda";
import { STUDENT_PREFIX, TABLE_NAME, dynamoClient as client } from "../client";
import { v4 as uuidv4 } from "uuid";
import {
  addPrefix,
  attributeMapToValues,
  attributeValueToValue,
  removePrefix,
  valueToAttributeValue,
} from "../utils";


const entityType = "student";


export const dynamoRecordToStudent = (record: any) => {
  const { pk, ...data } = record;


  return omit(["sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
  });
};


export const getStudentById = (id: string) =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
  })
  .then(({ Item }) => (Item ? dynamoRecordToStudent(Item) : undefined));


export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      email: valueToAttributeValue(_email),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
De nieuwste DynamoDB SDK van AWS heeft de typesafety voor items die in de database zijn opgeslagen verhoogd, maar daardoor is het werken ermee iets lastiger geworden. Om dit te verlichten maken we enkele helperfuncties. Het wordt later duidelijk waarom we ze nodig hebben wanneer we zien hoe DynamoDB data intern opslaat.
Maak een nieuw bestand in de root van de map src met de naam utils.ts.
import { AttributeValue } from "@aws-sdk/client-dynamodb";


export const valueToAttributeValue = <T>(value: T): AttributeValue => {
  switch (typeof value) {
    case "string":
      return { S: value };
    case "number":
      return { N: `${value}` };
    case "boolean":
      return { BOOL: value };
    case "object":
      if (Array.isArray(value)) {
        return { L: value.map((item) => valueToAttributeValue(item)) };
      }
      return {
        M: Object.entries(value as any).reduce(
          (acc, [key, item]) => ({
            ...acc,
            [key]: valueToAttributeValue(item),
          }),
          {}
        ),
      };
    default:
      throw new Error(`Unknown type ${typeof value}`);
  }
};


export const attributeValueToValue = <T>(value: AttributeValue): T => {
  switch (true) {
    case !!value.S:
      return value.S as T;
    case !!value.N:
      return Number(value.N) as T;
    case !!value.BOOL:
      return value.BOOL as T;
    case !!value.L:
      return value.L?.map((item) =>
        attributeValueToValue(item)
      ) as unknown as T;
    case !!value.M:
      return Object.entries(value.M || []).reduce(
        (acc, [key, item]) => ({ ...acc, [key]: attributeValueToValue(item) }),
        {}
      ) as unknown as T;
    default:
      throw new Error(`Unknown type ${JSON.stringify(value)}`);
  }
};


export const attributeMapToValues = (
  items: Record<string, AttributeValue>
): unknown[] =>
  Object.keys(items).reduce(
    (acc, key) => ({
      ...acc,
      [key]: attributeValueToValue(items[key]),
    }),
    []
  );


export const removePrefix = (id: string, prefix: string): string =>
  id.replace(prefix, "");


export const addPrefix = (id: string, prefix: string): string =>
  `${prefix}${removePrefix(id, prefix)}`;
Eindelijk zijn we klaar om CRUD-API-calls naar DynamoDB te sturen!
Open het bestand index.ts en plak de volgende code. Voer daarna vanaf de commandline yarn dev uit.
import { getStudentById, saveStudent } from "./domain/student";


Promise.resolve()
  .then(async () => {
    const id = await saveStudent({
      firstName: "John",
      lastName: "Smith",
      email: "john@datacamp.com",
    });


    const john = await getStudentById(id);


    console.log(john);
  })
  .catch((err) => {
    console.error(err);
    process.exit(1);
  })
  .then(() => {
    console.log("done");
    process.exit(0);
  });
Je zou zoiets als dit moeten terugkrijgen:
{
  "entityType": "student",
  "id": "dd4c2ee4-9422-4957-ae6f-f9fff748e5ab",
  "firstName": "John",
  "lastName": "Smith",
  "email": "john@datacamp.com",
  "xp": 0
}
Gebruik nu de CLI om DynamoDB te scannen door het volgende uit te voeren:
aws dynamodb scan --table-name demo-table --no-cli-pager
Aan de output zie je hoe DynamoDB data intern opslaat en typt, waarbij N verwijst naar een getaltype en S naar een stringtype. Dat zou eventuele vragen moeten wegnemen die je had over de code in utils.ts.
{
  "Items": [
    {
      "entityType": {
        "S": "student"
      },
      "lastName": {
        "S": "Smith"
      },
      "email": {
        "S": "john@datacamp.com"
      },
      "xp": {
        "N": "0"
      },
      "sk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "pk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "firstName": {
        "S": "John"
      }
    }
  ],
  "Count": 1,
  "ScannedCount": 1,
  "ConsumedCapacity": null
}
Wat als we alleen het e-mailadres van de student hadden om ons record te vinden? We kunnen dit toegangspatroon ondersteunen door een global secondary index toe te voegen.
Eerst moeten we onze oorspronkelijke tabel vernietigen (we omzeilen deze stap bij toekomstige terraform-wijzigingen door een truncate-table-functie te introduceren):
terraform destroy
Werk vervolgens de terraform-configuratie bij door de volgende GSI toe te voegen aan onze demo-table:
attribute {
  name = "gsi1_pk"
  type = "S"
}


attribute {
  name = "gsi1_sk"
  type = "S"
}


global_secondary_index {
  name = "gsi1"
  hash_key = "gsi1_pk"
  range_key = "gsi1_sk"
  projection_type = "ALL"
}
Pas deze wijziging toe met:
terraform apply -auto-approve
Vervolgens moeten we een kleine aanpassing doen aan hoe we een student opslaan:
export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      gsi1_pk: valueToAttributeValue(_email),
      gsi1_sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
Merk op dat we het e-mailadres niet langer expliciet opslaan, maar het gebruiken als onze GSI PK-waarde.
We moeten een kleine aanpassing doen aan hoe we DynamoDB-studentdata transformeren:
export const dynamoRecordToStudent = (record: any) => {
  const { pk, gsi1_pk, ...data } = record;


  return omit(["sk", "gsi1_sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
    email: attributeValueToValue<string>(gsi1_pk),
  });
};
Tot slot kunnen we met onze nieuw aangemaakte GSI gsi1 query'en om een studentrecord op e-mailadres op te halen:
export const getStudentByEmail = (email: string) =>
  client
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
      ExpressionAttributeNames: {
        "#gsi1_pk": "gsi1_pk",
      },
      ExpressionAttributeValues: {
        ":gsi1_pk": {
          S: email.toLocaleLowerCase(),
        },
      },
    })
.then((res) => head(pathOr([], ["Items"], res).map(dynamoRecordToStudent)));Om een student bij te werken, moeten we de methode update gebruiken en zowel de partition key als de sort key opgeven om het item dat we willen bijwerken eenduidig te identificeren.
export const updateStudent = async ({
  id,
  firstName,
  lastName,
  email,
}: {
  id: string;
  firstName?: string;
  lastName?: string;
  email?: string;
}) => {
  const updateExpressionParts = [];
  const ExpressionAttributeValues: Record<string, any> = {};


  if (firstName !== undefined) {
    updateExpressionParts.push("#firstName = :firstName");
    ExpressionAttributeValues[":firstName"] = valueToAttributeValue(firstName);
  }


  if (lastName !== undefined) {
    updateExpressionParts.push("#lastName = :lastName");
    ExpressionAttributeValues[":lastName"] = valueToAttributeValue(lastName);
  }


  if (email !== undefined) {
    updateExpressionParts.push("#gsi1_pk = :gsi1_pk");
    ExpressionAttributeValues[":gsi1_pk"] = valueToAttributeValue(email);
  }


  const UpdateExpression = `SET ${updateExpressionParts.join(", ")}`;


  const ExpressionAttributeNames = {
    ...(firstName && { "#firstName": "firstName" }),
    ...(lastName && { "#lastName": "lastName" }),
    ...(email && { "#gsi1_pk": "gsi1_pk" }),
  };


  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression,
    ExpressionAttributeNames,
    ExpressionAttributeValues,
  });
};
Laten we beginnen met het feit dat het truncaten van een tabel in DynamoDB niet native wordt ondersteund, behalve door de hele tabel te verwijderen en opnieuw aan te maken (zoals we eerder moesten doen om een nieuwe GSI te introduceren). Ik voeg een truncate-methode toe aan onze client.ts, maar ik wil benadrukken dat dit alleen voor testdoeleinden is en niet in productie moet worden gebruikt. De reden is dat we, om te weten wat we moeten verwijderen, de hele tabel moeten scannen, en elke bewerking in DynamoDB kosten met zich meebrengt. Als je dus een tabel met een miljoen items hebt, is het goedkoper om die tabel te verwijderen en opnieuw te beginnen (met een soort datamigratieproces zodat je geen productiedata verliest). Hier is onze truncate-functie:
type AttributeMap = Record<string, AttributeValue>;


const getItemKeyAndValue = (item: AttributeMap, key?: string) =>
  key ? { [`${key}`]: item[`${key}`] } : {};


export const truncateTable = async (
  client: DynamoDB,
  TableName: string,
  hash: string,
  range?: string
): Promise<void> => {
  const { Items } = await client.scan({ TableName });
  if (!Items) {
    return;
  }
  const keys = Items.map((item: AttributeMap) => ({
    ...getItemKeyAndValue(item, hash),
    ...getItemKeyAndValue(item, range),
  }));
  if (!keys.length) {
    return;
  }
  await Promise.all(keys?.map((Key) => client.deleteItem({ TableName, Key })));
};
Om de demo-table te truncaten:
await truncateTable(dynamoClient, TABLE_NAME, "pk", "sk");
Om een specifieke student te verwijderen, willen we eigenlijk niet de methode deleteItem uit de SDK gebruiken. NoSQL-databases kennen geen referentiële integriteit en als we andere items in onze database hadden die verwezen naar een student die niet meer bestond, zou dat een probleem zijn. DynamoDB verwijdert elk item dat we opgeven zonder de veiligheid van een vangnet dat, zoals een relationele database, controleert op foreign key-verwijzingen (en bij een relationele database voor die delete-operatie een fout zou geven).
Voor de zekerheid implementeren we een soft delete en passen we onze twee read-functies licht aan.
export const deleteStudent = async (id: string) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "SET #deleted = :deleted",
    ExpressionAttributeNames: {
      "#deleted": "deleted",
    },
    ExpressionAttributeValues: {
      ":deleted": valueToAttributeValue(true),
    },
  });
};
De query voor getStudentByEmail moet nu verwijderde records uitfilteren. Belangrijk om te weten: dit "filteren" gebeurt aan de clientzijde en niet in de database, wat betekent dat deze query nog steeds dezelfde kosten met zich meebrengt voor het ophalen van verwijderde records.
{
  TableName: TABLE_NAME,
  IndexName: "gsi1",
  KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
  ExpressionAttributeNames: {
    "#gsi1_pk": "gsi1_pk",
  },
  ExpressionAttributeValues: {
    ":gsi1_pk": {
      S: email.toLocaleLowerCase(),
    },
    ":notDeleted": {
      BOOL: false,
    },
  },
  FilterExpression:
    "attribute_not_exists(deleted) OR deleted = :notDeleted",
 }
De functie getStudentById gebruikt getItem, dus we kunnen hier geen filterexpressie toepassen. In plaats daarvan schrijven we de logica expliciet uit:
export const getStudentById = (id: string): Promise<Student | null> =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
        pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
        sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      },
    })
    .then(({ Item }) => {
      if (!Item) {
        return null;
      }
      const _item = dynamoRecordToStudent(Item);
      return _item.deleted ? null : _item;
    });
DataCamp verzamelt XP-data voor elke student, wat zorgt voor motivatie, een gevoel van prestatie, een eenvoudige manier om totale voortgang bij te houden en een middel waarmee studenten zich kunnen meten met hun peers. In een relationele database hebben we allerlei hulpmiddelen om data te manipuleren en te aggregeren, maar dat is niet het geval voor NoSQL-databases. Hoewel sommige NoSQL-databases zoals MongoDB een aggregatiekader bieden, haken deze tools vaak af wanneer de database zeer grote schaal bereikt. De reden om voor NoSQL te kiezen is vaak juist dat we enorme volumes data en traffic moeten ondersteunen.
In DynamoDB verwijst atomische updates naar de mogelijkheid om bepaalde updatebewerkingen op één attribuut van een item uit te voeren op een manier die atomiciteit, consistentie, isolatie en duurzaamheid (ACID-eigenschappen) waarborgt. Atomische updates zijn bewerkingen die de waarde van een specifiek attribuut wijzigen op een manier die het slagen van de operatie garandeert, zelfs bij gelijktijdige updates.
Met deze techniek kunnen we eenvoudig XP toevoegen wanneer een gebruiker een leerdoel voltooit.
export const updateStudentXp = async ({
  id,
  xp,
}: {
  id: string;
  xp: number;
}) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "set xp = xp + :inc",
    ExpressionAttributeValues: {
      ":inc": valueToAttributeValue(xp),
    },
  });
};
Als deze code bekend voorkomt, komt dat doordat we dit patroon al gebruikten voor de functie deleteStudent!
In deze tutorial hebben we de basis verkend van Amazon DynamoDB, een serverloze, zeer schaalbare database van AWS. De belangrijkste kenmerken van DynamoDB, waaronder naadloze schaalbaarheid, hoge beschikbaarheid en flexibel datamodel, maken het een uitstekende keuze voor moderne applicaties.
We behandelden essentiële onderwerpen zoals het maken van tabellen, het uitvoeren van CRUD-bewerkingen met Node.js en we bespraken het belang van atomische updates om dataconsistentie te behouden. Door de hele tutorial heen hebben we een datamodel ontwikkeld en functies geïmplementeerd om met DynamoDB te communiceren.
Als je je DynamoDB-reis voortzet, overweeg dan om je te verdiepen in geavanceerde onderwerpen zoals single-table design, prestatieoptimalisatie en DynamoDB Streams voor realtime gegevensverwerking. De veelzijdigheid en schaalbaarheid van DynamoDB stellen je in staat om krachtige, serverloze applicaties te bouwen binnen het AWS-ecosysteem.
Je vindt de volledige broncode van deze tutorial op Github. Veel codeerplezier!
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min