
Kursus
Pengantar Kueri SQL dengan AI
3 jam
7.3K
Tim Jan baru-baru ini merilis Jan-v1, sebuah model penalaran agen tingkat lanjut yang menghadirkan kemampuan otomatisasi riset canggih melalui pemanfaatan alat yang ditingkatkan dan pemecahan masalah multi-langkah.
Fokus saya dalam tutorial ini adalah pada kemampuan penalaran agen yang unik dari Jan-v1, menunjukkan bagaimana ia bertindak sebagai alur kerja riset yang kompleks melalui antarmuka Streamlit yang dijalankan secara lokal dan didukung oleh llama.cpp.
Dalam tutorial ini, saya akan menjelaskan cara:
Di akhir, aplikasi Anda akan terlihat seperti ini:
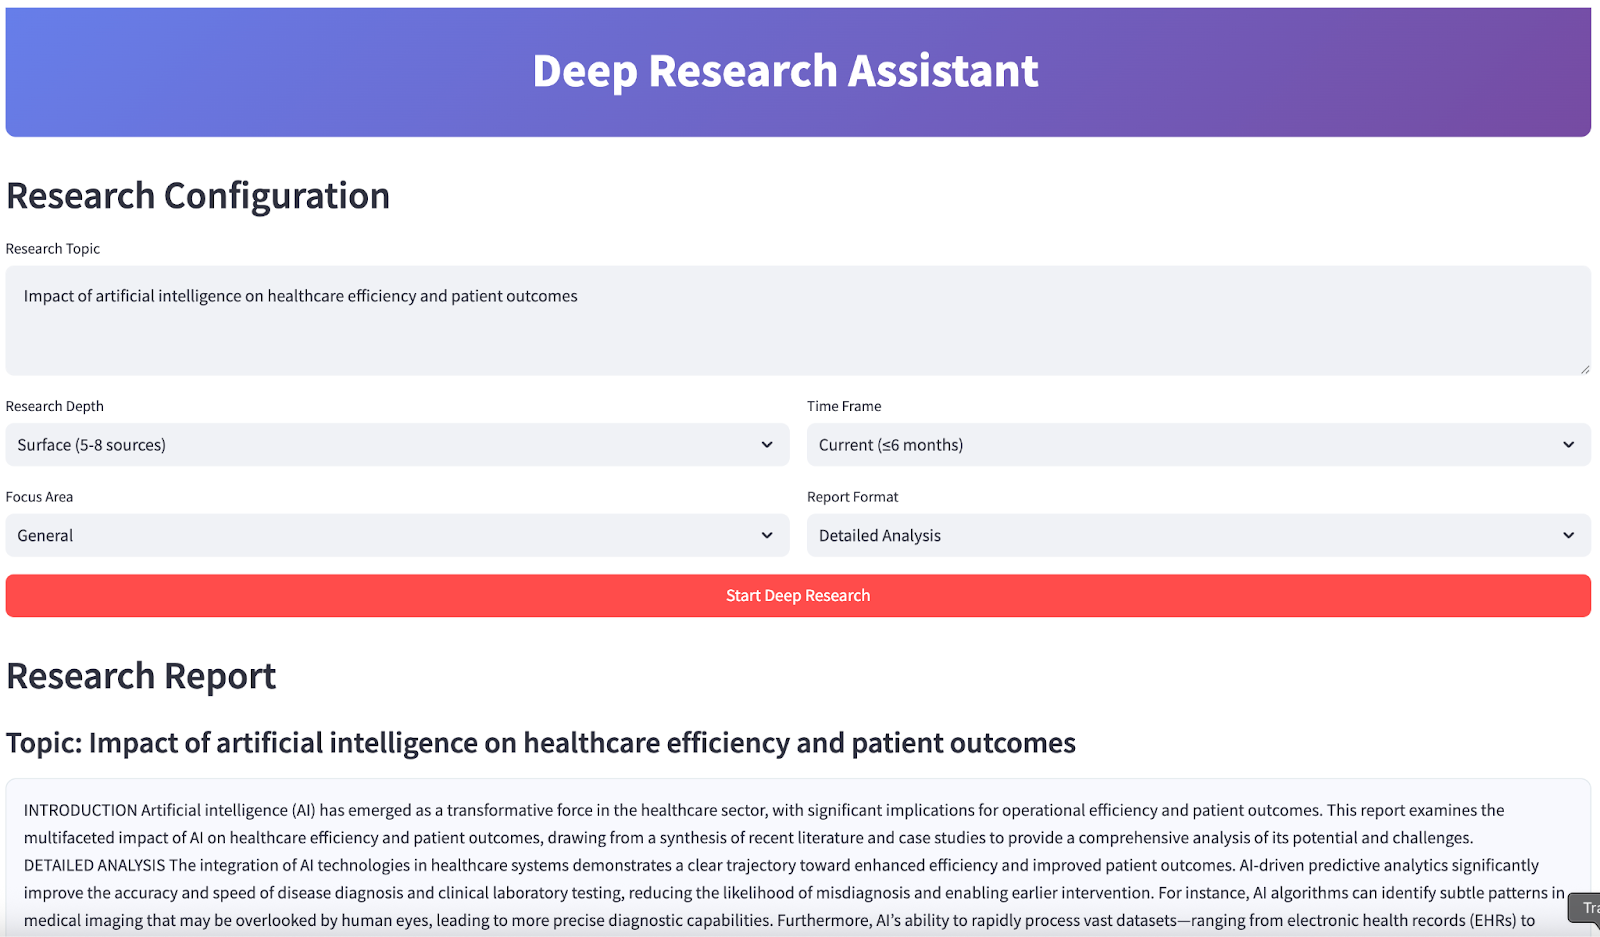
Jan-v1 adalah model berparameter 4B yang dibangun di atas fondasi Lucy dan Qwen3-4B-thinking, dirancang untuk alur kerja agen seperti penggunaan alat, penalaran multi-langkah, dan riset otomatis. Tidak seperti LLM konvensional, Jan-v1 unggul dalam mengoordinasikan alat, sumber data, dan langkah penalaran melalui scaffolding terstruktur dan penghargaan yang selaras dengan perilaku.
Berikut beberapa fitur utama model ini:
Untuk proyek ini, kita akan mendeploy Jan-v1 secara lokal menggunakan Llama.cpp dengan versi terkuantisasi GGUF untuk kinerja optimal dan efisiensi sumber daya.
Pertama, pastikan Anda memiliki paket Python yang diperlukan:
pip install llama-cpp-python==0.3.15
pip install streamlit aiohttp
Perintah ini memasang semua dependensi inti yang dibutuhkan untuk integrasi model AI, pembuatan antarmuka web, dan operasi web asinkron.
Sebelum mengunduh model, buat direktori baru bernama models/ menggunakan perintah berikut:
mkdir -p modelsLalu, unduh model menggunakan perintah berikut:
curl -L https://huggingface.co/janhq/Jan-v1-4B-GGUF/resolve/main/Jan-v1-4B-Q4_K_M.gguf -o Jan-v1-4B-Q4_K_M.ggufDengan menyelesaikan langkah ini, Anda telah berhasil mengunduh model Jan-v1 4B dalam format GGUF dan menempatkannya di direktori models/. Versi terkuantisasi ini menawarkan kompromi seimbang antara kinerja dan efisiensi memori, menjadikannya ideal untuk inferensi lokal pada CPU atau Colab.
Daftar atau masuk ke akun Serper Anda: https://serper.dev/api-keys dan pilih tab API Keys, lalu salin kunci API default untuk demo ini. Mari tetapkan kunci ini sebagai variabel lingkungan seperti berikut:
export SERPER_API_KEY=xxxxxxxxxxxxxxxxxxxxxxxxxxx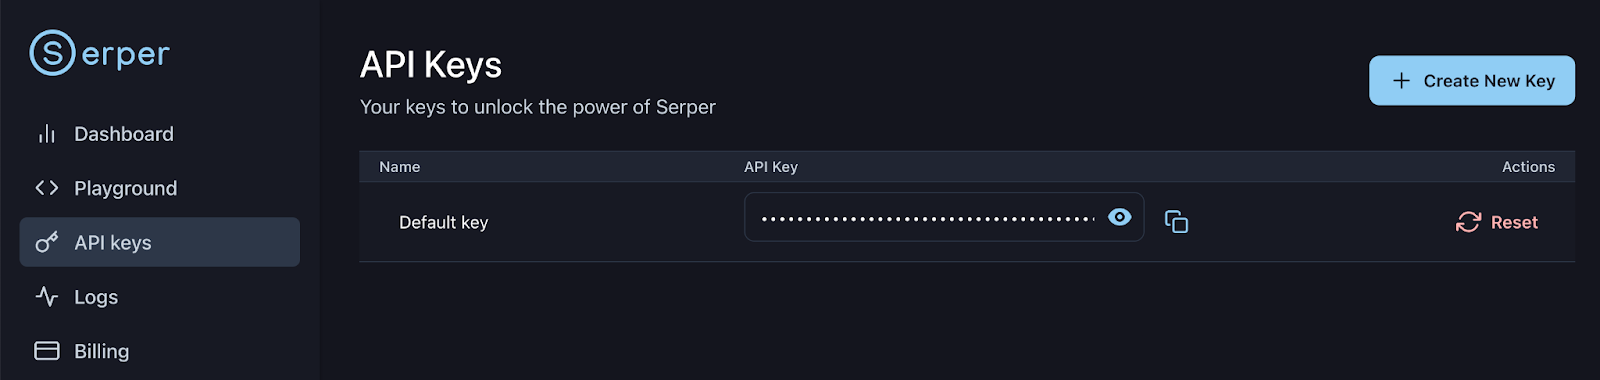
Sekarang Anda siap memuat dan berinteraksi dengan model dalam pipeline asisten riset Anda.
Mari kita membangun aplikasi Streamlit yang menunjukkan kemampuan riset lanjutan Jan-v1, dengan pembuatan kueri cerdas, penelusuran web otomatis (menggunakan Serper), dan sintesis laporan profesional.
Kita mulai dengan mengimpor semua pustaka yang diperlukan untuk asisten riset kita. Ini mendukung semuanya mulai dari pembuatan antarmuka web hingga penelusuran web asinkron dan integrasi model AI lokal.
import streamlit as st
import json
import time
import re
from datetime import datetime
from typing import List, Dict, Optional
import asyncio
import aiohttp
from llama_cpp import Llama
import os
from dataclasses import dataclass
Kita mengimpor semua pustaka inti yang digunakan di seluruh aplikasi. Ini mencakup komponen UI (Streamlit), alat konkurensi (asyncio, aiohttp), dan backend LLM (llama_cpp). Kita juga membawa utilitas untuk parsing, typing, dan penanganan tanggal.
Sekarang, kita akan mengimplementasikan beberapa fungsi pembantu yang menangani pemformatan laporan dan ekstraksi konten. Fungsi-fungsi ini memastikan laporan yang dihasilkan tetap berkualitas profesional dan memiliki struktur yang konsisten.
def sections_for_format(fmt: str) -> list[str]:
    fmt = (fmt or "").strip().lower()
    if fmt == "executive":
        return ["EXECUTIVE SUMMARY"]
    if fmt == "detailed":
        return [
            "INTRODUCTION",
            "DETAILED ANALYSIS",
            "CURRENT TRENDS AND DEVELOPMENTS",
            "IMPLICATIONS AND RECOMMENDATIONS",
            "CONCLUSION",
        ]
    if fmt == "academic":
        return [
            "ABSTRACT",
            "INTRODUCTION",
            "METHODOLOGY",
            "FINDINGS",
            "DISCUSSION",
            "CONCLUSION",
        ]
    if fmt == "presentation":
        return [
            "OVERVIEW",
            "KEY INSIGHTS",
            "RECOMMENDATIONS",
            "NEXT STEPS",
            "CONCLUSION",
        ]
    return ["INTRODUCTION", "DETAILED ANALYSIS", "CONCLUSION"]
def extract_final_block(text: str) -> str:
    m = re.search(r"<final>([\s\S]*?)</final>", text, flags=re.IGNORECASE)
    if m:
        cleaned_text = m.group(1).strip()
    else:
        cleaned_text = text
    preamble_patterns = [
        r"^(?:note:|okay,|hmm,|internal|let me|i (?:will|’ll)|as an ai|thinking|plan:|here is your report|the following is|i have prepared|i am presenting|based on the provided information|below is the report|i hope this meets your requirements|this report outlines|this is the final report).*?$",
        r"^(?:Here is the report|I have compiled the report|The report is provided below|This is the requested report).*?$", # More specific preambles
        r"^(?:Please find the report below|Here's the report).*?$"
    ]
    for pattern in preamble_patterns:
        cleaned_text = re.sub(pattern, "", cleaned_text, flags=re.IGNORECASE | re.MULTILINE).strip()
    cleaned_text = re.sub(r"(?m)^\s*[-*•]\s+", "", cleaned_text)
    cleaned_text = re.sub(r"[#`*_]{1,3}", "", cleaned_text)
    headers = [
        "EXECUTIVE SUMMARY","INTRODUCTION","DETAILED ANALYSIS","CURRENT TRENDS AND DEVELOPMENTS",
        "IMPLICATIONS AND RECOMMENDATIONS","CONCLUSION","ABSTRACT","METHODOLOGY","FINDINGS",
        "DISCUSSION","OVERVIEW","KEY INSIGHTS","RECOMMENDATIONS","NEXT STEPS"
    ]
    sorted_headers = sorted(headers, key=len, reverse=True)
    first_pos = -1
    for h in sorted_headers:
        match = re.search(r'\b' + re.escape(h) + r'\b', cleaned_text, flags=re.IGNORECASE)
        if match:
            if first_pos == -1 or match.start() < first_pos:
                first_pos = match.start()
    if first_pos >= 0:
        cleaned_text = cleaned_text[first_pos:].strip()
    return cleaned_text
Berikut peran setiap fungsi dalam pipeline:
sections_for_format() function: Fungsi ini menghasilkan judul bagian yang disesuaikan dengan format laporan yang dipilih (misalnya, executive, detailed, academic). Ini memastikan setiap laporan mematuhi standar profesional dan memenuhi ekspektasi pengguna.extract_final_block() function: Langkah pascapemrosesan ini mengisolasi konten inti laporan. Ia mengekstrak teks di antara tag <final> dan menghapus pembuka, frasa pengisi, dan artefak markdown. Ia juga mendeteksi header standar paling awal (misalnya "INTRODUCTION", "SUMMARY") untuk menghapus teks pembuka yang tidak relevan, memastikan keluaran akhir bersih, terstruktur, dan siap digunakan.Fungsi pembantu ini krusial untuk menjaga keluaran yang konsisten dan berkualitas tinggi di berbagai format laporan dan skenario riset untuk model thinking seperti Jan-v1.
Mari tetapkan sistem konfigurasi inti yang mengelola parameter model, pengaturan API, dan preferensi riset. Pendekatan modular ini memastikan kustomisasi mudah dan kinerja optimal.
Langkah ini mendefinisikan sistem konfigurasi dan pemuat model untuk inferensi lokal yang efisien dengan model Jan-v1. Sistem ini dirancang untuk mendukung tugas riset yang dapat direproduksi pada lingkungan hanya CPU, seperti laptop atau Colab Pro, sambil menjaga fleksibilitas dan keamanan.
@dataclass
class ResearchConfig:
    model_path: str = "models/Jan-v1-4B-Q4_K_M.gguf" #change as per your location
    max_tokens: int = 2048
    temperature: float = 0.6
    top_p: float = 0.95
    top_k: int = 20
    context_length: int = 4096
    search_api_key: str = os.getenv("SERPER_API_KEY", "")
    search_engine: str = "serper"
Berikut ikhtisar konfigurasi dari kode di atas:
ResearchConfig adalah @dataclass yang memusatkan semua konfigurasi LLM dan mesin pencari, sehingga mudah disetel untuk berbagai skenario riset.temperature, top_p, dan top_k diatur untuk menyeimbangkan kreativitas dengan pijakan faktual, yang penting bagi keluaran berorientasi riset.context_length ditetapkan 4096 token, dioptimalkan untuk kemampuan penalaran bentuk panjang Jan-v1.search_api_key memungkinkan integrasi dengan Serper untuk augmentasi penelusuran web waktu nyata.Pada langkah ini, kita mendefinisikan kelas Deep Research assistant yang bertindak sebagai pengendali inti untuk semua tugas riset, mengabstraksi penanganan model dan konfigurasi tingkat rendah sekaligus menyediakan antarmuka tingkat tinggi untuk generasi, pencarian, dan sintesis.
class DeepResearchAssistant:
    def __init__(self, config: ResearchConfig):
        self.config = config
        self.llm = None
        self.demo_mode = False
    def load_model(self):
        try:
            if not os.path.exists(self.config.model_path):
                print(f"Model file not found: {self.config.model_path}")
                return False
            file_size_gb = os.path.getsize(self.config.model_path) / (1024**3)
            if file_size_gb < 1.0:
                print(f"Model file too small ({file_size_gb:.1f} GB).")
                return False
            self.llm = Llama(
                model_path=self.config.model_path,
                n_ctx=self.config.context_length,
                verbose=False,
                n_threads=max(1, min(4, os.cpu_count() // 2)),
                n_gpu_layers=0,
                use_mmap=True,
                use_mlock=False,
                n_batch=128,
                f16_kv=True,
            )
            test = self.llm("Hi", max_tokens=3, temperature=0.1, echo=False)
            ok = bool(test and 'choices' in test)
            print("Model loaded " if ok else "Model loaded but test generation failed ")
            return ok
        except Exception as e:
            print(f"Model loading failed: {e}")
            return False
Kelas DeepResearchAssistant adalah orkesktrator utama yang mengelola pemuatan model, validasi konfigurasi, dan menyediakan antarmuka yang bersih untuk operasi riset. Sistem konfigurasi ini menyediakan penanganan kesalahan dan validasi, memastikan model dimuat dengan benar dan siap untuk tugas riset. Berikut fitur kunci kelas ini:
load_model() menginisialisasi model GGUF Jan-v1 secara aman menggunakan llama-cpp-python, yang dioptimalkan untuk inferensi CPU lokal.use_mmap=True untuk mengaktifkan pemuatan berbasis disk yang efisien tanpa mengonsumsi RAM penuh.f16_kv=True untuk penggunaan memori yang lebih rendah. Parameter n_gpu_layers=0 memastikan eksekusi hanya CPU.Penyiapan ini memastikan inferensi lokal yang cepat dan ringan, ideal untuk menjalankan Jan-v1 di laptop atau Colab tanpa GPU.
Selanjutnya, kita akan mengimplementasikan sistem generasi respons inti beserta kemampuan penelusuran web yang mendukung otomasi riset kita. Untuk ini, kita menggunakan layanan API Serper seperti ditunjukkan di bawah:
def generate_response(self, prompt: str, max_tokens: int = None, extra_stops: Optional[List[str]] = None) -> str:
        if not self.llm:
            return "Model not loaded."
        stops = ["</s>", "<|im_end|>", "<|endoftext|>"]
        if extra_stops:
            stops.extend(extra_stops)
        mt = max_tokens or self.config.max_tokens
        try:
            resp = self.llm(
                prompt,
                max_tokens=mt,
                temperature=self.config.temperature,
                top_p=self.config.top_p,
                top_k=self.config.top_k,
                stop=stops,
                echo=False
            )
            return resp["choices"][0]["text"].strip()
        except Exception as e:
            return f"Error generating response: {str(e)}"
    async def search_web(self, query: str, num_results: int = 10) -> List[Dict]:
        if self.config.search_api_key:
            return await self.search_serper(query, num_results)
        return []
    async def search_serper(self, query: str, num_results: int) -> List[Dict]:
        url = "https://google.serper.dev/search"
        payload = {"q": query, "num": num_results}
        headers = {"X-API-KEY": self.config.search_api_key, "Content-Type": "application/json"}
        async with aiohttp.ClientSession() as session:
            async with session.post(url, json=payload, headers=headers) as response:
                data = await response.json()
                results = []
                for item in data.get('organic', []):
                    results.append({
                        'title': item.get('title', ''),
                        'url': item.get('link', ''),
                        'snippet': item.get('snippet', ''),
                        'source': 'web'
                    })
                return results
    def generate_search_queries(self, topic: str, focus_area: str, depth: str) -> List[str]:
        counts = {'surface': 5, 'moderate': 8, 'deep': 15, 'comprehensive': 25}
        n = counts.get(depth, 8)
        base = [
            f"{topic} overview",
            f"{topic} recent developments",
            f"{topic} academic studies",
            f"{topic} case studies",
            f"{topic} policy and regulation",
            f"{topic} technical approaches",
            f"{topic} market analysis",
            f"{topic} statistics and data",
        ]
        return base[:n]
Kode di atas memecah fungsi inti sebagai berikut:
generate_response() function: Fungsi ini menangani semua interaksi model Jan-v1 dengan penanganan kesalahan yang tepat dan urutan stop yang dapat dikonfigurasi. Ini memastikan generasi teks yang konsisten dan berkualitas tinggi untuk sintesis riset.search_web() dan search_serper() functions: Fungsi-fungsi ini mengimplementasikan penelusuran web asinkron menggunakan API Serper, memungkinkan pencarian cepat dan paralel di banyak kueri. Desain async mencegah UI macet selama operasi riset.generate_search_queries() function: Untuk membuat kueri penelusuran beragam berdasarkan kedalaman riset dan topik fokus, kita mengimplementasikan fungsi generate_search_queries(). Ini memastikan cakupan komprehensif atas subjek riset, mulai dari gambaran umum dan pendekatan teknis hingga studi kasus, regulasi, dan analisis pasar. Ini memungkinkan pengguna menyesuaikan jumlah kueri dari 5 hingga 25 bergantung pada kedalaman yang dipilih (surface, moderate, deep, atau comprehensive).Sistem generasi respons ini membentuk inti otomasi riset kita, menggabungkan kemampuan penalaran Jan-v1 dengan penelusuran web waktu nyata untuk membuat laporan riset.
Selanjutnya, kita akan mengimplementasikan mesin sintesis riset yang mengubah hasil penelusuran mentah menjadi laporan profesional yang rapi.
def synthesize_research(self, topic: str, search_results: List[Dict], focus_area: str, report_format: str) -> str:
        context_lines = []
        for i, result in enumerate(search_results[:20]):
            title = result.get("title", "")
            snippet = result.get("snippet", "")
            context_lines.append(f"Source {i+1} Title: {title}\nSource {i+1} Summary: {snippet}")
        context = "\n".join(context_lines)
        sections = sections_for_format(report_format)
        sections_text = "\n".join(sections)
        synthesis_prompt = f"""
You are an expert research analyst. Write the final, polished report on: "{topic}" for a professional, real-world audience.
***CRITICAL INSTRUCTIONS:***
- Your entire response MUST be the final report, wrapped **EXACTLY** inside <final> and </final> tags.
- DO NOT output any text, thoughts, or commentary BEFORE the <final> tag or AFTER the </final> tag.
- DO NOT include any conversational filler, internal thoughts, or commentary about the generation process (e.g., "As an AI...", "I will now summarize...", "Here is your report:").
- DO NOT use markdown formatting (e.g., #, ##, *, -).
- DO NOT use bullet points or lists.
- Maintain a formal, academic/professional tone throughout.
- Ensure the report is complete and self-contained.
- Include the following section headers, in this order, and no others:
{sections_text}
Guidance:
- Base your writing strictly on the Research Notes provided below. If the notes lack specific data, write a careful, methodology-forward analysis without inventing facts or numbers.
Research Notes:
{context}
Now produce ONLY the final report:
<final>
...your report here...
</final>
"""
        raw = self.generate_response(synthesis_prompt, max_tokens=1800, extra_stops=["</final>"])
        final_report = extract_final_block(raw)
        final_report = re.sub(r"(?m)^\s*[-*•]\s+", "", final_report)
        final_report = re.sub(r"[#`*_]{1,3}", "", final_report)
        first = next((h for h in sections if h in final_report), None)
        if first:
            final_report = final_report[final_report.find(first):].strip()
        return final_report
Kode di atas memanfaatkan kemampuan penalaran lanjutan Jan-v1 untuk mengubah hasil penelusuran web mentah menjadi laporan profesional yang biasanya memerlukan berjam-jam riset dan penulisan manual. Mari pahami kemampuan kunci secara rinci:
sections_for_format(), kita menghasilkan judul bagian laporan yang disesuaikan dengan format keluaran yang dipilih, yang disuntikkan ke dalam prompt dengan aturan generasi ketat untuk membatasi perilaku model.<final>...</final> dan melarang scaffolding percakapan, model dicegah menambahkan teks tidak relevan, ringkasan spekulatif, atau pembingkaian yang berulang.regex untuk menghapus artefak markdown, penanda daftar, dan pemformatan yang tersisa. Fungsi juga memastikan keluaran dimulai dari header bagian valid pertama untuk meningkatkan konsistensi struktur.Terakhir, kita akan membangun antarmuka pengguna lengkap yang menyatukan semua kemampuan riset kita dalam sebuah aplikasi interaktif.
def main():
    st.set_page_config(page_title="Deep Research Assistant", page_icon="", layout="wide")
    st.markdown("""
    <div style="background: linear-gradient(135deg, #667eea 0%, #764ba2 100%); padding: 1.25rem; border-radius: 10px; color: white; text-align: center; margin-bottom: 1rem;">
        <h1 style="margin:0;"> Deep Research Assistant</h1>
    </div>
    """, unsafe_allow_html=True)
    if 'research_assistant' not in st.session_state:
        config = ResearchConfig()
        st.session_state.research_assistant = DeepResearchAssistant(config)
        st.session_state.model_loaded = st.session_state.research_assistant.load_model()
        st.session_state.research_results = None
    if not st.session_state.research_assistant.config.search_api_key:
        st.warning("SERPER_API_KEY not found in environment. Using fallback demo results.")
    st.header("Research Configuration")
    research_topic = st.text_area(
        "Research Topic",
        placeholder="e.g., Impact of artificial intelligence on healthcare efficiency and patient outcomes",
        height=100
    )
    col1a, col1b = st.columns(2)
    with col1a:
        research_depth = st.selectbox(
            "Research Depth",
            ["surface", "moderate", "deep", "comprehensive"],
            index=1,
            format_func=lambda x: {
                "surface": "Surface (5-8 sources)",
                "moderate": "Moderate (10-15)",
                "deep": "Deep Dive (20-30)",
                "comprehensive": "Comprehensive (40+)"
            }[x]
        )
        focus_area = st.selectbox("Focus Area", ["general", "academic", "business", "technical", "policy"], index=0, format_func=str.title)
    with col1b:
        time_frame = st.selectbox(
            "Time Frame",
            ["current", "recent", "comprehensive"],
            index=1,
            format_func=lambda x: {"current":"Current (≤6 months)","recent":"Recent (≤2 years)","comprehensive":"All time"}[x]
        )
        report_format = st.selectbox(
            "Report Format",
            ["executive", "detailed", "academic", "presentation"],
            index=1,
            format_func=lambda x: {
                "executive":"Executive Summary",
                "detailed":"Detailed Analysis",
                "academic":"Academic Style",
                "presentation":"Presentation Format"
            }[x]
        )
    if st.button("Start Deep Research", type="primary", use_container_width=True):
        if not st.session_state.model_loaded:
            st.error("Model not loaded. See terminal logs for details.")
        elif not research_topic.strip():
            st.error("Please enter a research topic.")
        else:
            start_research(research_topic, research_depth, focus_area, time_frame, report_format)
    if st.session_state.research_results:
        display_research_results(st.session_state.research_results)
def start_research(topic: str, depth: str, focus: str, timeframe: str, format_type: str):
    assistant = st.session_state.research_assistant
    progress_bar = st.progress(0)
    status_text = st.empty()
    try:
        status_text.text("Generating search queries...")
        progress_bar.progress(15)
        queries = assistant.generate_search_queries(topic, focus, depth)
        status_text.text("Searching sources...")
        progress_bar.progress(40)
        all_results = []
        for i, query in enumerate(queries):
            loop = asyncio.new_event_loop()
            asyncio.set_event_loop(loop)
            results = loop.run_until_complete(assistant.search_web(query, 5))
            all_results.extend(results)
            loop.close()
            progress_bar.progress(40 + int(((i + 1) / max(1, len(queries))) * 30))
            time.sleep(0.05)
        status_text.text("Synthesizing report...")
        progress_bar.progress(80)
        research_report = assistant.synthesize_research(topic, all_results, focus, format_type)
        status_text.text("Done.")
        progress_bar.progress(100)
        st.session_state.research_results = {
            'topic': topic,
            'report': research_report,
            'sources': all_results,
            'queries': queries,
            'config': {'depth': depth, 'focus': focus, 'timeframe': timeframe, 'format': format_type},
            'timestamp': datetime.now()
        }
        time.sleep(0.3)
        status_text.empty()
        progress_bar.empty()
    except Exception as e:
        st.error(f"Research failed: {str(e)}")
        status_text.empty()
        progress_bar.empty()
def display_research_results(results: Dict):
    st.header("Research Report")
    st.subheader(f"Topic: {results['topic']}")
    st.markdown(
        f'<div style="background:#f8f9ff;padding:1rem;border-radius:10px;border:1px solid #e1e8ed;">{results["report"]}</div>',
        unsafe_allow_html=True,
    )
    with st.expander("Sources", expanded=False):
        for i, source in enumerate(results['sources'][:12]):
            st.markdown(f"""
            <div style="background:#fff;padding:0.75rem;border-radius:8px;border:1px solid #e1e8ed;margin:0.4rem 0;">
                <h4 style="margin:0 0 .25rem 0;">{source['title']}</h4>
                <p style="margin:0 0 .25rem 0;">{source['snippet']}</p>
                <small><a href="{source['url']}" target="_blank">{source['url']}</a></small>
            </div>
            """, unsafe_allow_html=True)
    st.markdown("### Export")
    c1, c2, c3 = st.columns(3)
    with c1:
        report_text = f"Research Report: {results['topic']}\n\n{results['report']}"
        st.download_button("Download Text", data=report_text, file_name=f"research_report_{datetime.now().strftime('%Y%m%d_%H%M%S')}.txt", mime="text/plain")
    with c2:
        json_data = json.dumps(results, default=str, indent=2)
        st.download_button("Download JSON", data=json_data, file_name=f"research_data_{datetime.now().strftime('%Y%m%d_%H%M%S')}.json", mime="application/json")
    with c3:
        if st.button("Start New Research"):
            st.session_state.research_results = None
            st.experimental_rerun()
if __name__ == "__main__":
    main()
Kode di atas dibagi ke dalam lapisan mulai dari pemuatan model dan pengumpulan masukan pengguna hingga pembuatan kueri, penelusuran web, dan sintesis laporan akhir. Mari bahas lapisan-lapisan ini secara rinci:
DeepResearchAssistant diinisialisasi sekali per sesi menggunakan st.session_state, mempertahankan status model dan menghindari pemuatan berulang. asyncio, memastikan eksekusi kueri paralel tanpa mengorbankan responsivitas UI.TXT atau JSON atau menjalankan ulang alur kerja dengan sekali klik.Untuk mencobanya sendiri, simpan kode sebagai app.py dan jalankan:
streamlit run app.pyPelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




