
Last chance! 50% off DataCamp Premium
Sale ends in
हाल ही में Jan टीम ने Jan-v1 जारी किया है—एक उन्नत एजेंटिक रीजनिंग मॉडल जो बेहतर टूल उपयोग और मल्टी-स्टेप समस्या समाधान के माध्यम से परिष्कृत रिसर्च ऑटोमेशन क्षमताएँ लाता है।
इस ट्यूटोरियल में मेरा फोकस Jan-v1 की विशिष्ट एजेंटिक रीजनिंग क्षमताओं पर रहेगा, जिसमें मैं दिखाऊंगा कि यह किस तरह से llama.cpp द्वारा संचालित लोकल-डिप्लॉय Streamlit इंटरफेस के माध्यम से एक जटिल रिसर्च वर्कफ़्लो की तरह कार्य करता है।
इस ट्यूटोरियल में, मैं समझाऊंगा कि कैसे:
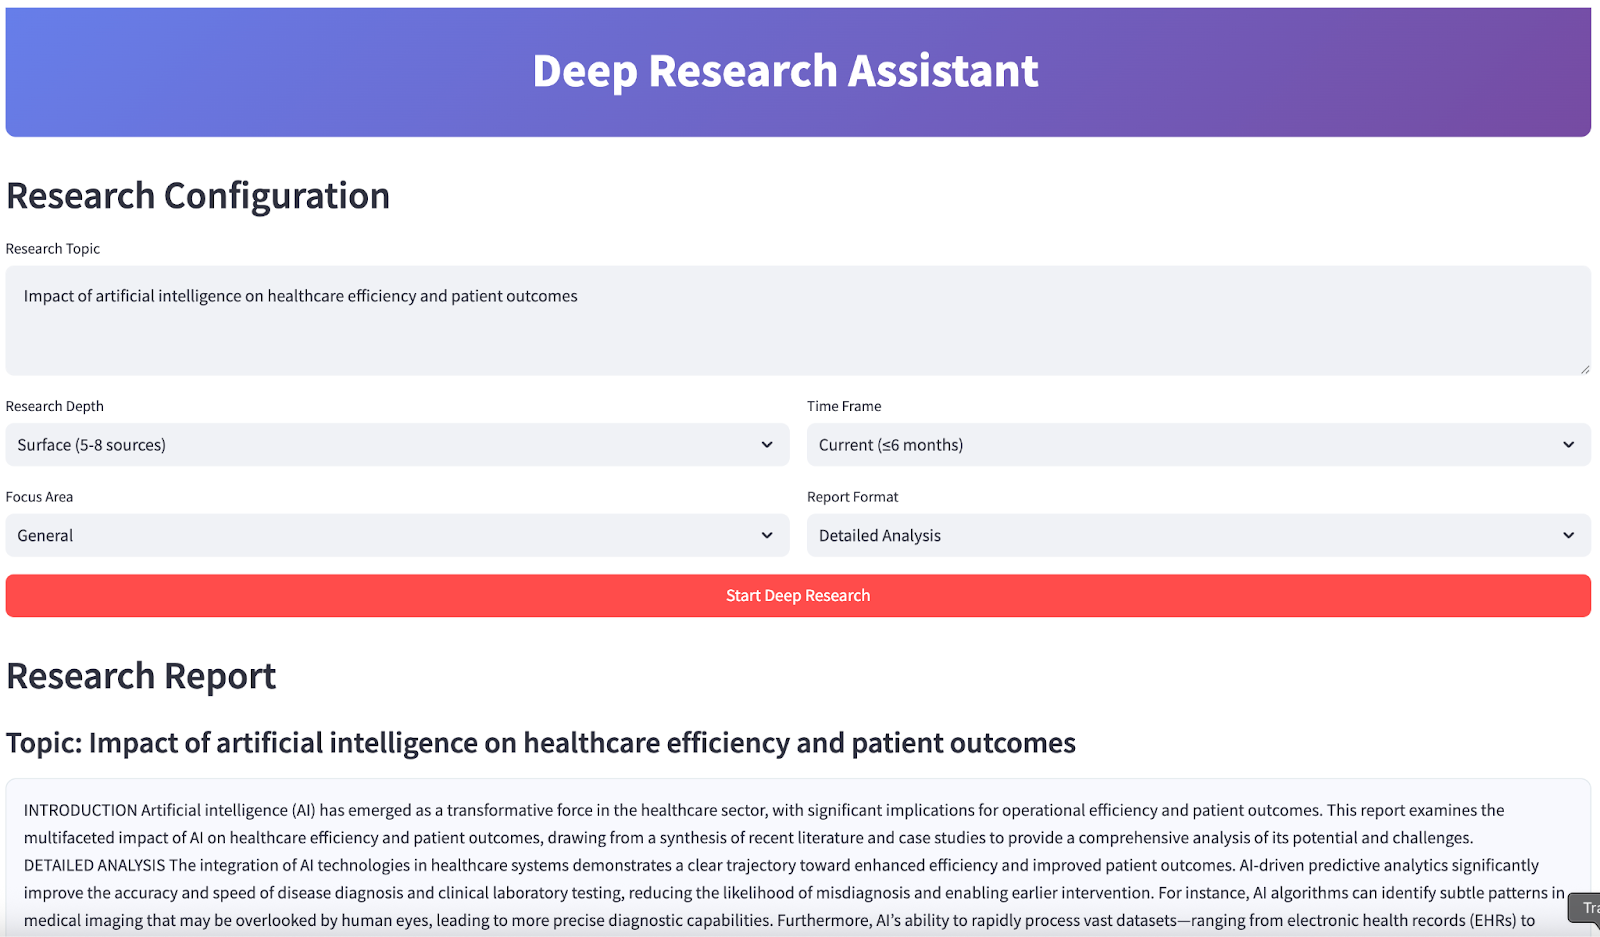
अंत में, आपका ऐप इस तरह दिखेगा:
Jan-v1 एक 4B-पैरामीटर मॉडल है जो Lucy और Qwen3-4B-thinking फाउंडेशन पर आधारित है। इसे टूल उपयोग, मल्टी-स्टेप रीजनिंग और ऑटोमेटेड रिसर्च जैसे एजेंटिक वर्कफ़्लोज़ के लिए डिज़ाइन किया गया है। पारंपरिक LLMs के विपरीत, Jan-v1 संरचित स्कैफोल्डिंग और बर्ताव-संरेखित रिवार्ड्स के माध्यम से टूल्स, डेटा स्रोतों और रीजनिंग स्टेप्स के बीच समन्वय में उत्कृष्ट है।
इस मॉडल की कुछ प्रमुख विशेषताएँ यहाँ हैं:
इस प्रोजेक्ट के लिए, हम Llama.cpp का उपयोग करते हुए GGUF क्वांटाइज़्ड वर्ज़न के साथ Jan-v1 को लोकल रूप से डिप्लॉय करेंगे ताकि प्रदर्शन और संसाधन-कुशलता सर्वोत्तम रहे।
सबसे पहले यह सुनिश्चित करें कि आपके पास आवश्यक Python पैकेज हैं:
pip install llama-cpp-python==0.3.15
pip install streamlit aiohttp
यह कमांड AI मॉडल इंटीग्रेशन, वेब इंटरफेस निर्माण और असिंक्रोनस वेब ऑपरेशंस के लिए सभी कोर डिपेंडेंसीज़ इंस्टॉल करती है।
मॉडल डाउनलोड करने से पहले, निम्न कमांड का उपयोग करके models/ नाम की एक नई डायरेक्टरी बनाएं:
mkdir -p modelsफिर, निम्न कमांड का उपयोग करके मॉडल डाउनलोड करें:
curl -L https://huggingface.co/janhq/Jan-v1-4B-GGUF/resolve/main/Jan-v1-4B-Q4_K_M.gguf -o Jan-v1-4B-Q4_K_M.ggufइस चरण को पूरा करने पर, आपने GGUF फॉर्मेट में Jan-v1 4B मॉडल सफलतापूर्वक डाउनलोड कर लिया है और उसे models/ डायरेक्टरी में रख दिया है। यह क्वांटाइज़्ड वर्ज़न प्रदर्शन और मेमोरी दक्षता के बीच संतुलन देता है, जो CPUs या Colab पर लोकल इन्फ्रेंस के लिए आदर्श है।
अपने Serper खाते में साइन अप या लॉगिन करें: https://serper.dev/api-keys और API Keys टैब चुनें, फिर इस डेमो के लिए डिफ़ॉल्ट API कुंजी कॉपी करें। आइए इस कुंजी को निम्न प्रकार से वातावरण चर (environment variable) के रूप में सेट करें:
export SERPER_API_KEY=xxxxxxxxxxxxxxxxxxxxxxxxxxx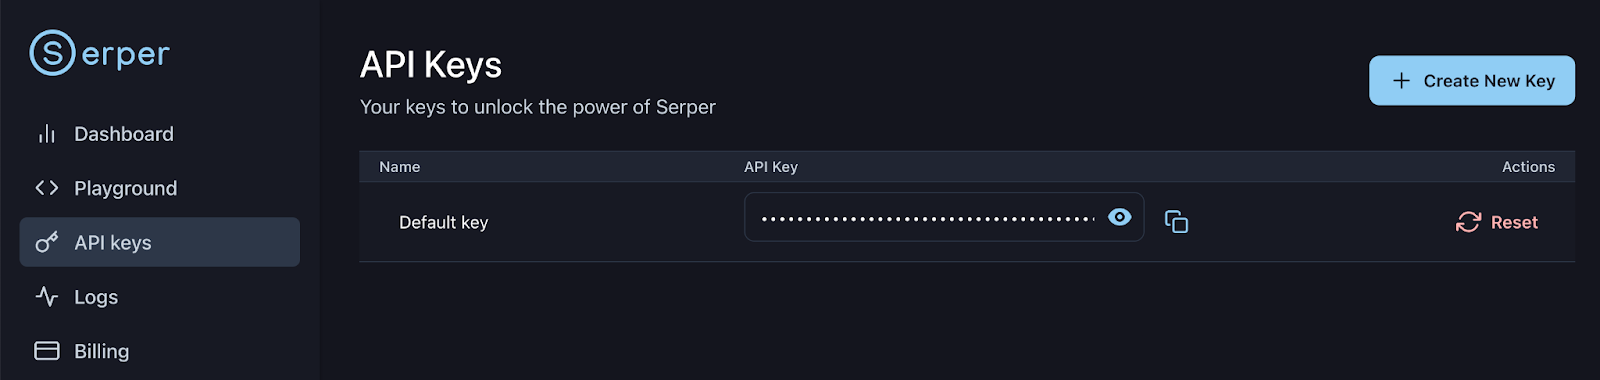
अब आप अपने रिसर्च असिस्टेंट पाइपलाइन में मॉडल को लोड करने और उसके साथ इंटरैक्ट करने के लिए तैयार हैं।
आइए एक Streamlit एप्लिकेशन बनाते हैं जो Jan-v1 की उन्नत रिसर्च क्षमताएँ दर्शाता है—इंटेलिजेंट क्वेरी जनरेशन, ऑटोमेटेड वेब सर्च (Serper का उपयोग करते हुए) और प्रोफेशनल रिपोर्ट सिंथेसिस के साथ।
हम अपने रिसर्च असिस्टेंट के लिए आवश्यक सभी लाइब्रेरीज़ इम्पोर्ट करके शुरुआत करेंगे। ये वेब इंटरफेस निर्माण से लेकर असिंक्रोनस वेब सर्चिंग और लोकल AI मॉडल इंटीग्रेशन तक सब कुछ सपोर्ट करती हैं।
import streamlit as st
import json
import time
import re
from datetime import datetime
from typing import List, Dict, Optional
import asyncio
import aiohttp
from llama_cpp import Llama
import os
from dataclasses import dataclass
हमने ऐप में प्रयुक्त सभी कोर लाइब्रेरीज़ इम्पोर्ट की हैं। इनमें UI कंपोनेंट्स (Streamlit), कंकरेन्सी टूल्स (asyncio, aiohttp) और LLM बैकएंड (llama_cpp) शामिल हैं। साथ ही हम पार्सिंग, टाइपिंग और डेट हैंडलिंग के यूटिलिटीज़ भी लाते हैं।
अब, हम कुछ हेल्पर फंक्शंस लागू करेंगे जो रिपोर्ट फॉर्मैटिंग और कंटेंट एक्सट्रैक्शन को संभालते हैं। ये फंक्शंस सुनिश्चित करते हैं कि जेनरेट की गई रिपोर्टें प्रोफेशनल क्वालिटी और सुसंगत संरचना बनाए रखें।
def sections_for_format(fmt: str) -> list[str]:
    fmt = (fmt or "").strip().lower()
    if fmt == "executive":
        return ["EXECUTIVE SUMMARY"]
    if fmt == "detailed":
        return [
            "INTRODUCTION",
            "DETAILED ANALYSIS",
            "CURRENT TRENDS AND DEVELOPMENTS",
            "IMPLICATIONS AND RECOMMENDATIONS",
            "CONCLUSION",
        ]
    if fmt == "academic":
        return [
            "ABSTRACT",
            "INTRODUCTION",
            "METHODOLOGY",
            "FINDINGS",
            "DISCUSSION",
            "CONCLUSION",
        ]
    if fmt == "presentation":
        return [
            "OVERVIEW",
            "KEY INSIGHTS",
            "RECOMMENDATIONS",
            "NEXT STEPS",
            "CONCLUSION",
        ]
    return ["INTRODUCTION", "DETAILED ANALYSIS", "CONCLUSION"]
def extract_final_block(text: str) -> str:
    m = re.search(r"<final>([\s\S]*?)</final>", text, flags=re.IGNORECASE)
    if m:
        cleaned_text = m.group(1).strip()
    else:
        cleaned_text = text
    preamble_patterns = [
        r"^(?:note:|okay,|hmm,|internal|let me|i (?:will|’ll)|as an ai|thinking|plan:|here is your report|the following is|i have prepared|i am presenting|based on the provided information|below is the report|i hope this meets your requirements|this report outlines|this is the final report).*?$",
        r"^(?:Here is the report|I have compiled the report|The report is provided below|This is the requested report).*?$", # More specific preambles
        r"^(?:Please find the report below|Here's the report).*?$"
    ]
    for pattern in preamble_patterns:
        cleaned_text = re.sub(pattern, "", cleaned_text, flags=re.IGNORECASE | re.MULTILINE).strip()
    cleaned_text = re.sub(r"(?m)^\s*[-*•]\s+", "", cleaned_text)
    cleaned_text = re.sub(r"[#`*_]{1,3}", "", cleaned_text)
    headers = [
        "EXECUTIVE SUMMARY","INTRODUCTION","DETAILED ANALYSIS","CURRENT TRENDS AND DEVELOPMENTS",
        "IMPLICATIONS AND RECOMMENDATIONS","CONCLUSION","ABSTRACT","METHODOLOGY","FINDINGS",
        "DISCUSSION","OVERVIEW","KEY INSIGHTS","RECOMMENDATIONS","NEXT STEPS"
    ]
    sorted_headers = sorted(headers, key=len, reverse=True)
    first_pos = -1
    for h in sorted_headers:
        match = re.search(r'\b' + re.escape(h) + r'\b', cleaned_text, flags=re.IGNORECASE)
        if match:
            if first_pos == -1 or match.start() < first_pos:
                first_pos = match.start()
    if first_pos >= 0:
        cleaned_text = cleaned_text[first_pos:].strip()
    return cleaned_text
प्रत्येक फंक्शन पाइपलाइन में इस प्रकार फिट होता है:
sections_for_format() फंक्शन: यह फंक्शन चुने गए रिपोर्ट फॉर्मेट (जैसे executive, detailed, academic) के अनुरूप सेक्शन हेडर जनरेट करता है। इससे हर रिपोर्ट पेशेवर मानकों का पालन करती है और उपयोगकर्ता की अपेक्षाओं को पूरा करती है।extract_final_block() फंक्शन: यह पोस्ट-प्रोसेसिंग चरण मुख्य रिपोर्ट कंटेंट को अलग करता है। यह <final> टैग्स के बीच का टेक्स्ट निकालता है और प्रीऐम्बल, फुलर वाक्यांशों और मार्कडाउन आर्टिफैक्ट्स को हटाता है। यह मानक हेडर (जैसे "INTRODUCTION", "SUMMARY") की सबसे शुरुआती उपस्थिति भी पहचानता है ताकि अप्रासंगिक आरंभी टेक्स्ट हटाया जा सके, और अंतिम आउटपुट साफ़, संरचित और उपयोग के लिए तैयार हो।ये हेल्पर फंक्शंस Jan-v1 जैसे थिंकिंग मॉडल के लिए अलग-अलग रिपोर्ट फॉर्मैट्स और रिसर्च परिदृश्यों में एकसमान, उच्च-गुणवत्ता वाले आउटपुट बनाए रखने में अहम हैं।
आइए कोर कॉन्फ़िगरेशन सिस्टम स्थापित करें जो मॉडल पैरामीटर्स, API सेटिंग्स और रिसर्च प्राथमिकताओं को मैनेज करता है। यह मॉड्यूलर अप्रोच आसान कस्टमाइज़ेशन और इष्टतम प्रदर्शन सुनिश्चित करती है।
यह चरण Jan-v1 मॉडल के साथ कुशल लोकल इन्फ्रेंस के लिए एक कॉन्फ़िगरेशन सिस्टम और मॉडल लोडर परिभाषित करता है। सिस्टम CPU-ओनली वातावरणों—जैसे लैपटॉप या Colab Pro—पर पुनरुत्पादन योग्य रिसर्च कार्यों का समर्थन करने के लिए डिज़ाइन किया गया है, जबकि लचीलापन और सेफ्टी बनाए रखता है।
@dataclass
class ResearchConfig:
    model_path: str = "models/Jan-v1-4B-Q4_K_M.gguf" #change as per your location
    max_tokens: int = 2048
    temperature: float = 0.6
    top_p: float = 0.95
    top_k: int = 20
    context_length: int = 4096
    search_api_key: str = os.getenv("SERPER_API_KEY", "")
    search_engine: str = "serper"
ऊपर दिए कोड का कॉन्फ़िगरेशन अवलोकन:
ResearchConfig एक @dataclass है जो सभी LLM और सर्च इंजन कॉन्फ़िगरेशन को केंद्रीकृत करता है, जिससे अलग-अलग रिसर्च परिदृश्यों के लिए ट्यूनिंग आसान हो जाती है।temperature, top_p, और top_k जैसे पैरामीटर्स रचनात्मकता और तथ्यों में ग्राउंडिंग के बीच संतुलन के लिए सेट हैं, जो रिसर्च-उन्मुख आउटपुट के लिए महत्वपूर्ण है।context_length 4096 टोकन पर सेट है, जो Jan-v1 की लॉन्ग-फॉर्म रीजनिंग क्षमताओं के लिए अनुकूलित है।search_api_key Serper के साथ रीयल-टाइम वेब सर्च ऑगमेंटेशन सक्षम करता है।इस चरण में, हम एक Deep Research असिस्टेंट क्लास परिभाषित करते हैं जो सभी रिसर्च कार्यों के लिए कोर कंट्रोलर के रूप में कार्य करता है—लो-लेवल मॉडल और कॉन्फ़िग हैंडलिंग को एब्स्ट्रैक्ट करते हुए जेनरेशन, सर्च और सिंथेसिस के लिए हाई-लेवल इंटरफेसेज़ उपलब्ध कराता है।
class DeepResearchAssistant:
    def __init__(self, config: ResearchConfig):
        self.config = config
        self.llm = None
        self.demo_mode = False
    def load_model(self):
        try:
            if not os.path.exists(self.config.model_path):
                print(f"Model file not found: {self.config.model_path}")
                return False
            file_size_gb = os.path.getsize(self.config.model_path) / (1024**3)
            if file_size_gb < 1.0:
                print(f"Model file too small ({file_size_gb:.1f} GB).")
                return False
            self.llm = Llama(
                model_path=self.config.model_path,
                n_ctx=self.config.context_length,
                verbose=False,
                n_threads=max(1, min(4, os.cpu_count() // 2)),
                n_gpu_layers=0,
                use_mmap=True,
                use_mlock=False,
                n_batch=128,
                f16_kv=True,
            )
            test = self.llm("Hi", max_tokens=3, temperature=0.1, echo=False)
            ok = bool(test and 'choices' in test)
            print("Model loaded " if ok else "Model loaded but test generation failed ")
            return ok
        except Exception as e:
            print(f"Model loading failed: {e}")
            return False
DeepResearchAssistant क्लास मुख्य ऑर्केस्ट्रेटर है जो मॉडल लोडिंग, कॉन्फ़िगरेशन वैलिडेशन मैनेज करता है और रिसर्च ऑपरेशंस के लिए क्लीन इंटरफेस प्रदान करता है। यह कॉन्फ़िगरेशन सिस्टम एरर हैंडलिंग और वैलिडेशन देता है, जिससे मॉडल सही तरीके से लोड हो और रिसर्च कार्यों के लिए तैयार रहे। इस क्लास की प्रमुख विशेषताएँ:
load_model() विधि llama-cpp-python का उपयोग करके Jan-v1 GGUF मॉडल को सुरक्षित रूप से इनिशियलाइज़ करती है, लोकल CPU इन्फ्रेंस के लिए ऑप्टिमाइज़्ड।use_mmap=True का उपयोग करते हैं ताकि पूर्ण RAM उपयोग के बिना कुशल डिस्क-बैक्ड लोडिंग सक्षम हो।f16_kv=True सक्षम करते हैं। n_gpu_layers=0 पैरामीटर CPU-ओनली निष्पादन सुनिश्चित करता है।यह सेटअप तेज, हल्का लोकल इन्फ्रेंस सुनिश्चित करता है—बिना GPU के लैपटॉप या Colab पर Jan-v1 चलाने के लिए आदर्श।
अगला, हम कोर रिस्पॉन्स जेनरेशन सिस्टम और वेब सर्च क्षमताएँ लागू करेंगे जो हमारे रिसर्च ऑटोमेशन को शक्ति देती हैं। इसके लिए हम Serper API सेवाओं का उपयोग करते हैं, जैसा कि नीचे दिखाया गया है:
def generate_response(self, prompt: str, max_tokens: int = None, extra_stops: Optional[List[str]] = None) -> str:
        if not self.llm:
            return "Model not loaded."
        stops = ["</s>", "<|im_end|>", "<|endoftext|>"]
        if extra_stops:
            stops.extend(extra_stops)
        mt = max_tokens or self.config.max_tokens
        try:
            resp = self.llm(
                prompt,
                max_tokens=mt,
                temperature=self.config.temperature,
                top_p=self.config.top_p,
                top_k=self.config.top_k,
                stop=stops,
                echo=False
            )
            return resp["choices"][0]["text"].strip()
        except Exception as e:
            return f"Error generating response: {str(e)}"
    async def search_web(self, query: str, num_results: int = 10) -> List[Dict]:
        if self.config.search_api_key:
            return await self.search_serper(query, num_results)
        return []
    async def search_serper(self, query: str, num_results: int) -> List[Dict]:
        url = "https://google.serper.dev/search"
        payload = {"q": query, "num": num_results}
        headers = {"X-API-KEY": self.config.search_api_key, "Content-Type": "application/json"}
        async with aiohttp.ClientSession() as session:
            async with session.post(url, json=payload, headers=headers) as response:
                data = await response.json()
                results = []
                for item in data.get('organic', []):
                    results.append({
                        'title': item.get('title', ''),
                        'url': item.get('link', ''),
                        'snippet': item.get('snippet', ''),
                        'source': 'web'
                    })
                return results
    def generate_search_queries(self, topic: str, focus_area: str, depth: str) -> List[str]:
        counts = {'surface': 5, 'moderate': 8, 'deep': 15, 'comprehensive': 25}
        n = counts.get(depth, 8)
        base = [
            f"{topic} overview",
            f"{topic} recent developments",
            f"{topic} academic studies",
            f"{topic} case studies",
            f"{topic} policy and regulation",
            f"{topic} technical approaches",
            f"{topic} market analysis",
            f"{topic} statistics and data",
        ]
        return base[:n]
उपरोक्त कोड कोर फंक्शनैलिटी को इस प्रकार विभाजित करता है:
generate_response() फंक्शन: यह फंक्शन उचित एरर हैंडलिंग और कॉन्फ़िगरेबल स्टॉप सीक्वेंसेज़ के साथ Jan-v1 मॉडल इंटरैक्शन संभालता है। इससे रिसर्च सिंथेसिस के लिए एकसमान, उच्च-गुणवत्ता वाला टेक्स्ट जेनरेशन सुनिश्चित होता है।search_web() और search_serper() फंक्शंस: ये फंक्शंस Serper API का उपयोग करके असिंक्रोनस वेब सर्च लागू करते हैं, जिससे कई क्वेरियों पर तेज, पैरेलल सर्च संभव होती है। Async डिज़ाइन रिसर्च ऑपरेशंस के दौरान UI ब्लॉकिंग को रोकता है।generate_search_queries() फंक्शन: रिसर्च डेप्थ और फोकस टॉपिक के आधार पर विविध सर्च क्वेरियाँ बनाने के लिए हम generate_search_queries() लागू करते हैं। यह विषय की व्यापक कवरेज सुनिश्चित करता है—ओवरव्यू और टेक्निकल अप्रोच से लेकर केस स्टडीज़, रेगुलेशंस और मार्केट एनालिसिस तक। उपयोगकर्ता चुनी गई डेप्थ (surface, moderate, deep, comprehensive) के अनुसार 5 से 25 तक क्वेरियों का स्केल कर सकता है।यह रिस्पॉन्स जेनरेशन सिस्टम Jan-v1 की रीजनिंग क्षमताओं को रीयल-टाइम वेब सर्च के साथ जोड़ता है ताकि रिसर्च रिपोर्टें तैयार की जा सकें—जो हमारे रिसर्च ऑटोमेशन का मूल है।
अब हम एक रिसर्च सिंथेसिस इंजन लागू करेंगे जो कच्चे सर्च परिणामों को पॉलिश्ड, प्रोफेशनल रिपोर्ट में बदलता है।
def synthesize_research(self, topic: str, search_results: List[Dict], focus_area: str, report_format: str) -> str:
        context_lines = []
        for i, result in enumerate(search_results[:20]):
            title = result.get("title", "")
            snippet = result.get("snippet", "")
            context_lines.append(f"Source {i+1} Title: {title}\nSource {i+1} Summary: {snippet}")
        context = "\n".join(context_lines)
        sections = sections_for_format(report_format)
        sections_text = "\n".join(sections)
        synthesis_prompt = f"""
You are an expert research analyst. Write the final, polished report on: "{topic}" for a professional, real-world audience.
***CRITICAL INSTRUCTIONS:***
- Your entire response MUST be the final report, wrapped **EXACTLY** inside <final> and </final> tags.
- DO NOT output any text, thoughts, or commentary BEFORE the <final> tag or AFTER the </final> tag.
- DO NOT include any conversational filler, internal thoughts, or commentary about the generation process (e.g., "As an AI...", "I will now summarize...", "Here is your report:").
- DO NOT use markdown formatting (e.g., #, ##, *, -).
- DO NOT use bullet points or lists.
- Maintain a formal, academic/professional tone throughout.
- Ensure the report is complete and self-contained.
- Include the following section headers, in this order, and no others:
{sections_text}
Guidance:
- Base your writing strictly on the Research Notes provided below. If the notes lack specific data, write a careful, methodology-forward analysis without inventing facts or numbers.
Research Notes:
{context}
Now produce ONLY the final report:
<final>
...your report here...
</final>
"""
        raw = self.generate_response(synthesis_prompt, max_tokens=1800, extra_stops=["</final>"])
        final_report = extract_final_block(raw)
        final_report = re.sub(r"(?m)^\s*[-*•]\s+", "", final_report)
        final_report = re.sub(r"[#`*_]{1,3}", "", final_report)
        first = next((h for h in sections if h in final_report), None)
        if first:
            final_report = final_report[final_report.find(first):].strip()
        return final_report
उपरोक्त कोड Jan-v1 की उन्नत रीजनिंग क्षमताओं का लाभ उठाता है ताकि कच्चे वेब सर्च परिणामों को उन प्रोफेशनल रिपोर्टों में बदला जा सके जो सामान्यतः घंटों के मैनुअल रिसर्च और लेखन की माँग करती हैं। प्रमुख क्षमताओं को विस्तार से समझें:
sections_for_format() फंक्शन का उपयोग करके, हम चयनित आउटपुट फॉर्मेट के अनुरूप रिपोर्ट सेक्शन हेडर्स जनरेट करते हैं, जिन्हें कड़े जेनरेशन नियमों के साथ प्रॉम्प्ट में डाला जाता है ताकि मॉडल के व्यवहार को नियंत्रित किया जा सके।<final>...</final> टैग्स के उपयोग को लागू करके और बातचीत संबंधी स्कैफोल्डिंग पर रोक लगाकर, मॉडल को अप्रासंगिक टेक्स्ट, अटकलें लगाने वाले सारांश, या अनावश्यक फ्रेमिंग शामिल करने से रोका जाता है।regex फ़िल्टर्स से क्लीन किया जाता है ताकि मार्कडाउन आर्टिफैक्ट्स, लिस्ट मार्कर्स और बिखरी फॉर्मैटिंग हटाई जा सके। फंक्शन यह भी सुनिश्चित करता है कि आउटपुट पहले वैध सेक्शन हेडर से शुरू हो, जिससे संरचनात्मक एकरूपता में सुधार हो।अंततः, हम पूर्ण यूज़र इंटरफेस बनाएंगे जो हमारी सभी रिसर्च क्षमताओं को एक इंटरेक्टिव एप्लिकेशन में एकजुट करता है।
def main():
    st.set_page_config(page_title="Deep Research Assistant", page_icon="", layout="wide")
    st.markdown("""
    <div style="background: linear-gradient(135deg, #667eea 0%, #764ba2 100%); padding: 1.25rem; border-radius: 10px; color: white; text-align: center; margin-bottom: 1rem;">
        <h1 style="margin:0;"> Deep Research Assistant</h1>
    </div>
    """, unsafe_allow_html=True)
    if 'research_assistant' not in st.session_state:
        config = ResearchConfig()
        st.session_state.research_assistant = DeepResearchAssistant(config)
        st.session_state.model_loaded = st.session_state.research_assistant.load_model()
        st.session_state.research_results = None
    if not st.session_state.research_assistant.config.search_api_key:
        st.warning("SERPER_API_KEY not found in environment. Using fallback demo results.")
    st.header("Research Configuration")
    research_topic = st.text_area(
        "Research Topic",
        placeholder="e.g., Impact of artificial intelligence on healthcare efficiency and patient outcomes",
        height=100
    )
    col1a, col1b = st.columns(2)
    with col1a:
        research_depth = st.selectbox(
            "Research Depth",
            ["surface", "moderate", "deep", "comprehensive"],
            index=1,
            format_func=lambda x: {
                "surface": "Surface (5-8 sources)",
                "moderate": "Moderate (10-15)",
                "deep": "Deep Dive (20-30)",
                "comprehensive": "Comprehensive (40+)"
            }[x]
        )
        focus_area = st.selectbox("Focus Area", ["general", "academic", "business", "technical", "policy"], index=0, format_func=str.title)
    with col1b:
        time_frame = st.selectbox(
            "Time Frame",
            ["current", "recent", "comprehensive"],
            index=1,
            format_func=lambda x: {"current":"Current (≤6 months)","recent":"Recent (≤2 years)","comprehensive":"All time"}[x]
        )
        report_format = st.selectbox(
            "Report Format",
            ["executive", "detailed", "academic", "presentation"],
            index=1,
            format_func=lambda x: {
                "executive":"Executive Summary",
                "detailed":"Detailed Analysis",
                "academic":"Academic Style",
                "presentation":"Presentation Format"
            }[x]
        )
    if st.button("Start Deep Research", type="primary", use_container_width=True):
        if not st.session_state.model_loaded:
            st.error("Model not loaded. See terminal logs for details.")
        elif not research_topic.strip():
            st.error("Please enter a research topic.")
        else:
            start_research(research_topic, research_depth, focus_area, time_frame, report_format)
    if st.session_state.research_results:
        display_research_results(st.session_state.research_results)
def start_research(topic: str, depth: str, focus: str, timeframe: str, format_type: str):
    assistant = st.session_state.research_assistant
    progress_bar = st.progress(0)
    status_text = st.empty()
    try:
        status_text.text("Generating search queries...")
        progress_bar.progress(15)
        queries = assistant.generate_search_queries(topic, focus, depth)
        status_text.text("Searching sources...")
        progress_bar.progress(40)
        all_results = []
        for i, query in enumerate(queries):
            loop = asyncio.new_event_loop()
            asyncio.set_event_loop(loop)
            results = loop.run_until_complete(assistant.search_web(query, 5))
            all_results.extend(results)
            loop.close()
            progress_bar.progress(40 + int(((i + 1) / max(1, len(queries))) * 30))
            time.sleep(0.05)
        status_text.text("Synthesizing report...")
        progress_bar.progress(80)
        research_report = assistant.synthesize_research(topic, all_results, focus, format_type)
        status_text.text("Done.")
        progress_bar.progress(100)
        st.session_state.research_results = {
            'topic': topic,
            'report': research_report,
            'sources': all_results,
            'queries': queries,
            'config': {'depth': depth, 'focus': focus, 'timeframe': timeframe, 'format': format_type},
            'timestamp': datetime.now()
        }
        time.sleep(0.3)
        status_text.empty()
        progress_bar.empty()
    except Exception as e:
        st.error(f"Research failed: {str(e)}")
        status_text.empty()
        progress_bar.empty()
def display_research_results(results: Dict):
    st.header("Research Report")
    st.subheader(f"Topic: {results['topic']}")
    st.markdown(
        f'<div style="background:#f8f9ff;padding:1rem;border-radius:10px;border:1px solid #e1e8ed;">{results["report"]}</div>',
        unsafe_allow_html=True,
    )
    with st.expander("Sources", expanded=False):
        for i, source in enumerate(results['sources'][:12]):
            st.markdown(f"""
            <div style="background:#fff;padding:0.75rem;border-radius:8px;border:1px solid #e1e8ed;margin:0.4rem 0;">
                <h4 style="margin:0 0 .25rem 0;">{source['title']}</h4>
                <p style="margin:0 0 .25rem 0;">{source['snippet']}</p>
                <small><a href="{source['url']}" target="_blank">{source['url']}</a></small>
            </div>
            """, unsafe_allow_html=True)
    st.markdown("### Export")
    c1, c2, c3 = st.columns(3)
    with c1:
        report_text = f"Research Report: {results['topic']}\n\n{results['report']}"
        st.download_button("Download Text", data=report_text, file_name=f"research_report_{datetime.now().strftime('%Y%m%d_%H%M%S')}.txt", mime="text/plain")
    with c2:
        json_data = json.dumps(results, default=str, indent=2)
        st.download_button("Download JSON", data=json_data, file_name=f"research_data_{datetime.now().strftime('%Y%m%d_%H%M%S')}.json", mime="application/json")
    with c3:
        if st.button("Start New Research"):
            st.session_state.research_results = None
            st.experimental_rerun()
if __name__ == "__main__":
    main()
उपरोक्त कोड को मॉडल लोडिंग और यूज़र इनपुट कलेक्शन से लेकर क्वेरी जेनरेशन, वेब सर्च और अंतिम रिपोर्ट सिंथेसिस तक लेयर्स में विभाजित किया गया है। आइए इन लेयर्स पर विस्तार से बात करें:
DeepResearchAssistant को st.session_state का उपयोग करते हुए प्रति सेशन एक बार इनिशियलाइज़ किया जाता है, जिससे मॉडल स्टेट सुरक्षित रहता है और बार-बार लोडिंग से बचाव होता है। asyncio के माध्यम से असिंक्रोनस रूप से चलाई जाती है, जिससे UI रिस्पॉन्सिवनेस प्रभावित हुए बिना पैरेलल क्वेरी एक्सेक्यूशन होता है।TXT या JSON फॉर्मेट में एक्सपोर्ट कर सकते हैं या एक क्लिक में वर्कफ़्लो फिर से चला सकते हैं।खुद आज़माने के लिए, कोड को app.py के रूप में सेव करें और लॉन्च करें:
streamlit run app.pyइन कोर्सेज़ के साथ AI सीखें!
कोर्स
कोर्स
कोर्स
