Kursus
Pengantar Deep Learning dengan Keras
4 jam
46.4K
Pada bagian Training Script, Anda akan mengerjakan masalah super-resolusi gambar menggunakan arsitektur deep learning yang baru. Tugasnya adalah melakukan pemetaan non-linear dari citra MR otak medan rendah 3-Tesla ke citra MR otak medan tinggi 7-Tesla. Pada bagian Testing Script ini, Anda akan menggunakan bobot yang dilatih di Bagian-1 dan akan melakukan prediksi pada data yang belum pernah dilihat saat pelatihan. Anda juga akan mempelajari cara menyimpan gambar 2D sebagai volume gabungan.
Tutorial ini terbagi menjadi dua bagian, bagian pertama akan memandu Anda melalui proses pelatihan dan bagian kedua akan membahas proses pengujian.
Catatan: Anda mungkin tertarik membaca makalahnya; jika ya, Anda dapat menemukan artikelnya di sini.
Secara singkat, Anda akan membahas topik-topik berikut di Bagian-1 tutorial:
Sebelum mengikuti tutorial ini pastikan Anda memiliki versi modul yang persis sama seperti di bawah ini:
Catatan: Sebelum mulai, harap dicatat bahwa model akan dilatih pada sistem dengan prosesor Nvidia 1080 Ti GPU Xeon e5 GeForce dan RAM 32GB. Jika Anda menggunakan Jupyter Notebook, Anda perlu menambahkan tiga baris kode lagi untuk menentukan urutan perangkat CUDA dan perangkat CUDA yang terlihat menggunakan modul os.
Pada kode di bawah, Anda menetapkan variabel lingkungan di notebook menggunakan os.environ. Sebaiknya lakukan ini sebelum menginisialisasi Keras untuk membatasi backend TensorFlow Keras agar menggunakan GPU pertama. Jika mesin tempat Anda melatih memiliki GPU pada 0, pastikan untuk menggunakan 0 alih-alih 1. Anda dapat memeriksanya dengan menjalankan perintah sederhana di terminal: misalnya, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU
Pertama, Anda mengimpor semua modul yang diperlukan seperti tensorflow, numpy dan yang terpenting keras serta fungsi atau layer yang dibutuhkan seperti Input, Conv2D,MaxPooling2D, dll. karena Anda akan menggunakan semua kerangka ini untuk melatih model!
Untuk membaca gambar berformat nifti, Anda juga harus mengimpor modul bernama nibabel.
import os
import numpy as np
import math
import tensorflow as tf
import nibabel as nib
import numpy as np
from keras.layers import Input,Dense,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import RMSprop
from keras import backend as K
import scipy.misc
from sklearn.utils import shuffle
from sklearn.cross_validation import train_test_split
import matplotlib.pyplot as plt
from keras.models import model_from_json
Using TensorFlow backend.
/usr/local/lib/python3.5/dist-packages/sklearn/cross_validation.py:41: DeprecationWarning: This module was deprecated in version 0.18 in favor of the model_selection module into which all the refactored classes and functions are moved. Also, note that the interface of the new CV iterators is different from that of this module. This module will be removed in 0.20.
  "This module will be removed in 0.20.", DeprecationWarning)
Dataset brain MRI 3T dan 7T terdiri dari volume 3D di mana setiap volume memiliki total 207 irisan/gambar MRI otak yang diambil pada irisan otak yang berbeda. Setiap irisan berdimensi 173 x 173. Gambar adalah citra grayscale saluran tunggal. Total terdapat 39 subjek, masing-masing berisi pemindaian MRI seorang pasien. Format gambar bukan jpeg, png, dll., melainkan format nifti. Anda akan melihat pada bagian selanjutnya cara membaca gambar berformat nifti.
Dataset ini terdiri dari citra MR modality T1; sekuens T1 secara tradisional dianggap baik untuk evaluasi struktur anatomi. Dataset yang akan Anda gunakan hari ini terdiri dari MRI Otak 3T dan 7T.
Dataset ini bersifat publik dan tersedia untuk diunduh pada sumber ini.
28 subjek digunakan untuk pelatihan sedangkan 11 subjek sisanya akan digunakan untuk pengujian.
Pertama-tama mari definisikan dimensi data. Anda akan mengubah ukuran gambar dari 173x173 menjadi 176x176 pada bagian pembacaan data. Di sini Anda juga akan mendefinisikan direktori data, ukuran batch untuk melatih model, jumlah kanal, layer Input(), matriks train dan test sebagai daftar, dan akhirnya untuk penskalaan ulang Anda akan memuat berkas teks yang berisi nilai minimum dan maksimum dari dataset MRI.
Catatan: Untuk penskalaan ulang, Anda juga dapat mengambil nilai maksimum dan minimum dari dataset karena Anda mungkin tidak memiliki berkas maxANDmin.txt.
x,y = 173,173
full_z = 207
resizeTo=176
batch_size = 32
inChannel = outChannel = 1
input_shape=(x,y,inChannel)
input_img = Input(shape = (resizeTo, resizeTo, inChannel))
inp = "ground3T"
out = "ground7T"
train_matrix = []
test_matrix = []
min_max = np.loadtxt('maxANDmin.txt')Selanjutnya, Anda memuat data mri menggunakan pustaka nibabel dan mengubah ukuran gambar dari 173 x 173 menjadi 176 x 176 dengan menambahkan padding nol pada dimensi x dan y.
Perlu dicatat bahwa saat Anda memuat volume berformat Nifti, Nibabel tidak memuat array gambar. Nibabel menunggu hingga Anda meminta data array. Cara standar untuk meminta data array adalah dengan memanggil metode get_data().
Karena Anda menginginkan irisan 2D alih-alih 3D, Anda akan menggunakan daftar train dan test yang telah diinisialisasi sebelumnya; setiap kali membaca volume, Anda akan mengiterasi semua 207 irisan lengkap dari volume 3D dan menambahkan setiap irisan satu per satu ke dalam daftar.
folder = os.listdir(inp)
Mari muat data 3T terlebih dahulu.
for f in folder:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load(inp + f)
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        train_matrix.append(a[:,j,:])
Kemudian, muat data 7T, dan Anda menggunakan variabel folder yang sama untuk memuat data 7T juga karena jumlah volume MR 3T dan 7T sama.
for f in folder:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    b = nib.load(out + f)
    b = b.get_data()
    temp[3:,:,3:] = b
    b = temp
    for j in range(full_z):
        test_matrix.append(b[:,j,:])
Karena matriks train dan test berupa daftar, Anda akan menggunakan modul numpy untuk mengonversi daftar tersebut menjadi array numpy.
Selanjutnya, Anda akan mengonversi type dari array numpy menjadi float32 dan juga melakukan penskalaan ulang pada input dan ground truth.
train_matrix = np.asarray(train_matrix)
train_matrix = train_matrix.astype('float32')
m = min_max[0]
mi = min_max[1]
train_matrix = (train_matrix - mi) / (m - mi)

test_matrix = np.asarray(test_matrix)
test_matrix = test_matrix.astype('float32')
test_matrix = (test_matrix - mi) / (m - mi)
Mari cepat cetak bentuk dari matriks train_matrix (3T) dan test_matrix (7T). Keduanya seharusnya berisi total 28 x 207 = 5796 gambar, masing-masing berdimensi 176 x 176.
train_matrix.shape
(5796, 176, 176)
test_matrix.shape
(5796, 176, 176)
Berikutnya, Anda akan membuat dua variabel baru augmented_images(3T/input) dan Haugmented_images (7T/ground truth) dengan bentuk yang sama seperti matriks train dan test. Ini akan menjadi matriks 4D di mana dimensi pertama adalah jumlah total gambar, dimensi kedua dan ketiga adalah dimensi setiap gambar, dan dimensi terakhir adalah jumlah kanal yang dalam kasus ini adalah satu.
augmented_images=np.zeros(shape=[(train_matrix.shape[0]),(train_matrix.shape[1]),(train_matrix.shape[2]),(1)])
Haugmented_images=np.zeros(shape=[(train_matrix.shape[0]),(train_matrix.shape[1]),(train_matrix.shape[2]),(1)])
Kemudian Anda akan mengiterasi semua gambar satu per satu, setiap kali Anda akan mengubah bentuk matriks train dan test menjadi 176 x 176 dan menambahkannya ke augmented_images(3T/input) dan Haugmented_images (7T/ground truth) masing-masing.
for i in range(train_matrix.shape[0]):
    augmented_images[i,:,:,0] = train_matrix[i,:,:].reshape(resizeTo,resizeTo)
    Haugmented_images[i,:,:,0] = test_matrix[i,:,:].reshape(resizeTo,resizeTo)
Setelah semua ini, penting untuk mempartisi data. Agar model Anda melakukan generalisasi dengan baik, Anda membagi data menjadi dua bagian: set pelatihan dan validasi. Anda akan melatih model pada 80% data dan memvalidasinya pada 20% sisa data pelatihan.
Hal ini juga akan membantu mengurangi kemungkinan overfitting, karena Anda akan memvalidasi model pada data yang tidak dilihatnya pada fase pelatihan.
Anda dapat menggunakan modul train_test_split dari scikit-learn yang telah Anda definisikan di awal untuk membagi data dengan benar:
data,Label = shuffle(augmented_images,Haugmented_images, random_state=2)
X_train, X_test, y_train, y_test = train_test_split(data, Label, test_size=0.2, random_state=2)
X_test = np.array(X_test)
y_test = np.array(y_test)
X_test = X_test.astype('float32')
y_test = y_test.astype('float32')
X_train = np.array(X_train)
y_train = np.array(y_train)
X_train = X_train.astype('float32')
y_train = y_train.astype('float32')
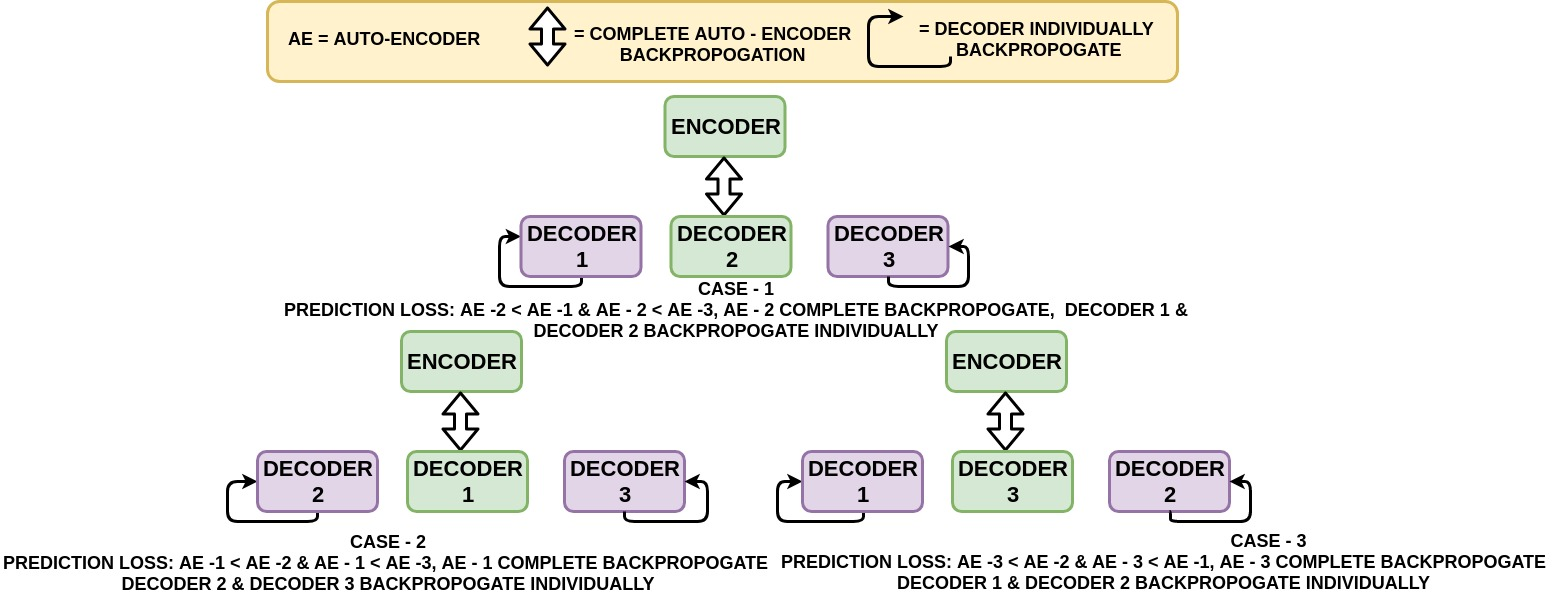
Berikutnya, Anda mendefinisikan arsitektur yang diusulkan dengan blok layer filter berurutan yang diikuti oleh layer max pooling pada bagian encoder seperti ditunjukkan pada sel berikutnya. Untuk merekonstruksi ukuran asli gambar pada output, sebuah layer upsampling diperkenalkan pada setiap blok decoder. Saat upsampling, mungkin muncul beberapa artefak akibat detail yang hilang pada input decoder yang telah didownsample. Oleh karena itu, Anda menggabungkan input decoder dengan versi yang di-upscale dari encoder untuk menyediakan sifat detail yang di-upscale demi rekonstruksi yang lebih baik saat upsampling pada decoder. Penambahan koneksi merge terbukti menghasilkan peningkatan PSNR yang signifikan (sekitar 5 dB). Pengaturan arsitektur ini terinspirasi dari makalah ini.
Pendekatan yang diusulkan menggunakan satu encoder dan beberapa decoder dengan input saluran tunggal. Tiga layer konvolusional digunakan pada setiap blok encoder dan ketiga decoder, diikuti oleh layer batch normalization untuk menjaga stabilitas numerik.
Blok konvolusional pertama pada encoder memiliki 32 filter, dan jumlah filter mengganda setelah setiap blok konvolusional. Pada semua decoder, blok konvolusional pertama memiliki 256 filter, dan jumlah filter dibagi dua setelah setiap blok. Anda akan menggunakan ukuran filter 3x3 pada semua blok konvolusional.
Rectified Linear Unit (ReLU) akan digunakan sebagai fungsi aktivasi di semua layer kecuali layer terakhir. Karena data dinormalisasi antara 0 dan 1, fungsi aktivasi Sigmoid digunakan pada layer terakhir.
Sudah diketahui bahwa detail gambar lokal pada berbagai skala berperan penting dalam rekonstruksi gambar. Arsitektur yang diusulkan mempertimbangkan gambar pada skala berbeda menggunakan layer hierarkis untuk downsampling (maxpooling) dan upsampling (masing-masing dengan faktor 2) pada encoder dan decoder. Representasi terenkode yang diperoleh setelah tiga operasi downsampling membawa data dari input berdimensi tinggi ke representasi ruang laten.
def encoder(input_img):
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    pool3 = MaxPooling2D(pool_size=(2, 2))(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(pool3)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv4)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='sigmoid', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    return conv5,conv4,conv3,conv2,conv1
def decoder_1(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_1 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_1
def decoder_2(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_2 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_2
def decoder_3(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_3 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_3
Pada 4 sel di atas, Anda mendefinisikan empat fungsi. Satu untuk encoder dan tiga sisanya untuk decoder. Karena ini adalah fungsi, Anda bisa saja mendefinisikan fungsi decoder() dan memanggilnya tiga kali, tetapi untuk pemahaman yang lebih baik, Anda akan mendefinisikannya tiga kali dan untuk menghindari masalah pada kerandoman dari ketiga decoder.
Selanjutnya, Anda akan menggunakan mean square error di mana Anda akan mengecualikan nilai (piksel) dari ground truth y_t dan y_p yang bernilai nol.
def root_mean_sq_GxGy(y_t, y_p):
    a1=1
    where = tf.not_equal(y_t, 0)
    a_t=tf.boolean_mask(y_t,where,name='boolean_mask')
    a_p=tf.boolean_mask(y_p,where,name='boolean_mask')
    return a1*(K.sqrt(K.mean((K.square(a_t-a_p)))))
Pertama, Anda akan memanggil fungsi encoder dengan memberikan input kepadanya. Karena Anda menggunakan koneksi merge pada arsitektur, fungsi encoder akan mengembalikan output dari lima layer convolution yang kemudian Anda merge dengan output dari ketiga decoder secara terpisah.
conv5,conv4,conv3,conv2,conv1 = encoder(input_img)
autoencoder_1 = Model(input_img, decoder_1(conv5,conv4,conv3,conv2,conv1))
autoencoder_1.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())

autoencoder_2 = Model(input_img, decoder_2(conv5,conv4,conv3,conv2,conv1))
autoencoder_2.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())

autoencoder_3 = Model(input_img, decoder_3(conv5,conv4,conv3,conv2,conv1))
autoencoder_3.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:2: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.

/usr/local/lib/python3.5/dist-packages/keras/legacy/layers.py:460: UserWarning: The `Merge` layer is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
  name=name)
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:10: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
  # Remove the CWD from sys.path while we load stuff.
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:18: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:26: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.


WARNING:tensorflow:From /usr/local/lib/python3.5/dist-packages/keras/backend/tensorflow_backend.py:1257: calling reduce_mean (from tensorflow.python.ops.math_ops) with keep_dims is deprecated and will be removed in a future version.
Instructions for updating:
keep_dims is deprecated, use keepdims instead
Anda akan menyimpan bobot hanya ketika peak signal-to-noise ratio pada data validasi meningkat. Jadi untuk itu Anda akan mendefinisikan daftar psnr_gray_channel di mana Anda menambahkan nilai awal 1; Anda menambahkan 1 karena perlu menginisialisasi daftar dengan angka acak dan PSNR akan jauh lebih besar dari nilai ini bahkan pada tahap awal pelatihan, sehingga ini hanya bertindak sebagai angka dummy.
Anda akan menginisialisasi laju pembelajaran sebesar 1e-3 dan menggunakan strategi penurunan laju pembelajaran di mana Anda menurunkan laju pembelajaran sebesar 10% dari nilai saat ini setiap 20 epoch!
psnr_gray_channel = []
psnr_gray_channel.append(1)
learning_rate = 0.001
j=0
Catatan: Kode lengkap berikut perlu dijalankan dalam satu sel utuh, tetapi untuk pemahaman yang lebih baik tentang keseluruhan proses pelatihan, kode akan dibagi menjadi sel-sel kecil.
Model dilatih selama 500 epoch. Laju pembelajaran awal adalah 1e-3 seperti didefinisikan pada sel sebelumnya. Anda juga akan menyimpan nilai PSNR, MSE setelah setiap epoch untuk 7T dengan hasil prediksi. Anda akan menggunakan fungsi K.set_value untuk mengubah laju pembelajaran dari ketiga model sebesar 10% tetapi setiap 20 epoch.
for jj in range(500):
    myfile_valid_psnr_7T = open('../1_encoder_3_decoders_complete_slices_single_channel/validation_psnr7T_1encoder_3decoders.txt', 'a')
    myfile_valid_mse_7T = open('../1_encoder_3_decoders_complete_slices_single_channel/validation_mse7T_1encoder_3decoders.txt', 'a')

    K.set_value(autoencoder_1.optimizer.lr, learning_rate)
    K.set_value(autoencoder_2.optimizer.lr, learning_rate)
    K.set_value(autoencoder_3.optimizer.lr, learning_rate)
Selanjutnya, Anda mengacak gambar input 3T dan ground truth 7T untuk menghindari overfitting karena tidak mengacak akan membuat model melihat sampel dalam urutan yang sama setelah setiap epoch. Lalu, Anda akan menghitung jumlah batch yang akan dibuat berdasarkan batch_size yang telah Anda definisikan sebelumnya. Terakhir, Anda mulai mengiterasi num_batches.
train_X,train_Y = shuffle(X_train,y_train)
print ("Epoch is: %d\n" % j)
print ("Number of batches: %d\n" % int(len(train_X)/batch_size))
num_batches = int(len(train_X)/batch_size)
for batch in range(num_batches):
Selain menyimpan nilai PSNR Anda juga akan menyimpan loss dari ketiga autoencoder dan ketiga decoder masing-masing.
myfile_ae1_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae1_train_loss_1encoder_3decoders.txt', 'a')
myfile_ae2_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae2_train_loss_1encoder_3decoders.txt', 'a')
myfile_ae3_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae3_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec1_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec1_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec2_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec2_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec3_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec3_train_loss_1encoder_3decoders.txt', 'a')
Karena pada setiap batch Anda menginginkan 32 sampel berikutnya (batch_size) dilihat oleh model, sel berikut melakukan itu untuk Anda!
batch_train_X = train_X[batch*batch_size:min((batch+1)*batch_size,len(train_X)),:]
batch_train_Y = train_Y[batch*batch_size:min((batch+1)*batch_size,len(train_Y)),:]
Berikutnya agar strategi Minimum autoencoder bekerja, setelah setiap epoch Anda melakukan pengujian pada data pelatihan menggunakan fungsi Keras test_on_batch yang akan memberikan tiga loss masing-masing, dan akhirnya, Anda mencetaknya.
loss_1 = autoencoder_1.test_on_batch(batch_train_X,batch_train_Y)
loss_2 = autoencoder_2.test_on_batch(batch_train_X,batch_train_Y)
loss_3 = autoencoder_3.test_on_batch(batch_train_X,batch_train_Y)
print ('epoch_num: %d batch_num: %d Test_loss_1: %f\n' % (j,batch,loss_1))
print ('epoch_num: %d batch_num: %d Test_loss_2: %f\n' % (j,batch,loss_2))
print ('epoch_num: %d batch_num: %d Test_loss_3: %f\n' % (j,batch,loss_3))
Ada enam kemungkinan kondisi pada jaringan Anda:
loss_1: Loss Autoencoder 1
loss_2: Loss Autoencoder 2
loss_3: Loss Autoencoder 3
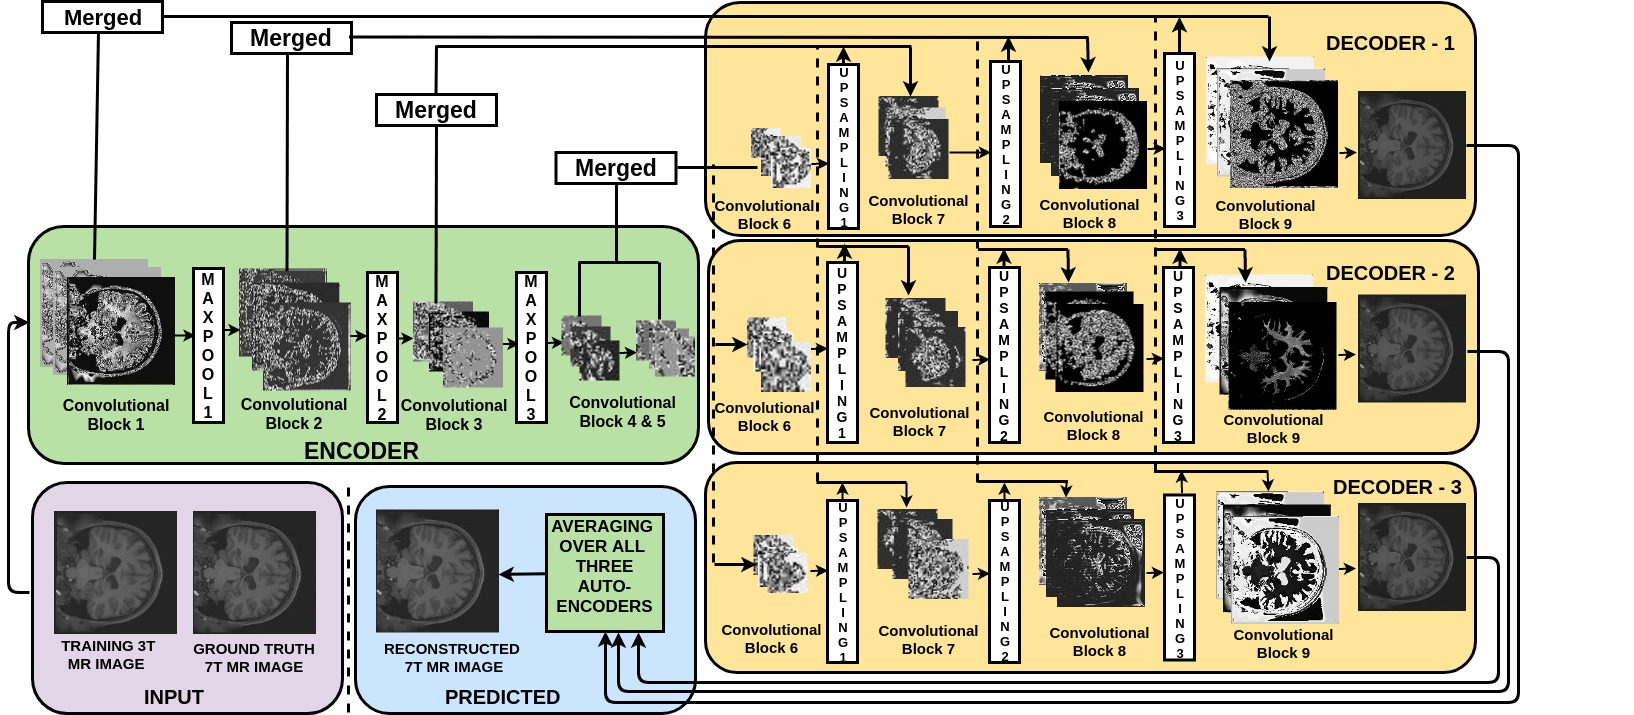
if loss_1 < loss_2 and loss_1 < loss_3:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1: %f\n' % (j,batch,train_1))
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_loss_3: %f\n' % (j,batch,train_3))
elif loss_2 < loss_1 and loss_2 < loss_3:
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_2: %f\n' % (j,batch,train_2))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_1.summary()
    #autoencoder_3.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" % (train_1))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3: %f\n' % (j,batch,train_3))
elif loss_3 < loss_1 and loss_3 < loss_2:
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_3: %f\n' % (j,batch,train_3))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    #autoencoder_1.summary()
    #autoencoder_2.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" %(train_1))
    myfile_dec2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
elif loss_1 == loss_2:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
elif loss_2 == loss_3:
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False

    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" % (train_1))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
elif loss_3 == loss_1:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))


    myfile_ae1_loss.close()
    myfile_ae2_loss.close()
    myfile_ae3_loss.close()
    myfile_dec1_loss.close()
    myfile_dec2_loss.close()
    myfile_dec3_loss.close()
Ini adalah langkah penting karena Anda membuat beberapa layer menjadi False pada kondisi di atas, Anda perlu mengubah layer tersebut menjadi True sehingga semua layer autoencoder dapat digunakan untuk fungsi test_on_batch dan Anda tidak ingin layer tersebut tetap False sepanjang pelatihan.
for layer in autoencoder_1.layers[:34]:
            layer.trainable = True
for layer in autoencoder_2.layers[:34]:
            layer.trainable = True
for layer in autoencoder_3.layers[:34]:
            layer.trainable = True
Anda akan menyimpan bobot dengan tiga cara berbeda, di bawah ini dua di antaranya. Pertama Anda akan menyimpan bobot setiap 100 epoch, dan kedua Anda akan menyimpan bobot setiap epoch. Pada dasarnya, bobot akan ditimpa setelah setiap epoch.
if jj % 100 ==0:
            autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1_" + str(jj)+".h5")
            autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2_" + str(jj)+".h5")
            autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3_" + str(jj)+".h5")


autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1.h5")
autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2.h5")
autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3.h5")
Anda akan mengacak data validasi terlebih dahulu dan kemudian menggunakan 6 kemungkinan kondisi yang sama seperti yang didefinisikan di atas. Jadi kondisi mana pun yang benar, Anda akan menguji model menggunakan autoencoder tersebut.
Lalu Anda menghitung dua metrik MSE dan PSNR antara decoded_imgs (prediksi) dan ground truth. Terakhir, Anda menyimpannya di berkas teks.
X_test,y_test = shuffle(X_test,y_test)
if loss_1 < loss_2 and loss_1 < loss_3:
    decoded_imgs = autoencoder_1.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)


    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))

    #print (check)
elif loss_2 < loss_1 and loss_2 < loss_3:
    decoded_imgs = autoencoder_2.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))

    #print (check)
elif loss_3 < loss_2 and loss_3 < loss_1:
    decoded_imgs = autoencoder_3.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))
    #print (check)

elif loss_1 == loss_2:
    decoded_imgs = autoencoder_1.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))


elif loss_2 == loss_3:
    decoded_imgs = autoencoder_2.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))


elif loss_3 == loss_1:
    decoded_imgs = autoencoder_3.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))
Di sini Anda menyimpan bobot hanya ketika PSNR antara 7T hasil prediksi dan ground truth (7T) adalah yang maksimum dibanding nilai PSNR sebelumnya yang disimpan dalam daftar psnr_gray_channel.
if max(psnr_gray_channel) < psnr_7T:
            autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1_" + str(jj)+".h5")
            autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2_" + str(jj)+".h5")
            autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3_" + str(jj)+".h5")

    psnr_gray_channel.append(psnr_7T)
Anda akan mendefinisikan matriks numpy temp berukuran 176 x 528 karena akan ada 3 gambar yang disimpan dalam satu baris, masing-masing berdimensi 176 x 176. Anda akan menyimpan salah satu gambar dari seluruh data validasi 3T, 7T, dan hasil prediksi serta mengalikan matriks dengan 255 karena gambar telah diskalakan ke antara 0 dan 1.
Akhirnya menggunakan fungsi scipy, Anda akan menyimpan gambar tersebut.
temp = np.zeros([resizeTo,resizeTo*3])
temp[:resizeTo,:resizeTo] = X_test[0,:,:,0]
temp[:resizeTo,resizeTo:resizeTo*2] = y_test[0,:,:,0]
temp[:resizeTo,2*resizeTo:] = decoded_imgs[0,:,:,0]
temp = temp*255
scipy.misc.imsave('../Results/1_encoder_3_decoders_complete_slices_single_channel/' + str(j) + '.jpg', temp)
j +=1
Mari tutup berkas PSNR dan MSE di akhir.
myfile_valid_psnr_7T.close()
myfile_valid_mse_7T.close()
Terakhir, pada akhirnya Anda akan menurunkan laju pembelajaran sebesar 10% dari nilainya saat ini setiap 20 epoch.
if jj % 20 ==0:
        learning_rate = learning_rate - learning_rate * 0.10
Anda akan membahas topik-topik berikut pada bagian-2 dari tutorial ini:
nibabel.Sebelum mengikuti tutorial ini pastikan Anda memiliki versi modul yang persis sama seperti di bawah ini:
Catatan: Sebelum mulai, harap dicatat bahwa model akan dilatih pada sistem dengan prosesor Nvidia 1080 Ti GPU Xeon e5 GeForce dan RAM 32GB. Jika Anda menggunakan Jupyter Notebook, Anda perlu menambahkan tiga baris kode lagi untuk menentukan urutan perangkat CUDA dan perangkat CUDA yang terlihat menggunakan modul os.
Pada kode di bawah, secara garis besar Anda menetapkan variabel lingkungan di notebook menggunakan os.environ. Sebaiknya lakukan ini sebelum menginisialisasi Keras untuk membatasi backend TensorFlow Keras agar menggunakan GPU pertama. Jika mesin tempat Anda melatih memiliki GPU pada 0, pastikan untuk menggunakan 0 alih-alih 1. Anda dapat memeriksanya dengan menjalankan perintah sederhana di terminal: misalnya, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU
Pertama, Anda mengimpor semua modul yang diperlukan seperti tensorflow, numpy dan yang terpenting keras serta fungsi atau layer yang dibutuhkan seperti Input, Conv2D,MaxPooling2D, dll. karena Anda akan menggunakan semua kerangka ini untuk melatih model!
Untuk membaca gambar berformat nifti, Anda juga harus mengimpor modul bernama nibabel.
import os
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
import numpy as np
import scipy.misc
import numpy.random as rng
from sklearn.utils import shuffle
import nibabel as nib
from sklearn.cross_validation import train_test_split
import math
Dataset MRI otak 3T dan 7T terdiri dari volume 3D; setiap volume memiliki total 207 irisan/gambar MRI otak yang diambil pada irisan berbeda dari otak. Setiap irisan berdimensi 173 x 173. Gambar berupa skala abu-abu satu kanal. Total ada 39 subjek, masing-masing berisi pemindaian MRI seorang pasien. Format gambarnya bukan jpeg, png, dan sejenisnya, melainkan format nifti. Anda akan melihat pada bagian selanjutnya cara membaca gambar berformat nifti.
Dataset ini terdiri dari citra MR modality T1; sekuens T1 secara tradisional dianggap baik untuk evaluasi struktur anatomi. Dataset yang akan Anda gunakan hari ini terdiri dari MRI Otak 3T dan 7T.
Dataset ini bersifat publik dan tersedia untuk diunduh dari sumber ini.
Pertama-tama, mari tetapkan dimensi datanya. Anda akan mengubah ukuran dimensi gambar dari 173x173 menjadi 176x176 pada bagian pembacaan data. Di sini kita juga mendefinisikan direktori data, ukuran batch yang digunakan untuk melatih model, jumlah kanal, layer Input(), matriks train dan test sebagai list, dan terakhir untuk penskalaan ulang kita memuat file teks yang berisi nilai minimum dan maksimum dari dataset MRI.
x,y = 173,173
full_z = 207
resizeTo=176
inChannel = outChannel = 1
input_shape=(x,y,inChannel)
input_img = Input(shape = (resizeTo, resizeTo, inChannel))
train_matrix = []
test_matrix = []
ff = os.listdir("../test_crossval1")
save = "../Result_nii_crossval1"
folder_ground = os.listdir("../test_g_crossval1")
ToPredict_images=[]
predict_matrix=[]
ground_images=[]
ground_matrix=[]
min_max=np.loadtxt('../maxANDmin.txt')
Selanjutnya, kita memuat data mri menggunakan pustaka nibabel dan mengubah ukuran gambar dari 173 x 173 menjadi 176 x 176 dengan menambahkan padding nol pada dimensi x dan y.
Perhatikan bahwa saat Anda memuat volume berformat Nifti, Nibabel tidak langsung memuat array gambar. Pustaka ini menunggu hingga Anda meminta data array. Cara standar untuk meminta data array adalah dengan memanggil metode get_data().
Karena Anda menginginkan irisan 2D alih-alih 3D, Anda akan menggunakan list train and test yang telah diinisialisasi sebelumnya; setiap kali membaca sebuah volume, Anda akan melakukan iterasi pada seluruh 207 irisan lengkap dari volume 3D dan menambahkan setiap irisan satu per satu ke dalam sebuah list.
for f in ff:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load("../test_crossval1" + f)
    affine = a.affine
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        predict_matrix.append(a[:,j,:])
for f in ff:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load("../test_g_crossval1" + f)
    affine = a.affine
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        ground_matrix.append(a[:,j,:])
Karena matriks uji 3T dan 7T berupa list, Anda akan menggunakan modul numpy untuk mengonversi list tersebut menjadi array numpy.
Selanjutnya, Anda akan mengonversi type array numpy menjadi float32 dan juga melakukan penskalaan ulang pada input dan ground truth.
ToPredict_images = np.asarray(predict_matrix)
ToPredict_images = ToPredict_images.astype('float32')
mx = min_max[0]
mn = min_max[1]
ToPredict_images[:,:,:,0] = (ToPredict_images[:,:,:,0] - mn ) / (mx - mn)
ground_images = np.asarray(ground_matrix)
ground_images = ground_images.astype('float32')
ground_images[:,:,:,0] = (ground_images[:,:,:,0] - mn ) / (mx - mn)
Berikutnya, Anda akan membuat dua variabel baru ToPredict_images (Uji 3T/input) dan ground_images (Uji 7T/ground truth) dengan bentuk seperti matriks train dan test. Ini akan berupa matriks 4D di mana dimensi pertama adalah total jumlah gambar, dimensi kedua dan ketiga adalah dimensi setiap gambar, dan dimensi terakhir adalah jumlah kanal yang dalam kasus ini bernilai satu.
ToPredict_images=np.zeros(shape=[(ToPredict_images.shape[0]),(ToPredict_images.shape[1]),(ToPredict_images.shape[2]),(1)])
ground_images=np.zeros(shape=[(ground_images.shape[0]),(ground_images.shape[1]),(ground_images.shape[2]),(1)])
Kemudian Anda akan melakukan iterasi pada semua gambar satu per satu, setiap kali Anda akan melakukan reshape matriks train dan test menjadi 176 x 176 dan menambahkannya ke ToPredict_images (Uji 3T/input) dan ground_images (Uji 7T/ground truth) masing-masing.
for i in range(ToPredict_images.shape[0]):
    ToPredict_images[i,:,:,0] = ToPredict_images[i,:,:].reshape(resizeTo,resizeTo)
for i in range(ground_images.shape[0]):
    ground_images[i,:,:,0] = ground_images[i,:,:].reshape(resizeTo,resizeTo)
def encoder(input_img):
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    pool3 = MaxPooling2D(pool_size=(2, 2))(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(pool3)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv4)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='sigmoid', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    return conv5,conv4,conv3,conv2,conv1
def decoder(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded
Berikutnya, Anda akan menggunakan mean square error di mana Anda mengecualikan nilai (piksel) dari ground truth y_t dan y_p yang bernilai nol.
def root_mean_sq_GxGy(y_t, y_p):
    a1=1
    zero = tf.constant(0, dtype=tf.float32)
    where = tf.not_equal(y_t, zero)
    a_t=tf.boolean_mask(y_t,where,name='boolean_mask')
    a_p=tf.boolean_mask(y_p,where,name='boolean_mask')
    return a1*(K.sqrt(K.mean((K.square(a_t-a_p)))))
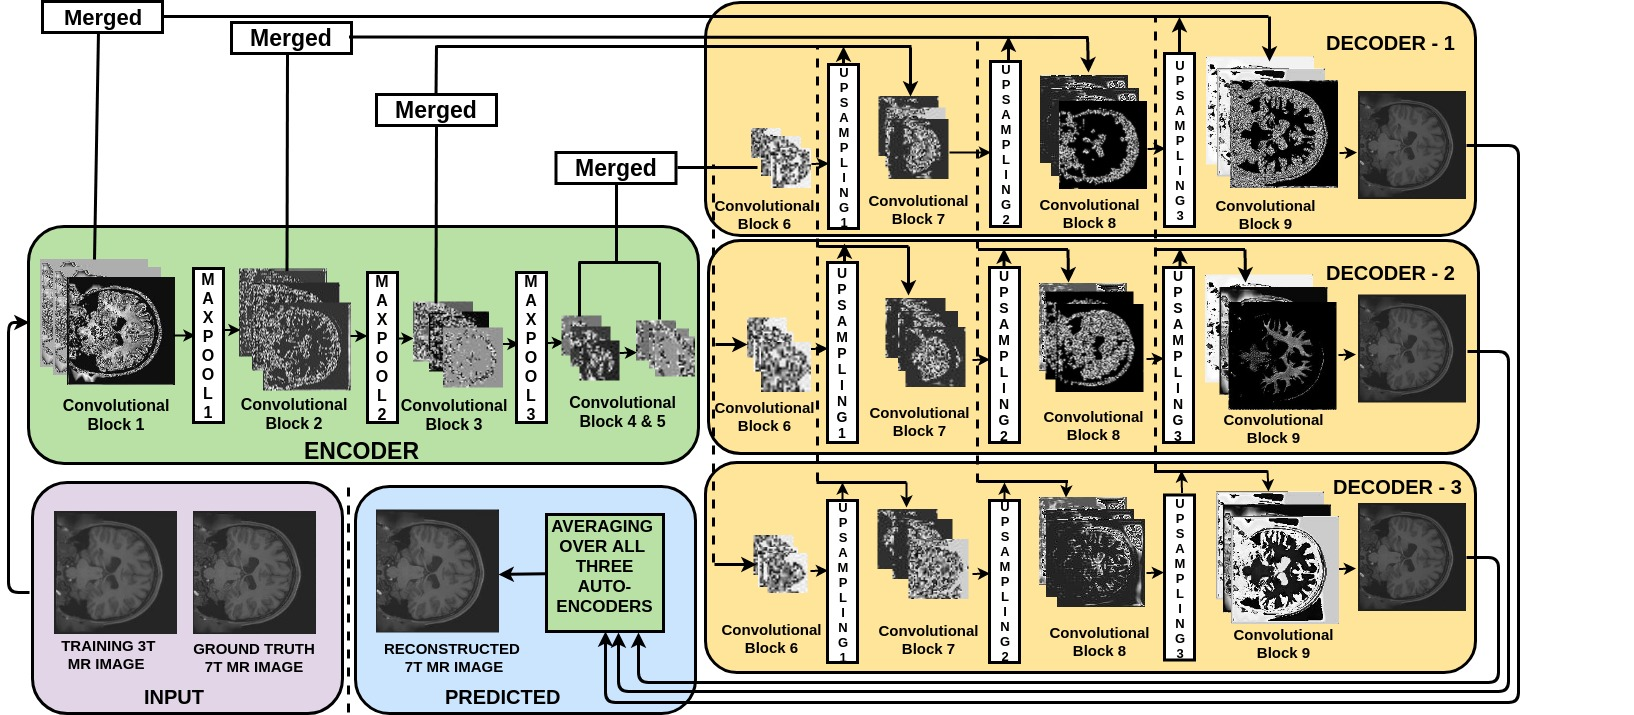
Pertama, panggil fungsi encoder dengan memasukkan input ke dalamnya. Karena Anda menggunakan koneksi merge dalam arsitektur, fungsi encoder akan mengembalikan keluaran dari lima layer convolution yang kemudian Anda merge dengan keluaran dari ketiga decoder secara terpisah.
conv5,conv4,conv3,conv2,conv1 = encoder(input_img)
Sekarang mari buat tiga model berbeda dan muat tiga bobot model terlatih ke masing-masing.
autoencoder_1 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_1.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE1.h5")
autoencoder_2 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_2.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE2.h5")
autoencoder_3 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_3.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE3.h5")
Mari dengan cepat inisialisasi dua array numpy masing-masing berukuran 11 x 3 x 1 di mana dimensi pertama merepresentasikan jumlah volume yang akan Anda gunakan untuk menguji model. Dimensi kedua merepresentasikan MSE dan PSNR antara: Citra MR 7T keluaran prediksi dan Ground Truth 7T, keluaran prediksi dan citra MR 3T input, citra MR 3T input dan Ground Truth 7T; dimensi ketiga merepresentasikan jumlah kanal yang akan Anda masukkan ke model!
mse= np.zeros([11,3,1])
psnr= np.zeros([11,3,1])
i=0 #untuk iterasi pada irisan dari semua 11 volume
Pada bagian selanjutnya, Anda akan melakukan iterasi pada semua 11 volume satu per satu. Pada setiap iterasi, Anda akan memprediksi setiap volume menggunakan ketiga autoencoder dan akhirnya merata-ratakan prediksinya.
Di tiap volume, Anda akan beriterasi pada jumlah kanal volume tersebut dan menghitung PSNR dan MSE untuk tiga kasus berbeda seperti dibahas di atas.
Lalu dengan pustaka nibabel, Anda akan menyimpan keluaran prediksi, input (3T), dan ground truth (7T) sebagai file berformat .nii: masing-masing dari 11 volume terdiri atas 207 irisan.
Terakhir, Anda akan menyimpan matriks PSNR ke dalam file teks menggunakan pustaka numpy.
Seperti dinyatakan dalam paper, merata-ratakan keluaran prediksi membantu mengurangi efek noise tetapi tetap mempertahankan fitur lokal pada gambar hasil rekonstruksi, sehingga PSNR menjadi lebih baik dibandingkan keluaran tiap decoder secara individual.
for j in range(11):
    decoded_imgs_1 = autoencoder_1.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs_2 = autoencoder_2.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs_3 = autoencoder_3.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs = np.mean( np.array([ decoded_imgs_1, decoded_imgs_2,decoded_imgs_3 ]), axis=0 )
    for channel in range(1):
        mse[j,0,channel]=  np.mean((ground_images[i:i+207,:,:,channel] - decoded_imgs[:,:,:,channel]) ** 2)
        psnr[j,0,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,0,channel]))
        mse[j,1,channel]=  np.mean((ground_images[i:i+207,:,:,channel] - ToPredict_images[i:i+207,:,:,channel])** 2)
        psnr[j,1,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,1,channel]))
        mse[j,2,channel] =  np.mean((ToPredict_images[i:i+207,:,:,channel] - decoded_imgs[:,:,:,channel]) ** 2)
        checklt = math.sqrt(mse[j,2,channel])
        psnr[j,2,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,2,channel]))
    obj = nib.Nifti1Image(decoded_imgs, affine)
    string =str(j)+'_crossval1.nii'
    nib.save(obj, save + string)
    obj = nib.Nifti1Image(ground_images[i:i+207,:,:,:], affine)
    string =str(j)+'_ground_images_crossval1.nii'
    nib.save(obj, save + string)
    obj = nib.Nifti1Image(ToPredict_images[i:i+207,:,:,:], affine)
    string =str(j)+'_ToPredict_images_crossval1.nii'
    nib.save(obj, save + string)
    i=i+207


np.savetxt('psnr_all_slices.txt',psnr[:,:,0])
Jika Anda ingin mempelajari lebih lanjut tentang Python, ikuti kursus DataCamp Introduction to Data Visualization with Matplotlib.
Lihat juga Keras Tutorial: Deep Learning in Python.
Pelajari lebih lanjut tentang Python dan Deep Learning
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt




