Curso
Introdução ao Deep Learning com Keras
4 h
46.3K
Na parte do Training Script, você vai trabalhar no problema de super-resolução de imagens usando uma arquitetura de deep learning inovadora. A tarefa é fazer um mapeamento não linear de uma imagem de RM cerebral de baixo campo (3 Tesla) para uma imagem de alto campo (7 Tesla). Nesta parte do Testing Script, você usará os pesos treinados na Parte 1 para prever em dados não vistos. Você também vai aprender a salvar imagens 2D como um volume combinado.
O tutorial está dividido em duas partes: a primeira mostra o processo de treino e a segunda cobre o processo de teste.
Observação: Se tiver interesse em ler o artigo, você pode encontrá-lo aqui.
Em resumo, você vai abordar os seguintes tópicos na Parte 1 do tutorial:
Antes de começar, certifique-se de usar exatamente as mesmas versões dos módulos indicadas abaixo:
Observação: Antes de começar, note que o modelo será treinado em um sistema com GPU Nvidia 1080 Ti, processador Xeon e5 GeForce e 32 GB de RAM. Se você estiver usando Jupyter Notebook, será preciso adicionar três linhas de código para especificar a ordem do dispositivo CUDA e os dispositivos visíveis CUDA usando o módulo os.
No código abaixo, você define variáveis de ambiente no notebook usando os.environ. É recomendável fazer isso antes de inicializar o Keras para limitar o TensorFlow (backend do Keras) a usar a primeira GPU. Se a máquina em que você treina tem a GPU no índice 0, use 0 em vez de 1. Você pode verificar isso executando no terminal um comando simples como nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU
Primeiro, importe todos os módulos necessários como tensorflow, numpy e, principalmente, keras e as funções/camadas como Input, Conv2D, MaxPooling2D etc., já que você vai usar esses frameworks para treinar o modelo!
Para ler imagens no formato NIfTI, também é preciso importar o módulo nibabel.
import os
import numpy as np
import math
import tensorflow as tf
import nibabel as nib
import numpy as np
from keras.layers import Input,Dense,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import RMSprop
from keras import backend as K
import scipy.misc
from sklearn.utils import shuffle
from sklearn.cross_validation import train_test_split
import matplotlib.pyplot as plt
from keras.models import model_from_json
Using TensorFlow backend.
/usr/local/lib/python3.5/dist-packages/sklearn/cross_validation.py:41: DeprecationWarning: This module was deprecated in version 0.18 in favor of the model_selection module into which all the refactored classes and functions are moved. Also, note that the interface of the new CV iterators is different from that of this module. This module will be removed in 0.20.
  "This module will be removed in 0.20.", DeprecationWarning)
O dataset de RM cerebral 3T e 7T consiste em volumes 3D; cada volume tem 207 cortes/imagens de RM do cérebro em diferentes fatias. Cada corte tem dimensão 173 x 173. As imagens são em escala de cinza com um único canal. Ao todo, são 39 sujeitos, cada um contendo o exame de RM de um paciente. O formato das imagens não é jpeg, png etc., e sim NIfTI. Na seção adiante, você verá como ler imagens no formato NIfTI.
O dataset consiste em imagens de RM na modalidade T1; sequências T1 são tradicionalmente boas para avaliar estruturas anatômicas. O dataset que você vai usar hoje é composto por RMs cerebrais de 3T e 7T.
O dataset é público e pode ser baixado nesta fonte.
28 sujeitos são usados para treino e os 11 restantes para teste.
Vamos definir primeiro as dimensões dos dados. Você vai redimensionar de 173x173 para 176x176 na etapa de leitura. Aqui também define o diretório dos dados, o batch size do treino, o número de canais, uma camada Input(), as matrizes de treino e teste como listas e, por fim, para reescalonamento, carregar o arquivo de texto com os valores mínimo e máximo do dataset de RM.
Observação: Para reescalar, você também pode usar o máximo e o mínimo do próprio dataset, pois talvez você não tenha o arquivo maxANDmin.txt.
x,y = 173,173
full_z = 207
resizeTo=176
batch_size = 32
inChannel = outChannel = 1
input_shape=(x,y,inChannel)
input_img = Input(shape = (resizeTo, resizeTo, inChannel))
inp = "ground3T"
out = "ground7T"
train_matrix = []
test_matrix = []
min_max = np.loadtxt('maxANDmin.txt')Agora, carregue os dados de RM usando a biblioteca nibabel e redimensione as imagens de 173 x 173 para 176 x 176 preenchendo com zeros nas dimensões x e y.
Observe que, ao carregar um volume NIfTI, o Nibabel não carrega imediatamente o array de imagem — ele espera até você solicitar os dados. A forma padrão é chamando o método get_data().
Como você quer cortes 2D em vez de 3D, use as listas train e test inicializadas anteriormente; sempre que ler um volume, itere por todos os 207 cortes do volume 3D e anexe cada corte, um a um, à lista.
folder = os.listdir(inp)
Vamos primeiro carregar os dados 3T.
for f in folder:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load(inp + f)
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        train_matrix.append(a[:,j,:])
Depois, carregue os dados 7T. Você usará a mesma variável folder também para 7T, já que o número de volumes 3T e 7T é igual.
for f in folder:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    b = nib.load(out + f)
    b = b.get_data()
    temp[3:,:,3:] = b
    b = temp
    for j in range(full_z):
        test_matrix.append(b[:,j,:])
Como as matrizes de treino e teste são listas, use numpy para convertê-las em arrays numpy.
Depois, converta o type do array para float32 e reescale tanto o input quanto o ground truth.
train_matrix = np.asarray(train_matrix)
train_matrix = train_matrix.astype('float32')
m = min_max[0]
mi = min_max[1]
train_matrix = (train_matrix - mi) / (m - mi)

test_matrix = np.asarray(test_matrix)
test_matrix = test_matrix.astype('float32')
test_matrix = (test_matrix - mi) / (m - mi)
Vamos imprimir rapidamente os shapes das matrizes train_matrix (3T) e test_matrix (7T). Elas devem ter 28 x 207 = 5.796 imagens no total, cada uma com dimensão 176 x 176.
train_matrix.shape
(5796, 176, 176)
test_matrix.shape
(5796, 176, 176)
Agora, crie duas novas variáveis, augmented_images (3T/input) e Haugmented_images (7T/ground truth), com o mesmo shape das matrizes de treino e teste. Será uma matriz 4D em que a primeira dimensão é o total de imagens, a segunda e a terceira são as dimensões de cada imagem e a última é o número de canais (um, neste caso).
augmented_images=np.zeros(shape=[(train_matrix.shape[0]),(train_matrix.shape[1]),(train_matrix.shape[2]),(1)])
Haugmented_images=np.zeros(shape=[(train_matrix.shape[0]),(train_matrix.shape[1]),(train_matrix.shape[2]),(1)])
Depois, itere por todas as imagens; a cada vez, reformate as matrizes de treino e teste para 176 x 176 e anexe em augmented_images (3T/input) e Haugmented_images (7T/ground truth), respectivamente.
for i in range(train_matrix.shape[0]):
    augmented_images[i,:,:,0] = train_matrix[i,:,:].reshape(resizeTo,resizeTo)
    Haugmented_images[i,:,:,0] = test_matrix[i,:,:].reshape(resizeTo,resizeTo)
Depois disso, é importante particionar os dados. Para que o modelo generalize bem, divida em treino e validação: treine com 80% e valide com 20%.
Isso também ajuda a reduzir overfitting, pois você valida em dados não vistos durante o treino.
Use o módulo train_test_split do scikit-learn que definimos no começo para fazer a divisão corretamente:
data,Label = shuffle(augmented_images,Haugmented_images, random_state=2)
X_train, X_test, y_train, y_test = train_test_split(data, Label, test_size=0.2, random_state=2)
X_test = np.array(X_test)
y_test = np.array(y_test)
X_test = X_test.astype('float32')
y_test = y_test.astype('float32')
X_train = np.array(X_train)
y_train = np.array(y_train)
X_train = X_train.astype('float32')
y_train = y_train.astype('float32')
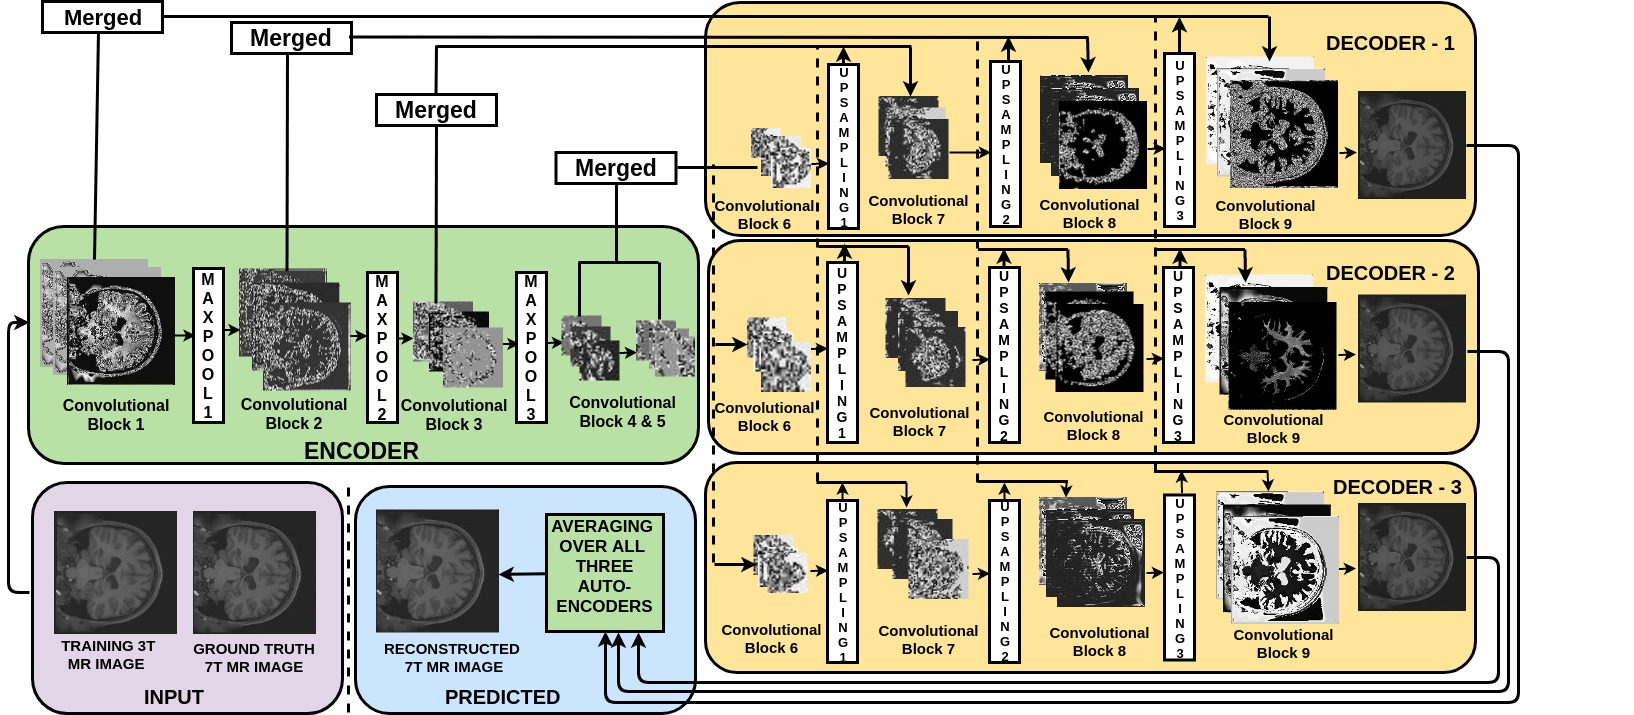
Agora, defina a arquitetura proposta com blocos de camadas de filtros seguidas por uma camada de max pooling na seção do codificador (encoder), como mostrado a seguir. Para reconstruir o tamanho original da imagem na saída, é usada uma camada de upsampling em cada bloco dos decodificadores. Durante o upsampling, podem surgir artefatos por falta de detalhes no input reduzido do decodificador. Por isso, concatenamos o input do decodificador com sua versão ampliada vinda do codificador, fornecendo detalhes para uma melhor reconstrução no upsampling do decoder. Adicionar as conexões de merge gera um ganho significativo de PSNR (da ordem de 5 dB). Essa configuração foi inspirada por este artigo.
A abordagem proposta usa um único codificador e múltiplos decodificadores com entrada de um canal. Três camadas convolucionais são usadas em cada bloco do codificador e em todos os três decodificadores, seguidas por batch normalization para manter a estabilidade numérica.
O primeiro bloco convolucional no codificador tem 32 filtros, e o número de filtros dobra após cada bloco. Em todos os decodificadores, o primeiro bloco tem 256 filtros, e o número de filtros é reduzido pela metade após cada bloco. O tamanho do filtro é 3x3 em todos os blocos.
ReLU é usada como função de ativação em todas as camadas, exceto na final. Como os dados estão normalizados entre 0 e 1, usa-se Sigmoid na camada final.
É sabido que detalhes locais em várias escalas são importantes na reconstrução de imagens. A arquitetura considera imagens em diferentes escalas usando camadas hierárquicas para downsampling (maxpooling) e upsampling (fator 2) no codificador e nos decodificadores, respectivamente. A representação codificada após três operações de downsampling traz os dados do alto dimensão de entrada para um espaço latente.
def encoder(input_img):
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    pool3 = MaxPooling2D(pool_size=(2, 2))(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(pool3)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv4)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='sigmoid', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    return conv5,conv4,conv3,conv2,conv1
def decoder_1(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_1 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_1
def decoder_2(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_2 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_2
def decoder_3(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_3 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_3
Nos quatro blocos acima, você definiu quatro funções: uma para o encoder e três para os decoders. Como são funções, seria possível definir uma função decoder() e chamá-la três vezes, mas, para facilitar o entendimento e evitar questões de aleatoriedade entre os decoders, deixamos definidas separadamente.
Agora, vamos usar o erro quadrático médio excluindo os valores (pixels) de y_t (ground truth) e y_p (predito) que são iguais a zero.
def root_mean_sq_GxGy(y_t, y_p):
    a1=1
    where = tf.not_equal(y_t, 0)
    a_t=tf.boolean_mask(y_t,where,name='boolean_mask')
    a_p=tf.boolean_mask(y_p,where,name='boolean_mask')
    return a1*(K.sqrt(K.mean((K.square(a_t-a_p)))))
Primeiro, chame a função encoder passando a entrada. Como usamos conexões de merge na arquitetura, a função encoder retorna a saída de cinco camadas convolution, que serão mescladas separadamente com a saída de cada um dos três decoders.
conv5,conv4,conv3,conv2,conv1 = encoder(input_img)
autoencoder_1 = Model(input_img, decoder_1(conv5,conv4,conv3,conv2,conv1))
autoencoder_1.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())

autoencoder_2 = Model(input_img, decoder_2(conv5,conv4,conv3,conv2,conv1))
autoencoder_2.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())

autoencoder_3 = Model(input_img, decoder_3(conv5,conv4,conv3,conv2,conv1))
autoencoder_3.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:2: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.

/usr/local/lib/python3.5/dist-packages/keras/legacy/layers.py:460: UserWarning: The `Merge` layer is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
  name=name)
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:10: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
  # Remove the CWD from sys.path while we load stuff.
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:18: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:26: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.


WARNING:tensorflow:From /usr/local/lib/python3.5/dist-packages/keras/backend/tensorflow_backend.py:1257: calling reduce_mean (from tensorflow.python.ops.math_ops) with keep_dims is deprecated and will be removed in a future version.
Instructions for updating:
keep_dims is deprecated, use keepdims instead
Você salvará os pesos somente quando o peak signal-to-noise ratio nos dados de validação melhorar. Para isso, defina uma lista psnr_gray_channel e adicione um valor padrão 1 — apenas como número inicial aleatório, já que o PSNR ficará bem acima disso mesmo nas fases iniciais do treino.
A taxa de aprendizado inicial será 1e-3, usando decaimento: você diminui 10% do valor atual a cada 20 épocas.
psnr_gray_channel = []
psnr_gray_channel.append(1)
learning_rate = 0.001
j=0
Observação: O próximo bloco completo deve ser executado em uma única célula, mas para facilitar o entendimento vamos dividir em células menores.
O modelo é treinado por 500 épocas. A taxa de aprendizado inicial é 1e-3, como definido. Você também salvará os valores de PSNR e MSE após cada época (7T previsto vs. 7T). Usaremos K.set_value para reduzir a taxa de aprendizado em 10% a cada 20 épocas para os três modelos.
for jj in range(500):
    myfile_valid_psnr_7T = open('../1_encoder_3_decoders_complete_slices_single_channel/validation_psnr7T_1encoder_3decoders.txt', 'a')
    myfile_valid_mse_7T = open('../1_encoder_3_decoders_complete_slices_single_channel/validation_mse7T_1encoder_3decoders.txt', 'a')

    K.set_value(autoencoder_1.optimizer.lr, learning_rate)
    K.set_value(autoencoder_2.optimizer.lr, learning_rate)
    K.set_value(autoencoder_3.optimizer.lr, learning_rate)
Em seguida, embaralhe as imagens 3T de entrada e 7T de ground truth para evitar overfitting, já que não embaralhar faria o modelo ver as amostras sempre na mesma ordem a cada época. Depois, calcule o número de batches com base no batch_size definido anteriormente. Por fim, itere sobre num_batches.
train_X,train_Y = shuffle(X_train,y_train)
print ("Epoch is: %d\n" % j)
print ("Number of batches: %d\n" % int(len(train_X)/batch_size))
num_batches = int(len(train_X)/batch_size)
for batch in range(num_batches):
Além de armazenar os valores de PSNR, você também registrará as perdas dos três autoencoders e dos três decoders, respectivamente.
myfile_ae1_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae1_train_loss_1encoder_3decoders.txt', 'a')
myfile_ae2_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae2_train_loss_1encoder_3decoders.txt', 'a')
myfile_ae3_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae3_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec1_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec1_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec2_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec2_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec3_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec3_train_loss_1encoder_3decoders.txt', 'a')
Como a cada batch você quer que os próximos 32 (batch_size) exemplos sejam vistos pelo modelo, o próximo bloco faz exatamente isso.
batch_train_X = train_X[batch*batch_size:min((batch+1)*batch_size,len(train_X)),:]
batch_train_Y = train_Y[batch*batch_size:min((batch+1)*batch_size,len(train_Y)),:]
Para a estratégia do autoencoder mínimo funcionar, após cada época você testa nos dados de treino usando a função Keras test_on_batch, que retorna as três perdas, e as imprime.
loss_1 = autoencoder_1.test_on_batch(batch_train_X,batch_train_Y)
loss_2 = autoencoder_2.test_on_batch(batch_train_X,batch_train_Y)
loss_3 = autoencoder_3.test_on_batch(batch_train_X,batch_train_Y)
print ('epoch_num: %d batch_num: %d Test_loss_1: %f\n' % (j,batch,loss_1))
print ('epoch_num: %d batch_num: %d Test_loss_2: %f\n' % (j,batch,loss_2))
print ('epoch_num: %d batch_num: %d Test_loss_3: %f\n' % (j,batch,loss_3))
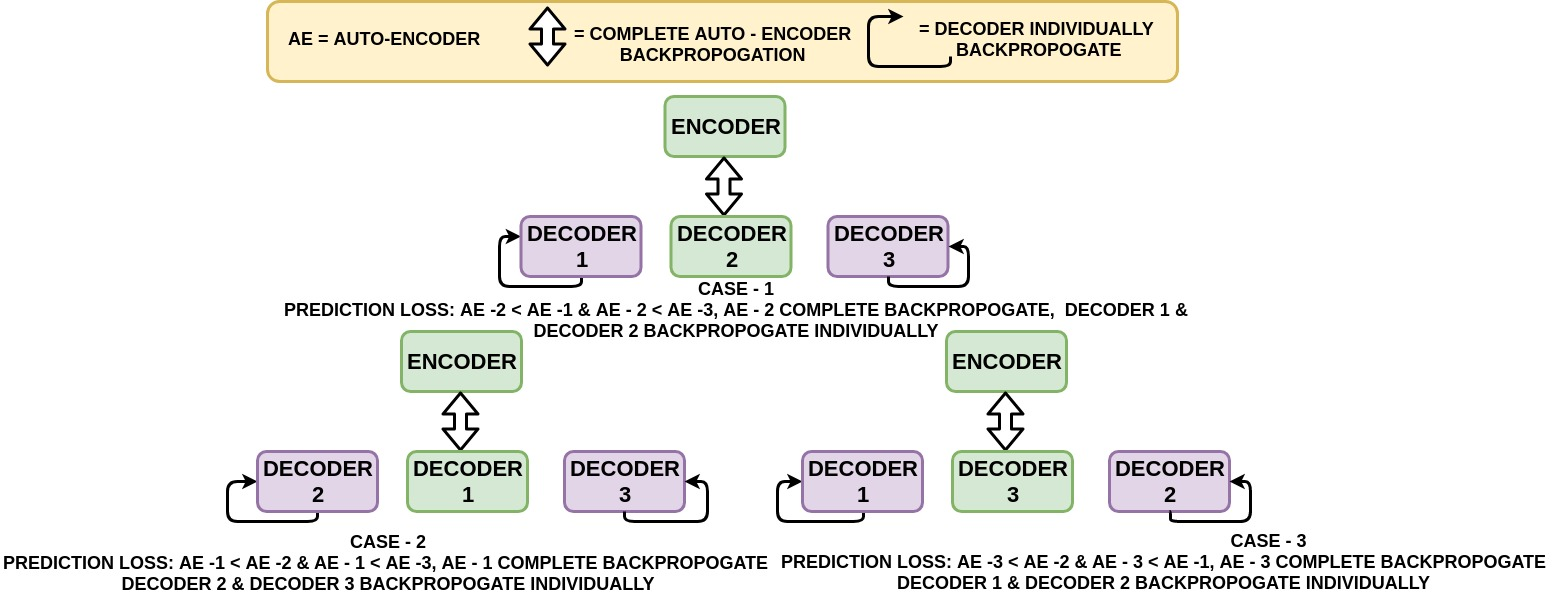
Podem ocorrer seis condições na sua rede:
loss_1: perda do Autoencoder 1
loss_2: perda do Autoencoder 2
loss_3: perda do Autoencoder 3
if loss_1 < loss_2 and loss_1 < loss_3:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1: %f\n' % (j,batch,train_1))
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_loss_3: %f\n' % (j,batch,train_3))
elif loss_2 < loss_1 and loss_2 < loss_3:
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_2: %f\n' % (j,batch,train_2))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_1.summary()
    #autoencoder_3.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" % (train_1))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3: %f\n' % (j,batch,train_3))
elif loss_3 < loss_1 and loss_3 < loss_2:
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_3: %f\n' % (j,batch,train_3))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    #autoencoder_1.summary()
    #autoencoder_2.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" %(train_1))
    myfile_dec2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
elif loss_1 == loss_2:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
elif loss_2 == loss_3:
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False

    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" % (train_1))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
elif loss_3 == loss_1:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))


    myfile_ae1_loss.close()
    myfile_ae2_loss.close()
    myfile_ae3_loss.close()
    myfile_dec1_loss.close()
    myfile_dec2_loss.close()
    myfile_dec3_loss.close()
Este passo é essencial: como em algumas condições acima você definiu camadas como False, é preciso reativá-las (True) para que todas as camadas dos autoencoders sejam usadas na função test_on_batch — e não fiquem desativadas durante todo o treino.
for layer in autoencoder_1.layers[:34]:
            layer.trainable = True
for layer in autoencoder_2.layers[:34]:
            layer.trainable = True
for layer in autoencoder_3.layers[:34]:
            layer.trainable = True
Você salvará os pesos de três formas; abaixo estão duas: salvar a cada 100 épocas e salvar a cada época (neste caso, sobrescrevendo).
if jj % 100 ==0:
            autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1_" + str(jj)+".h5")
            autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2_" + str(jj)+".h5")
            autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3_" + str(jj)+".h5")


autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1.h5")
autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2.h5")
autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3.h5")
Primeiro, embaralhe os dados de validação e use as mesmas seis condições possíveis definidas acima. A condição verdadeira determina com qual autoencoder você vai testar o modelo.
Depois, calcule duas métricas, MSE e PSNR, entre decoded_imgs (previsto) e ground truth. Por fim, salve em arquivos de texto.
X_test,y_test = shuffle(X_test,y_test)
if loss_1 < loss_2 and loss_1 < loss_3:
    decoded_imgs = autoencoder_1.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)


    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))

    #print (check)
elif loss_2 < loss_1 and loss_2 < loss_3:
    decoded_imgs = autoencoder_2.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))

    #print (check)
elif loss_3 < loss_2 and loss_3 < loss_1:
    decoded_imgs = autoencoder_3.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))
    #print (check)

elif loss_1 == loss_2:
    decoded_imgs = autoencoder_1.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))


elif loss_2 == loss_3:
    decoded_imgs = autoencoder_2.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))


elif loss_3 == loss_1:
    decoded_imgs = autoencoder_3.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))
Aqui, você salva os pesos somente quando o PSNR entre o 7T previsto e o 7T ground truth for o máximo em comparação aos valores anteriores armazenados na lista psnr_gray_channel.
if max(psnr_gray_channel) < psnr_7T:
            autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1_" + str(jj)+".h5")
            autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2_" + str(jj)+".h5")
            autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3_" + str(jj)+".h5")

    psnr_gray_channel.append(psnr_7T)
Defina uma matriz numpy temp de tamanho 176 x 528, pois salvaremos 3 imagens em uma única linha, cada uma de 176 x 176. Vamos salvar uma das imagens entre validação 3T, 7T e a prevista, e multiplicar a matriz por 255, já que as imagens foram escaladas entre 0 e 1.
Por fim, usando scipy, salve a imagem.
temp = np.zeros([resizeTo,resizeTo*3])
temp[:resizeTo,:resizeTo] = X_test[0,:,:,0]
temp[:resizeTo,resizeTo:resizeTo*2] = y_test[0,:,:,0]
temp[:resizeTo,2*resizeTo:] = decoded_imgs[0,:,:,0]
temp = temp*255
scipy.misc.imsave('../Results/1_encoder_3_decoders_complete_slices_single_channel/' + str(j) + '.jpg', temp)
j +=1
Vamos fechar os arquivos de PSNR e MSE ao final.
myfile_valid_psnr_7T.close()
myfile_valid_mse_7T.close()
Por fim, ao término, reduza a taxa de aprendizado em 10% do valor atual a cada 20 épocas.
if jj % 20 ==0:
        learning_rate = learning_rate - learning_rate * 0.10
Na parte 2 deste tutorial, você vai abordar:
nibabel.Antes de começar, certifique-se de usar exatamente as mesmas versões dos módulos indicadas abaixo:
Observação: Antes de começar, note que o modelo será treinado em um sistema com GPU Nvidia 1080 Ti, processador Xeon e5 GeForce e 32 GB de RAM. Se você estiver usando Jupyter Notebook, será preciso adicionar três linhas de código para especificar a ordem do dispositivo CUDA e os dispositivos visíveis CUDA usando o módulo os.
No código abaixo, você basicamente define variáveis de ambiente no notebook usando os.environ. É recomendável fazer isso antes de inicializar o Keras para limitar o TensorFlow (backend do Keras) a usar a primeira GPU. Se a máquina em que você treina tem a GPU no índice 0, use 0 em vez de 1. Você pode verificar isso executando no terminal um comando simples como nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU
Primeiro, importe todos os módulos necessários como tensorflow, numpy e, principalmente, keras e as funções/camadas como Input, Conv2D, MaxPooling2D etc., já que você vai usar esses frameworks para treinar o modelo!
Para ler imagens no formato NIfTI, também é preciso importar o módulo nibabel.
import os
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
import numpy as np
import scipy.misc
import numpy.random as rng
from sklearn.utils import shuffle
import nibabel as nib
from sklearn.cross_validation import train_test_split
import math
O dataset de RM cerebral 3T e 7T consiste em volumes 3D; cada volume tem 207 cortes/imagens de RM do cérebro em diferentes fatias. Cada corte tem dimensão 173 x 173. As imagens são em escala de cinza com um único canal. Ao todo, são 39 sujeitos, cada um contendo o exame de RM de um paciente. O formato das imagens não é jpeg, png etc., e sim NIfTI. Na seção adiante, você verá como ler imagens no formato NIfTI.
O dataset consiste em imagens de RM na modalidade T1; sequências T1 são tradicionalmente boas para avaliar estruturas anatômicas. O dataset que você vai usar hoje é composto por RMs cerebrais de 3T e 7T.
O dataset é público e pode ser baixado nesta fonte.
Vamos definir primeiro as dimensões dos dados. Você vai redimensionar de 173x173 para 176x176 na etapa de leitura. Aqui também definimos o diretório dos dados, o batch size usado no treino, o número de canais, uma camada Input(), as matrizes de treino e teste como listas e, por fim, para reescalonamento, carregamos o arquivo de texto com os valores mínimo e máximo do dataset de RM.
x,y = 173,173
full_z = 207
resizeTo=176
inChannel = outChannel = 1
input_shape=(x,y,inChannel)
input_img = Input(shape = (resizeTo, resizeTo, inChannel))
train_matrix = []
test_matrix = []
ff = os.listdir("../test_crossval1")
save = "../Result_nii_crossval1"
folder_ground = os.listdir("../test_g_crossval1")
ToPredict_images=[]
predict_matrix=[]
ground_images=[]
ground_matrix=[]
min_max=np.loadtxt('../maxANDmin.txt')
Agora, carregamos os dados de RM usando a biblioteca nibabel e redimensionamos as imagens de 173 x 173 para 176 x 176 preenchendo com zeros nas dimensões x e y.
Observe que, ao carregar um volume NIfTI, o Nibabel não carrega imediatamente o array de imagem — ele espera até você solicitar os dados. A forma padrão é chamando o método get_data().
Como você quer cortes 2D em vez de 3D, use as listas train e test inicializadas anteriormente; sempre que ler um volume, itere por todos os 207 cortes do volume 3D e anexe cada corte, um a um, à lista.
for f in ff:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load("../test_crossval1" + f)
    affine = a.affine
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        predict_matrix.append(a[:,j,:])
for f in ff:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load("../test_g_crossval1" + f)
    affine = a.affine
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        ground_matrix.append(a[:,j,:])
Como as matrizes de teste 3T e 7T são listas, use numpy para convertê-las em arrays.
Depois, converta o type para float32 e reescale tanto o input quanto o ground truth.
ToPredict_images = np.asarray(predict_matrix)
ToPredict_images = ToPredict_images.astype('float32')
mx = min_max[0]
mn = min_max[1]
ToPredict_images[:,:,:,0] = (ToPredict_images[:,:,:,0] - mn ) / (mx - mn)
ground_images = np.asarray(ground_matrix)
ground_images = ground_images.astype('float32')
ground_images[:,:,:,0] = (ground_images[:,:,:,0] - mn ) / (mx - mn)
Agora, crie duas novas variáveis, ToPredict_images (3T teste/input) e ground_images (7T teste/ground truth), com o mesmo shape das matrizes de treino e teste. Será uma matriz 4D em que a primeira dimensão é o total de imagens, a segunda e a terceira são as dimensões de cada imagem e a última é o número de canais (um, neste caso).
ToPredict_images=np.zeros(shape=[(ToPredict_images.shape[0]),(ToPredict_images.shape[1]),(ToPredict_images.shape[2]),(1)])
ground_images=np.zeros(shape=[(ground_images.shape[0]),(ground_images.shape[1]),(ground_images.shape[2]),(1)])
Depois, itere por todas as imagens; a cada vez, reformate as matrizes de treino e teste para 176 x 176 e anexe em ToPredict_images (3T teste/input) e ground_images (7T teste/ground truth), respectivamente.
for i in range(ToPredict_images.shape[0]):
    ToPredict_images[i,:,:,0] = ToPredict_images[i,:,:].reshape(resizeTo,resizeTo)
for i in range(ground_images.shape[0]):
    ground_images[i,:,:,0] = ground_images[i,:,:].reshape(resizeTo,resizeTo)
def encoder(input_img):
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    pool3 = MaxPooling2D(pool_size=(2, 2))(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(pool3)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv4)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='sigmoid', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    return conv5,conv4,conv3,conv2,conv1
def decoder(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded
Agora, vamos usar o erro quadrático médio excluindo os valores (pixels) de y_t e y_p que são iguais a zero.
def root_mean_sq_GxGy(y_t, y_p):
    a1=1
    zero = tf.constant(0, dtype=tf.float32)
    where = tf.not_equal(y_t, zero)
    a_t=tf.boolean_mask(y_t,where,name='boolean_mask')
    a_p=tf.boolean_mask(y_p,where,name='boolean_mask')
    return a1*(K.sqrt(K.mean((K.square(a_t-a_p)))))
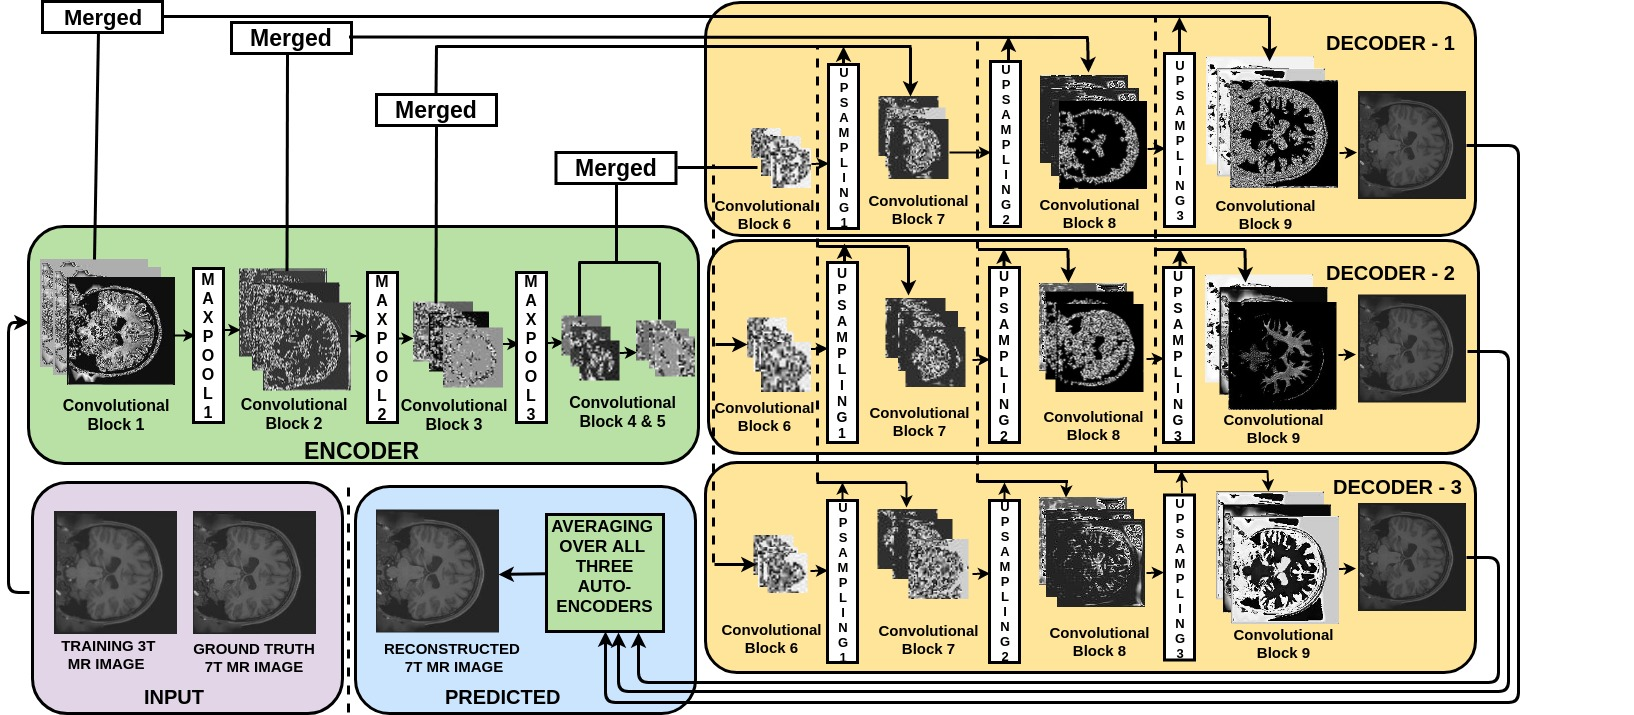
Primeiro, vamos chamar a função encoder passando a entrada. Como usamos conexões de merge na arquitetura, a função encoder retorna a saída de cinco camadas convolution, que serão mescladas separadamente com a saída dos três decoders.
conv5,conv4,conv3,conv2,conv1 = encoder(input_img)
Agora, vamos criar três modelos diferentes e carregar neles os pesos treinados.
autoencoder_1 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_1.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE1.h5")
autoencoder_2 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_2.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE2.h5")
autoencoder_3 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_3.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE3.h5")
Vamos inicializar rapidamente dois arrays numpy de tamanho 11 x 3 x 1: a primeira dimensão representa o número de volumes usados no teste; a segunda representa MSE e PSNR entre: saída prevista 7T e ground truth 7T, saída prevista e entrada 3T, e entrada 3T e ground truth 7T; a terceira dimensão representa o número de canais de entrada do modelo.
mse= np.zeros([11,3,1])
psnr= np.zeros([11,3,1])
i=0 #para iterar sobre os cortes dos 11 volumes
Na sequência, você vai iterar pelos 11 volumes, um a um. Em cada iteração, fará a predição do volume com os três autoencoders e, ao final, fará a média das previsões.
Em cada volume, você iterará pelos canais e calculará PSNR e MSE para os três casos discutidos acima.
Depois, usando a biblioteca nibabel, você salvará a saída prevista, a entrada (3T) e o ground truth (7T) como arquivos .nii: cada um dos 11 volumes com 207 cortes.
Por fim, salve a matriz de PSNR em um arquivo de texto usando numpy.
Como indicado no artigo, fazer a média das saídas previstas ajuda a reduzir ruído e preservar características locais nas imagens reconstruídas, melhorando o PSNR em relação às saídas individuais dos decoders.
for j in range(11):
    decoded_imgs_1 = autoencoder_1.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs_2 = autoencoder_2.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs_3 = autoencoder_3.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs = np.mean( np.array([ decoded_imgs_1, decoded_imgs_2,decoded_imgs_3 ]), axis=0 )
    for channel in range(1):
        mse[j,0,channel]=  np.mean((ground_images[i:i+207,:,:,channel] - decoded_imgs[:,:,:,channel]) ** 2)
        psnr[j,0,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,0,channel]))
        mse[j,1,channel]=  np.mean((ground_images[i:i+207,:,:,channel] - ToPredict_images[i:i+207,:,:,channel])** 2)
        psnr[j,1,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,1,channel]))
        mse[j,2,channel] =  np.mean((ToPredict_images[i:i+207,:,:,channel] - decoded_imgs[:,:,:,channel]) ** 2)
        checklt = math.sqrt(mse[j,2,channel])
        psnr[j,2,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,2,channel]))
    obj = nib.Nifti1Image(decoded_imgs, affine)
    string =str(j)+'_crossval1.nii'
    nib.save(obj, save + string)
    obj = nib.Nifti1Image(ground_images[i:i+207,:,:,:], affine)
    string =str(j)+'_ground_images_crossval1.nii'
    nib.save(obj, save + string)
    obj = nib.Nifti1Image(ToPredict_images[i:i+207,:,:,:], affine)
    string =str(j)+'_ToPredict_images_crossval1.nii'
    nib.save(obj, save + string)
    i=i+207


np.savetxt('psnr_all_slices.txt',psnr[:,:,0])
Se você quiser aprender mais sobre Python, faça o curso Introduction to Data Visualization with Matplotlib da DataCamp.
Confira também o Keras Tutorial: Deep Learning in Python.
Saiba mais sobre Python e deep learning
Curso
Curso
Curso
Tutorial
Natassha Selvaraj
8 min
Tutorial
Moez Ali
14 min
Tutorial
Karlijn Willems
14 min
Tutorial
Avinash Navlani
10 min
Tutorial
Kevin Babitz
8 min
Tutorial
DataCamp Team
10 min





