Kurs
Keras ile Deep Learning'e Giriş
4 sa
46.4K
Eğitim Betiği bölümünde, yeni bir derin öğrenme mimarisi kullanarak görüntü süper-çözünürlük problemini ele alacaksınız. Elinizdeki görev, düşük alanlı 3-Tesla Beyin MR Görüntüsünden yüksek alanlı 7-Tesla Beyin MR Görüntüsüne doğrusal olmayan bir eşleme yapmaktır. Bu Test Betiği bölümünde ise, Bölüm-1’de eğitilen ağırlıkları kullanacak ve görülmemiş eğitim verileri üzerinde tahmin yapacaksınız. Ayrıca 2B görüntüleri birleşik bir hacim olarak nasıl kaydedeceğinizi de öğreneceksiniz.
Bu eğitim iki parçaya ayrılmıştır; ilk kısım sizi eğitim sürecinde adım adım yönlendirecek, ikinci kısım ise test sürecini kapsayacaktır.
Not: Makaleyi okumak isteyebilirsiniz; öyleyse, ilgili yazıyı burada bulabilirsiniz.
Özetle, eğitimin Birinci Bölümünde aşağıdaki konuları ele alacaksınız:
Bu eğitimi takip etmeye başlamadan önce, aşağıda belirtilen modül sürümlerinin aynısına sahip olduğunuzdan emin olun:
Not: Başlamadan önce, modelin Nvidia 1080 Ti GPU Xeon e5 GeForce işlemcili ve 32 GB RAM’li bir sistemde eğitileceğini lütfen unutmayın. Jupyter Notebook kullanıyorsanız, os adlı bir modül kullanarak CUDA aygıt sırasını ve görünür CUDA aygıtlarını belirttiğiniz üç satır daha eklemeniz gerekir.
Aşağıdaki kodda, os.environ kullanarak not defterinde ortam değişkenlerini ayarlıyorsunuz. Keras’ı başlatmadan önce bunu yapmak, Keras arka ucu TensorFlow’un ilk GPU’yu kullanmasını sınırlandırmak için iyidir. Eğittiğiniz makinede GPU 0 konumundaysa, 1 yerine 0 kullandığınızdan emin olun. Bunu terminalinizde basit bir komut çalıştırarak doğrulayabilirsiniz: örneğin, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU
İlk olarak tensorflow, numpy ve en önemlisi keras ile Input, Conv2D,MaxPooling2D gibi gerekli işlev veya katmanlar dahil olmak üzere ihtiyaç duyulan tüm modülleri içe aktaracaksınız; çünkü modeli eğitmek için bu çerçevelerin hepsini kullanacaksınız!
Nifti formatındaki görüntüleri okumak için ayrıca nibabel adlı bir modülü de içe aktarmanız gerekir.
import os
import numpy as np
import math
import tensorflow as tf
import nibabel as nib
import numpy as np
from keras.layers import Input,Dense,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import RMSprop
from keras import backend as K
import scipy.misc
from sklearn.utils import shuffle
from sklearn.cross_validation import train_test_split
import matplotlib.pyplot as plt
from keras.models import model_from_json
Using TensorFlow backend.
/usr/local/lib/python3.5/dist-packages/sklearn/cross_validation.py:41: DeprecationWarning: This module was deprecated in version 0.18 in favor of the model_selection module into which all the refactored classes and functions are moved. Also, note that the interface of the new CV iterators is different from that of this module. This module will be removed in 0.20.
  "This module will be removed in 0.20.", DeprecationWarning)
Beyin MRG 3T ve 7T veri kümesi, her biri toplamda beyinin farklı kesitlerinden alınmış 207 dilim/görüntü içeren 3B hacimlerden oluşur. Her dilim 173 x 173 boyutundadır. Görüntüler tek kanallı gri tonlamalıdır. Toplamda 39 denek vardır; her denek bir hastanın MRG taramasını içerir. Görüntü formatı jpeg, png vb. değil, nifti formatındadır. Nifti formatındaki görüntülerin nasıl okunacağını ilerleyen bir bölümde göreceksiniz.
Veri kümesi T1 modalitesi MR görüntülerinden oluşur; T1 sekansları geleneksel olarak anatomik yapıların değerlendirilmesi için iyi kabul edilir. Bugün üzerinde çalışacağınız veri kümesi 3T ve 7T Beyin MRG’lerinden oluşmaktadır.
Veri kümesi herkese açıktır ve bu kaynak üzerinden indirilebilir.
28 denek eğitim için, kalan 11 denek ise test amacıyla kullanılacaktır.
Önce verilerin boyutlarını tanımlayalım. Veri okuma kısmında görüntü boyutunu 173x173’ten 176x176’ya yeniden boyutlandıracaksınız. Burada ayrıca veri dizinini, modeli eğitmek için parti boyutunu, kanal sayısını, bir Input() katmanını, eğitim ve test matrislerini liste olarak ve son olarak yeniden ölçeklendirme için MRG veri setinin minimum ve maksimum değerlerini içeren metin dosyasını tanımlayacaksınız.
Not: Yeniden ölçeklendirme için, elinizde maxANDmin.txt dosyası olmayacağından veri setinin maksimum ve minimumunu da alabilirsiniz.
x,y = 173,173
full_z = 207
resizeTo=176
batch_size = 32
inChannel = outChannel = 1
input_shape=(x,y,inChannel)
input_img = Input(shape = (resizeTo, resizeTo, inChannel))
inp = "ground3T"
out = "ground7T"
train_matrix = []
test_matrix = []
min_max = np.loadtxt('maxANDmin.txt')Sonraki adımda, nibabel kütüphanesini kullanarak mrg verilerini yükleyecek ve görüntüleri x ve y boyutlarında sıfır doldurarak 173 x 173’ten 176 x 176’ya yeniden boyutlandıracaksınız.
Bir Nifti formatlı hacmi yüklediğinizde, Nibabel görüntü dizisini yüklemez. Dizi verisini isteyene kadar bekler. Dizi verisini istemenin standart yolu get_data() metodunu çağırmaktır.
3B yerine 2B dilimler istediğiniz için, önceden başlattığınız train ve test listelerini kullanacaksınız; her hacmi okuduğunuzda, 3B hacmin tüm 207 dilimi üzerinde yineleme yapacak ve her dilimi tek tek listeye ekleyeceksiniz.
folder = os.listdir(inp)
Önce 3T verilerini yükleyelim.
for f in folder:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load(inp + f)
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        train_matrix.append(a[:,j,:])
Ardından 7T verilerini yükleyin ve 7T verilerini yüklemek için de 3T ve 7T MR hacimlerinin sayısı eşit olduğundan aynı folder değişkenini kullanın.
for f in folder:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    b = nib.load(out + f)
    b = b.get_data()
    temp[3:,:,3:] = b
    b = temp
    for j in range(full_z):
        test_matrix.append(b[:,j,:])
Eğitim ve test matrisleri bir liste olduğundan, listeyi bir numpy dizisine dönüştürmek için numpy modülünü kullanacaksınız.
Ayrıca numpy dizisinin type’ını float32’ye dönüştürecek ve hem giriş hem de gerçek değer (ground truth) için yeniden ölçeklendirme yapacaksınız.
train_matrix = np.asarray(train_matrix)
train_matrix = train_matrix.astype('float32')
m = min_max[0]
mi = min_max[1]
train_matrix = (train_matrix - mi) / (m - mi)

test_matrix = np.asarray(test_matrix)
test_matrix = test_matrix.astype('float32')
test_matrix = (test_matrix - mi) / (m - mi)
Hızlıca train_matrix (3T) ve test_matrix (7T) matrislerinin şekillerini yazdıralım. Toplamda 28 x 207 = 5796 görüntü bulunmalı ve her biri 176 x 176 boyutunda olmalıdır.
train_matrix.shape
(5796, 176, 176)
test_matrix.shape
(5796, 176, 176)
Sonraki adımda, eğitim ve test matrislerinin şekline sahip iki yeni değişken augmented_images(3T/giriş) ve Haugmented_images (7T/gerçek değer) oluşturacaksınız. Bu, ilk boyutu toplam görüntü sayısını, ikinci ve üçüncü boyutları her görüntünün boyutlarını ve son boyutu ise bu durumda bir olan kanal sayısını ifade eden 4B bir matris olacaktır."
augmented_images=np.zeros(shape=[(train_matrix.shape[0]),(train_matrix.shape[1]),(train_matrix.shape[2]),(1)])
Haugmented_images=np.zeros(shape=[(train_matrix.shape[0]),(train_matrix.shape[1]),(train_matrix.shape[2]),(1)])
Sonra tüm görüntüler üzerinde tek tek yineleme yapacak, her seferinde eğitim ve test matrisini 176 x 176 olarak yeniden şekillendirip sırasıyla augmented_images(3T/giriş) ve Haugmented_images (7T/gerçek değer) içine ekleyeceksiniz.
for i in range(train_matrix.shape[0]):
    augmented_images[i,:,:,0] = train_matrix[i,:,:].reshape(resizeTo,resizeTo)
    Haugmented_images[i,:,:,0] = test_matrix[i,:,:].reshape(resizeTo,resizeTo)
Tüm bunlardan sonra veriyi bölmek önemlidir. Modelinizin iyi genelleme yapabilmesi için veriyi iki parçaya ayırırsınız: eğitim ve doğrulama seti. Modelinizi verilerin %80’i ile eğitecek ve kalan %20’lik kısım üzerinde doğrulayacaksınız.
Bu, modeli eğitim aşamasında görmediği veriler üzerinde doğrulayacağınız için aşırı uyum riskini azaltmanıza da yardımcı olur.
Verileri uygun şekilde bölmek için, başta tanımladığınız scikit-learn’ün train_test_split modülünü kullanabilirsiniz:
data,Label = shuffle(augmented_images,Haugmented_images, random_state=2)
X_train, X_test, y_train, y_test = train_test_split(data, Label, test_size=0.2, random_state=2)
X_test = np.array(X_test)
y_test = np.array(y_test)
X_test = X_test.astype('float32')
y_test = y_test.astype('float32')
X_train = np.array(X_train)
y_train = np.array(y_train)
X_train = X_train.astype('float32')
y_train = y_train.astype('float32')
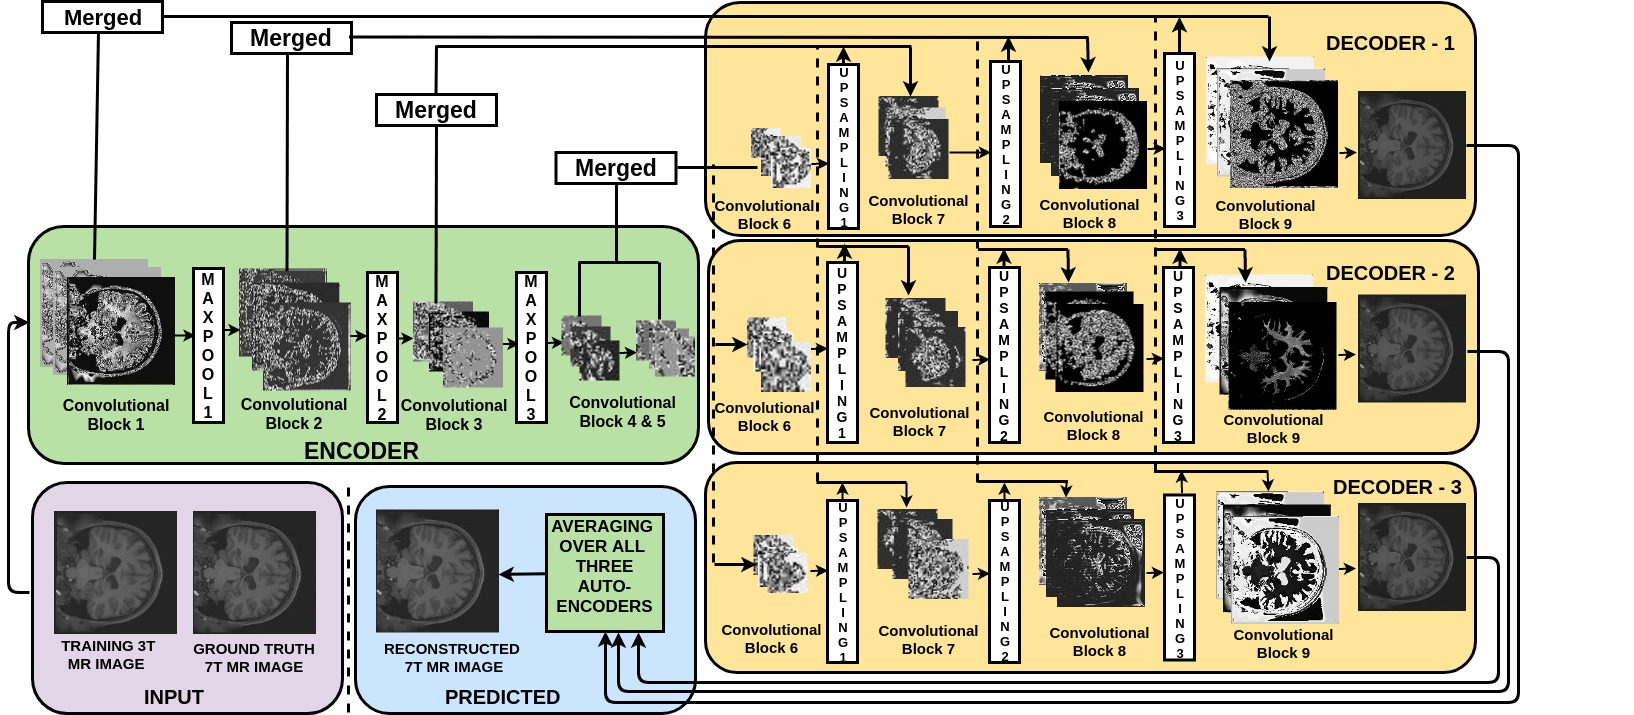
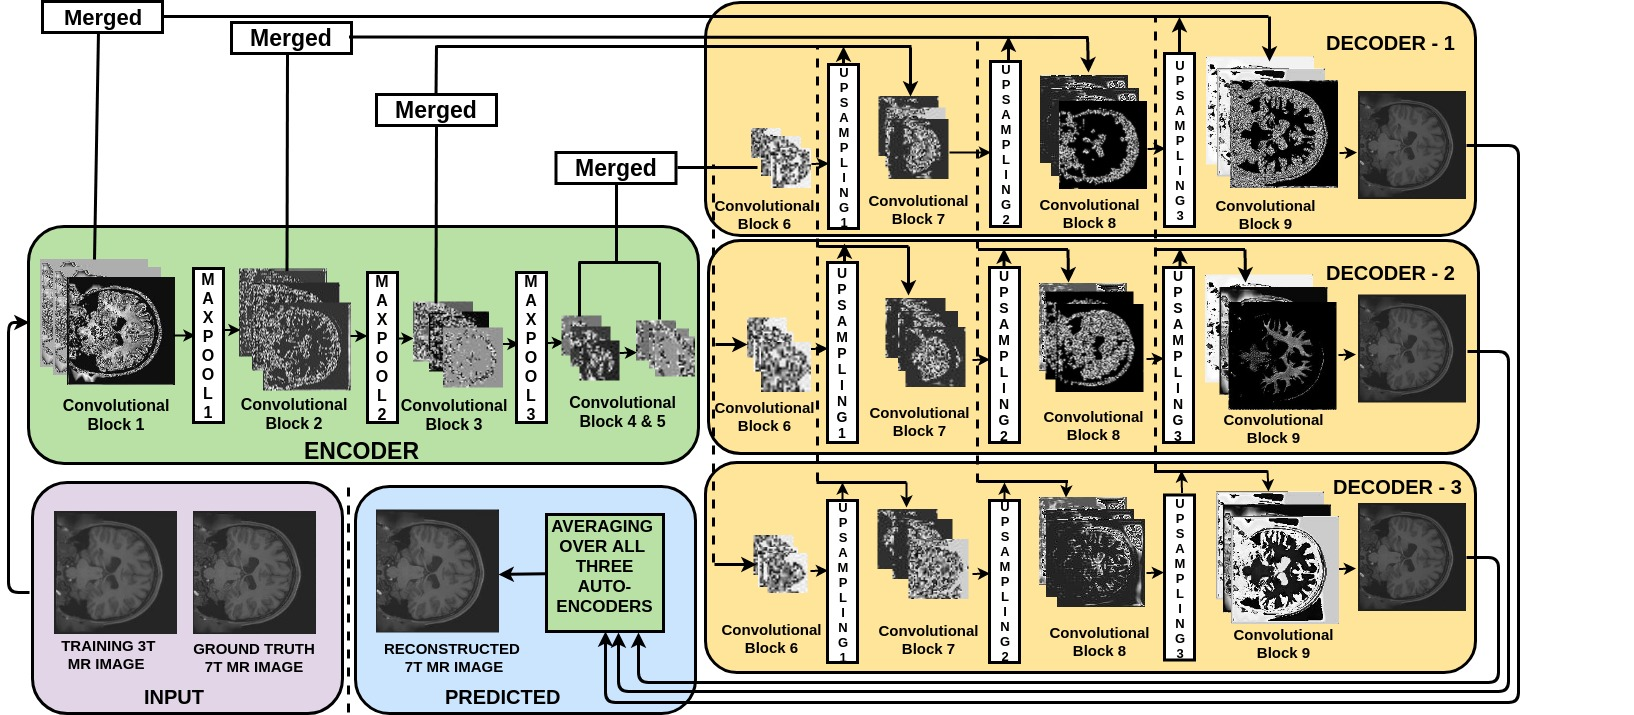
Sonraki adımda, aşağıdaki hücrede gösterildiği gibi kodlayıcı bölümünde azami havuzlama katmanını izleyen ardışık filtre katman bloklarıyla önerilen mimariyi tanımlarsınız. Çıkışta bir görüntünün orijinal boyutunu yeniden kurmak için, kod çözücülerdeki her blokta bir yeniden örnekleme (upsampling) katmanı kullanılır. Yeniden örnekleme sırasında, kod çözücünün aşağı örneklenmiş girişindeki eksik ayrıntılar nedeniyle bazı yapaylıklar oluşabilir. Bu nedenle, kod çözücünün girişini kodlayıcıdan yukarı örneklenmiş sürümüyle birleştirerek, kod çözücüde yeniden örnekleme esnasında daha iyi yeniden yapılandırma için yukarı örneklenmiş ayrıntıların doğasını sağlarsınız. Nitekim, birleştirme bağlantılarının eklenmesi belirgin bir PSNR iyileşmesi sağlar (yaklaşık 5 dB mertebesinde). Mimari ayarımız bu makaleden esinlenilmiştir.
Önerilen yaklaşım, tek kanallı girişle tek bir kodlayıcı ve birden fazla kod çözücü mimarisini kullanır. Kodlayıcıda ve üç kod çözücünün tamamında her blokta üç evrişim katmanı kullanılır ve sayısal kararlılığı korumak için bunları bir toplu normalleştirme katmanı izler.
Kodlayıcıdaki ilk evrişim bloğu 32 filtreye sahiptir ve filtre sayısı her evrişim bloğundan sonra iki katına çıkar. Tüm kod çözücülerde ilk evrişim bloğu 256 filtreye sahiptir ve filtre sayısı her bloktan sonra yarıya indirilir. Tüm evrişim bloklarında 3’e 3 filtre boyutu kullanacaksınız.
Düzeltilmiş Doğrusal Birim (ReLU), son katman hariç tüm katmanlarda aktivasyon fonksiyonu olarak kullanılacaktır. Veriler 0 ile 1 arasında normalize edildiği için, son katmanda Sigmoid aktivasyon fonksiyonu kullanılır.
Farklı ölçeklerdeki yerel görüntü ayrıntılarının görüntü yeniden yapılandırmada önemli rol oynadığı bilinmektedir. Önerilen mimari, kodlayıcı ve kod çözücülerde sırasıyla aşağı örnekleme (maxpooling) ve yukarı örnekleme (her biri 2 faktörü için) için hiyerarşik katmanlar kullanarak görüntüleri farklı ölçeklerde ele alır. Üç aşağı örnekleme işleminden sonra elde edilen kodlanmış gösterim, verileri yüksek boyutlu bir girişten örtük (latent) uzay gösterimine dönüştürür.
def encoder(input_img):
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    pool3 = MaxPooling2D(pool_size=(2, 2))(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(pool3)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv4)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='sigmoid', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    return conv5,conv4,conv3,conv2,conv1
def decoder_1(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_1 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_1
def decoder_2(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_2 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_2
def decoder_3(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_3 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_3
Yukarıdaki 4 hücrede dört işlev tanımladınız. Biri kodlayıcı, kalan üçü kod çözücüler içindir. Bunlar işlev olduğu için decoder() işlevini tanımlayıp üç kez çağırabilirsiniz; ancak daha iyi anlaşılması ve üç kod çözücünün rastgeleliğindeki olası sorunları önlemek için burada üç kez tanımlayacaksınız.
Sonraki adımda, hem gerçek değer y_t hem de y_p içinde sıfıra eşit olan değerleri (pikselleri) hariç tuttuğunuz ortalama kare hata kullanacaksınız.
def root_mean_sq_GxGy(y_t, y_p):
    a1=1
    where = tf.not_equal(y_t, 0)
    a_t=tf.boolean_mask(y_t,where,name='boolean_mask')
    a_p=tf.boolean_mask(y_p,where,name='boolean_mask')
    return a1*(K.sqrt(K.mean((K.square(a_t-a_p)))))
Önce encoder işlevini girdiyi ona ileterek çağıracaksınız. Mimarinizde birleştirme bağlantıları kullandığınız için, encoder işlevi beş convolution katmanının çıktısını döndürür ve bunları her üç kod çözücünün çıktısıyla ayrı ayrı merge edersiniz.
conv5,conv4,conv3,conv2,conv1 = encoder(input_img)
autoencoder_1 = Model(input_img, decoder_1(conv5,conv4,conv3,conv2,conv1))
autoencoder_1.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())

autoencoder_2 = Model(input_img, decoder_2(conv5,conv4,conv3,conv2,conv1))
autoencoder_2.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())

autoencoder_3 = Model(input_img, decoder_3(conv5,conv4,conv3,conv2,conv1))
autoencoder_3.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:2: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.

/usr/local/lib/python3.5/dist-packages/keras/legacy/layers.py:460: UserWarning: The `Merge` layer is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
  name=name)
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:10: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
  # Remove the CWD from sys.path while we load stuff.
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:18: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:26: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.


WARNING:tensorflow:From /usr/local/lib/python3.5/dist-packages/keras/backend/tensorflow_backend.py:1257: calling reduce_mean (from tensorflow.python.ops.math_ops) with keep_dims is deprecated and will be removed in a future version.
Instructions for updating:
keep_dims is deprecated, use keepdims instead
Ağırlıkları yalnızca doğrulama verisi üzerindeki tepe sinyal-gürültü oranı iyileştiğinde kaydedeceksiniz. Bunun için, varsayılan değer olarak 1 ekleyeceğiniz bir psnr_gray_channel listesi tanımlayacaksınız; 1 eklemenizin nedeni listeyi rastgele bir sayıyla başlatmanız gerektiğidir ve PSNR, eğitim sürecinin ilk aşamalarında bile bu değerden çok daha yüksek olacaktır; bu da yalnızca bir yer tutucu değer olarak işlev görecektir.
Öğrenme oranını 1e-3 olarak başlatacak ve her 20 epoch’tan sonra mevcut değerinden %10 azaltacağınız bir öğrenme oranı azalma stratejisi kullanacaksınız!
psnr_gray_channel = []
psnr_gray_channel.append(1)
learning_rate = 0.001
j=0
Not: Bir sonraki tam kod tek bir hücrede çalıştırılmalıdır; ancak tüm eğitim sürecinin daha iyi anlaşılması için küçük hücrelere bölünecektir.
Model 500 epoch boyunca eğitilir. Başlangıç öğrenme oranı bir önceki hücrede tanımlandığı üzere 1e-3’tür. Her epoch’tan sonra 7T ile tahmin edilen sonuçlar arasındaki PSNR ve MSE değerlerini de kaydedeceksiniz. K.set_value işlevini kullanarak her 20 epoch’tan sonra üç modelin de öğrenme oranını %10 azaltacaksınız.
for jj in range(500):
    myfile_valid_psnr_7T = open('../1_encoder_3_decoders_complete_slices_single_channel/validation_psnr7T_1encoder_3decoders.txt', 'a')
    myfile_valid_mse_7T = open('../1_encoder_3_decoders_complete_slices_single_channel/validation_mse7T_1encoder_3decoders.txt', 'a')

    K.set_value(autoencoder_1.optimizer.lr, learning_rate)
    K.set_value(autoencoder_2.optimizer.lr, learning_rate)
    K.set_value(autoencoder_3.optimizer.lr, learning_rate)
Sonra, ağı aşırı uyumdan kaçınmak için giriş 3T ve gerçek değer 7T görüntülerini karıştırırsınız; çünkü karıştırmamak, modelin her epoch’ta örnekleri aynı sırayla görmesine neden olur. Ardından, daha önce tanımladığınız batch_size’a göre oluşturulacak parti sayısını hesaplayacaksınız. Son olarak num_batches üzerinde yinelemeye başlayacaksınız.
train_X,train_Y = shuffle(X_train,y_train)
print ("Epoch is: %d\n" % j)
print ("Number of batches: %d\n" % int(len(train_X)/batch_size))
num_batches = int(len(train_X)/batch_size)
for batch in range(num_batches):
PSNR değerlerini saklamanın yanı sıra, her üç otokodlayıcının ve üç kod çözücünün kayıplarını da saklayacaksınız.
myfile_ae1_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae1_train_loss_1encoder_3decoders.txt', 'a')
myfile_ae2_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae2_train_loss_1encoder_3decoders.txt', 'a')
myfile_ae3_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae3_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec1_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec1_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec2_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec2_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec3_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec3_train_loss_1encoder_3decoders.txt', 'a')
Her partide modelin bir sonraki 32 (batch_size) örneği görmesini istediğinizden, aşağıdaki hücre bunu sizin için yapar!
batch_train_X = train_X[batch*batch_size:min((batch+1)*batch_size,len(train_X)),:]
batch_train_Y = train_Y[batch*batch_size:min((batch+1)*batch_size,len(train_Y)),:]
Minimum otokodlayıcı stratejimizin çalışması için, her epoch’tan sonra Keras’ın sırasıyla üç kayıp verecek olan test_on_batch işlevini kullanarak eğitim verileri üzerinde test yaparsınız ve sonunda bunları yazdırırsınız.
loss_1 = autoencoder_1.test_on_batch(batch_train_X,batch_train_Y)
loss_2 = autoencoder_2.test_on_batch(batch_train_X,batch_train_Y)
loss_3 = autoencoder_3.test_on_batch(batch_train_X,batch_train_Y)
print ('epoch_num: %d batch_num: %d Test_loss_1: %f\n' % (j,batch,loss_1))
print ('epoch_num: %d batch_num: %d Test_loss_2: %f\n' % (j,batch,loss_2))
print ('epoch_num: %d batch_num: %d Test_loss_3: %f\n' % (j,batch,loss_3))
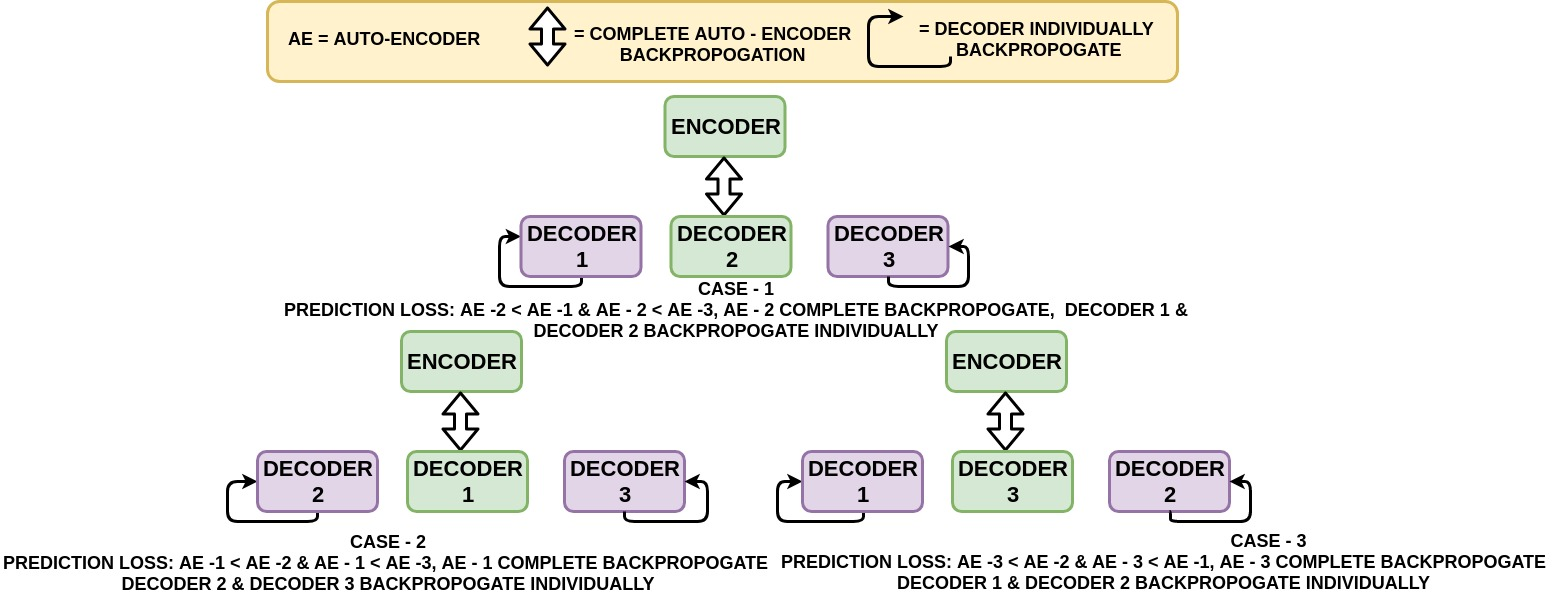
Ağınızda altı olası durum olabilir:
loss_1: Otokodlayıcı 1 kaybı
loss_2: Otokodlayıcı 2 kaybı
loss_3: Otokodlayıcı 3 kaybı
if loss_1 < loss_2 and loss_1 < loss_3:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1: %f\n' % (j,batch,train_1))
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_loss_3: %f\n' % (j,batch,train_3))
elif loss_2 < loss_1 and loss_2 < loss_3:
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_2: %f\n' % (j,batch,train_2))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_1.summary()
    #autoencoder_3.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" % (train_1))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3: %f\n' % (j,batch,train_3))
elif loss_3 < loss_1 and loss_3 < loss_2:
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_3: %f\n' % (j,batch,train_3))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    #autoencoder_1.summary()
    #autoencoder_2.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" %(train_1))
    myfile_dec2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
elif loss_1 == loss_2:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
elif loss_2 == loss_3:
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False

    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" % (train_1))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
elif loss_3 == loss_1:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))


    myfile_ae1_loss.close()
    myfile_ae2_loss.close()
    myfile_ae3_loss.close()
    myfile_dec1_loss.close()
    myfile_dec2_loss.close()
    myfile_dec3_loss.close()
Bu, önemli bir adımdır; çünkü yukarıdaki koşullarda bazı katmanları False yaptınız; bu katmanları True yapmanız gerekir ki tüm otokodlayıcı katmanları test_on_batch işlevinde kullanılabilsin ve eğitim boyunca False kalmasınlar.
for layer in autoencoder_1.layers[:34]:
            layer.trainable = True
for layer in autoencoder_2.layers[:34]:
            layer.trainable = True
for layer in autoencoder_3.layers[:34]:
            layer.trainable = True
Ağırlıkları üç farklı şekilde kaydedeceksiniz; aşağıda bunların ikisi yer alıyor. Birincisi, her 100 epoch’tan sonra ağırlıkları kaydedeceksiniz; ikincisi ise her epoch’tan sonra kaydedeceksiniz. Temelde, her epoch’tan sonra üzerlerine yazılır.
if jj % 100 ==0:
            autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1_" + str(jj)+".h5")
            autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2_" + str(jj)+".h5")
            autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3_" + str(jj)+".h5")


autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1.h5")
autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2.h5")
autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3.h5")
Önce doğrulama verisini karıştıracak ve sonra yukarıda tanımlandığı gibi meydana gelebilecek aynı 6 olası durumu kullanacaksınız. Hangi koşul doğruysa, modelinizi ilgili otokodlayıcıyı kullanarak test edeceksiniz.
Daha sonra decoded_imgs (tahmin) ile gerçek değer arasındaki iki metriği, MSE ve PSNR’yi hesaplayacaksınız. Son olarak bunları metin dosyalarına kaydedeceksiniz.
X_test,y_test = shuffle(X_test,y_test)
if loss_1 < loss_2 and loss_1 < loss_3:
    decoded_imgs = autoencoder_1.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)


    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))

    #print (check)
elif loss_2 < loss_1 and loss_2 < loss_3:
    decoded_imgs = autoencoder_2.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))

    #print (check)
elif loss_3 < loss_2 and loss_3 < loss_1:
    decoded_imgs = autoencoder_3.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))
    #print (check)

elif loss_1 == loss_2:
    decoded_imgs = autoencoder_1.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))


elif loss_2 == loss_3:
    decoded_imgs = autoencoder_2.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))


elif loss_3 == loss_1:
    decoded_imgs = autoencoder_3.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))
Burada, tahmin edilen 7T ile gerçek değer (7T) arasındaki PSNR, psnr_gray_channel listesinde saklanan önceki PSNR değerlerine kıyasla en yüksek olduğunda ağırlıkları yalnızca o zaman kaydedersiniz.
if max(psnr_gray_channel) < psnr_7T:
            autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1_" + str(jj)+".h5")
            autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2_" + str(jj)+".h5")
            autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3_" + str(jj)+".h5")

    psnr_gray_channel.append(psnr_7T)
Satırda üç görüntü kaydedileceği için her biri 176 x 176 boyutunda olmak üzere 176 x 528 boyutlarında bir temp adlı numpy matrisi tanımlayacaksınız. Tüm doğrulama 3T, 7T ve tahmin görüntülerinden herhangi birini kaydedecek ve matrisleri 0 ile 1 arasında ölçeklendirildikleri için 255 ile çarpacaksınız.
Son olarak scipy işlevini kullanarak görüntüyü kaydedeceksiniz.
temp = np.zeros([resizeTo,resizeTo*3])
temp[:resizeTo,:resizeTo] = X_test[0,:,:,0]
temp[:resizeTo,resizeTo:resizeTo*2] = y_test[0,:,:,0]
temp[:resizeTo,2*resizeTo:] = decoded_imgs[0,:,:,0]
temp = temp*255
scipy.misc.imsave('../Results/1_encoder_3_decoders_complete_slices_single_channel/' + str(j) + '.jpg', temp)
j +=1
Sonunda PSNR ve MSE dosyalarını kapatalım.
myfile_valid_psnr_7T.close()
myfile_valid_mse_7T.close()
Son olarak, her 20 epoch’tan sonra geçerli değerinin %10’u kadar öğrenme oranını düşüreceksiniz.
if jj % 20 ==0:
        learning_rate = learning_rate - learning_rate * 0.10
Bu eğitimin ikinci bölümünde aşağıdaki konuları ele alacaksınız:
nibabel kullanarak 2B görüntüleri birleşik bir hacim olarak kaydetmeyi öğreneceksiniz.Bu eğitimi takip etmeye başlamadan önce, aşağıda belirtilen modül sürümlerinin aynısına sahip olduğunuzdan emin olun:
Not: Başlamadan önce, modelin Nvidia 1080 Ti GPU Xeon e5 GeForce işlemcili ve 32 GB RAM’li bir sistemde eğitileceğini lütfen unutmayın. Jupyter Notebook kullanıyorsanız, os adlı bir modül kullanarak CUDA aygıt sırasını ve görünür CUDA aygıtlarını belirttiğiniz üç satır daha eklemeniz gerekir.
Aşağıdaki kodda, temel olarak os.environ kullanarak not defterinde ortam değişkenlerini ayarlarsınız. Keras’ı başlatmadan önce bunu yapmak, Keras arka ucu TensorFlow’un ilk GPU’yu kullanmasını sınırlandırmak için iyidir. Eğittiğiniz makinede GPU 0 konumundaysa, 1 yerine 0 kullandığınızdan emin olun. Bunu terminalinizde basit bir komut çalıştırarak doğrulayabilirsiniz: örneğin, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU
İlk olarak tensorflow, numpy ve en önemlisi keras ile Input, Conv2D,MaxPooling2D vb. gerekli işlev veya katmanlar dahil olmak üzere ihtiyaç duyulan tüm modülleri içe aktaracaksınız; çünkü modeli eğitmek için bu çerçevelerin hepsini kullanacaksınız!
Nifti formatındaki görüntüleri okumak için ayrıca nibabel adlı bir modülü de içe aktarmanız gerekir.
import os
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
import numpy as np
import scipy.misc
import numpy.random as rng
from sklearn.utils import shuffle
import nibabel as nib
from sklearn.cross_validation import train_test_split
import math
Beyin MRI 3T ve 7T veri kümesi, her biri beynin farklı kesitlerinden alınmış toplam 207 dilim/görüntü içeren 3B hacimlerden oluşur. Her dilim 173 x 173 boyutundadır. Görüntüler tek kanallı gri tonlamalıdır. Toplamda 39 denek vardır ve her denek bir hastanın MRI taramasını içerir. Görüntü formatı jpeg, png vb. değil; Nifti formatıdır. Nifti formatındaki görüntülerin nasıl okunacağını ilerleyen bir bölümde göreceksiniz.
Veri kümesi T1 modalitesinde MR görüntülerinden oluşur; T1 sekansları geleneksel olarak anatomik yapıları değerlendirmek için uygundur. Bugün üzerinde çalışacağınız veri kümesi 3T ve 7T Beyin MRI’larını içerir.
Veri kümesi herkese açıktır ve bu kaynaktan indirilebilir.
Önce verinin boyutlarını tanımlayalım. Veri okuma kısmında görüntü boyutunu 173x173’ten 176x176’ya, x ve y boyutlarına sıfır dolgusu ekleyerek yeniden boyutlandıracaksınız. Burada ayrıca veri dizinini, modeli eğitirken kullanacağımız yığın (batch) boyutunu, kanal sayısını, bir Input() katmanını, eğitim ve test matrislerini liste olarak ve son olarak yeniden ölçeklendirme için MRI veri kümesinin minimum ve maksimum değerlerini içeren metin dosyasını yüklüyoruz.
x,y = 173,173
full_z = 207
resizeTo=176
inChannel = outChannel = 1
input_shape=(x,y,inChannel)
input_img = Input(shape = (resizeTo, resizeTo, inChannel))
train_matrix = []
test_matrix = []
ff = os.listdir("../test_crossval1")
save = "../Result_nii_crossval1"
folder_ground = os.listdir("../test_g_crossval1")
ToPredict_images=[]
predict_matrix=[]
ground_images=[]
ground_matrix=[]
min_max=np.loadtxt('../maxANDmin.txt')
Şimdi, nibabel kütüphanesini kullanarak MRI verisini yüklüyor ve görüntüleri x ve y boyutlarına sıfır dolgusu ekleyerek 173 x 173’ten 176 x 176’ya yeniden boyutlandırıyoruz.
Nifti formatında bir hacim yüklediğinizde, Nibabel görüntü dizisini hemen yüklemez. Dizi verisini talep edene kadar bekler. Dizi verisini istemenin standart yolu get_data() metodunu çağırmaktır.
3B yerine 2B dilimlere ihtiyaç duyduğunuz için, daha önce ilklendirdiğiniz train and test listelerini kullanacaksınız; her hacmi okuduğunuzda 3B hacmin tüm 207 dilimi üzerinde yineleme yapacak ve her dilimi tek tek bir listeye ekleyeceksiniz.
for f in ff:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load("../test_crossval1" + f)
    affine = a.affine
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        predict_matrix.append(a[:,j,:])
for f in ff:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load("../test_g_crossval1" + f)
    affine = a.affine
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        ground_matrix.append(a[:,j,:])
3T ve 7T test matrisleri birer liste olduğundan, listeyi bir numpy dizisine dönüştürmek için numpy modülünü kullanacaksınız.
Ayrıca, numpy dizisinin type’ını float32 olarak değiştirecek ve hem girdiyi hem de gerçek değeri yeniden ölçeklendireceksiniz.
ToPredict_images = np.asarray(predict_matrix)
ToPredict_images = ToPredict_images.astype('float32')
mx = min_max[0]
mn = min_max[1]
ToPredict_images[:,:,:,0] = (ToPredict_images[:,:,:,0] - mn ) / (mx - mn)
ground_images = np.asarray(ground_matrix)
ground_images = ground_images.astype('float32')
ground_images[:,:,:,0] = (ground_images[:,:,:,0] - mn ) / (mx - mn)
Sonrasında, eğitim ve test matrisinin şekline sahip iki yeni değişken ToPredict_images(3T Test/girdi) ve ground_images (7T Test/gerçek değer) oluşturacaksınız. Bu, birinci boyutu toplam görüntü sayısı, ikinci ve üçüncü boyutları her bir görüntünün boyutu ve son boyutu kanal sayısı (bu durumda bir) olan 4B bir matris olacaktır."
ToPredict_images=np.zeros(shape=[(ToPredict_images.shape[0]),(ToPredict_images.shape[1]),(ToPredict_images.shape[2]),(1)])
ground_images=np.zeros(shape=[(ground_images.shape[0]),(ground_images.shape[1]),(ground_images.shape[2]),(1)])
Ardından tüm görüntüler üzerinde tek tek yineleme yapacak, her seferinde eğitim ve test matrisini 176 x 176 olarak yeniden şekillendirip sırasıyla ToPredict_images(3T Test/girdi) ve ground_images (7T Test/gerçek değer) dizilerine ekleyeceksiniz.
for i in range(ToPredict_images.shape[0]):
    ToPredict_images[i,:,:,0] = ToPredict_images[i,:,:].reshape(resizeTo,resizeTo)
for i in range(ground_images.shape[0]):
    ground_images[i,:,:,0] = ground_images[i,:,:].reshape(resizeTo,resizeTo)
def encoder(input_img):
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    pool3 = MaxPooling2D(pool_size=(2, 2))(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(pool3)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv4)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='sigmoid', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    return conv5,conv4,conv3,conv2,conv1
def decoder(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded
Sonraki adımda, hem gerçek değer y_t hem de y_p için sıfıra eşit olan değerleri (pikselleri) hariç tutacağınız bir ortalama kare hata kullanacaksınız.
def root_mean_sq_GxGy(y_t, y_p):
    a1=1
    zero = tf.constant(0, dtype=tf.float32)
    where = tf.not_equal(y_t, zero)
    a_t=tf.boolean_mask(y_t,where,name='boolean_mask')
    a_p=tf.boolean_mask(y_p,where,name='boolean_mask')
    return a1*(K.sqrt(K.mean((K.square(a_t-a_p)))))
Öncelikle, girdiyi ileterek encoder fonksiyonunu çağıralım. Mimarinizde birleştirme bağlantısı kullandığınız için, encoder fonksiyonu beş convolution katmanının çıktısını döndürecek ve bunları üç kod çözücünün çıktısıyla ayrı ayrı merge edeceksiniz.
conv5,conv4,conv3,conv2,conv1 = encoder(input_img)
Şimdi üç farklı model oluşturalım ve bunlara üç eğitilmiş model ağırlığını yükleyelim.
autoencoder_1 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_1.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE1.h5")
autoencoder_2 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_2.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE2.h5")
autoencoder_3 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_3.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE3.h5")
Hızlıca, her birinin boyutu 11 x 3 x 1 olan iki numpy dizisi ilklendirelim; birinci boyut, modelinizi test etmek için kullanacağınız hacim sayısını temsil edecek. İkinci boyut, şu çiftler arasındaki MSE ve PSNR değerlerini temsil edecek: Tahmin Edilen Çıktı 7T MR görüntüleri ile Gerçek Değer 7T MR görüntüleri, Tahmin Edilen Çıktı ile Girdi 3T MR görüntüleri, Girdi 3T MR görüntüleri ile Gerçek Değer 7T MR görüntüleri; üçüncü boyut ise modelinize gireceğiniz kanal sayısını temsil edecek!
mse= np.zeros([11,3,1])
psnr= np.zeros([11,3,1])
i=0 #for iterating over the slices of all the 11 volumes
Bir sonraki kısımda, 11 hacmin tamamı üzerinde tek tek yineleme yapacaksınız. Her yinelemede, her hacmi üç otomatik kodlayıcının tamamını kullanarak tahmin edecek ve sonunda tahminleri ortalamasını alacaksınız.
Her hacimde, o hacmin kanal sayısı üzerinde yineleme yapacak ve yukarıda tartışıldığı gibi üç farklı durum için PSNR ve MSE hesaplayacaksınız.
Ardından, nibabel kütüphanesini kullanarak tahmin edilen çıktıyı, girdiyi (3T) ve gerçek değeri (7T) her biri 207 dilimden oluşan .nii formatında dosyalar olarak kaydedeceksiniz.
Son olarak, numpy kütüphanesini kullanarak PSNR matrisini bir metin dosyasına kaydedeceksiniz.
Makalede belirtildiği gibi, tahmin edilen çıktıların ortalamasını almak gürültü etkilerini azaltırken yeniden oluşturulan görüntülerde yerel özellikleri korur; bu sayede PSNR, tekil kod çözücü çıktılarının üzerine çıkar.
for j in range(11):
    decoded_imgs_1 = autoencoder_1.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs_2 = autoencoder_2.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs_3 = autoencoder_3.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs = np.mean( np.array([ decoded_imgs_1, decoded_imgs_2,decoded_imgs_3 ]), axis=0 )
    for channel in range(1):
        mse[j,0,channel]=  np.mean((ground_images[i:i+207,:,:,channel] - decoded_imgs[:,:,:,channel]) ** 2)
        psnr[j,0,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,0,channel]))
        mse[j,1,channel]=  np.mean((ground_images[i:i+207,:,:,channel] - ToPredict_images[i:i+207,:,:,channel])** 2)
        psnr[j,1,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,1,channel]))
        mse[j,2,channel] =  np.mean((ToPredict_images[i:i+207,:,:,channel] - decoded_imgs[:,:,:,channel]) ** 2)
        checklt = math.sqrt(mse[j,2,channel])
        psnr[j,2,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,2,channel]))
    obj = nib.Nifti1Image(decoded_imgs, affine)
    string =str(j)+'_crossval1.nii'
    nib.save(obj, save + string)
    obj = nib.Nifti1Image(ground_images[i:i+207,:,:,:], affine)
    string =str(j)+'_ground_images_crossval1.nii'
    nib.save(obj, save + string)
    obj = nib.Nifti1Image(ToPredict_images[i:i+207,:,:,:], affine)
    string =str(j)+'_ToPredict_images_crossval1.nii'
    nib.save(obj, save + string)
    i=i+207


np.savetxt('psnr_all_slices.txt',psnr[:,:,0])
Python hakkında daha fazla bilgi edinmek isterseniz, DataCamp’in Matplotlib ile Veri Görselleştirmeye Giriş kursunu alın.
Keras Eğitimi: Python ile Derin Öğrenme yazısına da göz atın.
Python ve Derin Öğrenme hakkında daha fazlasını öğrenin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




