
Last chance! 50% off DataCamp Premium
Sale ends in
In het Training Script-gedeelte werk je aan beeld-superresolutie met een nieuw deep learning-architectuur. De taak is een niet-lineaire mapping maken van een laagveld 3-Tesla hersen-MRI naar een hoogveld 7-Tesla hersen-MRI. In dit Testing Script-gedeelte gebruik je de gewichten die in Deel 1 zijn getraind en voorspel je op de niet-gezien getrainde data. Je leert ook hoe je de 2D-beelden uiteindelijk als één gecombineerd volume opslaat.
De tutorial is verdeeld in twee delen: in het eerste deel loop je door het trainingsproces en in het tweede deel behandel je het testproces.
Opmerking: Je bent waarschijnlijk geïnteresseerd in het lezen van de paper; je vindt het artikel hier.
Samengevat behandel je in Deel 1 van de tutorial het volgende:
Voordat je deze tutorial volgt, zorg dat je exact dezelfde moduleversies hebt als hieronder vermeld:
Opmerking: Let op: het model wordt getraind op een systeem met een Nvidia 1080 Ti GPU, Xeon e5 GeForce-processor en 32GB RAM. Als je Jupyter Notebook gebruikt, moet je drie extra regels code toevoegen waarin je de CUDA-devicevolgorde en zichtbare CUDA-apparaten opgeeft met de module os.
In de onderstaande code stel je omgevingsvariabelen in de notebook in met os.environ. Het is handig dit vóór het initialiseren van Keras te doen om de Keras-backend TensorFlow te beperken tot de eerste GPU. Als de machine waarop je traint een GPU op 0 heeft, gebruik dan 0 in plaats van 1. Je kunt dit controleren met een eenvoudige terminalopdracht: bijvoorbeeld nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU
Eerst importeer je alle vereiste modules zoals tensorflow, numpy en vooral keras en de vereiste functies of lagen zoals Input, Conv2D,MaxPooling2D enz., omdat je al deze frameworks gaat gebruiken om het model te trainen!
Om beelden in NIfTI-formaat te lezen, moet je ook een module importeren met de naam nibabel.
import os
import numpy as np
import math
import tensorflow as tf
import nibabel as nib
import numpy as np
from keras.layers import Input,Dense,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import RMSprop
from keras import backend as K
import scipy.misc
from sklearn.utils import shuffle
from sklearn.cross_validation import train_test_split
import matplotlib.pyplot as plt
from keras.models import model_from_json
Using TensorFlow backend.
/usr/local/lib/python3.5/dist-packages/sklearn/cross_validation.py:41: DeprecationWarning: This module was deprecated in version 0.18 in favor of the model_selection module into which all the refactored classes and functions are moved. Also, note that the interface of the new CV iterators is different from that of this module. This module will be removed in 0.20.
  "This module will be removed in 0.20.", DeprecationWarning)
De 3T- en 7T-hersen-MRI-dataset bestaat uit 3D-volumes; elk volume bevat in totaal 207 slices/afbeeldingen van hersen-MRI’s, genomen op verschillende hoogten in de hersenen. Elke slice heeft een afmeting van 173 x 173. De beelden zijn enkelkanaals grijswaarden. Er zijn in totaal 39 proefpersonen, elk met de MRI-scan van een patiënt. Het bestandsformaat is geen jpeg, png, etc., maar NIfTI. In een later onderdeel zie je hoe je NIfTI-beelden leest.
De dataset bestaat uit T1-modus MR-beelden; T1-sequenties worden traditioneel als geschikt beschouwd voor de evaluatie van anatomische structuren. De dataset waarmee je vandaag werkt bestaat uit 3T- en 7T-hersen-MRI’s.
De dataset is openbaar en kan worden gedownload via deze bron.
28 proefpersonen worden gebruikt voor training, terwijl de resterende 11 voor testen worden gebruikt.
Definieer eerst de dimensies van de data. Je resize’t de afbeeldingsdimensie van 173x173 naar 176x176 in het uitleesgedeelte. Hier definieer je ook de datamap, de batchgrootte voor training, het aantal kanalen, een Input()-laag, train- en testmatrices als lijst en laad je ten slotte voor rescaling het tekstbestand met de minimum- en maximumwaarden van de MRI-dataset.
Opmerking: Voor rescaling kun je ook het maximum en minimum van de dataset nemen, aangezien je het bestand maxANDmin.txt mogelijk niet hebt.
x,y = 173,173
full_z = 207
resizeTo=176
batch_size = 32
inChannel = outChannel = 1
input_shape=(x,y,inChannel)
input_img = Input(shape = (resizeTo, resizeTo, inChannel))
inp = "ground3T"
out = "ground7T"
train_matrix = []
test_matrix = []
min_max = np.loadtxt('maxANDmin.txt')Vervolgens laad je de MRI-data met de nibabel-bibliotheek en resize je de beelden van 173 x 173 naar 176 x 176 door nullen te padden in de x- en y-dimensie.
Let op: wanneer je een NIfTI-volume laadt, laadt Nibabel de afbeeldingsarray niet direct. Er wordt gewacht tot je expliciet om de arraydata vraagt. De standaardmanier is de methode get_data() aanroepen.
Omdat je 2D-slices wilt in plaats van 3D, gebruik je de lijsten train en test die je eerder hebt geïnitialiseerd; telkens wanneer je een volume leest, itereer je over alle 207 slices van het 3D-volume en voeg je elke slice één voor één toe aan een lijst.
folder = os.listdir(inp)
Laten we eerst de 3T-data laden.
for f in folder:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load(inp + f)
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        train_matrix.append(a[:,j,:])
Laad daarna de 7T-data; je gebruikt dezelfde variabele folder voor het laden van 7T, aangezien het aantal 3T- en 7T-MR-volumes gelijk is.
for f in folder:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    b = nib.load(out + f)
    b = b.get_data()
    temp[3:,:,3:] = b
    b = temp
    for j in range(full_z):
        test_matrix.append(b[:,j,:])
Aangezien train- en testmatrices lijsten zijn, gebruik je numpy om de lijst naar een numpy-array om te zetten.
Verder zet je het type van de numpy-array om naar float32 en reschaal je zowel de input als de ground truth.
train_matrix = np.asarray(train_matrix)
train_matrix = train_matrix.astype('float32')
m = min_max[0]
mi = min_max[1]
train_matrix = (train_matrix - mi) / (m - mi)

test_matrix = np.asarray(test_matrix)
test_matrix = test_matrix.astype('float32')
test_matrix = (test_matrix - mi) / (m - mi)
Print snel even de shape van de train_matrix (3T) en test_matrix (7T). Ze zouden in totaal 28 x 207 = 5796 afbeeldingen moeten hebben, elk met een dimensie van 176 x 176.
train_matrix.shape
(5796, 176, 176)
test_matrix.shape
(5796, 176, 176)
Vervolgens maak je twee nieuwe variabelen augmented_images (3T/input) en Haugmented_images (7T/ground truth) met de shape van de train- en testmatrix. Dit wordt een 4D-matrix waarin de eerste dimensie het aantal afbeeldingen is, de tweede en derde de afmetingen van elke afbeelding, en de laatste het aantal kanalen, dat hier één is."
augmented_images=np.zeros(shape=[(train_matrix.shape[0]),(train_matrix.shape[1]),(train_matrix.shape[2]),(1)])
Haugmented_images=np.zeros(shape=[(train_matrix.shape[0]),(train_matrix.shape[1]),(train_matrix.shape[2]),(1)])
Daarna itereren je over alle afbeeldingen één voor één; elke keer reshape je de train- en testmatrix naar 176 x 176 en voeg je die toe aan respectievelijk augmented_images (3T/input) en Haugmented_images (7T/ground truth).
for i in range(train_matrix.shape[0]):
    augmented_images[i,:,:,0] = train_matrix[i,:,:].reshape(resizeTo,resizeTo)
    Haugmented_images[i,:,:,0] = test_matrix[i,:,:].reshape(resizeTo,resizeTo)
Na dit alles is het belangrijk de data te verdelen. Om je model goed te laten generaliseren, splits je de data in een trainings- en een validatieset. Je traint je model op 80% van de data en valideert op de resterende 20%.
Dit helpt ook om overfitting te verminderen, omdat je valideert op data die het model niet tijdens training heeft gezien.
Je kunt de train_test_split-module van scikit-learn gebruiken die je in het begin hebt gedefinieerd om de data goed te verdelen:
data,Label = shuffle(augmented_images,Haugmented_images, random_state=2)
X_train, X_test, y_train, y_test = train_test_split(data, Label, test_size=0.2, random_state=2)
X_test = np.array(X_test)
y_test = np.array(y_test)
X_test = X_test.astype('float32')
y_test = y_test.astype('float32')
X_train = np.array(X_train)
y_train = np.array(y_train)
X_train = X_train.astype('float32')
y_train = y_train.astype('float32')
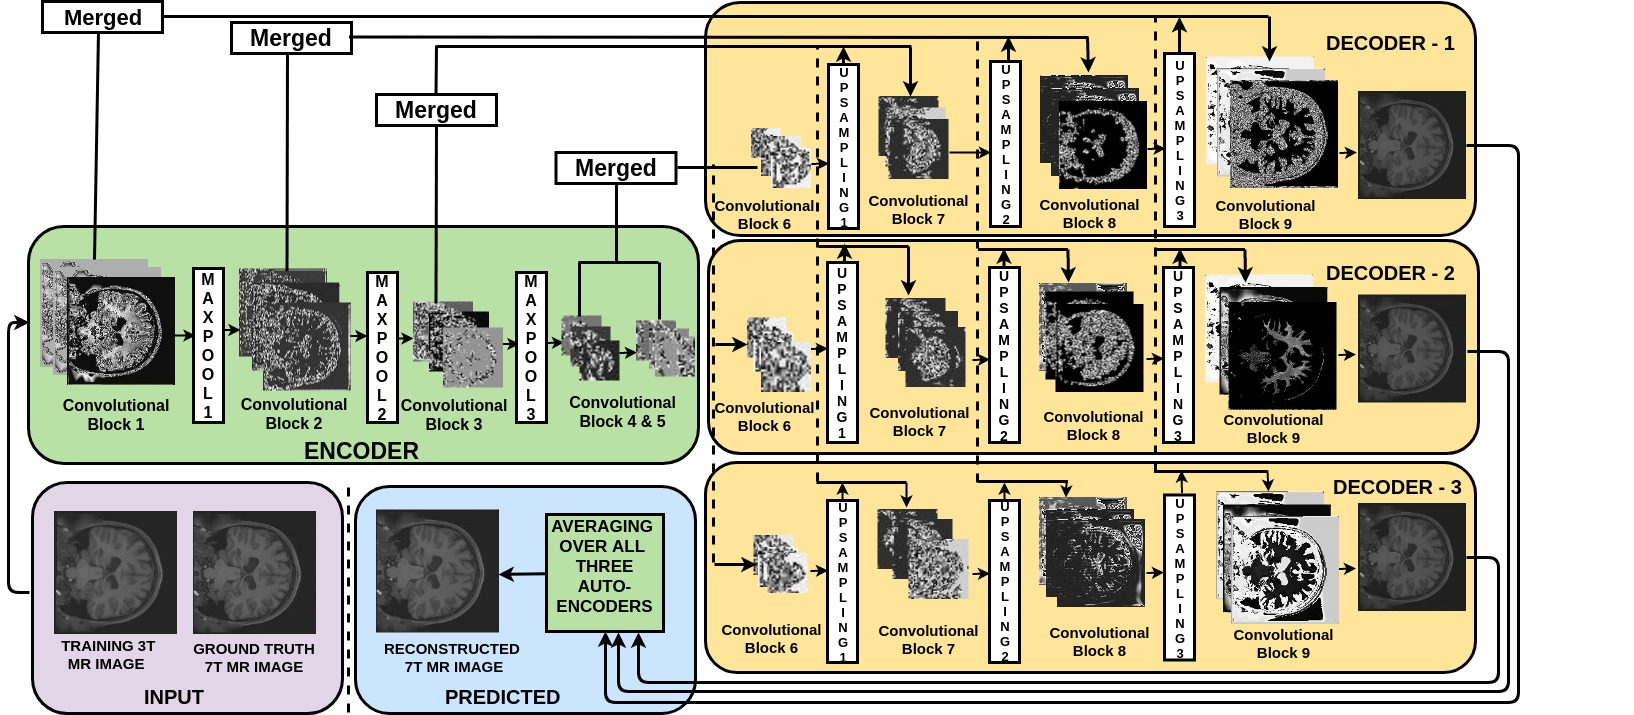
Vervolgens definieer je de voorgestelde architectuur met blokken van opeenvolgende filterlagen, gevolgd door een maxpooling-laag in de encodersectie, zoals in de volgende cel. Om de oorspronkelijke afbeeldingsgrootte bij de output te reconstrueren, wordt in elk decoderblok een upsampling-laag geïntroduceerd. Bij upsampling kunnen artefacten ontstaan door ontbrekende details in de gedownsamplede input van de decoder. Daarom concateneer je de input van de decoder met de opgeschaalde versie uit de encoder om de aard van opgeschaalde details te bieden voor een betere reconstructie tijdens het upsamplen in de decoder. Het toevoegen van merge-verbindingen levert inderdaad een significante PSNR-verbetering op (orde van 5 dB). Deze instelling is geïnspireerd op deze paper.
De voorgestelde aanpak gebruikt één encoder en meerdere decoders met een enkelkanaals input. In elk blok van de encoder en in alle drie de decoders worden drie convolutionele lagen gebruikt, gevolgd door batchnormalisatie om numerieke stabiliteit te behouden.
Het eerste convolutionele blok in de encoder heeft 32 filters, en het aantal filters verdubbelt na elk blok. In alle decoders heeft het eerste convolutionele blok 256 filters, en het aantal filters wordt na elk blok gehalveerd. Je gebruikt een filtergrootte van 3x3 in alle convolutionele blokken.
Rectified Linear Unit (ReLU) wordt als activatiefunctie gebruikt in alle lagen behalve de laatste. Omdat data is genormaliseerd tussen 0 en 1, wordt in de laatste laag een Sigmoid-activatie gebruikt.
Het is bekend dat lokale afbeeldingsdetails op verschillende schalen een grote rol spelen bij reconstructie. De voorgestelde architectuur bekijkt beelden op verschillende schalen met hiërarchische lagen voor downsampling (maxpooling) en upsampling (ieder met factor 2) in respectievelijk encoder en decoders. De gecodeerde representatie na drie downsamplings brengt de data van een hoge-dimensie-input naar een latente representatie.
def encoder(input_img):
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    pool3 = MaxPooling2D(pool_size=(2, 2))(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(pool3)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv4)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='sigmoid', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    return conv5,conv4,conv3,conv2,conv1
def decoder_1(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_1 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_1
def decoder_2(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_2 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_2
def decoder_3(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_3 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_3
In de bovenstaande 4 cellen definieerde je vier functies: één voor de encoder en de overige drie voor de decoders. Omdat het functies zijn, zou je de decoder()-functie kunnen definiëren en drie keer aanroepen, maar voor een beter begrip definieer je hem drie keer en om issues met de willekeur in de drie decoders te vermijden.
Vervolgens gebruik je mean squared error waarbij je de waarden (pixels) van zowel de ground truth y_t als y_p die gelijk zijn aan nul, uitsluit.
def root_mean_sq_GxGy(y_t, y_p):
    a1=1
    where = tf.not_equal(y_t, 0)
    a_t=tf.boolean_mask(y_t,where,name='boolean_mask')
    a_p=tf.boolean_mask(y_p,where,name='boolean_mask')
    return a1*(K.sqrt(K.mean((K.square(a_t-a_p)))))
Eerst roep je de encoder-functie aan met de input. Omdat je merge-verbindingen in je architectuur gebruikt, retourneert de encoder-functie de output van vijf convolution-lagen die je vervolgens afzonderlijk merget met alle drie decoder-uitgangen.
conv5,conv4,conv3,conv2,conv1 = encoder(input_img)
autoencoder_1 = Model(input_img, decoder_1(conv5,conv4,conv3,conv2,conv1))
autoencoder_1.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())

autoencoder_2 = Model(input_img, decoder_2(conv5,conv4,conv3,conv2,conv1))
autoencoder_2.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())

autoencoder_3 = Model(input_img, decoder_3(conv5,conv4,conv3,conv2,conv1))
autoencoder_3.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:2: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.

/usr/local/lib/python3.5/dist-packages/keras/legacy/layers.py:460: UserWarning: The `Merge` layer is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
  name=name)
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:10: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
  # Remove the CWD from sys.path while we load stuff.
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:18: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:26: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.


WARNING:tensorflow:From /usr/local/lib/python3.5/dist-packages/keras/backend/tensorflow_backend.py:1257: calling reduce_mean (from tensorflow.python.ops.math_ops) with keep_dims is deprecated and will be removed in a future version.
Instructions for updating:
keep_dims is deprecated, use keepdims instead
Je slaat de gewichten alleen op wanneer de peak signal-to-noise ratio op de validatiedata verbetert. Daarvoor definieer je een lijst psnr_gray_channel waarin je een standaardwaarde 1 toevoegt; je voegt 1 toe omdat je de lijst moet initialiseren met een willekeurig getal en de PSNR hier al snel hoger dan deze waarde zal zijn, zodat dit als dummy-waarde dient.
Je initialiseert de learning rate op 1e-3 en gebruikt een learning-rate-decaystrategie waarbij je de learning rate elke 20 epochs met 10% verlaagt vanaf de huidige waarde.
psnr_gray_channel = []
psnr_gray_channel.append(1)
learning_rate = 0.001
j=0
Opmerking: De volgende volledige code moet in één cel worden uitgevoerd, maar voor een beter begrip van het trainingsproces wordt hij in kleinere cellen opgesplitst.
Het model wordt 500 epochs getraind. De initiële learning rate is 1e-3 zoals hierboven gedefinieerd. Je slaat ook de PSNR- en MSE-waarden op na elke epoch van 7T met predicted. Je gebruikt de functie K.set_value om de learning rate van alle drie modellen met 10% te wijzigen, maar alleen na elke 20 epochs.
for jj in range(500):
    myfile_valid_psnr_7T = open('../1_encoder_3_decoders_complete_slices_single_channel/validation_psnr7T_1encoder_3decoders.txt', 'a')
    myfile_valid_mse_7T = open('../1_encoder_3_decoders_complete_slices_single_channel/validation_mse7T_1encoder_3decoders.txt', 'a')

    K.set_value(autoencoder_1.optimizer.lr, learning_rate)
    K.set_value(autoencoder_2.optimizer.lr, learning_rate)
    K.set_value(autoencoder_3.optimizer.lr, learning_rate)
Vervolgens shuffle je de input 3T- en ground truth 7T-beelden om overfitting te voorkomen, omdat niet shufflen het model dwingt de samples elke epoch in dezelfde volgorde te zien. Daarna bereken je het aantal batches op basis van de eerder gedefinieerde batch_size. Ten slotte begin je te itereren over num_batches.
train_X,train_Y = shuffle(X_train,y_train)
print ("Epoch is: %d\n" % j)
print ("Number of batches: %d\n" % int(len(train_X)/batch_size))
num_batches = int(len(train_X)/batch_size)
for batch in range(num_batches):
Naast PSNR-waarden sla je ook de losses van alle drie autoencoders en de drie decoders respectievelijk op.
myfile_ae1_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae1_train_loss_1encoder_3decoders.txt', 'a')
myfile_ae2_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae2_train_loss_1encoder_3decoders.txt', 'a')
myfile_ae3_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae3_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec1_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec1_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec2_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec2_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec3_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec3_train_loss_1encoder_3decoders.txt', 'a')
Omdat je in elke batch wilt dat het model de volgende 32 (batch_size) samples ziet, regelt de volgende cel dat.
batch_train_X = train_X[batch*batch_size:min((batch+1)*batch_size,len(train_X)),:]
batch_train_Y = train_Y[batch*batch_size:min((batch+1)*batch_size,len(train_Y)),:]
Voor onze Minimum-autoencoderstrategie test je na elke epoch op de trainingsdata met de Keras-functie test_on_batch die je drie losses geeft, en die print je ten slotte.
loss_1 = autoencoder_1.test_on_batch(batch_train_X,batch_train_Y)
loss_2 = autoencoder_2.test_on_batch(batch_train_X,batch_train_Y)
loss_3 = autoencoder_3.test_on_batch(batch_train_X,batch_train_Y)
print ('epoch_num: %d batch_num: %d Test_loss_1: %f\n' % (j,batch,loss_1))
print ('epoch_num: %d batch_num: %d Test_loss_2: %f\n' % (j,batch,loss_2))
print ('epoch_num: %d batch_num: %d Test_loss_3: %f\n' % (j,batch,loss_3))
Er kunnen zes mogelijke situaties zijn in je netwerk:
loss_1: Autoencoder 1 loss
loss_2: Autoencoder 2 loss
loss_3: Autoencoder 3 loss
if loss_1 < loss_2 and loss_1 < loss_3:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1: %f\n' % (j,batch,train_1))
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_loss_3: %f\n' % (j,batch,train_3))
elif loss_2 < loss_1 and loss_2 < loss_3:
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_2: %f\n' % (j,batch,train_2))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_1.summary()
    #autoencoder_3.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" % (train_1))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3: %f\n' % (j,batch,train_3))
elif loss_3 < loss_1 and loss_3 < loss_2:
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_3: %f\n' % (j,batch,train_3))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    #autoencoder_1.summary()
    #autoencoder_2.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" %(train_1))
    myfile_dec2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
elif loss_1 == loss_2:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
elif loss_2 == loss_3:
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False

    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" % (train_1))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
elif loss_3 == loss_1:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))


    myfile_ae1_loss.close()
    myfile_ae2_loss.close()
    myfile_ae3_loss.close()
    myfile_dec1_loss.close()
    myfile_dec2_loss.close()
    myfile_dec3_loss.close()
Dit is een essentiële stap: omdat je in de bovenstaande condities enkele lagen op False hebt gezet, moet je deze lagen weer True maken, zodat alle autoencoderlagen kunnen worden gebruikt voor de functie test_on_batch en je ze niet de hele training op False laat staan.
for layer in autoencoder_1.layers[:34]:
            layer.trainable = True
for layer in autoencoder_2.layers[:34]:
            layer.trainable = True
for layer in autoencoder_3.layers[:34]:
            layer.trainable = True
Je slaat gewichten op op drie manieren; hieronder staan er twee. Eén keer sla je na elke 100 epochs op, en ten tweede sla je na elke epoch op. In feite worden ze na elke epoch overschreven.
if jj % 100 ==0:
            autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1_" + str(jj)+".h5")
            autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2_" + str(jj)+".h5")
            autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3_" + str(jj)+".h5")


autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1.h5")
autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2.h5")
autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3.h5")
Eerst shuffle je de validatiedata en gebruik je dezelfde 6 mogelijke condities als hierboven gedefinieerd. Welke conditie ook True is, je test je model met die specifieke autoencoder.
Daarna bereken je twee metrics MSE en PSNR tussen decoded_imgs (voorspeld) en ground truth. Tot slot sla je ze op in tekstbestanden.
X_test,y_test = shuffle(X_test,y_test)
if loss_1 < loss_2 and loss_1 < loss_3:
    decoded_imgs = autoencoder_1.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)


    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))

    #print (check)
elif loss_2 < loss_1 and loss_2 < loss_3:
    decoded_imgs = autoencoder_2.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))

    #print (check)
elif loss_3 < loss_2 and loss_3 < loss_1:
    decoded_imgs = autoencoder_3.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))
    #print (check)

elif loss_1 == loss_2:
    decoded_imgs = autoencoder_1.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))


elif loss_2 == loss_3:
    decoded_imgs = autoencoder_2.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))


elif loss_3 == loss_1:
    decoded_imgs = autoencoder_3.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))
Hier sla je de gewichten alleen op wanneer de PSNR tussen de voorspelde 7T en de ground truth (7T) maximaal is vergeleken met de eerdere PSNR-waarden in de lijst psnr_gray_channel.
if max(psnr_gray_channel) < psnr_7T:
            autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1_" + str(jj)+".h5")
            autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2_" + str(jj)+".h5")
            autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3_" + str(jj)+".h5")

    psnr_gray_channel.append(psnr_7T)
Je definieert een numpy-matrix temp van 176 x 528, omdat er 3 afbeeldingen in één rij worden opgeslagen, elk 176 x 176. Je slaat een willekeurige afbeelding op uit de validatie-3T, 7T en predicted en vermenigvuldigt de matrix met 255 omdat de afbeeldingen geschaald waren tussen 0 en 1.
Tot slot sla je de afbeelding op met de scipy-functie.
temp = np.zeros([resizeTo,resizeTo*3])
temp[:resizeTo,:resizeTo] = X_test[0,:,:,0]
temp[:resizeTo,resizeTo:resizeTo*2] = y_test[0,:,:,0]
temp[:resizeTo,2*resizeTo:] = decoded_imgs[0,:,:,0]
temp = temp*255
scipy.misc.imsave('../Results/1_encoder_3_decoders_complete_slices_single_channel/' + str(j) + '.jpg', temp)
j +=1
Laten we de bestanden PSNR en MSE aan het eind sluiten.
myfile_valid_psnr_7T.close()
myfile_valid_mse_7T.close()
Tot slot verlaag je na elke 20 epochs de learning rate met 10% van de huidige waarde.
if jj % 20 ==0:
        learning_rate = learning_rate - learning_rate * 0.10
In deel 2 van deze tutorial behandel je het volgende:
nibabel.Voordat je deze tutorial volgt, zorg dat je exact dezelfde moduleversies hebt als hieronder vermeld:
Opmerking: Let op: het model wordt getraind op een systeem met een Nvidia 1080 Ti GPU, Xeon e5 GeForce-processor en 32GB RAM. Als je Jupyter Notebook gebruikt, moet je drie extra regels code toevoegen waarin je de CUDA-devicevolgorde en zichtbare CUDA-apparaten opgeeft met de module os.
In de onderstaande code stel je in feite omgevingsvariabelen in de notebook in met os.environ. Het is handig dit vóór het initialiseren van Keras te doen om de Keras-backend TensorFlow te beperken tot de eerste GPU. Als de machine waarop je traint een GPU op 0 heeft, gebruik dan 0 in plaats van 1. Je kunt dit controleren met een eenvoudige terminalopdracht: bijvoorbeeld nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU
Eerst importeer je alle vereiste modules zoals tensorflow, numpy en vooral keras en de vereiste functies of lagen zoals Input, Conv2D,MaxPooling2D, enz., omdat je al deze frameworks gaat gebruiken om het model te trainen!
Om beelden in NIfTI-formaat te lezen, moet je ook een module importeren met de naam nibabel.
import os
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
import numpy as np
import scipy.misc
import numpy.random as rng
from sklearn.utils import shuffle
import nibabel as nib
from sklearn.cross_validation import train_test_split
import math
De 3T- en 7T-hersen-MRI-dataset bestaat uit 3D-volumes; elk volume bevat in totaal 207 slices/afbeeldingen van hersen-MRI’s, genomen op verschillende hoogten in de hersenen. Elke slice heeft een afmeting van 173 x 173. De beelden zijn enkelkanaals grijswaarden. Er zijn in totaal 39 proefpersonen, elk met de MRI-scan van een patiënt. Het bestandsformaat is geen jpeg, png, etc., maar NIfTI. In een later onderdeel zie je hoe je NIfTI-beelden leest.
De dataset bestaat uit T1-modus MR-beelden; T1-sequenties worden traditioneel als geschikt beschouwd voor de evaluatie van anatomische structuren. De dataset waarmee je vandaag werkt bestaat uit 3T- en 7T-hersen-MRI’s.
De dataset is openbaar en kan worden gedownload via deze bron.
Definieer eerst de dimensies van de data. Je resize’t de afbeeldingsdimensie van 173x173 naar 176x176 in het uitleesgedeelte. Hier definiëren we ook de datamap, batchgrootte voor het trainen van het model, aantal kanalen, een Input()-laag, train- en testmatrices als lijst en ten slotte laden we voor rescaling het tekstbestand met de minimum- en maximumwaarden van de MRI-dataset.
x,y = 173,173
full_z = 207
resizeTo=176
inChannel = outChannel = 1
input_shape=(x,y,inChannel)
input_img = Input(shape = (resizeTo, resizeTo, inChannel))
train_matrix = []
test_matrix = []
ff = os.listdir("../test_crossval1")
save = "../Result_nii_crossval1"
folder_ground = os.listdir("../test_g_crossval1")
ToPredict_images=[]
predict_matrix=[]
ground_images=[]
ground_matrix=[]
min_max=np.loadtxt('../maxANDmin.txt')
Vervolgens laden we de MRI-data met de nibabel-bibliotheek en resize’en we de beelden van 173 x 173 naar 176 x 176 door nullen te padden in de x- en y-dimensie.
Let op: wanneer je een NIfTI-volume laadt, laadt Nibabel de afbeeldingsarray niet direct. Er wordt gewacht tot je expliciet om de arraydata vraagt. De standaardmanier is de methode get_data() aanroepen.
Omdat je 2D-slices wilt in plaats van 3D, gebruik je de lijsten train en test die je eerder hebt geïnitialiseerd; telkens wanneer je een volume leest, itereer je over alle 207 slices van het 3D-volume en voeg je elke slice één voor één toe aan een lijst.
for f in ff:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load("../test_crossval1" + f)
    affine = a.affine
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        predict_matrix.append(a[:,j,:])
for f in ff:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load("../test_g_crossval1" + f)
    affine = a.affine
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        ground_matrix.append(a[:,j,:])
Aangezien de 3T- en 7T-testmatrices lijsten zijn, gebruik je numpy om de lijst naar een numpy-array om te zetten.
Verder zet je het type van de numpy-array om naar float32 en reschaal je zowel de input als de ground truth.
ToPredict_images = np.asarray(predict_matrix)
ToPredict_images = ToPredict_images.astype('float32')
mx = min_max[0]
mn = min_max[1]
ToPredict_images[:,:,:,0] = (ToPredict_images[:,:,:,0] - mn ) / (mx - mn)
ground_images = np.asarray(ground_matrix)
ground_images = ground_images.astype('float32')
ground_images[:,:,:,0] = (ground_images[:,:,:,0] - mn ) / (mx - mn)
Vervolgens maak je twee nieuwe variabelen ToPredict_images (3T Test/input) en ground_images (7T Test/ground truth) met de shape van de train- en testmatrix. Dit wordt een 4D-matrix waarin de eerste dimensie het aantal afbeeldingen is, de tweede en derde de afmetingen van elke afbeelding, en de laatste het aantal kanalen, dat hier één is."
ToPredict_images=np.zeros(shape=[(ToPredict_images.shape[0]),(ToPredict_images.shape[1]),(ToPredict_images.shape[2]),(1)])
ground_images=np.zeros(shape=[(ground_images.shape[0]),(ground_images.shape[1]),(ground_images.shape[2]),(1)])
Daarna itereren je over alle afbeeldingen één voor één; elke keer reshape je de train- en testmatrix naar 176 x 176 en voeg je die toe aan respectievelijk ToPredict_images (3T Test/input) en ground_images (7T Test/ground truth).
for i in range(ToPredict_images.shape[0]):
    ToPredict_images[i,:,:,0] = ToPredict_images[i,:,:].reshape(resizeTo,resizeTo)
for i in range(ground_images.shape[0]):
    ground_images[i,:,:,0] = ground_images[i,:,:].reshape(resizeTo,resizeTo)
def encoder(input_img):
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    pool3 = MaxPooling2D(pool_size=(2, 2))(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(pool3)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv4)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='sigmoid', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    return conv5,conv4,conv3,conv2,conv1
def decoder(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded
Vervolgens gebruik je mean squared error waarbij je de waarden (pixels) van zowel de ground truth y_t als y_p die gelijk zijn aan nul, uitsluit.
def root_mean_sq_GxGy(y_t, y_p):
    a1=1
    zero = tf.constant(0, dtype=tf.float32)
    where = tf.not_equal(y_t, zero)
    a_t=tf.boolean_mask(y_t,where,name='boolean_mask')
    a_p=tf.boolean_mask(y_p,where,name='boolean_mask')
    return a1*(K.sqrt(K.mean((K.square(a_t-a_p)))))
Roep eerst de encoder-functie aan met de input. Omdat je merge-verbindingen gebruikt in je architectuur, retourneert de encoder-functie de output van vijf convolution-lagen die je vervolgens afzonderlijk merget met alle drie decoder-uitgangen.
conv5,conv4,conv3,conv2,conv1 = encoder(input_img)
Laten we nu drie verschillende modellen maken en de drie getrainde modelgewichten erin laden.
autoencoder_1 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_1.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE1.h5")
autoencoder_2 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_2.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE2.h5")
autoencoder_3 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_3.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE3.h5")
Laten we snel twee numpy-arrays initialiseren van elk 11 x 3 x 1, waarbij de eerste dimensie het aantal volumes voor testen is. De tweede dimensie staat voor de MSE en PSNR tussen: voorspelde 7T-MR-beelden en ground truth 7T-MR-beelden, voorspelde output en input 3T-MR-beelden, input 3T-MR-beelden en ground truth 7T-MR-beelden; de derde dimensie staat voor het aantal kanalen dat je aan je model voert!
mse= np.zeros([11,3,1])
psnr= np.zeros([11,3,1])
i=0 #for iterating over the slices of all the 11 volumes
In het volgende deel van de cel itereer je over alle 11 volumes één voor één. In elke iteratie voorspel je elk volume met alle drie autoencoders en neem je uiteindelijk het gemiddelde van de voorspellingen.
In elk volume itereer je over het aantal kanalen van dat volume en bereken je PSNR en MSE voor drie verschillende gevallen zoals hierboven besproken.
Vervolgens sla je met de nibabel-bibliotheek de voorspelde output, input (3T) en ground truth (7T) op als .nii-bestanden: elk van de 11 volumes met 207 slices.
Ten slotte sla je de PSNR-matrix op in een tekstbestand met de numpy-bibliotheek.
Zoals vermeld in de paper helpt het middelen van de voorspelde outputs om ruiseffecten te verminderen maar lokale features in de gereconstrueerde beelden te behouden, waardoor de PSNR verbetert ten opzichte van individuele decoderoutputs.
for j in range(11):
    decoded_imgs_1 = autoencoder_1.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs_2 = autoencoder_2.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs_3 = autoencoder_3.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs = np.mean( np.array([ decoded_imgs_1, decoded_imgs_2,decoded_imgs_3 ]), axis=0 )
    for channel in range(1):
        mse[j,0,channel]=  np.mean((ground_images[i:i+207,:,:,channel] - decoded_imgs[:,:,:,channel]) ** 2)
        psnr[j,0,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,0,channel]))
        mse[j,1,channel]=  np.mean((ground_images[i:i+207,:,:,channel] - ToPredict_images[i:i+207,:,:,channel])** 2)
        psnr[j,1,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,1,channel]))
        mse[j,2,channel] =  np.mean((ToPredict_images[i:i+207,:,:,channel] - decoded_imgs[:,:,:,channel]) ** 2)
        checklt = math.sqrt(mse[j,2,channel])
        psnr[j,2,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,2,channel]))
    obj = nib.Nifti1Image(decoded_imgs, affine)
    string =str(j)+'_crossval1.nii'
    nib.save(obj, save + string)
    obj = nib.Nifti1Image(ground_images[i:i+207,:,:,:], affine)
    string =str(j)+'_ground_images_crossval1.nii'
    nib.save(obj, save + string)
    obj = nib.Nifti1Image(ToPredict_images[i:i+207,:,:,:], affine)
    string =str(j)+'_ToPredict_images_crossval1.nii'
    nib.save(obj, save + string)
    i=i+207


np.savetxt('psnr_all_slices.txt',psnr[:,:,0])
Wil je meer leren over Python? Volg de DataCamp-cursus Introduction to Data Visualization with Matplotlib.
Bekijk ook de Keras Tutorial: Deep Learning in Python.
Meer leren over Python en Deep Learning
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

