Curso
Introducción al Deep Learning con Keras
4 h
46.3K
En la parte del Training Script, trabajarás en un problema de súper resolución de imágenes con una arquitectura de deep learning novedosa. La tarea consiste en realizar un mapeo no lineal de una imagen de RM cerebral de bajo campo 3 teslas a una imagen de alto campo 7 teslas. En esta parte del Testing Script, usarás los pesos entrenados en la Parte 1 y harás predicciones sobre datos no vistos. También aprenderás a guardar las imágenes 2D como un volumen combinado.
El tutorial está dividido en dos partes: la primera te guía por el proceso de entrenamiento y la segunda cubre el proceso de prueba.
Nota: Probablemente te interese leer el paper; puedes encontrar el artículo aquí.
En resumen, en la Parte 1 del tutorial abordarás lo siguiente:
Antes de seguir este tutorial, asegúrate de tener exactamente las mismas versiones de módulos que se indican a continuación:
Nota: Ten en cuenta que el modelo se entrenará en un sistema con GPU Nvidia 1080 Ti, procesador Xeon e5 GeForce y 32 GB de RAM. Si usas Jupyter Notebook, tendrás que añadir tres líneas de código más para especificar el orden del dispositivo CUDA y las GPU visibles usando el módulo os.
En el código siguiente, defines variables de entorno en el notebook con os.environ. Es recomendable hacerlo antes de inicializar Keras para limitar que el backend TensorFlow use la primera GPU. Si la máquina en la que entrenas tiene la GPU en 0, usa 0 en lugar de 1. Puedes comprobarlo ejecutando un comando sencillo en tu terminal, por ejemplo, nvidia-smi.
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU
Primero, importa todos los módulos necesarios como tensorflow, numpy y, sobre todo, keras y las funciones o capas requeridas como Input, Conv2D, MaxPooling2D, etc., ya que usarás todos estos frameworks para entrenar el modelo.
Para leer imágenes en formato NIfTI, también necesitas importar el módulo nibabel.
import os
import numpy as np
import math
import tensorflow as tf
import nibabel as nib
import numpy as np
from keras.layers import Input,Dense,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import RMSprop
from keras import backend as K
import scipy.misc
from sklearn.utils import shuffle
from sklearn.cross_validation import train_test_split
import matplotlib.pyplot as plt
from keras.models import model_from_json
Using TensorFlow backend.
/usr/local/lib/python3.5/dist-packages/sklearn/cross_validation.py:41: DeprecationWarning: This module was deprecated in version 0.18 in favor of the model_selection module into which all the refactored classes and functions are moved. Also, note that the interface of the new CV iterators is different from that of this module. This module will be removed in 0.20.
  "This module will be removed in 0.20.", DeprecationWarning)
El dataset de RM cerebral 3T y 7T consta de volúmenes 3D; cada volumen tiene 207 cortes/imágenes de RM obtenidas en distintos planos del cerebro. Cada corte tiene dimensiones 173 x 173. Las imágenes son monocanal en escala de grises. Hay 39 sujetos en total, cada uno con la RM de un paciente. El formato de imagen no es jpeg, png, etc., sino NIfTI. En una sección posterior verás cómo leer imágenes en formato NIfTI.
El dataset consiste en imágenes de RM de modalidad T1, tradicionalmente adecuadas para evaluar estructuras anatómicas. Hoy trabajarás con RM cerebrales 3T y 7T.
El dataset es público y puede descargarse desde esta fuente.
Se usan 28 sujetos para entrenamiento y los 11 restantes para pruebas.
Primero definamos las dimensiones de los datos. Redimensionarás las imágenes de 173x173 a 176x176 en la parte de lectura de datos. Aquí también definirás el directorio de datos, el tamaño de batch para entrenar, el número de canales, una capa Input(), las matrices de train y test como listas y, por último, para el reescalado cargarás el fichero de texto con los valores mínimo y máximo del dataset de RM.
Nota: Para reescalar, también puedes usar el máximo y el mínimo del propio dataset si no tienes el fichero maxANDmin.txt.
x,y = 173,173
full_z = 207
resizeTo=176
batch_size = 32
inChannel = outChannel = 1
input_shape=(x,y,inChannel)
input_img = Input(shape = (resizeTo, resizeTo, inChannel))
inp = "ground3T"
out = "ground7T"
train_matrix = []
test_matrix = []
min_max = np.loadtxt('maxANDmin.txt')A continuación, cargarás los datos de RM con la librería nibabel y redimensionarás las imágenes de 173 x 173 a 176 x 176 rellenando con ceros en las dimensiones x e y.
Ten en cuenta que cuando cargas un volumen en formato NIfTI, Nibabel no carga el array de imagen hasta que se lo pides. La forma estándar de solicitar el array es llamar al método get_data().
Como quieres cortes 2D en lugar de 3D, usarás las listas train y test que inicializaste antes; cada vez que leas un volumen, iterarás por los 207 cortes del volumen 3D y añadirás cada corte a la lista uno a uno.
folder = os.listdir(inp)
Primero carguemos los datos 3T.
for f in folder:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load(inp + f)
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        train_matrix.append(a[:,j,:])
Luego carga los datos 7T. Usas la misma variable folder porque el número de volúmenes 3T y 7T es igual.
for f in folder:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    b = nib.load(out + f)
    b = b.get_data()
    temp[3:,:,3:] = b
    b = temp
    for j in range(full_z):
        test_matrix.append(b[:,j,:])
Como las matrices de train y test son listas, usarás NumPy para convertirlas en arrays.
Después, cambiarás el type del array a float32 y reescalarás tanto el input como el ground truth.
train_matrix = np.asarray(train_matrix)
train_matrix = train_matrix.astype('float32')
m = min_max[0]
mi = min_max[1]
train_matrix = (train_matrix - mi) / (m - mi)

test_matrix = np.asarray(test_matrix)
test_matrix = test_matrix.astype('float32')
test_matrix = (test_matrix - mi) / (m - mi)
Imprimamos rápidamente las formas de las matrices train_matrix (3T) y test_matrix (7T). Deben tener 28 x 207 = 5796 imágenes en total, cada una de 176 x 176.
train_matrix.shape
(5796, 176, 176)
test_matrix.shape
(5796, 176, 176)
A continuación, crearás dos nuevas variables, augmented_images (3T/input) y Haugmented_images (7T/ground truth), con la misma forma que train y test. Será una matriz 4D: primera dimensión número total de imágenes, segunda y tercera dimensiones el tamaño de cada imagen y la última el número de canales (uno en este caso).
augmented_images=np.zeros(shape=[(train_matrix.shape[0]),(train_matrix.shape[1]),(train_matrix.shape[2]),(1)])
Haugmented_images=np.zeros(shape=[(train_matrix.shape[0]),(train_matrix.shape[1]),(train_matrix.shape[2]),(1)])
Luego iterarás sobre todas las imágenes; cada vez remodelarás las matrices de train y test a 176 x 176 y las añadirás a augmented_images (3T/input) y Haugmented_images (7T/ground truth) respectivamente.
for i in range(train_matrix.shape[0]):
    augmented_images[i,:,:,0] = train_matrix[i,:,:].reshape(resizeTo,resizeTo)
    Haugmented_images[i,:,:,0] = test_matrix[i,:,:].reshape(resizeTo,resizeTo)
Después de todo esto, es importante particionar los datos. Para que tu modelo generalice bien, divide los datos en entrenamiento y validación. Entrenarás con el 80% y validarás con el 20% restante.
Esto también ayuda a reducir el sobreajuste, ya que validarás con datos no vistos durante el entrenamiento.
Puedes usar train_test_split de scikit-learn que definiste al principio para dividir correctamente:
data,Label = shuffle(augmented_images,Haugmented_images, random_state=2)
X_train, X_test, y_train, y_test = train_test_split(data, Label, test_size=0.2, random_state=2)
X_test = np.array(X_test)
y_test = np.array(y_test)
X_test = X_test.astype('float32')
y_test = y_test.astype('float32')
X_train = np.array(X_train)
y_train = np.array(y_train)
X_train = X_train.astype('float32')
y_train = y_train.astype('float32')
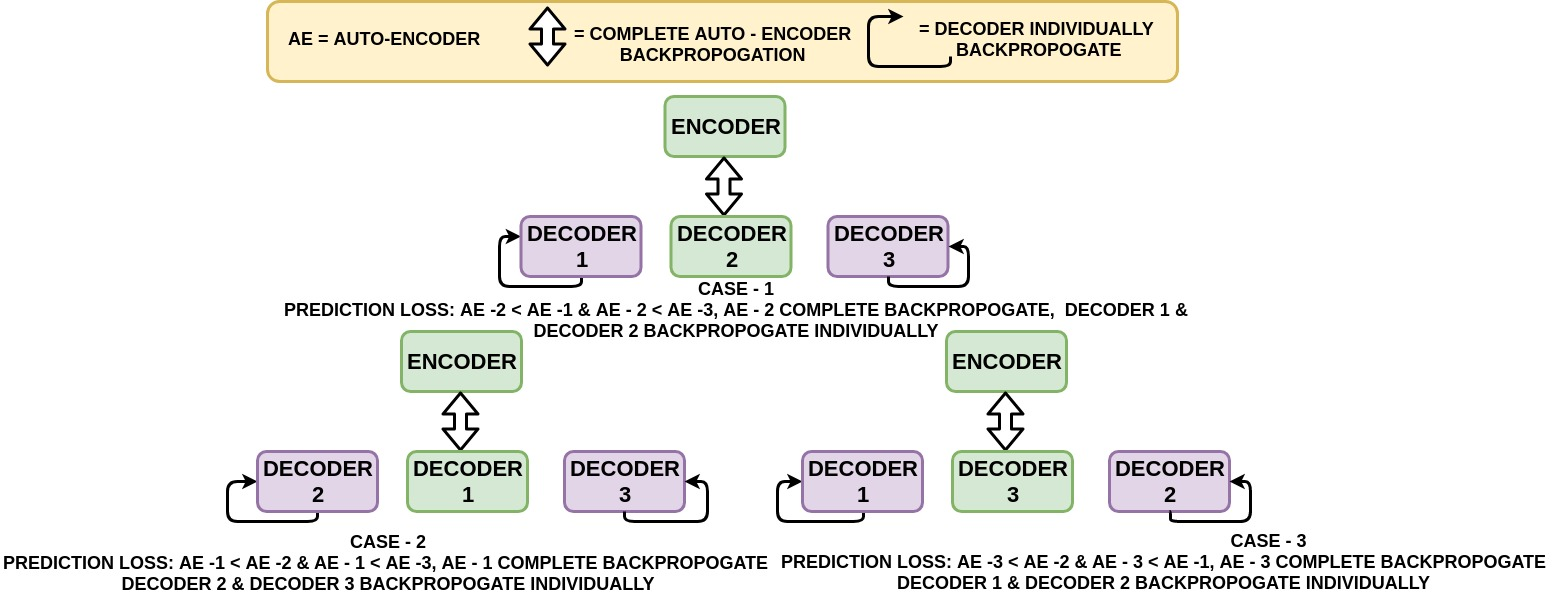
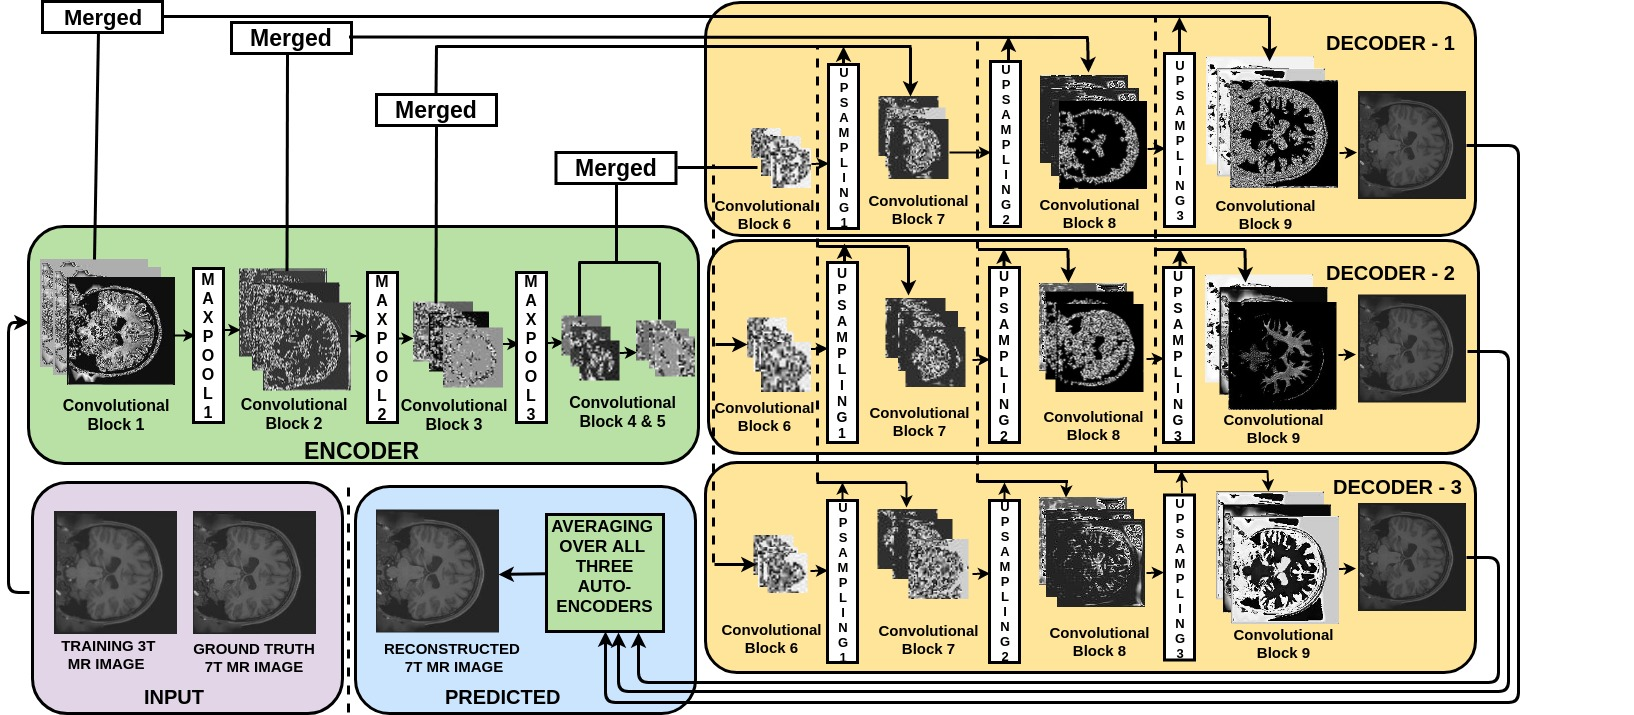
Ahora defines la arquitectura propuesta con bloques de capas de filtros seguidos de una capa de max pooling en la parte del codificador, como se muestra en la siguiente celda. Para reconstruir el tamaño original de la imagen a la salida, se introduce una capa de upsampling en cada bloque de los decodificadores. Durante el upsampling pueden aparecer artefactos por detalles faltantes en la entrada reducida del decodificador. Por eso, concatenas la entrada del decodificador con su versión reescalada desde el codificador, aportando detalles para una mejor reconstrucción al hacer upsampling en el decodificador. Añadir conexiones de fusión mejora significativamente el PSNR (del orden de 5 dB). Esta configuración se inspira en este paper.
La propuesta emplea un único codificador y múltiples decodificadores con entrada monocanal. Se usan tres capas convolucionales en cada bloque del codificador y en los tres decodificadores, seguidas de una capa de normalización por lotes para mantener la estabilidad numérica.
El primer bloque convolucional del codificador tiene 32 filtros y este número se duplica tras cada bloque. En todos los decodificadores, el primer bloque tiene 256 filtros y el número se reduce a la mitad tras cada bloque. Usarás filtros de 3x3 en todos los bloques.
La activación Rectified Linear Unit (ReLU) se usa en todas las capas excepto en la final. Como los datos están normalizados entre 0 y 1, en la última capa se usa una activación Sigmoid.
Es bien sabido que los detalles locales de imagen a distintas escalas son clave en la reconstrucción. La arquitectura propuesta considera imágenes a diferentes escalas usando capas jerárquicas para downsampling (max pooling) y upsampling (factor 2) en codificador y decodificadores, respectivamente. La representación codificada tras tres reducciones lleva los datos de una entrada de alta dimensión a un espacio latente.
def encoder(input_img):
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    pool3 = MaxPooling2D(pool_size=(2, 2))(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(pool3)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv4)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='sigmoid', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    return conv5,conv4,conv3,conv2,conv1
def decoder_1(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_1 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_1
def decoder_2(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_2 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_2
def decoder_3(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded_3 = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded_3
En las 4 celdas anteriores definiste cuatro funciones: una para el codificador y tres para los decodificadores. Como son funciones, podrías definir decoder() y llamarlo tres veces, pero para mayor claridad lo definimos tres veces y así evitamos problemas de aleatoriedad entre decodificadores.
Usarás un error cuadrático medio excluyendo los valores (píxeles) de y_t y y_p que sean cero.
def root_mean_sq_GxGy(y_t, y_p):
    a1=1
    where = tf.not_equal(y_t, 0)
    a_t=tf.boolean_mask(y_t,where,name='boolean_mask')
    a_p=tf.boolean_mask(y_p,where,name='boolean_mask')
    return a1*(K.sqrt(K.mean((K.square(a_t-a_p)))))
Primero llamarás a la función encoder pasándole la entrada. Como usas conexiones de fusión en tu arquitectura, encoder devolverá la salida de cinco capas convolution que luego fusionarás por separado con los tres decodificadores.
conv5,conv4,conv3,conv2,conv1 = encoder(input_img)
autoencoder_1 = Model(input_img, decoder_1(conv5,conv4,conv3,conv2,conv1))
autoencoder_1.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())

autoencoder_2 = Model(input_img, decoder_2(conv5,conv4,conv3,conv2,conv1))
autoencoder_2.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())

autoencoder_3 = Model(input_img, decoder_3(conv5,conv4,conv3,conv2,conv1))
autoencoder_3.compile(loss=root_mean_sq_GxGy, optimizer = RMSprop())
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:2: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.

/usr/local/lib/python3.5/dist-packages/keras/legacy/layers.py:460: UserWarning: The `Merge` layer is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
  name=name)
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:10: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
  # Remove the CWD from sys.path while we load stuff.
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:18: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.
/usr/local/lib/python3.5/dist-packages/ipykernel_launcher.py:26: UserWarning: The `merge` function is deprecated and will be removed after 08/2017. Use instead layers from `keras.layers.merge`, e.g. `add`, `concatenate`, etc.


WARNING:tensorflow:From /usr/local/lib/python3.5/dist-packages/keras/backend/tensorflow_backend.py:1257: calling reduce_mean (from tensorflow.python.ops.math_ops) with keep_dims is deprecated and will be removed in a future version.
Instructions for updating:
keep_dims is deprecated, use keepdims instead
Guardarás los pesos solo cuando el peak signal-to-noise ratio en los datos de validación mejore. Para ello definirás una lista psnr_gray_channel en la que añadirás un valor por defecto 1; necesitas inicializar la lista con un número y el PSNR estará muy por encima de ese valor incluso en etapas tempranas, actuando solo como un número de relleno.
Inicializarás la tasa de aprendizaje en 1e-3 y aplicarás una estrategia de decaimiento, reduciéndola un 10% cada 20 épocas.
psnr_gray_channel = []
psnr_gray_channel.append(1)
learning_rate = 0.001
j=0
Nota: El siguiente código completo debe ejecutarse en una única celda, pero para entender mejor el proceso de entrenamiento lo dividiremos en partes.
El modelo se entrena durante 500 épocas. La tasa de aprendizaje inicial es 1e-3 como se definió antes. También guardarás PSNR y MSE tras cada época de 7T con lo predicho. Usarás K.set_value para cambiar la tasa de aprendizaje de los tres modelos en un 10% cada 20 épocas.
for jj in range(500):
    myfile_valid_psnr_7T = open('../1_encoder_3_decoders_complete_slices_single_channel/validation_psnr7T_1encoder_3decoders.txt', 'a')
    myfile_valid_mse_7T = open('../1_encoder_3_decoders_complete_slices_single_channel/validation_mse7T_1encoder_3decoders.txt', 'a')

    K.set_value(autoencoder_1.optimizer.lr, learning_rate)
    K.set_value(autoencoder_2.optimizer.lr, learning_rate)
    K.set_value(autoencoder_3.optimizer.lr, learning_rate)
Luego barajas las imágenes 3T de entrada y 7T de ground truth para evitar sobreajuste, ya que no barajar forzaría al modelo a ver las muestras siempre en el mismo orden. Después calculas el número de batches según el batch_size definido y finalmente iteras sobre num_batches.
train_X,train_Y = shuffle(X_train,y_train)
print ("Epoch is: %d\n" % j)
print ("Number of batches: %d\n" % int(len(train_X)/batch_size))
num_batches = int(len(train_X)/batch_size)
for batch in range(num_batches):
Además de almacenar los valores de PSNR, guardarás las pérdidas de los tres autoencoders y de los tres decodificadores respectivamente.
myfile_ae1_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae1_train_loss_1encoder_3decoders.txt', 'a')
myfile_ae2_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae2_train_loss_1encoder_3decoders.txt', 'a')
myfile_ae3_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/ae3_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec1_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec1_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec2_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec2_train_loss_1encoder_3decoders.txt', 'a')
myfile_dec3_loss = open('../1_encoder_3_decoders_complete_slices_single_channel/dec3_train_loss_1encoder_3decoders.txt', 'a')
Como en cada batch quieres que el modelo vea las siguientes 32 muestras (batch_size), la siguiente celda se encarga de ello.
batch_train_X = train_X[batch*batch_size:min((batch+1)*batch_size,len(train_X)),:]
batch_train_Y = train_Y[batch*batch_size:min((batch+1)*batch_size,len(train_Y)),:]
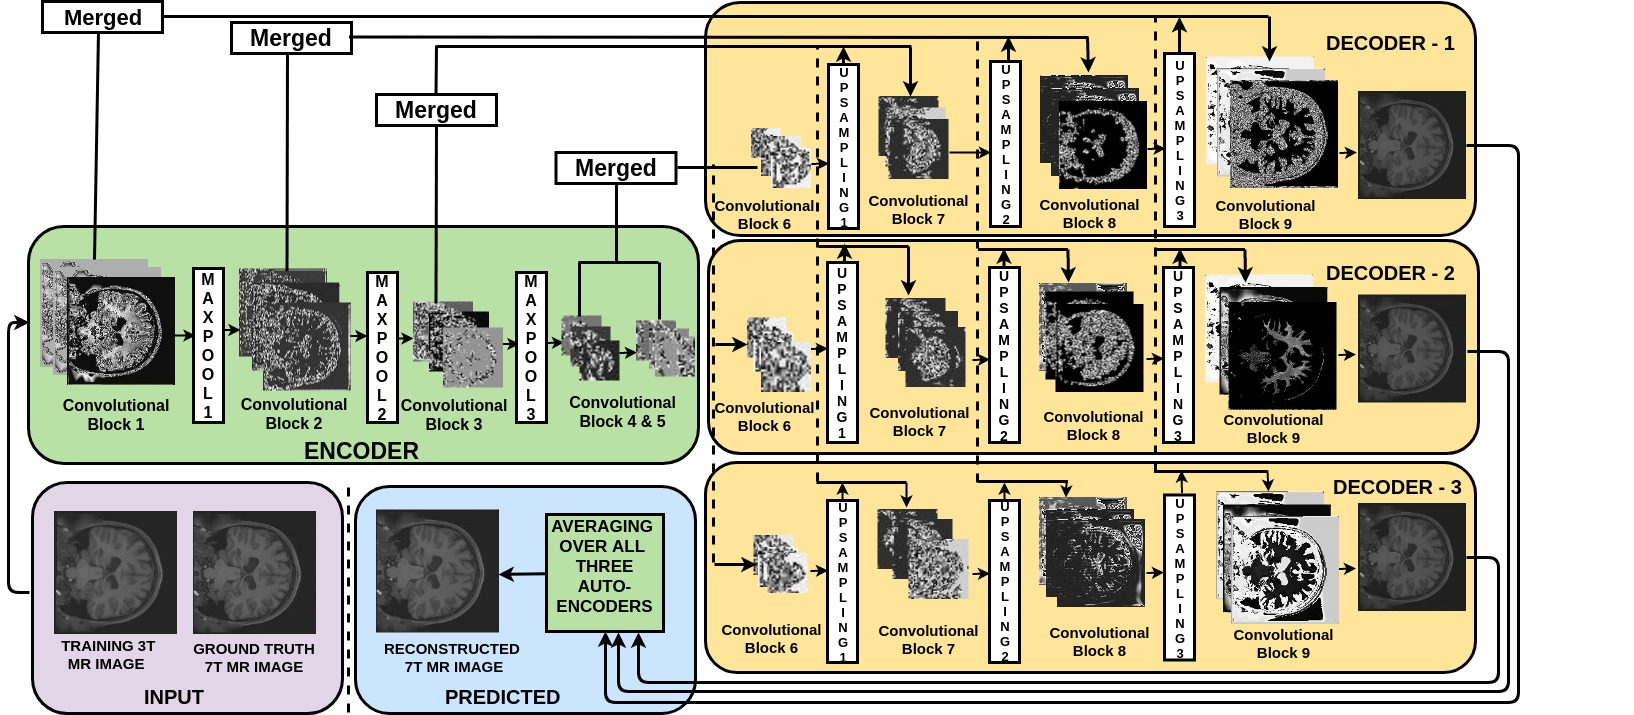
Para que la estrategia de autoencoder mínimo funcione, tras cada época pruebas en los datos de entrenamiento usando test_on_batch de Keras, que te devuelve tres pérdidas, y finalmente las imprimes.
loss_1 = autoencoder_1.test_on_batch(batch_train_X,batch_train_Y)
loss_2 = autoencoder_2.test_on_batch(batch_train_X,batch_train_Y)
loss_3 = autoencoder_3.test_on_batch(batch_train_X,batch_train_Y)
print ('epoch_num: %d batch_num: %d Test_loss_1: %f\n' % (j,batch,loss_1))
print ('epoch_num: %d batch_num: %d Test_loss_2: %f\n' % (j,batch,loss_2))
print ('epoch_num: %d batch_num: %d Test_loss_3: %f\n' % (j,batch,loss_3))
Pueden darse seis condiciones en tu red:
loss_1: pérdida del Autoencoder 1
loss_2: pérdida del Autoencoder 2
loss_3: pérdida del Autoencoder 3
if loss_1 < loss_2 and loss_1 < loss_3:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1: %f\n' % (j,batch,train_1))
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_loss_3: %f\n' % (j,batch,train_3))
elif loss_2 < loss_1 and loss_2 < loss_3:
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_2: %f\n' % (j,batch,train_2))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_1.summary()
    #autoencoder_3.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" % (train_1))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3: %f\n' % (j,batch,train_3))
elif loss_3 < loss_1 and loss_3 < loss_2:
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_3: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_3: %f\n' % (j,batch,train_3))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    #autoencoder_1.summary()
    #autoencoder_2.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" %(train_1))
    myfile_dec2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2: %f\n' % (j,batch,train_2))
elif loss_1 == loss_2:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
elif loss_2 == loss_3:
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae2_loss.write("%f \n" % (train_2))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    for layer in autoencoder_1.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False

    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec1_loss.write("%f \n" % (train_1))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
elif loss_3 == loss_1:
    train_1 = autoencoder_1.train_on_batch(batch_train_X,batch_train_Y)
    myfile_ae1_loss.write("%f \n" % (train_1))
    print ('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    #myfile.write('epoch_num: %d batch_num: %d AE_Train_loss_1_equal_state: %f\n' % (j,batch,train_1))
    for layer in autoencoder_2.layers[:34]:
        layer.trainable = False
    for layer in autoencoder_3.layers[:34]:
        layer.trainable = False
    #autoencoder_2.summary()
    #autoencoder_3.summary()
    train_2 = autoencoder_2.train_on_batch(batch_train_X,batch_train_Y)
    train_3 = autoencoder_3.train_on_batch(batch_train_X,batch_train_Y)
    myfile_dec2_loss.write("%f \n" % (train_2))
    myfile_dec3_loss.write("%f \n" % (train_3))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    print ('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_2_equal_state: %f\n' % (j,batch,train_2))
    #myfile.write('epoch_num: %d batch_num: %d Decoder_Train_loss_3_equal_state: %f\n' % (j,batch,train_3))


    myfile_ae1_loss.close()
    myfile_ae2_loss.close()
    myfile_ae3_loss.close()
    myfile_dec1_loss.close()
    myfile_dec2_loss.close()
    myfile_dec3_loss.close()
Este paso es esencial: como pusiste algunas capas en False en las condiciones anteriores, debes volver a ponerlas en True para que todas las capas de los autoencoders se usen con test_on_batch y no se queden en False durante todo el entrenamiento.
for layer in autoencoder_1.layers[:34]:
            layer.trainable = True
for layer in autoencoder_2.layers[:34]:
            layer.trainable = True
for layer in autoencoder_3.layers[:34]:
            layer.trainable = True
Guardarás pesos de tres formas; abajo van dos: guardar tras cada 100 épocas y guardar tras cada época (se sobrescriben).
if jj % 100 ==0:
            autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1_" + str(jj)+".h5")
            autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2_" + str(jj)+".h5")
            autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3_" + str(jj)+".h5")


autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1.h5")
autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2.h5")
autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3.h5")
Primero barajarás los datos de validación y luego aplicarás las mismas 6 condiciones posibles definidas arriba. La condición que se cumpla determinará con qué autoencoder probar tu modelo.
Después calculas dos métricas, MSE y PSNR, entre decoded_imgs (predicción) y ground truth. Finalmente las guardas en ficheros de texto.
X_test,y_test = shuffle(X_test,y_test)
if loss_1 < loss_2 and loss_1 < loss_3:
    decoded_imgs = autoencoder_1.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)


    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))

    #print (check)
elif loss_2 < loss_1 and loss_2 < loss_3:
    decoded_imgs = autoencoder_2.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))

    #print (check)
elif loss_3 < loss_2 and loss_3 < loss_1:
    decoded_imgs = autoencoder_3.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))
    #print (check)

elif loss_1 == loss_2:
    decoded_imgs = autoencoder_1.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))


elif loss_2 == loss_3:
    decoded_imgs = autoencoder_2.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))


elif loss_3 == loss_1:
    decoded_imgs = autoencoder_3.predict(X_test)
    mse_7T=  np.mean((y_test[:,:,:,0] - decoded_imgs[:,:,:,0]) ** 2)
    check_7T = math.sqrt(mse_7T)
    psnr_7T = 20 * math.log10( 1.0 / check_7T)

    myfile_valid_psnr_7T.write("%f \n" % (psnr_7T))
    myfile_valid_mse_7T.write("%f \n" % (mse_7T))
Aquí solo guardas los pesos cuando el PSNR entre la predicción 7T y el ground truth (7T) es el máximo respecto a los valores previos almacenados en psnr_gray_channel.
if max(psnr_gray_channel) < psnr_7T:
            autoencoder_1.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE1_" + str(jj)+".h5")
            autoencoder_2.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE2_" + str(jj)+".h5")
            autoencoder_3.save_weights("../Model/CROSSVAL1/CROSSVAL1_AE3_" + str(jj)+".h5")

    psnr_gray_channel.append(psnr_7T)
Definirás una matriz de NumPy temp de tamaño 176 x 528, ya que guardarás 3 imágenes en una fila, cada una de 176 x 176. Guardarás una de las imágenes de validación 3T, 7T y la predicha y multiplicarás la matriz por 255 porque las imágenes estaban escaladas entre 0 y 1.
Finalmente, con scipy guardarás la imagen.
temp = np.zeros([resizeTo,resizeTo*3])
temp[:resizeTo,:resizeTo] = X_test[0,:,:,0]
temp[:resizeTo,resizeTo:resizeTo*2] = y_test[0,:,:,0]
temp[:resizeTo,2*resizeTo:] = decoded_imgs[0,:,:,0]
temp = temp*255
scipy.misc.imsave('../Results/1_encoder_3_decoders_complete_slices_single_channel/' + str(j) + '.jpg', temp)
j +=1
Cerremos los ficheros de PSNR y MSE al final.
myfile_valid_psnr_7T.close()
myfile_valid_mse_7T.close()
Por último, reducirás la tasa de aprendizaje un 10% de su valor actual cada 20 épocas.
if jj % 20 ==0:
        learning_rate = learning_rate - learning_rate * 0.10
En la parte 2 de este tutorial abordarás lo siguiente:
nibabel.Antes de seguir este tutorial, asegúrate de tener exactamente las mismas versiones de módulos que se indican a continuación:
Nota: Ten en cuenta que el modelo se entrenará en un sistema con GPU Nvidia 1080 Ti, procesador Xeon e5 GeForce y 32 GB de RAM. Si usas Jupyter Notebook, tendrás que añadir tres líneas de código más para especificar el orden del dispositivo CUDA y las GPU visibles usando el módulo os.
En el código siguiente, básicamente defines variables de entorno en el notebook con os.environ. Conviene hacerlo antes de inicializar Keras para limitar que el backend TensorFlow use la primera GPU. Si la máquina en la que entrenas tiene la GPU en 0, usa 0 en lugar de 1. Puedes comprobarlo ejecutando, por ejemplo, nvidia-smi.
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU
Primero, importa todos los módulos necesarios como tensorflow, numpy y, sobre todo, keras y las funciones o capas requeridas como Input, Conv2D, MaxPooling2D, etc., ya que usarás todos estos frameworks para entrenar el modelo.
Para leer imágenes en formato NIfTI, también necesitas importar el módulo nibabel.
import os
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
import numpy as np
import scipy.misc
import numpy.random as rng
from sklearn.utils import shuffle
import nibabel as nib
from sklearn.cross_validation import train_test_split
import math
El dataset de RM cerebral 3T y 7T consta de volúmenes 3D; cada volumen tiene 207 cortes/imágenes de RM obtenidas en distintos planos del cerebro. Cada corte tiene dimensiones 173 x 173. Las imágenes son monocanal en escala de grises. Hay 39 sujetos en total, cada uno con la RM de un paciente. El formato de imagen no es jpeg, png, etc., sino NIfTI. En una sección posterior verás cómo leer imágenes en formato NIfTI.
El dataset consiste en imágenes de RM de modalidad T1, tradicionalmente adecuadas para evaluar estructuras anatómicas. Hoy trabajarás con RM cerebrales 3T y 7T.
El dataset es público y puede descargarse desde esta fuente.
Primero definamos las dimensiones de los datos. Redimensionarás las imágenes de 173x173 a 176x176 en la parte de lectura de datos. Aquí también definimos el directorio de datos, el tamaño de batch que usamos para entrenar, el número de canales, una capa Input(), las matrices de train y test como listas y, por último, para el reescalado cargamos el fichero de texto con los valores mínimo y máximo del dataset de RM.
x,y = 173,173
full_z = 207
resizeTo=176
inChannel = outChannel = 1
input_shape=(x,y,inChannel)
input_img = Input(shape = (resizeTo, resizeTo, inChannel))
train_matrix = []
test_matrix = []
ff = os.listdir("../test_crossval1")
save = "../Result_nii_crossval1"
folder_ground = os.listdir("../test_g_crossval1")
ToPredict_images=[]
predict_matrix=[]
ground_images=[]
ground_matrix=[]
min_max=np.loadtxt('../maxANDmin.txt')
A continuación, cargamos los datos de RM con la librería nibabel y redimensionamos las imágenes de 173 x 173 a 176 x 176 rellenando con ceros en las dimensiones x e y.
Ten en cuenta que cuando cargas un volumen en formato NIfTI, Nibabel no carga el array de imagen hasta que se lo pides. La forma estándar de solicitar el array es llamar al método get_data().
Como quieres cortes 2D en lugar de 3D, usarás las listas train y test que inicializaste antes; cada vez que leas un volumen, iterarás por los 207 cortes del volumen 3D y añadirás cada corte a la lista uno a uno.
for f in ff:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load("../test_crossval1" + f)
    affine = a.affine
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        predict_matrix.append(a[:,j,:])
for f in ff:
    temp = np.zeros([resizeTo,full_z,resizeTo])
    a = nib.load("../test_g_crossval1" + f)
    affine = a.affine
    a = a.get_data()
    temp[3:,:,3:] = a
    a = temp
    for j in range(full_z):
        ground_matrix.append(a[:,j,:])
Como las matrices de prueba 3T y 7T son listas, usarás NumPy para convertirlas en arrays.
Después, cambiarás el type del array a float32 y reescalarás tanto el input como el ground truth.
ToPredict_images = np.asarray(predict_matrix)
ToPredict_images = ToPredict_images.astype('float32')
mx = min_max[0]
mn = min_max[1]
ToPredict_images[:,:,:,0] = (ToPredict_images[:,:,:,0] - mn ) / (mx - mn)
ground_images = np.asarray(ground_matrix)
ground_images = ground_images.astype('float32')
ground_images[:,:,:,0] = (ground_images[:,:,:,0] - mn ) / (mx - mn)
A continuación, crearás dos nuevas variables, ToPredict_images (3T test/input) y ground_images (7T test/ground truth), con la forma de train y test. Será una matriz 4D: número total de imágenes, dimensiones de cada imagen y número de canales (uno en este caso).
ToPredict_images=np.zeros(shape=[(ToPredict_images.shape[0]),(ToPredict_images.shape[1]),(ToPredict_images.shape[2]),(1)])
ground_images=np.zeros(shape=[(ground_images.shape[0]),(ground_images.shape[1]),(ground_images.shape[2]),(1)])
Luego iterarás sobre todas las imágenes; cada vez remodelarás las matrices de train y test a 176 x 176 y las añadirás a ToPredict_images (3T test/input) y ground_images (7T test/ground truth) respectivamente.
for i in range(ToPredict_images.shape[0]):
    ToPredict_images[i,:,:,0] = ToPredict_images[i,:,:].reshape(resizeTo,resizeTo)
for i in range(ground_images.shape[0]):
    ground_images[i,:,:,0] = ground_images[i,:,:].reshape(resizeTo,resizeTo)
def encoder(input_img):
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3,3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    pool3 = MaxPooling2D(pool_size=(2, 2))(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(pool3)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv4)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(512, (3, 3), activation='sigmoid', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    return conv5,conv4,conv3,conv2,conv1
def decoder(conv5,conv4,conv3,conv2,conv1):
    up6 = merge([conv5, conv4], mode='concat', concat_axis=3)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(up6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up7 = UpSampling2D((2,2))(conv6)
    up7 = merge([up7, conv3], mode='concat', concat_axis=3)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(up7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up8 = UpSampling2D((2,2))(conv7)
    up8 = merge([up8, conv2], mode='concat', concat_axis=3)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(up8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    conv8 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv8)
    conv8 = BatchNormalization()(conv8)
    up9 = UpSampling2D((2,2))(conv8)
    up9 = merge([up9, conv1], mode='concat', concat_axis=3)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(up9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    conv9 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv9)
    conv9 = BatchNormalization()(conv9)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(conv9)
    return decoded
Usarás un error cuadrático medio excluyendo los valores (píxeles) de y_t y y_p que sean cero.
def root_mean_sq_GxGy(y_t, y_p):
    a1=1
    zero = tf.constant(0, dtype=tf.float32)
    where = tf.not_equal(y_t, zero)
    a_t=tf.boolean_mask(y_t,where,name='boolean_mask')
    a_p=tf.boolean_mask(y_p,where,name='boolean_mask')
    return a1*(K.sqrt(K.mean((K.square(a_t-a_p)))))
Primero, llama a la función encoder pasándole la entrada. Como usas conexiones de fusión, encoder devolverá la salida de cinco capas convolution que luego fusionarás por separado con los tres decodificadores.
conv5,conv4,conv3,conv2,conv1 = encoder(input_img)
Ahora crea tres modelos distintos y carga en ellos los pesos entrenados.
autoencoder_1 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_1.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE1.h5")
autoencoder_2 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_2.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE2.h5")
autoencoder_3 = Model(input_img, decoder(conv5,conv4,conv3,conv2,conv1))

autoencoder_3.load_weights("../Model/CROSSVAL1/CROSSVAL1_AE3.h5")
Inicialicemos rápidamente dos arrays de NumPy de tamaño 11 x 3 x 1: la primera dimensión representa el número de volúmenes para probar el modelo. La segunda representa el MSE y PSNR entre: imágenes 7T predichas y 7T de ground truth, predicción y entrada 3T, y entrada 3T y 7T de ground truth; la tercera dimensión representa el número de canales que introducirás en tu modelo.
mse= np.zeros([11,3,1])
psnr= np.zeros([11,3,1])
i=0 #para iterar sobre los cortes de los 11 volúmenes
En la siguiente parte, iterarás por los 11 volúmenes uno a uno. En cada iteración, predecirás cada volumen con los tres autoencoders y promediarás las predicciones.
En cada volumen, iterarás por los canales y calcularás PSNR y MSE para los tres casos comentados arriba.
Después, con nibabel, guardarás la salida predicha, la entrada (3T) y el ground truth (7T) como archivos .nii: cada volumen con 207 cortes.
Por último, guardarás la matriz de PSNR en un archivo de texto con NumPy.
Tal y como se indica en el paper, promediar las salidas predichas ayuda a reducir el ruido y preserva las características locales en las imágenes reconstruidas, lo que mejora el PSNR frente a las salidas individuales de cada decodificador.
for j in range(11):
    decoded_imgs_1 = autoencoder_1.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs_2 = autoencoder_2.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs_3 = autoencoder_3.predict(ToPredict_images[i:i+207,:,:,:])
    decoded_imgs = np.mean( np.array([ decoded_imgs_1, decoded_imgs_2,decoded_imgs_3 ]), axis=0 )
    for channel in range(1):
        mse[j,0,channel]=  np.mean((ground_images[i:i+207,:,:,channel] - decoded_imgs[:,:,:,channel]) ** 2)
        psnr[j,0,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,0,channel]))
        mse[j,1,channel]=  np.mean((ground_images[i:i+207,:,:,channel] - ToPredict_images[i:i+207,:,:,channel])** 2)
        psnr[j,1,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,1,channel]))
        mse[j,2,channel] =  np.mean((ToPredict_images[i:i+207,:,:,channel] - decoded_imgs[:,:,:,channel]) ** 2)
        checklt = math.sqrt(mse[j,2,channel])
        psnr[j,2,channel] = 20 * math.log10( 1.0 / math.sqrt(mse[j,2,channel]))
    obj = nib.Nifti1Image(decoded_imgs, affine)
    string =str(j)+'_crossval1.nii'
    nib.save(obj, save + string)
    obj = nib.Nifti1Image(ground_images[i:i+207,:,:,:], affine)
    string =str(j)+'_ground_images_crossval1.nii'
    nib.save(obj, save + string)
    obj = nib.Nifti1Image(ToPredict_images[i:i+207,:,:,:], affine)
    string =str(j)+'_ToPredict_images_crossval1.nii'
    nib.save(obj, save + string)
    i=i+207


np.savetxt('psnr_all_slices.txt',psnr[:,:,0])
Si quieres aprender más sobre Python, echa un vistazo al curso Introduction to Data Visualization with Matplotlib de DataCamp.
No te pierdas el Keras Tutorial: Deep Learning in Python.
Descubre más sobre Python y deep learning
Curso
Curso
Curso
Tutorial
Abid Ali Awan
15 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Natassha Selvaraj
8 min
Tutorial
Avinash Navlani
12 min
Tutorial
Tutorial
Olivia Smith
9 min