
{count, plural, one {Kursus} other {Kursus}}
Pengantar Apache Airflow dengan Python
{hours} jam
65.1K
Memulai prototipe AI itu mudah. Sebuah notebook, sebuah kunci API, dan beberapa baris Python mungkin sudah cukup untuk mengklasifikasikan teks, meringkas dokumen, atau menghasilkan rekomendasi.
Namun, menjaga prototipe tersebut berjalan andal setiap hari adalah tantangan yang berbeda.
Apa yang terjadi ketika API model mencapai batas laju? Bagaimana jika satu permintaan mengalami timeout, output tidak mengikuti format yang diharapkan, atau basis data hilir untuk sementara tidak tersedia?
Seiring pipeline AI menjadi alur kerja berulang, keandalan, pemantauan, dan pemulihan dengan cepat menjadi sama pentingnya dengan model itu sendiri.
Dalam artikel ini, saya akan menunjukkan cara membangun pipeline AI lengkap dengan Apache Airflow, platform open-source untuk mengembangkan, menjadwalkan, dan memantau alur kerja.
Pipeline kita akan berjalan setiap hari, mengambil ulasan pelanggan, mengklasifikasikan sentimennya menggunakan large language model (LLM), dan menyimpan hasilnya. Semua secara andal dalam satu alur kerja!
Jupyter notebook sangat bagus untuk eksperimen. Kita semua menyukai notebook untuk menguji ide, menulis kode cepat, dan memvisualisasikan hasil sambil berjalan.
Sebuah cron job sering kali cukup untuk menjalankan skrip sederhana setiap malam. Walau, kalau kita jujur, banyak skrip dijalankan manual selama berminggu-minggu sebelum akhirnya ada yang memberi jadwal yang semestinya.
Masalah mulai muncul saat satu skrip berkembang menjadi beberapa skrip, dan skrip-skrip itu saling bergantung. Pada titik itu, kita tidak lagi memiliki program mandiri: kita memiliki sebuah alur kerja.
Baik notebook maupun cron job tidak dirancang untuk mengelola alur kerja kompleks secara andal.
Dependensi sering kali tersembunyi di dalam kode, kegagalan memerlukan investigasi manual, dan menjalankan ulang pipeline bisa berarti mengulang langkah-langkah yang sebenarnya sudah berhasil diselesaikan.
Kita sudah menemui sebagian kompleksitas ini pada pipeline Extract-Transform-Load (ETL) tradisional. Alur kerja ETL mungkin perlu mengambil data, mentransformasikannya, memvalidasi, dan memuatnya ke sistem lain.
Bahkan ketika input dan transformasi dapat diprediksi, setiap langkah tambahan menciptakan titik kegagalan baru. Kini, pipeline AI membuat tantangan ini semakin nyata.
Jika Anda tertarik secara khusus pada pipeline ETL, saya merekomendasikan kursus ini tentang pipeline ETL di Airflow.
Pertimbangkan alur kerja AI yang lazim: kumpulkan data, bersihkan, panggil API model, validasi respons, simpan hasil, dan beri tahu seseorang saat ada masalah.
Setiap langkah bergantung pada langkah sebelumnya, dan masing-masing bisa gagal dengan cara berbeda: API dapat mengembalikan error batas laju. Permintaan model bisa timeout. Respons yang dihasilkan bisa berupa JSON valid tetapi tetap gagal pada pemeriksaan kualitas.
Output juga mungkin tidak lengkap, tidak konsisten, atau diformat berbeda dari yang diharapkan langkah berikutnya.
Airflow tidak menghilangkan kegagalan-kegagalan ini, tetapi mempermudah penanganannya.
Dengan Airflow, sebuah tugas yang memanggil LLM dapat mencoba ulang setelah respons batas laju sementara tanpa menjalankan ulang langkah ingestion data. Tugas validasi dapat menolak hasil yang formatnya salah atau berkualitas rendah sebelum mencapai produksi. Notifikasi dapat memberi tahu tim hanya setelah upaya retry yang dikonfigurasi habis.
Airflow memungkinan hal ini dengan merepresentasikan alur kerja sebagai Directed Acyclic Graph (DAG).
Alih-alih menyembunyikan seluruh pipeline di dalam satu skrip panjang, DAG mendefinisikan setiap operasi sebagai tugas terpisah dengan dependensi eksplisit, kebijakan retry, log, dan status eksekusi.
Inilah alasan utama Airflow sangat cocok untuk pipeline AI: Airflow memperlakukan kegagalan sebagai bagian yang diharapkan dari alur kerja, bukan kejutan yang luar biasa.
Saat sebuah eksperimen tumbuh menjadi proses produksi berulang, Airflow menyediakan lapisan orkestrasi yang dibutuhkan agar dapat diobservasi, dipulihkan, dan lebih mudah dirawat.
Sebelum mulai membangun pipeline kita, mari siapkan lingkungannya.
Ada tiga langkah singkat yang perlu kita lakukan untuk menyiapkan lingkungan.
Untuk tutorial ini, kita akan menjalankan Airflow secara lokal.
Pengaturan ini praktis untuk belajar dan pengembangan karena satu perintah akan menginisialisasi basis data metadata dan memulai layanan yang diperlukan untuk menggunakan Airflow.
Pertama, mari buat dan aktifkan virtual environment untuk menjaga Airflow dan dependensinya tetap terisolasi dari instalasi Python lainnya:
python3 -m venv ~/airflow-venv
source ~/airflow-venv/bin/activate
Selanjutnya, kita perlu memasang Airflow 3 menggunakan pin versi dan file constraints resmi:
AIRFLOW_VERSION=3.3.0
PYTHON_VERSION="$(python -c 'import sys; print(f"{sys.version_info.major}.{sys.version_info.minor}")')"

CONSTRAINT_URL="https://raw.githubusercontent.com/apache/airflow/constraints-${AIRFLOW_VERSION}/constraints-${PYTHON_VERSION}.txt"

pip install "apache-airflow==${AIRFLOW_VERSION}" \
 --constraint "${CONSTRAINT_URL}"
Perhatikan bahwa Airflow bergantung pada banyak paket Python, dan paket-paket tersebut memiliki dependensi masing-masing. Tanpa file constraints, pip bisa saja memilih versi paket yang lebih baru atau tidak kompatibel.
Instalasi mungkin terlihat berhasil, tetapi Airflow kemudian bisa gagal saat mengimpor provider, memulai layanan, atau menjalankan tugas. Panduan instalasi resmi Airflow merekomendasikan penggunaan file constraints untuk memasang sekumpulan dependensi yang sudah diketahui kompatibel.
Karena alur kerja kita akan memanggil LLM, kita juga memerlukan Common AI provider milik Airflow dan dependensi OpenAI untuk Pydantic AI:
pip install \
 "apache-airflow-providers-common-ai" \
 "pydantic-ai-slim[openai]"
Selanjutnya, mari konfigurasikan koneksi OpenAI. Airflow menggunakan koneksi untuk menyimpan kredensial dan pengaturan koneksi di luar kode DAG. Ini membuat berkas Python lebih bersih dan menghindari hard-code secret dalam pipeline.
Setelah kita memvalidasi instalasi, saatnya menetapkan kunci OpenAI agar dapat berkomunikasi dengan model. Ada banyak opsi untuk melakukannya.
Opsi pilihan saya adalah:
export OPENAI_API_KEY="your-openai-api-key"airflow connections add pydanticai_default \
--conn-type pydanticai \
--conn-password "$OPENAI_API_KEY" \
--conn-extra '{"model":"openai:gpt-4o-mini"}'Common AI provider menggunakan tipe koneksi pydanticai untuk berkomunikasi dengan penyedia LLM melalui Pydantic AI.
Perintah ini menyimpan koneksi di basis data metadata Airflow, sehingga setelah itu Anda tidak perlu menyimpan berkas .env atau mengirimkan kunci lagi setiap kali Anda memulai Airflow.
airflow standaloneBiarkan terminal ini tetap terbuka saat Airflow berjalan. Mode standalone ideal untuk pengembangan lokal dan tutorial, tetapi tidak dimaksudkan untuk penempatan produksi.
Untuk mengakses antarmuka Airflow, sekarang kita dapat membuka http://localhost:8080 di browser. Hal pertama yang akan kita lihat adalah halaman login. Tapi nama pengguna dan kata sandi apa yang harus kita gunakan?
Tampilan login Apache Airflow.
Saat Airflow dimulai dalam mode standalone, kredensial login dibuat secara otomatis. Nama pengguna dan kata sandi dicetak di output terminal dan juga disimpan di $AIRFLOW_HOME/simple_auth_manager_passwords.json.generated.
Secara bawaan, AIRFLOW_HOME adalah ~/airflow, jadi kita bisa mengambil kredensial dengan:
cat ~/airflow/simple_auth_manager_passwords.json.generatedAkhirnya, kredensial tersebut akan memungkinkan kita masuk ke antarmuka Airflow.
Setelah masuk, Airflow terbuka di halaman Home. Tampilan ini memberi Anda ringkasan cepat tentang lingkungan Airflow lokal.
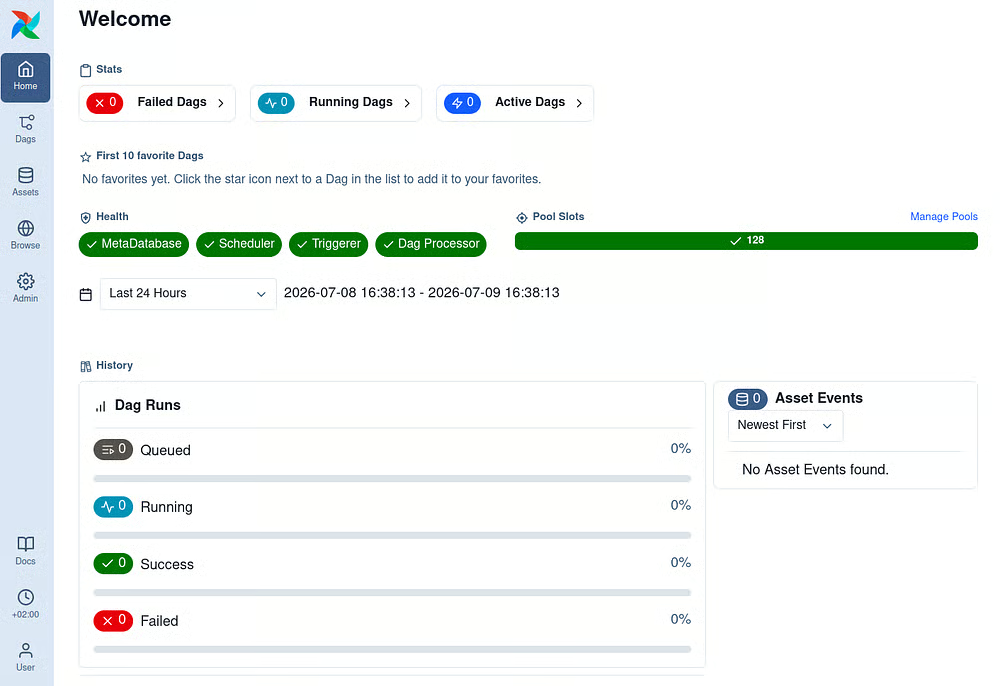
Tampilan UI Airflow setelah login pertama.
Di bagian atas, kartu Stats merangkum status DAG Anda saat ini, termasuk alur kerja yang gagal, berjalan, dan aktif.
Karena kita belum membuat pipeline, nilai-nilai ini mungkin masih nol.
Bagian Health menampilkan apakah layanan utama Airflow sedang berjalan.
Di bawahnya, bilah Pool Slots menampilkan kapasitas eksekusi yang tersedia. Kita tidak akan mengonfigurasi pool kustom dalam artikel ini, tetapi area ini menjadi berguna saat mengontrol berapa banyak tugas yang dapat berjalan pada saat yang sama.
Terakhir, bagian History merangkum run DAG terbaru. Setelah kita memicu pipeline sentimen ulasan, area ini akan mulai menampilkan run yang mengantri, berjalan, berhasil, dan gagal.
Sekarang Airflow berjalan, mari buat berkas yang diperlukan untuk pipeline kita:
mkdir -p ~/airflow/dags
touch ~/airflow/dags/review_sentiment_pipeline.py
touch ~/airflow/requirements.txt
Dalam instalasi lokal standalone, Airflow menggunakan ~/airflow sebagai AIRFLOW_HOME secara default. Kita akan menempatkan berkas DAG kita di dalam direktori dags dan menyimpan berkas requirements.txt untuk mendokumentasikan dependensi proyek.
Dengan demikian, proyek akan memiliki struktur sebagai berikut:
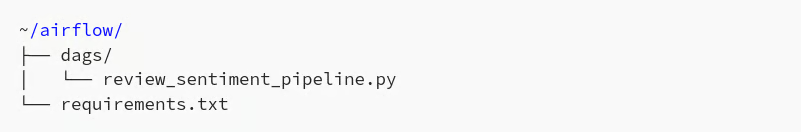
Struktur proyek Airflow minimal.
Berkas eview_sentiment_pipeline.py akan memuat definisi alur kerja, termasuk tugas untuk mengambil ulasan, mengklasifikasikan sentimennya, dan menyimpan hasilnya.
Airflow memantau direktori dags yang dikonfigurasi dan mencari definisi DAG yang valid di dalam berkas Python. Setelah berkas kita berisi DAG yang valid, alur kerja akan muncul di halaman Dags pada UI Airflow.
Jika Anda menemukan kendala saat onboarding, saya sarankan melihat tutorial Memulai dengan Apache Airflow. .
Untuk mulai bekerja langsung dengan Airflow, kita akan membangun job harian yang memproses ulasan pelanggan dan mengklasifikasikan sentimennya.
Bayangkan kita baru saja membangun platform e-commerce. Pelanggan sudah meninggalkan ulasan, dan kita ingin menganalisisnya secara otomatis setiap hari.
Alih-alih menjalankan skrip secara manual, kita dapat menggunakan Airflow untuk mengorkestrasi alur kerja.
Bayangkan ulasan mentah disimpan dalam berkas .jsonl.
Setiap baris memuat satu ulasan sebagai objek JSON, dan ulasan baru ditambahkan ke akhir berkas sepanjang hari. Dalam sistem produksi, data ini mungkin berasal dari API, basis data, object store, atau message queue. Untuk tutorial ini, berkas JSONL memberi kita sumber data ulasan mentah yang sederhana dan realistis.
Dalam skenario ini, langkah pertama dalam pipeline adalah memuat ulasan tersebut ke Airflow. Kita mulai dengan fungsi Python biasa, seperti halnya di notebook atau skrip:
REVIEWS_FILE = Path.home() / "airflow" / "data" / "reviews.jsonl"

def fetch_reviews() -> list[dict]:
   """Load raw customer reviews from the JSONL landing file."""
   reviews = []

   with REVIEWS_FILE.open("r", encoding="utf-8") as file:
       for line_number, line in enumerate(file, start=1):
           if not line.strip():
               continue

           try:
               reviews.append(json.loads(line))
           except json.JSONDecodeError as error:
               raise ValueError(
                   f"Invalid JSON on line {line_number}"
               ) from error

   print(f"Fetched {len(reviews)} reviews")
   return reviews
Fungsi ini membuka berkas JSONL, membacanya baris demi baris, melewati baris kosong, dan mengonversi setiap objek JSON menjadi dictionary Python.
Jika ada baris berisi JSON tidak valid, tugas akan gagal dengan pesan kesalahan yang jelas menampilkan nomor barisnya.
Sejauh ini, ini adalah Python murni. Langkah berikutnya adalah mengubahnya menjadi tugas Airflow dan menempatkannya di dalam DAG.
Untuk mengubah fungsi menjadi bagian dari alur kerja Airflow, kita membutuhkan tiga bagian:
@task. Ini memberi tahu Airflow bahwa fungsi tersebut adalah sebuah tugas.@dag. DAG memberi alur kerja nama, jadwal, tanggal mulai, dan konfigurasi lainnya.Berikut versi minimalnya:
from airflow.sdk import dag

@dag(    fetch_reviews()
   dag_id="fetch_reviews_pipeline",
)

def fetch_reviews_pipeline():
   fetch_reviews()

fetch_reviews_pipeline()
Perhatikan bahwa DAG ini belum akan dieksekusi secara otomatis.
Seperti yang tertulis, kita perlu memicunya secara manual dari UI Airflow. Untuk mengonfigurasi kapan alur kerja harus berjalan, kita bisa menambahkan parameter penjadwalan ke definisi DAG. Salah satu opsinya adalah:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
Mari kita uraikan!
dag_id memberi DAG nama unik di Airflow.schedule="@daily" menjalankan DAG sekali per hari.start_date memberi tahu Airflow kapan penjadwalan dapat dimulai.catchup=False mencegah Airflow membuat run untuk tanggal-tanggal lampau.tags membantu mengatur dan memfilter DAG di UI Airflow.Setelah DAG didefinisikan, kita dapat beralih ke UI dan melihat seperti apa tampilannya dalam praktik:
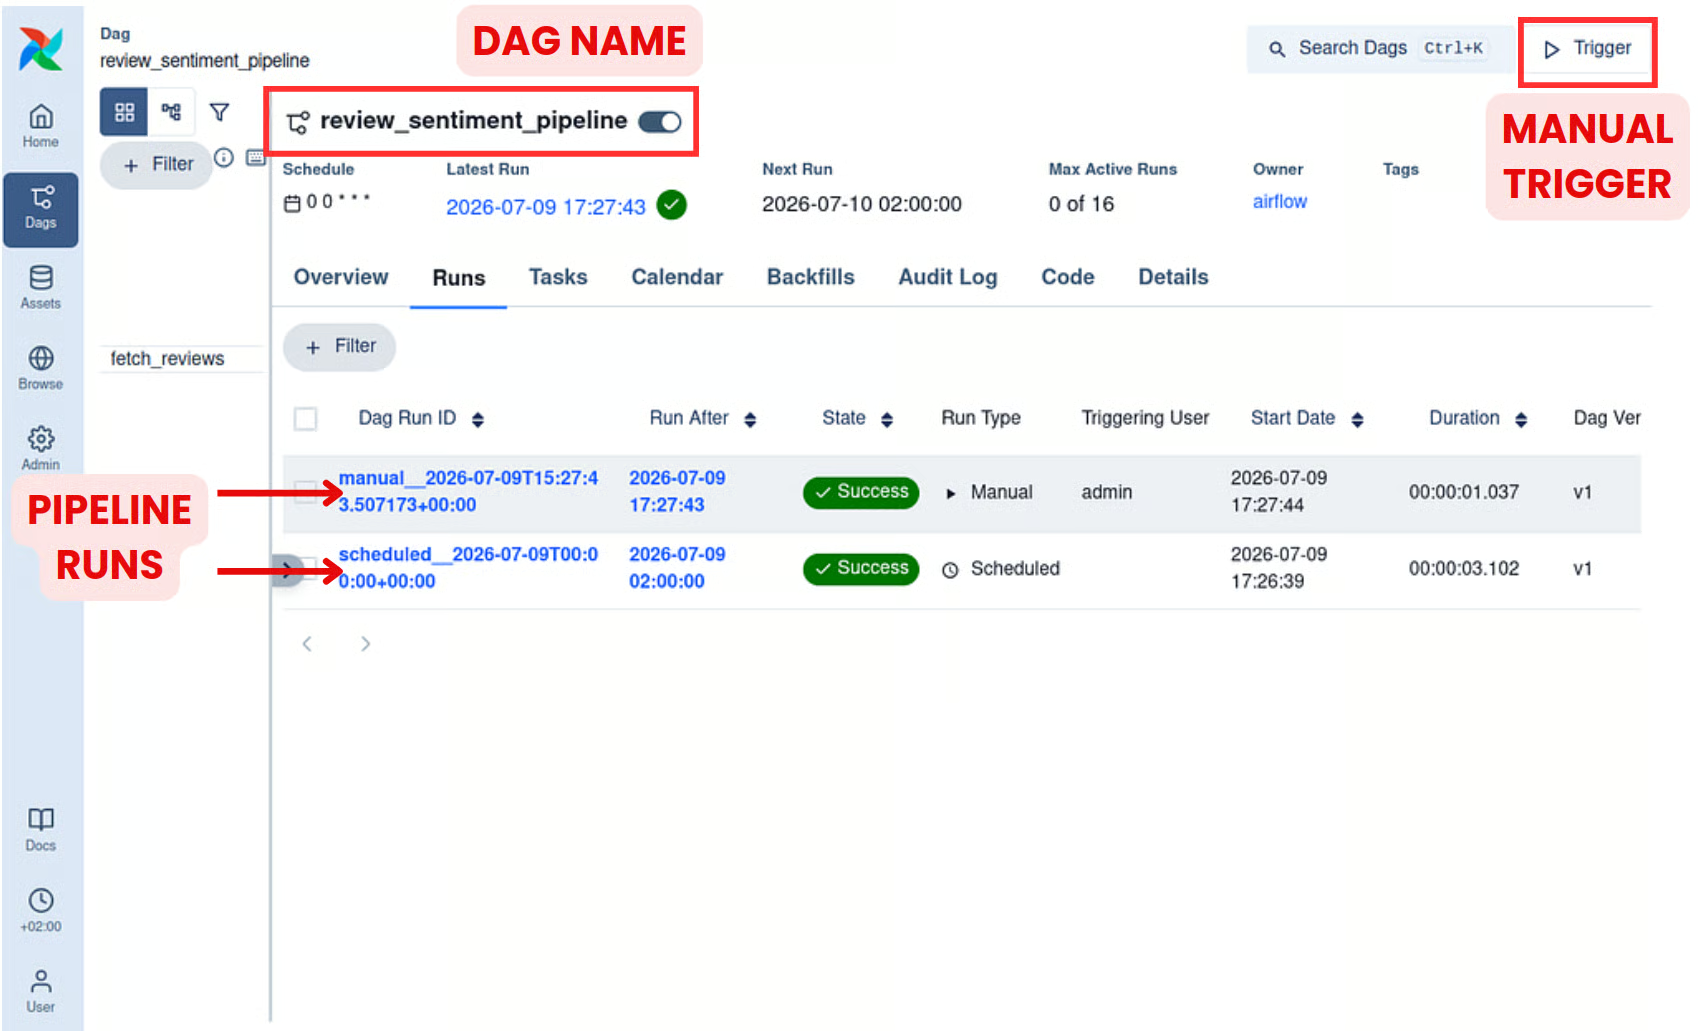
Tampilan UI Airflow dari pipeline review_sentiment_pipeline kita. Perhatikan dua jenis run (terjadwal dan manual) serta tombol Trigger manual.
Di UI, kita dapat melihat bahwa Airflow secara otomatis menemukan DAG bernama review_sentiment_pipeline.
Kita juga dapat melihat bahwa DAG berjalan sesuai jadwalnya, dan bahwa kita memicu satu run tambahan secara manual menggunakan tombol Trigger di pojok kanan atas antarmuka.
Salah satu fitur menarik adalah tampilan gaya kalender, di mana Airflow mencatat run pipeline beserta status masing-masing run:
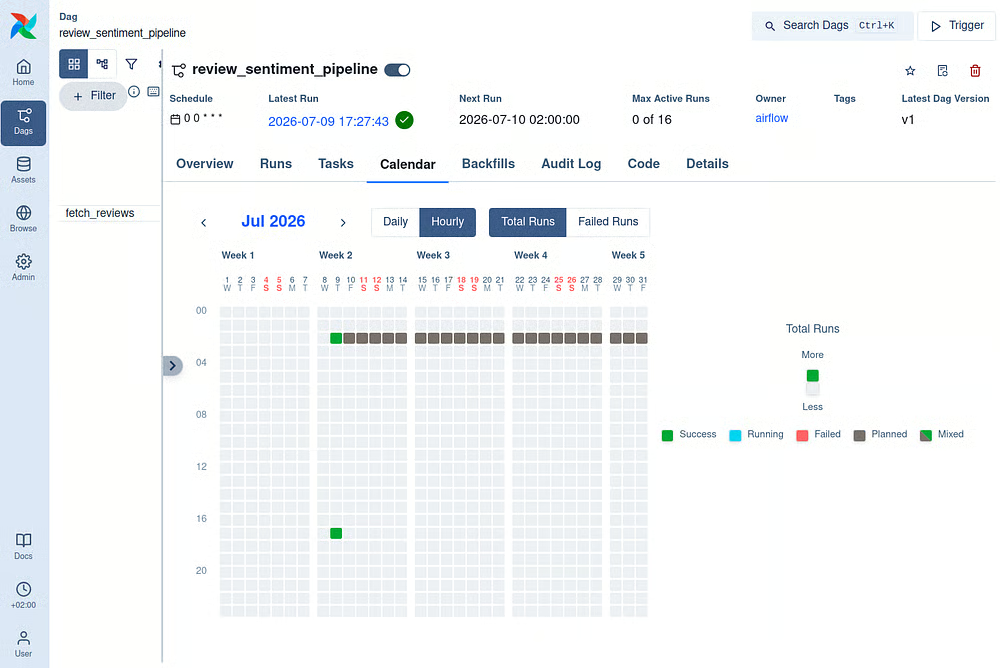
Tampilan kalender pipeline Airflow kita dengan run terjadwal dan manual.
Silakan jeda membaca artikel ini dan jelajahi UI Airflow!
Setelah ulasan dimuat, langkah berikutnya adalah mengklasifikasikan sentimennya. Untuk ini, kita akan menggunakan @task.llm, sebuah dekorator yang mengubah panggilan LLM menjadi tugas Airflow native.
Kita bisa memanggil API OpenAI secara manual di dalam @task biasa, tetapi @task.llm memberi integrasi yang lebih rapi.
Dekorator ini menangani detail spesifik LLM seperti koneksi model, system prompt, output terstruktur, dan serialisasi hasil. Pada saat yang sama, tugas tersebut tetap mendapat manfaat dari fitur standar Airflow seperti retry, logging, pemantauan, dan manajemen dependensi.
Langkah kedua ini punya beberapa bagian lebih banyak daripada tugas persisnya, jadi mari kita bangun secara bertahap:
from typing import Literal
from pydantic import BaseModel

class ReviewClassification(BaseModel):
   """Structured result returned by the LLM."""

   review_id: str
   sentiment: Literal["positive", "neutral", "negative"]
Ini memberi tahu tugas LLM bahwa setiap respons harus memuat ID ulasan dan salah satu dari tiga label sentimen: positive, neutral, atau negative.
@task.llm(
   llm_conn_id="pydanticai_default",
   system_prompt=(
       "Classify the customer review as positive, neutral, or negative. "
       "Use both the written review and the star rating as context. "
       "Return the review ID and sentiment."
   ),
   output_type=ReviewClassification,
   serialize_output=True,
   retries=3,
)
def classify_review(review: dict) -> str:
   """Build the prompt sent to the LLM."""
   return (
       f"Review ID: {review['review_id']}\n"
       f"Product: {review['product']}\n"
       f"Rating: {review['rating']} out of 5 stars\n"
       f"Review: {review['review_text']}"
   )
Badan fungsi mengembalikan string prompt, sementara dekorator @task.llm menangani pengiriman prompt itu ke model menggunakan koneksi pydanticai_default yang kita konfigurasikan sebelumnya.
Parameter system_prompt memberi instruksi pada model, sementara output_type=ReviewClassification meminta respons terstruktur. Kita juga menetapkan serialize_output=True agar Airflow menyimpan hasil sebagai dictionary biasa, sehingga lebih mudah diteruskan ke tugas hilir.
Tertarik pada tugas yang memerlukan inferensi LLM? Pertimbangkan kursus LangChain ini untuk aplikasi yang lebih spesialis!
Tugas klasifikasi mengembalikan hasil terstruktur, tetapi selama pengembangan, ada baiknya melihat apa yang dihasilkan model tanpa menunggu hingga langkah penyimpanan akhir.
Memang, satu langkah pipeline dapat terdiri dari lebih dari satu tugas Airflow.
Dalam kasus ini, kita akan menambahkan tugas kecil yang mencetak setiap klasifikasi ke log Airflow:
@task
def show_classification(classification: dict) -> dict:
   """Print one model classification to the Airflow task logs."""
   print(
       f"Review {classification['review_id']}: "
       f"{classification['sentiment']}"
   )

   return classification
Tugas ini tidak mengubah hasil. Tugas ini hanya mencatat output model dan mengembalikan dictionary yang sama, sehingga klasifikasi tetap dapat diteruskan ke langkah berikutnya dalam pipeline.
3. Terakhir, kita perlu menghubungkan tugas baru tersebut di dalam fungsi DAG:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
def review_sentiment_pipeline():
   reviews = fetch_reviews()

   classifications = classify_review.expand(
       review=reviews
   )

   displayed_classifications = show_classification.expand(
       classification=classifications
   )

review_sentiment_pipeline()Catatan: Dalam pipeline ini, kita menggunakan dynamic task mapping dengan .expand(review=reviews). Ini memberi tahu Airflow untuk membuat satu instance tugas classify_review untuk setiap ulasan, sehingga setiap ulasan dikirim ke LLM dalam permintaan terpisah.
Biasanya ini lebih disukai daripada mengirim seluruh daftar ulasan ke satu tugas LLM. Panggilan seperti classify_reviews(reviews) akan memproses semua ulasan sekaligus, yang dapat membuat kegagalan lebih sulit di-debug, retry menjadi kurang terarah, dan input besar lebih mungkin mengenai batas konteks model atau API.
Sebelum menyelesaikan langkah kedua pipeline ini, kita bisa kembali ke UI Airflow dan memvisualisasikan bagaimana alur kerja telah berkembang.
Pada titik ini, DAG berisi tiga tugas: fetch_reviews, classify_review, dan show_classification :
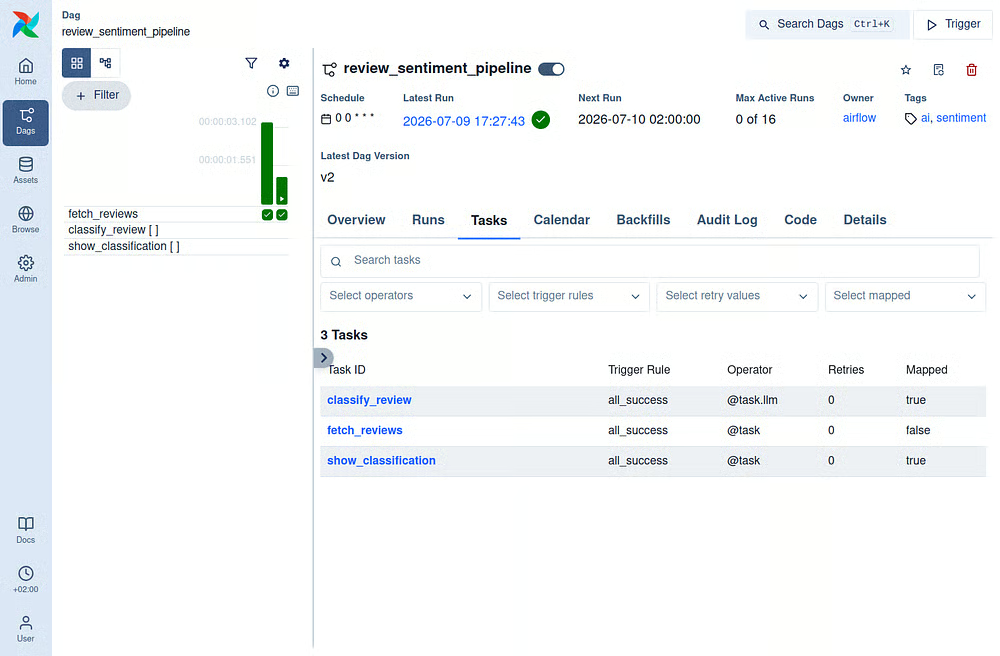
Tampilan UI Airflow dari tiga tugas dalam DAG review_sentiment_pipeline kita.
Karena kita menggunakan dynamic task mapping, Airflow mengirim satu permintaan LLM per ulasan. Ini berguna karena setiap ulasan dilacak secara independen:
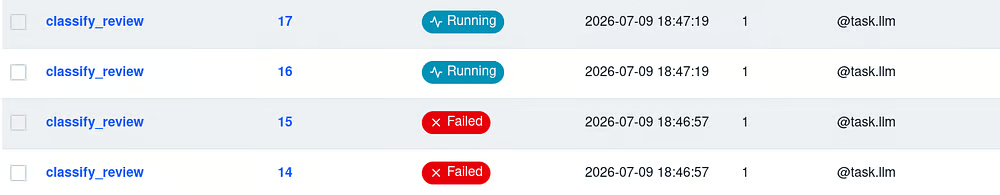
UI Airflow menampilkan ulasan yang diklasifikasikan secara independen. Beberapa tugas telah selesai atau gagal, sementara yang lain masih berjalan.
Permintaan LLM dapat gagal karena alasan seperti batas laju API, masalah jaringan, atau timeout model.
Alih-alih segera menggagalkan seluruh pipeline, kita dapat meminta Airflow mencoba ulang tugas yang terdampak secara otomatis.
Mari tambahkan fitur ini!
from datetime import timedelta

@task.llm(
   llm_conn_id="pydanticai_default",
   system_prompt=(
       "Classify the customer review as positive, neutral, or negative. "
       "Use both the written review and the star rating as context. "
       "Return the review ID and sentiment."
   ),
   output_type=ReviewClassification,
   serialize_output=True,
   retries=3,
   retry_delay=timedelta(seconds=30),
   retry_exponential_backoff=True,
   max_retry_delay=timedelta(minutes=5),
)
Di sini, retries=3 mengizinkan hingga tiga percobaan tambahan setelah kegagalan pertama.
Retry pertama menunggu 30 detik, dan exponential backoff meningkatkan jeda antara percobaan selanjutnya, hingga maksimum lima menit.
Bagian terbaiknya adalah Airflow hanya mencoba ulang tugas yang gagal dan terpetakan tersebut.
Jika 49 ulasan berhasil diklasifikasikan dan satu permintaan gagal, hanya ulasan yang gagal itu yang dijadwalkan untuk retry. Sisanya tidak perlu mengulang pekerjaan yang sudah berhasil.
Setelah beberapa waktu, klasifikasi ulasan yang gagal akan kembali dijadwalkan untuk retry:
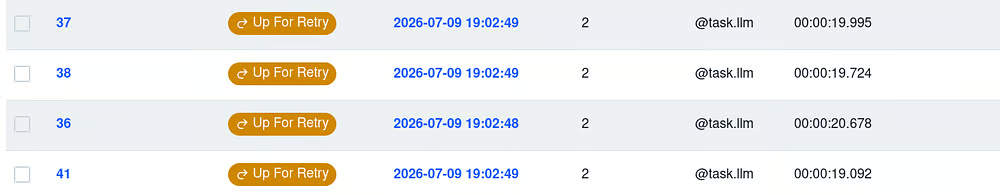
UI Airflow menampilkan semua tugas klasifikasi ulasan yang gagal menunggu untuk dicoba ulang.
Setelah klasifikasi ulasan berhasil, setiap instance tugas show_classification() yang terpetakan menampilkan respons model untuk satu ulasan pada log masing-masing.
Ini berarti langkah tampilan juga independen: Anda dapat membuka, memeriksa, atau men-debug output satu ulasan terlepas dari status ulasan lainnya.
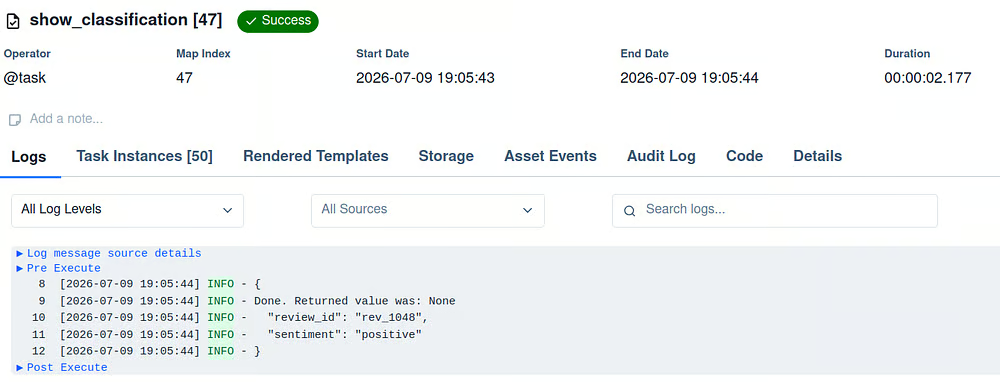
Tampilan UI Airflow untuk klasifikasi sentimen LLM pada ulasan 47.
Mencetak setiap klasifikasi berguna saat mengembangkan DAG karena memungkinkan kita dengan cepat memeriksa respons model di log Airflow.
Namun, log bukan tempat yang andal untuk menyimpan hasil pipeline. Log lebih sulit untuk diquery, digunakan ulang, dan diintegrasikan dengan sistem hilir.
Langkah terakhir adalah mengumpulkan klasifikasi dan menuliskannya ke output terstruktur.
Untuk artikel ini, kita akan menghapus pemanggilan show_classification() dan menyimpan hasilnya dalam berkas JSON lokal.
Dalam pipeline produksi, tugas ini biasanya menulis ke basis data, data warehouse, atau object store.
Salah satu implementasi yang mungkin untuk @task baru ini adalah:
OUTPUT_FILE = (
   Path.home()
   / "airflow"
   / "output"
   / "classified_reviews.json"
)

@task
def store_results(results: list[dict]) -> str:
   """Write all classified reviews to a local JSON file."""
   OUTPUT_FILE.parent.mkdir(parents=True, exist_ok=True)

   classifications = list(results)

   with OUTPUT_FILE.open("w", encoding="utf-8") as file:
       json.dump(
           classifications,
           file,
           indent=2,
           ensure_ascii=False,
       )

   print(
       f"Stored {len(classifications)} classifications "
       f"in {OUTPUT_FILE}"
   )

   return str(OUTPUT_FILE)
Tugas ini adalah langkah load kita.
Tugas ini mengambil klasifikasi yang dihasilkan LLM, membuat folder output jika perlu, dan menulis semuanya ke berkas JSON lokal.
Konversi kecil list(results) berguna karena klasifikasi berasal dari tugas yang terpetakan.
Airflow mengumpulkan output terpetakan tersebut untuk kita, dan tugas ini mengubahnya menjadi list biasa sebelum menyimpannya. Sekarang kita hanya perlu menghubungkan tugas di dalam DAG dengan memanggil store_results(classifications).
Dengan baris ini, Airflow tahu bahwa store_results() bergantung pada langkah klasifikasi. Dengan kata lain, berkas output ditulis hanya setelah semua klasifikasi ulasan selesai dengan sukses.
Dengan ketiga langkah terhubung, DAG lengkap sekarang mengambil ulasan, membuat satu tugas LLM untuk setiap ulasan, dan menyimpan hasil gabungannya.
Di dalam fungsi DAG, pipeline terlihat seperti ini:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
def review_sentiment_pipeline():
   reviews = fetch_reviews()
   classifications = classify_review.expand(
       review=reviews
   )
   store_results(classifications)

review_sentiment_pipeline()
Setelah Anda menyimpan berkas, Airflow akan membutuhkan beberapa detik untuk mem-parsing dan menemukan DAG lengkapnya. Setelah review_sentiment_pipeline muncul dalam daftar DAG, aktifkan dengan toggle dan klik Trigger untuk memulai run manual.
Ini memungkinkan kita menguji pipeline penuh segera, tanpa menunggu run harian terjadwal berikutnya. Setelah run berhasil, berkas JSON final akan tersedia secara lokal di ~/airflow/output/classified_reviews.json.
Berkas JSON output adalah output tahan lama dari alur kerja, yang dapat digunakan kembali di luar DAG atau diteruskan ke sistem hilir nanti.
Sebaliknya, UI Airflow memberi kita tampilan operasional dari pipeline: tugas mana yang berjalan, mana yang gagal atau berhasil, dan di mana memeriksa log.
Pipeline final ditampilkan di bawah ini:
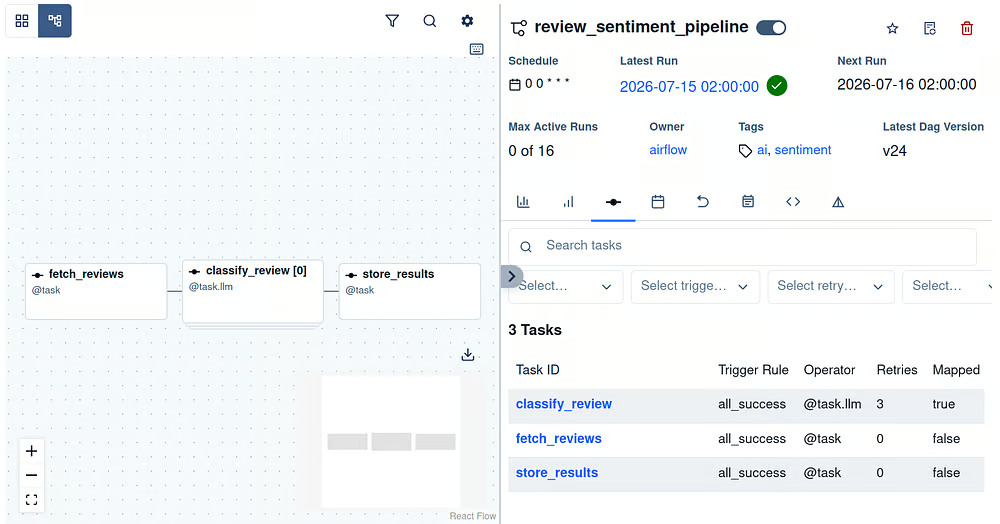
Tampilan UI Airflow dari tiga tugas dalam pipeline kita. Panel kanan bawah menampilkan properti setiap tugas, termasuk nama, aturan pemicu, operator atau dekorator, dan jumlah retry.
Akhirnya, dalam beberapa hari ke depan, UI Airflow akan mulai terisi dengan run harian otomatis, memberi kita riwayat yang jelas tentang kapan pipeline berjalan dan apakah setiap eksekusi berhasil:
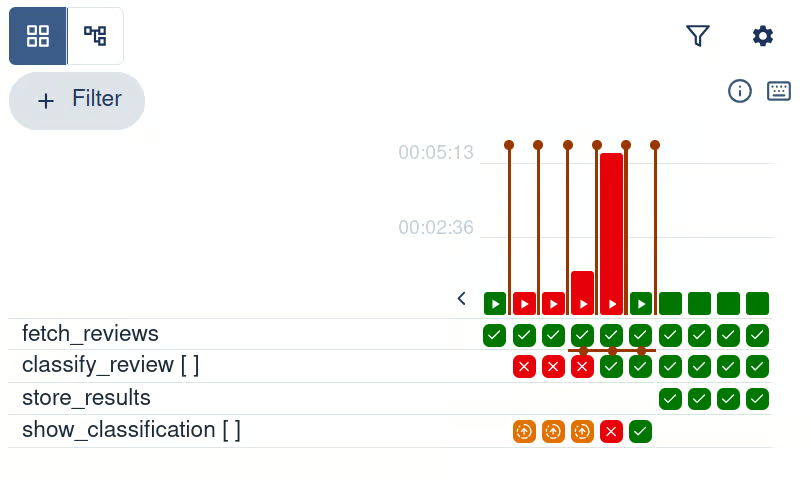
Tampilan UI Airflow dari run pipeline dan statusnya. Setelah Langkah 3, pipeline berhenti menggunakan show_classification dan menjalankan store_results sebagai gantinya.
Pipeline kita sekarang mengambil ulasan, mengklasifikasikannya dengan LLM, dan menyimpan hasilnya dalam jadwal harian.
Airflow 3 juga mendukung pola yang lebih canggih yang dapat membuat alur kerja AI lebih responsif dan lebih mudah diawasi.
Alih-alih menjalankan pipeline pada waktu tertentu setiap hari, Airflow dapat memulainya ketika terjadi peristiwa eksternal.
Misalnya, pipeline ulasan dapat berjalan setiap kali berkas ulasan baru diunggah ke object storage atau sebuah pesan tiba di antrian.
Airflow 3 mendukung penjadwalan berbasis peristiwa melalui aset dan trigger yang kompatibel dengan peristiwa. Ini menghilangkan kebutuhan untuk berulang kali memeriksa data baru dan memungkinkan pipeline bereaksi segera setelah suatu peristiwa terdeteksi.
Tidak setiap keputusan model harus diterima secara otomatis.
Beberapa ulasan mungkin ambigu, sensitif, atau memerlukan penilaian manusia. Operator human-in-the-loop Airflow dapat menjeda alur kerja yang berjalan dan meminta masukan melalui antarmuka Airflow.
Seorang reviewer dapat menyetujui atau menolak hasil, memberikan informasi, atau memilih cabang alur kerja mana yang harus dilanjutkan.
Common AI provider juga mendukung pola peninjauan interaktif untuk alur kerja agentic, di mana seorang reviewer dapat menyetujui, menolak, atau meminta perubahan pada hasil yang dihasilkan LLM.
Bersama-sama, penjadwalan berbasis peristiwa dan tinjauan manusia memungkinkan pembuatan pipeline AI yang bereaksi cepat tanpa menghilangkan pengawasan manusia di tempat yang penting.
Untuk mempelajari lebih lanjut tentang fitur Airflow 3.0, saya sarankan melihat panduan terpisah kami.
Dalam artikel ini, kita membangun pipeline AI lengkap dengan Apache Airflow.
Pipeline ini mengambil ulasan pelanggan, mengklasifikasikan setiap ulasan dengan LLM, dan menyimpan hasil akhir dalam berkas JSON terstruktur.
Sepanjang jalan, kita melihat bagaimana Airflow mengubah fungsi Python menjadi tugas terjadwal yang dapat diobservasi. Ini sangat berguna untuk alur kerja AI, di mana batas API, timeout model, dan output tak terduga bisa terjadi.
Dengan dependensi tugas, dynamic task mapping, retry, log, dan UI Airflow, kita dapat membuat pipeline AI lebih mudah dipantau, di-debug, dan dipulihkan.
Contoh ini menggunakan berkas lokal agar tetap sederhana, tetapi struktur yang sama dapat diperluas ke API, basis data, alur kerja berbasis peristiwa, dan tinjauan human-in-the-loop.
Jika Anda siap untuk terus mengeksplorasi, saya sarankan mulai dengan kursus Pengantar Apache Airflow dalam Python kami, lalu lanjutkan ke Membangun Data Pipeline dengan Airflow untuk praktik yang lebih mendalam.
Untuk jalur belajar yang lebih luas, Data Engineer in Python mencakup serangkaian keterampilan yang lebih luas untuk membangun dan mengelola data pipeline produksi.
Kursus Teratas DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt




