
कोर्स
Python में Apache Airflow परिचय
4 घंटा
64.9K
AI प्रोटोटाइप शुरू करना आसान है। एक नोटबुक, एक API कुंजी, और कुछ Python लाइनों से ही टेक्स्ट को वर्गीकृत करना, दस्तावेज़ों का सारांश बनाना, या अनुशंसाएँ जनरेट करना संभव हो जाता है।
हालाँकि, उस प्रोटोटाइप को हर दिन भरोसेमंद तरीके से चलाए रखना एक अलग चुनौती है।
क्या होता है जब मॉडल API अपनी दर सीमा तक पहुँच जाती है? यदि कोई अनुरोध टाइमआउट हो जाए, आउटपुट अपेक्षित फ़ॉर्मेट का न हो, या डाउनस्ट्रीम डेटाबेस अस्थायी रूप से अनुपलब्ध हो तो?
जैसे-जैसे AI पाइपलाइन एक आवर्ती वर्कफ़्लो बनती है, विश्वसनीयता, मॉनिटरिंग, और रिकवरी उतने ही महत्वपूर्ण हो जाते हैं जितना कि स्वयं मॉडल।
इस लेख में, मैं आपको Apache Airflow के साथ एक सम्पूर्ण AI पाइपलाइन बनाना दिखाऊँगा—यह वर्कफ़्लो विकसित करने, शेड्यूल करने और मॉनिटर करने के लिए एक मुक्त स्रोत प्लेटफ़ॉर्म है।
हमारी पाइपलाइन रोज़ चलेगी, ग्राहक समीक्षाएँ लाएगी, एक बड़े भाषा मॉडल (LLM) से उनकी भावनाओं का वर्गीकरण करेगी, और परिणामों को संग्रहीत करेगी—यह सब एक ही वर्कफ़्लो में भरोसेमंद ढंग से!
Jupyter नोटबुक प्रयोग के लिए बेहतरीन है। हम सब विचार जाँचने, त्वरित कोड लिखने, और चलते-चलते परिणाम विज़ुअलाइज़ करने के लिए नोटबुक पसंद करते हैं।
एक क्रॉन जॉब अक्सर हर रात एक साधारण स्क्रिप्ट चलाने के लिए काफ़ी होता है। सच कहें तो, कई स्क्रिप्ट हफ्तों तक मैन्युअल रूप से चलाई जाती हैं, इससे पहले कि कोई उन्हें ठीक से शेड्यूल करे।
समस्या तब शुरू होती है जब एक स्क्रिप्ट कई स्क्रिप्ट्स में बदल जाती है, और वे स्क्रिप्ट्स एक-दूसरे पर निर्भर होने लगती हैं। उस बिंदु पर, हमारे पास अब एक स्टैंडअलोन प्रोग्राम नहीं रहता: हमारे पास एक वर्कफ़्लो होता है।
न तो नोटबुक और न ही क्रॉन जॉब्स जटिल वर्कफ़्लोज़ को भरोसेमंद ढंग से प्रबंधित करने के लिए डिज़ाइन किए गए हैं।
निर्भरताएँ अक्सर कोड के अंदर छिपी रहती हैं, विफलताओं के लिए मैन्युअल जाँच करनी पड़ती है, और पाइपलाइन को फिर से चलाने का मतलब पहले से सफलतापूर्वक पूरी हो चुकी स्टेप्स को भी दोहराना हो सकता है।
हम इनमें से कुछ जटिलताओं का सामना पारंपरिक Extract-Transform-Load (ETL) पाइपलाइनों में पहले से करते हैं। ETL वर्कफ़्लोज़ को डेटा प्राप्त करना, उसे ट्रांसफ़ॉर्म करना, वैलिडेट करना, और किसी अन्य सिस्टम में लोड करना पड़ सकता है।
भले ही इनपुट और ट्रांसफ़ॉर्मेशन पूर्वानुमेय हों, हर अतिरिक्त स्टेप एक और संभावित विफलता बिंदु जोड़ देता है। आजकल, AI पाइपलाइनें इस चुनौती को और भी अधिक रेखांकित करती हैं।
यदि आप विशेष रूप से ETL पाइपलाइनों में रुचि रखते हैं, तो मैं Airflow में ETL पाइपलाइनों पर इस कोर्स की सिफारिश करता/करती हूँ।
एक सामान्य AI वर्कफ़्लो पर विचार करें: डेटा एकत्र करना, उसे साफ़ करना, एक मॉडल API को कॉल करना, प्रतिक्रिया को वैलिडेट करना, परिणाम संग्रहीत करना, और कुछ गड़बड़ होने पर किसी को सूचित करना।
हर स्टेप पिछले पर निर्भर करता है, और हर एक अलग तरीके से विफल हो सकता है: कोई API रेट-लिमिट त्रुटि दे सकती है। कोई मॉडल अनुरोध टाइमआउट हो सकता है। कोई जनरेटेड प्रतिक्रिया मान्य JSON हो सकती है लेकिन फिर भी क्वालिटी चेक में फेल हो सकती है।
आउटपुट अधूरे, असंगत, या अगले स्टेप की अपेक्षा के अनुरूप फ़ॉर्मेट में न भी हो सकते हैं।
Airflow इन विफलताओं को समाप्त नहीं करता, लेकिन उन्हें संभालना आसान बना देता है।
Airflow के साथ, LLM को कॉल करने वाला कोई टास्क अस्थायी रेट-लिमिट प्रतिक्रिया के बाद डेटा-इंजेशन स्टेप को फिर से चलाए बिना रिट्राई कर सकता है। कोई वैलिडेशन टास्क गलत फ़ॉर्मेट या कम-गुणवत्ता वाले परिणाम को प्रोडक्शन तक पहुँचने से पहले ही अस्वीकार कर सकता है। अलर्ट्स टीम को तभी सूचित कर सकते हैं जब कॉन्फ़िगर किए गए सभी रिट्राई प्रयास समाप्त हो जाएँ।
Airflow यह काम वर्कफ़्लो को एक डायरेक्टेड एसीक्लिक ग्राफ़ (DAG) के रूप में प्रस्तुत करके संभव बनाता है।
पूरी पाइपलाइन को एक लंबी स्क्रिप्ट के अंदर छिपाने के बजाय, एक DAG हर ऑपरेशन को अलग टास्क के रूप में परिभाषित करता है—स्पष्ट निर्भरताओं, रिट्राई नीतियों, लॉग्स, और निष्पादन स्थिति के साथ।
यही मुख्य कारण है कि Airflow AI पाइपलाइनों के लिए बेहतरीन बैठता है: यह विफलताओं को वर्कफ़्लो का अपेक्षित हिस्सा मानता है, न कि कोई अप्रत्याशित अपवाद।
जैसे-जैसे कोई प्रयोग आवर्ती प्रोडक्शन प्रक्रिया में बदलता है, Airflow वह ऑर्केस्ट्रेशन लेयर देता है जो उसे ऑब्ज़र्वेबल, रिकवर करने योग्य, और बनाए रखने में आसान बनाती है।
अपनी पाइपलाइन बनाना शुरू करने से पहले, आइए परिवेश सेट करें।
परिवेश सेट करने के लिए हमें तीन संक्षिप्त कदम उठाने होंगे।
इस ट्यूटोरियल के लिए, हम Airflow को लोकल रूप से चलाएँगे।
यह सेटअप सीखने और विकास के लिए सुविधाजनक है क्योंकि एक ही कमांड मेटाडेटा डेटाबेस को इनिशियलाइज़ कर देता है और Airflow के लिए आवश्यक सेवाएँ शुरू कर देता है।
सबसे पहले, Airflow और उसकी निर्भरताओं को आपकी शेष Python इंस्टॉलेशन से पृथक रखने के लिए एक वर्चुअल एनवायरनमेंट बनाएँ और सक्रिय करें:
python3 -m venv ~/airflow-venv
source ~/airflow-venv/bin/activate
अब, हमें संस्करण पिनिंग और आधिकारिक कंस्ट्रेंट्स फ़ाइल का उपयोग करते हुए Airflow 3 इंस्टॉल करना है:
AIRFLOW_VERSION=3.3.0
PYTHON_VERSION="$(python -c 'import sys; print(f"{sys.version_info.major}.{sys.version_info.minor}")')"

CONSTRAINT_URL="https://raw.githubusercontent.com/apache/airflow/constraints-${AIRFLOW_VERSION}/constraints-${PYTHON_VERSION}.txt"

pip install "apache-airflow==${AIRFLOW_VERSION}" \
 --constraint "${CONSTRAINT_URL}"
ध्यान दें कि Airflow कई Python पैकेजों पर निर्भर करता है, और उन पैकेजों की अपनी निर्भरताएँ होती हैं। कंस्ट्रेंट्स फ़ाइल के बिना, pip नए या असंगत पैकेज संस्करण चुन सकता है।
इंस्टॉलेशन ऊपर-ऊपर ठीक लगता है, लेकिन बाद में Airflow प्रोवाइडर्स इम्पोर्ट करते समय, सेवाएँ शुरू करते समय, या टास्क चलाते समय फेल हो सकता है। Airflow के आधिकारिक इंस्टॉलेशन गाइड में ज्ञात-संगत निर्भरताएँ इंस्टॉल करने के लिए कंस्ट्रेंट्स फ़ाइलें उपयोग करने की सिफारिश की गई है।
क्योंकि हमारा वर्कफ़्लो LLM को कॉल करेगा, हमें Airflow के Common AI प्रोवाइडर और Pydantic AI के लिए OpenAI निर्भरता की भी ज़रूरत होगी:
pip install \
 "apache-airflow-providers-common-ai" \
 "pydantic-ai-slim[openai]"
अगला कदम OpenAI कनेक्शन कॉन्फ़िगर करना है। Airflow कनेक्शनों का उपयोग क्रेडेंशियल्स और कनेक्शन सेटिंग्स को DAG कोड के बाहर स्टोर करने के लिए करता है। इससे Python फ़ाइल साफ़ रहती है और पाइपलाइन में सीक्रेट्स हार्ड-कोड करने से बचा जा सकता है।
इंस्टॉलेशन वैध कर लेने के बाद, अब मॉडल के साथ वास्तविक संचार के लिए OpenAI कुंजी सेट करने का समय है। ऐसा करने के कई विकल्प हैं।
मेरा पसंदीदा विकल्प यह है:
export OPENAI_API_KEY="your-openai-api-key"airflow connections add pydanticai_default \
--conn-type pydanticai \
--conn-password "$OPENAI_API_KEY" \
--conn-extra '{"model":"openai:gpt-4o-mini"}'Common AI प्रोवाइडर,
pydanticai कनेक्शन प्रकार का उपयोग करता है ताकि Pydantic AI के माध्यम से LLM प्रोवाइडर्स से संचार किया जा सके।
यह कमांड कनेक्शन को Airflow के मेटाडेटा डेटाबेस में स्टोर कर देता है, इसलिए इसके बाद आपको .env फ़ाइल रखने या Airflow हर बार शुरू करते समय कुंजी फिर से पास करने की ज़रूरत नहीं है।
airflow standaloneजब तक Airflow चल रहा है, इस टर्मिनल को खुला रखें। स्टैंडअलोन मोड लोकल विकास और ट्यूटोरियल्स के लिए आदर्श है, लेकिन प्रोडक्शन डिप्लॉयमेंट्स के लिए अभिप्रेत नहीं है।
Airflow इंटरफ़ेस तक पहुँचने के लिए, अब हम ब्राउज़र में http://localhost:8080 खोल सकते हैं। सबसे पहले हमें लॉगिन पेज दिखेगा। लेकिन उपयोगकर्ता नाम और पासवर्ड क्या होना चाहिए?
Apache Airflow का लॉगिन दृश्य।
जब Airflow स्टैंडअलोन मोड में शुरू होता है, तो यह लॉगिन क्रेडेंशियल्स स्वचालित रूप से जेनरेट करता है। उपयोगकर्ता नाम और पासवर्ड टर्मिनल आउटपुट में प्रिंट होते हैं और $AIRFLOW_HOME/simple_auth_manager_passwords.json.generated में भी स्टोर होते हैं।
डिफ़ॉल्ट रूप से, AIRFLOW_HOME is ~/airflow, इसलिए हम यह कमांड चलाकर क्रेडेंशियल्स प्राप्त कर सकते हैं:
cat ~/airflow/simple_auth_manager_passwords.json.generatedआख़िरकार, ये क्रेडेंशियल्स हमें Airflow इंटरफ़ेस में लॉगिन करने देंगे।
लॉगिन करने के बाद, Airflow होम पेज पर खुलता है। यह दृश्य आपके लोकल Airflow परिवेश का त्वरित अवलोकन देता है।
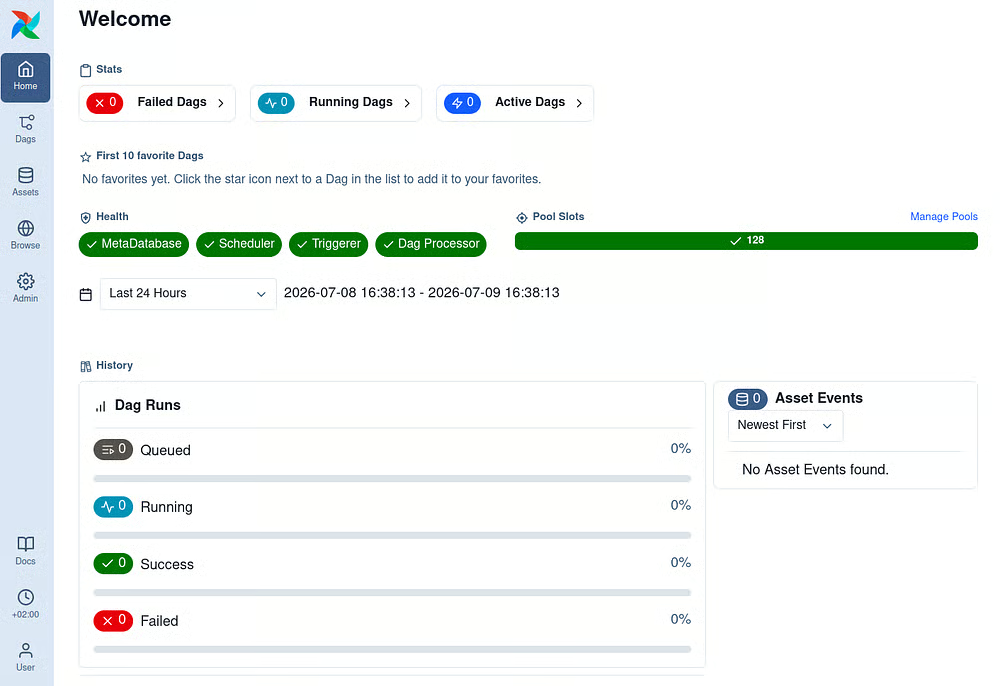
पहली बार लॉगिन के बाद Airflow UI दृश्य।
ऊपर की ओर, स्टैट्स कार्ड्स आपके DAGs की वर्तमान स्थिति का सारांश देते हैं, जिनमें विफल, चल रहे, और सक्रिय वर्कफ़्लो शामिल हैं।
क्योंकि हमने अभी अपनी पाइपलाइन नहीं बनाई है, ये मान अभी भी शून्य हो सकते हैं।
हेल्थ सेक्शन दिखाता है कि क्या मुख्य Airflow सेवाएँ चल रही हैं।
नीचे, पूल स्लॉट्स बार उपलब्ध निष्पादन क्षमता दिखाता है। हम इस लेख में कस्टम पूल्स कॉन्फ़िगर नहीं करेंगे, लेकिन साथ-साथ चलने वाले टास्क्स की संख्या नियंत्रित करने में यह क्षेत्र उपयोगी होता है।
अंत में, हिस्ट्री सेक्शन हाल के DAG रन का सारांश देता है। जैसे ही हम अपनी समीक्षा-भावना पाइपलाइन ट्रिगर करेंगे, यह क्षेत्र कतारबद्ध, चल रहे, सफल, और विफल रन दिखाना शुरू कर देगा।
अब जबकि Airflow चल रहा है, आइए अपनी पाइपलाइन के लिए आवश्यक फ़ाइलें बनाएँ:
mkdir -p ~/airflow/dags
touch ~/airflow/dags/review_sentiment_pipeline.py
touch ~/airflow/requirements.txt
लोकल स्टैंडअलोन इंस्टॉलेशन में, Airflow डिफ़ॉल्ट रूप से ~/airflow को AIRFLOW_HOME के रूप में उपयोग करता है। हम अपनी DAG फ़ाइल को dags डायरेक्टरी में रखेंगे और प्रोजेक्ट निर्भरताओं का दस्तावेज़ रखने के लिए एक requirements.txt फ़ाइल रखेंगे।
इस प्रकार, प्रोजेक्ट की संरचना निम्न होगी:
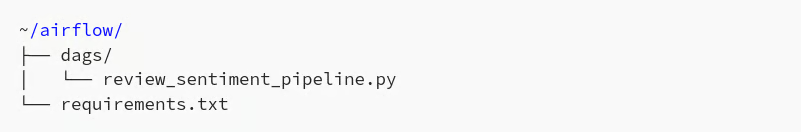
न्यूनतम Airflow प्रोजेक्ट संरचना।
eview_sentiment_pipeline.py फ़ाइल में वर्कफ़्लो परिभाषा होगी, जिसमें समीक्षाएँ लाने, उनकी भावना का वर्गीकरण करने, और परिणाम संग्रहीत करने के टास्क शामिल होंगे।
Airflow कॉन्फ़िगर की गई dags डायरेक्टरी की निगरानी करता है और Python फ़ाइलों के भीतर मान्य DAG परिभाषाएँ ढूँढता है। जैसे ही हमारी फ़ाइल में कोई मान्य DAG होगा, वर्कफ़्लो Airflow UI के Dags पेज पर दिखाई देगा।
यदि आपको ऑनबोर्डिंग में कुछ दिक्कत आ रही है, तो मैं Getting Started with Apache Airflow ट्यूटोरियल देखने का सुझाव देता/देती हूँ। .
Airflow के साथ हाथ-से-हाथ काम शुरू करने के लिए, हम एक दैनिक जॉब बनाएँगे जो ग्राहक समीक्षाएँ प्रोसेस करता है और उनकी भावना का वर्गीकरण करता है।
कल्पना करें कि हमने अभी-अभी एक ई-कॉमर्स प्लेटफ़ॉर्म बनाया है। ग्राहक पहले से समीक्षाएँ दे रहे हैं, और हम उन्हें हर दिन स्वचालित रूप से विश्लेषित करना चाहते हैं।
मैन्युअल रूप से स्क्रिप्ट चलाने के बजाय, हम Airflow का उपयोग करके वर्कफ़्लो का ऑर्केस्ट्रेशन कर सकते हैं।
मान लें कि कच्ची समीक्षाएँ किसी .jsonl फ़ाइल में स्टोर हैं।
हर पंक्ति में एक समीक्षा JSON ऑब्जेक्ट के रूप में होती है, और दिन भर में नई समीक्षाएँ फ़ाइल के अंत में जोड़ दी जाती हैं। प्रोडक्शन सिस्टम में, यह डेटा किसी API, डेटाबेस, ऑब्जेक्ट स्टोर, या मैसेज क्यू से आ सकता है। इस ट्यूटोरियल के लिए, JSONL फ़ाइल हमें कच्चे समीक्षा डेटा का सरल और वास्तविक स्रोत देती है।
इस परिदृश्य में, पाइपलाइन का पहला कदम उन समीक्षाओं को Airflow में लोड करना है। हम एक सामान्य Python फ़ंक्शन से शुरू करते हैं, जैसे हम किसी नोटबुक या स्क्रिप्ट में करते:
REVIEWS_FILE = Path.home() / "airflow" / "data" / "reviews.jsonl"

def fetch_reviews() -> list[dict]:
   """Load raw customer reviews from the JSONL landing file."""
   reviews = []

   with REVIEWS_FILE.open("r", encoding="utf-8") as file:
       for line_number, line in enumerate(file, start=1):
           if not line.strip():
               continue

           try:
               reviews.append(json.loads(line))
           except json.JSONDecodeError as error:
               raise ValueError(
                   f"Invalid JSON on line {line_number}"
               ) from error

   print(f"Fetched {len(reviews)} reviews")
   return reviews
यह फ़ंक्शन JSONL फ़ाइल खोलता है, उसे पंक्ति-दर-पंक्ति पढ़ता है, खाली पंक्तियाँ छोड़ देता है, और हर JSON ऑब्जेक्ट को Python डिक्शनरी में बदल देता है।
यदि किसी पंक्ति में अमान्य JSON हो, तो टास्क उस पंक्ति संख्या के साथ स्पष्ट त्रुटि संदेश देकर फेल हो जाता है।
अब तक यह शुद्ध Python है। अगला कदम इसे Airflow टास्क में बदलना और किसी DAG के भीतर रखना है।
फ़ंक्शन को Airflow वर्कफ़्लो का हिस्सा बनाने के लिए, हमें तीन चीज़ें चाहिए:
@task से सजाते हैं। यह Airflow को बताता है कि यह फ़ंक्शन एक टास्क है।@dag से एक DAG परिभाषित करते हैं। DAG वर्कफ़्लो को नाम, शेड्यूल, प्रारंभ तिथि, और अन्य कॉन्फ़िगरेशन देता है।यह न्यूनतम संस्करण है:
from airflow.sdk import dag

@dag(    fetch_reviews()
   dag_id="fetch_reviews_pipeline",
)

def fetch_reviews_pipeline():
   fetch_reviews()

fetch_reviews_pipeline()
ध्यान दें कि यह DAG अभी स्वतः निष्पादित नहीं होगा।
जैसा लिखा है, हमें इसे Airflow UI से मैन्युअल रूप से ट्रिगर करना होगा। वर्कफ़्लो कब चलना चाहिए, यह कॉन्फ़िगर करने के लिए हम DAG परिभाषा में शेड्यूलिंग पैरामीटर्स जोड़ सकते हैं। एक संभावित विकल्प है:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
आइए इसे समझते हैं!
dag_id Airflow में DAG को एक अद्वितीय नाम देता है।schedule="@daily" DAG को रोज़ एक बार चलाता है।start_date बताता है कि शेड्यूलिंग कब से शुरू हो सकती है।catchup=False Airflow को पिछली तिथियों के लिए रन बनाने से रोकता है।tags Airflow UI में DAG को व्यवस्थित और फ़िल्टर करने में मदद करते हैं।एक बार DAG परिभाषित हो जाने के बाद, हम UI पर जाकर देख सकते हैं कि यह व्यवहार में कैसा दिखता है:
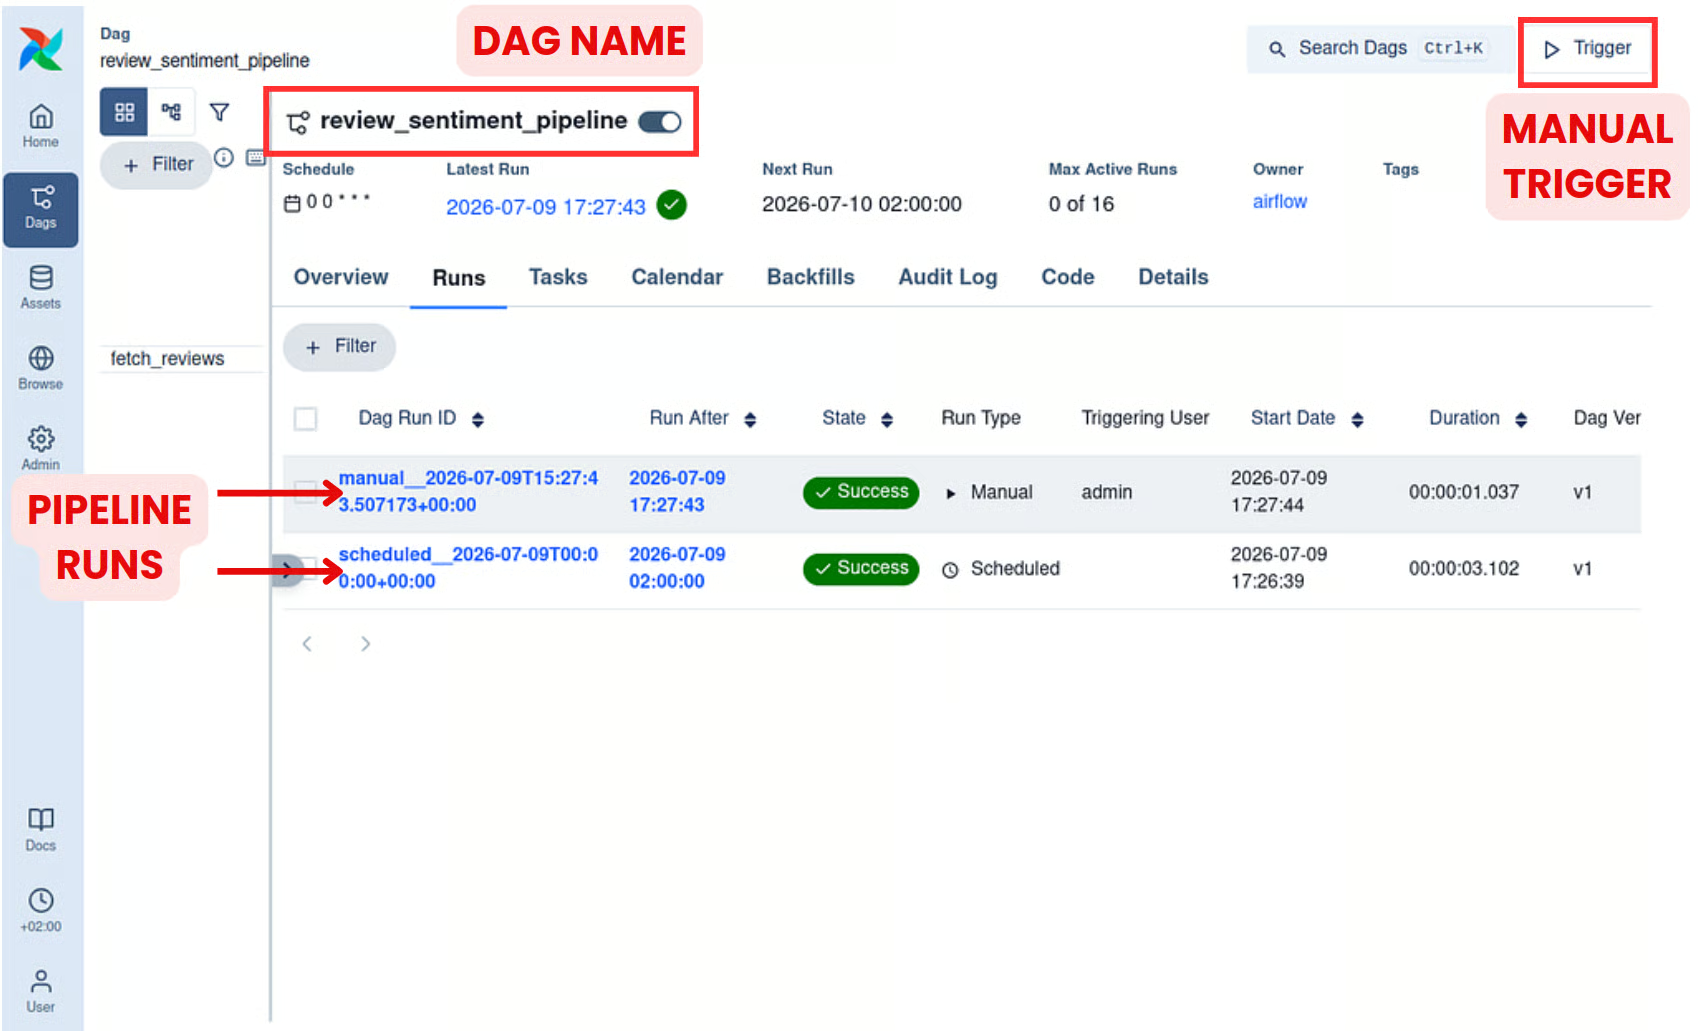
हमारी पाइपलाइन review_sentiment_pipeline का Airflow UI दृश्य। अनुसूचित और मैन्युअल—दो तरह के रन और ऊपर-दाएँ कोने में मैन्युअल Trigger बटन पर ध्यान दें।
UI में, हम देख सकते हैं कि Airflow ने स्वतः review_sentiment_pipeline नाम का DAG खोज लिया है।
हम यह भी देख सकते हैं कि यह अपने शेड्यूल के अनुसार चला, और हमने इंटरफ़ेस के ऊपर-दाएँ कोने में Trigger बटन का उपयोग करके एक अतिरिक्त मैन्युअल रन भी ट्रिगर किया।
एक अच्छी सुविधा कैलेंडर-शैली का दृश्य है, जहाँ Airflow पाइपलाइन रन को हर रन की स्थिति के साथ लॉग करता है:
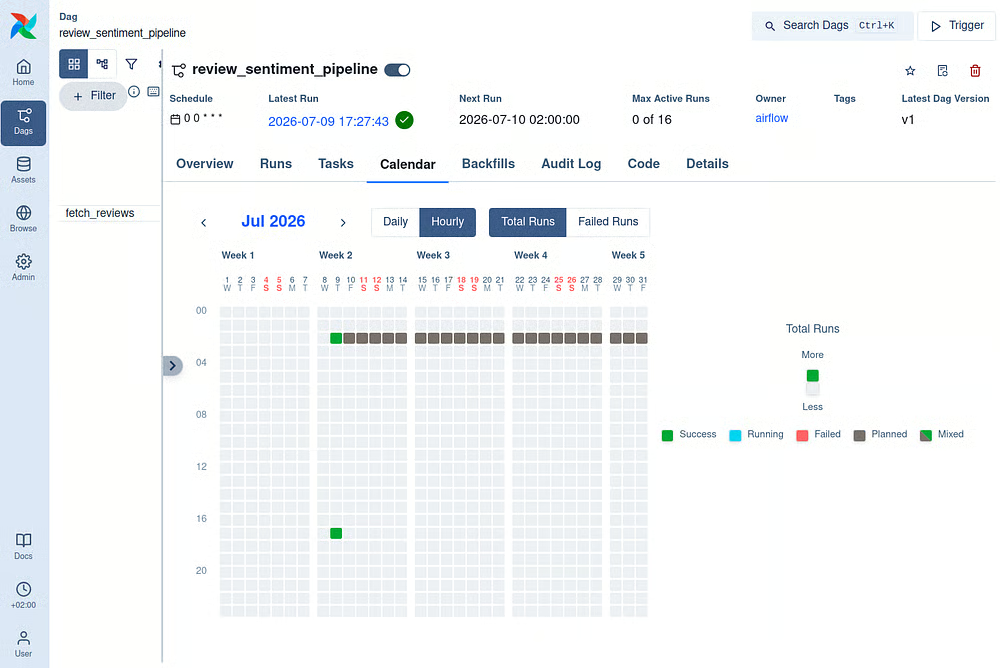
अनुसूचित और मैन्युअल दोनों रनों के साथ हमारी Airflow पाइपलाइन का कैलेंडर दृश्य।
चाहें तो यहाँ लेख को रोककर Airflow UI का अन्वेषण करें!
समीक्षाएँ लोड हो जाने के बाद, अगला कदम उनकी भावना का वर्गीकरण करना है। इसके लिए, हम @task.llm का उपयोग करेंगे—यह डेकोरेटर किसी LLM कॉल को एक नेटिव Airflow टास्क में बदल देता है।
हम किसी सामान्य @task के अंदर OpenAI API को मैन्युअल रूप से भी कॉल कर सकते थे, लेकिन @task.llm हमें अधिक साफ़-सुथरा इंटीग्रेशन देता है।
यह मॉडल कनेक्शन, सिस्टम प्रॉम्प्ट, स्ट्रक्चर्ड आउटपुट, और परिणाम सीरियलाइज़ेशन जैसे LLM-विशिष्ट विवरण संभालता है। साथ ही, टास्क अभी भी रिट्राई, लॉगिंग, मॉनिटरिंग, और निर्भरता प्रबंधन जैसे मानक Airflow फ़ीचर्स का लाभ उठाता है।
इस दूसरे कदम में सटीक टास्क से कुछ ज़्यादा हिस्से हैं, तो आइए इसे क्रम से बनाएँ:
from typing import Literal
from pydantic import BaseModel

class ReviewClassification(BaseModel):
   """Structured result returned by the LLM."""

   review_id: str
   sentiment: Literal["positive", "neutral", "negative"]
यह LLM टास्क को बताता है कि हर प्रतिक्रिया में समीक्षा ID और तीन लेबलों में से एक भावना होनी चाहिए: positive, neutral, या negative।
@task.llm(
   llm_conn_id="pydanticai_default",
   system_prompt=(
       "Classify the customer review as positive, neutral, or negative. "
       "Use both the written review and the star rating as context. "
       "Return the review ID and sentiment."
   ),
   output_type=ReviewClassification,
   serialize_output=True,
   retries=3,
)
def classify_review(review: dict) -> str:
   """Build the prompt sent to the LLM."""
   return (
       f"Review ID: {review['review_id']}\n"
       f"Product: {review['product']}\n"
       f"Rating: {review['rating']} out of 5 stars\n"
       f"Review: {review['review_text']}"
   )
फ़ंक्शन बॉडी एक स्ट्रिंग प्रॉम्प्ट लौटाती है, जबकि @task.llm डेकोरेटर उसे हमारे पहले से कॉन्फ़िगर किए गए pydanticai_default कनेक्शन का उपयोग करके मॉडल को भेज देता है।
system_prompt मॉडल को निर्देश देता है, जबकि output_type=ReviewClassification एक स्ट्रक्चर्ड प्रतिक्रिया माँगता है। हम serialize_output=True भी सेट करते हैं ताकि Airflow परिणाम को सादी डिक्शनरी के रूप में स्टोर करे—जिससे उसे डाउनस्ट्रीम टास्क्स को पास करना आसान हो जाता है।
LLM इन्फ़रेंस की ज़रूरत वाले टास्क्स में रुचि है? अधिक विशिष्ट अनुप्रयोगों के लिए यह LangChain कोर्स देखें!
वर्गीकरण टास्क एक स्ट्रक्चर्ड परिणाम लौटाता है, लेकिन विकास के दौरान यह उपयोगी है कि हम अंतिम स्टोरेज स्टेप तक इंतज़ार किए बिना देखें कि मॉडल ने क्या उत्पन्न किया।
वास्तव में, किसी पाइपलाइन स्टेप में एक से अधिक Airflow टास्क हो सकते हैं।
इस मामले में, हम एक छोटा टास्क जोड़ेंगे जो हर वर्गीकरण को Airflow लॉग्स में प्रिंट कर देगा:
@task
def show_classification(classification: dict) -> dict:
   """Print one model classification to the Airflow task logs."""
   print(
       f"Review {classification['review_id']}: "
       f"{classification['sentiment']}"
   )

   return classification
यह टास्क परिणाम को नहीं बदलता। यह केवल मॉडल आउटपुट को लॉग करता है और वही डिक्शनरी लौटाता है, ताकि वर्गीकरण पाइपलाइन के अगले स्टेप को पास किया जा सके।
3. अंत में, हमें नए टास्क्स को DAG फ़ंक्शन के अंदर जोड़ना है:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
def review_sentiment_pipeline():
   reviews = fetch_reviews()

   classifications = classify_review.expand(
       review=reviews
   )

   displayed_classifications = show_classification.expand(
       classification=classifications
   )

review_sentiment_pipeline()नोट: इस पाइपलाइन में, हम .expand(review=reviews) के साथ डायनेमिक टास्क मैपिंग का उपयोग करते हैं। यह Airflow को बताता है कि हर समीक्षा के लिए एक classify_review टास्क इंस्टेंस बनाएँ—ताकि हर समीक्षा अलग-अलग अनुरोध में LLM को भेजी जाए।
यह प्रायः पूरी समीक्षा सूची को एक LLM टास्क को भेजने से बेहतर होता है। classify_reviews(reviews) जैसी कॉल सभी समीक्षाओं को साथ प्रोसेस करेगी, जिससे विफलताओं को डिबग करना कठिन, रिट्राई कम लक्षित, और बड़े इनपुट मॉडल कॉन्टेक्स्ट या API सीमाएँ हिट करने की अधिक संभावना वाला हो सकता है।
इस दूसरे कदम को पूरा करने से पहले, हम Airflow UI पर लौट सकते हैं और देख सकते हैं कि वर्कफ़्लो कैसे विकसित हुआ है।
इस समय, DAG में तीन टास्क हैं: fetch_reviews, classify_review, और show_classification :
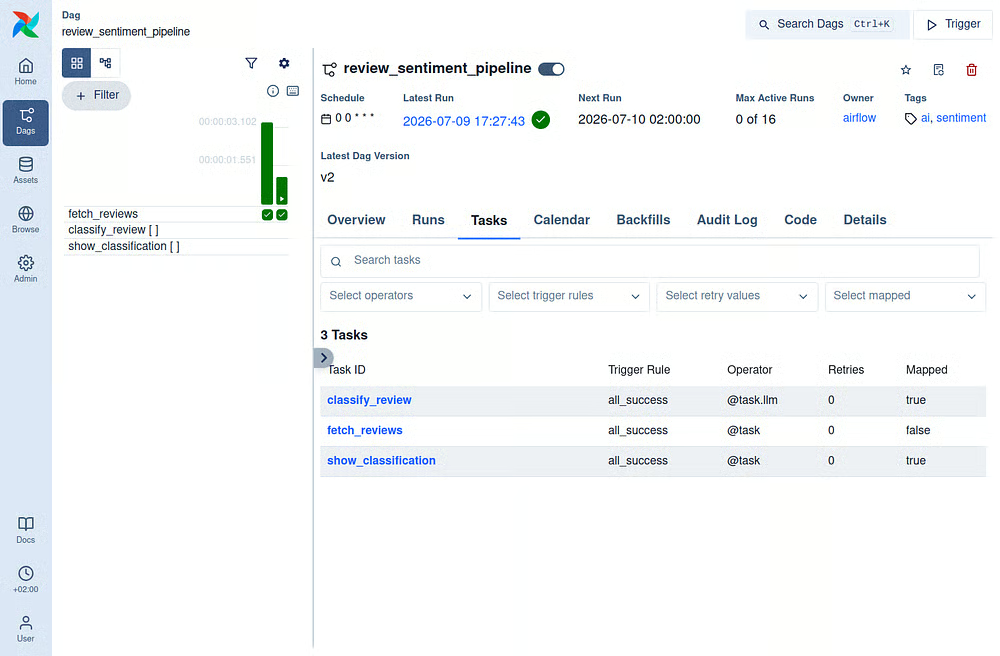
हमारे review_sentiment_pipeline DAG के तीन टास्क का Airflow UI दृश्य।
क्योंकि हमने डायनेमिक टास्क मैपिंग का उपयोग किया है, Airflow प्रति समीक्षा एक LLM अनुरोध भेजता है। यह उपयोगी है क्योंकि हर समीक्षा स्वतंत्र रूप से ट्रैक होती है:
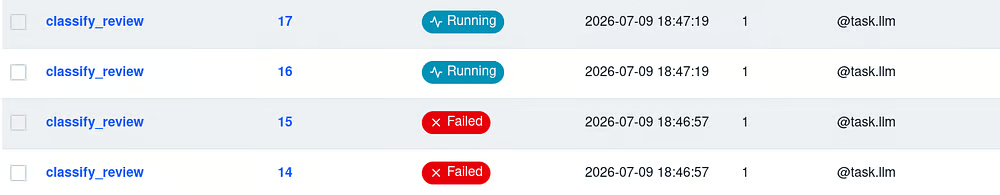
Airflow UI स्वतंत्र रूप से वर्गीकृत होती समीक्षाएँ दिखा रहा है। कुछ टास्क पूरे हो चुके या विफल हो चुके हैं, जबकि अन्य अभी भी चल रहे हैं।
LLM अनुरोध API रेट-लिमिट, नेटवर्क समस्याओं, या मॉडल टाइमआउट जैसे कारणों से फेल हो सकते हैं।
पूरी पाइपलाइन को तुरंत विफल करने के बजाय, हम Airflow से प्रभावित टास्क को स्वतः रिट्राई करने के लिए कह सकते हैं।
आइए यह सुविधा जोड़ें!
from datetime import timedelta

@task.llm(
   llm_conn_id="pydanticai_default",
   system_prompt=(
       "Classify the customer review as positive, neutral, or negative. "
       "Use both the written review and the star rating as context. "
       "Return the review ID and sentiment."
   ),
   output_type=ReviewClassification,
   serialize_output=True,
   retries=3,
   retry_delay=timedelta(seconds=30),
   retry_exponential_backoff=True,
   max_retry_delay=timedelta(minutes=5),
)
यहाँ, retries=3 पहली विफलता के बाद तीन अतिरिक्त प्रयासों तक की अनुमति देता है।
पहला रिट्राई 30 सेकंड इंतज़ार करता है, और एक्सपोनेंशियल बैकऑफ़ बाद के प्रयासों के बीच की देरी बढ़ा देता है—अधिकतम पाँच मिनट तक।
अच्छी बात यह है कि Airflow केवल विफल मैप्ड टास्क को ही रिट्राई करता है।
यदि 49 समीक्षाएँ सफलतापूर्वक वर्गीकृत हो गईं और एक अनुरोध विफल हुआ, तो केवल वही विफल समीक्षा रिट्राई के लिए निर्धारित होती है। पाइपलाइन का बाकी हिस्सा पहले से सफल हुए कार्य को दोहराने की ज़रूरत नहीं रखता।
कुछ समय बाद, विफल समीक्षा-वर्गीकरण फिर से रिट्राई के लिए कतारबद्ध हो जाएँगे:
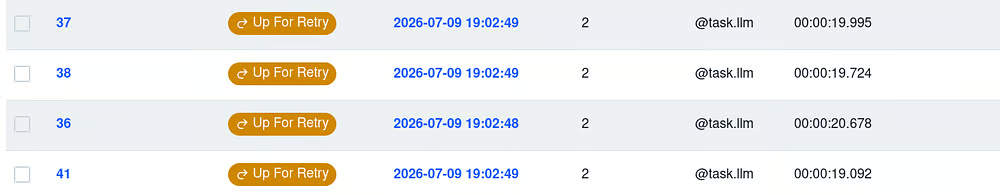
Airflow UI सभी विफल समीक्षा-वर्गीकरण टास्क्स को रिट्राई के लिए प्रतीक्षारत दिखा रहा है।
जैसे ही समीक्षा वर्गीकरण सफल होता है, हर मैप्ड show_classification() टास्क इंस्टेंस अपनी-अपनी लॉग्स में एक समीक्षा के लिए मॉडल प्रतिक्रिया दिखाता है।
इसका मतलब डिस्प्ले स्टेप भी स्वतंत्र है: आप एक समीक्षा का आउटपुट खोल, जाँच, या डिबग कर सकते हैं—अन्य की स्थिति से स्वतंत्र।
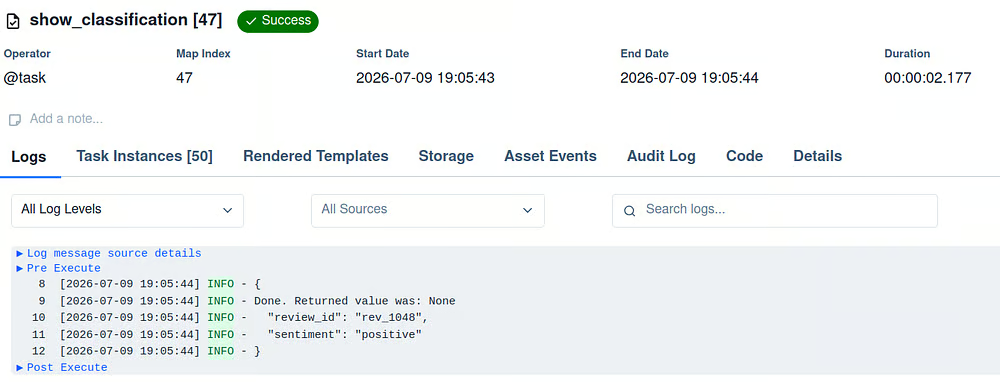
रिव्यू 47 के लिए LLM भावना-वर्गीकरण का Airflow UI दृश्य।
हर वर्गीकरण को प्रिंट करना DAG विकसित करते समय उपयोगी है क्योंकि इससे हम Airflow लॉग्स में मॉडल प्रतिक्रियाएँ जल्दी जाँच सकते हैं।
हालाँकि, लॉग्स पाइपलाइन के परिणाम संग्रहीत करने की विश्वसनीय जगह नहीं हैं। उन्हें क्वेरी करना, पुन: उपयोग करना, और डाउनस्ट्रीम सिस्टमों के साथ एकीकृत करना कठिन होता है।
इसलिए अंतिम कदम वर्गीकरणों को एकत्र करके उन्हें किसी संरचित आउटपुट में लिखना है।
इस लेख के लिए, हम show_classification() कॉल को हटा देंगे और परिणामों को एक लोकल JSON फ़ाइल में स्टोर करेंगे।
प्रोडक्शन पाइपलाइन में, यह टास्क आमतौर पर किसी डेटाबेस, डेटा वेयरहाउस, या ऑब्जेक्ट स्टोर में लिखेगा।
इस नए @task के लिए एक संभावित कार्यान्वयन होगा:
OUTPUT_FILE = (
   Path.home()
   / "airflow"
   / "output"
   / "classified_reviews.json"
)

@task
def store_results(results: list[dict]) -> str:
   """Write all classified reviews to a local JSON file."""
   OUTPUT_FILE.parent.mkdir(parents=True, exist_ok=True)

   classifications = list(results)

   with OUTPUT_FILE.open("w", encoding="utf-8") as file:
       json.dump(
           classifications,
           file,
           indent=2,
           ensure_ascii=False,
       )

   print(
       f"Stored {len(classifications)} classifications "
       f"in {OUTPUT_FILE}"
   )

   return str(OUTPUT_FILE)
यह टास्क हमारा लोड स्टेप है।
यह LLM द्वारा उत्पादित वर्गीकरणों को लेता है, आवश्यकता होने पर एक आउटपुट फ़ोल्डर बनाता है, और सब कुछ एक लोकल JSON फ़ाइल में लिख देता है।
छोटा सा list(results) रूपांतरण उपयोगी है क्योंकि वर्गीकरण मैप्ड टास्क्स से आते हैं।
Airflow हमारे लिए उन मैप्ड आउटपुट्स को इकट्ठा करता है, और यह टास्क उन्हें सेव करने से पहले एक सामान्य सूची में बदल देता है। अब हमें DAG के अंदर store_results(classifications) कॉल करके टास्क को कनेक्ट करना है।
इस लाइन के साथ, Airflow जानता है कि store_results() वर्गीकरण स्टेप पर निर्भर करता है। दूसरे शब्दों में, आउटपुट फ़ाइल तभी लिखी जाती है जब सभी समीक्षा-वर्गीकरण सफलतापूर्वक पूरे हो जाते हैं।
तीनों स्टेप्स जुड़ जाने पर, सम्पूर्ण DAG अब समीक्षाएँ लाता है, हर समीक्षा के लिए एक LLM टास्क बनाता है, और संयुक्त परिणामों को स्टोर करता है।
DAG फ़ंक्शन के अंदर, पाइपलाइन कुछ ऐसी दिखती है:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
def review_sentiment_pipeline():
   reviews = fetch_reviews()
   classifications = classify_review.expand(
       review=reviews
   )
   store_results(classifications)

review_sentiment_pipeline()
फ़ाइल सेव करने के बाद, Airflow उसे पार्स करने और सम्पूर्ण DAG खोजने में कुछ सेकंड लेगा। जैसे ही review_sentiment_pipeline DAG सूची में दिखाई दे, उसे टॉगल से सक्षम करें और मैन्युअल रन शुरू करने के लिए Trigger पर क्लिक करें।
इससे हम बिना अगली निर्धारित दैनिक रन का इंतज़ार किए पूरी पाइपलाइन का तुरंत परीक्षण कर सकते हैं। रन सफल होने पर, अंतिम JSON फ़ाइल लोकल रूप से ~/airflow/output/classified_reviews.json पर उपलब्ध होगी।
आउटपुट JSON फ़ाइल वर्कफ़्लो का स्थायी आउटपुट है, जिसे DAG के बाहर पुन: उपयोग किया जा सकता है या बाद में डाउनस्ट्रीम सिस्टमों को पास किया जा सकता है।
इसके विपरीत, Airflow UI हमें पाइपलाइन का ऑपरेशनल दृश्य देता है: कौन से टास्क चले, कौन से विफल या सफल हुए, और लॉग्स कहाँ देखें।
अंतिम पाइपलाइन नीचे प्रदर्शित है:
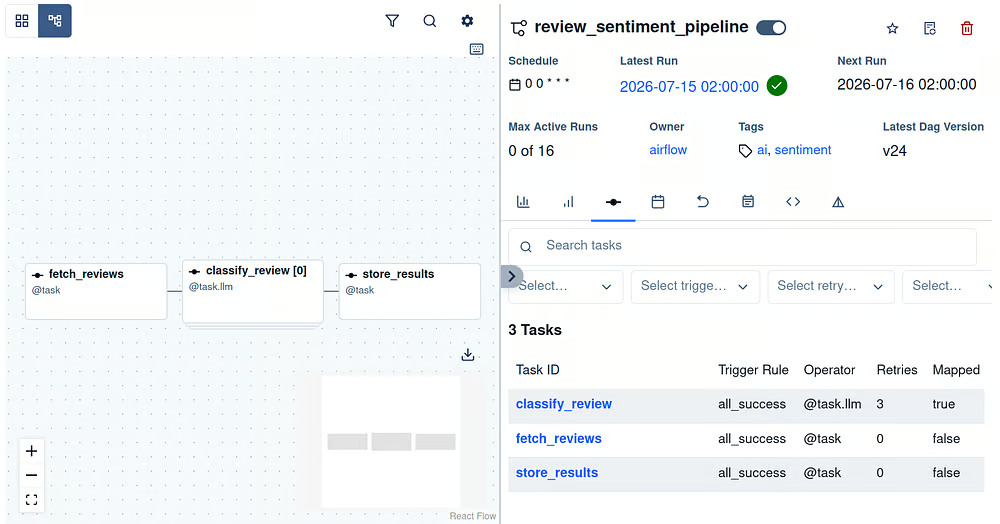
हमारी पाइपलाइन के तीन टास्क का Airflow UI दृश्य। दाएँ-नीचे का पैनल हर टास्क की प्रॉपर्टीज़ दिखाता है, जिनमें नाम, ट्रिगर नियम, ऑपरेटर/डेकोरेटर, और रिट्राई की संख्या शामिल हैं।
अंत में, अगले कुछ दिनों में Airflow UI स्वतः दैनिक रनों से भरना शुरू कर देगा, जिससे हमें यह स्पष्ट इतिहास मिलेगा कि पाइपलाइन कब चली और क्या प्रत्येक निष्पादन सफल रहा:
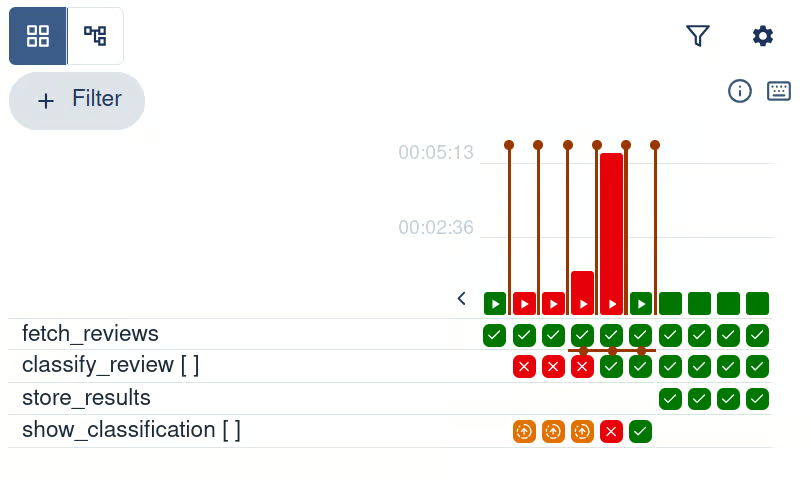
पाइपलाइन रनों और उनकी अवस्थाओं का Airflow UI दृश्य। कदम 3 के बाद, पाइपलाइन show_classification का उपयोग बंद कर देती है और उसकी जगह store_results चलाती है।
अब हमारी पाइपलाइन रोज़ाना समीक्षाएँ लाती है, उन्हें LLM से वर्गीकृत करती है, और परिणाम संग्रहीत करती है।
Airflow 3 और भी उन्नत पैटर्न सपोर्ट करता है जो AI वर्कफ़्लोज़ को अधिक प्रतिक्रियाशील और देखरेख में आसान बना सकते हैं।
रोज़ तय समय पर पाइपलाइन चलाने के बजाय, Airflow किसी बाहरी इवेंट के होने पर उसे शुरू कर सकता है।
उदाहरण के लिए, समीक्षा पाइपलाइन तब चल सकती है जब कोई नई समीक्षा फ़ाइल ऑब्जेक्ट स्टोरेज में अपलोड हो या किसी क्यू में संदेश आए।
Airflow 3 एसेट्स और इवेंट-कम्पैटिबल ट्रिगर्स के माध्यम से इवेंट-ड्रिवन शेड्यूलिंग सपोर्ट करता है। इससे नए डेटा के लिए बार-बार जाँच करने की आवश्यकता समाप्त हो जाती है और पाइपलाइन किसी इवेंट का पता लगते ही प्रतिक्रिया दे सकती है।
हर मॉडल निर्णय को स्वचालित रूप से स्वीकार नहीं किया जाना चाहिए।
कुछ समीक्षाएँ अस्पष्ट, संवेदनशील, या मानवीय निर्णय की माँग कर सकती हैं। Airflow के मानव-इन-द-लूप ऑपरेटर्स चल रहे वर्कफ़्लो को रोक सकते हैं और Airflow इंटरफ़ेस के माध्यम से इनपुट माँग सकते हैं।
कोई समीक्षक किसी परिणाम को स्वीकृत या अस्वीकार कर सकता है, जानकारी दे सकता है, या चुन सकता है कि वर्कफ़्लो की कौन सी शाखा आगे बढ़े।
Common AI प्रोवाइडर एजेंटिक वर्कफ़्लोज़ के लिए इंटरैक्टिव रिव्यू पैटर्न भी सपोर्ट करता है, जहाँ कोई समीक्षक LLM-जनित परिणाम को स्वीकृत, अस्वीकार, या बदलाव का अनुरोध कर सकता है।
साथ मिलकर, इवेंट-ड्रिवन शेड्यूलिंग और मानवीय समीक्षा ऐसी AI पाइपलाइनें बनाना संभव बनाती हैं जो तेजी से प्रतिक्रिया देती हैं, और जहाँ ज़रूरी हो वहाँ मानवीय निगरानी बनी रहती है।
Airflow 3.0 की विशेषताओं के बारे में और जानने के लिए, हमारा अलग गाइड देखें।
इस लेख में, हमने Apache Airflow के साथ एक सम्पूर्ण AI पाइपलाइन बनाई।
पाइपलाइन ग्राहक समीक्षाएँ लाती है, हर समीक्षा का LLM से वर्गीकरण करती है, और अंतिम परिणामों को एक संरचित JSON फ़ाइल में स्टोर करती है।
रास्ते में, हमने देखा कि Airflow कैसे Python फ़ंक्शनों को अनुसूचित, ऑब्ज़र्वेबल टास्क्स में बदल देता है। यह विशेष रूप से AI वर्कफ़्लोज़ के लिए उपयोगी है, जहाँ API सीमाएँ, मॉडल टाइमआउट्स, और अप्रत्याशित आउटपुट हो सकते हैं।
टास्क निर्भरताएँ, डायनेमिक टास्क मैपिंग, रिट्राई, लॉग्स, और Airflow UI के साथ, हम AI पाइपलाइनों को मॉनिटर, डिबग, और रिकवर करना आसान बना सकते हैं।
उदाहरण में चीज़ों को सरल रखने के लिए लोकल फ़ाइलों का उपयोग किया गया, लेकिन यही संरचना APIs, डेटाबेस, इवेंट-ड्रिवन वर्कफ़्लोज़, और मानव-इन-द-लूप समीक्षा तक बढ़ाई जा सकती है।
यदि आप और आगे खोजने के लिए तैयार हैं, तो मैं हमारे Introduction to Apache Airflow in Python कोर्स से शुरू करने, और फिर Building Data Pipelines with Airflow पर आगे बढ़ने की सलाह देता/देती हूँ, ताकि और अधिक हाथ-से-हाथ अभ्यास हो सके।
विस्तृत लर्निंग पाथ के लिए, Data Engineer in Python करियर ट्रैक उन व्यापक कौशलों को कवर करता है जो प्रोडक्शन डेटा पाइपलाइनों को बनाने और प्रबंधित करने के लिए आवश्यक हैं।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
लर्निंग पाथ