
Last chance! 50% off DataCamp Premium
Sale ends in
Bắt đầu với các nguyên mẫu AI thì dễ. Một notebook, một khóa API và vài dòng Python có thể đủ để phân loại văn bản, tóm tắt tài liệu hoặc tạo đề xuất.
Tuy nhiên, vận hành nguyên mẫu đó ổn định mỗi ngày lại là một thách thức khác.
Điều gì xảy ra khi API của mô hình chạm ngưỡng giới hạn tốc độ? Nếu một yêu cầu bị hết thời gian chờ, đầu ra không theo định dạng mong đợi, hoặc cơ sở dữ liệu hạ nguồn tạm thời không khả dụng thì sao?
Khi một pipeline AI trở thành quy trình lặp lại, độ tin cậy, giám sát và khả năng khôi phục nhanh chóng trở nên quan trọng không kém gì chính mô hình.
Trong bài viết này, tôi sẽ hướng dẫn bạn xây dựng một pipeline AI hoàn chỉnh với Apache Airflow, một nền tảng mã nguồn mở để phát triển, lập lịch và giám sát quy trình làm việc.
Pipeline của chúng ta sẽ chạy hàng ngày, lấy đánh giá của khách hàng, phân loại cảm xúc của chúng bằng mô hình ngôn ngữ lớn (LLM) và lưu trữ kết quả. Tất cả đều đáng tin cậy trong một luồng công việc duy nhất!
Jupyter notebook rất tuyệt để thử nghiệm. Tất cả chúng ta đều thích notebook để kiểm thử ý tưởng, viết mã nhanh và trực quan hóa kết quả khi làm.
Một cron job thường đủ để chạy một script đơn giản mỗi đêm. Dù thành thật mà nói, nhiều script đã được chạy thủ công hàng tuần trước khi ai đó cuối cùng mới đặt lịch đàng hoàng cho chúng.
Vấn đề bắt đầu khi một script phát triển thành nhiều script, và các script đó bắt đầu phụ thuộc lẫn nhau. Tại thời điểm đó, chúng ta không còn một chương trình độc lập nữa: chúng ta có một luồng công việc.
Notebook hay cron job đều không được thiết kế để quản lý các luồng công việc phức tạp một cách đáng tin cậy.
Các phụ thuộc thường ẩn trong mã, lỗi cần điều tra thủ công, và chạy lại pipeline có thể đồng nghĩa với lặp lại các bước vốn đã hoàn tất thành công.
Chúng ta đã gặp một phần độ phức tạp này trong các pipeline ETL (Extract-Transform-Load) truyền thống. Các luồng ETL có thể cần truy xuất dữ liệu, biến đổi, kiểm định và nạp vào hệ thống khác.
Ngay cả khi đầu vào và biến đổi có thể dự đoán, mỗi bước bổ sung lại tạo thêm một điểm có thể thất bại. Ngày nay, các pipeline AI khiến thách thức này càng rõ rệt hơn.
Nếu bạn quan tâm cụ thể đến pipeline ETL, tôi khuyến nghị khóa học về pipeline ETL trong Airflow.
Hãy xét một luồng AI điển hình: thu thập dữ liệu, làm sạch, gọi API mô hình, kiểm định phản hồi, lưu kết quả, và thông báo khi có sự cố.
Mỗi bước phụ thuộc vào bước trước và mỗi bước có thể thất bại theo cách khác nhau: API có thể trả lỗi giới hạn tốc độ. Một yêu cầu tới mô hình có thể hết thời gian chờ. Phản hồi sinh ra có thể là JSON hợp lệ nhưng vẫn trượt kiểm tra chất lượng.
Đầu ra cũng có thể thiếu, không nhất quán, hoặc định dạng khác những gì bước tiếp theo mong đợi.
Airflow không loại bỏ các lỗi này, nhưng giúp quản lý chúng dễ dàng hơn.
Với Airflow, một tác vụ gọi LLM có thể thử lại sau khi gặp phản hồi giới hạn tạm thời mà không cần chạy lại bước nạp dữ liệu. Một tác vụ kiểm định có thể loại bỏ kết quả sai định dạng hoặc chất lượng kém trước khi lên production. Cảnh báo có thể chỉ gửi cho nhóm sau khi đã thử lại theo cấu hình mà vẫn thất bại.
Airflow làm được điều này bằng cách biểu diễn luồng công việc dưới dạng Đồ thị có hướng không chu trình (DAG).
Thay vì giấu toàn bộ pipeline trong một script dài, DAG định nghĩa mỗi thao tác là một tác vụ riêng với phụ thuộc rõ ràng, chính sách thử lại, log và trạng thái thực thi.
Đây là lý do chính khiến Airflow rất phù hợp với pipeline AI: nó xem thất bại là một phần dự kiến của luồng công việc chứ không phải điều bất ngờ ngoại lệ.
Khi một thử nghiệm phát triển thành quy trình production lặp lại, Airflow cung cấp lớp điều phối cần thiết để quan sát, khôi phục và dễ bảo trì hơn.
Trước khi bắt đầu xây dựng pipeline của riêng mình, hãy thiết lập môi trường.
Có ba bước ngắn cần thực hiện để thiết lập môi trường.
Trong hướng dẫn này, chúng ta sẽ chạy Airflow cục bộ.
Thiết lập này thuận tiện cho việc học và phát triển vì một lệnh duy nhất sẽ khởi tạo cơ sở dữ liệu metadata và khởi động các dịch vụ cần thiết để dùng Airflow.
Đầu tiên, hãy tạo và kích hoạt một môi trường ảo để tách Airflow và các phụ thuộc khỏi cài đặt Python còn lại của bạn:
python3 -m venv ~/airflow-venv
source ~/airflow-venv/bin/activate
Tiếp theo, chúng ta cần cài đặt Airflow 3 bằng cách cố định phiên bản và sử dụng tệp constraints chính thức:
AIRFLOW_VERSION=3.3.0
PYTHON_VERSION="$(python -c 'import sys; print(f"{sys.version_info.major}.{sys.version_info.minor}")')"

CONSTRAINT_URL="https://raw.githubusercontent.com/apache/airflow/constraints-${AIRFLOW_VERSION}/constraints-${PYTHON_VERSION}.txt"

pip install "apache-airflow==${AIRFLOW_VERSION}" \
 --constraint "${CONSTRAINT_URL}"
Lưu ý Airflow phụ thuộc vào nhiều gói Python, và các gói đó cũng có phụ thuộc riêng. Nếu không có tệp constraints, pip có thể chọn phiên bản mới hơn hoặc không tương thích.
Việc cài đặt có vẻ hoạt động, nhưng Airflow có thể lỗi sau đó khi import providers, khởi động dịch vụ, hoặc chạy tác vụ. Hướng dẫn cài đặt chính thức của Airflow khuyến nghị dùng tệp constraints để cài đặt bộ phụ thuộc đã biết là tương thích.
Vì luồng công việc của chúng ta sẽ gọi một LLM, chúng ta cũng cần Common AI provider của Airflow và phụ thuộc OpenAI cho Pydantic AI:
pip install \
 "apache-airflow-providers-common-ai" \
 "pydantic-ai-slim[openai]"
Tiếp theo, hãy cấu hình kết nối OpenAI. Airflow dùng connection để lưu thông tin xác thực và thiết lập kết nối bên ngoài mã DAG. Điều này giúp tệp Python gọn gàng hơn và tránh hard-code bí mật trong pipeline.
Sau khi xác nhận cài đặt, đã đến lúc đặt khóa OpenAI để có thể thực sự giao tiếp với mô hình. Có nhiều cách để làm điều này.
Tùy chọn tôi ưa thích là:
export OPENAI_API_KEY="your-openai-api-key"airflow connections add pydanticai_default \
--conn-type pydanticai \
--conn-password "$OPENAI_API_KEY" \
--conn-extra '{"model":"openai:gpt-4o-mini"}'Common AI provider sử dụng kiểu kết nối pydanticai để giao tiếp với các nhà cung cấp LLM thông qua Pydantic AI.
Lệnh này lưu kết nối trong cơ sở dữ liệu metadata của Airflow, vì vậy sau đó bạn không cần giữ tệp .env hoặc truyền khóa lại mỗi lần khởi động Airflow.
airflow standaloneGiữ terminal này mở khi Airflow đang chạy. Chế độ Standalone lý tưởng cho phát triển cục bộ và hướng dẫn, nhưng không dành cho triển khai production.
Để truy cập giao diện Airflow, giờ chúng ta có thể mở http://localhost:8080 trong trình duyệt. Điều đầu tiên bạn sẽ thấy là trang đăng nhập. Nhưng dùng tên người dùng và mật khẩu nào?
Màn hình đăng nhập của Apache Airflow.
Khi Airflow khởi động ở chế độ standalone, nó tự động tạo thông tin đăng nhập. Tên người dùng và mật khẩu được in trong output của terminal và cũng được lưu tại $AIRFLOW_HOME/simple_auth_manager_passwords.json.generated.
Theo mặc định, AIRFLOW_HOME là ~/airflow, nên chúng ta có thể lấy thông tin đăng nhập bằng:
cat ~/airflow/simple_auth_manager_passwords.json.generatedCuối cùng, các thông tin này sẽ cho phép chúng ta đăng nhập vào giao diện Airflow.
Sau khi đăng nhập, Airflow mở ở trang Home. Màn hình này cho bạn cái nhìn tổng quan nhanh về môi trường Airflow cục bộ.
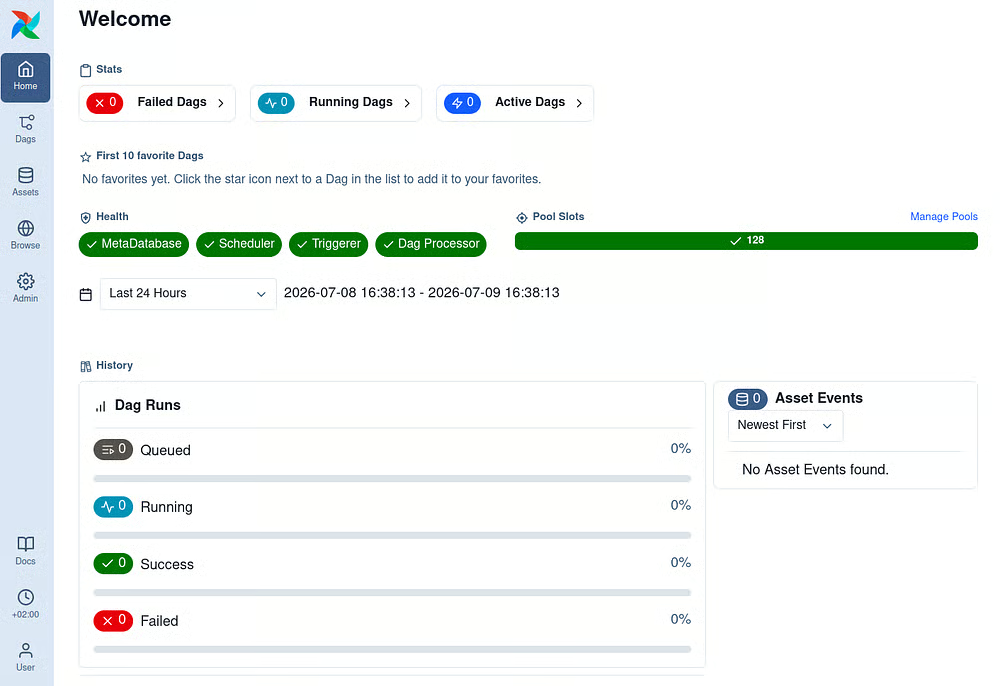
Giao diện Airflow sau lần đăng nhập đầu tiên.
Trên cùng, các thẻ Stats tóm tắt trạng thái hiện tại của DAGs, bao gồm workflow thất bại, đang chạy và đang hoạt động.
Vì ta chưa tạo pipeline, các giá trị này có thể vẫn là 0.
Phần Health cho biết các dịch vụ chính của Airflow có đang chạy hay không.
Bên dưới, thanh Pool Slots hiển thị năng lực thực thi còn trống. Chúng ta sẽ không cấu hình pool tùy chỉnh trong bài này, nhưng khu vực này hữu ích khi kiểm soát số tác vụ có thể chạy đồng thời.
Cuối cùng, phần History tóm tắt các lần chạy DAG gần đây. Khi kích hoạt pipeline phân tích cảm xúc đánh giá, khu vực này sẽ hiển thị các lượt đợi, đang chạy, thành công và thất bại.
Giờ Airflow đã chạy, hãy tạo các tệp cần thiết cho pipeline của chúng ta:
mkdir -p ~/airflow/dags
touch ~/airflow/dags/review_sentiment_pipeline.py
touch ~/airflow/requirements.txt
Trong cài đặt standalone cục bộ, Airflow dùng ~/airflow làm AIRFLOW_HOME theo mặc định. Chúng ta sẽ đặt tệp DAG trong thư mục dags và giữ một tệp requirements.txt để ghi lại các phụ thuộc của dự án.
Vì vậy, dự án sẽ có cấu trúc như sau:
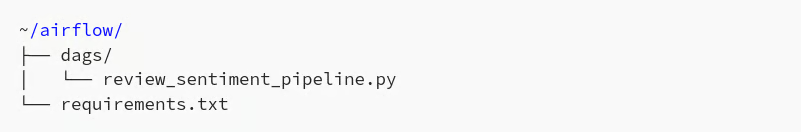
Cấu trúc dự án Airflow tối thiểu.
Tệp eview_sentiment_pipeline.py sẽ chứa định nghĩa luồng công việc, gồm các tác vụ lấy đánh giá, phân loại cảm xúc và lưu trữ kết quả.
Airflow giám sát thư mục dags được cấu hình và tìm các định nghĩa DAG hợp lệ bên trong các tệp Python. Khi tệp của chúng ta có một DAG hợp lệ, workflow sẽ xuất hiện trên trang Dags trong giao diện Airflow.
Nếu bạn gặp khó khăn khi bắt đầu, tôi gợi ý xem hướng dẫn Bắt đầu với Apache Airflow. .
Để bắt đầu thực hành với Airflow, chúng ta sẽ xây một tác vụ hàng ngày xử lý đánh giá của khách hàng và phân loại cảm xúc của chúng.
Hãy tưởng tượng chúng ta vừa xây một nền tảng thương mại điện tử. Khách hàng đã để lại đánh giá, và chúng ta muốn phân tích chúng tự động mỗi ngày.
Thay vì chạy script thủ công, chúng ta có thể dùng Airflow để điều phối luồng công việc.
Hãy giả định các đánh giá thô được lưu trong một tệp .jsonl.
Mỗi dòng chứa một đánh giá dưới dạng đối tượng JSON, và các đánh giá mới được nối vào cuối tệp trong ngày. Trong hệ thống production, dữ liệu này có thể đến từ API, cơ sở dữ liệu, object store hoặc hàng đợi thông điệp. Với hướng dẫn này, tệp JSONL cho chúng ta một nguồn dữ liệu đánh giá thô đơn giản và thực tế.
Trong kịch bản này, bước đầu tiên của pipeline là nạp các đánh giá đó vào Airflow. Chúng ta bắt đầu với một hàm Python thông thường, giống như trong notebook hoặc script:
REVIEWS_FILE = Path.home() / "airflow" / "data" / "reviews.jsonl"

def fetch_reviews() -> list[dict]:
   """Load raw customer reviews from the JSONL landing file."""
   reviews = []

   with REVIEWS_FILE.open("r", encoding="utf-8") as file:
       for line_number, line in enumerate(file, start=1):
           if not line.strip():
               continue

           try:
               reviews.append(json.loads(line))
           except json.JSONDecodeError as error:
               raise ValueError(
                   f"Invalid JSON on line {line_number}"
               ) from error

   print(f"Fetched {len(reviews)} reviews")
   return reviews
Hàm này mở tệp JSONL, đọc từng dòng, bỏ qua dòng trống và chuyển mỗi đối tượng JSON thành một dict Python.
Nếu một dòng chứa JSON không hợp lệ, tác vụ sẽ thất bại với thông báo lỗi rõ ràng kèm số dòng.
Cho đến giờ vẫn chỉ là Python thuần. Bước tiếp theo là biến nó thành một tác vụ Airflow và đặt trong một DAG.
Để biến hàm thành một phần của luồng công việc Airflow, chúng ta cần ba phần:
@task. Điều này cho Airflow biết hàm là một tác vụ.@dag. DAG đặt tên luồng công việc, lịch chạy, ngày bắt đầu và cấu hình khác.Đây là phiên bản tối thiểu:
from airflow.sdk import dag

@dag(    fetch_reviews()
   dag_id="fetch_reviews_pipeline",
)

def fetch_reviews_pipeline():
   fetch_reviews()

fetch_reviews_pipeline()
Lưu ý DAG này chưa chạy tự động.
Như đang viết, chúng ta cần kích hoạt thủ công từ giao diện Airflow. Để cấu hình khi nào workflow chạy, có thể thêm tham số lập lịch vào định nghĩa DAG. Một lựa chọn là:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
Hãy cùng phân tích!
dag_id đặt tên duy nhất cho DAG trong Airflow.schedule="@daily" chạy DAG mỗi ngày một lần.start_date cho Airflow biết khi nào bắt đầu lập lịch.catchup=False ngăn Airflow tạo các lượt chạy cho các ngày trong quá khứ.tags giúp sắp xếp và lọc DAG trong giao diện Airflow.Khi DAG đã được định nghĩa, chúng ta có thể mở giao diện và xem thực tế:
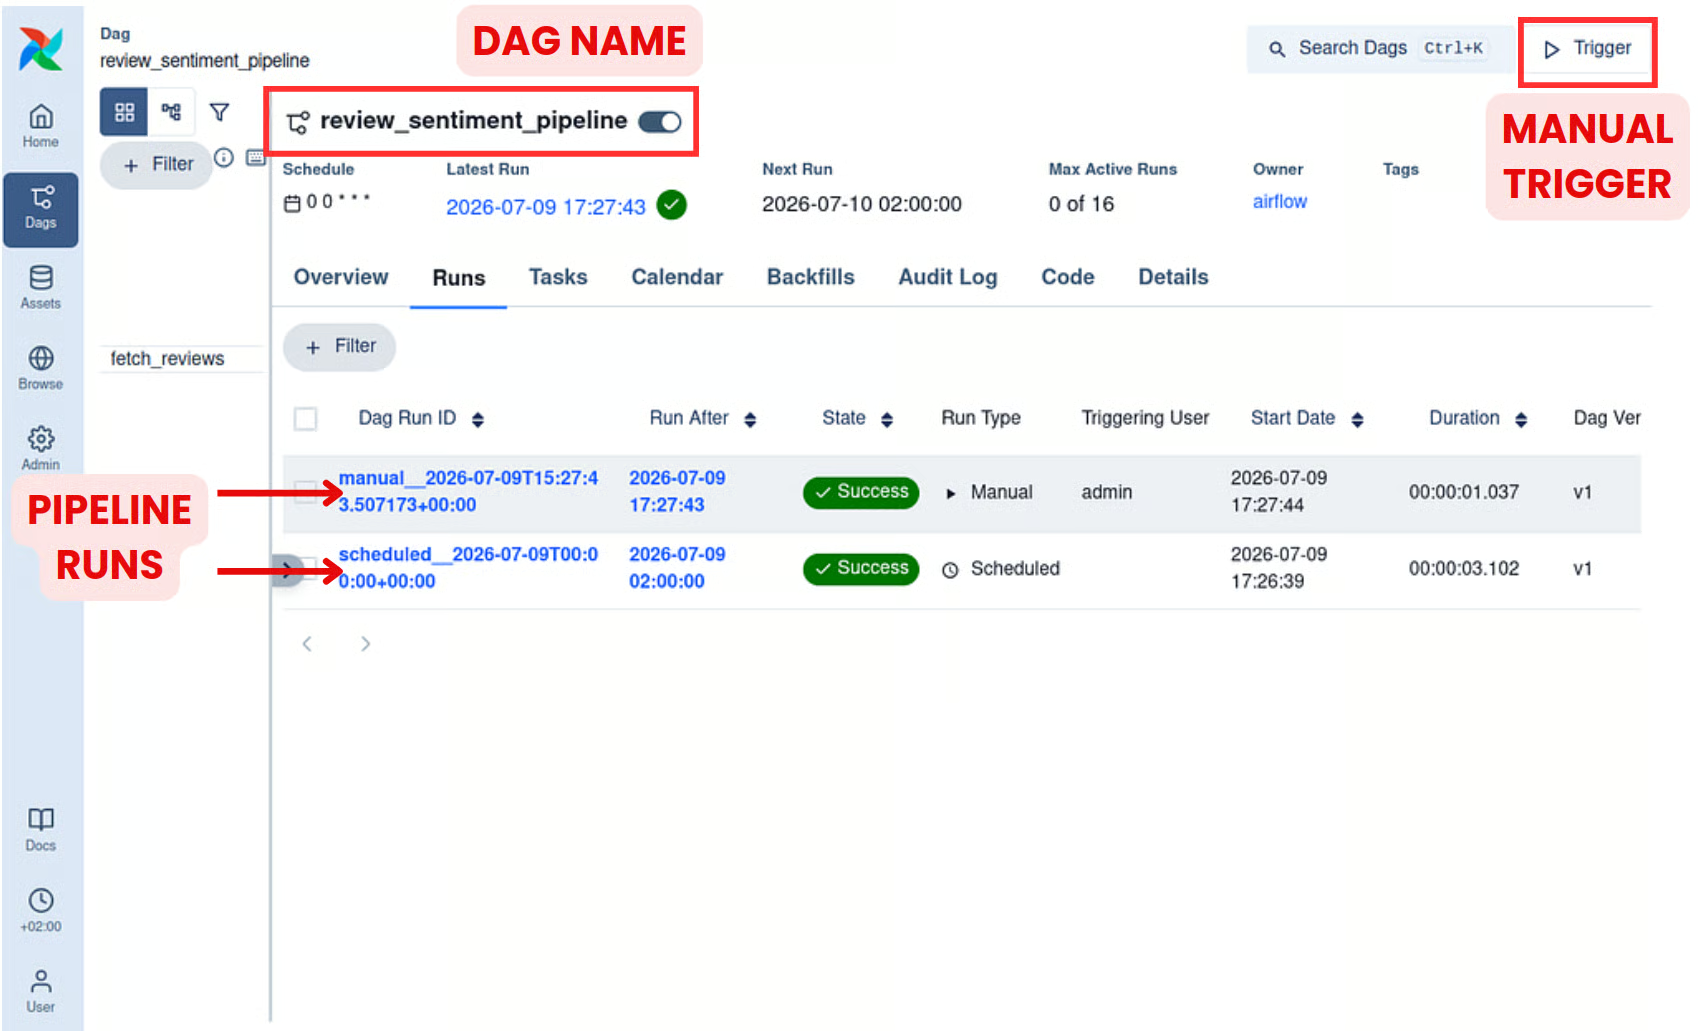
Giao diện Airflow của pipeline review_sentiment_pipeline. Lưu ý hai loại lượt chạy (theo lịch và thủ công) và nút Trigger thủ công.
Trong giao diện, ta thấy Airflow tự động phát hiện DAG tên review_sentiment_pipeline.
Chúng ta cũng thấy nó chạy theo lịch, và rằng ta đã kích hoạt thêm một lượt chạy thủ công bằng nút Trigger ở góc trên bên phải.
Một tính năng hay là chế độ xem dạng lịch, nơi Airflow ghi lại các lượt chạy pipeline cùng trạng thái của từng lượt:
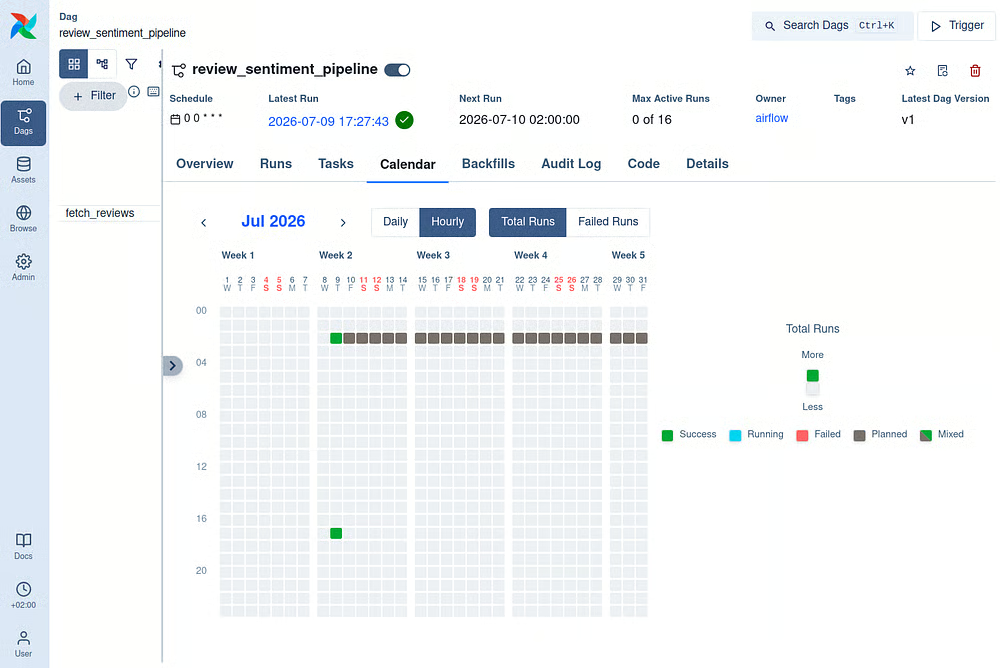
Chế độ xem lịch của pipeline Airflow với cả lượt chạy theo lịch và thủ công.
Bạn có thể tạm dừng bài viết ở đây và khám phá giao diện Airflow!
Sau khi đã nạp đánh giá, bước tiếp theo là phân loại cảm xúc của chúng. Cho việc này, chúng ta sẽ dùng @task.llm, một decorator biến lời gọi LLM thành tác vụ Airflow thuần.
Chúng ta có thể gọi API OpenAI thủ công trong một @task thông thường, nhưng @task.llm cho tích hợp gọn gàng hơn.
Nó xử lý các chi tiết đặc thù LLM như kết nối mô hình, system prompt, đầu ra có cấu trúc và tuần tự hóa kết quả. Đồng thời, tác vụ vẫn hưởng các tính năng chuẩn của Airflow như thử lại, ghi log, giám sát và quản lý phụ thuộc.
Bước thứ hai này có vài phần hơn so với tác vụ trước, nên hãy xây dần từng bước:
from typing import Literal
from pydantic import BaseModel

class ReviewClassification(BaseModel):
   """Structured result returned by the LLM."""

   review_id: str
   sentiment: Literal["positive", "neutral", "negative"]
Điều này cho tác vụ LLM biết rằng mỗi phản hồi phải chứa ID đánh giá và một trong ba nhãn cảm xúc: tích cực, trung tính hoặc tiêu cực.
@task.llm(
   llm_conn_id="pydanticai_default",
   system_prompt=(
       "Classify the customer review as positive, neutral, or negative. "
       "Use both the written review and the star rating as context. "
       "Return the review ID and sentiment."
   ),
   output_type=ReviewClassification,
   serialize_output=True,
   retries=3,
)
def classify_review(review: dict) -> str:
   """Build the prompt sent to the LLM."""
   return (
       f"Review ID: {review['review_id']}\n"
       f"Product: {review['product']}\n"
       f"Rating: {review['rating']} out of 5 stars\n"
       f"Review: {review['review_text']}"
   )
Phần thân hàm trả về một chuỗi prompt, còn decorator @task.llm lo việc gửi prompt đó đến mô hình bằng kết nối pydanticai_default mà ta đã cấu hình ở trên.
Tham số system_prompt đưa chỉ dẫn cho mô hình, còn output_type=ReviewClassification yêu cầu phản hồi có cấu trúc. Ta cũng đặt serialize_output=True để Airflow lưu kết quả dưới dạng dict thuần, giúp truyền cho các tác vụ phía sau dễ hơn.
Quan tâm đến các tác vụ cần suy luận LLM? Hãy cân nhắc khóa học LangChain cho các ứng dụng chuyên sâu hơn!
Tác vụ phân loại trả về kết quả có cấu trúc, nhưng trong quá trình phát triển, việc xem nhanh mô hình tạo ra gì mà không đợi đến bước lưu trữ cuối cùng rất hữu ích.
Thực tế, một bước trong pipeline có thể gồm nhiều tác vụ Airflow.
Trong trường hợp này, chúng ta thêm một tác vụ nhỏ để in từng phân loại vào log của Airflow:
@task
def show_classification(classification: dict) -> dict:
   """Print one model classification to the Airflow task logs."""
   print(
       f"Review {classification['review_id']}: "
       f"{classification['sentiment']}"
   )

   return classification
Tác vụ này không thay đổi kết quả. Nó chỉ ghi đầu ra của mô hình và trả lại cùng dict, để phân loại vẫn có thể truyền sang bước tiếp theo của pipeline.
3. Cuối cùng, chúng ta cần nối các tác vụ mới trong hàm DAG:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
def review_sentiment_pipeline():
   reviews = fetch_reviews()

   classifications = classify_review.expand(
       review=reviews
   )

   displayed_classifications = show_classification.expand(
       classification=classifications
   )

review_sentiment_pipeline()
Lưu ý: Trong pipeline này, chúng ta dùng ánh xạ tác vụ động với .expand(review=reviews). Điều này yêu cầu Airflow tạo một instance tác vụ classify_review cho mỗi đánh giá, do đó mỗi đánh giá được gửi tới LLM bằng một yêu cầu riêng.
Cách này thường tốt hơn so với gửi toàn bộ danh sách đánh giá cho một tác vụ LLM. Một lời gọi như classify_reviews(reviews) sẽ xử lý tất cả cùng lúc, khiến lỗi khó gỡ hơn, thử lại kém nhắm mục tiêu, và đầu vào lớn dễ chạm giới hạn ngữ cảnh mô hình hoặc API.
Trước khi kết thúc bước thứ hai của pipeline, hãy quay lại giao diện Airflow và trực quan hóa luồng công việc đã thay đổi thế nào.
Lúc này, DAG gồm ba tác vụ: fetch_reviews, classify_review, và show_classification :
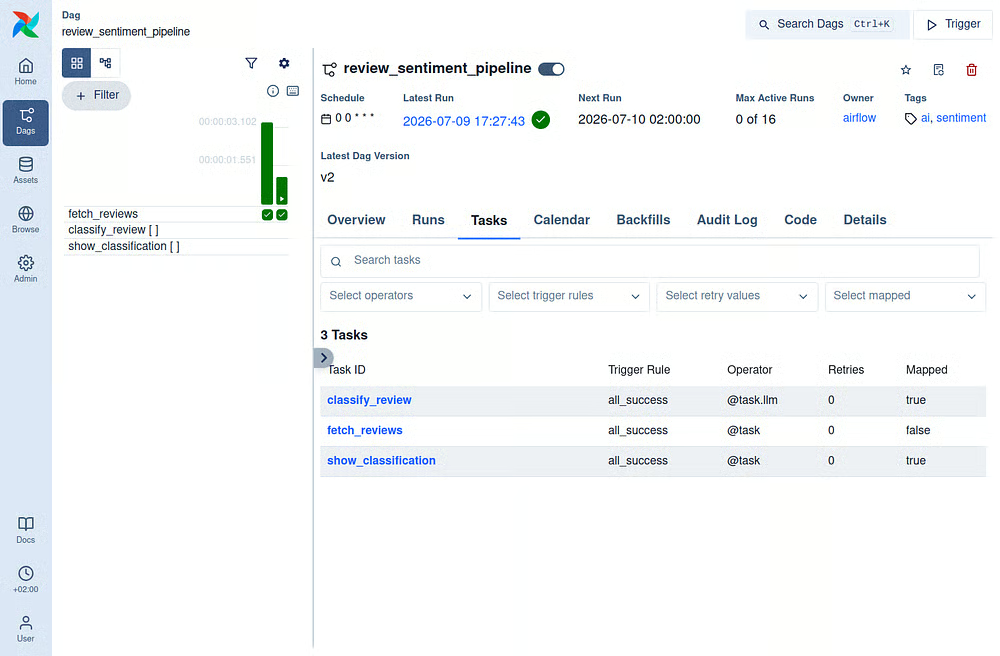
Giao diện Airflow hiển thị ba tác vụ trong DAG review_sentiment_pipeline.
Nhờ dùng ánh xạ tác vụ động, Airflow gửi một yêu cầu LLM cho mỗi đánh giá. Điều này hữu ích vì mỗi đánh giá được theo dõi độc lập:
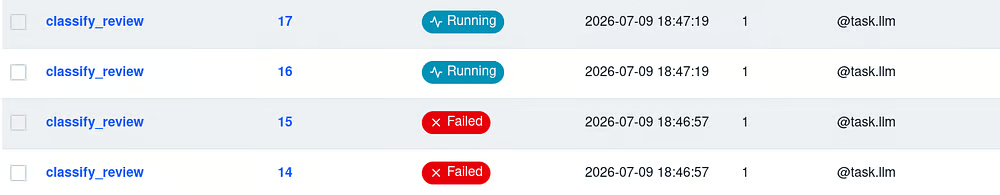
Giao diện Airflow hiển thị các đánh giá được phân loại độc lập. Một số tác vụ đã hoàn tất hoặc thất bại, trong khi số khác vẫn đang chạy.
Yêu cầu LLM có thể thất bại do giới hạn tốc độ API, sự cố mạng, hoặc hết thời gian chờ của mô hình.
Thay vì để cả pipeline thất bại ngay, chúng ta có thể yêu cầu Airflow tự động thử lại tác vụ bị ảnh hưởng.
Hãy thêm tính năng này!
from datetime import timedelta

@task.llm(
   llm_conn_id="pydanticai_default",
   system_prompt=(
       "Classify the customer review as positive, neutral, or negative. "
       "Use both the written review and the star rating as context. "
       "Return the review ID and sentiment."
   ),
   output_type=ReviewClassification,
   serialize_output=True,
   retries=3,
   retry_delay=timedelta(seconds=30),
   retry_exponential_backoff=True,
   max_retry_delay=timedelta(minutes=5),
)
Ở đây, retries=3 cho phép tối đa ba lần thử bổ sung sau lần thất bại đầu.
Lần thử lại đầu chờ 30 giây, và backoff lũy thừa tăng dần thời gian chờ giữa các lần sau, tối đa năm phút.
Điểm hay là Airflow chỉ thử lại tác vụ đã ánh xạ bị lỗi.
Nếu 49 đánh giá phân loại thành công và một yêu cầu thất bại, chỉ đánh giá bị lỗi đó được lên lịch thử lại. Phần còn lại của pipeline không cần lặp lại công việc đã thành công.
Sau một thời gian, các phân loại đánh giá thất bại sẽ lại được thử lại:
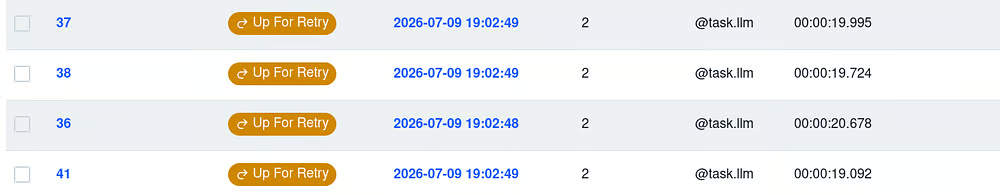
Giao diện Airflow hiển thị tất cả tác vụ phân loại đánh giá thất bại đang chờ thử lại.
Khi phân loại đánh giá thành công, mỗi instance đã ánh xạ của show_classification() hiển thị phản hồi của mô hình cho một đánh giá trong log riêng của nó.
Điều này có nghĩa bước hiển thị cũng độc lập: bạn có thể mở, kiểm tra hoặc gỡ lỗi đầu ra của một đánh giá bất kể trạng thái của các đánh giá khác.
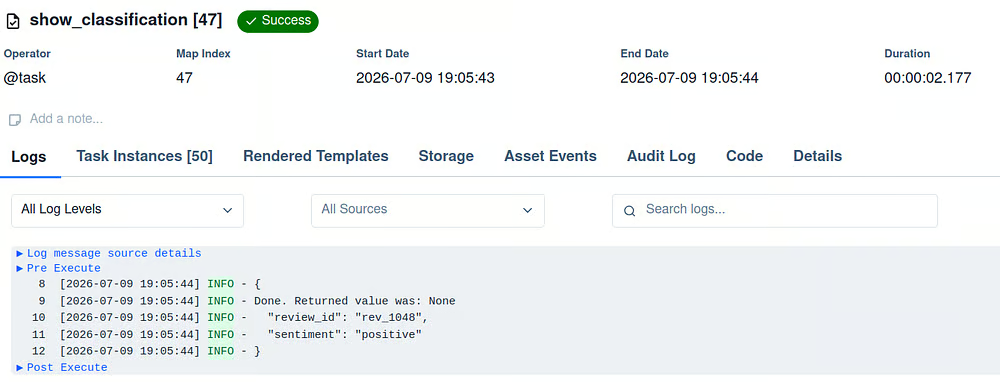
Giao diện Airflow hiển thị phân loại cảm xúc bằng LLM cho đánh giá 47.
In từng phân loại hữu ích khi phát triển DAG vì giúp chúng ta nhanh chóng kiểm tra phản hồi của mô hình trong log Airflow.
Tuy nhiên, log không phải nơi đáng tin để lưu kết quả pipeline. Chúng khó truy vấn, tái sử dụng và tích hợp với hệ thống hạ nguồn.
Vì vậy, bước cuối là thu thập các phân loại và ghi chúng vào một đầu ra có cấu trúc.
Trong bài này, chúng ta sẽ bỏ lời gọi show_classification() và lưu kết quả vào một tệp JSON cục bộ.
Trong pipeline production, tác vụ này thường ghi vào cơ sở dữ liệu, kho dữ liệu hoặc object store.
Một cách hiện thực cho @task mới này là:
OUTPUT_FILE = (
   Path.home()
   / "airflow"
   / "output"
   / "classified_reviews.json"
)

@task
def store_results(results: list[dict]) -> str:
   """Write all classified reviews to a local JSON file."""
   OUTPUT_FILE.parent.mkdir(parents=True, exist_ok=True)

   classifications = list(results)

   with OUTPUT_FILE.open("w", encoding="utf-8") as file:
       json.dump(
           classifications,
           file,
           indent=2,
           ensure_ascii=False,
       )

   print(
       f"Stored {len(classifications)} classifications "
       f"in {OUTPUT_FILE}"
   )

   return str(OUTPUT_FILE)
Tác vụ này là bước load của chúng ta.
Nó nhận các phân loại do LLM tạo ra, tạo thư mục đầu ra nếu cần và ghi tất cả vào một tệp JSON cục bộ.
Phép chuyển nhỏ list(results) hữu ích vì các phân loại đến từ các tác vụ đã ánh xạ.
Airflow thu thập các đầu ra đã ánh xạ đó cho chúng ta, và tác vụ này biến chúng thành một danh sách thông thường trước khi lưu. Giờ ta chỉ cần nối tác vụ trong DAG bằng cách gọi store_results(classifications).
Với dòng này, Airflow biết rằng store_results() phụ thuộc vào bước phân loại. Nói cách khác, tệp đầu ra chỉ được ghi sau khi toàn bộ phân loại đánh giá hoàn tất thành công.
Khi cả ba bước đã được nối, DAG hoàn chỉnh giờ sẽ lấy đánh giá, tạo một tác vụ LLM cho mỗi đánh giá và lưu trữ kết quả tổng hợp.
Bên trong hàm DAG, pipeline trông như sau:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
def review_sentiment_pipeline():
   reviews = fetch_reviews()
   classifications = classify_review.expand(
       review=reviews
   )
   store_results(classifications)

review_sentiment_pipeline()
Sau khi lưu tệp, Airflow sẽ mất vài giây để phân tích và phát hiện DAG hoàn chỉnh. Khi review_sentiment_pipeline xuất hiện trong danh sách DAG, hãy bật nó bằng công tắc và nhấp Trigger để bắt đầu một lượt chạy thủ công.
Việc này cho phép chúng ta kiểm thử toàn bộ pipeline ngay, không cần đợi lượt chạy hằng ngày kế tiếp. Khi lượt chạy thành công, tệp JSON cuối cùng sẽ có sẵn cục bộ tại ~/airflow/output/classified_reviews.json.
Tệp JSON đầu ra là đầu ra bền vững của luồng công việc, có thể được tái sử dụng ngoài DAG hoặc truyền cho hệ thống hạ nguồn sau này.
Ngược lại, giao diện Airflow cho chúng ta góc nhìn vận hành của pipeline: tác vụ nào đã chạy, tác vụ nào thất bại hoặc thành công, và nơi xem log.
Pipeline cuối cùng được hiển thị dưới đây:
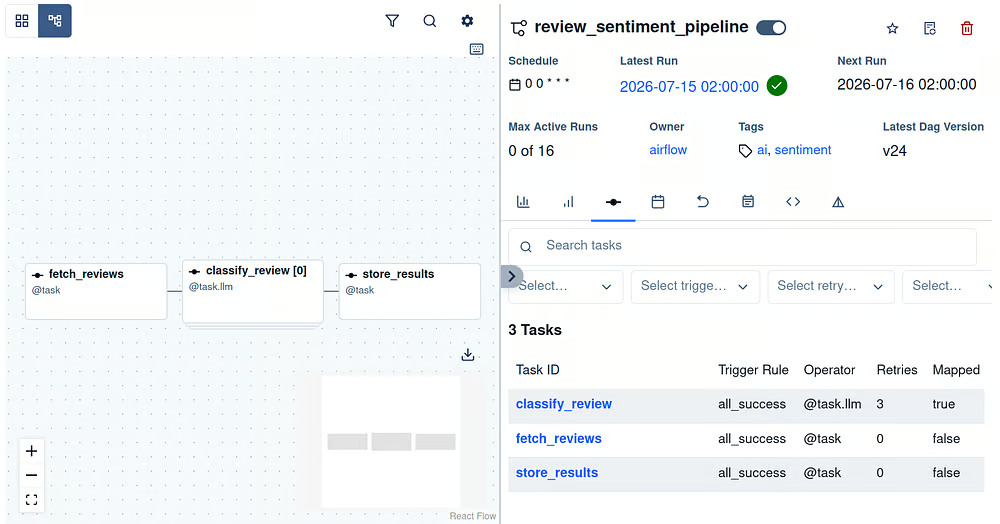
Giao diện Airflow hiển thị ba tác vụ trong pipeline của chúng ta. Bảng điều khiển dưới bên phải hiển thị thuộc tính của từng tác vụ, gồm tên, quy tắc kích hoạt, operator hoặc decorator, và số lần thử lại.
Cuối cùng, trong những ngày tới, giao diện Airflow sẽ bắt đầu lấp đầy bằng các lượt chạy tự động hàng ngày, cung cấp lịch sử rõ ràng về thời điểm pipeline chạy và mỗi lần thực thi có thành công hay không:
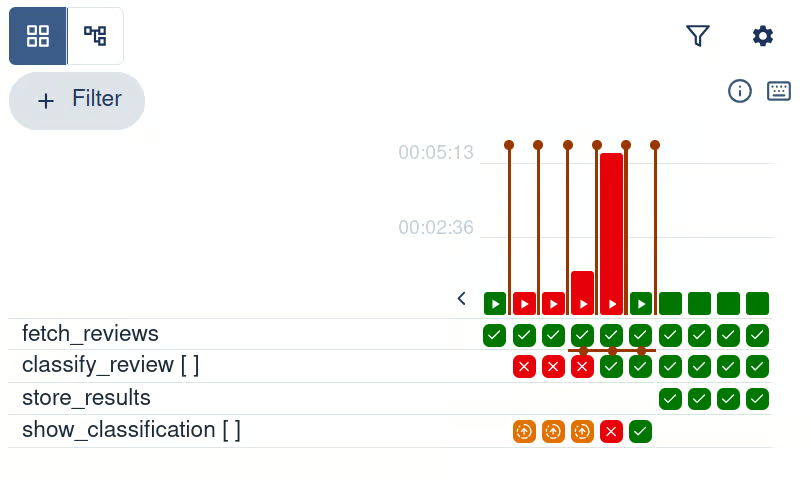
Giao diện Airflow hiển thị các lần chạy pipeline và trạng thái của chúng. Sau Bước 3, pipeline ngừng dùng show_classification và chạy store_results thay thế.
Pipeline của chúng ta giờ đã lấy đánh giá, phân loại bằng LLM và lưu kết quả theo lịch hàng ngày.
Airflow 3 cũng hỗ trợ các mẫu nâng cao hơn giúp luồng AI phản hồi nhanh và dễ giám sát hơn.
Thay vì chạy pipeline vào thời điểm cố định mỗi ngày, Airflow có thể khởi động khi có sự kiện bên ngoài xảy ra.
Ví dụ, pipeline đánh giá có thể chạy bất cứ khi nào một tệp đánh giá mới được tải lên object storage hoặc một thông điệp đến hàng đợi.
Airflow 3 hỗ trợ lập lịch theo sự kiện thông qua assets và các trigger tương thích sự kiện. Điều này loại bỏ nhu cầu kiểm tra lặp lại dữ liệu mới và cho phép pipeline phản ứng ngay khi phát hiện sự kiện.
Không phải mọi quyết định của mô hình đều nên tự động chấp nhận.
Một số đánh giá có thể mơ hồ, nhạy cảm, hoặc cần phán đoán của con người. Human-in-the-loop operators của Airflow có thể tạm dừng một luồng công việc đang chạy và yêu cầu đầu vào thông qua giao diện Airflow.
Người rà soát có thể phê duyệt hoặc từ chối kết quả, cung cấp thông tin, hoặc chọn nhánh nào của luồng công việc sẽ tiếp tục.
Common AI provider cũng hỗ trợ mẫu rà soát tương tác cho các workflow tác tử, nơi người rà soát có thể phê duyệt, từ chối hoặc yêu cầu chỉnh sửa kết quả do LLM tạo.
Kết hợp lập lịch theo sự kiện và rà soát của con người cho phép xây dựng pipeline AI phản ứng nhanh mà vẫn không bỏ qua giám sát của con người ở những nơi quan trọng.
Để tìm hiểu thêm về các tính năng của Airflow 3.0, tôi khuyến nghị xem hướng dẫn riêng của chúng tôi.
Trong bài viết này, chúng ta đã xây dựng một pipeline AI hoàn chỉnh với Apache Airflow.
Pipeline lấy đánh giá của khách hàng, phân loại từng đánh giá bằng LLM và lưu kết quả cuối cùng vào tệp JSON có cấu trúc.
Trong quá trình đó, chúng ta đã thấy cách Airflow biến các hàm Python thành các tác vụ có lịch trình và có thể quan sát. Điều này đặc biệt hữu ích với luồng AI, nơi giới hạn API, hết thời gian chờ của mô hình và đầu ra bất ngờ có thể xảy ra.
Với phụ thuộc giữa tác vụ, ánh xạ tác vụ động, thử lại, log và giao diện Airflow, chúng ta có thể làm cho pipeline AI dễ giám sát, gỡ lỗi và khôi phục hơn.
Ví dụ đã dùng tệp cục bộ để đơn giản, nhưng cùng cấu trúc có thể mở rộng sang API, cơ sở dữ liệu, luồng công việc theo sự kiện và rà soát có con người tham gia.
Nếu bạn sẵn sàng khám phá tiếp, tôi khuyến nghị bắt đầu với khóa Giới thiệu Apache Airflow bằng Python, rồi chuyển sang Xây dựng Data Pipeline với Airflow để thực hành nhiều hơn.
Cho lộ trình học rộng hơn, lộ trình Data Engineer bằng Python bao quát bộ kỹ năng rộng hơn cần để xây dựng và quản lý pipeline dữ liệu trên production.
Các khóa học hàng đầu trên DataCamp
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Lộ trình} other {Lộ trình}}
{count, plural, one {blog} other {blog}}
Matt Crabtree
10 phút

