Última chance! Formação ilimitada com 50% de desconto
A promoção termina em
Prototipar com IA é fácil de começar. Um notebook, uma chave de API e algumas linhas de Python já podem bastar para classificar textos, resumir documentos ou gerar recomendações.
Mas manter esse protótipo rodando com confiabilidade todos os dias é outro desafio.
O que acontece quando a API do modelo atinge o rate limit? E se uma requisição expirar, a saída não seguir o formato esperado ou um banco de dados a jusante ficar temporariamente indisponível?
Quando um pipeline de IA vira um fluxo recorrente, confiabilidade, monitoramento e recuperação rapidamente se tornam tão importantes quanto o próprio modelo.
Neste artigo, vou mostrar como construir um pipeline completo de IA com Apache Airflow, uma plataforma open source para desenvolver, agendar e monitorar workflows.
Nosso pipeline vai rodar diariamente, buscando avaliações de clientes, classificando o sentimento com um large language model (LLM) e gravando os resultados. Tudo de forma confiável em um único fluxo!
Um notebook Jupyter é ótimo para experimentação. A gente adora notebooks para testar ideias, escrever códigos rápidos e visualizar resultados no caminho.
Um cron job muitas vezes basta para rodar um script simples todas as noites. Embora, sendo sinceros, muitos scripts ficam semanas sendo executados manualmente até alguém finalmente agendá-los direito.
Os problemas começam quando um script vira vários, e esses scripts passam a depender uns dos outros. Nesse ponto, já não temos um programa isolado: temos um workflow.
Nem notebooks nem cron jobs foram feitos para gerenciar workflows complexos com confiabilidade.
As dependências costumam ficar escondidas no código, falhas exigem investigação manual e reexecutar o pipeline pode significar repetir etapas que já tinham dado certo.
Já vemos parte dessa complexidade em pipelines tradicionais de ETL (Extract-Transform-Load). Workflows de ETL podem precisar buscar dados, transformá-los, validá-los e carregá-los em outro sistema.
Mesmo quando entradas e transformações são previsíveis, cada etapa adicional cria um novo ponto potencial de falha. Hoje, pipelines de IA tornam esse desafio ainda mais evidente.
Se você quer se aprofundar especificamente em pipelines de ETL, recomendo este curso sobre pipelines de ETL no Airflow.
Considere um fluxo típico de IA: coletar dados, limpá-los, chamar a API de um modelo, validar a resposta, armazenar o resultado e avisar alguém quando algo der errado.
Cada etapa depende da anterior e pode falhar de jeitos diferentes: uma API pode retornar erro de rate limit. Uma requisição ao modelo pode expirar. Uma resposta gerada pode ser um JSON válido e ainda assim reprovar em uma checagem de qualidade.
As saídas também podem estar incompletas, inconsistentes ou com um formato diferente do esperado pela próxima etapa.
O Airflow não elimina essas falhas, mas torna sua gestão muito mais fácil.
Com Airflow, uma tarefa que chama um LLM pode tentar novamente após uma resposta temporária de rate limit sem reexecutar a etapa de ingestão de dados. Uma tarefa de validação pode rejeitar um resultado malformado ou de baixa qualidade antes de chegar à produção. Alertas podem notificar o time só depois que as tentativas configuradas se esgotarem.
O Airflow viabiliza isso ao representar o workflow como um grafo acíclico direcionado (DAG).
Em vez de esconder o pipeline inteiro dentro de um script longo, um DAG define cada operação como uma tarefa separada com dependências explícitas, políticas de retry, logs e status de execução.
Esse é o principal motivo de o Airflow se encaixar tão bem em pipelines de IA: ele trata falhas como parte esperada do workflow, e não como surpresa excepcional.
À medida que um experimento cresce e vira um processo recorrente em produção, o Airflow entrega a camada de orquestração necessária para torná-lo observável, recuperável e mais fácil de manter.
Antes de construir nosso pipeline, vamos preparar o ambiente.
Precisamos de três passos rápidos para deixar o ambiente pronto.
Para este tutorial, vamos rodar o Airflow localmente.
Essa configuração é prática para aprendizado e desenvolvimento porque um único comando inicializa o banco de metadados e inicia os serviços necessários para usar o Airflow.
Primeiro, vamos criar e ativar um ambiente virtual para manter o Airflow e suas dependências isolados do restante da sua instalação do Python:
python3 -m venv ~/airflow-venv
source ~/airflow-venv/bin/activate
Em seguida, precisamos instalar o Airflow 3 usando version pinning e o arquivo oficial de constraints:
AIRFLOW_VERSION=3.3.0
PYTHON_VERSION="$(python -c 'import sys; print(f"{sys.version_info.major}.{sys.version_info.minor}")')"

CONSTRAINT_URL="https://raw.githubusercontent.com/apache/airflow/constraints-${AIRFLOW_VERSION}/constraints-${PYTHON_VERSION}.txt"

pip install "apache-airflow==${AIRFLOW_VERSION}" \
 --constraint "${CONSTRAINT_URL}"
Note que o Airflow depende de muitos pacotes Python, e esses pacotes têm suas próprias dependências. Sem o arquivo de constraints, o pip pode escolher versões mais novas ou incompatíveis.
A instalação pode até parecer funcionar, mas o Airflow pode falhar depois ao importar providers, iniciar serviços ou executar tarefas. O guia oficial de instalação do Airflow recomenda usar arquivos de constraints para instalar um conjunto de dependências sabidamente compatível.
Como nosso workflow vai chamar um LLM, também precisamos do Common AI provider do Airflow e da dependência OpenAI para Pydantic AI:
pip install \
 "apache-airflow-providers-common-ai" \
 "pydantic-ai-slim[openai]"
Agora vamos configurar a conexão com a OpenAI. O Airflow usa conexões para armazenar credenciais e configurações fora do código do DAG. Isso deixa o arquivo Python mais limpo e evita colocar segredos no pipeline.
Depois de validar a instalação, é hora de definir a chave da OpenAI para permitir a comunicação real com o modelo. Há várias formas de fazer isso.
Minha opção preferida é:
export OPENAI_API_KEY="your-openai-api-key"airflow connections add pydanticai_default \
--conn-type pydanticai \
--conn-password "$OPENAI_API_KEY" \
--conn-extra '{"model":"openai:gpt-4o-mini"}'O Common AI provider usa o tipo de conexão pydanticai para se comunicar com provedores de LLM via Pydantic AI.
Esse comando armazena a conexão no banco de metadados do Airflow, então depois disso você não precisa manter o arquivo .env nem passar a chave toda vez que iniciar o Airflow.
airflow standaloneMantenha este terminal aberto enquanto o Airflow estiver rodando. O modo Standalone é ideal para desenvolvimento local e tutoriais, mas não é indicado para produção.
Para acessar a interface do Airflow, agora podemos abrir http://localhost:8080 no navegador. A primeira coisa que veremos é a página de login. Mas qual usuário e senha usar?
Visão de login do Apache Airflow.
Quando o Airflow inicia em modo standalone, ele gera as credenciais automaticamente. O usuário e a senha são impressos na saída do terminal e também ficam em $AIRFLOW_HOME/simple_auth_manager_passwords.json.generated.
Por padrão, AIRFLOW_HOME é ~/airflow, então podemos recuperar as credenciais com:
cat ~/airflow/simple_auth_manager_passwords.json.generatedCom essas credenciais, conseguimos entrar na interface do Airflow.
Após o login, o Airflow abre na Home. Essa visão traz um panorama rápido do ambiente local do Airflow.
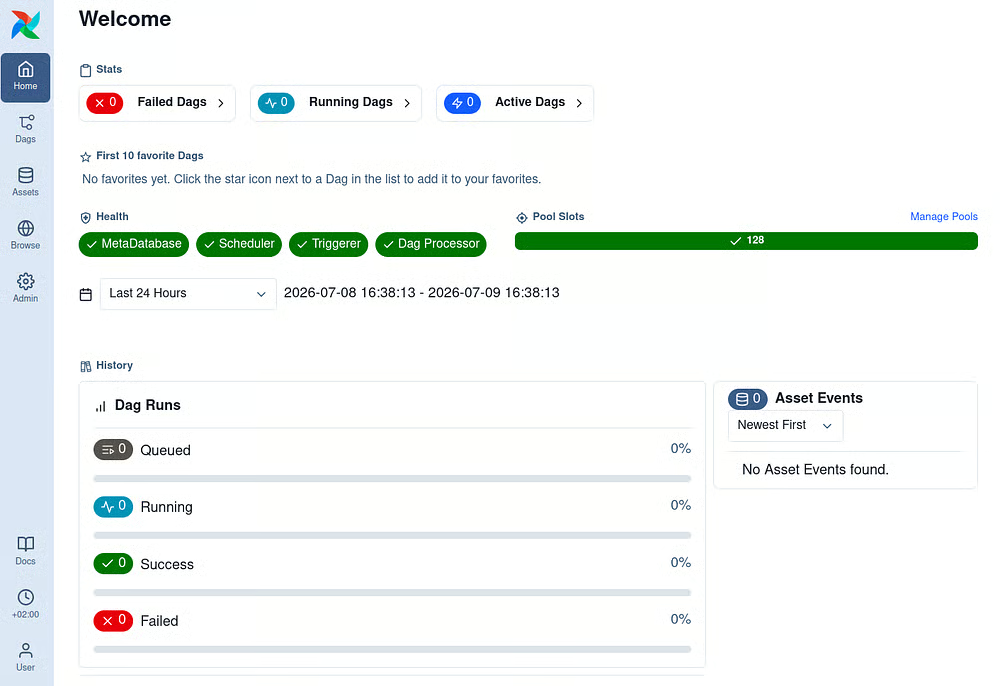
Interface do Airflow após o primeiro login.
No topo, os cards de Stats resumem o estado atual dos seus DAGs, incluindo workflows com falha, em execução e ativos.
Como ainda não criamos nosso pipeline, esses valores podem estar zerados.
A seção Health mostra se os principais serviços do Airflow estão rodando.
Abaixo, a barra Pool Slots exibe a capacidade de execução disponível. Não vamos configurar pools personalizados neste artigo, mas essa área é útil para controlar quantas tarefas podem rodar ao mesmo tempo.
Por fim, a seção History resume as execuções recentes de DAGs. Assim que acionarmos nosso pipeline de sentimento de reviews, essa área começará a mostrar execuções enfileiradas, em execução, bem-sucedidas e com falha.
Com o Airflow rodando, vamos criar os arquivos necessários para o nosso pipeline:
mkdir -p ~/airflow/dags
touch ~/airflow/dags/review_sentiment_pipeline.py
touch ~/airflow/requirements.txt
Em uma instalação local standalone, o Airflow usa ~/airflow como AIRFLOW_HOME por padrão. Vamos colocar nosso arquivo de DAG dentro do diretório dags e manter um requirements.txt para documentar as dependências do projeto.
Assim, o projeto ficará com a seguinte estrutura:
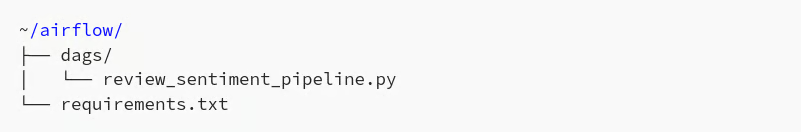
Estrutura mínima de projeto no Airflow.
O arquivo eview_sentiment_pipeline.py conterá a definição do workflow, incluindo as tarefas de buscar reviews, classificar o sentimento e armazenar os resultados.
O Airflow monitora o diretório dags configurado e procura por definições válidas de DAG dentro de arquivos Python. Assim que nosso arquivo tiver um DAG válido, o workflow aparecerá na página Dags na interface do Airflow.
Se você tiver algum percalço nesta etapa inicial, sugiro conferir o tutorial Getting started with Apache Airflow.
Para colocar a mão na massa com Airflow, vamos criar um job diário que processa avaliações de clientes e classifica o sentimento.
Imagine que acabamos de lançar uma plataforma de e-commerce. Os clientes já estão deixando reviews e queremos analisá-los automaticamente todos os dias.
Em vez de rodar um script manualmente, podemos usar o Airflow para orquestrar o workflow.
Vamos supor que os reviews brutos estejam em um arquivo .jsonl.
Cada linha contém um review como um objeto JSON, e novos reviews são adicionados ao final do arquivo ao longo do dia. Em produção, esses dados podem vir de uma API, banco de dados, object storage ou fila de mensagens. Para este tutorial, o arquivo JSONL nos dá uma fonte simples e realista de dados brutos.
Nesse cenário, o primeiro passo do pipeline é carregar esses reviews no Airflow. Começamos com uma função Python comum, como faríamos em um notebook ou script:
REVIEWS_FILE = Path.home() / "airflow" / "data" / "reviews.jsonl"

def fetch_reviews() -> list[dict]:
   """Load raw customer reviews from the JSONL landing file."""
   reviews = []

   with REVIEWS_FILE.open("r", encoding="utf-8") as file:
       for line_number, line in enumerate(file, start=1):
           if not line.strip():
               continue

           try:
               reviews.append(json.loads(line))
           except json.JSONDecodeError as error:
               raise ValueError(
                   f"Invalid JSON on line {line_number}"
               ) from error

   print(f"Fetched {len(reviews)} reviews")
   return reviews
Essa função abre o arquivo JSONL, lê linha a linha, ignora linhas vazias e converte cada objeto JSON em um dicionário Python.
Se alguma linha tiver JSON inválido, a tarefa falha com uma mensagem clara indicando o número da linha.
Até aqui, é Python puro. O próximo passo é transformá-la em uma tarefa do Airflow e colocá-la dentro de um DAG.
Para transformar a função em parte de um workflow no Airflow, precisamos de três peças:
@task. Isso diz ao Airflow que a função é uma tarefa.@dag. O DAG dá nome, agenda, data de início e outras configurações ao workflow.Aqui vai a versão mínima:
from airflow.sdk import dag

@dag(    fetch_reviews()
   dag_id="fetch_reviews_pipeline",
)

def fetch_reviews_pipeline():
   fetch_reviews()

fetch_reviews_pipeline()
Observe que esse DAG ainda não será executado automaticamente.
Como está escrito, precisaríamos acioná-lo manualmente pela interface do Airflow. Para configurar quando o workflow deve rodar, podemos adicionar parâmetros de agendamento na definição do DAG. Uma opção seria:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
Vamos destrinchar!
dag_id dá um nome único ao DAG no Airflow.schedule="@daily" executa o DAG uma vez por dia.start_date indica quando a programação pode começar.catchup=False impede o Airflow de criar execuções para datas passadas.tags ajudam a organizar e filtrar o DAG na interface do Airflow.Depois de definir o DAG, podemos ir à UI e ver como isso fica na prática:
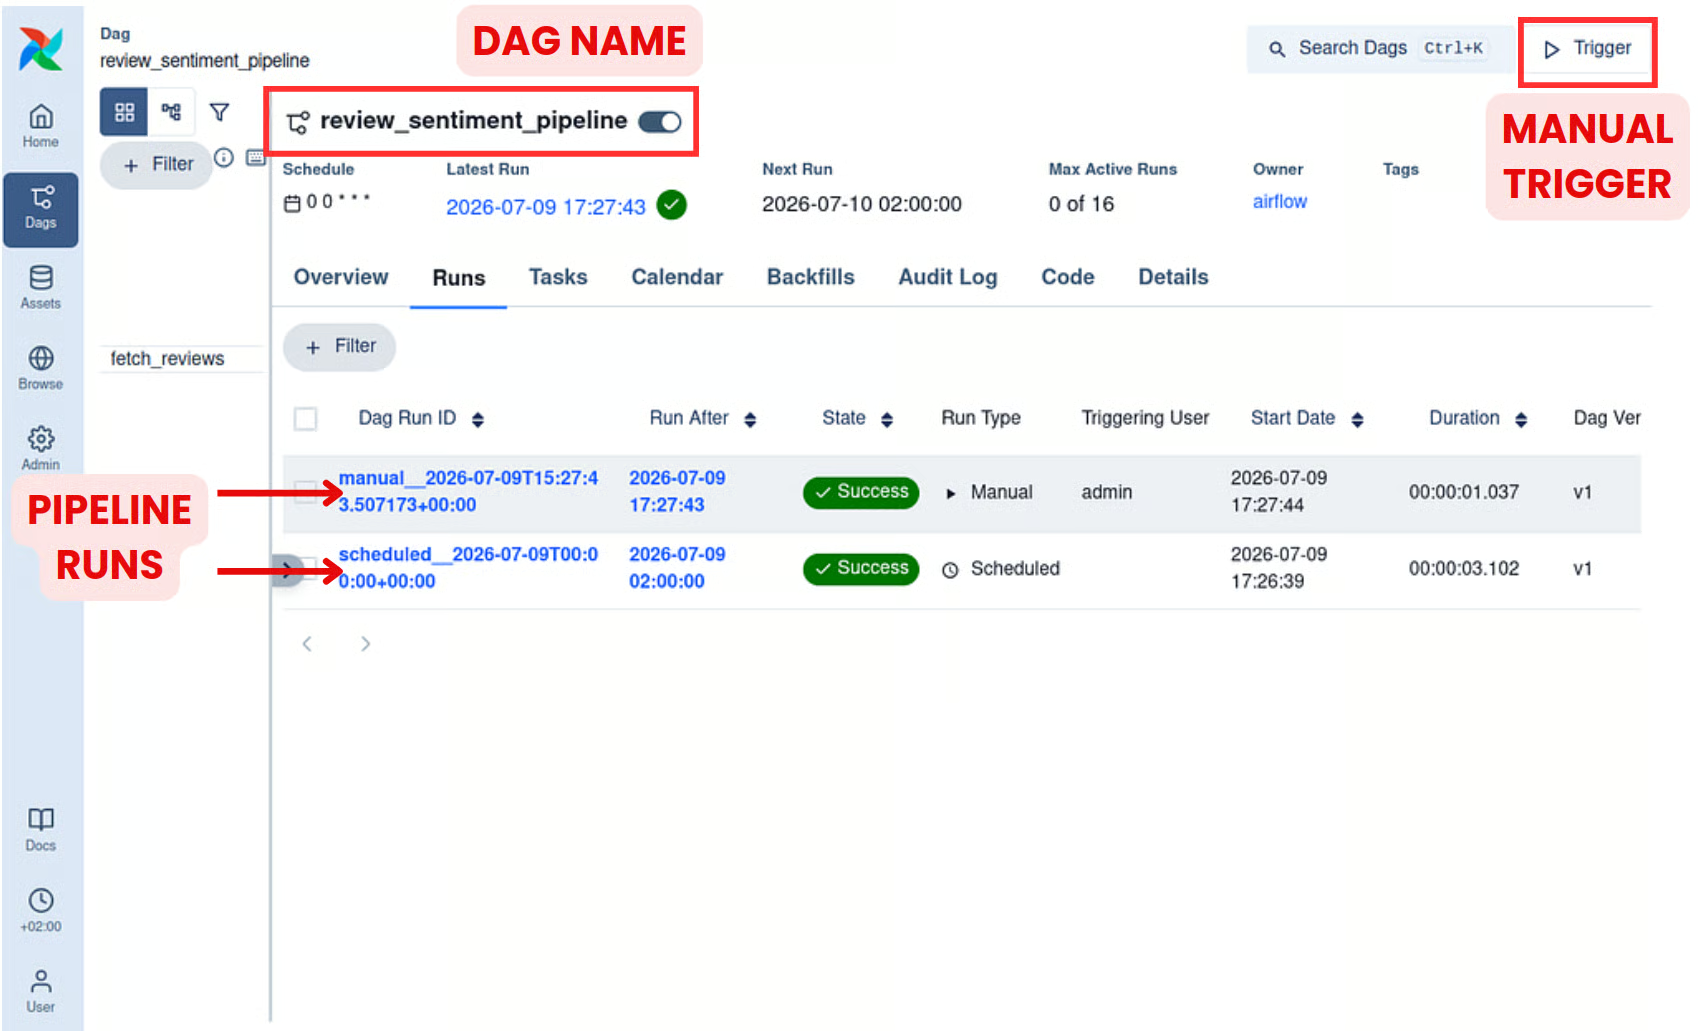
Interface do Airflow com nosso pipeline review_sentiment_pipeline. Note os dois tipos de execução (agendada e manual) e o botão Trigger manual.
Na interface, vemos que o Airflow descobriu automaticamente o DAG chamado review_sentiment_pipeline.
Também dá para ver que ele rodou conforme a agenda e que acionamos uma execução adicional manualmente usando o botão Trigger no canto superior direito.
Um recurso bacana é a visualização em calendário, onde o Airflow registra as execuções do pipeline junto com o status de cada uma:
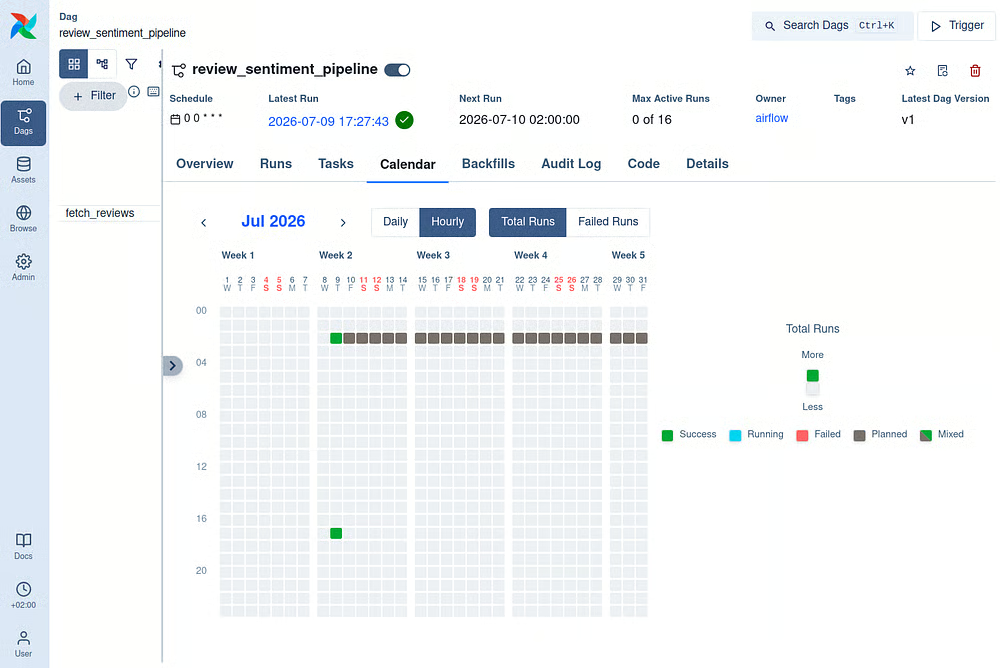
Visão em calendário do nosso pipeline no Airflow com execuções agendadas e manuais.
Fique à vontade para pausar a leitura e explorar a interface do Airflow!
Com os reviews carregados, o próximo passo é classificar o sentimento. Para isso, vamos usar @task.llm, um decorator que transforma uma chamada a LLM em uma tarefa nativa do Airflow.
Poderíamos chamar a API da OpenAI manualmente dentro de um @task comum, mas @task.llm oferece uma integração mais limpa.
Ele cuida de detalhes específicos de LLM como conexão com o modelo, system prompt, saída estruturada e serialização do resultado. Ao mesmo tempo, a tarefa continua se beneficiando dos recursos padrão do Airflow, como retries, logging, monitoramento e gestão de dependências.
Esse segundo passo tem algumas peças além da tarefa em si, então vamos construí-lo aos poucos:
from typing import Literal
from pydantic import BaseModel

class ReviewClassification(BaseModel):
   """Structured result returned by the LLM."""

   review_id: str
   sentiment: Literal["positive", "neutral", "negative"]
Isso informa à tarefa LLM que cada resposta deve conter o ID do review e um dos três rótulos de sentimento: positive, neutral ou negative.
@task.llm(
   llm_conn_id="pydanticai_default",
   system_prompt=(
       "Classify the customer review as positive, neutral, or negative. "
       "Use both the written review and the star rating as context. "
       "Return the review ID and sentiment."
   ),
   output_type=ReviewClassification,
   serialize_output=True,
   retries=3,
)
def classify_review(review: dict) -> str:
   """Build the prompt sent to the LLM."""
   return (
       f"Review ID: {review['review_id']}\n"
       f"Product: {review['product']}\n"
       f"Rating: {review['rating']} out of 5 stars\n"
       f"Review: {review['review_text']}"
   )
O corpo da função retorna um prompt em string, enquanto o decorator @task.llm cuida de enviar esse prompt ao modelo usando a conexão pydanticai_default que configuramos.
O system_prompt dá a instrução ao modelo, enquanto output_type=ReviewClassification pede uma resposta estruturada. Também definimos serialize_output=True para o Airflow armazenar o resultado como dicionário simples, facilitando o repasse para as próximas tarefas.
Quer ver tarefas que exigem inferência de LLM? Considere este curso de LangChain para aplicações mais avançadas!
A tarefa de classificação retorna um resultado estruturado, mas durante o desenvolvimento é útil ver o que o modelo produziu sem esperar até a etapa final de armazenamento.
Na prática, uma etapa do pipeline pode ser composta por mais de uma tarefa no Airflow.
Neste caso, vamos adicionar uma pequena tarefa que imprime cada classificação nos logs do Airflow:
@task
def show_classification(classification: dict) -> dict:
   """Print one model classification to the Airflow task logs."""
   print(
       f"Review {classification['review_id']}: "
       f"{classification['sentiment']}"
   )

   return classification
Essa tarefa não altera o resultado. Ela apenas registra a saída do modelo e retorna o mesmo dicionário, para que a classificação siga para a próxima etapa do pipeline.
3. Por fim, precisamos conectar as novas tarefas dentro da função do DAG:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
def review_sentiment_pipeline():
   reviews = fetch_reviews()

   classifications = classify_review.expand(
       review=reviews
   )

   displayed_classifications = show_classification.expand(
       classification=classifications
   )

review_sentiment_pipeline()Observação: Neste pipeline, usamos mapeamento dinâmico de tarefas com .expand(review=reviews). Isso instrui o Airflow a criar uma instância de classify_review para cada review, enviando cada um em uma requisição separada ao LLM.
Geralmente isso é melhor do que mandar a lista inteira para uma única tarefa de LLM. Uma chamada como classify_reviews(reviews) processaria tudo junto, o que dificulta debug, torna os retries menos precisos e aumenta a chance de estourar o contexto do modelo ou limites da API.
Antes de finalizar o segundo passo, podemos voltar à UI do Airflow e visualizar como o workflow evoluiu.
Agora o DAG contém três tarefas: fetch_reviews, classify_review e show_classification:
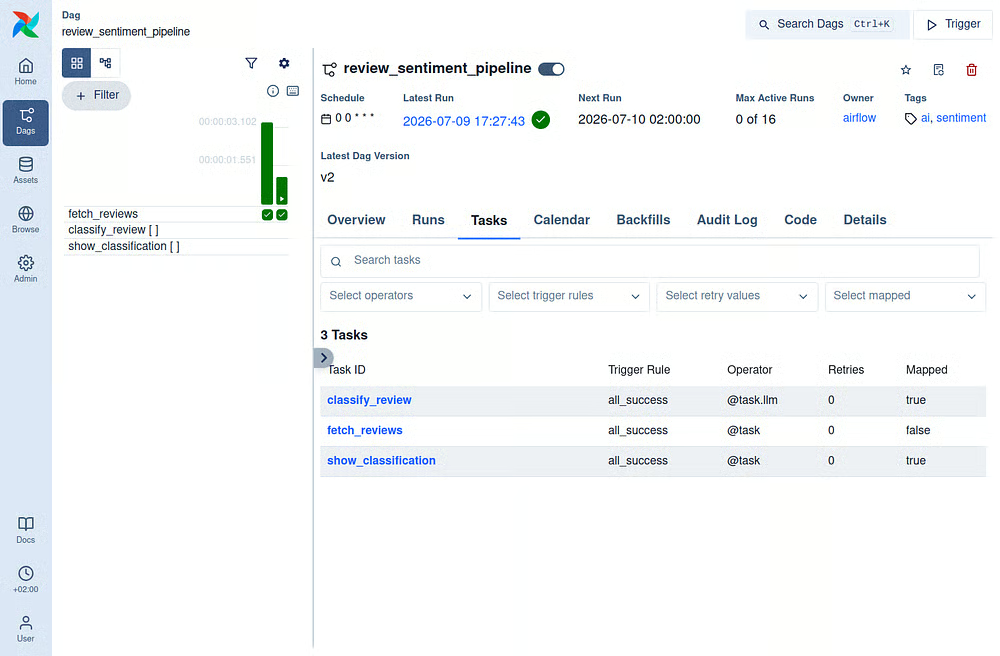
Interface do Airflow com as três tarefas do nosso DAG review_sentiment_pipeline.
Como usamos mapeamento dinâmico, o Airflow envia uma requisição ao LLM por review. Isso é útil porque cada review é acompanhado de forma independente:
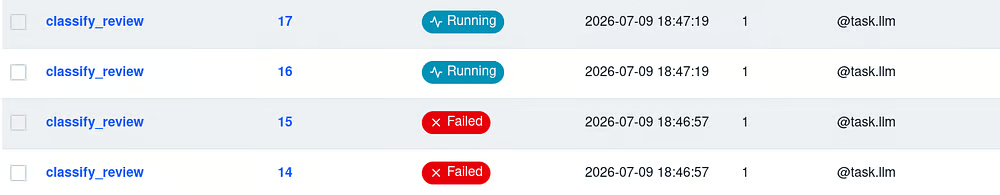
Interface do Airflow mostrando reviews sendo classificados de forma independente. Algumas tarefas já concluíram ou falharam, enquanto outras ainda estão rodando.
Requisições a LLM podem falhar por motivos como rate limit da API, problemas de rede ou timeouts do modelo.
Em vez de derrubar todo o pipeline na hora, podemos pedir ao Airflow para tentar novamente automaticamente a tarefa afetada.
Vamos adicionar esse recurso!
from datetime import timedelta

@task.llm(
   llm_conn_id="pydanticai_default",
   system_prompt=(
       "Classify the customer review as positive, neutral, or negative. "
       "Use both the written review and the star rating as context. "
       "Return the review ID and sentiment."
   ),
   output_type=ReviewClassification,
   serialize_output=True,
   retries=3,
   retry_delay=timedelta(seconds=30),
   retry_exponential_backoff=True,
   max_retry_delay=timedelta(minutes=5),
)
Aqui, retries=3 permite até três tentativas adicionais após a primeira falha.
A primeira repetição espera 30 segundos, e o backoff exponencial aumenta o intervalo entre as tentativas seguintes, até um máximo de cinco minutos.
A parte boa é que o Airflow repete apenas a tarefa mapeada que falhou.
Se 49 reviews foram classificados com sucesso e uma requisição falhou, só esse review com falha é agendado para retry. O restante do pipeline não precisa refazer o que já deu certo.
Depois de um tempo, as classificações que falharam voltarão a ser tentadas:
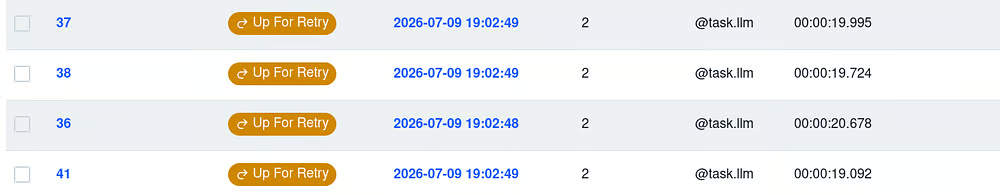
Interface do Airflow mostrando todas as tarefas de classificação de reviews com falha aguardando retry.
Quando a classificação do review for bem-sucedida, cada instância mapeada de show_classification() exibirá a resposta do modelo para um review em seus próprios logs.
Isso significa que a etapa de exibição também é independente: você pode abrir, inspecionar ou depurar a saída de um review independentemente do estado dos demais.
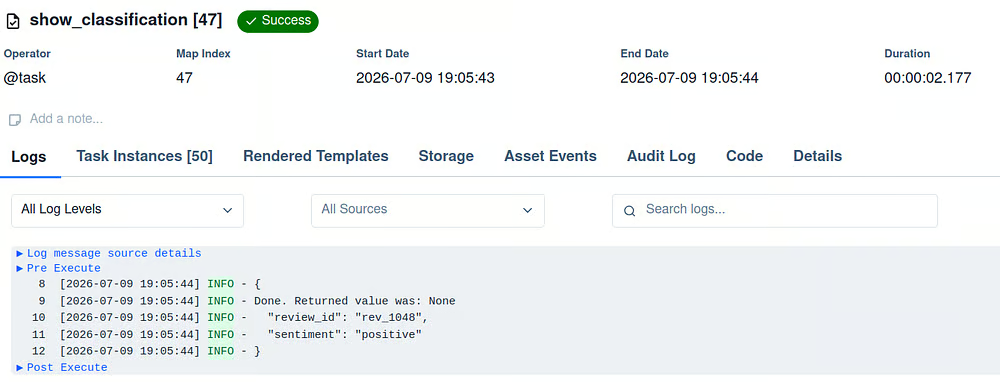
Interface do Airflow com a classificação de sentimento do LLM para o review 47.
Imprimir cada classificação é útil durante o desenvolvimento do DAG, pois permite inspecionar rapidamente as respostas do modelo nos logs do Airflow.
Mas logs não são um lugar confiável para armazenar resultados de pipeline. Eles são mais difíceis de consultar, reutilizar e integrar com sistemas a jusante.
O passo final, portanto, é coletar as classificações e gravá-las em uma saída estruturada.
Para este artigo, vamos remover a chamada a show_classification() e armazenar os resultados em um arquivo JSON local.
Em um pipeline de produção, essa tarefa normalmente escreveria em um banco de dados, data warehouse ou object store.
Uma possível implementação para este novo @task seria:
OUTPUT_FILE = (
   Path.home()
   / "airflow"
   / "output"
   / "classified_reviews.json"
)

@task
def store_results(results: list[dict]) -> str:
   """Write all classified reviews to a local JSON file."""
   OUTPUT_FILE.parent.mkdir(parents=True, exist_ok=True)

   classifications = list(results)

   with OUTPUT_FILE.open("w", encoding="utf-8") as file:
       json.dump(
           classifications,
           file,
           indent=2,
           ensure_ascii=False,
       )

   print(
       f"Stored {len(classifications)} classifications "
       f"in {OUTPUT_FILE}"
   )

   return str(OUTPUT_FILE)
Essa tarefa é nossa etapa de carga.
Ela recebe as classificações geradas pelo LLM, cria a pasta de saída se necessário e grava tudo em um arquivo JSON local.
A pequena conversão list(results) é útil porque as classificações vêm de tarefas mapeadas.
O Airflow coleta essas saídas mapeadas para nós, e essa tarefa as transforma em uma lista comum antes de salvar. Agora só precisamos conectar a tarefa dentro do DAG chamando store_results(classifications).
Com essa linha, o Airflow sabe que store_results() depende da etapa de classificação. Ou seja, o arquivo de saída só é escrito depois que todas as classificações terminarem com sucesso.
Com as três etapas conectadas, o DAG completo agora busca os reviews, cria uma tarefa de LLM para cada review e armazena os resultados consolidados.
Dentro da função do DAG, o pipeline fica assim:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
def review_sentiment_pipeline():
   reviews = fetch_reviews()
   classifications = classify_review.expand(
       review=reviews
   )
   store_results(classifications)

review_sentiment_pipeline()
Depois de salvar o arquivo, o Airflow levará alguns segundos para analisá-lo e descobrir o DAG completo. Assim que review_sentiment_pipeline aparecer na lista, habilite-o no toggle e clique em Trigger para iniciar uma execução manual.
Isso nos permite testar o pipeline completo na hora, sem esperar a próxima execução diária agendada. Quando a execução terminar com sucesso, o arquivo JSON final estará disponível localmente em ~/airflow/output/classified_reviews.json.
O JSON de saída é o artefato durável do workflow, que pode ser reutilizado fora do DAG ou enviado a sistemas a jusante depois.
Já a interface do Airflow nos dá a visão operacional do pipeline: quais tarefas rodaram, quais falharam ou tiveram sucesso e onde inspecionar os logs.
O pipeline final está abaixo:
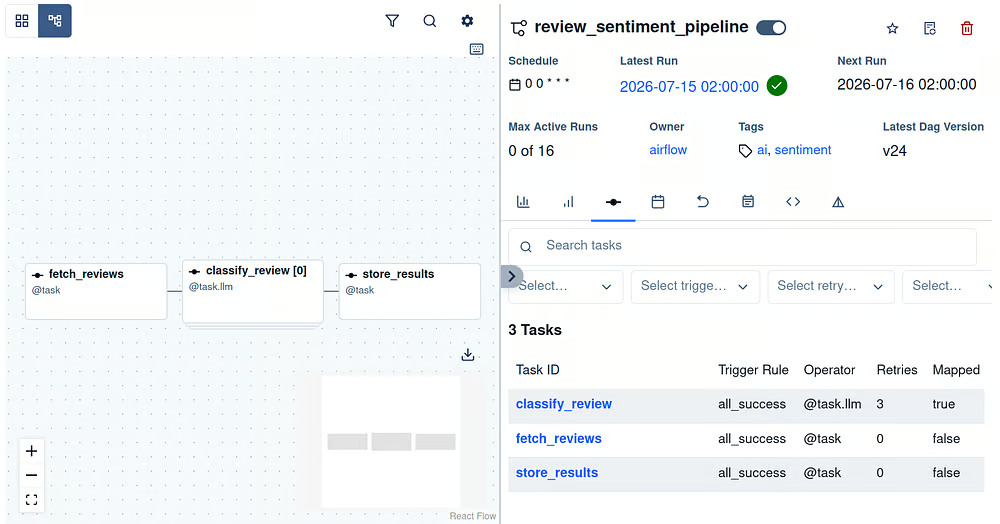
Interface do Airflow com as três tarefas do nosso pipeline. O painel inferior direito exibe as propriedades de cada tarefa, incluindo nome, regra de disparo, operador/decorator e número de retries.
Por fim, nos próximos dias, a interface do Airflow vai se preenchendo com as execuções diárias automáticas, dando um histórico claro de quando o pipeline rodou e se cada execução teve sucesso:
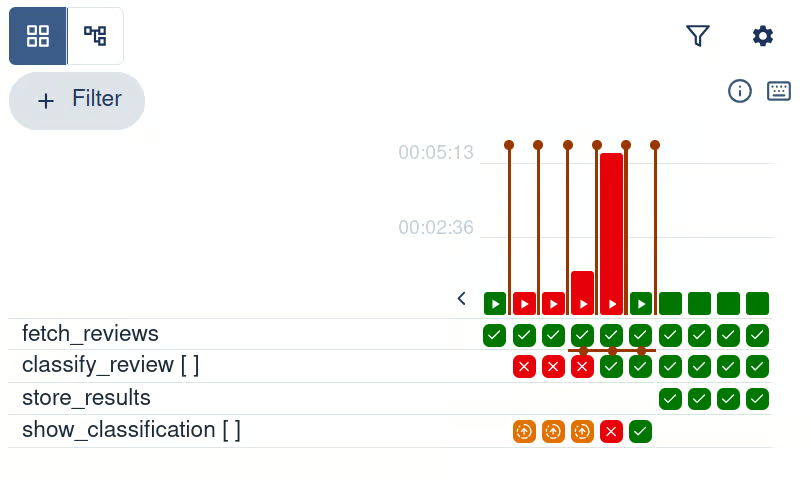
Interface do Airflow com as execuções do pipeline e seus estados. Após o Passo 3, o pipeline deixa de usar show_classification e passa a rodar store_results.
Nosso pipeline agora busca reviews, classifica com um LLM e armazena os resultados em agenda diária.
O Airflow 3 também suporta padrões mais avançados que tornam workflows de IA mais responsivos e fáceis de supervisionar.
Em vez de rodar o pipeline em um horário fixo todo dia, o Airflow pode iniciá-lo quando um evento externo ocorrer.
Por exemplo, o pipeline de reviews pode rodar sempre que um novo arquivo de reviews for enviado ao object storage ou quando chegar uma mensagem em uma fila.
O Airflow 3 dá suporte a agendamento orientado a eventos por meio de assets e triggers compatíveis. Isso evita ficar checando por novos dados o tempo todo e permite que o pipeline reaja assim que um evento for detectado.
Nem toda decisão do modelo deve ser aceita automaticamente.
Alguns reviews podem ser ambíguos, sensíveis ou exigir julgamento humano. Os operadores de human-in-the-loop do Airflow podem pausar um workflow em execução e solicitar input pela interface do Airflow.
Um revisor pode aprovar ou rejeitar um resultado, fornecer informações ou escolher qual ramificação do workflow deve continuar.
O Common AI provider também suporta padrões de revisão interativa para workflows com agentes, onde um revisor pode aprovar, rejeitar ou pedir ajustes a um resultado gerado por LLM.
Juntos, agendamento por eventos e revisão humana permitem construir pipelines de IA que reagem rápido sem abrir mão da supervisão humana onde importa.
Para saber mais sobre os recursos do Airflow 3.0, confira nosso guia dedicado.
Neste artigo, construímos um pipeline completo de IA com Apache Airflow.
O pipeline busca avaliações de clientes, classifica cada review com um LLM e armazena os resultados finais em um arquivo JSON estruturado.
No caminho, vimos como o Airflow transforma funções Python em tarefas agendadas e observáveis. Isso é especialmente útil em workflows de IA, onde limites de API, timeouts de modelo e saídas inesperadas podem acontecer.
Com dependências entre tarefas, mapeamento dinâmico, retries, logs e a interface do Airflow, conseguimos tornar pipelines de IA mais fáceis de monitorar, depurar e recuperar.
O exemplo usou arquivos locais para simplificar, mas a mesma estrutura se estende para APIs, bancos de dados, workflows orientados a eventos e revisão com participação humana.
Se você quer continuar explorando, recomendo começar pelo nosso curso Introduction to Apache Airflow in Python e depois seguir para Building Data Pipelines with Airflow para praticar mais.
Para uma trilha mais ampla, a carreira Data Engineer in Python cobre o conjunto de habilidades necessário para construir e gerenciar pipelines de dados em produção.
Principais cursos da DataCamp
Curso
Curso
Programa
blog
Javier Canales Luna
9 min
Tutorial
Zoumana Keita
8 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
12 min
Tutorial