

Cursus
Introductie tot Apache Airflow in Python
4 uur
65.3K
Oefen en volg je voortgang.
Ga Verder Met GoogleAI-prototypes zijn makkelijk om mee te beginnen. Een notebook, een API-sleutel en een paar regels Python kunnen genoeg zijn om tekst te classificeren, documenten samen te vatten of aanbevelingen te genereren.
Maar zo'n prototype elke dag betrouwbaar laten draaien is een heel andere uitdaging.
Wat gebeurt er als de model-API zijn rate limit bereikt? Wat als een verzoek time-out, de output niet het verwachte formaat volgt of een downstream database tijdelijk niet beschikbaar is?
Zodra een AI-pijplijn een terugkerende workflow wordt, zijn betrouwbaarheid, monitoring en herstel net zo belangrijk als het model zelf.
In dit artikel laat ik je zien hoe je een complete AI-pijplijn bouwt met Apache Airflow, een open-sourceplatform voor het ontwikkelen, plannen en monitoren van workflows.
Onze pijplijn draait dagelijks, haalt klantbeoordelingen op, classificeert hun sentiment met een large language model (LLM) en slaat de resultaten op. Alles betrouwbaar in één workflow!
Een Jupyter-notebook is geweldig om te experimenteren. We zijn allemaal dol op notebooks om ideeën te testen, snel code te schrijven en resultaten te visualiseren terwijl we bezig zijn.
Een cronjob is vaak genoeg om elke nacht een simpel script te draaien. Al moeten we eerlijk zijn: veel scripts worden wekenlang handmatig uitgevoerd voordat iemand ze eindelijk een fatsoenlijk schema geeft.
De problemen beginnen wanneer één script uitgroeit tot meerdere scripts, en die scripts van elkaar afhankelijk worden. Op dat punt hebben we geen losstaand programma meer: we hebben een workflow.
Noch notebooks, noch cronjobs zijn ontworpen om complexe workflows betrouwbaar te beheren.
Afhankelijkheden zitten vaak verborgen in de code, bij storingen is handmatig onderzoek nodig en de pijplijn opnieuw draaien kan betekenen dat je stappen herhaalt die al succesvol waren voltooid.
We komen een deel van deze complexiteit al tegen in traditionele Extract-Transform-Load (ETL)-pijplijnen. ETL-workflows moeten mogelijk data ophalen, transformeren, valideren en in een ander systeem laden.
Zelfs als de input en transformaties voorspelbaar zijn, creëert elke extra stap een nieuw mogelijk falen. Tegenwoordig maken AI-pijplijnen deze uitdaging nog duidelijker.
Ben je specifiek geïnteresseerd in ETL-pijplijnen? Dan raad ik deze cursus aan over ETL-pijplijnen in Airflow.
Denk aan een typische AI-workflow: data verzamelen, opschonen, een model-API aanroepen, de respons valideren, het resultaat opslaan en iemand waarschuwen als er iets misgaat.
Elke stap is afhankelijk van de vorige en kan op een andere manier falen: een API kan een rate-limitfout teruggeven. Een modelverzoek kan time-out. Een gegenereerde respons kan geldige JSON zijn en toch een kwaliteitscontrole niet doorstaan.
Outputs kunnen ook onvolledig of inconsistent zijn, of anders geformatteerd dan de volgende stap verwacht.
Airflow elimineert deze fouten niet, maar maakt ze wel makkelijker te beheren.
Met Airflow kan een taak die een LLM aanroept, opnieuw proberen na een tijdelijke rate-limitrespons, zonder de data-ingestietaak opnieuw uit te voeren. Een validatietaak kan een verkeerd gevormd of laagwaardig resultaat afwijzen voordat het productie bereikt. Alerts kunnen het team pas waarschuwen nadat de geconfigureerde retries zijn uitgeput.
Airflow maakt dit mogelijk door de workflow weer te geven als een Directed Acyclic Graph (DAG).
In plaats van de hele pijplijn te verbergen in één lang script, definieert een DAG elke bewerking als een aparte taak met expliciete afhankelijkheden, retrybeleid, logs en uitvoeringsstatus.
Dit is de belangrijkste reden waarom Airflow zo goed past bij AI-pijplijnen: het behandelt fouten als een verwacht onderdeel van de workflow, niet als een uitzonderlijke verrassing.
Wanneer een experiment uitgroeit tot een terugkerend productieproces, biedt Airflow de orkestratielaag die nodig is om het observeerbaar, herstelbaar en onderhoudsvriendelijk te maken.
Voordat we onze eigen pijplijn gaan bouwen, richten we de omgeving in.
We moeten drie korte stappen doorlopen om de omgeving in te richten.
Voor deze tutorial draaien we Airflow lokaal.
Deze setup is handig om te leren en te ontwikkelen, omdat één commando de metadatadatabase initialiseert en de services start die nodig zijn om Airflow te gebruiken.
Laten we eerst een virtuele omgeving maken en activeren om Airflow en zijn afhankelijkheden te isoleren van de rest van je Python-installatie:
python3 -m venv ~/airflow-venv
source ~/airflow-venv/bin/activate
Vervolgens moeten we Airflow 3 installeren met version pinning en het officiële constraints-bestand:
AIRFLOW_VERSION=3.3.0
PYTHON_VERSION="$(python -c 'import sys; print(f"{sys.version_info.major}.{sys.version_info.minor}")')"

CONSTRAINT_URL="https://raw.githubusercontent.com/apache/airflow/constraints-${AIRFLOW_VERSION}/constraints-${PYTHON_VERSION}.txt"

pip install "apache-airflow==${AIRFLOW_VERSION}" \
 --constraint "${CONSTRAINT_URL}"
Let op dat Airflow afhankelijk is van veel Python-pakketten, en die pakketten hebben hun eigen afhankelijkheden. Zonder het constraints-bestand kan pip nieuwere of incompatibele pakketversies kiezen.
De installatie lijkt misschien te werken, maar Airflow kan later falen bij het importeren van providers, het starten van services of het uitvoeren van taken. De officiële installatiegids van Airflow raadt aan constraint-bestanden te gebruiken om een bekend-compatibele set afhankelijkheden te installeren.
Omdat onze workflow een LLM aanroept, hebben we ook Airflows Common AI-provider en de OpenAI-afhankelijkheid voor Pydantic AI nodig:
pip install \
 "apache-airflow-providers-common-ai" \
 "pydantic-ai-slim[openai]"
Laten we daarna de OpenAI-verbinding configureren. Airflow gebruikt connections om inloggegevens en verbindingsinstellingen buiten de DAG-code op te slaan. Dit houdt het Python-bestand overzichtelijker en voorkomt hardcodering van secrets in de pijplijn.
Zodra we de installatie hebben gevalideerd, is het tijd om de OpenAI-sleutel in te stellen om daadwerkelijk met het model te kunnen communiceren. Er zijn daar veel opties voor.
Mijn voorkeursoptie is:
export OPENAI_API_KEY="your-openai-api-key"airflow connections add pydanticai_default \
--conn-type pydanticai \
--conn-password "$OPENAI_API_KEY" \
--conn-extra '{"model":"openai:gpt-4o-mini"}'De Common AI-provider gebruikt het pydanticai connection type om met LLM-providers te communiceren via Pydantic AI.
Dit commando slaat de verbinding op in Airflows metadatadatabase, dus daarna hoef je het .env-bestand niet te bewaren of de sleutel opnieuw door te geven telkens wanneer je Airflow start.
airflow standaloneLaat deze terminal open terwijl Airflow draait. Standalone-modus is ideaal voor lokale ontwikkeling en tutorials, maar is niet bedoeld voor productieomgevingen.
Om de Airflow-interface te openen, kunnen we nu http://localhost:8080 in de browser openen. Het eerste wat we zien is de inlogpagina. Maar welke gebruikersnaam en welk wachtwoord moeten we gebruiken?
Inlogweergave van Apache Airflow.
Wanneer Airflow in standalone-modus start, genereert het automatisch inloggegevens. De gebruikersnaam en het wachtwoord worden afgedrukt in de terminaloutput en ook opgeslagen in $AIRFLOW_HOME/simple_auth_manager_passwords.json.generated.
Standaard is AIRFLOW_HOME ~/airflow, dus we kunnen de inloggegevens ophalen met:
cat ~/airflow/simple_auth_manager_passwords.json.generatedMet die inloggegevens kunnen we uiteindelijk inloggen op de Airflow-interface.
Na het inloggen opent Airflow op de Home-pagina. Deze weergave geeft je een snel overzicht van de lokale Airflow-omgeving.
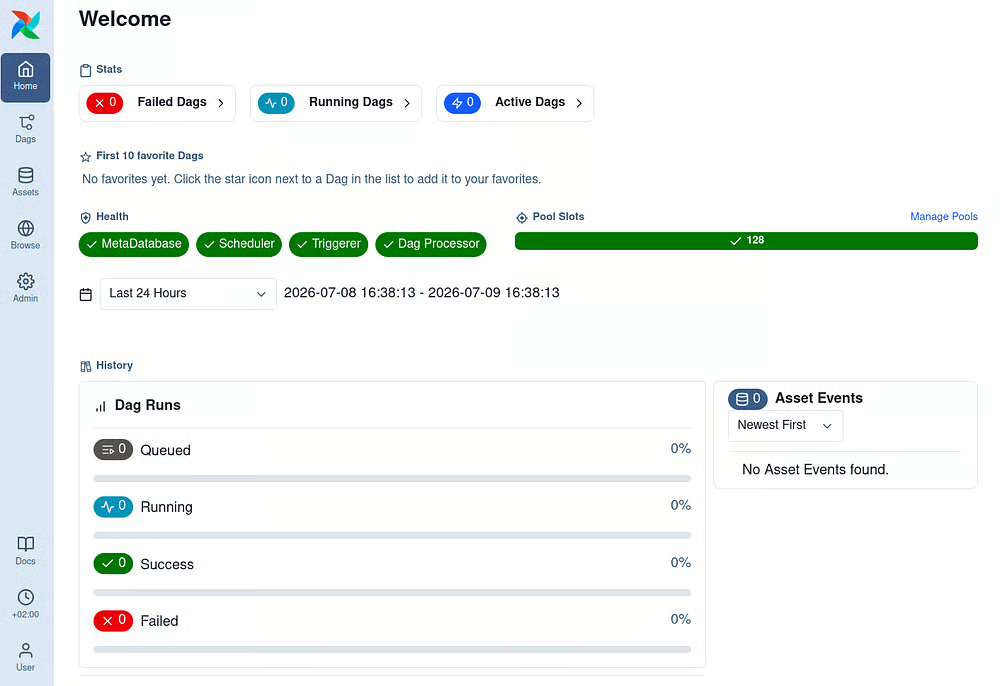
Airflow UI-weergave na de eerste login.
Bovenaan geven de Stats-kaarten een samenvatting van de huidige status van je DAGs, waaronder mislukte, draaiende en actieve workflows.
Omdat we onze pijplijn nog niet hebben gemaakt, kunnen deze waarden nog op nul staan.
De sectie Health laat zien of de belangrijkste Airflow-services draaien.
Daaronder toont de Pool Slots-balk de beschikbare uitvoeringscapaciteit. We configureren in dit artikel geen aangepaste pools, maar dit gebied wordt nuttig wanneer je wilt bepalen hoeveel taken tegelijk mogen draaien.
Tot slot vat de sectie History recente DAG-runs samen. Zodra we onze pijplijn voor reviewsentiment triggeren, begint dit gebied in de wachtrij geplaatste, draaiende, geslaagde en mislukte runs te tonen.
Nu Airflow draait, maken we de benodigde bestanden voor onze pijplijn aan:
mkdir -p ~/airflow/dags
touch ~/airflow/dags/review_sentiment_pipeline.py
touch ~/airflow/requirements.txt
In een lokale standalone-installatie gebruikt Airflow standaard ~/airflow als AIRFLOW_HOME. We plaatsen ons DAG-bestand in de map dags en houden een requirements.txt-bestand bij om de projectafhankelijkheden te documenteren.
Daarom krijgt het project de volgende structuur:
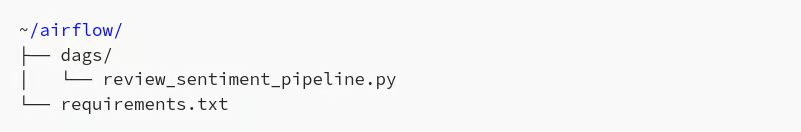
Minimale Airflow-projectstructuur.
Het bestand eview_sentiment_pipeline.py bevat de workflowdefinitie, inclusief de taken voor het ophalen van reviews, het classificeren van hun sentiment en het opslaan van de resultaten.
Airflow monitort de geconfigureerde map dags en zoekt naar geldige DAG-definities in Python-bestanden. Zodra ons bestand een geldige DAG bevat, verschijnt de workflow op de Dags-pagina in de Airflow UI.
Loop je tegen onboardingproblemen aan? Bekijk dan de tutorial Getting Started with Apache Airflow. .
Om hands-on met Airflow aan de slag te gaan, bouwen we een dagelijkse job die klantbeoordelingen verwerkt en hun sentiment classificeert.
Stel dat we net een e-commerceplatform hebben gebouwd. Klanten laten al reviews achter, en we willen die elke dag automatisch analyseren.
In plaats van een script handmatig te draaien, kunnen we Airflow gebruiken om de workflow te orkestreren.
Stel je voor dat de ruwe reviews zijn opgeslagen in een .jsonl-bestand.
Elke regel bevat één review als JSON-object, en nieuwe reviews worden gedurende de dag aan het einde van het bestand toegevoegd. In een productiesysteem kan deze data uit een API, database, object store of message queue komen. Voor deze tutorial biedt het JSONL-bestand een eenvoudige en realistische bron van ruwe reviewdata.
In dit scenario is de eerste stap in de pijplijn om die reviews in Airflow te laden. We beginnen met een gewone Python-functie, net zoals we in een notebook of script zouden doen:
REVIEWS_FILE = Path.home() / "airflow" / "data" / "reviews.jsonl"

def fetch_reviews() -> list[dict]:
   """Load raw customer reviews from the JSONL landing file."""
   reviews = []

   with REVIEWS_FILE.open("r", encoding="utf-8") as file:
       for line_number, line in enumerate(file, start=1):
           if not line.strip():
               continue

           try:
               reviews.append(json.loads(line))
           except json.JSONDecodeError as error:
               raise ValueError(
                   f"Invalid JSON on line {line_number}"
               ) from error

   print(f"Fetched {len(reviews)} reviews")
   return reviews
Deze functie opent het JSONL-bestand, leest het regel voor regel, slaat lege regels over en zet elk JSON-object om in een Python-dictionary.
Als een regel ongeldige JSON bevat, faalt de taak met een duidelijke foutmelding met het regelnummer.
Tot nu toe is dit pure Python. De volgende stap is om er een Airflow-taak van te maken en deze in een DAG te plaatsen.
Om de functie onderdeel te maken van een Airflow-workflow, hebben we drie onderdelen nodig:
@task. Dit vertelt Airflow dat de functie een taak is.@dag. De DAG geeft de workflow een naam, schema, startdatum en andere configuratie.Hier is de minimale versie:
from airflow.sdk import dag

@dag(    fetch_reviews()
   dag_id="fetch_reviews_pipeline",
)

def fetch_reviews_pipeline():
   fetch_reviews()

fetch_reviews_pipeline()
Let op: deze DAG wordt nog niet automatisch uitgevoerd.
Zoals het nu staat, zouden we hem handmatig moeten triggeren vanuit de Airflow UI. Om te configureren wanneer de workflow moet draaien, kunnen we planningsparameters toevoegen aan de DAG-definitie. Een mogelijke optie is:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
Laten we het ontleden!
dag_id geeft de DAG een unieke naam in Airflow.schedule="@daily" draait de DAG één keer per dag.start_date vertelt Airflow wanneer de planning kan beginnen.catchup=False voorkomt dat Airflow runs voor data in het verleden aanmaakt.tags helpen de DAG te organiseren en te filteren in de Airflow UI.Zodra de DAG is gedefinieerd, kunnen we naar de UI gaan en bekijken hoe dit er in de praktijk uitziet:
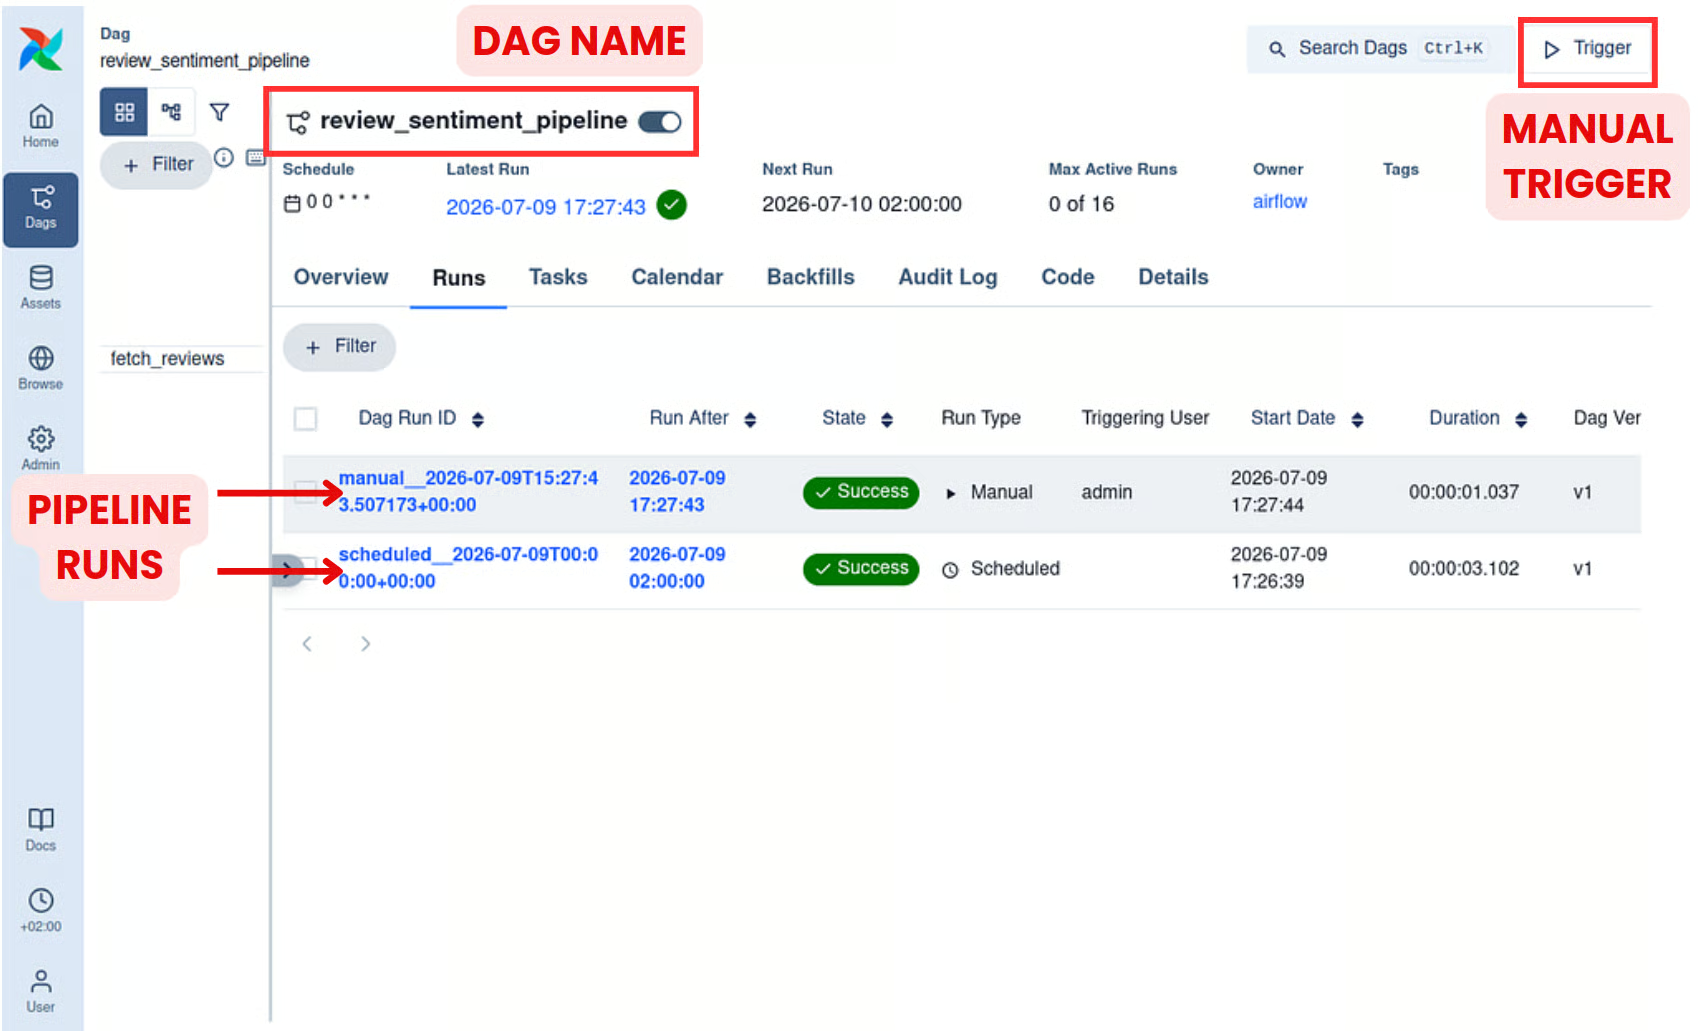
Airflow UI-weergave van onze pijplijn review_sentiment_pipeline. Let op de twee soorten runs (gepland en handmatig) en de handmatige Trigger-knop.
In de UI zien we dat Airflow de DAG met de naam review_sentiment_pipeline automatisch heeft ontdekt.
We zien ook dat hij volgens schema heeft gedraaid en dat we één extra run handmatig hebben getriggerd met de Trigger-knop in de rechterbovenhoek van de interface.
Een fijne feature is de kalenderweergave, waarin Airflow pijplijnruns bijhoudt samen met de status van elke run:
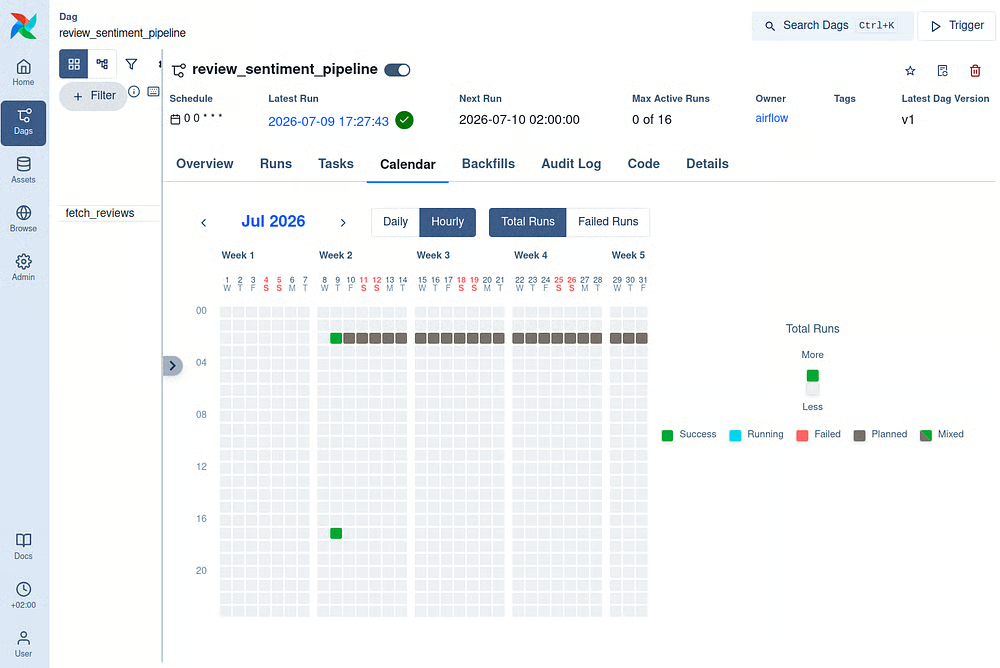
Kalenderweergave van onze Airflow-pijplijn met zowel de geplande als handmatige runs.
Neem gerust een pauze in het artikel en verken de Airflow UI!
Met de reviews geladen is de volgende stap hun sentiment te classificeren. Hiervoor gebruiken we @task.llm, een decorateur die een LLM-aanroep omzet in een native Airflow-taak.
We zouden de OpenAI-API handmatig kunnen aanroepen binnen een gewone @task, maar @task.llm geeft ons een schonere integratie.
Het handelt LLM-specifieke details af zoals de modelverbinding, system prompt, gestructureerde output en serialisatie van resultaten. Tegelijkertijd profiteert de taak nog steeds van standaard Airflow-functies zoals retries, logging, monitoring en afhankelijkheidsbeheer.
Deze tweede stap heeft net wat meer onderdelen dan de exacte taak, dus laten we hem geleidelijk opbouwen:
from typing import Literal
from pydantic import BaseModel

class ReviewClassification(BaseModel):
   """Structured result returned by the LLM."""

   review_id: str
   sentiment: Literal["positive", "neutral", "negative"]
Dit vertelt de LLM-taak dat elke respons de review-ID en een van drie sentimentlabels moet bevatten: positive, neutral of negative.
@task.llm(
   llm_conn_id="pydanticai_default",
   system_prompt=(
       "Classify the customer review as positive, neutral, or negative. "
       "Use both the written review and the star rating as context. "
       "Return the review ID and sentiment."
   ),
   output_type=ReviewClassification,
   serialize_output=True,
   retries=3,
)
def classify_review(review: dict) -> str:
   """Build the prompt sent to the LLM."""
   return (
       f"Review ID: {review['review_id']}\n"
       f"Product: {review['product']}\n"
       f"Rating: {review['rating']} out of 5 stars\n"
       f"Review: {review['review_text']}"
   )
De functiebody retourneert een stringprompt, terwijl de decorateur @task.llm ervoor zorgt dat die prompt naar het model wordt gestuurd via de pydanticai_default-verbinding die we eerder hebben geconfigureerd.
De system_prompt geeft het model zijn instructie, terwijl output_type=ReviewClassification om een gestructureerde respons vraagt. We zetten ook serialize_output=True zodat Airflow het resultaat als een gewone dictionary opslaat, wat het doorgeven aan downstream-taken makkelijker maakt.
Geïnteresseerd in taken die LLM-inferentie vereisen? Overweeg deze LangChain-cursus voor meer gespecialiseerde toepassingen!
De classificatietaak retourneert een gestructureerd resultaat, maar tijdens de ontwikkeling is het handig om te zien wat het model produceerde zonder te wachten tot de laatste opslagstap.
Inderdaad, een pijplijnstap kan uit meer dan één Airflow-taak bestaan.
In dit geval voegen we een kleine taak toe die elke classificatie naar de Airflow-logs print:
@task
def show_classification(classification: dict) -> dict:
   """Print one model classification to the Airflow task logs."""
   print(
       f"Review {classification['review_id']}: "
       f"{classification['sentiment']}"
   )

   return classification
Deze taak verandert het resultaat niet. Hij logt simpelweg de modeloutput en retourneert dezelfde dictionary, zodat de classificatie nog steeds kan worden doorgegeven aan de volgende stap van de pijplijn.
3. Tot slot moeten we de nieuwe taken verbinden binnen de DAG-functie:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
def review_sentiment_pipeline():
   reviews = fetch_reviews()

   classifications = classify_review.expand(
       review=reviews
   )

   displayed_classifications = show_classification.expand(
       classification=classifications
   )

review_sentiment_pipeline()
Let op: In deze pijplijn gebruiken we dynamic task mapping met .expand(review=reviews). Dit vertelt Airflow om één classify_review-taakinstantie te maken voor elke review, zodat elke review in een apart verzoek naar de LLM wordt gestuurd.
Dit verdient meestal de voorkeur boven het sturen van de volledige reviewlijst naar één LLM-taak. Een aanroep als classify_reviews(reviews) zou alle reviews samen verwerken, wat fouten lastiger kan maken om te debuggen, retries minder gericht maakt en de kans vergroot dat grote inputs de modelcontext of API-limieten raken.
Voordat we deze tweede stap van de pijplijn afronden, kunnen we terugkeren naar de Airflow UI en visualiseren hoe de workflow is geëvolueerd.
Op dit punt bevat de DAG drie taken: fetch_reviews, classify_review en show_classification :
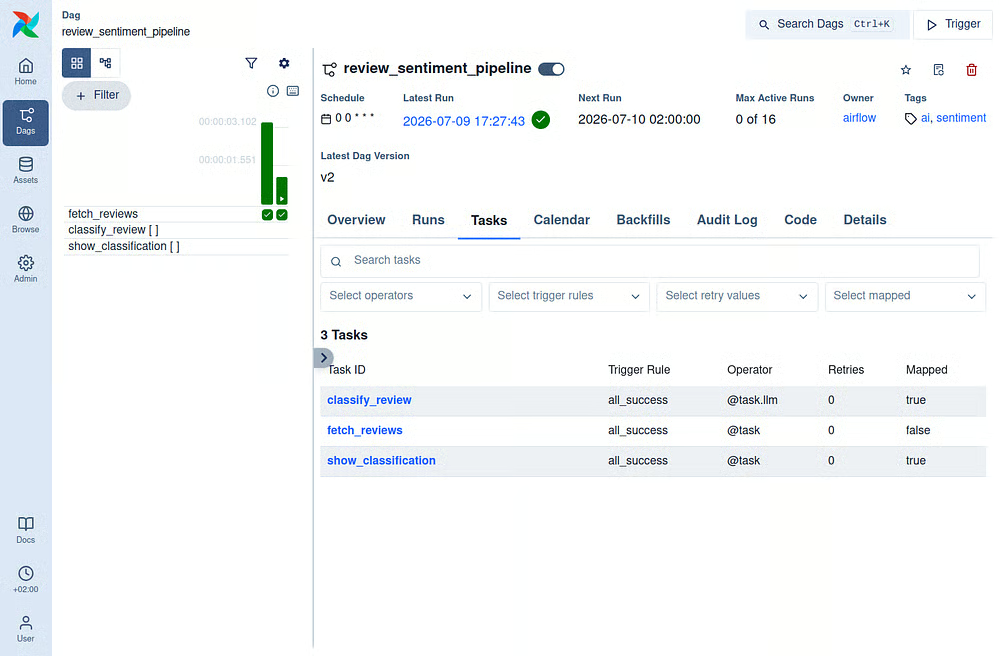
Airflow UI-weergave van de drie taken in onze review_sentiment_pipeline-DAG.
Omdat we dynamic task mapping hebben gebruikt, stuurt Airflow één LLM-verzoek per review. Dit is handig omdat elke review onafhankelijk wordt gevolgd:
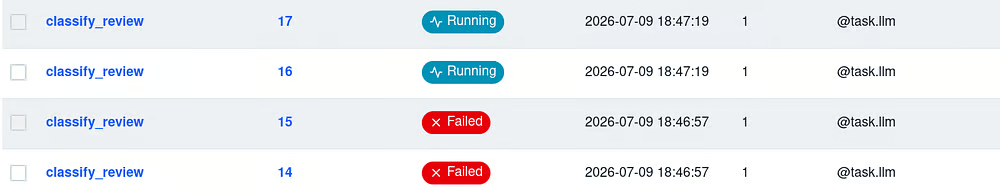
Airflow UI toont dat reviews onafhankelijk worden geclassificeerd. Sommige taken zijn al voltooid of mislukt, terwijl andere nog draaien.
LLM-verzoeken kunnen falen door redenen als API-rate-limits, netwerkproblemen of model-timeouts.
In plaats van de hele pijplijn meteen te laten falen, kunnen we Airflow vragen om de getroffen taak automatisch opnieuw te proberen.
Laten we deze feature toevoegen!
from datetime import timedelta

@task.llm(
   llm_conn_id="pydanticai_default",
   system_prompt=(
       "Classify the customer review as positive, neutral, or negative. "
       "Use both the written review and the star rating as context. "
       "Return the review ID and sentiment."
   ),
   output_type=ReviewClassification,
   serialize_output=True,
   retries=3,
   retry_delay=timedelta(seconds=30),
   retry_exponential_backoff=True,
   max_retry_delay=timedelta(minutes=5),
)
Hier staat retries=3 tot drie extra pogingen toe na de eerste mislukking.
De eerste retry wacht 30 seconden, en exponential backoff vergroot de wachttijd tussen latere pogingen, tot een maximum van vijf minuten.
Het mooie is dat Airflow alleen de mislukte gemapte taak opnieuw probeert.
Als 49 reviews succesvol zijn geclassificeerd en één verzoek is mislukt, wordt alleen die mislukte review opnieuw ingepland. De rest van de pijplijn hoeft geen werk te herhalen dat al is geslaagd.
Na enige tijd komen de mislukte reviewclassificaties weer in aanmerking voor een retry:
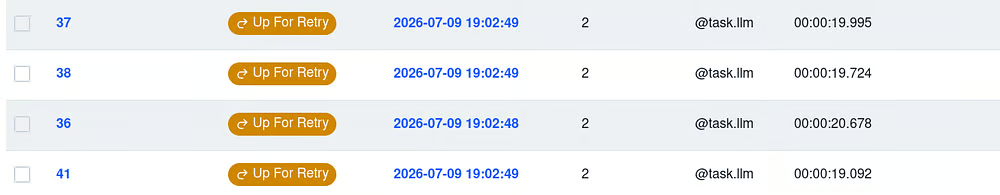
Airflow UI toont alle mislukte reviewclassificatietaken die wachten op een retry.
Zodra de reviewclassificatie slaagt, toont elke gemapte instantie van show_classification() de modelrespons voor één review in zijn eigen logs.
Dit betekent dat de weergavestap ook onafhankelijk is: je kunt de output van één review openen, inspecteren of debuggen, ongeacht de status van de andere.
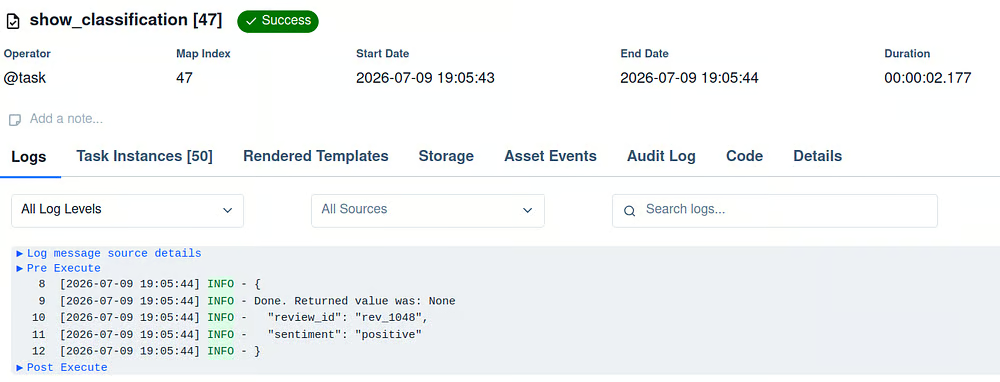
Airflow UI-weergave van de LLM-sentimentclassificatie voor review 47.
Elke classificatie printen is handig tijdens het ontwikkelen van de DAG, omdat we zo de modelresponsen snel in de Airflow-logs kunnen bekijken.
Logs zijn echter geen betrouwbare plaats om pijplijnresultaten op te slaan. Ze zijn lastiger te bevragen, te hergebruiken en te integreren met downstream-systemen.
De laatste stap is daarom om de classificaties te verzamelen en ze naar een gestructureerde output te schrijven.
Voor dit artikel verwijderen we de aanroep van show_classification() en slaan we de resultaten op in een lokaal JSON-bestand.
In een productiepijplijn zou deze taak doorgaans naar een database, data warehouse of object store schrijven.
Een mogelijke implementatie voor deze nieuwe @task is:
OUTPUT_FILE = (
   Path.home()
   / "airflow"
   / "output"
   / "classified_reviews.json"
)

@task
def store_results(results: list[dict]) -> str:
   """Write all classified reviews to a local JSON file."""
   OUTPUT_FILE.parent.mkdir(parents=True, exist_ok=True)

   classifications = list(results)

   with OUTPUT_FILE.open("w", encoding="utf-8") as file:
       json.dump(
           classifications,
           file,
           indent=2,
           ensure_ascii=False,
       )

   print(
       f"Stored {len(classifications)} classifications "
       f"in {OUTPUT_FILE}"
   )

   return str(OUTPUT_FILE)
Deze taak is onze load-stap.
Hij neemt de classificaties die door de LLM zijn geproduceerd, maakt indien nodig een outputmap aan en schrijft alles naar een lokaal JSON-bestand.
De kleine conversie list(results) is nuttig omdat de classificaties uit gemapte taken komen.
Airflow verzamelt die gemapte outputs voor ons, en deze taak zet ze om in een gewone lijst voordat ze worden opgeslagen. Nu hoeven we de taak alleen nog in de DAG te verbinden door store_results(classifications) aan te roepen.
Met deze regel weet Airflow dat store_results() afhankelijk is van de classificatiestap. Met andere woorden: het outputbestand wordt pas geschreven nadat alle reviewclassificaties succesvol zijn afgerond.
Met alle drie de stappen verbonden, haalt de complete DAG nu de reviews op, maakt één LLM-taak per review en slaat de gecombineerde resultaten op.
Binnen de DAG-functie ziet de pijplijn er zo uit:
@dag(
   dag_id="review_sentiment_pipeline",
   schedule="@daily",
   start_date=datetime(2026, 1, 1),
   catchup=False,
   tags=["ai", "sentiment"],
)
def review_sentiment_pipeline():
   reviews = fetch_reviews()
   classifications = classify_review.expand(
       review=reviews
   )
   store_results(classifications)

review_sentiment_pipeline()
Nadat je het bestand hebt opgeslagen, doet Airflow er een paar seconden over om het te parsen en de complete DAG te ontdekken. Zodra review_sentiment_pipeline in de DAG-lijst verschijnt, zet je hem aan met de schakelaar en klik je op Trigger om een handmatige run te starten.
Zo kunnen we de volledige pijplijn meteen testen, zonder te wachten op de volgende geplande dagelijkse run. Zodra de run slaagt, is het uiteindelijke JSON-bestand lokaal beschikbaar op ~/airflow/output/classified_reviews.json.
Het output-JSON-bestand is de duurzame output van de workflow, die buiten de DAG kan worden hergebruikt of later aan downstream-systemen kan worden doorgegeven.
Ter vergelijking biedt de Airflow UI ons het operationele beeld van de pijplijn: welke taken draaiden, welke faalden of slaagden en waar je logs kunt inspecteren.
De uiteindelijke pijplijn staat hieronder weergegeven:
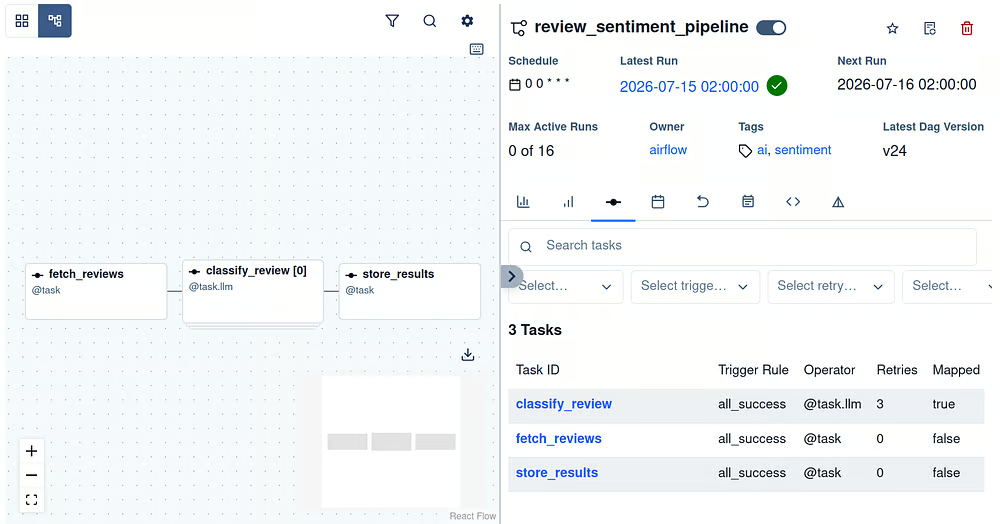
Airflow UI-weergave van de drie taken in onze pijplijn. Het paneel rechtsonder toont de eigenschappen van elke taak, inclusief naam, triggeregel, operator of decorateur en aantal retries.
In de komende dagen zal de Airflow UI zich vullen met automatische dagelijkse runs, waardoor we een duidelijk overzicht krijgen van wanneer de pijplijn heeft gedraaid en of elke uitvoering is geslaagd:
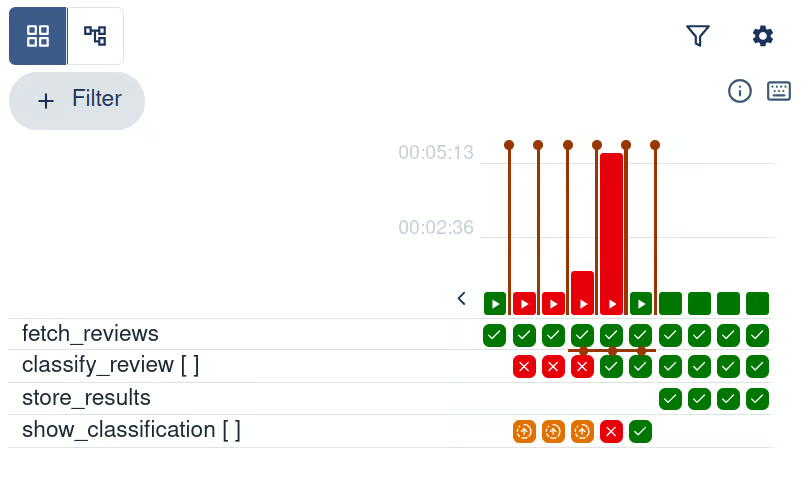
Airflow UI-weergave van de pijplijnruns en hun status. Na Stap 3 stopt de pijplijn met het gebruik van show_classification en draait in plaats daarvan store_results.
Onze pijplijn haalt nu reviews op, classificeert ze met een LLM en slaat de resultaten op volgens een dagelijks schema.
Airflow 3 ondersteunt ook meer geavanceerde patronen die AI-workflows responsiever en makkelijker te superviseren maken.
In plaats van de pijplijn elke dag op een vast tijdstip te draaien, kan Airflow hem starten wanneer een extern event plaatsvindt.
Zo zou de reviewpijplijn kunnen draaien zodra een nieuw reviewbestand naar objectopslag is geüpload of wanneer er een bericht binnenkomt in een queue.
Airflow 3 ondersteunt event-driven scheduling via assets en event-compatibele triggers. Dit voorkomt dat je herhaaldelijk op nieuwe data moet controleren en laat de pijplijn reageren zodra een event wordt gedetecteerd.
Niet elke modelbeslissing moet automatisch worden geaccepteerd.
Sommige reviews kunnen dubbelzinnig, gevoelig of afhankelijk van menselijk oordeel zijn. Airflows human-in-the-loop-operators kunnen een draaiende workflow pauzeren en input vragen via de Airflow-interface.
Een reviewer kan een resultaat goedkeuren of afwijzen, informatie aanleveren of kiezen welke tak van de workflow moet doorgaan.
De Common AI-provider ondersteunt ook interactieve reviewpatronen voor agentische workflows, waarbij een reviewer een door een LLM gegenereerd resultaat kan goedkeuren, afwijzen of om wijzigingen kan vragen.
Samen maken event-driven scheduling en menselijke review het mogelijk om AI-pijplijnen te bouwen die snel reageren zonder menselijke controle te verwijderen waar dat ertoe doet.
Wil je meer leren over de functies van Airflow 3.0? Bekijk dan onze aparte gids.
In dit artikel hebben we een complete AI-pijplijn gebouwd met Apache Airflow.
De pijplijn haalt klantbeoordelingen op, classificeert elke review met een LLM en slaat de eindresultaten op in een gestructureerd JSON-bestand.
Onderweg zagen we hoe Airflow Python-functies omzet in geplande, observeerbare taken. Dit is vooral nuttig voor AI-workflows, waar API-limieten, model-timeouts en onverwachte outputs kunnen voorkomen.
Met taakafhankelijkheden, dynamic task mapping, retries, logs en de Airflow UI maken we AI-pijplijnen makkelijker te monitoren, debuggen en herstellen.
Het voorbeeld gebruikte lokale bestanden om het simpel te houden, maar dezelfde structuur is uit te breiden naar APIs, databases, event-driven workflows en human-in-the-loop-review.
Klaar om verder te gaan? Begin dan met onze cursus Introduction to Apache Airflow in Python, en ga daarna verder met Building Data Pipelines with Airflow voor meer hands-on oefening.
Voor een breder leerpad behandelt de Data Engineer in Python-carrièreroute de bredere set vaardigheden die nodig zijn om productiedatapijplijnen te bouwen en te beheren.
Top DataCamp-cursussen
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

