Dalam artikel ini, saya akan menggunakan contoh penskalaan data numerik (data numerik: data yang terdiri dari angka, berbeda dari kategori/string; penskalaan: menggunakan aritmetika dasar untuk mengubah rentang data; detail lebih lanjut menyusul) untuk menunjukkan pentingnya mempertimbangkan prapemrosesan sebagai bagian dari struktur yang lebih besar, yaitu pipeline machine learning (ML). Untuk itu, kita akan melihat contoh dunia nyata di mana penskalaan dapat meningkatkan kinerja model.
Saya akan terlebih dahulu memperkenalkan masalah klasifikasi dalam ML dan k-Nearest Neighbors, salah satu algoritme paling sederhana yang digunakan dalam konteks tersebut. Untuk memahami pentingnya penskalaan data numerik dalam konteks ini, saya perlu memperkenalkan ukuran kinerja model dan konsep train dan test set. Anda akan melihat semua konsep dan praktik ini diterapkan pada sebuah dataset ketika saya mencoba mengklasifikasikan kualitas anggur merah. Saya juga akan memastikan menempatkan prapemrosesan di tempat yang paling berguna, yaitu di awal pipeline data science yang iteratif. Semua contoh di sini menggunakan Python. Jika Anda belum familiar dengan Python, Anda dapat melihat kursus DataCamp kami di sini. Saya akan menggunakan pustaka pandas untuk kebutuhan dataframe dan scikit-learn untuk kebutuhan machine learning.
Ini adalah bagian pertama dari tutorial tiga bagian:
Bagian 2: Centering, Scaling, dan Regresi Logistik
Bagian 3: Scaling pada Data Tersintesis
Pengenalan Singkat Masalah Klasifikasi dalam Machine Learning
Mengklasifikasikan dan memberi label pada hal-hal di dunia fenomenal adalah seni kuno. Pada abad ke-4 SM, Aristoteles membangun sistem klasifikasi makhluk hidup yang digunakan selama 2.000 tahun. Di dunia modern, klasifikasi umumnya diposisikan sebagai tugas machine learning, khususnya tugas pembelajaran terawasi (supervised learning). Prinsip dasar pembelajaran terawasi cukup sederhana: kita memiliki sekumpulan data yang terdiri dari variabel prediktor dan sebuah variabel target. Tujuan dari pembelajaran terawasi adalah membangun model yang "andalan" dalam memprediksi variabel target, diberikan variabel prediktor. Jika variabel target terdiri dari kategori (mis. "klik" atau "tidak", tumor "ganas" atau "jinak"), kita menyebut tugas pembelajaran tersebut sebagai klasifikasi. Sebaliknya, jika target adalah variabel yang berubah secara kontinu (mis. harga rumah), itu adalah tugas regresi.
Contoh ilustratif akan sangat membantu di sini: pertimbangkan dataset penyakit jantung, yang memiliki 75 variabel prediktor, seperti "usia", "jenis kelamin" dan "perokok atau tidak" dan variabel target mengacu pada keberadaan penyakit jantung dan berkisar dari 0 (tidak ada penyakit jantung) hingga 4. Banyak pekerjaan pada dataset ini berfokus pada upaya membedakan ada tidaknya penyakit jantung. Ini adalah tugas klasifikasi. Jika Anda mencoba memprediksi nilai aktual (0 hingga 4) dari variabel target, itu akan menjadi masalah regresi (karena variabel target berurut). Saya akan membahas regresi di pos berikutnya. Di sini saya akan melihat salah satu algoritme paling sederhana untuk tugas klasifikasi, yaitu algoritme k-Nearest Neighbors.
k-Nearest Neighbors untuk klasifikasi dalam machine learning
Katakanlah kita memiliki data berlabel, misalnya data yang terdiri dari karakteristik anggur merah (mis. kadar alkohol, densitas, jumlah asam sitrat, pH, dll.; ini adalah variabel prediktor) dengan variabel target "Quality" dan label "good" & "bad". Maka, dengan diberikan karakteristik anggur baru yang belum berlabel, tugas klasifikasi adalah memprediksi "Quality"-nya. Ketika semua variabel prediktor bersifat numerik (ada juga cara menangani kasus kategorikal), kita dapat menganggap tiap baris/anggur sebagai titik dalam ruang berdimensi-n, dan dalam kasus ini, k-Nearest Neighbors (k-NN) adalah metode klasifikasi yang sederhana secara konseptual & komputasional: untuk setiap anggur baru yang belum berlabel, kita hitung, untuk suatu bilangan bulat k, k tetangga terdekatnya dalam ruang variabel prediktor berdimensi-n. Lalu kita lihat label dari k tetangga tersebut (yaitu "good" atau "bad") & menetapkan label dengan jumlah suara terbanyak ke anggur baru tersebut (mis. jika k = 5, 3 tetangga memilih "good" dan 2 memilih "bad", maka model kita memberi label "good"). Perhatikan bahwa di sini, melatih model sepenuhnya hanya berupa menyimpan titik data: tidak ada parameter yang harus di-fit!
Gambaran visual k-Nearest Neighbors
Pada gambar di bawah, ada contoh k-NN dalam 2D: bagaimana Anda mengklasifikasikan titik data di tengah? Jika k=3, Anda akan mengklasifikasikannya sebagai merah dan, jika k=5, sebagai hijau.
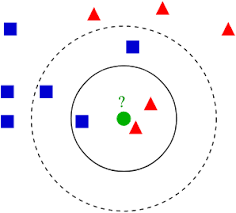
Implementasi k-NN di Python (scikit-learn)
import pandas as pd%matplotlib inlineimport matplotlib.pyplot as pltplt.style.use('ggplot')df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')X = df.drop('quality' , 1).values # drop target variabley1 = df['quality'].valuespd.DataFrame.hist(df, figsize = [15,15]);
Perhatikan terlebih dahulu rentang variabel prediktor: "free sulfur dioxide" berkisar dari 0 hingga ~70 dan "volatile acidity" dari ~0 hingga ~1,2. Lebih spesifiknya, yang pertama memiliki rentang 2 orde magnitudo lebih besar daripada yang kedua. Algoritme apa pun, seperti k-NN, yang memperhatikan jarak antar titik data, dapat menjadi terlalu fokus dan tidak adil pada variabel dengan rentang lebih besar, seperti "free sulfur dioxide", variabel yang bisa saja hanya berisi noise, sejauh yang kita tahu. Hal ini memotivasi kita untuk melakukan penskalaan data, yang akan segera kita bahas.
Sekarang variabel target adalah penilaian "Quality" anggur dan berkisar dari 3 hingga 8. Demi kemudahan pemaparan, mari kita ubah menjadi variabel dua kategori yang terdiri dari "good" (rating > 5) & "bad" (rating <= 5). Kita juga akan memplot histogram dari kedua formulasi variabel target tersebut untuk memahami konteksnya.
y = y1 <= 5 # is the rating <= 5?# plot histograms of original target variable# and aggregated target variableplt.figure(figsize=(20,5));plt.subplot(1, 2, 1 );plt.hist(y1);plt.xlabel('original target value')plt.ylabel('count')plt.subplot(1, 2, 2);plt.hist(y)plt.xlabel('aggregated target value')plt.show()
k-Nearest Neighbors: seberapa baik kinerjanya?
Catatan: akurasi juga dapat didefinisikan dalam kerangka confusion matrix dan lazim didefinisikan untuk masalah klasifikasi biner dalam istilah true positives & false negatives; ukuran kinerja model lain yang umum dan diturunkan dari confusion matrix adalah precision, jumlah true positives dibagi jumlah true & false positives, dan recall, jumlah true positives dibagi jumlah true positives ditambah jumlah false negatives; ukuran lain, F1-score adalah rata-rata harmonik dari precision dan recall. Lihat machine learning mastery untuk paparan yang baik tentang ukuran-ukuran ini; juga lihat entri Wikipedia tentang confusion matrix dan F1 score.
k-Nearest Neighbors: kinerja dalam praktik dan train test split
from sklearn.cross_validation import train_test_splitX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)We now build the k-NN model, make predictions on the test set and compare these predictions to the ground truth in order to get a measure of model performance:from sklearn import neighbors, linear_modelknn = neighbors.KNeighborsClassifier(n_neighbors = 5)knn_model_1 = knn.fit(X_train, y_train)print('k-NN accuracy for test set: %f' % knn_model_1.score(X_test, y_test))k-NN accuracy for test set: 0.612500
Perlu ditegaskan kembali bahwa metode penilaian default untuk k-NN di scikit-learn adalah akurasi. Akurasi 61% memang tidak istimewa tetapi untuk model out-of-the-box tanpa prapemrosesan juga tidak buruk. Untuk melihat berbagai metrik lain, kita juga dapat menggunakan classification report dari scikit-learn:
from sklearn.metrics import classification_reporty_true, y_pred = y_test, knn_model_1.predict(X_test)print(classification_report(y_true, y_pred))Sekarang kita akan memperkenalkan scaling dan centering, metode paling dasar untuk prapemrosesan data numerik, dan melihat apakah dan bagaimana keduanya memengaruhi kinerja model kita.
Mekanisme Prapemrosesan: Scaling dan Centering
Sebelum menjalankan model, seperti regresi (memprediksi variabel kontinu) atau klasifikasi (memprediksi variabel diskret), pada data, Anda hampir selalu ingin melakukan beberapa prapemrosesan. Untuk variabel numerik, umum untuk menormalkan atau menstandarkan data Anda. Apa makna istilah-istilah ini?
Yang dimaksud normalisasi adalah menskalakan dataset sehingga minimumnya 0 dan maksimumnya 1. Untuk mencapainya kita mentransformasikan setiap titik data $x$ menjadi
$$x_{normalized} = \frac{x-x_{min}}{x_{max}-x_{min}}.$$Standarisasi sedikit berbeda; tugasnya adalah memusatkan data di sekitar 0 dan melakukan skala terhadap simpangan baku:
$$x_{standardized} = \frac{x-\mu}{\sigma},$$di mana $\mu$ dan $\sigma$ masing-masing adalah mean dan simpangan baku dataset. Perhatikan terlebih dahulu bahwa transformasi ini hanya mengubah rentang data dan bukan distribusinya. Anda mungkin nantinya ingin menggunakan berbagai transformasi lain, seperti transformasi log atau Box-Cox, untuk membuat data Anda lebih menyerupai Gaussian (seperti kurva lonceng). Namun sebelum melangkah lebih jauh, penting untuk mengajukan pertanyaan berikut: mengapa kita melakukan skala pada data? Adakah saat-saat ketika ini lebih tepat daripada yang lain? Misalnya, apakah ini lebih penting dalam masalah klasifikasi daripada regresi?
Mari terlebih dahulu menelusuri tantangan klasifikasi dan melihat bagaimana penskalaan memengaruhi kinerja k-Nearest Neighbors:
Prapemrosesan: scaling dalam praktik
Di bawah ini saya (i) melakukan skala pada data, (ii) menggunakan k-Nearest Neighbors dan (iii) memeriksa kinerja model. Saya akan menggunakan fungsi scale dari scikit-learn, yang menstandarkan semua fitur (kolom) pada array yang diberikan.
from sklearn.preprocessing import scaleXs = scale(X)from sklearn.cross_validation import train_test_splitXs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)knn_model_2 = knn.fit(Xs_train, y_train)print('k-NN score for test set: %f' % knn_model_2.score(Xs_test, y_test))print('k-NN score for training set: %f' % knn_model_2.score(Xs_train, y_train))y_true, y_pred = y_test, knn_model_2.predict(Xs_test)print(classification_report(y_true, y_pred)) k-NN score for test set: 0.712500k-NN score for training set: 0.814699 precision recall f1-score support False 0.72 0.79 0.75 179 True 0.70 0.62 0.65 141avg / total 0.71 0.71 0.71 320Semua ukuran ini meningkat sebesar 0,1, yaitu peningkatan 16% dan signifikan! Seperti disinggung di atas, sebelum penskalaan ada sejumlah variabel prediktor dengan rentang yang berbeda beberapa orde magnitudo, yang berarti satu atau dua di antaranya bisa mendominasi dalam konteks algoritme seperti k-NN. Dua alasan utama untuk melakukan skala pada data Anda adalah
- Variabel prediktor Anda mungkin memiliki rentang yang sangat berbeda dan, dalam situasi tertentu, seperti saat menerapkan k-NN, hal ini perlu diredam agar fitur tertentu tidak mendominasi algoritme;
- Anda ingin fitur Anda tidak bergantung pada satuan, yaitu tidak bergantung pada skala pengukuran yang digunakan: misalnya, Anda mungkin memiliki fitur terukur dalam meter dan saya memiliki fitur yang sama dalam sentimeter. Jika kita berdua melakukan skala pada data masing-masing, fitur ini akan setara bagi kita berdua.
Kita telah melihat tempat esensial yang ditempati prapemrosesan, dalam bentuk scaling dan centering, dalam pipeline data science, dan kita melakukannya untuk mendorong pendekatan holistik terhadap tantangan machine learning. Pada artikel mendatang, saya berharap memperluas pembahasan ini ke jenis prapemrosesan lain, seperti transformasi data numerik dan prapemrosesan data kategorikal, keduanya aspek penting dari perangkat kerja setiap data scientist. Sebelum ke sana, pada artikel berikutnya saya akan mengeksplorasi peran scaling dalam pendekatan regresi untuk klasifikasi. Khususnya, saya akan melihat regresi logistik dan Anda akan melihat bahwa hasilnya sangat berbeda dari yang baru saja Anda lihat dalam konteks k-Nearest Neighbors.
Pada jendela interaktif di bawah, Anda dapat bereksperimen dengan datanya sendiri. Mulailah dengan mengubah variabel n_neig, yaitu jumlah tetangga yang digunakan dalam algoritme k-NN. Anda juga dapat melakukan skala pada data dengan menetapkan sc = True, jika diinginkan. Lalu jalankan seluruh skrip untuk melaporkan akurasi model, beserta classification report.
import pandas as pdimport matplotlib.pyplot as pltfrom sklearn.cross_validation import train_test_splitfrom sklearn import neighborsfrom sklearn.preprocessing import scalefrom sklearn.metrics import classification_report # Set the the number of neighbors for k-NNn_neig = 5# Set sc = True if you want to scale your featuressc = False# Load datadf = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')X = df.drop('quality' , 1).values# drop target variable# Here we scale, if desiredif sc == True: X = scale(X)# Target valuey1 = df['quality'].values# original target variabley = y1 <= 5# new target variable: is the rating <= 5?# Split the data into a test set and a training setX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)# Train k-NN model and print performance on the test setknn = neighbors.KNeighborsClassifier(n_neighbors = n_neig)knn_model = knn.fit(X_train, y_train)y_true, y_pred = y_test, knn_model.predict(X_test)print('k-NN accuracy for test set: %f' % knn_model.score(X_test, y_test))print(classification_report(y_true, y_pred))Kamus
Supervised learning: Tugas menyimpulkan sebuah variabel target dari variabel prediktor. Misalnya, menyimpulkan variabel target "keberadaan penyakit jantung" dari variabel prediktor seperti "usia", "jenis kelamin", dan "status perokok".
Tugas klasifikasi: Suatu tugas pembelajaran terawasi disebut tugas klasifikasi jika variabel target terdiri dari kategori (mis. "klik" atau "tidak", tumor "ganas" atau "jinak").
Tugas regresi: Suatu tugas pembelajaran terawasi disebut tugas regresi jika variabel target adalah variabel yang berubah secara kontinu (mis. harga rumah) atau variabel kategorikal berurut seperti "penilaian kualitas anggur".
k-Nearest Neighbors: Algoritme untuk tugas klasifikasi, di mana suatu titik data diberi label berdasarkan suara mayoritas dari k tetangga terdekatnya.
Prapemrosesan: Berbagai operasi yang digunakan data scientist untuk menyiapkan data agar lebih sesuai dengan tujuan analisis. Misalnya, sebelum melakukan analisis sentimen pada data Twitter, Anda mungkin ingin menghapus tag HTML, spasi berlebih, memperluas singkatan, dan memecah tweet menjadi daftar kata yang dikandungnya.
Centering dan Scaling: Keduanya merupakan bentuk prapemrosesan data numerik, yaitu data yang terdiri dari angka, berbeda dari kategori atau string, misalnya; centering sebuah variabel adalah mengurangkan mean variabel dari setiap titik data sehingga mean variabel baru menjadi 0; scaling sebuah variabel adalah mengalikan setiap titik data dengan konstanta untuk mengubah rentang data. Lihat isi artikel untuk pentingnya hal ini, beserta contohnya.
Artikel ini dihasilkan dari Jupyter notebook. Anda dapat mengunduh notebook-nya di sini.



