Neste artigo, vou usar o exemplo de escalonar dados numéricos (dados numéricos: dados compostos por números, em oposição a categorias/strings; escalonamento: usar aritmética básica para mudar o intervalo dos dados; mais detalhes a seguir) para mostrar por que é importante encarar o pré-processamento como parte de uma estrutura maior: o pipeline de machine learning (ML). Para isso, veremos um exemplo do mundo real em que o escalonamento melhora o desempenho do modelo.
Primeiro vou apresentar problemas de classificação em ML e o k-Nearest Neighbors, um dos algoritmos mais simples usados nesse contexto. Para valorizar a importância de escalonar dados numéricos nessa situação, vou introduzir métricas de desempenho de modelo e os conceitos de conjunto de treino e de teste. Você verá todos esses conceitos e práticas em ação com um conjunto de dados em que tento classificar a qualidade de vinhos tintos. Também vou colocar o pré-processamento no lugar mais útil: logo no início de um pipeline iterativo de ciência de dados. Todos os exemplos aqui serão em Python. Se você não conhece Python, confira nossos cursos da DataCamp aqui. Vou usar as bibliotecas pandas para manipulação de dataframes e scikit-learn para machine learning.
Este é o primeiro de um tutorial em três partes:
Parte 2: centralização, escalonamento e regressão logística
Parte 3: escalonando dados sintetizados
uma breve introdução a problemas de classificação em machine learning
Classificar e rotular fenômenos do mundo é uma arte antiga. No século IV a.C., Aristóteles criou um sistema de classificação dos seres vivos usado por 2.000 anos. No mundo moderno, classificação costuma ser formulada como uma tarefa de machine learning — em particular, de aprendizado supervisionado. O princípio básico do aprendizado supervisionado é direto: temos um conjunto de dados com variáveis preditoras e uma variável-alvo. O objetivo do aprendizado supervisionado é construir um modelo que seja "bom em" prever a variável-alvo a partir das variáveis preditoras. Se a variável-alvo é categórica (por exemplo, "clique" ou "não", tumor "maligno" ou "benigno"), chamamos a tarefa de classificação. Se a variável-alvo é contínua (por exemplo, preço de uma casa), trata-se de uma tarefa de regressão.
Um exemplo ajuda bastante: considere o conjunto de dados de doença cardíaca, que tem 75 variáveis preditoras, como "idade", "sexo" e "fumante ou não", e a variável-alvo indica presença de doença cardíaca, variando de 0 (sem doença) a 4. Muito do trabalho com esse dataset busca distinguir presença de doença de sua ausência — uma tarefa de classificação. Se você tentasse prever o valor exato (0 a 4) da variável-alvo, seria um problema de regressão (porque a variável-alvo é ordenada). Vou falar de regressão no próximo post. Aqui, vou olhar um dos algoritmos mais simples para classificação: o k-Nearest Neighbors.
k-Nearest Neighbors para classificação em machine learning
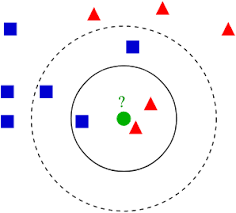
Suponha que temos dados rotulados, por exemplo, características de vinhos tintos (teor alcoólico, densidade, ácido cítrico, pH etc.; essas são as variáveis preditoras) com a variável-alvo "Quality" e rótulos "good" e "bad". Dadas as características de um novo vinho sem rótulo, a tarefa de classificação é prever sua "Quality". Quando todas as variáveis preditoras são numéricas (também há formas de tratar o caso categórico), podemos considerar cada linha/vinho como um ponto em um espaço n-dimensional e, nesse caso, k-Nearest Neighbors (k-NN) é um método de classificação conceitual e computacionalmente simples: para cada novo vinho sem rótulo, calculamos, para um inteiro k, seus k vizinhos mais próximos no espaço n-dimensional das variáveis preditoras. Em seguida, olhamos os rótulos desses k vizinhos ("good" ou "bad") e atribuímos ao novo vinho o rótulo mais frequente (ex.: se k = 5, 3 vizinhos votam "good" e 2 votam "bad", o modelo rotula o novo vinho como "good"). Note que, aqui, treinar o modelo consiste basicamente em armazenar os pontos de dados: não há parâmetros a ajustar!
uma descrição visual do k-Nearest Neighbors
Na imagem abaixo, há um exemplo de k-NN em 2D: como você classificaria o ponto no meio? Se k=3, ele seria classificado como vermelho; se k=5, como verde.
implementação de k-NN em Python (scikit-learn)
import pandas as pd%matplotlib inlineimport matplotlib.pyplot as pltplt.style.use('ggplot')df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')X = df.drop('quality' , 1).values # drop target variabley1 = df['quality'].valuespd.DataFrame.hist(df, figsize = [15,15]);
Primeiro, repare no intervalo das variáveis preditoras: "free sulfur dioxide" varia de 0 até ~70 e "volatile acidity" de ~0 até ~1,2. Mais especificamente, a primeira tem um intervalo duas ordens de grandeza maior que a segunda. Qualquer algoritmo que leve em conta a distância entre pontos, como o k-NN, pode acabar focando de forma desproporcional em variáveis com maior amplitude, como "free sulfur dioxide" — que pode até ser puro ruído, por tudo que sabemos. Isso motiva o escalonamento dos dados, assunto que veremos já já.
A variável-alvo é a nota de "Quality" do vinho e varia de 3 a 8. Para simplificar a exposição, vamos transformá-la em duas categorias: "good" (nota > 5) e "bad" (nota <= 5). Também vamos traçar histogramas das duas formulações da variável-alvo para entender melhor o cenário.
y = y1 <= 5 # is the rating <= 5?# plot histograms of original target variable# and aggregated target variableplt.figure(figsize=(20,5));plt.subplot(1, 2, 1 );plt.hist(y1);plt.xlabel('original target value')plt.ylabel('count')plt.subplot(1, 2, 2);plt.hist(y)plt.xlabel('aggregated target value')plt.show()
k-Nearest Neighbors: quão bem ele performa?
Observação: a acurácia também pode ser definida a partir da matriz de confusão e é comumente apresentada em problemas binários em termos de verdadeiros positivos e falsos negativos. Outras métricas derivadas da matriz de confusão são a precisão (true positives divididos por true + false positives) e o recall (true positives divididos por true positives + false negatives). Outra métrica, o F1-score, é a média harmônica de precisão e recall. Veja o Machine Learning Mastery para uma boa explicação dessas métricas; consulte também as entradas da Wikipedia sobre matriz de confusão e F1 score.
k-Nearest Neighbors: desempenho na prática e o train-test split
from sklearn.cross_validation import train_test_splitX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)We now build the k-NN model, make predictions on the test set and compare these predictions to the ground truth in order to get a measure of model performance:from sklearn import neighbors, linear_modelknn = neighbors.KNeighborsClassifier(n_neighbors = 5)knn_model_1 = knn.fit(X_train, y_train)print('k-NN accuracy for test set: %f' % knn_model_1.score(X_test, y_test))k-NN accuracy for test set: 0.612500
Vale reforçar que a métrica padrão do k-NN no scikit-learn é a acurácia. Uma acurácia de 61% não é excelente, mas para um modelo pronto para uso, sem nenhum pré-processamento, também não é péssima. Para ver outras métricas, podemos usar o classification report do scikit-learn também:
from sklearn.metrics import classification_reporty_true, y_pred = y_test, knn_model_1.predict(X_test)print(classification_report(y_true, y_pred))Agora vamos introduzir escalonamento e centralização, os métodos mais básicos de pré-processamento de dados numéricos, e ver se — e como — eles afetam o desempenho do modelo.
a mecânica do pré-processamento: escalonamento e centralização
Antes de rodar um modelo — seja de regressão (variável contínua) ou de classificação (variável discreta) —, quase sempre vale fazer algum pré-processamento. Para variáveis numéricas, é comum normalizar ou padronizar os dados. O que esses termos significam?
Normalização significa escalonar o conjunto de dados para que o mínimo seja 0 e o máximo 1. Para isso, transformamos cada ponto x em
$$x_{normalized} = \frac{x-x_{min}}{x_{max}-x_{min}}.$$Padronização é um pouco diferente: o objetivo é centralizar os dados em torno de 0 e escalonar em relação ao desvio padrão:
$$x_{standardized} = \frac{x-\mu}{\sigma},$$em que \mu e \sigma são, respectivamente, a média e o desvio padrão do conjunto de dados. Note que essas transformações apenas mudam o intervalo dos dados, não a distribuição. Mais adiante, você pode aplicar outras transformações, como log ou Box-Cox, para deixar os dados mais próximos de uma Gaussiana (curva em forma de sino). Mas antes, é importante perguntar: por que escalonamos os dados? Há momentos em que isso é mais apropriado? Por exemplo, é mais importante em classificação do que em regressão?
Vamos começar com desafios de classificação e ver como o escalonamento afeta o desempenho do k-Nearest Neighbors:
pré-processamento: escalonamento na prática
Abaixo eu (i) escalono os dados, (ii) aplico k-Nearest Neighbors e (iii) avalio o desempenho. Vou usar a função scale do scikit-learn, que padroniza todos os atributos (colunas) do array passado.
from sklearn.preprocessing import scaleXs = scale(X)from sklearn.cross_validation import train_test_splitXs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)knn_model_2 = knn.fit(Xs_train, y_train)print('k-NN score for test set: %f' % knn_model_2.score(Xs_test, y_test))print('k-NN score for training set: %f' % knn_model_2.score(Xs_train, y_train))y_true, y_pred = y_test, knn_model_2.predict(Xs_test)print(classification_report(y_true, y_pred)) k-NN score for test set: 0.712500k-NN score for training set: 0.814699 precision recall f1-score support False 0.72 0.79 0.75 179 True 0.70 0.62 0.65 141avg / total 0.71 0.71 0.71 320Todas as métricas melhoraram em 0,1 — um ganho de cerca de 16%, significativo! Como já sugerido, antes do escalonamento havia variáveis preditoras com amplitudes em ordens de grandeza diferentes, o que fazia com que uma ou duas dominassem em algoritmos baseados em distância, como o k-NN. As duas principais razões para escalonar seus dados são:
- Suas variáveis preditoras podem ter intervalos muito diferentes e, em certos cenários, como na implementação do k-NN, é preciso mitigar isso para que alguns atributos não dominem o algoritmo;
- Você quer que seus atributos sejam independentes de unidade, ou seja, não dependam da escala da medição: por exemplo, você pode ter uma variável em metros e eu a mesma variável em centímetros. Se ambos escalonarmos nossos dados, essa variável ficará equivalente para nós dois.
Vimos o papel essencial do pré-processamento — na forma de escalonamento e centralização — dentro do pipeline de ciência de dados, incentivando uma visão holística dos desafios de machine learning. Em artigos futuros, pretendo estender a discussão para outros tipos de pré-processamento, como transformações de dados numéricos e tratamento de dados categóricos, ambos essenciais no kit de ferramentas de qualquer cientista de dados. Antes disso, no próximo artigo vou explorar o papel do escalonamento em abordagens de regressão para classificação. Em particular, veremos regressão logística — e você vai notar que o resultado é bem diferente do observado com k-Nearest Neighbors.
No painel interativo abaixo, você pode experimentar os dados você mesmo. Comece alterando a variável n_neig, que é o número de vizinhos usado no algoritmo k-NN. Você também pode escalonar os dados definindo sc = True, se quiser. Depois, execute o script inteiro para ver a acurácia do modelo e o classification report.
import pandas as pdimport matplotlib.pyplot as pltfrom sklearn.cross_validation import train_test_splitfrom sklearn import neighborsfrom sklearn.preprocessing import scalefrom sklearn.metrics import classification_report # Set the the number of neighbors for k-NNn_neig = 5# Set sc = True if you want to scale your featuressc = False# Load datadf = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')X = df.drop('quality' , 1).values# drop target variable# Here we scale, if desiredif sc == True: X = scale(X)# Target valuey1 = df['quality'].values# original target variabley = y1 <= 5# new target variable: is the rating <= 5?# Split the data into a test set and a training setX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)# Train k-NN model and print performance on the test setknn = neighbors.KNeighborsClassifier(n_neighbors = n_neig)knn_model = knn.fit(X_train, y_train)y_true, y_pred = y_test, knn_model.predict(X_test)print('k-NN accuracy for test set: %f' % knn_model.score(X_test, y_test))print(classification_report(y_true, y_pred))dicionário
Aprendizado supervisionado: tarefa de inferir uma variável-alvo a partir de variáveis preditoras. Exemplo: inferir a variável-alvo "presença de doença cardíaca" a partir de variáveis preditoras como "idade", "sexo" e "status de fumante".
Tarefa de classificação: uma tarefa de aprendizado supervisionado é de classificação quando a variável-alvo é categórica (por exemplo, "clique" ou "não", tumor "maligno" ou "benigno").
Tarefa de regressão: uma tarefa de aprendizado supervisionado é de regressão quando a variável-alvo é contínua (por exemplo, preço de uma casa) ou uma variável categórica ordenada, como "nota de qualidade do vinho".
k-Nearest Neighbors: algoritmo para tarefas de classificação, no qual um ponto recebe o rótulo decidido pela maioria de seus k vizinhos mais próximos.
Pré-processamento: conjunto de operações usadas por cientistas de dados para deixar os dados mais apropriados ao objetivo da análise. Exemplo: antes de fazer análise de sentimento em dados do Twitter, remover tags HTML, espaços em branco, expandir abreviações e dividir os tweets nas palavras que os compõem.
Centralização e escalonamento: formas de pré-processar dados numéricos, isto é, dados compostos por números (e não por categorias ou strings). Centralizar uma variável é subtrair sua média de cada ponto para que a nova média seja 0; escalonar é multiplicar cada ponto por uma constante para alterar o intervalo dos dados. Veja no corpo do artigo por que isso é importante, com exemplos.
Este artigo foi gerado a partir de um Jupyter notebook. Você pode baixar o notebook aqui.



