Bu makalede, sayısal verilerin ölçeklendirilmesi örneğini (sayısal veri: kategoriler/ifadeler yerine sayılardan oluşan veri; ölçeklendirme: verinin aralığını değiştirmek için temel aritmetik kullanımı; ayrıntılar aşağıda) kullanarak, önişlemenin daha büyük bir yapının, makine öğrenimi (ML) hattının, parçası olarak ele alınmasının önemini göstereceğim. Bu amaçla, ölçeklendirmenin model performansını iyileştirebileceği gerçek dünya örneğini göreceğiz.
Önce ML’de sınıflandırma problemlerini ve bu ortamlarda kullanılan en basit algoritmalardan biri olan k-En Yakın Komşu’yu tanıtacağım. Böyle bir ortamda sayısal verileri ölçeklendirmenin önemini takdir etmek için model performansı ölçütlerini ve eğitim ve test kümeleri kavramlarını tanıtmam gerekecek. Bu kavram ve uygulamaların tümünü kırmızı şarap kalitesini sınıflandırmayı denediğim bir veri kümesiyle göreceksiniz. Ayrıca, önişlemeyi en faydalı yerine, yinelemeli bir veri bilimi hattının başlangıcına yakın bir noktaya koyduğumdan emin olacağım. Buradaki tüm örnekler Python ile olacak. Python’a aşina değilseniz, DataCamp kurslarımıza buradan göz atabilirsiniz. Veri çerçevesi ihtiyaçlarımız için pandas ve makine öğrenimi ihtiyaçlarımız için scikit-learn kütüphanelerini kullanacağım.
Bu, üç bölümlük bir eğitimin birinci parçasıdır:
Bölüm 2: Merkezleme, Ölçeklendirme ve Lojistik Regresyon
Bölüm 3: Sentetik Verilerin Ölçeklendirilmesi
Makine Öğreniminde Sınıflandırma Problemlerine Kısa Bir Giriş
Olgusal dünyadaki şeyleri sınıflandırmak ve etiketlemek kadim bir sanattır. MÖ 4. yüzyılda Aristoteles, 2.000 yıl boyunca kullanılan bir canlılar sınıflandırma sistemi kurdu. Modern dünyada ise sınıflandırma genellikle bir makine öğrenimi görevi, daha özelde gözetimli öğrenme görevi olarak ele alınır. Gözetimli öğrenmenin temel ilkesi basittir: tahmin değişkenleri ve bir hedef değişkenden oluşan bir yığın verimiz vardır. Gözetimli öğrenmenin amacı, tahmin değişkenleri verildiğinde hedef değişkeni tahmin etmede ‘iyi’ olan bir model kurmaktır. Hedef değişken kategorilerden oluşuyorsa (ör. ‘tık’ ya da ‘değil’, ‘kötü huylu’ ya da ‘iyi huylu’ tümör), bu öğrenme görevine sınıflandırma denir. Alternatif olarak, hedef sürekli değişen bir değişkense (ör. bir evin fiyatı), bu bir regresyon görevidir.
Örnekle anlatmak faydalı olacaktır: 75 tahmin değişkeni içeren (ör. ‘yaş’, ‘cinsiyet’ ve ‘sigara içiyor mu’) ve hedef değişkenin kalp hastalığının varlığını ifade edip 0’dan (kalp hastalığı yok) 4’e kadar değiştiği kalp hastalığı veri kümesini düşünün. Bu veri kümesi üzerinde yapılan çalışmaların çoğu, kalp hastalığının varlığını yokluğundan ayırt etmeye odaklanmıştır. Bu bir sınıflandırma görevidir. Hedef değişkenin gerçek değerini (0’dan 4’e) tahmin etmeye çalışsaydınız, bu (hedef değişken sıralı olduğundan) bir regresyon problemi olurdu. Regresyonu bir sonraki yazıda tartışacağım. Burada sınıflandırma görevleri için en basit algoritmalardan biri olan k-En Yakın Komşular (k-NN) algoritmasına bakacağım.
Makine öğreniminde sınıflandırma için k-En Yakın Komşu
Diyelim ki etiketlenmiş verilerimiz var; örneğin, kırmızı şarabın özelliklerinden (ör. alkol oranı, yoğunluk, sitrik asit miktarı, pH vb.; bunlar tahmin değişkenleridir) oluşan, ‘Kalite’ hedef değişkenine ve ‘iyi’ & ‘kötü’ etiketlerine sahip bir veri. O halde, yeni ve etiketlenmemiş bir şarabın özellikleri verildiğinde sınıflandırma görevi, onun ‘Kalite’sini tahmin etmektir. Tüm tahmin değişkenleri sayısal olduğunda (kategorik durumla başa çıkmanın yolları da vardır), her satır/şarabı n boyutlu uzayda bir nokta olarak düşünebiliriz ve bu durumda k-En Yakın Komşular (k-NN) kavramsal ve hesaplama açısından basit bir sınıflandırma yöntemidir: Yeni, etiketlenmemiş her şarap için, bazı tamsayı k değeri için, n boyutlu tahmin değişkenleri uzayındaki k en yakın komşusunu hesaplarız. Sonra bu k komşunun etiketlerine bakarız (‘iyi’ ya da ‘kötü’) ve en çok oyu alan etiketi yeni şaraba atarız (ör. k = 5 ise, 3 komşu ‘iyi’, 2 komşu ‘kötü’ oyu verirse, modelimiz yeni şarabı ‘iyi’ olarak etiketler). Burada, modeli eğitmenin tamamen veri noktalarını saklamaktan ibaret olduğuna dikkat edin: Ayarlanacak parametre yoktur!
k-En Yakın Komşu’nun görsel bir betimi
Aşağıdaki görselde, 2B’de k-NN örneği var: Ortadaki veri noktasını nasıl sınıflandırırsınız? k=3 ise kırmızı, k=5 ise yeşil olarak sınıflandırırsınız.
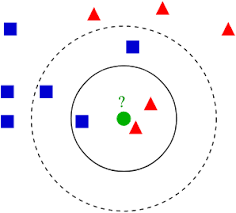
Python’da (scikit-learn) k-NN uygulaması
import pandas as pd%matplotlib inlineimport matplotlib.pyplot as pltplt.style.use('ggplot')df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')X = df.drop('quality' , 1).values # drop target variabley1 = df['quality'].valuespd.DataFrame.hist(df, figsize = [15,15]);
Önce tahmin değişkenlerinin aralığına dikkat edin: ‘serbest kükürt dioksit’ 0 ile ~70 arasında ve ‘uçucu asitlik’ ~0 ile ~1,2 arasında. Daha somut olarak, ilki ikincinin aralığından 2 mertebe daha büyüktür. Veri noktaları arasındaki mesafeyle ilgilenen k-NN gibi herhangi bir algoritma, bu nedenle doğrudan ve haksız biçimde ‘serbest kükürt dioksit’ gibi aralığı daha büyük değişkenlere odaklanabilir; ki bu değişken, bildiğimiz kadarıyla yalnızca gürültü de içerebilir. Bu durum, verilerimizi ölçeklendirmemiz için motivasyon sağlar; buna birazdan geleceğiz.
Şimdi hedef değişken, 3’ten 8’e kadar değişen bir şarap ‘Kalite’ puanıdır. Açıklamayı kolaylaştırmak için bunu ‘iyi’ (puan > 5) ve ‘kötü’ (puan <= 5) olmak üzere iki kategorili bir değişkene dönüştürelim. Ayrıca, olup biteni kavramak için hedef değişkenin her iki formülasyonunun da histogramlarını çizelim.
y = y1 <= 5 # is the rating <= 5?# plot histograms of original target variable# and aggregated target variableplt.figure(figsize=(20,5));plt.subplot(1, 2, 1 );plt.hist(y1);plt.xlabel('original target value')plt.ylabel('count')plt.subplot(1, 2, 2);plt.hist(y)plt.xlabel('aggregated target value')plt.show()
k-En Yakın Komşular: ne kadar iyi performans gösterir?
Not: doğruluk aynı zamanda bir karmaşıklık matrisi (confusion matrix) cinsinden de tanımlanabilir ve yaygın olarak ikili sınıflandırma problemleri için doğru pozitifler ve yanlış negatifler üzerinden ifade edilir; karmaşıklık matrisinden türetilen diğer yaygın model performansı ölçütleri arasında, doğru pozitiflerin sayısının doğru ve yanlış pozitiflerin toplamına oranı olan kesinlik (precision) ve doğru pozitiflerin sayısının doğru pozitifler ile yanlış negatiflerin toplamına oranı olan duyarlılık (recall) yer alır; bir diğer ölçüt olan F1 skoru ise kesinlik ve duyarlılığın harmonik ortalamasıdır. Bu ölçütlere dair güzel bir açıklama için machine learning mastery yazısına; ayrıca karmaşıklık matrisi ve F1 skoru ile ilgili Vikipedi maddelerine bakınız.
k-En Yakın Komşular: uygulamada performans ve eğitim-test ayrımı
from sklearn.cross_validation import train_test_splitX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)We now build the k-NN model, make predictions on the test set and compare these predictions to the ground truth in order to get a measure of model performance:from sklearn import neighbors, linear_modelknn = neighbors.KNeighborsClassifier(n_neighbors = 5)knn_model_1 = knn.fit(X_train, y_train)print('k-NN accuracy for test set: %f' % knn_model_1.score(X_test, y_test))k-NN accuracy for test set: 0.612500
scikit-learn’de k-NN için varsayılan puanlama yönteminin doğruluk olduğunu yinelemekte fayda var. %61 doğruluk harika değil, ancak herhangi bir önişleme olmadan kutudan çıktığı gibi bir model için de fena sayılmaz. Başka metriklere bakmak için scikit-learn’ün sınıflandırma raporunu da kullanabiliriz:
from sklearn.metrics import classification_reporty_true, y_pred = y_test, knn_model_1.predict(X_test)print(classification_report(y_true, y_pred))Şimdi, sayısal verilerin önişlemesinin en temel yöntemleri olan ölçeklendirme ve merkezlemeyi tanıtacak ve bunların model performansını etkileyip etkilemediğine bakacağız.
Önişlemenin Mekaniği: Ölçeklendirme ve Merkezleme
Bir modeli, örneğin regresyonu (sürekli bir değişkeni tahmin etme) ya da sınıflandırmayı (ayrık bir değişkeni tahmin etme), veriler üzerinde çalıştırmadan önce neredeyse her zaman bir miktar önişleme yapmak istersiniz. Sayısal değişkenler için verinizi ya normalize etmek ya da standardize etmek yaygındır. Bu terimler ne anlama gelir?
Normalize etmek, bir veri kümesini en küçüğü 0 ve en büyüğü 1 olacak şekilde ölçeklendirmekten ibarettir. Bunu başarmak için her bir veri noktasını $x$ şu dönüşümle dönüştürürüz
$$x_{normalized} = \frac{x-x_{min}}{x_{max}-x_{min}}.$$Standardizasyon biraz farklıdır; görevi veriyi 0 etrafında merkezlemek ve standart sapmaya göre ölçeklendirmektir:
$$x_{standardized} = \frac{x-\mu}{\sigma},$$burada $\mu$ ve $\sigma$ sırasıyla veri kümesinin ortalaması ve standart sapmasıdır. Öncelikle bu dönüşümlerin yalnızca verinin aralığını değiştirdiğini, dağılımı değiştirmediğini not edin. Daha sonra verinizi daha Gaussvari (çan eğrisi gibi) göstermek için log dönüşümü ya da Box-Cox dönüşümü gibi başka dönüşümler kullanmak isteyebilirsiniz. Ancak daha ileri gitmeden önce şu soruları sormak önemlidir: Neden verimizi ölçeklendiririz? Diğerlerine göre daha uygun olduğu zamanlar var mıdır? Örneğin, sınıflandırmada mı yoksa regresyonda mı daha önemlidir?
Önce sınıflandırma sorunlarına dalalım ve ölçeklendirmenin k-En Yakın Komşular’ın performansını nasıl etkilediğine bakalım:
Önişleme: uygulamada ölçeklendirme
Aşağıda (i) veriyi ölçeklendiriyor, (ii) k-En Yakın Komşular’ı kullanıyor ve (iii) model performansını kontrol ediyorum. scikit-learn’ün, kendisine geçirilen dizideki tüm özellikleri (sütunları) standardize eden scale fonksiyonunu kullanacağım.
from sklearn.preprocessing import scaleXs = scale(X)from sklearn.cross_validation import train_test_splitXs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)knn_model_2 = knn.fit(Xs_train, y_train)print('k-NN score for test set: %f' % knn_model_2.score(Xs_test, y_test))print('k-NN score for training set: %f' % knn_model_2.score(Xs_train, y_train))y_true, y_pred = y_test, knn_model_2.predict(Xs_test)print(classification_report(y_true, y_pred)) k-NN score for test set: 0.712500k-NN score for training set: 0.814699 precision recall f1-score support False 0.72 0.79 0.75 179 True 0.70 0.62 0.65 141avg / total 0.71 0.71 0.71 320Tüm bu ölçütler 0,1 arttı; bu, %16’lık anlamlı bir iyileşme! Yukarıda ima edildiği gibi, ölçeklendirme öncesinde farklı mertebelerde aralıklara sahip bir dizi tahmin değişkeni vardı; bu da k-NN gibi bir algoritmanın bağlamında bir ya da ikisinin baskın olabileceği anlamına geliyordu. Verilerinizi ölçeklendirmenin iki ana nedeni şunlardır
- Tahmin değişkenleriniz önemli ölçüde farklı aralıklara sahip olabilir ve k-NN uygulamak gibi belirli durumlarda, bazı özelliklerin algoritmaya hükmetmesini önlemek için bunun etkisini azaltmak gerekir;
- Özelliklerinizin birimden bağımsız olmasını istersiniz; yani, ölçüm ölçeğine bağlı olmamasını: Örneğin sizde bir özellik metre cinsinden, bende aynı özellik santimetre cinsinden ifade edilmiş olabilir. İkimiz de verilerimizi ölçeklendirirsek bu özellik ikimiz için de aynı hale gelir.
Veri bilimi hattında ölçeklendirme ve merkezleme biçimindeki önişlemenin işgal ettiği asli yeri gördük ve bunu, makine öğrenimi zorluklarına bütüncül bir yaklaşımı teşvik etmek için yaptık. Gelecekteki yazılarda bu tartışmayı, sayısal verilerin dönüşümü ve kategorik verilerin önişlemesi gibi diğer önişleme türlerine genişletmeyi umuyorum; bunların ikisi de herhangi bir veri bilimcisinin araç setinin temel parçalarıdır. Buna geçmeden önce, bir sonraki yazıda sınıflandırmaya yönelik regresyon yaklaşımlarında ölçeklendirmenin rolünü inceleyeceğim. Özellikle lojistik regresyona bakacağım ve sonucun, k-En Yakın Komşular bağlamında az önce gördüğünüzden çok farklı olduğunu göreceksiniz.
Aşağıdaki etkileşimli pencerede verilerle kendiniz oynayabilirsiniz. k-NN algoritmasında kullanılacak komşu sayısı olan n_neig değişkenini değiştirerek başlayın. İsterseniz sc = True ayarıyla verileri ölçeklendirebilirsiniz. Ardından, modelin doğruluğunu ve sınıflandırma raporunu görmek için betiğin tamamını çalıştırın.
import pandas as pdimport matplotlib.pyplot as pltfrom sklearn.cross_validation import train_test_splitfrom sklearn import neighborsfrom sklearn.preprocessing import scalefrom sklearn.metrics import classification_report # Set the the number of neighbors for k-NNn_neig = 5# Set sc = True if you want to scale your featuressc = False# Load datadf = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')X = df.drop('quality' , 1).values# drop target variable# Here we scale, if desiredif sc == True: X = scale(X)# Target valuey1 = df['quality'].values# original target variabley = y1 <= 5# new target variable: is the rating <= 5?# Split the data into a test set and a training setX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)# Train k-NN model and print performance on the test setknn = neighbors.KNeighborsClassifier(n_neighbors = n_neig)knn_model = knn.fit(X_train, y_train)y_true, y_pred = y_test, knn_model.predict(X_test)print('k-NN accuracy for test set: %f' % knn_model.score(X_test, y_test))print(classification_report(y_true, y_pred))Sözlük
Gözetimli öğrenme: Hedef değişkenin, tahmin değişkenlerinden çıkarım yoluyla elde edilmesi görevi. Örneğin, ‘kalp hastalığının varlığı’ hedef değişkeninin ‘yaş’, ‘cinsiyet’ ve ‘sigara içme durumu’ gibi tahmin değişkenlerinden çıkarılması.
Sınıflandırma görevi: Hedef değişken kategorilerden oluşuyorsa (ör. ‘tık’ ya da ‘değil’, ‘kötü huylu’ ya da ‘iyi huylu’ tümör) bir gözetimli öğrenme görevi bir sınıflandırma görevidir.
Regresyon görevi: Hedef değişken sürekli değişen bir değişken (ör. bir evin fiyatı) ya da ‘şarabın kalite puanı’ gibi sıralı kategorik bir değişkense, bir gözetimli öğrenme görevi bir regresyon görevidir.
k-En Yakın Komşular: Bir veri noktasına, k en yakın komşusunun çoğunluk oyuyla belirlenen etiketin atandığı sınıflandırma görevlerine yönelik bir algoritma.
Önişleme: Veri bilimcilerin verilerini yapmak istedikleri işe daha uygun bir hale getirmek için kullandıkları çok sayıda işlem. Örneğin, Twitter verilerinde duygu analizi gerçekleştirmeden önce HTML etiketlerini ve boşlukları temizlemek, kısaltmaları açmak ve tweet’leri içerdiği kelimelerin listelerine bölmek isteyebilirsiniz.
Merkezleme ve Ölçeklendirme: Bunların ikisi de sayısal verilerin önişleme biçimleridir; yani kategoriler ya da dizgeler yerine sayılardan oluşan veriler. Bir değişkeni merkezlemek, her veri noktasından değişkenin ortalamasını çıkararak yeni değişkenin ortalamasını 0 yapmaktır; bir değişkeni ölçeklendirmek ise verinin aralığını değiştirmek için her veri noktasını bir sabitle çarpmaktır. Bunların önemine ve örneklerine yazının gövdesinde bakınız.
Bu makale bir Jupyter not defterinden üretildi. Not defterini buradan indirebilirsiniz.




