En este artículo usaré el ejemplo del escalado de datos numéricos (datos numéricos: datos que consisten en números, a diferencia de categorías/cadenas; escalado: uso de aritmética básica para cambiar el rango de los datos; más detalles a continuación) para mostrar por qué conviene considerar el preprocesamiento como parte de una estructura mayor: la canalización de machine learning (ML). Para ello, veremos un ejemplo real en el que el escalado puede mejorar el rendimiento del modelo.
Primero presentaré los problemas de clasificación en ML y k-Nearest Neighbors, uno de los algoritmos más sencillos en este ámbito. Para entender la importancia de escalar los datos numéricos en este contexto, tendré que introducir medidas de rendimiento del modelo y los conceptos de conjuntos de entrenamiento y prueba. Verás todos estos conceptos y prácticas en acción con un conjunto de datos en el que intento clasificar la calidad del vino tinto. También me aseguraré de colocar el preprocesamiento en el lugar más útil, cerca del inicio de una canalización iterativa de ciencia de datos. Todos los ejemplos serán en Python. Si no estás familiarizado con Python, puedes consultar nuestros cursos de DataCamp aquí. Utilizaré las librerías pandas para trabajar con dataframes y scikit-learn para las necesidades de machine learning.
Este es el primer artículo de un tutorial en tres partes:
Parte 2: Centrado, escalado y regresión logística
Parte 3: Escalado de datos sintetizados
Breve introducción a los problemas de clasificación en machine learning
Clasificar y etiquetar cosas en el mundo fenomenológico es un arte ancestral. En el siglo IV a. C., Aristóteles construyó un sistema de clasificación de los seres vivos que se utilizó durante 2.000 años. En el mundo moderno, la clasificación suele enmarcarse como una tarea de machine learning, en concreto, una tarea de aprendizaje supervisado. El principio básico del aprendizaje supervisado es sencillo: disponemos de un conjunto de datos con variables predictoras y una variable objetivo. El objetivo del aprendizaje supervisado es construir un modelo que sea "bueno" prediciendo la variable objetivo a partir de las variables predictoras. Si la variable objetivo es categórica (p. ej., "clic" o "no", tumor "maligno" o "benigno"), llamamos a la tarea clasificación. Si, en cambio, la variable objetivo varía de forma continua (p. ej., el precio de una vivienda), se trata de una tarea de regresión.
Un ejemplo ilustrativo ayuda mucho: piensa en el conjunto de datos de enfermedad cardíaca, con 75 variables predictoras como "edad", "sexo" y "si fuma o no", y una variable objetivo que indica la presencia de enfermedad cardíaca y va de 0 (sin enfermedad) a 4. Gran parte del trabajo con este conjunto se ha centrado en distinguir entre presencia y ausencia de la enfermedad. Esto es una tarea de clasificación. Si intentaras predecir el valor exacto (0 a 4) de la variable objetivo, sería un problema de regresión (porque la variable objetivo está ordenada). Hablaré de regresión en el siguiente artículo. Aquí veré uno de los algoritmos más sencillos para clasificación: el algoritmo de k-Nearest Neighbors.
k-Nearest Neighbors para clasificación en machine learning
Imagina que tenemos datos etiquetados, por ejemplo, datos con características de vinos tintos (contenido de alcohol, densidad, ácido cítrico, pH, etc.; estas son las variables predictoras) con la variable objetivo "Quality" y etiquetas "good" y "bad". Dadas las características de un vino nuevo sin etiqueta, la tarea de clasificación consiste en predecir su "Quality". Cuando todas las variables predictoras son numéricas (también hay formas de tratar el caso categórico), podemos considerar cada fila/vino como un punto en un espacio n-dimensional y, en ese caso, k-Nearest Neighbors (k-NN) es un método de clasificación sencillo tanto conceptual como computacionalmente: para cada vino nuevo sin etiqueta, calculamos, para algún entero k, sus k vecinos más cercanos en el espacio n-dimensional de variables predictoras. Luego miramos las etiquetas de esos k vecinos ("good" o "bad") y asignamos al vino nuevo la etiqueta con más votos (p. ej., si k = 5, 3 vecinos votan "good" y 2 votan "bad", entonces el modelo etiqueta el vino como "good"). Observa que aquí entrenar el modelo consiste únicamente en almacenar los datos: ¡no hay parámetros que ajustar!
Descripción visual de k-Nearest Neighbors
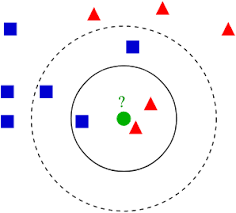
En la imagen siguiente tienes un ejemplo de k-NN en 2D: ¿cómo clasificarías el punto central? Pues bien, si k=3 lo clasificarías como rojo y, si k=5, como verde.
Implementación de k-NN en Python (scikit-learn)
import pandas as pd%matplotlib inlineimport matplotlib.pyplot as pltplt.style.use('ggplot')df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')X = df.drop('quality' , 1).values # drop target variabley1 = df['quality'].valuespd.DataFrame.hist(df, figsize = [15,15]);
Fíjate primero en los rangos de las variables predictoras: "free sulfur dioxide" va de 0 a ~70 y "volatile acidity" de ~0 a ~1,2. Más en concreto, la primera tiene un rango 2 órdenes de magnitud mayor que la segunda. Cualquier algoritmo que tenga en cuenta la distancia entre puntos, como k-NN, puede centrarse de forma desproporcionada en variables con rangos mayores, como "free sulfur dioxide", que por lo que sabemos podría contener solo ruido. Esto motiva escalar los datos, a lo que llegaremos enseguida.
La variable objetivo es una valoración de "Quality" del vino que va de 3 a 8. Para simplificar la exposición, convirtámosla en una variable binaria con "good" (rating > 5) y "bad" (rating <= 5). También representaremos histogramas de ambas formulaciones de la variable objetivo para entender mejor qué ocurre.
y = y1 <= 5 # is the rating <= 5?# plot histograms of original target variable# and aggregated target variableplt.figure(figsize=(20,5));plt.subplot(1, 2, 1 );plt.hist(y1);plt.xlabel('original target value')plt.ylabel('count')plt.subplot(1, 2, 2);plt.hist(y)plt.xlabel('aggregated target value')plt.show()
k-Nearest Neighbors: ¿qué tal rinde?
Nota: la accuracy también puede definirse en términos de la matriz de confusión y, en problemas binarios, se expresa a partir de verdaderos positivos y falsos negativos; otras medidas habituales derivadas de la matriz de confusión son la precisión (true positives entre true + false positives) y el recall (true positives entre true positives + false negatives). Otra métrica, el F1-score, es la media armónica de precisión y recall. Consulta machine learning mastery para una buena exposición de estas métricas; también las entradas de Wikipedia sobre la matriz de confusión y el F1 score.
k-Nearest Neighbors: rendimiento en la práctica y división train-test
from sklearn.cross_validation import train_test_splitX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)We now build the k-NN model, make predictions on the test set and compare these predictions to the ground truth in order to get a measure of model performance:from sklearn import neighbors, linear_modelknn = neighbors.KNeighborsClassifier(n_neighbors = 5)knn_model_1 = knn.fit(X_train, y_train)print('k-NN accuracy for test set: %f' % knn_model_1.score(X_test, y_test))k-NN accuracy for test set: 0.612500
Conviene reiterar que el método de scoring por defecto para k-NN en scikit-learn es la accuracy. Una accuracy del 61% no es brillante, pero para un modelo listo para usar y sin preprocesamiento tampoco es desastrosa. Para explorar otras métricas, también podemos usar el classification report de scikit-learn:
from sklearn.metrics import classification_reporty_true, y_pred = y_test, knn_model_1.predict(X_test)print(classification_report(y_true, y_pred))Ahora vamos a introducir el escalado y el centrado, los métodos más básicos para preprocesar datos numéricos, y veremos si afectan o no al rendimiento del modelo.
Mecánica del preprocesamiento: escalado y centrado
Antes de ajustar un modelo, ya sea de regresión (predecir una variable continua) o de clasificación (predecir una variable discreta), casi siempre conviene realizar cierto preprocesamiento. Para variables numéricas, es habitual normalizar o estandarizar los datos. ¿Qué significan estos términos?
Normalizar significa escalar un conjunto de datos para que su mínimo sea 0 y su máximo 1. Para lograrlo transformamos cada punto de datos x en
$$x_{normalized} = \frac{x-x_{min}}{x_{max}-x_{min}}.$$La estandarización es ligeramente distinta; su función es centrar los datos en torno a 0 y escalar con respecto a la desviación estándar:
$$x_{standardized} = \frac{x-\mu}{\sigma},$$donde \mu y \sigma son la media y la desviación estándar del conjunto, respectivamente. Observa primero que estas transformaciones solo cambian el rango de los datos, no su distribución. Más adelante quizá quieras aplicar otras transformaciones, como log o Box-Cox, para que tus datos se parezcan más a una distribución gaussiana (en forma de campana). Pero antes de seguir, es importante hacerse estas preguntas: ¿por qué escalamos los datos? ¿Hay situaciones en las que tenga más sentido que en otras? Por ejemplo, ¿es más importante en clasificación que en regresión?
Empecemos por los retos de clasificación y veamos cómo afecta el escalado al rendimiento de k-Nearest Neighbors:
Preprocesamiento: escalado en la práctica
A continuación (i) escalo los datos, (ii) aplico k-Nearest Neighbors y (iii) evalúo el rendimiento. Usaré la función scale de scikit-learn, que estandariza todas las características (columnas) del array que recibe.
from sklearn.preprocessing import scaleXs = scale(X)from sklearn.cross_validation import train_test_splitXs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)knn_model_2 = knn.fit(Xs_train, y_train)print('k-NN score for test set: %f' % knn_model_2.score(Xs_test, y_test))print('k-NN score for training set: %f' % knn_model_2.score(Xs_train, y_train))y_true, y_pred = y_test, knn_model_2.predict(Xs_test)print(classification_report(y_true, y_pred)) k-NN score for test set: 0.712500k-NN score for training set: 0.814699 precision recall f1-score support False 0.72 0.79 0.75 179 True 0.70 0.62 0.65 141avg / total 0.71 0.71 0.71 320Todas estas métricas mejoraron en 0,1, lo que supone una mejora del 16% y es significativa. Como apuntábamos, antes de escalar había variables predictoras con rangos de distinto orden de magnitud, de modo que una o dos podían dominar en un algoritmo como k-NN. Las dos razones principales para escalar tus datos son:
- Tus variables predictoras pueden tener rangos muy diferentes y, en situaciones como la implementación de k-NN, hay que mitigarlo para que ciertas características no dominen el algoritmo;
- Quieres que las características sean independientes de la unidad, es decir, que no dependan de la escala de medida: por ejemplo, tú podrías tener una característica medida en metros y yo la misma en centímetros. Si ambos escalamos nuestros datos, esa característica será comparable para los dos.
Hemos visto el papel esencial del preprocesamiento —en su forma de escalado y centrado— dentro de la canalización de ciencia de datos, y lo hemos hecho para fomentar un enfoque holístico de los retos de machine learning. En próximos artículos, me gustaría ampliar este debate a otros tipos de preprocesamiento, como transformaciones de datos numéricos y el preprocesamiento de datos categóricos, ambos esenciales en la caja de herramientas de cualquier profesional de datos. Antes de eso, en el siguiente artículo exploraré el papel del escalado en enfoques de regresión para la clasificación. En particular, revisaré la regresión logística y verás que el resultado es muy distinto al que acabas de ver con k-Nearest Neighbors.
En la ventana interactiva de abajo puedes trastear con los datos. Empieza cambiando la variable n_neig, que es el número de vecinos que usa el algoritmo k-NN. También puedes escalar los datos poniendo sc = True, si quieres. Luego ejecuta todo el script para ver la accuracy del modelo y un classification report.
import pandas as pdimport matplotlib.pyplot as pltfrom sklearn.cross_validation import train_test_splitfrom sklearn import neighborsfrom sklearn.preprocessing import scalefrom sklearn.metrics import classification_report # Set the the number of neighbors for k-NNn_neig = 5# Set sc = True if you want to scale your featuressc = False# Load datadf = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')X = df.drop('quality' , 1).values# drop target variable# Here we scale, if desiredif sc == True: X = scale(X)# Target valuey1 = df['quality'].values# original target variabley = y1 <= 5# new target variable: is the rating <= 5?# Split the data into a test set and a training setX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)# Train k-NN model and print performance on the test setknn = neighbors.KNeighborsClassifier(n_neighbors = n_neig)knn_model = knn.fit(X_train, y_train)y_true, y_pred = y_test, knn_model.predict(X_test)print('k-NN accuracy for test set: %f' % knn_model.score(X_test, y_test))print(classification_report(y_true, y_pred))Glosario
Aprendizaje supervisado: Tarea de inferir una variable objetivo a partir de variables predictoras. Por ejemplo, inferir la variable objetivo "presencia de enfermedad cardíaca" a partir de variables predictoras como "edad", "sexo" y "si fuma".
Tarea de clasificación: Una tarea de aprendizaje supervisado es de clasificación si la variable objetivo es categórica (p. ej., "clic" o "no", tumor "maligno" o "benigno").
Tarea de regresión: Una tarea de aprendizaje supervisado es de regresión si la variable objetivo es continua (p. ej., precio de una vivienda) o una variable categórica ordenada como la "valoración de calidad del vino".
k-Nearest Neighbors: Algoritmo para tareas de clasificación en el que a un punto de datos se le asigna la etiqueta decidida por la mayoría de sus k vecinos más cercanos.
Preprocesamiento: Conjunto de operaciones para dejar los datos en una forma más adecuada al objetivo. Por ejemplo, antes de analizar el sentimiento en datos de Twitter, quizá quieras eliminar etiquetas HTML, espacios en blanco, expandir abreviaturas y dividir los tuits en listas de palabras.
Centrado y escalado: Ambos son formas de preprocesar datos numéricos (datos que consisten en números, a diferencia de categorías o cadenas). Centrar una variable es restar su media a cada dato para que la nueva media sea 0; escalar una variable es multiplicar cada dato por una constante para alterar el rango. Consulta el cuerpo del artículo para ver su importancia y ejemplos.
Este artículo se generó a partir de un cuaderno de Jupyter. Puedes descargarlo aquí.