
Last chance! 50% off DataCamp Premium
Sale ends in
Pada artikel pertama dalam seri ini, saya membahas peran prapemrosesan dalam tugas klasifikasi machine learning (ML), dengan pembahasan mendalam tentang algoritma k-Nearest Neighbours (k-NN) dan kumpulan data kualitas wine. Di sana Anda melihat bahwa centering dan scaling data numerik meningkatkan kinerja k-NN untuk sejumlah metrik kinerja model (misalnya akurasi). Anda juga melihat bahwa prapemrosesan tidak terjadi secara terpisah dan nilainya hanya dapat dinilai ketika dilihat dalam konteks pipeline ML berorientasi prediksi. Namun, kita hanya melihat pentingnya prapemrosesan dalam konteks satu model, k-NN. Dalam kasus itu, model kita berkinerja jauh lebih baik — tetapi apakah ini selalu terjadi? Tidak selalu! Dalam artikel ini, saya akan membahas peran scaling dan centering data numerik dalam model dasar lainnya, regresi logistik. Anda mungkin ingin menyegarkan ingatan dengan melihat artikel sebelumnya dan/atau glosarium istilah di bagian bawah tulisan ini. Sekali lagi, kita akan mengeksplorasi kumpulan data kualitas wine. Semua contoh di sini menggunakan Python. Jika Anda belum familiar dengan Python, Anda dapat melihat semua kursus data science kami di sini. Saya akan menggunakan pustaka pandas untuk kebutuhan dataframe dan scikit-learn untuk kebutuhan machine learning.
Saya akan terlebih dahulu memberi pengantar singkat tentang regresi, yang dapat digunakan untuk memprediksi nilai variabel numerik maupun kelas. Saya akan memperkenalkan regresi linear, regresi logistik, lalu menggunakan yang terakhir untuk memprediksi kualitas wine merah. Anda kemudian akan melihat apakah centering dan scaling membantu model kita dalam konteks regresi.
Seperti disebutkan di atas, regresi lazim digunakan untuk memprediksi nilai satu variabel numerik dari variabel numerik lainnya. Sebagai contoh, di bawah ini kita melakukan regresi linear pada data perumahan Boston (kumpulan data bawaan di scikit-learn): dalam hal ini, variabel independen (sumbu-x) adalah jumlah kamar dan variabel dependen (sumbu-y) adalah harga.
Bagaimana regresi seperti ini bekerja? Secara singkat, mekanismenya sebagai berikut: kita ingin menyesuaikan model \(y = ax + b\) ke data \((x_i,y_i)\), yaitu, kita ingin menemukan \(a\) dan \(b\) yang optimal, diberikan data tersebut. Dalam formulasi ordinary least squares (OLS, sejauh ini yang paling umum), diasumsikan bahwa galat terjadi pada variabel dependen. Karena itu, \(a\) dan \(b\) optimal ditemukan dengan meminimalkan \[SSE = \sum_i (y_i - (ax_i + b))^2\] dan optimisasi ini umumnya dicapai menggunakan algoritma yang dikenal sebagai gradient descent. Di sini kita melakukan regresi linear sederhana pada data perumahan Boston:
# Import necessary packages
import pandas as pd
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
from sklearn import datasets
from sklearn import linear_model
import numpy as np

# Load data
boston = datasets.load_boston()
yb = boston.target.reshape(-1, 1)
Xb = boston['data'][:,5].reshape(-1, 1)

# Plot data
plt.scatter(Xb,yb)
plt.ylabel('value of house /1000 ($)')
plt.xlabel('number of rooms')

# Create linear regression object
regr = linear_model.LinearRegression()
# Train the model using the training sets
regr.fit( Xb, yb)

# Plot outputs
plt.scatter(Xb, yb,  color='black')
plt.plot(Xb, regr.predict(Xb), color='blue',
         linewidth=3)
plt.show()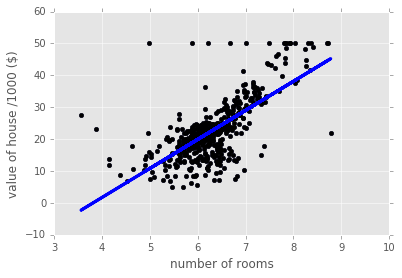
Regresi ini menangkap tren kenaikan umum dari data tetapi tidak banyak lagi. Kita hanya menggunakan satu variabel prediktor dan bisa saja menggunakan lebih banyak, yang dalam hal itu kita akan memiliki \(n\) koefisien \(a_1,\ldots,a_n\) dalam model, masing-masing untuk satu variabel prediktor. Perlu dicatat bahwa besaran variabel \(a_i\) memberi tahu kita seberapa kuat variabel terkait berkorelasi dengan variabel target.
Regresi juga dapat digunakan untuk masalah klasifikasi. Contoh alaminya adalah regresi logistik. Dalam klasifikasi biner (dua label), kita dapat memandang label sebagai 0 & 1. Sekali lagi dengan menyatakan variabel prediktor sebagai \(x\), model regresi logistik diberikan oleh fungsi logistik \[F(x) = \frac{1}{1+e^{-(ax+b)}}.\] Ini berbentuk sigmoid (melengkung seperti huruf S) dan Anda dapat melihat contohnya di bawah. Untuk setiap \(x\) tertentu, jika \(F(x) <0.5\), maka model logistik memprediksi y = 0 dan, sebaliknya, jika \(F(X) > 0.5\) model memprediksi \(y = 1\). Sekali lagi, jika kita memiliki lebih dari satu variabel prediktor, kita juga memiliki \(n\) koefisien \(a_1,\ldots,a_n\), masing-masing untuk setiap variabel prediktor. Dalam hal ini, besaran variabel \(a_i\) memberi tahu kita seberapa kuat variabel terkait memengaruhi variabel prediktor.
# Synthesize data
X1 = np.random.normal(size=150)
y1 = (X1 > 0).astype(np.float)
X1[X1 > 0] *= 4
X1 += .3 * np.random.normal(size=150)
X1= X1.reshape(-1, 1)

# Run the classifier
clf = linear_model.LogisticRegression()
clf.fit(X1, y1)

# Plot the result
plt.scatter(X1.ravel(), y1, color='black', zorder=20 , alpha = 0.5)
plt.plot(X1_ordered, clf.predict_proba(X1_ordered)[:,1], color='blue' , linewidth = 3)
plt.ylabel('target variable')
plt.xlabel('predictor variable')
plt.show()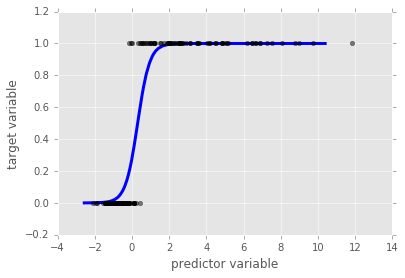
Sekarang kita telah melihat mekanisme regresi logistik, mari terapkan pengklasifikasi regresi logistik pada kumpulan data wine kita yang lezat. Saya akan mengimpor data dan memplot variabel target (wine bagus/buruk) sebagai pengingat:
# Import necessary modules
from sklearn import linear_model
from sklearn.cross_validation import train_test_split

# Load data
df = pd.read_csv('http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv ' , sep = ';')
X = df.drop('quality' , 1).values #drop target variable
y1 = df['quality'].values
y = y1 <= 5 # is the rating <= 5?

# plot histograms of original target variable
# and aggregated target variable
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.hist(y1);
plt.xlabel('original target value')
plt.ylabel('count')
plt.subplot(1, 2, 2);
plt.hist(y)
plt.xlabel('aggregated target value')
plt.show()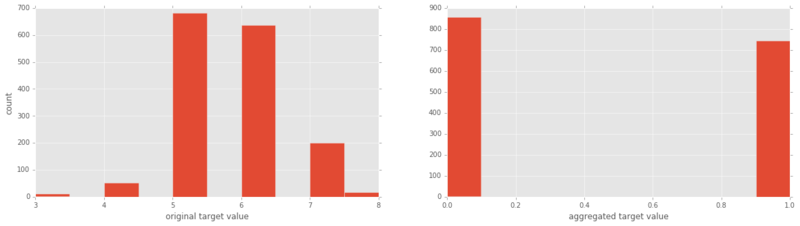
Sekarang mari jalankan regresi logistik kita dan lihat kinerjanya!
# Split the data into test and training sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

#initial logistic regression model
lr = linear_model.LogisticRegression()

# fit the model
lr = lr.fit(X_train, y_train)
print('Logistic Regression score for training set: %f' % lr.score(X_train, y_train))
from sklearn.metrics import classification_report
y_true, y_pred = y_test, lr.predict(X_test)
print(classification_report(y_true, y_pred))
Logistic Regression score for training set: 0.752932
precision recall f1-score support
False 0.78 0.74 0.76 179
True 0.69 0.74 0.71 141
avg / total 0.74 0.74 0.74 320Secara default, regresi logistik ini berkinerja lebih baik daripada K-NN (dengan atau tanpa scaling). Sekarang mari kita skalakan data kita dan lakukan regresi logistik:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
lr_2 = lr.fit(Xs_train, y_train)
print('Scaled Logistic Regression score for test set: %f' % lr_2.score(Xs_test, y_test))
y_true, y_pred = y_test, lr_2.predict(Xs_test)
print(classification_report(y_true, y_pred))
Scaled Logistic Regression score for test set: 0.740625
precision recall f1-score support
False 0.79 0.74 0.76 179
True 0.69 0.74 0.72 141
avg / total 0.74 0.74 0.74 320Ini sangat menarik! Kinerja regresi logistik tidak meningkat dengan penskalaan data. Mengapa tidak, terutama ketika kita melihat bahwa kinerja k-Nearest Neighbours meningkat secara signifikan dengan scaling? Alasannya adalah, jika ada variabel prediktor dengan rentang besar yang tidak memengaruhi variabel target, algoritma regresi akan membuat koefisien terkait \(a_i\) menjadi kecil sehingga tidak terlalu memengaruhi prediksi. K-nearest neighbours tidak memiliki strategi bawaan seperti itu sehingga kita memang sangat perlu melakukan penskalaan data.
Pada artikel berikutnya, saya akan mengurai perbedaan hasil centering dan scaling pada k-NN dan regresi logistik dengan menyintesis sebuah kumpulan data, menambahkan noise, dan melihat bagaimana centering dan scaling mengubah kinerja kedua model sebagai fungsi dari kekuatan noise.
Pada jendela interaktif di bawah ini, Anda dapat bereksperimen sendiri dengan datanya. Anda dapat melakukan penskalaan data dengan menyetel sc = True, jika diinginkan. Kemudian jalankan seluruh skrip untuk melaporkan akurasi model regresi logistik, beserta classification report.
Pembelajaran terawasi (Supervised learning): Tugas menyimpulkan sebuah variabel target dari variabel prediktor. Misalnya, menyimpulkan variabel target ‘keberadaan penyakit jantung’ dari variabel prediktor seperti ‘usia’, ‘jenis kelamin’, dan ‘status perokok’.
Tugas klasifikasi: Tugas pembelajaran terawasi disebut tugas klasifikasi jika variabel target terdiri atas kategori (misalnya ‘klik’ atau ‘tidak’, tumor ‘ganas’ atau ‘jinak’).
Tugas regresi: Tugas pembelajaran terawasi disebut tugas regresi jika variabel target merupakan variabel yang bervariasi secara kontinu (misalnya harga rumah) atau variabel kategorikal berurutan seperti ‘peringkat kualitas wine’.
k-Nearest Neighbors: Algoritma untuk tugas klasifikasi, di mana sebuah titik data diberi label yang ditentukan oleh suara mayoritas dari k tetangga terdekatnya.
Prapemrosesan: Berbagai operasi yang digunakan data scientist untuk menyiapkan data agar lebih sesuai dengan tujuan yang ingin dicapai. Misalnya, sebelum melakukan analisis sentimen pada data Twitter, Anda mungkin ingin menghapus tag HTML, spasi kosong, menguraikan singkatan, dan memecah cuitan menjadi daftar kata yang dikandungnya.
Centering dan Scaling: Keduanya adalah bentuk prapemrosesan data numerik, yaitu data yang terdiri dari angka, bukan kategori atau string, misalnya; centering suatu variabel berarti mengurangkan nilai rata-rata variabel dari setiap titik data sehingga rata-rata variabel baru menjadi 0; scaling suatu variabel berarti mengalikan setiap titik data dengan suatu konstanta untuk mengubah rentang data. Lihat isi artikel untuk pentingnya kedua hal ini, beserta contohnya.
Artikel ini dihasilkan dari sebuah notebook Jupyter. Anda dapat mengunduh notebook-nya di sini.
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



