
Last chance! 50% off DataCamp Premium
Sale ends in
Dalam dua tulisan sebelumnya, saya membahas peran prapemrosesan data dalam pipeline machine learning. Secara khusus, saya meninjau algoritme k-Nearest Neighbors (k-NN) dan regresi logistik dan melihat bagaimana penskalaan data numerik sangat memengaruhi performa yang pertama, namun tidak pada yang kedua, seperti diukur misalnya dengan akurasi (lihat Glosarium di bawah atau artikel sebelumnya untuk definisi penskalaan, k-NN, dan istilah relevan lainnya). Pesan utama yang perlu diambil adalah bahwa prapemrosesan tidak terjadi dalam ruang hampa; artinya, Anda bisa melakukan prapemrosesan habis-habisan pada data Anda, tetapi buktinya ada pada hasil: seberapa baik model Anda bekerja?
Penskalaan data numerik (yaitu mengalikan semua instance suatu variabel dengan konstanta untuk mengubah rentang variabel tersebut) memiliki dua tujuan terkait: i) jika pengukuran Anda dalam meter dan saya dalam mil, maka jika kita berdua melakukan skala pada data masing-masing, hasilnya menjadi sebanding & ii) jika dua variabel memiliki rentang yang sangat berbeda, variabel dengan rentang lebih besar dapat mendominasi model prediktif Anda, meskipun mungkin kurang penting bagi variabel target dibanding variabel dengan rentang lebih kecil. Kita melihat bahwa masalah yang diidentifikasi pada poin ii) terjadi pada k-NN, yang secara eksplisit melihat seberapa dekat data satu sama lain, tetapi tidak pada regresi logistik yang, saat dilatih, akan mengecilkan koefisien terkait untuk mengompensasi kurangnya penskalaan.
Karena data yang digunakan pada artikel sebelumnya adalah data dunia nyata, yang bisa kita lihat hanya bagaimana performa model sebelum dan sesudah penskalaan. Di sini, untuk melihat bagaimana derau berupa variabel pengganggu (yang tidak memengaruhi variabel target tetapi dapat memengaruhi model Anda) mengubah performa model baik pra- maupun pascapenskalaan, saya akan menyintesis sebuah dataset di mana saya dapat mengendalikan sifat pasti variabel pengganggu tersebut. Kita akan melihat bahwa semakin berderau data sintetisnya, semakin penting penskalaan untuk k-NN. Semua contoh di sini menggunakan Python. Jika Anda belum familiar dengan Python, Anda dapat melihat kursus DataCamp kami di sini. Saya akan menggunakan pustaka pandas untuk kebutuhan DataFrame dan scikit-learn untuk kebutuhan machine learning.
Pada potongan kode di bawah, kita menggunakan fungsi make_blobs dari scikit-learn untuk menghasilkan 2000 titik data dalam 4 klaster (setiap titik data memiliki 2 variabel prediktor dan 1 variabel target).
# Generate some clustered data (blobs!)
import numpy as np
from sklearn.datasets.samples_generator import make_blobs
n_samples=2000
X, y = make_blobs(n_samples, centers=4, n_features=2,
random_state=0)Sekarang kita akan memplot di bidang datar data yang telah kita sintesis. Setiap sumbu adalah variabel prediktor dan warna menunjukkan variabel target:
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('ggplot')
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(X[:,0] , X[:,1],  c = y, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.hist(y)
plt.show()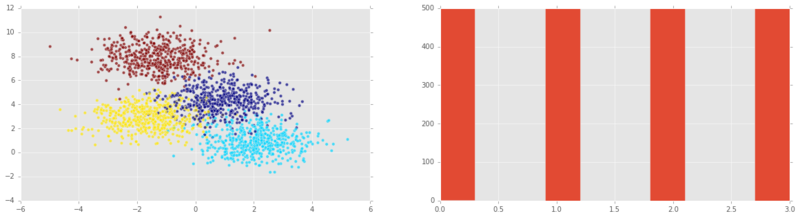
Catatan: pada plot ke-2 kita dapat melihat bahwa semua kemungkinan variabel target terwakili secara setara. Dalam kasus ini (atau bahkan jika terwakili kira-kira setara), kita mengatakan kelas y seimbang.
Sekarang saya ingin memplot histogram fitur (variabel prediktor):
import pandas as pd
df = pd.DataFrame(X)
pd.DataFrame.hist(df, figsize=(20,5));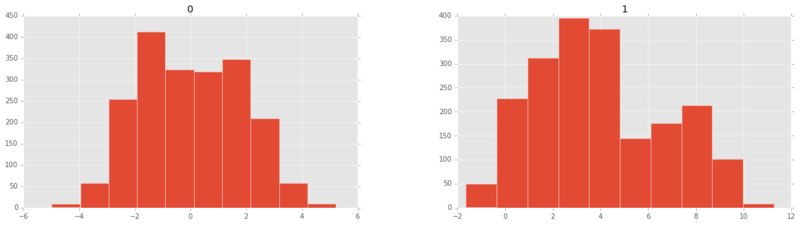
Sekarang mari pisahkan menjadi set pengujian & pelatihan dan plot keduanya:
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.title('training set')
plt.scatter(X_train[:,0] , X_train[:,1],  c = y_train, alpha = 0.7);
plt.subplot(1, 2, 2);
plt.scatter(X_test[:,0] , X_test[:,1],  c = y_test, alpha = 0.7);
plt.title('test set')
plt.show()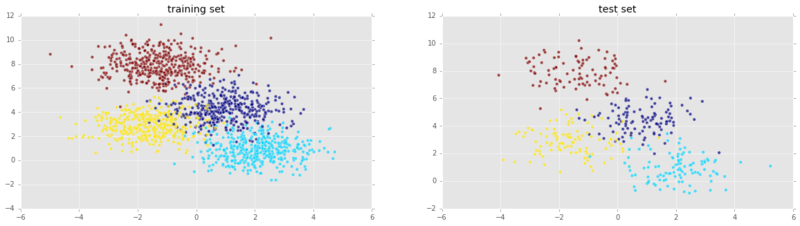
Terlihat bagus! Sekarang mari kita instansiasi classifier voting k-Nearest Neighbors dan latih pada set pelatihan kita:
from sklearn import neighbors, linear_model
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(X_train, y_train)
Sekarang setelah model kita terlatih, kita bisa mengujinya pada set uji dan menghitung akurasinya:
print('k-NN score for test set: %f' % knn_model.score(X_test, y_test))`k-NN score for test set: 0.935000`Kita juga dapat melatih ulang pada set pelatihan dan menghitung akurasinya. Kita berharap kinerjanya lebih baik pada set pelatihan dibanding set uji:
print('k-NN score for training set: %f' % knn_model.score(X_train, y_train))`k-NN score for training set: 0.941875`Perlu diulangi bahwa metode penilaian bawaan untuk k-NN di scikit-learn adalah akurasi. Untuk memeriksa berbagai metrik lainnya, kita juga dapat menggunakan classification report dari scikit-learn:
from sklearn.metrics import classification_report
y_true, y_pred = y_test, knn_model.predict(X_test)
print(classification_report(y_true, y_pred))
precision recall f1-score support
0 0.87 0.90 0.88 106
1 0.98 0.93 0.95 102
2 0.90 0.92 0.91 100
3 1.00 1.00 1.00 92
avg / total 0.94 0.94 0.94 400Sekarang saya akan melakukan skala pada variabel prediktor lalu menggunakan k-NN lagi:
from sklearn.preprocessing import scale
Xs = scale(X)
Xs_train, Xs_test, y_train, y_test = train_test_split(Xs, y, test_size=0.2, random_state=42)
plt.figure(figsize=(20,5));
plt.subplot(1, 2, 1 );
plt.scatter(Xs_train[:,0] , Xs_train[:,1],  c = y_train, alpha = 0.7);
plt.title('scaled training set')
plt.subplot(1, 2, 2);
plt.scatter(Xs_test[:,0] , Xs_test[:,1],  c = y_test, alpha = 0.7);
plt.title('scaled test set')
plt.show()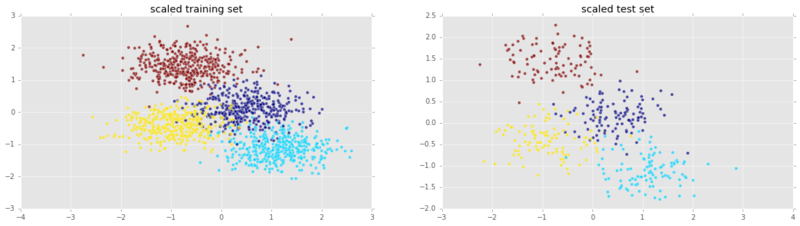
knn_model_s = knn.fit(Xs_train, y_train)
print('k-NN score for test set: %f' % knn_model_s.score(Xs_test, y_test))
`k-NN score for test set: 0.935000`Tidak ada peningkatan kinerja dengan penskalaan! Kemungkinan besar karena kedua fitur sudah berada pada rentang yang mirip. Penskalaan benar-benar masuk akal ketika variabel memiliki rentang yang sangat bervariasi. Untuk melihat ini, kita akan menambahkan satu fitur lagi. Selain itu, fitur ini tidak relevan dengan variabel target: murni derau.
Kita menambahkan variabel ketiga berupa derau Gaussian dengan mean 0 dan simpangan baku variabel \(\sigma\). Kita akan menyebut \(\sigma\) sebagai kekuatan derau dan kita akan melihat bahwa semakin kuat deraunya, semakin buruk performa k-Nearest Neighbours.
# Add noise column to predictor variables
ns = 10**(3) # Strength of noise term
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Sekarang kita gunakan paket mplot3d untuk memplot data 3D:
from mpl_toolkits.mplot3d import Axes3D
fig = plt.figure(figsize=(15,10));
ax = fig.add_subplot(111, projection='3d' , alpha = 0.5);
ax.scatter(Xn[:,0], Xn[:,1], Xn[:,2], c = y);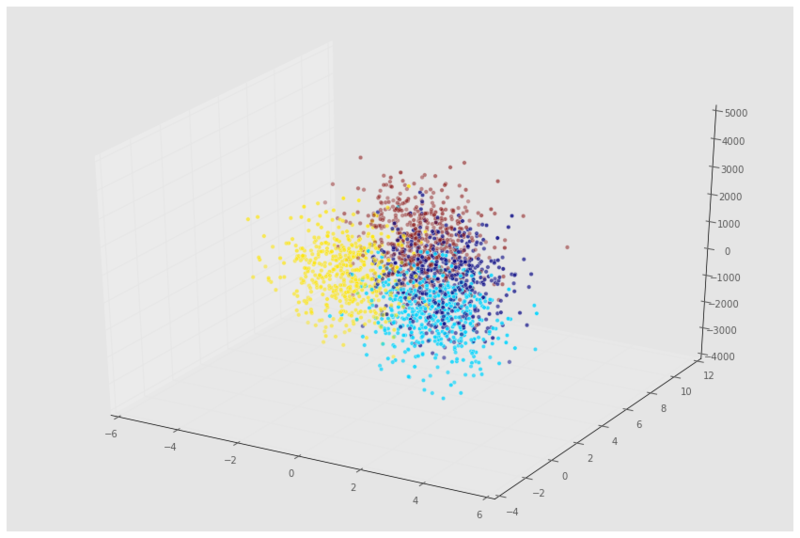
Sekarang mari kita lihat bagaimana performa model pada data baru:
Xn_train, Xn_test, y_train, y_test = train_test_split(Xn, y, test_size=0.2, random_state=42)
knn = neighbors.KNeighborsClassifier()
knn_model = knn.fit(Xn_train, y_train)
print('k-NN score for test set: %f' % knn_model.score(Xn_test, y_test))
k-NN score for test set: 0.400000
Model ini buruk sekali! Bagaimana jika kita melakukan skala lalu cek performanya?
Xns = scale(Xn)
s = int(.2*n_samples)
Xns_train = Xns[s:]
y_train = y[s:]
Xns_test = Xns[:s]
y_test = y[:s]
knn = neighbors.KNeighborsClassifier()
knn_models = knn.fit(Xns_train, y_train)
print('k-NN score for test set: %f' % knn_models.score(Xns_test, y_test))
`k-NN score for test set: 0.907500`Hebat, setelah penskalaan data, model berkinerja hampir sebaik saat tidak ada derau yang diperkenalkan. Sekarang mari kita lihat performa model sebagai fungsi dari kekuatan derau.
Sekarang kita akan melihat bagaimana kekuatan derau memengaruhi akurasi model. Karena kita perlu menggunakan kode yang sama berkali-kali, mari kita bungkus bagian utamanya dalam fungsi kecil:
def accu( X, y):
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    knn = neighbors.KNeighborsClassifier()
    knn_model = knn.fit(X_train, y_train)
    return(knn_model.score(X_test, y_test))
noise = [10**i for i in np.arange(-1,6)]
A1 = np.zeros(len(noise))
A2 = np.zeros(len(noise))
count = 0
for ns in noise:
newcol = np.transpose([ns*np.random.randn(n_samples)])
Xn = np.concatenate((X, newcol), axis = 1)
Xns = scale(Xn)
A1[count] = accu( Xn, y)
A2[count] = accu( Xns, y)
count += 1Sekarang kita plot akurasi sebagai fungsi kekuatan derau (perhatikan sumbu x log):
plt.scatter( noise, A1 )
plt.plot( noise, A1, label = 'unscaled', linewidth = 2)
plt.scatter( noise, A2 , c = 'r')
plt.plot( noise, A2 , label = 'scaled', linewidth = 2)
plt.xscale('log')
plt.xlabel('Noise strength')
plt.ylabel('Accuracy')
plt.legend(loc=3);
Terlihat pada gambar di atas bahwa semakin banyak derau pada variabel pengganggu, semakin penting melakukan skala pada data Anda untuk model k-NN! Di bawah ini, Anda akan berkesempatan melakukan hal yang sama untuk regresi logistik. Sebagai penutup, kita telah melihat posisi esensial yang ditempati prapemrosesan dalam pipeline ilmu data, khususnya dalam bentuk penskalaan dan pemusatan, dan kita melakukannya untuk mendorong pendekatan holistis terhadap tantangan machine learning. Pada artikel mendatang, saya berharap dapat memperluas pembahasan ke jenis prapemrosesan lain, seperti transformasi data numerik dan prapemrosesan data kategorikal, keduanya aspek esensial dalam perangkat kerja setiap data scientist.
Latihan untuk pembaca yang antusias: coba latih model regresi logistik pada dataset sintetis di atas dan periksa performa modelnya. Bagaimana akurasi sebagai fungsi dari kekuatan derau untuk data yang diskalakan dan tidak diskalakan? Anda dapat melakukannya di widget DataCamp Light di bawah! Ubah eksponen 10 untuk mengatur jumlah derau (coba dulu rentang yang saya gunakan di atas untuk k-NN) dan setel sc = True jika Anda ingin melakukan skala pada fitur Anda. Anda juga dapat melihat DataCamp Light di Github!
Supervised learning: Tugas menyimpulkan variabel target dari variabel prediktor. Misalnya, menyimpulkan variabel target ‘keberadaan penyakit jantung’ dari variabel prediktor seperti ‘usia’, ‘jenis kelamin’, dan ‘status perokok’.
Tugas klasifikasi: Suatu tugas supervised learning disebut tugas klasifikasi jika variabel target terdiri dari kategori (misalnya ‘klik’ atau ‘tidak’, tumor ‘ganas’ atau ‘jinak’).
Tugas regresi: Suatu tugas supervised learning disebut tugas regresi jika variabel target adalah variabel yang bervariasi secara kontinu (misalnya harga rumah) atau variabel kategorikal berurutan seperti ‘penilaian kualitas anggur’.
k-Nearest Neighbors: Algoritme untuk tugas klasifikasi, di mana suatu titik data diberi label yang diputuskan oleh suara mayoritas dari k tetangga terdekatnya.
Prapemrosesan: Beragam operasi yang digunakan data scientist untuk menyiapkan data mereka agar lebih sesuai dengan apa yang ingin mereka lakukan. Misalnya, sebelum melakukan analisis sentimen pada data Twitter, Anda mungkin ingin menghapus tag HTML, spasi kosong, memperluas singkatan, dan membagi tweet menjadi daftar kata yang dikandungnya.
Pemusatan dan Penskalaan: Keduanya adalah bentuk prapemrosesan data numerik, yaitu data yang terdiri dari angka, berbeda dengan kategori atau string, misalnya; memusatkan variabel berarti mengurangkan mean variabel dari setiap titik data sehingga mean variabel baru adalah 0; menskalakan variabel berarti mengalikan setiap titik data dengan konstanta untuk mengubah rentang data. Lihat isi artikel untuk pentingnya hal ini, beserta contoh.
Artikel ini dihasilkan dari sebuah Jupyter notebook. Anda dapat mengunduh notebook-nya di sini.
Kursus Python
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



