
Kursus
Memahami Prompt Engineering
1 jam
235.8K
Di lanskap kecerdasan buatan yang berkembang pesat, mengoptimalkan large language model (LLM) bukan hanya soal mendorong batas kemampuan, tetapi juga memastikan efisiensi dan efektivitas biaya.
Kompresi prompt muncul sebagai teknik penting untuk meningkatkan kinerja model sekaligus meminimalkan biaya komputasi. Dengan riset baru yang muncul hampir setiap minggu, mengikuti perkembangannya memang menantang, tetapi memahami dasarnya sangat penting.
Artikel ini membahas dasar-dasar kompresi prompt, kapan sebaiknya digunakan, pentingnya dalam menurunkan biaya pada pipeline RAG, serta contoh-contoh menggunakan model gpt-3.5-turbo-0125 melalui API OpenAI.
Jika Anda ingin mempelajari lebih lanjut, lihat kursus tentang prompt engineering ini.
Kompresi prompt adalah teknik dalam natural language processing (NLP) untuk mengoptimalkan masukan ke LLM dengan mengurangi panjangnya tanpa mengubah kualitas dan relevansi keluaran secara signifikan. Optimalisasi ini krusial karena jumlah token dalam kueri berdampak pada kinerja LLM.
Token adalah unit dasar teks yang digunakan LLM, merepresentasikan kata atau subkata bergantung pada tokenizer model bahasanya. Mengurangi jumlah token dalam prompt bermanfaat, dan kadang perlu, karena beberapa alasan:
Kompresi prompt mengurangi jumlah token dengan strategi seperti menghapus informasi berulang, meringkas poin-poin kunci, atau menggunakan algoritme khusus untuk menyarikan esensi prompt sambil meminimalkan jumlah tokennya.
Mari kita telusuri skenario ketika kita bisa menggunakan kompresi prompt.
Teknik seperti chain-of-thought prompting, meski sangat efektif, sering menghasilkan prompt panjang yang bisa mencapai ribuan token. Ini meningkatkan waktu pemrosesan dan biaya, dan mungkin melebihi batas token beberapa model.
Kompresi prompt mengurangi masalah ini dengan menurunkan jumlah token sambil mempertahankan efektivitas prompt.
Pipeline RAG menggabungkan pengambilan informasi dengan generasi teks dan sering digunakan pada chatbot khusus serta aplikasi lain yang menuntut pemahaman kontekstual. Pipeline ini kerap membutuhkan riwayat percakapan yang panjang atau dokumen hasil retrieval sebagai prompt, sehingga jumlah token tinggi dan biaya meningkat.
Kompresi prompt penting dalam kasus seperti ini untuk menjaga konteks esensial sambil meminimalkan biaya.
Perlu dicatat bahwa kompresi prompt bukan solusi universal dan harus digunakan secara bijak. Misalnya, model asisten seperti ChatGPT yang dirancang untuk konteks percakapan mungkin tidak diuntungkan oleh kompresi prompt yang agresif.
Model-model ini sering tidak menagih per token dan memiliki fitur ringkasan percakapan serta memori terintegrasi untuk mengelola riwayat percakapan secara efektif, sehingga kompresi menjadi berlebihan.
Perlu juga dicatat bahwa bahkan saat bekerja dengan model yang menagih per token, kompresi berlebihan dapat menghilangkan nuansa atau detail penting. Menemukan keseimbangan antara mengurangi ukuran dan menjaga integritas makna prompt adalah kuncinya.
Teknik kompresi prompt dapat dikategorikan menjadi tiga metode utama: knowledge distillation, encoding, dan filtering. Masing-masing memanfaatkan kekuatan berbeda untuk mengoptimalkan panjang dan efisiensi prompt bagi LLM.
Meski kita akan membahas masing-masing teknik, Anda bisa menemukan pendekatan yang lebih komprehensif di paper: Efficient Prompting Methods for Large Language Models: A Survey. Sepanjang artikel, saya akan merujuk paper ini sebagai “survey paper”.
Knowledge distillation adalah teknik di bidang machine learning, pertama kali diperkenalkan oleh Hinton et al. (2015), di mana model yang lebih kecil dan sederhana (student) dilatih untuk meniru perilaku model yang lebih besar dan kompleks (teacher).
Teknik ini awalnya dikembangkan untuk mengatasi tantangan komputasi saat melatih ansambel model. Dalam konteks prompt engineering, knowledge distillation dapat digunakan untuk mengompresi prompt alih-alih modelnya.
Ini dicapai dengan mempelajari cara mengompresi hard prompt di dalam LLM melalui soft prompt tuning. Untuk wawasan detail, lihat bagian 3.1 dan lampiran A.1.1 pada survey paper.
Metode encoding mengubah teks masukan menjadi vektor, mengurangi panjang prompt tanpa kehilangan informasi penting. Vektor ini menangkap makna esensial prompt, memungkinkan LLM memproses masukan yang lebih pendek secara efisien.
Namun, bergantung pada bahasa encoding dan tokenizer, panjang token justru bisa meningkat. Misalnya, jika Anda meng-encode prompt dalam Base64, panjang token bisa jadi lebih besar, jadi pastikan melakukan pengujian awal sesuai kasus penggunaan Anda.
Menariknya, beberapa teknik encoding juga digunakan untuk model jailbreaking, yakni memanipulasi LLM agar melewati mekanisme keamanannya. Untuk detail metode encoding, lihat bagian 3.2 dan lampiran A.1.2 pada survey paper.
Sementara dua metode sebelumnya berupaya mengompresi seluruh prompt, teknik filtering berfokus pada penghilangan bagian yang tidak perlu untuk meningkatkan efisiensi LLM.
Teknik filtering mengevaluasi kandungan informasi dari bagian-bagian berbeda dalam prompt dan menghapus informasi yang berulang karena tidak semua informasi dalam prompt bermanfaat bagi LLM. Ini dapat dilakukan pada berbagai tingkat, seperti kalimat, frasa, atau token.
Tujuannya adalah mempertahankan hanya bagian paling relevan dari prompt. Dalam paper Selective Context oleh Li et al. (2023), peneliti menggunakan metrik self-information untuk menyaring informasi yang redundan. Dalam paper LLMLingua: Compressing Prompts for Accelerated Inference of Large Language Models, peneliti dari Microsoft menyaring prompt menjadi komponen kunci dan menyesuaikan rasio kompresi secara dinamis untuk tiap bagian. Untuk bacaan lebih lanjut, lihat bagian 3.3 dan lampiran A.1.3 pada survey paper.
Di bagian ini, saya akan mengimplementasikan dan menguji algoritme Selective Context yang populer dan dianggap state-of-the-art. Jika Anda hanya ingin mengujinya, Anda tidak perlu memasang apa pun—algoritme ini sudah dihosting di platform HuggingFace.
Ada juga teknik kompresi arus utama lainnya, seperti Keep It Simple (KIS), SCLR, dan algoritme dari keluarga LLMLingua, tetapi kita tidak akan sempat membahasnya dalam artikel singkat ini.
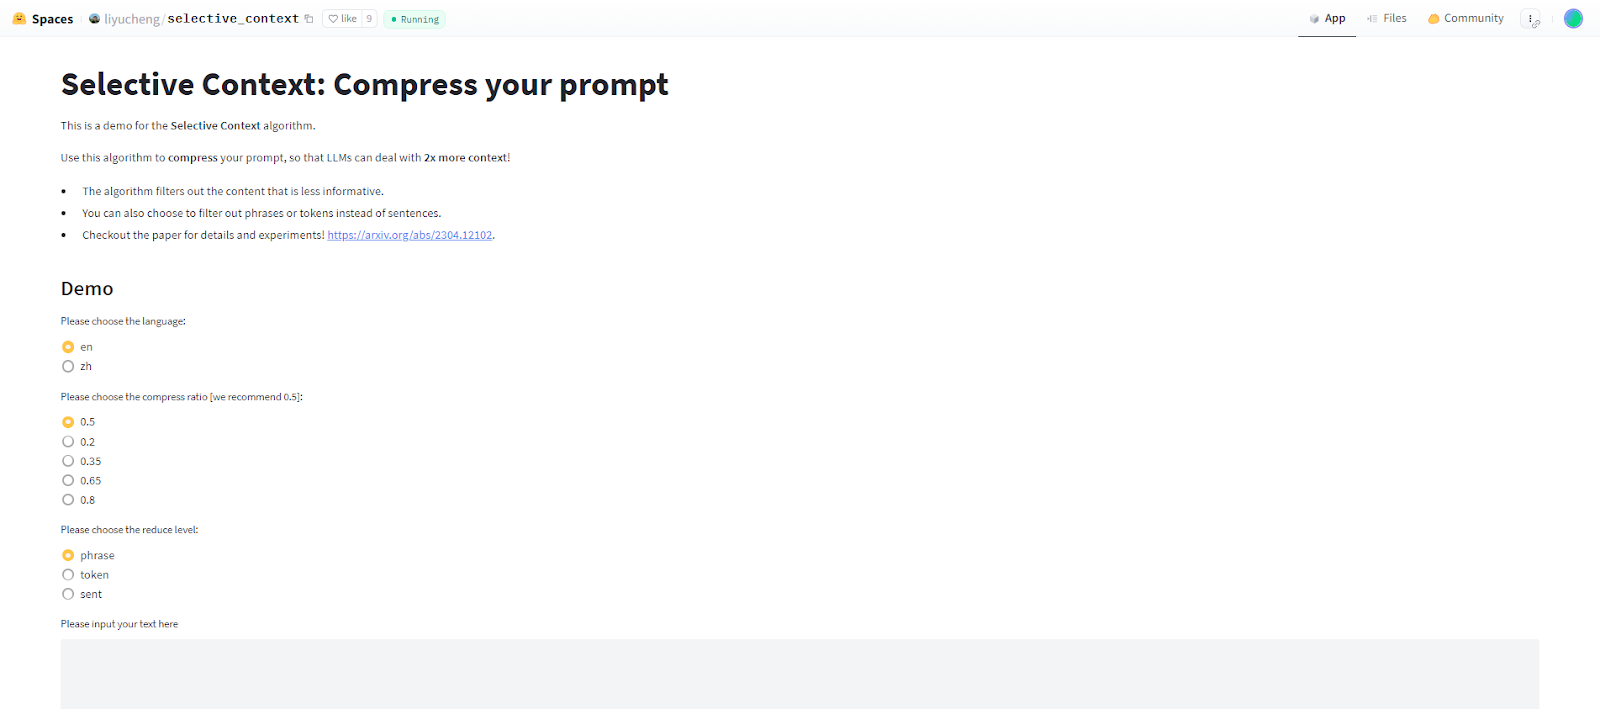
Di aplikasi web Selective Context, Anda dapat memilih bahasa prompt yang ingin dikompresi (Inggris atau Mandarin Sederhana). Anda juga dapat mengatur rasio kompresi dan memilih apakah akan menyaring kalimat, token, atau frasa.
Sekarang mari kita kerjakan implementasi Python-nya. Kita juga akan menguji beberapa prompt terkompresi dengan model gpt-3.5-turbo-0125.
Pertama, kita perlu memasang semua modul yang diperlukan. Kita perlu memasang pustaka selective-context menggunakan pip:
pip install selective-contextKita juga perlu mengunduh model en_core_web_sm dari spacy, ini bisa dilakukan dengan perintah berikut:
python -m spacy download en_core_web_smSekarang kita perlu menginisialisasi objek SelectiveContext. Kita dapat memilih curie atau gpt-2 untuk model dan en atau zh untuk bahasanya. Saya akan menggunakan gpt-2 untuk contoh ini.
sc = SelectiveContext(model_type = ‘gpt-2’, lang = ‘en’)Selanjutnya, kita dapat memanggil objek SelectiveContext pada string teks yang ingin kita kompres. Kita dapat mengatur parameter reduce_ratio dan reduce_level. reduce_level harus salah satu dari: ‘sent’, ‘phrase’, atau ‘token’. Pemanggilan objek mengembalikan pasangan (context, reduced_content), di mana context adalah prompt terkompresi dan reduced_content adalah daftar frasa, kalimat, atau token yang dihapus.
context, reduced_content = sc(text, reduce_ratio = 0.5, reduce_level = ‘sent’)Sekarang mari kita buat beberapa contoh. Saya akan meminta model gpt-3.5-turbo-0125 untuk meringkas bagian “Kapan kita harus menggunakan kompresi prompt” dari artikel ini. Lalu, kita akan mengompresi bagian tersebut dengan tingkat kompresi 0,5 menggunakan tiga level reduksi: kalimat, frasa, dan token. Kita akan meminta model untuk meringkas versi terkompresi lagi dan membandingkan jumlah token setiap prompt serta keluaran model.
Di bawah ini, Anda dapat melihat pemanggilan API yang akan saya gunakan—kita hanya akan mengubah variabel text dalam string format. Pertama, kita meminta model untuk meringkas paragraf asli yang belum dikompresi:
from openai import OpenAI
client = OpenAI(api_key = key)
completion = client.chat.completions.create(
	model = “gpt-3.5-turbo-0125”,
	messages = [
{“role”: “user”, “content”: f”Summarize the following paragraph:\n {text}”}
]
)
Dengan memeriksa completion.usage kita dapat melihat bahwa prompt asli panjangnya 304 token, dan berikut adalah keluarannya:
[Prompt compression is useful in scenarios such as advanced prompt engineering techniques and retrieval-augmented generation pipelines to reduce token counts and costs while preserving effectiveness and context. However, it is not a universal solution and should be used judiciously, as excessive compression can lead to a loss of important details. It is important to strike a balance between reducing size and maintaining the prompt's meaning.]Seperti yang terlihat, model merangkum paragraf yang tidak dikompresi dengan cukup baik.
Sekarang coba versi yang direduksi pada tingkat token. Paragraf terkompresi terlihat seperti ini:
[When Should Prompt CompProm compression particularly following Advanced prompt engineering Techniques like chainofthought prompting while highly lengthy prompts reach thousands tokensThis increases processing costs and may exceed token limits of certain modelsProm compression mit these token count while prompt effectivenessRetri-au generationRAG pipelines R combine information retrieval text specialized chat contextual understandingThese pipelines frequently involve providing extensive conversation histories retrieved as prompts leading high token counts increased expensesProm compression essential such essential context while costsApplic prompt compression It prompt universal judFor instance assistant models like ChatGPT designed convers contexts benefit aggressive prompt compressionThese models often do charge per token integrated chat summar memory features conversation history effectively compression redundantIt even working models charge per token excessive compression could nuance importantSt reducing size maintaining prompt’s meaning is]Prompt ini sepanjang 162 token, dan berikut ringkasan model:
[Prompt compression is recommended following advanced prompt engineering techniques like chain of thought prompting, especially when dealing with lengthy prompts that reach thousands of tokens. This helps reduce processing costs and ensure that the prompt remains effective for models like RAG pipelines, which involve extensive conversation histories. Prompt compression is essential for maintaining context while keeping costs low, particularly for models like ChatGPT that charge per token and benefit from aggressive compression. However, excessive compression could lead to loss of important nuances, so it is important to strike a balance between reducing size and maintaining the prompt's meaning.]Paragraf ini tidak diringkas dengan benar. Nuansa tentang ChatGPT yang tidak diuntungkan oleh kompresi agresif hilang.
Berikutnya, mari coba reduksi tingkat kalimat. Prompt yang direduksi sepanjang 129 token:
[When Should We Use Prompt Compression? This increases processing times and costs and may exceed token limits of certain models. These pipelines frequently involve providing extensive conversation histories or retrieved documents as prompts, leading to high token counts and increased expenses. Prompt compression is essential in such cases to maintain essential context while minimizing costs. For instance, assistant models like ChatGPT, designed for conversational contexts, may not benefit from aggressive prompt compression. These models often do not charge per token and have integrated chat summarization and memory features to manage conversation history effectively, making compression redundant. ]Berikut ringkasan model:
[Prompt compression is necessary when processing times, costs, and token limits may be exceeded in pipelines involving extensive conversation histories or retrieved documents as prompts. However, for certain models like ChatGPT, designed for conversational contexts, aggressive prompt compression may not be beneficial as they already have features to manage conversation history effectively without the need for compression.]Ringkasan ini tidak memuat kesalahan, tetapi melewatkan pembahasan tentang RAG.
Terakhir, mari uji reduksi tingkat frasa. Prompt ini sepanjang 183 token:
[When Should Prompt Compression Prompt compression particularly beneficial Advanced prompt engineering techniques Techniques like chainofthought prompting while highly lengthy prompts reach thousands tokens This increases processing costs and may exceed token limits of certain models Prompt compression these issues token count while the prompt's effectiveness Retrieval-augmented generation (RAG) pipelines RAG pipelines combine information retrieval text generation specialized chatbots contextual understanding These pipelines frequently involve providing extensive conversation histories or retrieved as prompts leading high token counts increased expenses Prompt compression essential such cases to maintain essential context while costs Applicability prompt compression It's For instance assistant models like ChatGPT designed conversational contexts may benefit aggressive prompt compression These models often do charge per token have integrated chat summarization memory features manage conversation history effectively making compression redundant It even working models charge per token excessive compression could nuance important details reducing size maintaining the prompt’s meaning is
]
Berikut ringkasan model:
[Prompt compression is beneficial in advanced prompt engineering techniques, such as chainofthought prompting, which can involve lengthy prompts reaching thousands of tokens. Retrieval-augmented generation (RAG) pipelines combine information retrieval and text generation in specialized chatbots, requiring extensive conversation histories or retrieved prompts leading to high token counts and increased expenses. Prompt compression is essential in maintaining context while managing costs in such cases. For instance, assistant models like ChatGPT, which are designed for conversational contexts, may benefit from aggressive prompt compression to effectively manage conversation history and reduce costs. However, excessive compression could compromise important details, so maintaining the prompt's meaning is crucial.]Ringkasan ini sebagian besar benar dan koheren. Namun, bagian tentang ChatGPT yang diuntungkan dari kompresi agresif dipahami secara keliru.
Dengan membandingkan jumlah token dan isi ringkasan model pada berbagai tingkat kompresi, kita dapat melihat dampak kompresi prompt terhadap keluaran model:
|
Tingkat kompresi |
Jumlah token (aslinya 304) |
Akurasi |
|
Tingkat token |
162 |
Kehilangan nuansa penting tentang ChatGPT yang tidak diuntungkan dari kompresi agresif, dan membuat kesalahan. |
|
Tingkat kalimat |
129 |
Tidak membuat kesalahan, tetapi melewatkan beberapa konteks tentang pipeline RAG. |
|
Tingkat frasa |
183 |
Mirip tingkat token, secara keliru menyatakan bahwa ChatGPT diuntungkan dari kompresi agresif. |
Secara keseluruhan, kompresi prompt dapat secara signifikan mengurangi jumlah token sambil mempertahankan gagasan utama. Namun, penting untuk menemukan keseimbangan agar tidak kehilangan nuansa dan konteks penting.
Latihan ini menyoroti perlunya memilih tingkat kompresi dengan cermat berdasarkan aplikasi spesifik dan tingkat pentingnya mempertahankan detail tertentu dalam prompt.
Perlu dicatat bahwa kita menjalankan semua eksperimen dengan tingkat kompresi 0,5, yang relatif tinggi. Anda mungkin ingin bereksperimen dengan berbagai tingkat kompresi untuk berbagai kasus penggunaan guna menemukan keseimbangan optimal antara mengurangi ukuran prompt dan menjaga integritasnya.
Kompresi prompt adalah teknik ampuh untuk mengoptimalkan efisiensi dan efektivitas biaya LLM. Kita telah menelusuri dasarnya, membahas pentingnya, berbagai teknik, serta detail implementasinya.
Seiring terus berkembangnya bidang AI generatif, mengikuti perkembangan terbaru sangatlah penting. Untuk lebih meningkatkan keterampilan dan pemahaman Anda tentang kompresi prompt dan teknik terkait, saya mendorong Anda mengeksplorasi paper yang dirujuk dalam artikel ini, serta artikel blog dan kursus komprehensif berikut dari DataCamp:
Pelajari lebih lanjut tentang prompt engineering!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




