
{count, plural, one {कोर्स} other {कोर्स}}
Prompt Engineering को समझना
{hours} घंटा
237.5K
कृत्रिम बुद्धिमत्ता के तेजी से विकसित हो रहे परिदृश्य में, बड़े भाषा मॉडल (LLMs) का अनुकूलन केवल संभावनाओं की सीमाओं को आगे बढ़ाने तक सीमित नहीं है, बल्कि दक्षता और लागत-प्रभावशीलता सुनिश्चित करना भी उतना ही महत्वपूर्ण है।
प्रॉम्प्ट कंप्रेशन इन मॉडलों के प्रदर्शन को बेहतर बनाने के लिए एक अहम तकनीक के रूप में उभरा है, जो संगणनात्मक खर्चों को कम करते हुए काम करता है। हर सप्ताह लगभग नए शोध सामने आने के साथ, साथ बने रहना चुनौतीपूर्ण है, लेकिन मूलभूत बातों को समझना आवश्यक है।
यह लेख प्रॉम्प्ट कंप्रेशन की बुनियादी जानकारी कवर करता है, यह कब उपयोगी होता है, RAG पाइपलाइनों में लागत घटाने में इसका महत्व, और OpenAI की API के माध्यम से gpt-3.5-turbo-0125 मॉडल का उपयोग करते हुए उदाहरण प्रस्तुत करता है।
यदि आप और सीखना चाहते हैं, तो प्रॉम्प्ट इंजीनियरिंग पर यह कोर्स देखें।
प्रॉम्प्ट कंप्रेशन, प्राकृतिक भाषा संसाधन (NLP) में उपयोग की जाने वाली एक तकनीक है, जो LLMs को दिए जाने वाले इनपुट को उनकी लंबाई घटाकर अनुकूलित करती है, बिना आउटपुट की गुणवत्ता और प्रासंगिकता में उल्लेखनीय बदलाव किए। यह अनुकूलन महत्वपूर्ण है क्योंकि क्वेरी में टोकनों की संख्या LLM के प्रदर्शन पर प्रभाव डालती है।
टोकन वे मूल इकाइयाँ हैं जिनका LLMs उपयोग करते हैं—ये शब्द या उपशब्द हो सकते हैं, यह भाषा मॉडल के टोकनाइज़र पर निर्भर करता है। प्रॉम्प्ट में टोकनों की संख्या कम करना कई कारणों से लाभकारी और कई बार आवश्यक होता है:
प्रॉम्प्ट कंप्रेशन, अतिरिक्त जानकारी हटाने, प्रमुख बिंदुओं का सार प्रस्तुत करने, या विशेष एल्गोरिद्म का उपयोग कर प्रॉम्प्ट के सार को संक्षेप में उतारते हुए टोकन संख्या घटाने जैसी रणनीतियों से हासिल किया जाता है।
आइए उन परिदृश्यों का अन्वेषण करें जहाँ हम प्रॉम्प्ट कंप्रेशन का उपयोग कर सकते हैं।
जैसी तकनीकें जैसे chain-of-thought प्रॉम्प्टिंग, अत्यंत प्रभावी होते हुए भी, अक्सर लंबे प्रॉम्प्ट का कारण बनती हैं जो हज़ारों टोकन तक पहुँच सकते हैं। इससे प्रोसेसिंग समय और लागत बढ़ती है और कुछ मॉडलों की टोकन सीमाएँ पार हो सकती हैं।
प्रॉम्प्ट कंप्रेशन, टोकन संख्या घटाकर जबकि प्रॉम्प्ट की प्रभावशीलता बनाए रखते हुए, इन समस्याओं को कम करता है।
RAG पाइपलाइनें सूचना पुनर्प्राप्ति को टेक्स्ट जनरेशन के साथ जोड़ती हैं और प्रायः विशेषीकृत चैटबॉट्स व अन्य ऐसे अनुप्रयोगों में उपयोग होती हैं जहाँ संदर्भात्मक समझ अहम होती है। ये पाइपलाइनें अक्सर विस्तृत वार्तालाप इतिहास या प्राप्त दस्तावेजों को प्रॉम्प्ट के रूप में माँगती हैं, जिससे टोकन संख्या और लागत दोनों बढ़ जाते हैं।
ऐसे मामलों में, आवश्यक संदर्भ को बनाए रखते हुए लागत घटाने के लिए प्रॉम्प्ट कंप्रेशन अनिवार्य है।
यह समझना महत्वपूर्ण है कि प्रॉम्प्ट कंप्रेशन हर स्थिति का सार्वभौमिक समाधान नहीं है और इसका विवेकपूर्ण उपयोग होना चाहिए। उदाहरण के लिए, ChatGPT जैसे असिस्टेंट मॉडल, जो संवादात्मक संदर्भों के लिए बनाए गए हैं, आक्रामक कंप्रेशन से लाभान्वित नहीं हो सकते।
ये मॉडल प्रायः प्रति टोकन शुल्क नहीं लेते और वार्तालाप इतिहास को प्रभावी ढंग से प्रबंधित करने के लिए समेकित चैट-सारांशण और मेमोरी सुविधाएँ रखते हैं, जिससे कंप्रेशन अनावश्यक हो जाता है।
यह भी ध्यान देने योग्य है कि प्रति टोकन शुल्क लेने वाले मॉडलों के साथ काम करते समय भी, अत्यधिक कंप्रेशन सूक्ष्मताओं या महत्त्वपूर्ण विवरणों के खोने का कारण बन सकता है। आकार घटाने और प्रॉम्प्ट के अर्थ की अखंडता बनाए रखने के बीच सही संतुलन साधना आवश्यक है।
प्रॉम्प्ट कंप्रेशन तकनीकों को मुख्यतः तीन विधियों में वर्गीकृत किया जा सकता है: नॉलेज डिस्टिलेशन, एन्कोडिंग, और फिल्टरिंग। प्रत्येक तकनीक LLMs के लिए प्रॉम्प्ट की लंबाई और दक्षता को अनुकूलित करने के लिए अलग-अलग ताकतों का उपयोग करती है।
हालाँकि हम इन प्रत्येक तकनीकों पर बात करेंगे, एक अधिक व्यापक दृष्टिकोण आपको इस पेपर में मिलेगा: Efficient Prompting Methods for Large Language Models: A Survey। इस लेख में, मैं इस पेपर को “सर्वे पेपर” के रूप में संदर्भित करूँगा।
नॉलेज डिस्टिलेशन मशीन लर्निंग का एक तरीक़ा है, जिसे सबसे पहले Hinton et al. (2015) ने प्रस्तुत किया, जहाँ एक छोटा, सरल मॉडल (स्टूडेंट) एक बड़े, जटिल मॉडल (टीचर) के व्यवहार की नकल करना सीखता है।
यह तकनीक मूल रूप से मॉडलों के एन्सेम्बल को प्रशिक्षित करने की संगणनात्मक चुनौतियों से निपटने के लिए विकसित की गई थी। प्रॉम्प्ट इंजीनियरिंग के संदर्भ में, नॉलेज डिस्टिलेशन का उपयोग मॉडल के बजाय प्रॉम्प्ट को संपीड़ित करने में किया जा सकता है।
यह LLMs के भीतर कठिन प्रॉम्प्ट को सॉफ्ट प्रॉम्प्ट ट्यूनिंग के माध्यम से कंप्रेस करना सीखकर हासिल किया जाता है। विस्तृत जानकारी के लिए, सर्वे पेपर के अनुभाग 3.1 और परिशिष्ट A.1.1 देखें।
एन्कोडिंग विधियाँ इनपुट टेक्स्ट को वेक्टर में बदलती हैं, जिससे आवश्यक जानकारी खोए बिना प्रॉम्प्ट की लंबाई घटती है। ये वेक्टर प्रॉम्प्ट के मूल अर्थ को समेटते हैं, जिससे LLMs छोटे इनपुट को कुशलतापूर्वक प्रोसेस कर पाते हैं।
हालाँकि, एन्कोडिंग भाषा और टोकनाइज़र पर निर्भर करते हुए, टोकन लंबाई वास्तव में बढ़ भी सकती है। उदाहरण के लिए, यदि आप किसी प्रॉम्प्ट को Base64 में एन्कोड करते हैं, तो टोकन लंबाई और बड़ी हो सकती है, इसलिए अपने उपयोग-प्रकरण के आधार पर प्रारंभिक परीक्षण अवश्य करें।
आश्चर्यजनक रूप से, कुछ एन्कोडिंग तकनीकों का उपयोग मॉडल को जेलब्रेक करने में भी किया जाता है, जिसमें LLM की सुरक्षा प्रणालियों को दरकिनार करवाना शामिल है। एन्कोडिंग विधियों पर अधिक जानकारी के लिए सर्वे पेपर के अनुभाग 3.2 और परिशिष्ट A.1.2 देखें।
जहाँ पिछली दोनों विधियाँ पूरे प्रॉम्प्ट को कंप्रेस करने की कोशिश करती हैं, वहीं फिल्टरिंग तकनीकें LLMs की दक्षता बढ़ाने के लिए अनावश्यक हिस्सों को हटाने पर केंद्रित होती हैं।
फिल्टरिंग तकनीकें प्रॉम्प्ट के विभिन्न भागों की सूचना-वस्तु का मूल्यांकन करती हैं और अतिरिक्त जानकारी को हटाती हैं, क्योंकि प्रॉम्प्ट की सारी जानकारी LLMs के लिए उपयोगी नहीं होती। यह वाक्य, वाक्यांश या टोकन जैसे विभिन्न स्तरों पर किया जा सकता है।
उद्देश्य केवल प्रॉम्प्ट के सबसे प्रासंगिक हिस्सों को बनाए रखना है। Li et al. (2023) द्वारा Selective Context नामक पेपर में, शोधकर्ताओं ने अनावश्यक जानकारी को फ़िल्टर करने के लिए सेल्फ-इन्फॉर्मेशन मीट्रिक्स का उपयोग किया। LLMLingua: Compressing Prompts for Accelerated Inference of Large Language Models पेपर में, Microsoft के शोधकर्ताओं ने प्रॉम्प्ट को प्रमुख घटकों में परिष्कृत किया और प्रत्येक हिस्से के लिए कंप्रेशन अनुपात को गतिशील रूप से समायोजित किया। आगे पढ़ने के लिए सर्वे पेपर के अनुभाग 3.3 और परिशिष्ट A.1.3 देखें।
इस खंड में, मैं Selective Context एल्गोरिद्म को लागू और परीक्षण करूँगा, जो लोकप्रिय है और state-of-the-art माना जाता है। यदि आप केवल एल्गोरिद्म को आज़माना चाहते हैं, तो आपको कुछ इंस्टॉल करने की आवश्यकता नहीं है—यह पहले से ही HuggingFace प्लेटफॉर्म पर होस्टेड है।
अन्य प्रचलित कंप्रेशन तकनीकें भी हैं, जैसे Keep It Simple (KIS), SCLR, और LLMLingua परिवार के एल्गोरिद्म, लेकिन हम उन्हें इस छोटे से लेख में कवर नहीं कर पाएँगे।
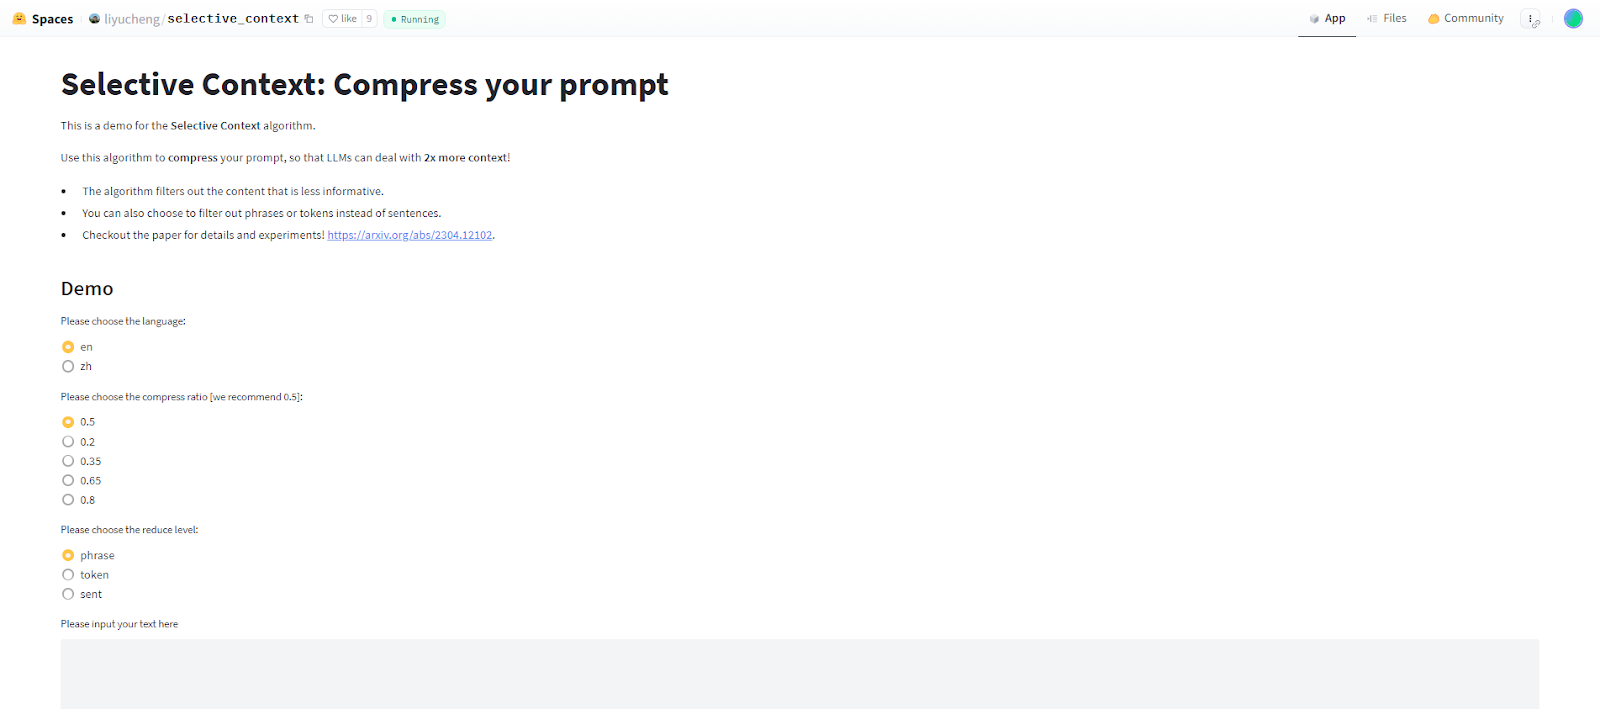
Selective Context वेब ऐप में, आप उस प्रॉम्प्ट की भाषा चुन सकते हैं जिसे आप कंप्रेस करना चाहते हैं (अंग्रेज़ी या सरलीकृत चीनी)। आप कंप्रेशन अनुपात भी सेट कर सकते हैं और यह चुन सकते हैं कि वाक्यों, टोकनों या वाक्यांशों को फ़िल्टर करना है।
अब आइए Python इम्प्लीमेंटेशन पर काम करते हैं। हम gpt-3.5-turbo-0125 मॉडल के साथ कुछ कंप्रेस्ड प्रॉम्प्ट का परीक्षण भी करेंगे।
सबसे पहले, हमें सभी आवश्यक मॉड्यूल इंस्टॉल करने होंगे। हमें pip का उपयोग कर selective-context लाइब्रेरी इंस्टॉल करनी है:
pip install selective-contextहमें spacy से en_core_web_sm मॉडल भी डाउनलोड करना होगा, यह निम्नलिखित कमांड से किया जा सकता है:
python -m spacy download en_core_web_smअब हमें SelectiveContext ऑब्जेक्ट को इनिशियलाइज़ करना है। हम मॉडल के लिए curie या gpt-2 और भाषा के लिए en या zh चुन सकते हैं। इस उदाहरण में मैं gpt-2 का उपयोग करूँगा।
sc = SelectiveContext(model_type = ‘gpt-2’, lang = ‘en’)अगला कदम, हम उस टेक्स्ट स्ट्रिंग पर अपने SelectiveContext ऑब्जेक्ट को कॉल कर सकते हैं जिसे हम कंप्रेस करना चाहते हैं। हम reduce_ratio और reduce_level पैरामीटर सेट कर सकते हैं। reduce_level निम्न में से एक होना चाहिए: ‘sent’, ‘phrase’, या ‘token’। ऑब्जेक्ट कॉल एक (context, reduced_content) टपल लौटाता है, जहाँ context कंप्रेस्ड प्रॉम्प्ट है और reduced_content हटाए गए वाक्यांशों, वाक्यों या टोकनों की सूची है।
context, reduced_content = sc(text, reduce_ratio = 0.5, reduce_level = ‘sent’)अब कुछ उदाहरण करते हैं। मैं gpt-3.5-turbo-0125 मॉडल से इस लेख के “हमें प्रॉम्प्ट कंप्रेशन कब उपयोग करना चाहिए” खंड का सार बताने के लिए कहूँगा। फिर, हम इस खंड को 0.5 कंप्रेशन दर के साथ तीनों रिडक्शन स्तरों—वाक्य, वाक्यांश, और टोकन—में कंप्रेस करेंगे। हम मॉडल से कंप्रेस्ड संस्करणों का फिर से सार माँगेंगे और प्रत्येक प्रॉम्प्ट के टोकन काउंट और मॉडल के आउटपुट की तुलना करेंगे।
नीचे आप वह API कॉल देख सकते हैं जिसका मैं उपयोग करूँगा—हम केवल फ़ॉर्मेट स्ट्रिंग में text वेरिएबल बदलेंगे। पहले, हम मॉडल से मूल, अनकंप्रेस्ड अनुच्छेद का सार माँगते हैं:
from openai import OpenAI
client = OpenAI(api_key = key)
completion = client.chat.completions.create(
	model = “gpt-3.5-turbo-0125”,
	messages = [
{“role”: “user”, “content”: f”Summarize the following paragraph:\n {text}”}
]
)
completion.usage जाँचकर हम देख सकते हैं कि मूल प्रॉम्प्ट 304 टोकन लंबा है, और यह रहा आउटपुट:
[Prompt compression is useful in scenarios such as advanced prompt engineering techniques and retrieval-augmented generation pipelines to reduce token counts and costs while preserving effectiveness and context. However, it is not a universal solution and should be used judiciously, as excessive compression can lead to a loss of important details. It is important to strike a balance between reducing size and maintaining the prompt's meaning.]जैसा कि आप देख सकते हैं, मॉडल ने अनकंप्रेस्ड अनुच्छेद का अच्छा सार प्रस्तुत किया है।
अब टोकन-रिड्यूस्ड संस्करण आज़माते हैं। कंप्रेस्ड अनुच्छेद इस प्रकार दिखता है:
[When Should Prompt CompProm compression particularly following Advanced prompt engineering Techniques like chainofthought prompting while highly lengthy prompts reach thousands tokensThis increases processing costs and may exceed token limits of certain modelsProm compression mit these token count while prompt effectivenessRetri-au generationRAG pipelines R combine information retrieval text specialized chat contextual understandingThese pipelines frequently involve providing extensive conversation histories retrieved as prompts leading high token counts increased expensesProm compression essential such essential context while costsApplic prompt compression It prompt universal judFor instance assistant models like ChatGPT designed convers contexts benefit aggressive prompt compressionThese models often do charge per token integrated chat summar memory features conversation history effectively compression redundantIt even working models charge per token excessive compression could nuance importantSt reducing size maintaining prompt’s meaning is]प्रॉम्प्ट 162 टोकन लंबा है, और यह रहा मॉडल का सार:
[Prompt compression is recommended following advanced prompt engineering techniques like chain of thought prompting, especially when dealing with lengthy prompts that reach thousands of tokens. This helps reduce processing costs and ensure that the prompt remains effective for models like RAG pipelines, which involve extensive conversation histories. Prompt compression is essential for maintaining context while keeping costs low, particularly for models like ChatGPT that charge per token and benefit from aggressive compression. However, excessive compression could lead to loss of important nuances, so it is important to strike a balance between reducing size and maintaining the prompt's meaning.]अनुच्छेद का सार ठीक नहीं है। ChatGPT को आक्रामक कंप्रेशन से लाभ न होने वाला महत्त्वपूर्ण बिंदु खो गया।
अब वाक्य-स्तरीय रिडक्शन आज़माते हैं। रिड्यूस्ड प्रॉम्प्ट 129 टोकन लंबा है:
[When Should We Use Prompt Compression? This increases processing times and costs and may exceed token limits of certain models. These pipelines frequently involve providing extensive conversation histories or retrieved documents as prompts, leading to high token counts and increased expenses. Prompt compression is essential in such cases to maintain essential context while minimizing costs. For instance, assistant models like ChatGPT, designed for conversational contexts, may not benefit from aggressive prompt compression. These models often do not charge per token and have integrated chat summarization and memory features to manage conversation history effectively, making compression redundant. ]यह रहा मॉडल का सार:
[Prompt compression is necessary when processing times, costs, and token limits may be exceeded in pipelines involving extensive conversation histories or retrieved documents as prompts. However, for certain models like ChatGPT, designed for conversational contexts, aggressive prompt compression may not be beneficial as they already have features to manage conversation history effectively without the need for compression.]यह सार किसी त्रुटि से मुक्त है, लेकिन RAG की चर्चा छूट गई है।
अंत में, वाक्यांश-स्तरीय रिडक्शन जाँचते हैं। प्रॉम्प्ट 183 टोकन लंबा है:
[When Should Prompt Compression Prompt compression particularly beneficial Advanced prompt engineering techniques Techniques like chainofthought prompting while highly lengthy prompts reach thousands tokens This increases processing costs and may exceed token limits of certain models Prompt compression these issues token count while the prompt's effectiveness Retrieval-augmented generation (RAG) pipelines RAG pipelines combine information retrieval text generation specialized chatbots contextual understanding These pipelines frequently involve providing extensive conversation histories or retrieved as prompts leading high token counts increased expenses Prompt compression essential such cases to maintain essential context while costs Applicability prompt compression It's For instance assistant models like ChatGPT designed conversational contexts may benefit aggressive prompt compression These models often do charge per token have integrated chat summarization memory features manage conversation history effectively making compression redundant It even working models charge per token excessive compression could nuance important details reducing size maintaining the prompt’s meaning is
]
यह रहा मॉडल का सार:
[Prompt compression is beneficial in advanced prompt engineering techniques, such as chainofthought prompting, which can involve lengthy prompts reaching thousands of tokens. Retrieval-augmented generation (RAG) pipelines combine information retrieval and text generation in specialized chatbots, requiring extensive conversation histories or retrieved prompts leading to high token counts and increased expenses. Prompt compression is essential in maintaining context while managing costs in such cases. For instance, assistant models like ChatGPT, which are designed for conversational contexts, may benefit from aggressive prompt compression to effectively manage conversation history and reduce costs. However, excessive compression could compromise important details, so maintaining the prompt's meaning is crucial.]सार अधिकांशतः सही और सुसंगत है। हालाँकि, इसमें यह बात गलत समझी गई कि ChatGPT आक्रामक प्रॉम्प्ट कंप्रेशन से लाभान्वित होता है।
विभिन्न कंप्रेशन स्तरों पर टोकन काउंट और मॉडल के सार-सामग्री की तुलना कर, हम देख सकते हैं कि प्रॉम्प्ट कंप्रेशन का मॉडल के आउटपुट पर क्या प्रभाव पड़ता है:
|
कंप्रेशन स्तर |
टोकन काउंट (मूल 304 है) |
शुद्धता |
|
टोकन-स्तर |
162 |
ChatGPT को आक्रामक कंप्रेशन से लाभ न होने वाली अहम सूक्ष्मताएँ खो गईं, और गलतियाँ हुईं। |
|
वाक्य-स्तर |
129 |
कोई गलती नहीं हुई, लेकिन RAG पाइपलाइनों का कुछ संदर्भ छूट गया। |
|
वाक्यांश-स्तर |
183 |
टोकन-स्तर की तरह, गलत तरीके से बताया कि ChatGPT आक्रामक कंप्रेशन से लाभान्वित होता है। |
कुल मिलाकर, प्रॉम्प्ट कंप्रेशन मुख्य विचारों को बनाए रखते हुए टोकन संख्या में उल्लेखनीय कमी ला सकता है। हालाँकि, आवश्यक सूक्ष्मताओं और संदर्भों के नुकसान से बचने के लिए सही संतुलन साधना आवश्यक है।
यह अभ्यास दर्शाता है कि विशिष्ट अनुप्रयोग और प्रॉम्प्ट में कुछ विवरणों की महत्ता के आधार पर कंпрेशन स्तर का सावधानीपूर्वक चयन करना क्यों जरूरी है।
यह उल्लेखनीय है कि हमने सभी प्रयोग 0.5 कंप्रेशन दर के साथ किए, जो अपेक्षाकृत अधिक है। आप विभिन्न उपयोग-प्रकरणों के लिए अलग-अलग कंप्रेशन दरों के साथ प्रयोग कर सकते हैं, ताकि प्रॉम्प्ट के आकार को घटाने और उसकी अखंडता बनाए रखने के बीच सर्वश्रेष्ठ संतुलन मिल सके।
प्रॉम्प्ट कंप्रेशन LLMs की दक्षता और लागत-प्रभावशीलता को अनुकूलित करने की एक शक्तिशाली तकनीक है। हमने इसके मूल तत्त्वों, इसके महत्व, विभिन्न तकनीकों और इम्प्लीमेंटेशन विवरणों पर चर्चा की है।
जैसे-जैसे जनरेटिव AI का क्षेत्र विकसित हो रहा है, नवीनतम प्रगतियों से अवगत रहना महत्त्वपूर्ण है। प्रॉम्प्ट कंप्रेशन और संबंधित तकनीकों पर अपनी समझ और कौशल को और बढ़ाने के लिए, मैं आपको इस लेख में संदर्भित पेपर्स के साथ-साथ DataCamp के निम्न व्यापक ब्लॉगपोस्ट और कोर्स देखने के लिए प्रोत्साहित करता हूँ:
प्रॉम्प्ट इंजीनियरिंग के बारे में और जानें!
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}