
Last chance! 50% off DataCamp Premium
Sale ends in
In het snel veranderende landschap van kunstmatige intelligentie draait het optimaliseren van large language models (LLM’s) niet alleen om de grenzen van het mogelijke te verleggen, maar ook om te zorgen voor efficiëntie en kosteneffectiviteit.
Promptcompressie is daarbij uitgegroeid tot een belangrijke techniek om de prestaties van deze modellen te verbeteren en tegelijk de rekencapaciteit en kosten te beperken. Met bijna wekelijks nieuw onderzoek is bijblijven een uitdaging, maar de basis begrijpen is essentieel.
Dit artikel behandelt de basis van promptcompressie, wanneer je het gebruikt, het belang ervan voor kostenreductie in RAG-pijplijnen, en laat voorbeelden zien met het model gpt-3.5-turbo-0125 via de API van OpenAI.
Wil je meer leren? Bekijk dan deze cursus over prompt engineering.
Promptcompressie is een techniek in natural language processing (NLP) om de invoer voor LLM’s te optimaliseren door deze in te korten zonder de kwaliteit en relevantie van de output noemenswaardig aan te tasten. Deze optimalisatie is cruciaal omdat het aantal tokens in een query de prestaties van LLM’s sterk beïnvloedt.
Tokens zijn de basiseenheden tekst die LLM’s gebruiken; ze vertegenwoordigen woorden of subwoorden, afhankelijk van de tokenizer van het taalmodel. Het aantal tokens in een prompt verminderen is om meerdere redenen gunstig en soms noodzakelijk:
Promptcompressie verlaagt het aantal tokens door strategieën toe te passen als het verwijderen van redundante informatie, het samenvatten van kernpunten, of het gebruiken van gespecialiseerde algoritmen die de essentie van een prompt destilleren met een minimale tokencount.
Laten we de scenario’s verkennen waarin we promptcompressie kunnen inzetten.
Technieken zoals chain-of-thought prompting zijn zeer effectief, maar leiden vaak tot lange prompts die kunnen oplopen tot duizenden tokens. Dit verhoogt de verwerkingstijd en kosten en kan de tokenlimieten van bepaalde modellen overschrijden.
Promptcompressie verzacht deze problemen door het aantal tokens te verlagen terwijl de effectiviteit van de prompt behouden blijft.
RAG-pijplijnen combineren informatie-ophaling met tekstgeneratie en worden vaak gebruikt in gespecialiseerde chatbots en andere toepassingen waar contextueel begrip cruciaal is. Deze pijplijnen hebben vaak uitgebreide gespreksgeschiedenissen of opgehaalde documenten als prompt nodig, wat leidt tot hoge tokencounts en hogere kosten.
Promptcompressie is in zulke gevallen essentieel om de noodzakelijke context te behouden en tegelijk de kosten te beperken.
Let op: promptcompressie is geen universele oplossing en je moet het met beleid toepassen. Assistentmodellen zoals ChatGPT, ontworpen voor gesprekken, profiteren bijvoorbeeld niet per se van agressieve promptcompressie.
Deze modellen rekenen vaak niet per token af en hebben geïntegreerde functies voor chatsamenvatting en geheugen om de gespreksgeschiedenis effectief te beheren, waardoor compressie overbodig wordt.
Ook als je werkt met modellen die wel per token rekenen, kan te veel compressie leiden tot verlies aan nuance of belangrijke details. De juiste balans vinden tussen verkleinen en de integriteit van de betekenis behouden is de sleutel.
Promptcompressietechnieken vallen grofweg in drie categorieën: knowledge distillation, encoding en filtering. Elke techniek benut andere sterke punten om de lengte en efficiëntie van prompts voor LLM’s te optimaliseren.
Hoewel we elk van deze technieken kort bespreken, vind je een uitgebreidere aanpak in dit paper: Efficient Prompting Methods for Large Language Models: A Survey. In dit artikel noem ik dit paper het “survey paper”.
Knowledge distillation is een techniek uit de machine learning, voor het eerst geïntroduceerd door Hinton et al. (2015), waarbij een kleiner, eenvoudiger model (de student) wordt getraind om het gedrag van een groter, complexer model (de leraar) te repliceren.
Deze techniek is oorspronkelijk ontwikkeld om de rekenkundige uitdagingen van het trainen van een ensemble van modellen aan te pakken. In de context van prompt engineering kun je met knowledge distillation de prompt comprimeren in plaats van het model.
Dit doe je door te leren hoe je harde prompts binnen LLM’s kunt comprimeren via soft prompt tuning. Voor meer details, zie sectie 3.1 en appendix A.1.1 van het survey paper.
Met encoding-methoden zet je invoerteksten om in vectoren, waardoor de prompt korter wordt zonder cruciale informatie te verliezen. Deze vectoren vangen de essentie van prompts, zodat LLM’s kortere input efficiënt kunnen verwerken.
Afhankelijk van de encodetaal en de tokenizer kan het aantal tokens echter juist toenemen. Als je een prompt bijvoorbeeld codeert in Base64, kan de tokencount zelfs groter uitvallen. Test dus eerst voor jouw use case.
Verrassend genoeg worden sommige encodingtechnieken ook gebruikt voor model-jailbreaking, waarbij je een LLM manipuleert om veiligheidsmechanismen te omzeilen. Voor meer details over encodingmethoden, zie sectie 3.2 en appendix A.1.2 van het survey paper.
Waar de vorige twee methoden proberen de hele prompt te comprimeren, richten filteringstechnieken zich op het weglaten van onnodige delen om de efficiëntie van LLM’s te verhogen.
Filteringstechnieken beoordelen de informatiewaarde van verschillende delen van een prompt en verwijderen redundante informatie, omdat niet alle informatie in de prompt nuttig is voor LLM’s. Dit kan op zins-, woordgroep- of tokenniveau.
Het doel is om alleen de meest relevante delen van de prompt te behouden. In het paper Selective Context van Li et al. (2023) gebruiken onderzoekers self-information-metrieken om redundante informatie te filteren. In het paper LLMLingua: Compressing Prompts for Accelerated Inference of Large Language Models verfijnen onderzoekers van Microsoft prompts tot kerncomponenten en passen ze de compressieratio dynamisch aan per onderdeel. Zie voor verdere lectuur sectie 3.3 en appendix A.1.3 van het survey paper.
In dit deel implementeer en test ik het Selective Context-algoritme, dat populair is en wordt beschouwd als state-of-the-art. Als je het algoritme alleen wilt uitproberen, hoef je niets te installeren—het staat al op het HuggingFace-platform.
Er zijn ook andere gangbare compressietechnieken, zoals Keep It Simple (KIS), SCLR en de algoritmen uit de LLMLingua-familie, maar die passen niet in dit korte artikel.
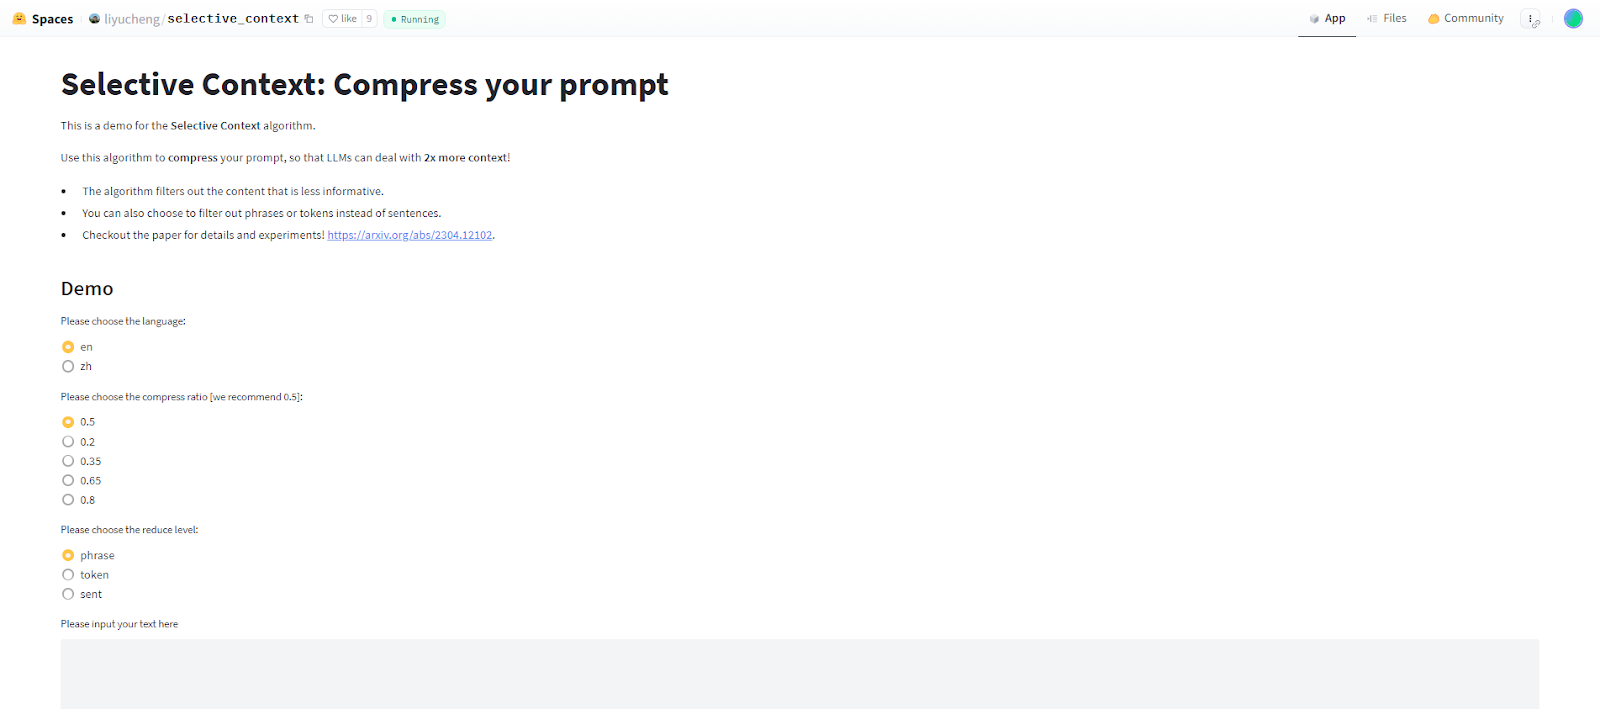
In de Selective Context-webapp kun je de taal kiezen van de prompt die je wilt comprimeren (Engels of Vereenvoudigd Chinees). Je kunt ook de compressieratio instellen en kiezen of je zinnen, tokens of woordgroepen wilt filteren.
Laten we nu aan de slag gaan met de Python-implementatie. We testen ook een paar gecomprimeerde prompts met het model gpt-3.5-turbo-0125.
Eerst installeren we de vereiste modules. We installeren de bibliotheek selective-context met pip:
pip install selective-contextWe moeten ook het model en_core_web_sm van spacy downloaden. Dat kan met het volgende commando:
python -m spacy download en_core_web_smNu initialiseren we het object SelectiveContext. We kunnen kiezen uit het model curie of gpt-2 en de taal en of zh. In dit voorbeeld gebruik ik gpt-2.
sc = SelectiveContext(model_type = ‘gpt-2’, lang = ‘en’)Vervolgens kunnen we ons SelectiveContext-object aanroepen op de te comprimeren tekststring. We kunnen de parameters reduce_ratio en reduce_level instellen. reduce_level moet een van de volgende zijn: ‘sent’, ‘phrase’ of ‘token’. De aanroep retourneert een tuple (context, reduced_content), waarbij context de gecomprimeerde prompt is en reduced_content een lijst met verwijderde woordgroepen, zinnen of tokens.
context, reduced_content = sc(text, reduce_ratio = 0.5, reduce_level = ‘sent’)Laten we nu wat voorbeelden doen. Ik laat het model gpt-3.5-turbo-0125 de sectie “Wanneer zouden we promptcompressie gebruiken” uit dit artikel samenvatten. Vervolgens comprimeren we de sectie met een ratio van 0,5 op alle drie de reductieniveaus: zin, woordgroep en token. We vragen het model om de gecomprimeerde versies opnieuw samen te vatten en vergelijken het aantal tokens van elke prompt en de modeloutput.
Hieronder zie je de API-aanroep die ik gebruik—alleen de variabele text in de formatstring verandert. Eerst vragen we het model om de originele, ongecomprimeerde alinea samen te vatten:
from openai import OpenAI
client = OpenAI(api_key = key)
completion = client.chat.completions.create(
	model = “gpt-3.5-turbo-0125”,
	messages = [
{“role”: “user”, “content”: f”Summarize the following paragraph:\n {text}”}
]
)
Als we completion.usage bekijken, zien we dat de originele prompt 304 tokens lang is, en dit is de output:
[Prompt compression is useful in scenarios such as advanced prompt engineering techniques and retrieval-augmented generation pipelines to reduce token counts and costs while preserving effectiveness and context. However, it is not a universal solution and should be used judiciously, as excessive compression can lead to a loss of important details. It is important to strike a balance between reducing size and maintaining the prompt's meaning.]Zoals je ziet vatte het model de ongecomprimeerde alinea prima samen.
Laten we nu de token-gereduceerde versie proberen. De gecomprimeerde alinea ziet er zo uit:
[When Should Prompt CompProm compression particularly following Advanced prompt engineering Techniques like chainofthought prompting while highly lengthy prompts reach thousands tokensThis increases processing costs and may exceed token limits of certain modelsProm compression mit these token count while prompt effectivenessRetri-au generationRAG pipelines R combine information retrieval text specialized chat contextual understandingThese pipelines frequently involve providing extensive conversation histories retrieved as prompts leading high token counts increased expensesProm compression essential such essential context while costsApplic prompt compression It prompt universal judFor instance assistant models like ChatGPT designed convers contexts benefit aggressive prompt compressionThese models often do charge per token integrated chat summar memory features conversation history effectively compression redundantIt even working models charge per token excessive compression could nuance importantSt reducing size maintaining prompt’s meaning is]De prompt telt 162 tokens, en dit is de samenvatting van het model:
[Prompt compression is recommended following advanced prompt engineering techniques like chain of thought prompting, especially when dealing with lengthy prompts that reach thousands of tokens. This helps reduce processing costs and ensure that the prompt remains effective for models like RAG pipelines, which involve extensive conversation histories. Prompt compression is essential for maintaining context while keeping costs low, particularly for models like ChatGPT that charge per token and benefit from aggressive compression. However, excessive compression could lead to loss of important nuances, so it is important to strike a balance between reducing size and maintaining the prompt's meaning.]De alinea is niet correct samengevat. De nuance dat ChatGPT niet gebaat is bij agressieve compressie ging verloren.
Proberen we vervolgens de reductie op zinsniveau. De verkorte prompt telt 129 tokens:
[When Should We Use Prompt Compression? This increases processing times and costs and may exceed token limits of certain models. These pipelines frequently involve providing extensive conversation histories or retrieved documents as prompts, leading to high token counts and increased expenses. Prompt compression is essential in such cases to maintain essential context while minimizing costs. For instance, assistant models like ChatGPT, designed for conversational contexts, may not benefit from aggressive prompt compression. These models often do not charge per token and have integrated chat summarization and memory features to manage conversation history effectively, making compression redundant. ]Dit is de samenvatting van het model:
[Prompt compression is necessary when processing times, costs, and token limits may be exceeded in pipelines involving extensive conversation histories or retrieved documents as prompts. However, for certain models like ChatGPT, designed for conversational contexts, aggressive prompt compression may not be beneficial as they already have features to manage conversation history effectively without the need for compression.]Deze samenvatting bevat geen fouten, maar mist de bespreking van RAG.
Tot slot testen we de reductie op woordgroepniveau. De prompt telt 183 tokens:
[When Should Prompt Compression Prompt compression particularly beneficial Advanced prompt engineering techniques Techniques like chainofthought prompting while highly lengthy prompts reach thousands tokens This increases processing costs and may exceed token limits of certain models Prompt compression these issues token count while the prompt's effectiveness Retrieval-augmented generation (RAG) pipelines RAG pipelines combine information retrieval text generation specialized chatbots contextual understanding These pipelines frequently involve providing extensive conversation histories or retrieved as prompts leading high token counts increased expenses Prompt compression essential such cases to maintain essential context while costs Applicability prompt compression It's For instance assistant models like ChatGPT designed conversational contexts may benefit aggressive prompt compression These models often do charge per token have integrated chat summarization memory features manage conversation history effectively making compression redundant It even working models charge per token excessive compression could nuance important details reducing size maintaining the prompt’s meaning is
]
Dit is de samenvatting van het model:
[Prompt compression is beneficial in advanced prompt engineering techniques, such as chainofthought prompting, which can involve lengthy prompts reaching thousands of tokens. Retrieval-augmented generation (RAG) pipelines combine information retrieval and text generation in specialized chatbots, requiring extensive conversation histories or retrieved prompts leading to high token counts and increased expenses. Prompt compression is essential in maintaining context while managing costs in such cases. For instance, assistant models like ChatGPT, which are designed for conversational contexts, may benefit from aggressive prompt compression to effectively manage conversation history and reduce costs. However, excessive compression could compromise important details, so maintaining the prompt's meaning is crucial.]De samenvatting is grotendeels correct en coherent. Maar het deel over ChatGPT wordt verkeerd begrepen: het zou juist niet gebaat zijn bij agressieve compressie.
Door de tokencounts en de inhoud van de modelsamenvattingen bij verschillende compressieniveaus te vergelijken, zie je het effect van promptcompressie op de modeloutput:
|
Compressieniveau |
Aantal tokens (origineel is 304 lang) |
Nauwkeurigheid |
|
Tokenniveau |
162 |
Belangrijke nuance verloren dat ChatGPT niet gebaat is bij agressieve compressie; bevatte fouten. |
|
Zinsniveau |
129 |
Maakte geen fouten, maar miste context over RAG-pijplijnen. |
|
Woordgroepniveau |
183 |
Net als op tokenniveau onterecht gesteld dat ChatGPT baat heeft bij agressieve compressie. |
Kortom, promptcompressie kan het aantal tokens aanzienlijk verminderen terwijl de hoofdgedachten behouden blijven. Maar het is belangrijk om de balans te vinden, zodat je geen cruciale nuances en context verliest.
Deze oefening laat zien dat je het compressieniveau zorgvuldig moet kiezen op basis van de toepassing en het belang van het behoud van bepaalde details in de prompt.
Let op dat we alle experimenten uitvoerden met een compressieratio van 0,5, wat relatief hoog is. Je kunt voor verschillende use cases met uiteenlopende ratios experimenteren om de optimale balans te vinden tussen het verkleinen van de prompt en het behouden van de integriteit.
Promptcompressie is een krachtige techniek om de efficiëntie en kosteneffectiviteit van LLM’s te optimaliseren. We hebben de basis, het belang, verschillende technieken en implementatiedetails verkend.
Naarmate generatieve AI zich verder ontwikkelt, is het cruciaal om op de hoogte te blijven van de laatste ontwikkelingen. Ter verdieping van je vaardigheden en begrip van promptcompressie en aanverwante technieken raad ik je aan de papers te bekijken die in dit artikel worden genoemd, evenals de volgende uitgebreide blogposts en cursussen van DataCamp:
Leer meer over prompt engineering!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


