Kurs
So funktioniert Prompt Engineering
1 Std.
231.4K
Im rasant entwickelnden Feld der Künstlichen Intelligenz geht es bei der Optimierung großer Sprachmodelle (LLMs) nicht nur darum, die Grenzen des Möglichen zu verschieben, sondern auch um Effizienz und Kosten.
Prompt-Kompression hat sich dabei als Schlüsselmethode etabliert, um die Leistungsfähigkeit dieser Modelle zu steigern und zugleich den Rechenaufwand zu senken. Da fast wöchentlich neue Forschung erscheint, ist es schwer, Schritt zu halten — die Grundlagen zu verstehen, ist jedoch essenziell.
Dieser Artikel erklärt die Basics der Prompt-Kompression, zeigt, wann du sie sinnvoll einsetzt, warum sie Kosten in RAG-Pipelines reduziert, und liefert Beispiele mit dem Modell gpt-3.5-turbo-0125 über die OpenAI-API.
Wenn du tiefer einsteigen willst, schau dir diesen Kurs zu Prompt Engineering an.
Prompt-Kompression ist eine Technik aus dem Natural Language Processing (NLP), bei der die Eingaben für LLMs so optimiert werden, dass sie kürzer ausfallen, ohne die Qualität und Relevanz der Ausgabe spürbar zu beeinträchtigen. Diese Optimierung ist wichtig, weil die Anzahl der Tokens in Anfragen einen direkten Einfluss auf die Leistung von LLMs hat.
Tokens sind die kleinsten Texteinheiten, mit denen LLMs arbeiten. Je nach Tokenizer des Modells entsprechen sie Wörtern oder Teilwörtern. Weniger Tokens in einem Prompt sind aus mehreren Gründen vorteilhaft und teils notwendig:
Prompt-Kompression senkt die Tokenzahl, indem sie Redundanzen entfernt, Kernaussagen zusammenfasst oder spezielle Algorithmen nutzt, um den Gehalt eines Prompts bei minimaler Tokenanzahl zu destillieren.
Schauen wir uns typische Szenarien an, in denen Prompt-Kompression sinnvoll ist.
Techniken wie Chain-of-Thought-Prompting sind sehr effektiv, führen aber oft zu langen Prompts mit Tausenden Tokens. Das treibt Laufzeiten und Kosten hoch und kann Token-Limits mancher Modelle sprengen.
Prompt-Kompression entschärft diese Probleme, indem sie die Tokenzahl reduziert und dabei die Wirksamkeit des Prompts erhält.
RAG-Pipelines kombinieren Informationssuche mit Textgenerierung und kommen häufig in spezialisierten Chatbots und Anwendungen zum Einsatz, in denen Kontextverständnis entscheidend ist. Dazu werden oft lange Gesprächsverläufe oder abgerufene Dokumente als Prompt übergeben — mit entsprechend hohen Tokenzahlen und Kosten.
Prompt-Kompression ist hier zentral, um den notwendigen Kontext zu wahren und die Kosten zu senken.
Prompt-Kompression ist kein Allheilmittel und sollte mit Augenmaß eingesetzt werden. Assistentenmodelle wie ChatGPT, die für Konversationen ausgelegt sind, profitieren nicht zwangsläufig von aggressiver Kompression.
Diese Modelle rechnen oft nicht pro Token ab und verfügen über integrierte Chat-Zusammenfassungen und Memory-Funktionen, um Gesprächsverläufe effizient zu managen — zusätzliche Kompression kann dann überflüssig sein.
Auch wenn du mit Modellen arbeitest, die pro Token abrechnen, kann übermäßige Kompression Nuancen oder wichtige Details zerstören. Die richtige Balance zwischen Kürze und inhaltlicher Integrität ist entscheidend.
Prompt-Kompression lässt sich grob in drei Ansätze gliedern: Knowledge Distillation, Encoding und Filtering. Jede Methode nutzt eigene Stärken, um Länge und Effizienz von Prompts für LLMs zu optimieren.
Wir streifen hier alle drei Techniken; einen umfassenderen Überblick liefert dieses Paper: Efficient Prompting Methods for Large Language Models: A Survey. Im Folgenden nenne ich es das „Survey-Paper“.
Knowledge Distillation ist eine Technik aus dem maschinellen Lernen, erstmals von Hinton et al. (2015) vorgestellt. Dabei lernt ein kleineres, einfacheres Modell (der Student), das Verhalten eines großen, komplexen Modells (der Lehrer) nachzuahmen.
Ursprünglich sollte damit der Rechenaufwand für Modell-Ensembles gesenkt werden. Im Kontext von Prompt Engineering kann Knowledge Distillation genutzt werden, um den Prompt statt des Modells zu komprimieren.
Das gelingt, indem LLMs lernen, harte Prompts per Soft-Prompt-Tuning zu verdichten. Details findest du im Survey-Paper in Abschnitt 3.1 und Anhang A.1.1.
Encoding-Methoden wandeln Texte in Vektoren um, wodurch sich die Promptlänge verkürzen lässt, ohne wesentliche Informationen zu verlieren. Diese Vektoren erfassen die Kernaussage des Prompts und ermöglichen LLMs eine effiziente Verarbeitung kürzerer Eingaben.
Je nach Encodingsprache und Tokenizer kann die Tokenzahl allerdings auch steigen. Wenn du z. B. in Base64 kodierst, kann die Tokenlänge größer werden — teste deshalb zunächst, was für deinen Anwendungsfall gilt.
Erstaunlicherweise werden manche Encoding-Techniken auch für Model-Jailbreaking genutzt, also zum Umgehen von Sicherheitsmechanismen. Mehr zu Encoding-Methoden findest du im Survey-Paper in Abschnitt 3.2 und Anhang A.1.2.
Während die beiden vorherigen Methoden den gesamten Prompt verdichten, zielen Filtering-Techniken darauf ab, Überflüssiges zu entfernen und so die Effizienz zu steigern.
Dabei wird der Informationsgehalt einzelner Prompt-Bestandteile bewertet und Redundantes entfernt, denn nicht alles ist für LLMs hilfreich. Das kann auf Satz-, Phrasen- oder Tokenebene erfolgen.
Ziel ist, nur die relevantesten Teile zu behalten. In Selective Context von Li et al. (2023) wird etwa mithilfe von Self-Information-Metriken gefiltert. In LLMLingua: Compressing Prompts for Accelerated Inference of Large Language Models destillieren Microsoft-Forschende Prompts in Schlüsselteile und passen die Kompressionsraten dynamisch an. Siehe auch Abschnitt 3.3 und Anhang A.1.3 im Survey-Paper.
In diesem Abschnitt implementiere und teste ich den Selective-Context-Algorithmus, der beliebt ist und als State of the Art gilt. Wenn du nur testen willst, musst du nichts installieren — die App ist bereits auf Hugging Face gehostet.
Es gibt auch andere gängige Verfahren, etwa Keep It Simple (KIS), SCLR und die Algorithmen der LLMLingua-Familie. In diesem kurzen Artikel können wir sie jedoch nicht abdecken.
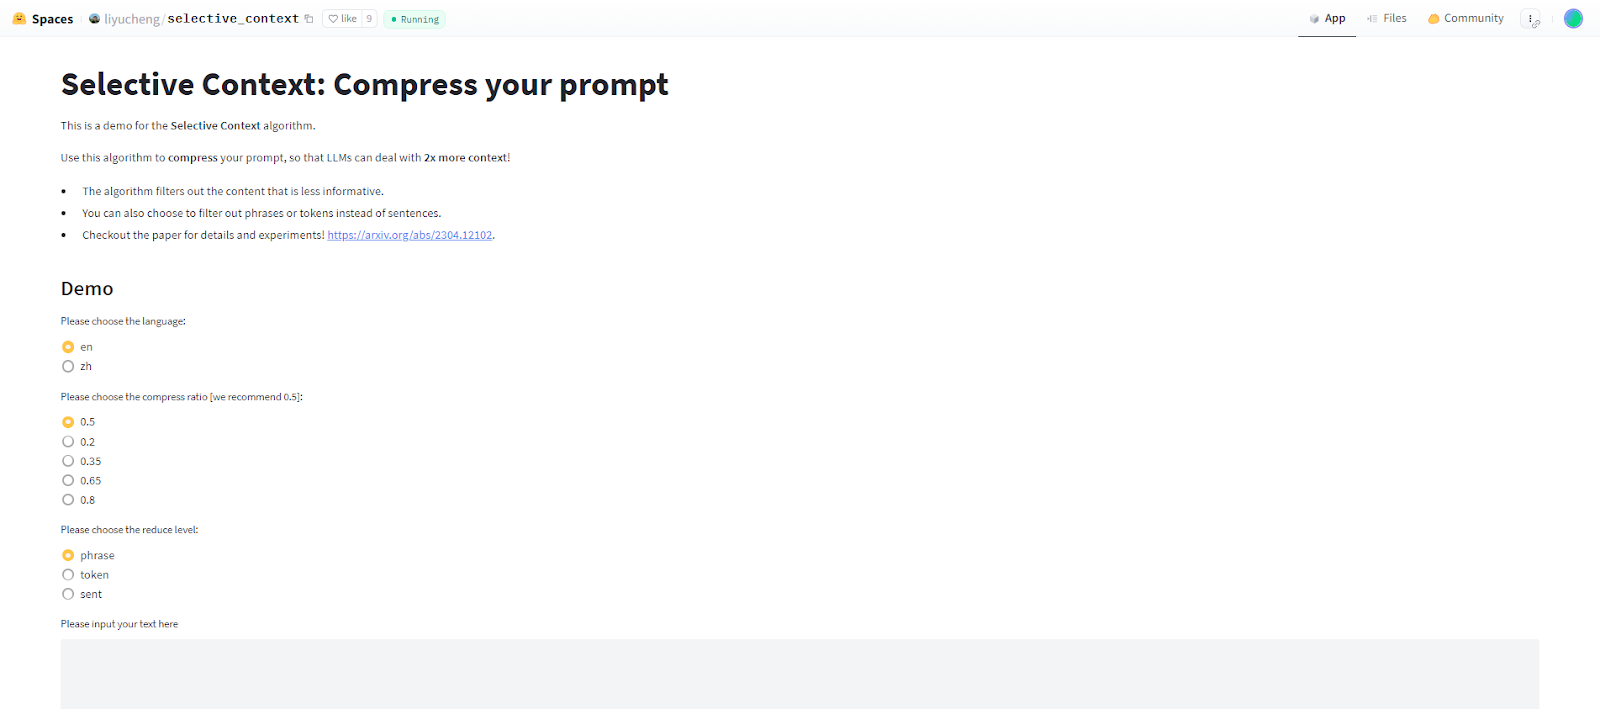
In der Selective-Context-Webapp kannst du die Sprache des zu komprimierenden Prompts wählen (Englisch oder Vereinfachtes Chinesisch). Außerdem legst du das Kompressionsverhältnis fest und wählst, ob auf Satz-, Token- oder Phrasenebene gefiltert werden soll.
Kommen wir nun zur Python-Implementierung. Wir testen außerdem einige komprimierte Prompts mit dem Modell gpt-3.5-turbo-0125.
Zuerst installieren wir die benötigten Module. Wir installieren die Bibliothek selective-context per pip:
pip install selective-contextAußerdem laden wir das en_core_web_sm-Modell von spacy mit folgendem Befehl herunter:
python -m spacy download en_core_web_smNun initialisieren wir das SelectiveContext-Objekt. Als Modell kommen curie oder gpt-2 in Frage, als Sprache en oder zh. Im Beispiel nutze ich gpt-2.
sc = SelectiveContext(model_type = ‘gpt-2’, lang = ‘en’)Anschließend rufen wir unser SelectiveContext-Objekt mit dem zu komprimierenden Text auf. Wir setzen die Parameter reduce_ratio und reduce_level. reduce_level ist eines von: ‘sent’, ‘phrase’ oder ‘token’. Der Aufruf liefert ein (context, reduced_content)-Tuple, wobei context der komprimierte Prompt ist und reduced_content die entfernten Phrasen, Sätze oder Tokens enthält.
context, reduced_content = sc(text, reduce_ratio = 0.5, reduce_level = ‘sent’)Jetzt ein paar Beispiele. Ich lasse das Modell gpt-3.5-turbo-0125 den Abschnitt „Wann sollten wir Prompt-Kompression einsetzen“ aus diesem Artikel zusammenfassen. Danach komprimieren wir den Abschnitt mit einer Rate von 0,5 auf allen drei Ebenen — Satz, Phrase und Token —, lassen das Modell die komprimierten Versionen erneut zusammenfassen und vergleichen Tokenzahl und Output.
Unten siehst du den API-Aufruf, den ich verwende — lediglich die Variable text in der Format-String-Ersetzung ändert sich. Zunächst bitten wir das Modell, den ursprünglichen, unkomprimierten Absatz zu zusammenzufassen:
from openai import OpenAI
client = OpenAI(api_key = key)
completion = client.chat.completions.create(
	model = “gpt-3.5-turbo-0125”,
	messages = [
{“role”: “user”, “content”: f”Summarize the following paragraph:\n {text}”}
]
)
Über completion.usage sehen wir: Der Originalprompt ist 304 Tokens lang. Die Ausgabe lautet:
[Prompt-Kompression ist in Szenarien wie fortgeschrittenen Prompt-Engineering-Techniken und Retrieval-Augmented-Generation-Pipelines nützlich, um Tokenzahlen und Kosten zu reduzieren und dabei Wirksamkeit und Kontext zu bewahren. Sie ist jedoch kein Allheilmittel und sollte maßvoll eingesetzt werden, da übermäßige Kompression wichtige Details kosten kann. Es gilt, die richtige Balance zwischen Kürze und Bedeutung des Prompts zu finden.]Wie du siehst, fasst das Modell den unkomprimierten Absatz überzeugend zusammen.
Nun die tokenreduzierte Version. Der komprimierte Absatz sieht so aus:
[When Should Prompt CompProm compression particularly following Advanced prompt engineering Techniques like chainofthought prompting while highly lengthy prompts reach thousands tokensThis increases processing costs and may exceed token limits of certain modelsProm compression mit these token count while prompt effectivenessRetri-au generationRAG pipelines R combine information retrieval text specialized chat contextual understandingThese pipelines frequently involve providing extensive conversation histories retrieved as prompts leading high token counts increased expensesProm compression essential such essential context while costsApplic prompt compression It prompt universal judFor instance assistant models like ChatGPT designed convers contexts benefit aggressive prompt compressionThese models often do charge per token integrated chat summar memory features conversation history effectively compression redundantIt even working models charge per token excessive compression could nuance importantSt reducing size maintaining prompt’s meaning is]Der Prompt ist 162 Tokens lang. Die Modellzusammenfassung:
[Prompt-Kompression wird insbesondere nach fortgeschrittenen Prompt-Engineering-Techniken wie Chain-of-Thought-Prompting empfohlen, vor allem bei sehr langen Prompts mit tausenden Tokens. Sie senkt Kosten und erhält die Wirksamkeit, z. B. in RAG-Pipelines mit langen Gesprächsverläufen. Prompt-Kompression ist wichtig, um Kontext zu wahren und Kosten niedrig zu halten, besonders bei Modellen wie ChatGPT, die pro Token abrechnen und von aggressiver Kompression profitieren. Allerdings kann übermäßige Kompression wichtige Nuancen zerstören, daher ist Balance wichtig.]Die Zusammenfassung ist inhaltlich fehlerhaft. Die Nuance, dass ChatGPT nicht von aggressiver Kompression profitiert, ging verloren.
Als Nächstes die Reduktion auf Satzebene. Der reduzierte Prompt hat 129 Tokens:
[When Should We Use Prompt Compression? This increases processing times and costs and may exceed token limits of certain models. These pipelines frequently involve providing extensive conversation histories or retrieved documents as prompts, leading to high token counts and increased expenses. Prompt compression is essential in such cases to maintain essential context while minimizing costs. For instance, assistant models like ChatGPT, designed for conversational contexts, may not benefit from aggressive prompt compression. These models often do not charge per token and have integrated chat summarization and memory features to manage conversation history effectively, making compression redundant. ]Die Modellzusammenfassung:
[Prompt-Kompression ist notwendig, wenn Laufzeiten, Kosten und Tokenlimits überschritten werden könnten, etwa in Pipelines mit langen Gesprächsverläufen oder abgerufenen Dokumenten als Prompts. Für Modelle wie ChatGPT, die für Konversationen ausgelegt sind, ist aggressive Prompt-Kompression hingegen oft nicht sinnvoll, da sie bereits Funktionen zur Verwaltung des Gesprächsverlaufs besitzen.]Diese Zusammenfassung ist korrekt, blendet jedoch den RAG-Aspekt aus.
Zum Schluss die Reduktion auf Phrasenebene. Der Prompt umfasst 183 Tokens:
[When Should Prompt Compression Prompt compression particularly beneficial Advanced prompt engineering techniques Techniques like chainofthought prompting while highly lengthy prompts reach thousands tokens This increases processing costs and may exceed token limits of certain models Prompt compression these issues token count while the prompt's effectiveness Retrieval-augmented generation (RAG) pipelines RAG pipelines combine information retrieval text generation specialized chatbots contextual understanding These pipelines frequently involve providing extensive conversation histories or retrieved as prompts leading high token counts increased expenses Prompt compression essential such cases to maintain essential context while costs Applicability prompt compression It's For instance assistant models like ChatGPT designed conversational contexts may benefit aggressive prompt compression These models often do charge per token have integrated chat summarization memory features manage conversation history effectively making compression redundant It even working models charge per token excessive compression could nuance important details reducing size maintaining the prompt’s meaning is
]
Die Modellzusammenfassung:
[Prompt-Kompression ist bei fortgeschrittenen Prompt-Engineering-Techniken wie Chain-of-Thought-Prompting hilfreich, die sehr lange Prompts erzeugen können. RAG-Pipelines verknüpfen Informationssuche und Textgenerierung in spezialisierten Chatbots und benötigen oft umfangreiche Gesprächsverläufe oder abgerufene Prompts, was zu hohen Tokenzahlen und Kosten führt. Prompt-Kompression hilft, Kontext zu bewahren und Kosten zu senken. Für Assistentenmodelle wie ChatGPT könne aggressive Kompression dabei helfen, Gesprächsverläufe zu managen und Kosten zu reduzieren. Übermäßige Kompression kann jedoch wichtige Details zerstören, daher ist die Bedeutung des Prompts zu wahren.]Die Zusammenfassung ist größtenteils schlüssig, interpretiert jedoch fälschlich, dass ChatGPT von aggressiver Kompression profitiert.
Der Vergleich von Tokenzahlen und Zusammenfassungen auf unterschiedlichen Kompressionsebenen zeigt den Einfluss der Prompt-Kompression auf die Modellausgabe:
|
Kompressionsebene |
Tokenzahl (Original: 304) |
Genauigkeit |
|
Tokenebene |
162 |
Wichtige Nuancen gingen verloren (z. B. ChatGPT profitiert nicht von aggressiver Kompression); zudem Fehler. |
|
Satzebene |
129 |
Keine Fehler, aber Kontext zu RAG-Pipelines fehlte. |
|
Phrasenebene |
183 |
Ähnlich wie auf Tokenebene: Falsch dargestellt, dass ChatGPT von aggressiver Kompression profitiert. |
Unterm Strich kann Prompt-Kompression die Tokenzahl deutlich senken und die Kernaussagen erhalten. Entscheidend ist jedoch, die Balance zu wahren, um keine wichtigen Nuancen oder Kontextinformationen zu verlieren.
Die Übung zeigt, wie wichtig es ist, die Kompressionsebene passend zur Anwendung zu wählen — insbesondere, wenn bestimmte Details im Prompt kritisch sind.
Beachte auch: Wir haben in allen Experimenten mit einer Kompressionsrate von 0,5 gearbeitet, was relativ hoch ist. Für verschiedene Use Cases solltest du mit mehreren Raten experimentieren, um die optimale Balance aus Kürze und inhaltlicher Integrität zu finden.
Prompt-Kompression ist eine wirkungsvolle Methode, um Effizienz und Kosten von LLMs zu optimieren. Wir haben die Grundlagen, Einsatzfelder, Techniken und die Umsetzung beleuchtet.
Da sich Generative KI rasant weiterentwickelt, ist es wichtig, am Ball zu bleiben. Um deine Kompetenzen rund um Prompt-Kompression und verwandte Techniken auszubauen, lies die im Artikel verlinkten Paper und wirf einen Blick auf diese Blogposts und Kurse von DataCamp:
Mehr über Prompt Engineering lernen!
Kurs
Kurs
Kurs