
Corso
Comprendere l'ingegneria del prompt
1 ore
237.1K
Nel panorama in rapida evoluzione dell’intelligenza artificiale, ottimizzare i large language model (LLM) non significa solo spingere i confini del possibile, ma anche garantire efficienza e convenienza economica.
La compressione dei prompt è emersa come una tecnica fondamentale per migliorare le prestazioni di questi modelli riducendo al contempo le spese computazionali. Con nuove ricerche quasi ogni settimana, restare al passo è impegnativo, ma comprenderne i fondamenti è essenziale.
Questo articolo copre le basi della compressione dei prompt, discute quando usarla, la sua importanza nel ridurre i costi nelle pipeline RAG e fornisce esempi utilizzando il modello gpt-3.5-turbo-0125 tramite l’API di OpenAI.
Se vuoi saperne di più, dai un’occhiata a questo corso sul prompt engineering.
La compressione dei prompt è una tecnica utilizzata nell’elaborazione del linguaggio naturale (NLP) per ottimizzare gli input forniti agli LLM riducendone la lunghezza senza alterare in modo significativo la qualità e la pertinenza dell’output. Questa ottimizzazione è cruciale per l’impatto che il numero di token nelle query ha sulle prestazioni degli LLM.
I token sono le unità di base del testo utilizzate dagli LLM, rappresentano parole o sotto-parole a seconda del tokenizer del modello linguistico. Ridurre il numero di token in un prompt è utile, e talvolta necessario, per diversi motivi:
La compressione dei prompt riduce il numero di token impiegando strategie come la rimozione di informazioni ridondanti, il riassunto dei punti chiave o l’uso di algoritmi specializzati per distillare l’essenza di un prompt minimizzandone il conteggio dei token.
Esploriamo gli scenari in cui potremmo usare la compressione dei prompt.
Tecniche come la chain-of-thought prompting, pur essendo molto efficaci, spesso producono prompt lunghi che possono raggiungere migliaia di token. Questo aumenta i tempi di elaborazione e i costi, e può superare i limiti di token di alcuni modelli.
La compressione dei prompt mitiga questi problemi riducendo il numero di token preservando l’efficacia del prompt.
Le pipeline RAG combinano il recupero delle informazioni con la generazione di testo e sono spesso usate in chatbot specializzati e altre applicazioni in cui la comprensione del contesto è fondamentale. Queste pipeline necessitano frequentemente di ampie cronologie di conversazione o documenti recuperati come prompt, con conseguenti conteggi di token elevati e costi maggiori.
In questi casi la compressione dei prompt è essenziale per mantenere il contesto indispensabile riducendo al minimo i costi.
È importante notare che la compressione dei prompt non è una soluzione universale e va usata con giudizio. Ad esempio, i modelli assistenti come ChatGPT, progettati per contesti conversazionali, potrebbero non trarre beneficio da una compressione aggressiva.
Questi modelli spesso non tariffano per token e hanno funzionalità integrate di sintesi delle chat e memoria per gestire efficacemente la cronologia della conversazione, rendendo la compressione superflua.
È anche importante notare che, anche quando si lavora con modelli che tariffano per token, una compressione eccessiva può portare a perdita di sfumature o dettagli importanti. La chiave è trovare il giusto equilibrio tra riduzione della dimensione e mantenimento dell’integrità del significato del prompt.
Le tecniche di compressione dei prompt possono essere suddivise in tre metodi principali: distillazione della conoscenza, codifica e filtraggio. Ogni tecnica sfrutta punti di forza diversi per ottimizzare la lunghezza e l’efficienza dei prompt per gli LLM.
Pur parlando di ciascuna di queste tecniche, puoi trovare un approccio più completo in questo paper: Efficient Prompting Methods for Large Language Models: A Survey. In tutto l’articolo farò riferimento a questo paper come “survey paper”.
La distillazione della conoscenza è una tecnica nel campo del machine learning, introdotta per la prima volta da Hinton et al. (2015), in cui un modello più piccolo e semplice (lo studente) viene addestrato per replicare il comportamento di un modello più grande e complesso (l’insegnante).
Questa tecnica è stata inizialmente sviluppata per affrontare le sfide computazionali dell’addestramento di un ensemble di modelli. Nel contesto del prompt engineering, la distillazione della conoscenza può essere utilizzata per comprimere il prompt invece del modello.
Questo si ottiene imparando a comprimere i prompt “hard” all’interno degli LLM tramite soft prompt tuning. Per approfondimenti, vedi le sezioni 3.1 e l’appendice A.1.1 del survey paper.
I metodi di codifica trasformano i testi di input in vettori, riducendo la lunghezza del prompt senza perdere informazioni critiche. Questi vettori catturano il significato essenziale dei prompt, consentendo agli LLM di elaborare input più brevi in modo efficiente.
Tuttavia, a seconda del linguaggio di codifica e del tokenizer, la lunghezza in token potrebbe in realtà aumentare. Ad esempio, se codifichi un prompt in Base64, la lunghezza in token potrebbe risultare maggiore: assicurati quindi di fare test preliminari in base al tuo caso d’uso.
Sorprendentemente, alcune tecniche di codifica vengono anche utilizzate per il jailbreaking dei modelli, ovvero per manipolare un LLM al fine di aggirarne i meccanismi di sicurezza. Per maggiori dettagli sui metodi di codifica, vedi le sezioni 3.2 e l’appendice A.1.2 del survey paper.
Mentre i due metodi precedenti cercano di comprimere l’intero prompt, le tecniche di filtraggio si concentrano sull’eliminazione delle parti non necessarie per migliorare l’efficienza degli LLM.
Le tecniche di filtraggio valutano il contenuto informativo delle diverse parti di un prompt e rimuovono le informazioni ridondanti, poiché non tutte le informazioni presenti nel prompt sono utili per gli LLM. Questo può essere fatto a vari livelli, come frasi, sintagmi o token.
L’obiettivo è mantenere solo le parti più rilevanti del prompt. Nel paper Selective Context di Li et al. (2023), i ricercatori utilizzano metriche di auto-informazione per filtrare le informazioni ridondanti. Nel paper LLMLingua: Compressing Prompts for Accelerated Inference of Large Language Models, i ricercatori di Microsoft raffinano i prompt in componenti chiave e regolano dinamicamente i rapporti di compressione per ciascuna parte. Per ulteriori letture, consulta le sezioni 3.3 e l’appendice A.1.3 del survey paper.
In questa sezione implementerò e testerò l’algoritmo Selective Context, che è popolare e considerato all’avanguardia. Se vuoi solo testare l’algoritmo, non devi installare nulla: è già ospitato sulla piattaforma HuggingFace.
Esistono anche altre tecniche di compressione mainstream, come Keep It Simple (KIS), SCLR e gli algoritmi della famiglia LLMLingua, ma non riusciremo a trattarle in questo breve articolo.
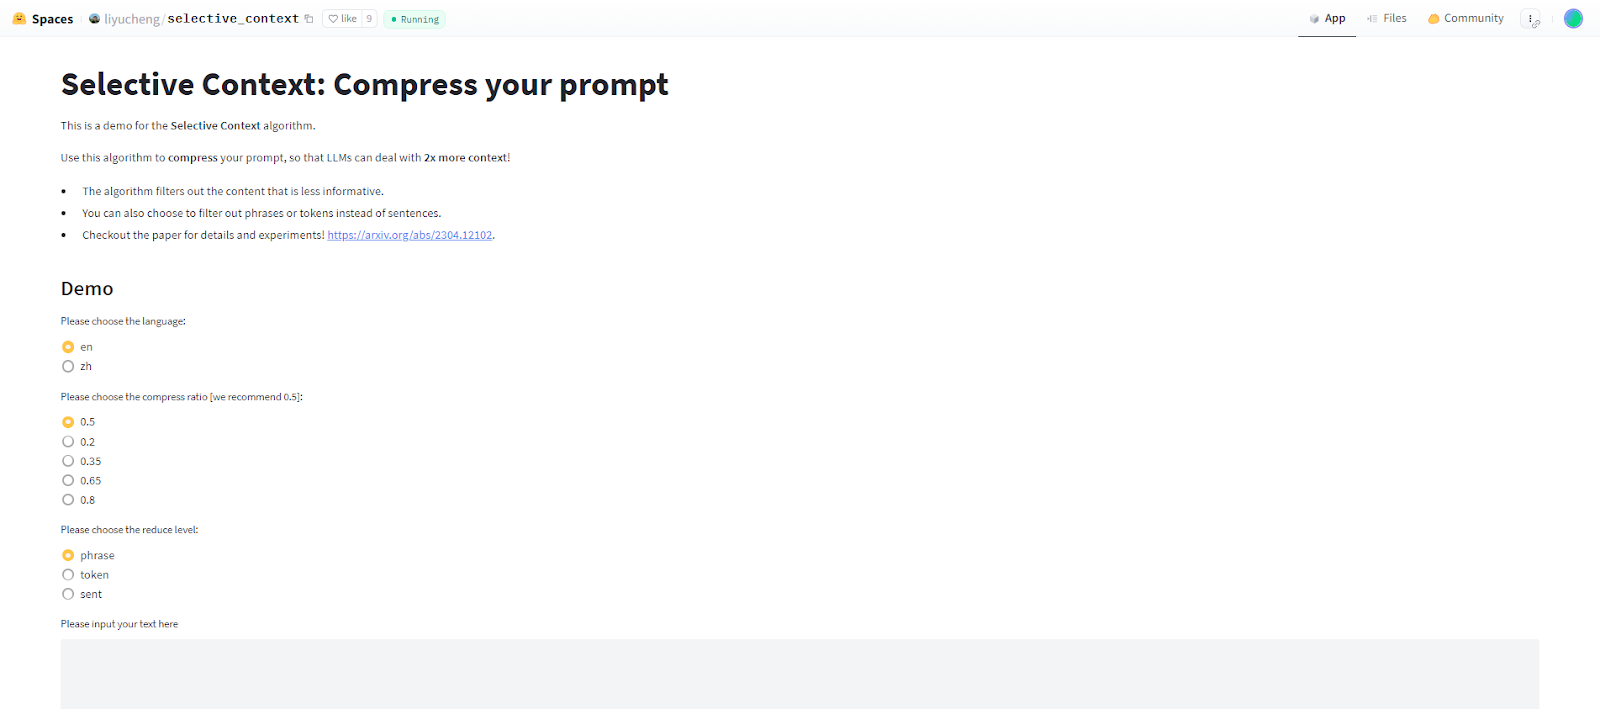
Nell’app web Selective Context, puoi scegliere la lingua del prompt che vuoi comprimere (inglese o cinese semplificato). Puoi anche impostare il rapporto di compressione e scegliere se filtrare frasi, token o sintagmi.
Ora passiamo all’implementazione in Python. Testeremo anche alcuni prompt compressi con il modello gpt-3.5-turbo-0125.
Per prima cosa dobbiamo installare tutti i moduli necessari. Dobbiamo installare la libreria selective-context usando pip:
pip install selective-contextDobbiamo anche scaricare il modello en_core_web_sm di spacy; si può fare con il seguente comando:
python -m spacy download en_core_web_smOra dobbiamo inizializzare l’oggetto SelectiveContext. Possiamo scegliere curie o gpt-2 per il modello e en o zh per la lingua. In questo esempio userò gpt-2.
sc = SelectiveContext(model_type = ‘gpt-2’, lang = ‘en’)Successivamente possiamo richiamare il nostro oggetto SelectiveContext sulla stringa di testo che vogliamo comprimere. Possiamo impostare i parametri reduce_ratio e reduce_level. reduce_level deve essere uno dei seguenti: ‘sent’, ‘phrase’ o ‘token’. La chiamata dell’oggetto restituisce una tupla (context, reduced_content), dove context è il prompt compresso e reduced_content è un elenco di sintagmi, frasi o token rimossi.
context, reduced_content = sc(text, reduce_ratio = 0.5, reduce_level = ‘sent’)Ora facciamo alcuni esempi. Chiederò al modello gpt-3.5-turbo-0125 di riassumere la sezione “Quando dovremmo usare la compressione dei prompt” di questo articolo. Poi comprimeremo la sezione con un tasso di compressione di 0,5 usando tutti e tre i livelli di riduzione: frase, sintagma e token. Chiederemo al modello di riassumere di nuovo le versioni compresse e confronteremo il conteggio dei token di ciascun prompt e l’output del modello.
Di seguito puoi vedere la chiamata all’API che userò: cambieremo solo la variabile text nella stringa di formato. Per prima cosa, chiediamo al modello di riassumere il paragrafo originale, non compresso:
from openai import OpenAI
client = OpenAI(api_key = key)
completion = client.chat.completions.create(
	model = “gpt-3.5-turbo-0125”,
	messages = [
{“role”: “user”, “content”: f”Summarize the following paragraph:\n {text}”}
]
)
Controllando completion.usage possiamo vedere che il prompt originale è lungo 304 token, e questo è l’output:
[Prompt compression is useful in scenarios such as advanced prompt engineering techniques and retrieval-augmented generation pipelines to reduce token counts and costs while preserving effectiveness and context. However, it is not a universal solution and should be used judiciously, as excessive compression can lead to a loss of important details. It is important to strike a balance between reducing size and maintaining the prompt's meaning.]Come puoi vedere, il modello ha riassunto piuttosto bene il paragrafo non compresso.
Ora proviamo la versione ridotta a livello di token. Il paragrafo compresso è il seguente:
[When Should Prompt CompProm compression particularly following Advanced prompt engineering Techniques like chainofthought prompting while highly lengthy prompts reach thousands tokensThis increases processing costs and may exceed token limits of certain modelsProm compression mit these token count while prompt effectivenessRetri-au generationRAG pipelines R combine information retrieval text specialized chat contextual understandingThese pipelines frequently involve providing extensive conversation histories retrieved as prompts leading high token counts increased expensesProm compression essential such essential context while costsApplic prompt compression It prompt universal judFor instance assistant models like ChatGPT designed convers contexts benefit aggressive prompt compressionThese models often do charge per token integrated chat summar memory features conversation history effectively compression redundantIt even working models charge per token excessive compression could nuance importantSt reducing size maintaining prompt’s meaning is]Il prompt è lungo 162 token, e questo è il riassunto del modello:
[Prompt compression is recommended following advanced prompt engineering techniques like chain of thought prompting, especially when dealing with lengthy prompts that reach thousands of tokens. This helps reduce processing costs and ensure that the prompt remains effective for models like RAG pipelines, which involve extensive conversation histories. Prompt compression is essential for maintaining context while keeping costs low, particularly for models like ChatGPT that charge per token and benefit from aggressive compression. However, excessive compression could lead to loss of important nuances, so it is important to strike a balance between reducing size and maintaining the prompt's meaning.]Il paragrafo non è stato riassunto correttamente. Si è persa la sfumatura secondo cui ChatGPT non trae beneficio da una compressione aggressiva.
Passiamo ora alla riduzione a livello di frase. Il prompt ridotto è lungo 129 token:
[When Should We Use Prompt Compression? This increases processing times and costs and may exceed token limits of certain models. These pipelines frequently involve providing extensive conversation histories or retrieved documents as prompts, leading to high token counts and increased expenses. Prompt compression is essential in such cases to maintain essential context while minimizing costs. For instance, assistant models like ChatGPT, designed for conversational contexts, may not benefit from aggressive prompt compression. These models often do not charge per token and have integrated chat summarization and memory features to manage conversation history effectively, making compression redundant. ]Ecco il riassunto del modello:
[Prompt compression is necessary when processing times, costs, and token limits may be exceeded in pipelines involving extensive conversation histories or retrieved documents as prompts. However, for certain models like ChatGPT, designed for conversational contexts, aggressive prompt compression may not be beneficial as they already have features to manage conversation history effectively without the need for compression.]Questo riassunto non contiene errori, ma manca il riferimento alle pipeline RAG.
Infine, testiamo la riduzione a livello di sintagma. Il prompt è lungo 183 token:
[When Should Prompt Compression Prompt compression particularly beneficial Advanced prompt engineering techniques Techniques like chainofthought prompting while highly lengthy prompts reach thousands tokens This increases processing costs and may exceed token limits of certain models Prompt compression these issues token count while the prompt's effectiveness Retrieval-augmented generation (RAG) pipelines RAG pipelines combine information retrieval text generation specialized chatbots contextual understanding These pipelines frequently involve providing extensive conversation histories or retrieved as prompts leading high token counts increased expenses Prompt compression essential such cases to maintain essential context while costs Applicability prompt compression It's For instance assistant models like ChatGPT designed conversational contexts may benefit aggressive prompt compression These models often do charge per token have integrated chat summarization memory features manage conversation history effectively making compression redundant It even working models charge per token excessive compression could nuance important details reducing size maintaining the prompt’s meaning is
]
Ecco il riassunto del modello:
[Prompt compression is beneficial in advanced prompt engineering techniques, such as chainofthought prompting, which can involve lengthy prompts reaching thousands of tokens. Retrieval-augmented generation (RAG) pipelines combine information retrieval and text generation in specialized chatbots, requiring extensive conversation histories or retrieved prompts leading to high token counts and increased expenses. Prompt compression is essential in maintaining context while managing costs in such cases. For instance, assistant models like ChatGPT, which are designed for conversational contexts, may benefit from aggressive prompt compression to effectively manage conversation history and reduce costs. However, excessive compression could compromise important details, so maintaining the prompt's meaning is crucial.]Il riassunto è per lo più corretto e coerente. Tuttavia, interpreta in modo errato la parte secondo cui ChatGPT trae beneficio da una compressione aggressiva.
Confrontando il numero di token e i contenuti dei riassunti del modello ai diversi livelli di compressione, possiamo vedere l’impatto della compressione dei prompt sull’output del modello:
|
Livello di compressione |
Conteggio token (l’originale è lungo 304) |
Accuratezza |
|
A livello di token |
162 |
Ha perso importanti sfumature sul fatto che ChatGPT non trae beneficio da una compressione aggressiva e ha commesso errori. |
|
A livello di frase |
129 |
Non ha commesso errori, ma ha tralasciato parte del contesto sulle pipeline RAG. |
|
A livello di sintagma |
183 |
Analogamente al livello di token, ha affermato erroneamente che ChatGPT trae beneficio da una compressione aggressiva. |
In generale, la compressione dei prompt può ridurre significativamente il numero di token preservando le idee principali. Tuttavia, è essenziale trovare un equilibrio per evitare di perdere sfumature e contesto importanti.
Questo esercizio evidenzia la necessità di scegliere con attenzione il livello di compressione in base all’applicazione specifica e alla criticità del mantenimento di alcuni dettagli nel prompt.
Vale la pena notare che abbiamo eseguito tutti gli esperimenti con un tasso di compressione di 0,5, che è relativamente alto. Potresti voler sperimentare vari tassi di compressione per diversi casi d’uso, per trovare il giusto equilibrio tra riduzione della dimensione del prompt e mantenimento della sua integrità.
La compressione dei prompt è una tecnica potente per ottimizzare l’efficienza e la convenienza economica degli LLM. Ne abbiamo esplorato i fondamenti, discutendone l’importanza, le diverse tecniche e i dettagli di implementazione.
Man mano che il campo dell’AI generativa continua a evolversi, restare aggiornati sugli ultimi sviluppi è cruciale. Per approfondire le tue competenze e la comprensione della compressione dei prompt e delle tecniche correlate, ti invito a esplorare gli articoli citati in questo articolo, oltre ai seguenti post del blog e corsi completi di DataCamp:
Scopri di più sul prompt engineering!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



