Cours
Comprendre l'ingénierie des prompts
1 h
231.7K
Dans le paysage de l’intelligence artificielle qui évolue à toute vitesse, optimiser les grands modèles de langage (LLM) ne consiste pas seulement à repousser les limites du possible, mais aussi à garantir l’efficacité et la maîtrise des coûts.
La compression des prompts s’est imposée comme une technique clé pour améliorer les performances de ces modèles tout en réduisant les dépenses de calcul. Face à une recherche qui avance presque chaque semaine, rester à jour est un défi, mais comprendre les fondamentaux reste indispensable.
Cet article présente les bases de la compression des prompts, explique quand l’utiliser, son importance pour réduire les coûts dans les pipelines RAG, et propose des exemples avec le modèle gpt-3.5-turbo-0125 via l’API d’OpenAI.
Pour aller plus loin, découvrez ce cours sur le prompt engineering.
La compression des prompts est une technique de traitement automatique du langage (TAL) qui optimise les entrées fournies aux LLM en réduisant leur longueur sans altérer de manière significative la qualité et la pertinence des sorties. Cette optimisation est cruciale en raison de l’impact du nombre de tokens dans les requêtes sur les performances des LLM.
Les tokens sont les unités de base de texte utilisées par les LLM, représentant des mots ou des sous-mots selon le tokenizer du modèle. Réduire le nombre de tokens dans un prompt est utile, et parfois nécessaire, pour plusieurs raisons :
La compression des prompts réduit le nombre de tokens grâce à des stratégies comme la suppression des redondances, la synthèse des points clés ou l’utilisation d’algorithmes spécialisés pour distiller l’essentiel d’un prompt tout en minimisant son volume en tokens.
Voyons dans quels cas il est pertinent d’y recourir.
Des techniques comme la chain-of-thought prompting, bien que très efficaces, produisent souvent des prompts longs pouvant atteindre des milliers de tokens. Cela augmente les temps de traitement et les coûts, et peut dépasser les limites de certains modèles.
La compression des prompts atténue ces problèmes en réduisant le nombre de tokens tout en préservant l’efficacité du prompt.
Les pipelines RAG combinent récupération d’information et génération de texte, et sont fréquemment utilisés dans des chatbots spécialisés et d’autres applications où le contexte est crucial. Ils nécessitent souvent de longs historiques de conversation ou des documents récupérés comme prompts, ce qui gonfle le nombre de tokens et les coûts.
Dans ces cas, la compression des prompts est essentielle pour conserver le contexte indispensable tout en maîtrisant les dépenses.
Il est important de noter que la compression des prompts n’est pas une solution universelle et doit être utilisée avec discernement. Par exemple, des assistants de type ChatGPT, conçus pour des échanges conversationnels, ne profitent pas forcément d’une compression agressive.
Ces modèles ne facturent pas toujours au token et disposent de fonctions intégrées de synthèse et de mémoire pour gérer efficacement l’historique des conversations, rendant la compression redondante.
De même, même avec des modèles facturés au token, une compression excessive peut faire perdre des nuances ou des détails importants. L’enjeu est de trouver le bon équilibre entre réduction de la taille et préservation du sens du prompt.
On peut regrouper les techniques de compression des prompts en trois familles : distillation des connaissances, encodage et filtrage. Chacune s’appuie sur des atouts différents pour optimiser la longueur et l’efficacité des prompts pour les LLM.
Nous allons les passer en revue, mais vous trouverez une approche plus exhaustive dans cet article : Efficient Prompting Methods for Large Language Models: A Survey. Dans la suite, nous l’appellerons « l’article de synthèse ».
La distillation des connaissances est une technique d’apprentissage automatique présentée pour la première fois par Hinton et al. (2015), où un modèle plus petit et plus simple (l’élève) est entraîné à reproduire le comportement d’un modèle plus grand et plus complexe (le professeur).
Initialement pensée pour réduire les coûts de calcul liés à l’entraînement d’ensembles de modèles, elle peut, en prompt engineering, servir à compresser le prompt plutôt que le modèle.
On y parvient en apprenant à compresser les « hard prompts » au sein des LLM via le soft prompt tuning. Pour des détails, voir les sections 3.1 et annexe A.1.1 de l’article de synthèse.
Les méthodes d’encodage transforment les textes d’entrée en vecteurs, ce qui réduit la longueur du prompt sans perdre d’informations critiques. Ces vecteurs capturent le sens essentiel du prompt et permettent aux LLM de traiter des entrées plus courtes efficacement.
Cependant, selon le langage d’encodage et le tokenizer, le nombre de tokens peut parfois augmenter. Par exemple, un encodage en Base64 peut générer davantage de tokens ; faites donc des tests préliminaires en fonction de votre cas d’usage.
Fait surprenant, certaines techniques d’encodage sont aussi utilisées pour le « jailbreaking » de modèles, consistant à contourner leurs mécanismes de sécurité. Pour en savoir plus, voir les sections 3.2 et annexe A.1.2 de l’article de synthèse.
Alors que les deux méthodes précédentes cherchent à compresser l’ensemble du prompt, les techniques de filtrage se concentrent sur l’élimination des éléments non nécessaires pour améliorer l’efficacité des LLM.
Elles évaluent l’information contenue dans les différentes parties d’un prompt et suppriment les redondances, car toutes les informations ne sont pas utiles aux LLM. Le filtrage peut se faire à plusieurs niveaux : phrases, segments ou tokens.
L’objectif est de ne conserver que les éléments les plus pertinents. Dans Selective Context de Li et al. (2023), les auteurs utilisent des métriques d’auto-information pour filtrer les redondances. Dans LLMLingua: Compressing Prompts for Accelerated Inference of Large Language Models, des chercheurs de Microsoft raffinent les prompts en composants clés et ajustent dynamiquement le taux de compression de chaque partie. Voir les sections 3.3 et annexe A.1.3 de l’article de synthèse.
Dans cette section, nous allons implémenter et tester l’algorithme Selective Context, très utilisé et considéré comme état de l’art. Si vous souhaitez uniquement le tester, vous n’avez rien à installer : il est déjà hébergé sur la plateforme HuggingFace.
Il existe d’autres techniques de compression répandues, comme Keep It Simple (KIS), SCLR et les algorithmes de la famille LLMLingua, mais nous ne pourrons pas les couvrir dans ce court article.
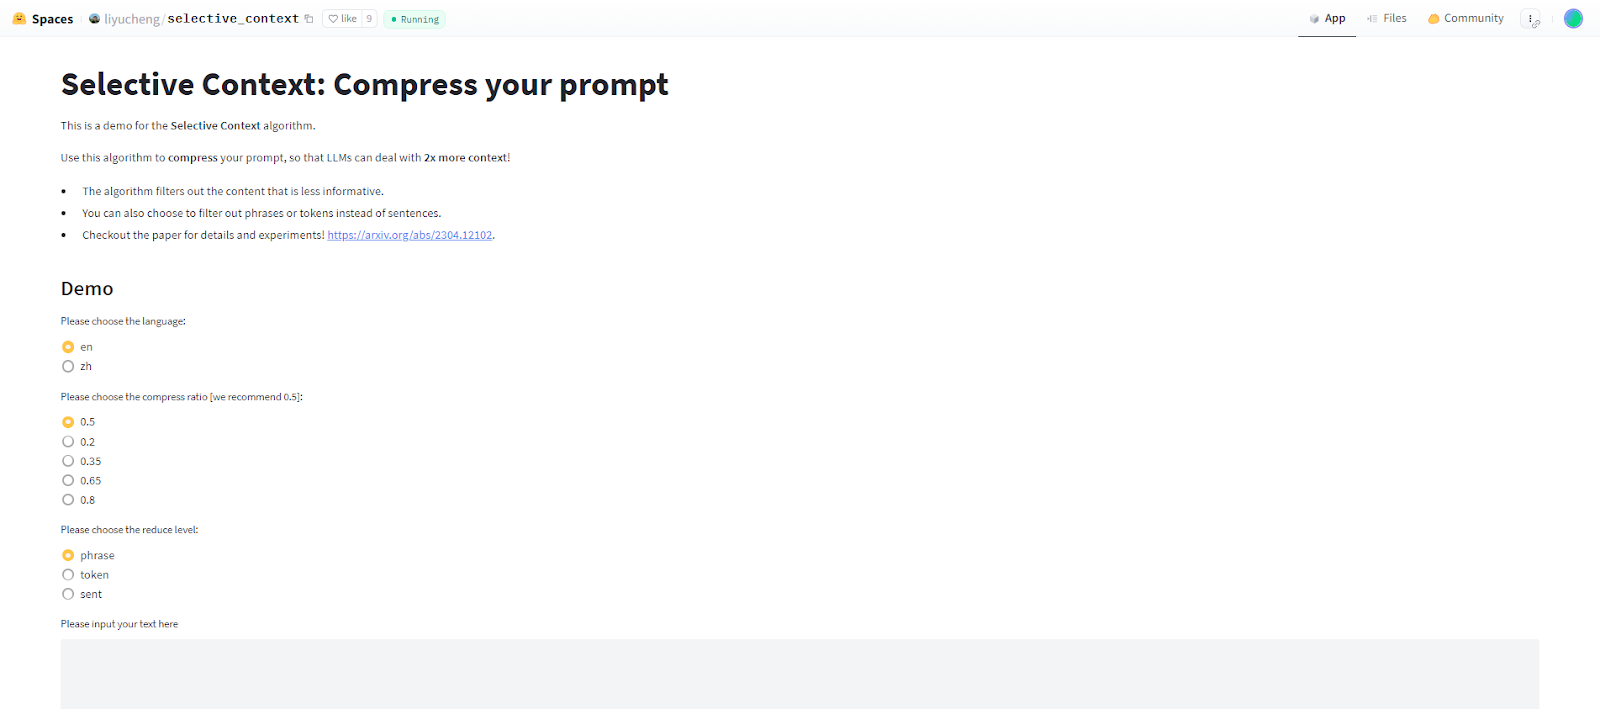
Dans l’application web Selective Context, vous pouvez choisir la langue du prompt à compresser (anglais ou chinois simplifié). Vous pouvez aussi définir le taux de compression et sélectionner si le filtrage s’applique aux phrases, aux tokens ou aux segments.
Passons maintenant à l’implémentation en Python. Nous testerons aussi quelques prompts compressés avec le modèle gpt-3.5-turbo-0125.
Commençons par installer les modules requis. Il faut installer la bibliothèque selective-context avec pip :
pip install selective-contextNous devons également télécharger le modèle en_core_web_sm de spacy avec la commande suivante :
python -m spacy download en_core_web_smInitialisons ensuite l’objet SelectiveContext. On peut choisir curie ou gpt-2 pour le modèle et en ou zh pour la langue. J’utiliserai gpt-2 dans cet exemple.
sc = SelectiveContext(model_type = ‘gpt-2’, lang = ‘en’)Ensuite, on peut appeler notre objet SelectiveContext sur le texte à compresser. Nous pouvons régler les paramètres reduce_ratio et reduce_level. reduce_level doit être l’un des suivants : ‘sent’, ‘phrase’ ou ‘token’. L’appel renvoie un tuple (context, reduced_content), où context est le prompt compressé et reduced_content la liste des phrases, segments ou tokens supprimés.
context, reduced_content = sc(text, reduce_ratio = 0.5, reduce_level = ‘sent’)Passons aux exemples. Je vais demander au modèle gpt-3.5-turbo-0125 de résumer la section « Quand utiliser la compression des prompts » de cet article. Puis nous compresserons cette section avec un taux de 0,5 en testant les trois niveaux : phrase, segment et token. Nous demanderons ensuite au modèle de résumer les versions compressées, puis nous comparerons le nombre de tokens de chaque prompt et la sortie du modèle.
Ci-dessous, voici l’appel d’API utilisé — nous ne changerons que la variable text dans la f-string. D’abord, nous demandons au modèle de résumer le paragraphe original non compressé :
from openai import OpenAI
client = OpenAI(api_key = key)
completion = client.chat.completions.create(
	model = “gpt-3.5-turbo-0125”,
	messages = [
{“role”: “user”, “content”: f”Summarize the following paragraph:\n {text}”}
]
)
En vérifiant completion.usage, on constate que le prompt original compte 304 tokens, et voici la sortie :
[Prompt compression is useful in scenarios such as advanced prompt engineering techniques and retrieval-augmented generation pipelines to reduce token counts and costs while preserving effectiveness and context. However, it is not a universal solution and should be used judiciously, as excessive compression can lead to a loss of important details. It is important to strike a balance between reducing size and maintaining the prompt's meaning.]Comme vous le voyez, le modèle a correctement résumé le paragraphe non compressé.
Essayons maintenant la version réduite au niveau des tokens. Le paragraphe compressé ressemble à ceci :
[When Should Prompt CompProm compression particularly following Advanced prompt engineering Techniques like chainofthought prompting while highly lengthy prompts reach thousands tokensThis increases processing costs and may exceed token limits of certain modelsProm compression mit these token count while prompt effectivenessRetri-au generationRAG pipelines R combine information retrieval text specialized chat contextual understandingThese pipelines frequently involve providing extensive conversation histories retrieved as prompts leading high token counts increased expensesProm compression essential such essential context while costsApplic prompt compression It prompt universal judFor instance assistant models like ChatGPT designed convers contexts benefit aggressive prompt compressionThese models often do charge per token integrated chat summar memory features conversation history effectively compression redundantIt even working models charge per token excessive compression could nuance importantSt reducing size maintaining prompt’s meaning is]Le prompt compte 162 tokens, et voici la synthèse du modèle :
[Prompt compression is recommended following advanced prompt engineering techniques like chain of thought prompting, especially when dealing with lengthy prompts that reach thousands of tokens. This helps reduce processing costs and ensure that the prompt remains effective for models like RAG pipelines, which involve extensive conversation histories. Prompt compression is essential for maintaining context while keeping costs low, particularly for models like ChatGPT that charge per token and benefit from aggressive compression. However, excessive compression could lead to loss of important nuances, so it is important to strike a balance between reducing size and maintaining the prompt's meaning.]Le paragraphe n’est pas résumé correctement. La nuance selon laquelle ChatGPT ne bénéficie pas d’une compression agressive a été perdue.
Essayons ensuite la réduction au niveau des phrases. Le prompt réduit compte 129 tokens :
[When Should We Use Prompt Compression? This increases processing times and costs and may exceed token limits of certain models. These pipelines frequently involve providing extensive conversation histories or retrieved documents as prompts, leading to high token counts and increased expenses. Prompt compression is essential in such cases to maintain essential context while minimizing costs. For instance, assistant models like ChatGPT, designed for conversational contexts, may not benefit from aggressive prompt compression. These models often do not charge per token and have integrated chat summarization and memory features to manage conversation history effectively, making compression redundant. ]Voici la synthèse du modèle :
[Prompt compression is necessary when processing times, costs, and token limits may be exceeded in pipelines involving extensive conversation histories or retrieved documents as prompts. However, for certain models like ChatGPT, designed for conversational contexts, aggressive prompt compression may not be beneficial as they already have features to manage conversation history effectively without the need for compression.]Cette synthèse ne contient pas d’erreurs, mais omet la discussion sur les pipelines RAG.
Enfin, testons la réduction au niveau des segments. Le prompt compte 183 tokens :
[When Should Prompt Compression Prompt compression particularly beneficial Advanced prompt engineering techniques Techniques like chainofthought prompting while highly lengthy prompts reach thousands tokens This increases processing costs and may exceed token limits of certain models Prompt compression these issues token count while the prompt's effectiveness Retrieval-augmented generation (RAG) pipelines RAG pipelines combine information retrieval text generation specialized chatbots contextual understanding These pipelines frequently involve providing extensive conversation histories or retrieved as prompts leading high token counts increased expenses Prompt compression essential such cases to maintain essential context while costs Applicability prompt compression It's For instance assistant models like ChatGPT designed conversational contexts may benefit aggressive prompt compression These models often do charge per token have integrated chat summarization memory features manage conversation history effectively making compression redundant It even working models charge per token excessive compression could nuance important details reducing size maintaining the prompt’s meaning is
]
Voici la synthèse du modèle :
[Prompt compression is beneficial in advanced prompt engineering techniques, such as chainofthought prompting, which can involve lengthy prompts reaching thousands of tokens. Retrieval-augmented generation (RAG) pipelines combine information retrieval and text generation in specialized chatbots, requiring extensive conversation histories or retrieved prompts leading to high token counts and increased expenses. Prompt compression is essential in maintaining context while managing costs in such cases. For instance, assistant models like ChatGPT, which are designed for conversational contexts, may benefit from aggressive prompt compression to effectively manage conversation history and reduce costs. However, excessive compression could compromise important details, so maintaining the prompt's meaning is crucial.]La synthèse est globalement correcte et cohérente. Toutefois, elle interprète à tort que ChatGPT tire parti d’une compression agressive.
En comparant le nombre de tokens et le contenu des synthèses du modèle selon les différents niveaux de compression, on observe l’impact de la compression sur le résultat :
|
Niveau de compression |
Nombre de tokens (304 pour l’original) |
Précision |
|
Au niveau des tokens |
162 |
Perte de nuances importantes sur l’absence de bénéfice pour ChatGPT d’une compression agressive, et erreurs. |
|
Au niveau des phrases |
129 |
Pas d’erreurs, mais contexte sur les pipelines RAG manquant. |
|
Au niveau des segments |
183 |
Comme au niveau token, indique à tort que ChatGPT bénéficie d’une compression agressive. |
Globalement, la compression des prompts permet de réduire sensiblement le nombre de tokens tout en préservant les idées principales. Toutefois, il est essentiel de trouver le bon compromis pour ne pas perdre de nuances et de contexte.
Cet exercice souligne la nécessité d’adapter finement le niveau de compression selon l’application et l’importance de préserver certains détails dans le prompt.
À noter : nous avons mené toutes les expériences avec un taux de compression de 0,5, relativement élevé. N’hésitez pas à expérimenter différents taux selon vos cas d’usage pour trouver l’équilibre optimal entre réduction de taille et intégrité du prompt.
La compression des prompts est une technique puissante pour optimiser l’efficacité et le coût des LLM. Nous avons vu ses fondamentaux, son importance, ses différentes approches et des éléments d’implémentation.
À mesure que l’IA générative évolue, rester au fait des dernières avancées est crucial. Pour renforcer vos compétences et votre compréhension de la compression des prompts et des techniques associées, nous vous invitons à consulter les articles de recherche cités ainsi que les billets de blog et cours suivants de DataCamp :
Approfondissez le prompt engineering !
Cours
Cours
Cours