Cara Menelusuri Gambar dan Teks Menggunakan MongoDB Vector Search dengan FastAPI
Bangun aplikasi vector search end-to-end dengan FastAPI dan MongoDB Atlas. Pelajari cara membuat, menyimpan, dan melakukan query embedding teks dan gambar dalam tutorial praktis ini.
Pencarian berbasis kata kunci bekerja baik untuk pencarian sederhana, tetapi cepat kewalahan saat kita peduli pada makna alih-alih kata yang persis sama. Jika satu dokumen menyebutkan “meningkatkan waktu respons” dan dokumen lain membahas “meningkatkan performa,” mesin pencari tradisional menganggapnya tidak terkait, meskipun keduanya menggambarkan gagasan yang sama. Kita kehilangan hubungan semantik hanya karena perumusannya berbeda.
Vector search mengatasi keterbatasan ini dengan merepresentasikan teks dan gambar sebagai embedding: vektor numerik yang dihasilkan oleh model pembelajaran mesin yang menangkap konteks, niat, dan kesamaan semantik. Setelah kita menyimpan embedding ini di MongoDB, kita bisa melakukan query untuk menemukan item yang benar-benar terkait, terlepas dari istilah yang digunakan.
Dalam tutorial ini, kita akan membangun contoh praktis end-to-end dari alur kerja ini menggunakan FastAPI dan MongoDB Atlas Vector Search. Kita akan membuat embedding teks menggunakan SentenceTransformers dan embedding gambar menggunakan model berbasis CLIP, menyimpan keduanya di MongoDB, dan menjalankan pencarian kemiripan lintas keduanya. Pada akhirnya, kita akan memiliki fondasi kerja yang dapat mendukung pencarian artikel semantik, rekomendasi produk, alat kemiripan visual, dan banyak aplikasi dunia nyata lainnya.
Dengan itu, mari kita mulai.
Prasyarat
Sebelum mulai membangun, kita perlu menyiapkan beberapa hal. Tutorial ini mengasumsikan Anda memiliki pemahaman dasar tentang Python, FastAPI, dan MongoDB, tetapi kita tidak akan bergantung pada hal-hal tingkat lanjut—semuanya akan diperkenalkan seiring berjalannya penjelasan.
Berikut yang kita perlukan:
Python 3.10+
Cluster MongoDB Atlas dengan Vector Search diaktifkan
Lingkungan FastAPI
Postman atau cURL
Akses internet untuk mengunduh dan membuat embedding model
Pustaka Python yang akan kita gunakan
Kita akan memasangnya sebagai bagian dari penyiapan:
FastAPI: kerangka kerja web kita
uvicorn: server pengembangan
pymongo: driver MongoDB
sentence-transformers: model embedding teks
open_clip: model embedding gambar berbasis CLIP
torch: diperlukan oleh CLIP dan SentenceTransformers
Pillow: dukungan pemrosesan gambar (PIL)
Perangkat ini memberi kita semua yang diperlukan untuk membuat embedding, menyimpannya di MongoDB, dan melakukan query secara efisien menggunakan vector search.
Memahami Vector Search
Sebelum mulai menulis kode, ada baiknya memahami apa yang sebenarnya terjadi di bawah alur kerja. Vector search tidak rumit setelah diurai, dan memahami dasarnya membuat sisa tutorial jauh lebih mudah diikuti.
Apa itu embedding?
Sebuah embedding hanyalah daftar angka (sebuah vektor) yang merepresentasikan makna dari suatu data.
Untuk teks, embedding menangkap hal-hal seperti konteks dan niat. Untuk gambar, embedding menangkap pola dan fitur visual.
Contoh embedding yang sangat disederhanakan terlihat seperti ini:
Dua hal yang secara semantik mirip—misalnya, dua kalimat yang menggambarkan ide yang sama, atau dua gambar dengan objek serupa—akan menghasilkan vektor yang secara matematis berdekatan. Vector search bekerja dengan mengukur kedekatan ini.
Bagaimana MongoDB menggunakan embedding
MongoDB sendiri tidak membuat embedding. Sebaliknya, MongoDB berfokus pada keahliannya:
Menyimpan vektor embedding
Mengindeksnya menggunakan indeks vektor
Mengambil tetangga terdekat secara efisien
Dengan kata lain, model kita membuat embedding, dan MongoDB menangani pencariannya.
Pemisahan yang rapi ini membuat sistem menjadi fleksibel dan dapat diskalakan.
Jenis-jenis model embedding
Kita dapat memilih model embedding apa pun, selama menghasilkan vektor numerik. Model yang berbeda mengkhususkan diri pada tipe data yang berbeda:
Jenis Data
Contoh Model
Catatan
Teks
all-MiniLM-L6-v2
Ringan dan banyak digunakan untuk NLP
Gambar
CLIP/OpenCLIP
Mengonversi gambar menjadi vektor semantik
Multimodal
Multimodal
Menangani teks dan gambar secara bersamaan
Inilah alur kerja yang akan kita terapkan menggunakan FastAPI dan MongoDB Atlas.
Setelah disiapkan, kita dapat menelusuri teks dan gambar berdasarkan makna—sesuatu yang tidak bisa dilakukan oleh pencarian kata kunci tradisional.
Menyiapkan MongoDB Atlas
Sebelum kita mulai membangun aplikasi FastAPI, kita memerlukan tempat untuk menyimpan dan melakukan query embedding. MongoDB Atlas membuatnya menjadi mudah, dan menyiapkan indeks vektor hanya membutuhkan beberapa menit.
1. Buat cluster
Jika Anda belum memilikinya, buat cluster baru di MongoDB Atlas. Cluster tingkat gratis (M0) sudah cukup untuk tutorial ini. Kunjungi dokumentasi MongoDB untuk detail selengkapnya tentang cara membuat cluster.
2. Buat database dan koleksi
Di dalam cluster:
Buat database. Kita akan menamainya vector_db. Untuk detail lebih lanjut, lihat dokumentasi.
Buat dua koleksi di dalamnya:
texts: tempat kita menyimpan dokumen teks dan embedding-nya
images: tempat kita menyimpan nama file gambar dan embedding gambar
Kita memisahkan koleksi gambar dan teks karena keduanya bergantung pada model embedding dan dimensi vektor yang berbeda.
3. Buat indeks vektor
MongoDB memerlukan indeks vektor untuk menjalankan pencarian kemiripan dengan cepat. Kita akan membuat satu indeks untuk embedding teks dan satu untuk embedding gambar.
Anda bisa membuatnya di Atlas → Collections → Search Indexes. Mari mulai menyiapkannya untuk koleksi teks.
Gambar berikut menjelaskan prosesnya dengan lebih baik.
Pada layar berikutnya, klik Vector Search ->JSON Editor -> Next. Gambar berikut akan membantu Anda memahami prosesnya lebih lanjut
Indeks vektor untuk teks
Di indeks vector search, ubah teks JSON agar sesuai dengan kode kita.
Kita menggunakan model all-MiniLM-L6-v2 untuk teks, yang menghasilkan embedding 384 dimensi.
Berikut definisi JSON-nya:
{"fields":[{"type":"vector","path":"embedding","numDimensions":384,"similarity":"cosine"}]}Didukung oleh
Beri nama indeks ini: vector_texts_searchdan simpan.
Ini memungkinkan MongoDB melakukan pencarian kemiripan cosine pada embedding teks. Gambar di bawah menggambarkan prosesnya lebih detail.
Indeks vektor untuk gambar
Untuk gambar, kita menggunakan model berbasis CLIP yang menghasilkan vektor 512 dimensi, jadi indeks gambar harus sesuai dengan dimensi tersebut. Definisi JSON harus cocok dengan kode di bawah. Selain itu, alur lainnya sama.
{"fields":[{"type":"vector","path":"embedding","numDimensions":512,"similarity":"cosine"}]}Didukung oleh
Beri nama indeks ini: vector_images_search.
Setelah kedua indeks aktif, MongoDB Atlas siap untuk query vector search.
Menyiapkan Proyek FastAPI
Sekarang cluster MongoDB Atlas dan indeks vektor kita sudah siap, kita bisa menyiapkan aplikasi FastAPI yang akan membuat embedding dan menyimpannya di MongoDB. Kita akan menjaga struktur proyek tetap kecil dan fokus karena tutorial ini bertujuan memahami alur kerja, bukan membangun layanan produksi penuh.
1. Pasang dependensi yang diperlukan
Kita akan memasang FastAPI, Uvicorn, driver Python MongoDB, dan pustaka yang diperlukan untuk membuat embedding teks dan gambar. Jalankan:
python-dotenv—memuat variabel lingkungan dari .env
sentence-transformers—model embedding teks
torch—diperlukan oleh model embedding
pillow—penanganan gambar dasar
open_clip_torch—model embedding gambar berbasis CLIP
python-multipart—diperlukan untuk mengunggah file melalui FastAPI
Setelah terpasang, kita siap menata proyek.
2. Struktur proyek
Kita akan menaruh semuanya dalam satu berkas Python, dengan konfigurasi ditangani melalui variabel lingkungan:
fastapi-mongodb-vector-search/
│── main.py
│── .env
│── venv/Didukung oleh
main.py akan memuat seluruh aplikasi: endpoint teks, endpoint gambar, dan koneksi MongoDB.
MONGODB_URI="your connection string"
DB_NAME="vector_db"
TEXT_COLLECTION="texts"
IMAGE_COLLECTION="images"Didukung oleh
MONGODB_URI—URI Atlas untuk cluster Anda
DB_NAME—database yang kita buat
TEXT_COLLECTION—tempat teks + embedding akan disimpan
IMAGE_COLLECTION—tempat embedding gambar akan disimpan
FastAPI akan memuat ini saat aplikasi mulai berjalan, menjaga konfigurasi terpisah dari kode.
Menerapkan Pencarian Teks
Dengan proyek FastAPI siap, kita bisa mulai membangun alur kerja pencarian teks. Bagian ini memperkenalkan ide inti di balik vector search: Kita membuat embedding untuk teks, menyimpannya di MongoDB, dan melakukan query menggunakan indeks vektor yang kita buat sebelumnya.
Kita akan membaginya menjadi dua langkah kecil agar semuanya mudah diuji dan di-debug seiring berjalannya proses.
a. Tambahkan teks dan buat embedding
Endpoint pertama akan menerima judul dan konten teks. Kita akan menggabungkan kedua bidang menjadi satu string, membuat embedding menggunakan SentenceTransformers, dan menyimpan dokumen bersama vektor embedding-nya.
Berikut tampilan kodenya:
# main.py (excerpt)from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from pymongo import MongoClient
from sentence_transformers import SentenceTransformer
from dotenv import load_dotenv
import os
load_dotenv()
app = FastAPI()# --- DB setup ---
client = MongoClient(os.getenv("MONGODB_URI"))
db = client[os.getenv("DB_NAME")]
texts_coll = db[os.getenv("TEXT_COLLECTION")]
Images_coll = db[os.getenv("IMAGE_COLLECTION")]# --- text embedding model ---
MODEL_NAME ="all-MiniLM-L6-v2"
text_model = SentenceTransformer(MODEL_NAME)# --- request schema ---classAddTextRequest(BaseModel):
title:str
content:str@app.post("/add-text")defadd_text(payload: AddTextRequest):try:# Combine fields for richer embeddings
text =f"{payload.title}\n\n{payload.content}"# Generate text embedding
embedding = text_model.encode(text).tolist()# Store document in MongoDB
doc ={"title": payload.title,"content": payload.content,"embedding": embedding,"model": MODEL_NAME,}
result = texts_coll.insert_one(doc)return{"inserted_id":str(result.inserted_id),"title": payload.title
}except Exception as e:raise HTTPException(status_code=500, detail=str(e))Didukung oleh
Cara menguji endpoint ini
cURL, Postman, dan alat pengujian API serupa dapat digunakan untuk menguji. Untuk tutorial ini, kita akan menguji menggunakan Postman.
Kita juga perlu mengekspos endpoint FastAPI kita ke internet agar bisa diuji menggunakan Postman di web. Kita akan menggunakan Ngrok untuk ini. Jika Anda baru dengan Ngrok, kunjungi dokumentasinya.U ntuk menguji, jalankan dulu kode FastAPI menggunakan perintah di bawah:
Ini akan menghasilkan URL untuk diuji, seperti pada gambar di bawah:
Kirim permintaan POST menggunakan Postman ke endpoint add-text. Gambar di bawah menggambarkan lebih lanjut proses pengiriman permintaan dan respons yang diharapkan.
Respons yang diharapkan:
{
  "inserted_id": "65f...",
  "title": "Why FastAPI is great."
}Didukung oleh
Ini mengonfirmasi model embedding Anda dimuat dengan benar, dan MongoDB menyimpan vektornya. Jika ini berhasil, pipa teks Anda berfungsi.
b. Menelusuri teks menggunakan vector search
Sekarang kita bisa menambahkan teks, langkah berikutnya adalah menelusurinya menggunakan tahapan $vectorSearch MongoDB. Di sini, kita:
Mengonversi kueri pengguna menjadi embedding.
Meminta MongoDB mengambil vektor terdekat.
Mengembalikan dokumen yang paling mirip.
Tambahkan endpoint berikut ke main.py:
classSearchTextRequest(BaseModel):
query:str
limit:int=5@app.post("/search-text")defsearch_text(payload: SearchTextRequest):try:# Convert search query to embedding
query_vector = text_model.encode(payload.query).tolist()# Vector search pipeline
pipeline =[{"$vectorSearch":{"queryVector": query_vector,"path":"embedding","numCandidates":100,"limit": payload.limit,"index":"vector_texts_search"# field MUST match the index name in Atlas exactly}},{"$project":{"title":1,"content":1,"score":{"$meta":"vectorSearchScore"},"_id":0}}]
results =list(texts_coll.aggregate(pipeline))return{"results": results}except Exception as e:raise HTTPException(status_code=500, detail=str(e))Didukung oleh
> Parameter numCandidates menentukan berapa banyak kandidat yang dievaluasi sebelum mengembalikan hasil teratas.
> Nilai yang lebih tinggi meningkatkan akurasi tetapi menambah waktu kueri. Aturan praktis yang baik adalah 10-20x dari limit Anda.
Cara menguji pencarian teks
Setelah menambahkan satu atau lebih dokumen, lakukan permintaan POST ke endpoint /search-text melalui Postman menggunakan tautan yang dihasilkan Ngrok, seperti pada gambar di bawah:
Keluaran yang diharapkan:
{
  "results": [
    {
      "title": "Why FastAPI is great",
      "content": "FastAPI makes building APIs simple and fast.",
      "score": 0.85
    }
  ]
}Didukung oleh
Jika Anda melihat hasil dengan skor kemiripan, maka pipa vector search teks Anda berfungsi dari ujung ke ujung. Setelah bagian ini berfungsi andal, kita siap beralih ke alur kerja gambar.
Menerapkan Pencarian Gambar
Setelah alur kerja teks berjalan lancar, kita bisa memperluas gagasan yang sama ke gambar. Alur keseluruhannya mirip—perbedaan utama adalah cara kita membuat embedding. Alih-alih SentenceTransformers, kita akan menggunakan model berbasis CLIP, yang dirancang untuk mengonversi gambar menjadi vektor 512 dimensi.
Sama seperti sebelumnya, kita akan menerapkannya selangkah demi selangkah agar mudah diuji dan di-debug.
a. Tambahkan gambar dan buat embedding
Endpoint ini menerima berkas gambar yang diunggah, mengonversinya menjadi tensor yang dapat dipahami CLIP, membuat embedding 512 dimensi, dan menyimpannya di MongoDB.
Berikut tampilannya:
# --- CLIP model setup ---import torch
import open_clip
from PIL import Image
import io
from fastapi import UploadFile, File
# Load CLIP model once when the app starts
clip_model, _, preprocess = open_clip.create_model_and_transforms("ViT-B-32",
pretrained="openai")
device ="cuda"if torch.cuda.is_available()else"cpu"
clip_model.to(device)@app.post("/add-image")asyncdefadd_image(file: UploadFile = File(...)):"""
Upload an image, generate its CLIP embedding, and store in MongoDB.
"""try:# Read file contents
image_bytes =awaitfile.read()
image = Image.open(io.BytesIO(image_bytes)).convert("RGB")# Preprocess for CLIP and encode
image_tensor = preprocess(image).unsqueeze(0).to(device)with torch.no_grad():
image_embedding = clip_model.encode_image(image_tensor)# Normalize the embedding (important for cosine similarity)
image_embedding /= image_embedding.norm(dim=-1, keepdim=True)
vector = image_embedding.cpu().numpy().flatten().tolist()# Store in MongoDB
doc ={"filename":file.filename,"embedding": vector
}
result = images_coll.insert_one(doc)return{"inserted_id":str(result.inserted_id),"filename":file.filename
}except Exception as e:raise HTTPException(status_code=500, detail=str(e))Didukung oleh
Mengapa normalisasi penting
Embedding CLIP bekerja paling baik dengan cosine similarity. Untuk membuat perbandingan akurat dan stabil, kita menormalisasi vektornya:
image_embedding /= image_embedding.norm(dim=-1, keepdim=True)Didukung oleh
Ini memastikan bahwa jarak cosine mencerminkan kemiripan yang sebenarnya.
Uji endpoint unggah gambar
Untuk menguji fitur ini di Postman, buat permintaan POST ke endpoint /add-image. Kirim form-data sebagai body permintaan dengan gambar jenis .jpg atau .png. Gambar di bawah memperlihatkan prosesnya.
Jika semuanya berfungsi, Anda akan mendapatkan sesuatu seperti:
{
  "inserted_id": "692454f6156fbb762ed865a0",
  "filename": "file-name.png"
}Didukung oleh
Pada titik ini, embedding gambar Anda berhasil disimpan di MongoDB.
b. Menelusuri gambar menggunakan vector search
Sekarang, kita bisa membangun endpoint yang menerima gambar kueri yang diunggah, mengonversinya menjadi embedding, dan menemukan gambar tersimpan yang paling dekat menggunakan indeks vektor gambar kita.
@app.post("/search-image")asyncdefsearch_image(file: UploadFile = File(...)):"""
Upload an image and find the most visually similar images in MongoDB.
"""try:# Read the uploaded file
image_bytes =awaitfile.read()
image = Image.open(io.BytesIO(image_bytes)).convert("RGB")# Generate embedding for the query image
image_tensor = preprocess(image).unsqueeze(0).to(device)with torch.no_grad():
query_embedding = clip_model.encode_image(image_tensor)
query_embedding /= query_embedding.norm(dim=-1, keepdim=True)
query_vector = query_embedding.cpu().numpy().flatten().tolist()# Vector search pipeline
pipeline =[{"$vectorSearch":{"queryVector": query_vector,"path":"embedding","numCandidates":100,"limit":5,"index":"vector_images_search"}},{"$project":{"filename":1,"score":{"$meta":"vectorSearchScore"},"_id":0}}]
results =list(images_coll.aggregate(pipeline))return{"results": results}except Exception as e:raise HTTPException(status_code=500, detail=str(e))Didukung oleh
Uji endpoint pencarian gambar
Untuk menguji fitur ini di Postman, buat permintaan POST ke endpoint /search-image. Kirim form data sebagai body permintaan dengan gambar apa pun yang mirip dengan yang Anda simpan sebelumnya. Gambar di bawah memperlihatkan prosesnya.
Keluaran yang diharapkan terlihat seperti:
{"results":[{"filename":"image1.png","score":1.0},{"filename":"image2.png","score":0.81}]}Didukung oleh
Skor 1,0 berarti cocok dengan gambar yang persis sama. Nilai yang mendekati (0,7–0,9) menunjukkan kemiripan visual yang kuat.
Jika Anda melihat array dengan hasil, vector search gambar Anda kini berfungsi.
Pada titik ini, jika semuanya berfungsi, kita memiliki sistem pencarian semantik lengkap yang bekerja untuk teks dan gambar.
Kesimpulan
Dalam tutorial ini, kita membangun alur kerja pencarian semantik lengkap menggunakan FastAPI dan MongoDB Atlas. Kita membuat embedding teks dengan SentenceTransformers, membuat embedding gambar dengan model CLIP, menyimpan semuanya di MongoDB, dan melakukan query menggunakan Vector Search MongoDB dan Postman. Pola ini menjadi fondasi bagi aplikasi seperti pencarian dokumen semantik, alat kemiripan gambar, sistem rekomendasi, dan fitur AI multimodal.
Yang membuat arsitektur ini kuat adalah fleksibilitasnya: MongoDB tidak mengunci Anda pada model tertentu. Selama embedding berupa vektor numerik dan dimensinya sesuai dengan konfigurasi indeks Anda, Anda dapat memasangkan model embedding teks, gambar, atau multimodal apa pun yang diperlukan kasus penggunaan Anda.
Dengan fondasi ini, Anda dapat memperluas proyek lebih jauh—menyimpan metadata, membangun logika pemeringkatan, atau mengintegrasikannya dengan aplikasi untuk pengguna. Alur kerja yang sama juga dapat diskalakan dengan mudah menggunakan layanan terkelola sepenuhnya dari MongoDB Atlas.
Anda dapat menemukan proyek lengkap yang berfungsi di GitHub.
Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.


 David Woods · 13 min

 Dario Radečić · 15 min

 Hugo Bowne-Anderson · 13 min


Pencarian berbasis kata kunci bekerja baik untuk pencarian sederhana, tetapi cepat kewalahan saat kita peduli pada makna alih-alih kata yang persis sama. Jika satu dokumen menyebutkan “meningkatkan waktu respons” dan dokumen lain membahas “meningkatkan performa,” mesin pencari tradisional menganggapnya tidak terkait, meskipun keduanya menggambarkan gagasan yang sama. Kita kehilangan hubungan semantik hanya karena perumusannya berbeda.
Vector search mengatasi keterbatasan ini dengan merepresentasikan teks dan gambar sebagai embedding: vektor numerik yang dihasilkan oleh model pembelajaran mesin yang menangkap konteks, niat, dan kesamaan semantik. Setelah kita menyimpan embedding ini di MongoDB, kita bisa melakukan query untuk menemukan item yang benar-benar terkait, terlepas dari istilah yang digunakan.
Dalam tutorial ini, kita akan membangun contoh praktis end-to-end dari alur kerja ini menggunakan FastAPI dan MongoDB Atlas Vector Search. Kita akan membuat embedding teks menggunakan SentenceTransformers dan embedding gambar menggunakan model berbasis CLIP, menyimpan keduanya di MongoDB, dan menjalankan pencarian kemiripan lintas keduanya. Pada akhirnya, kita akan memiliki fondasi kerja yang dapat mendukung pencarian artikel semantik, rekomendasi produk, alat kemiripan visual, dan banyak aplikasi dunia nyata lainnya.
Dengan itu, mari kita mulai.
Prasyarat
Sebelum mulai membangun, kita perlu menyiapkan beberapa hal. Tutorial ini mengasumsikan Anda memiliki pemahaman dasar tentang Python, FastAPI, dan MongoDB, tetapi kita tidak akan bergantung pada hal-hal tingkat lanjut—semuanya akan diperkenalkan seiring berjalannya penjelasan.
Berikut yang kita perlukan:
Pustaka Python yang akan kita gunakan
Kita akan memasangnya sebagai bagian dari penyiapan:
Perangkat ini memberi kita semua yang diperlukan untuk membuat embedding, menyimpannya di MongoDB, dan melakukan query secara efisien menggunakan vector search.
Memahami Vector Search
Sebelum mulai menulis kode, ada baiknya memahami apa yang sebenarnya terjadi di bawah alur kerja. Vector search tidak rumit setelah diurai, dan memahami dasarnya membuat sisa tutorial jauh lebih mudah diikuti.
Apa itu embedding?
Sebuah embedding hanyalah daftar angka (sebuah vektor) yang merepresentasikan makna dari suatu data.
Untuk teks, embedding menangkap hal-hal seperti konteks dan niat. Untuk gambar, embedding menangkap pola dan fitur visual.
Contoh embedding yang sangat disederhanakan terlihat seperti ini:
Dua hal yang secara semantik mirip—misalnya, dua kalimat yang menggambarkan ide yang sama, atau dua gambar dengan objek serupa—akan menghasilkan vektor yang secara matematis berdekatan. Vector search bekerja dengan mengukur kedekatan ini.
Bagaimana MongoDB menggunakan embedding
MongoDB sendiri tidak membuat embedding. Sebaliknya, MongoDB berfokus pada keahliannya:
Dengan kata lain, model kita membuat embedding, dan MongoDB menangani pencariannya.
Pemisahan yang rapi ini membuat sistem menjadi fleksibel dan dapat diskalakan.
Jenis-jenis model embedding
Kita dapat memilih model embedding apa pun, selama menghasilkan vektor numerik. Model yang berbeda mengkhususkan diri pada tipe data yang berbeda:
Jenis Data
Contoh Model
Catatan
Teks
all-MiniLM-L6-v2Ringan dan banyak digunakan untuk NLP
Gambar
CLIP/OpenCLIP
Mengonversi gambar menjadi vektor semantik
Multimodal
Multimodal
Menangani teks dan gambar secara bersamaan
Inilah alur kerja yang akan kita terapkan menggunakan FastAPI dan MongoDB Atlas.
Setelah disiapkan, kita dapat menelusuri teks dan gambar berdasarkan makna—sesuatu yang tidak bisa dilakukan oleh pencarian kata kunci tradisional.
Menyiapkan MongoDB Atlas
Sebelum kita mulai membangun aplikasi FastAPI, kita memerlukan tempat untuk menyimpan dan melakukan query embedding. MongoDB Atlas membuatnya menjadi mudah, dan menyiapkan indeks vektor hanya membutuhkan beberapa menit.
1. Buat cluster
Jika Anda belum memilikinya, buat cluster baru di MongoDB Atlas. Cluster tingkat gratis (M0) sudah cukup untuk tutorial ini. Kunjungi dokumentasi MongoDB untuk detail selengkapnya tentang cara membuat cluster.
2. Buat database dan koleksi
Di dalam cluster:
vector_db. Untuk detail lebih lanjut, lihat dokumentasi.texts: tempat kita menyimpan dokumen teks dan embedding-nyaimages: tempat kita menyimpan nama file gambar dan embedding gambarKunjungi dokumentasi untuk detail lebih lanjut tentang cara membuat koleksi.
Kita memisahkan koleksi gambar dan teks karena keduanya bergantung pada model embedding dan dimensi vektor yang berbeda.
3. Buat indeks vektor
MongoDB memerlukan indeks vektor untuk menjalankan pencarian kemiripan dengan cepat. Kita akan membuat satu indeks untuk embedding teks dan satu untuk embedding gambar.
Anda bisa membuatnya di Atlas → Collections → Search Indexes. Mari mulai menyiapkannya untuk koleksi teks.
Gambar berikut menjelaskan prosesnya dengan lebih baik.
Pada layar berikutnya, klik Vector Search ->JSON Editor -> Next. Gambar berikut akan membantu Anda memahami prosesnya lebih lanjut
Indeks vektor untuk teks
Di indeks vector search, ubah teks JSON agar sesuai dengan kode kita.
Kita menggunakan model
all-MiniLM-L6-v2untuk teks, yang menghasilkan embedding 384 dimensi.Berikut definisi JSON-nya:
Beri nama indeks ini:
vector_texts_searchdan simpan.Ini memungkinkan MongoDB melakukan pencarian kemiripan cosine pada embedding teks. Gambar di bawah menggambarkan prosesnya lebih detail.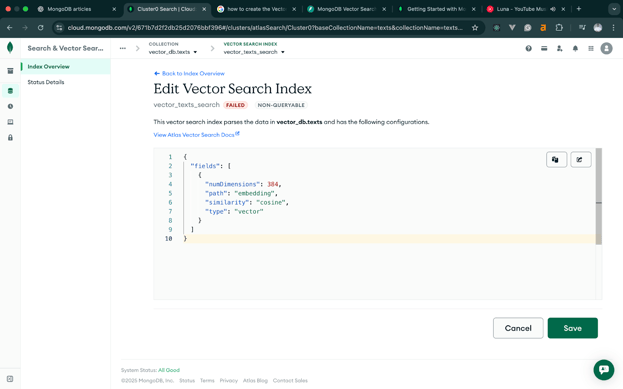
Indeks vektor untuk gambar
Untuk gambar, kita menggunakan model berbasis CLIP yang menghasilkan vektor 512 dimensi, jadi indeks gambar harus sesuai dengan dimensi tersebut. Definisi JSON harus cocok dengan kode di bawah. Selain itu, alur lainnya sama.
Beri nama indeks ini:
vector_images_search.Setelah kedua indeks aktif, MongoDB Atlas siap untuk query vector search.
Menyiapkan Proyek FastAPI
Sekarang cluster MongoDB Atlas dan indeks vektor kita sudah siap, kita bisa menyiapkan aplikasi FastAPI yang akan membuat embedding dan menyimpannya di MongoDB. Kita akan menjaga struktur proyek tetap kecil dan fokus karena tutorial ini bertujuan memahami alur kerja, bukan membangun layanan produksi penuh.
1. Pasang dependensi yang diperlukan
Kita akan memasang FastAPI, Uvicorn, driver Python MongoDB, dan pustaka yang diperlukan untuk membuat embedding teks dan gambar. Jalankan:
Sekilas alasan kita memerlukannya:
.envSetelah terpasang, kita siap menata proyek.
2. Struktur proyek
Kita akan menaruh semuanya dalam satu berkas Python, dengan konfigurasi ditangani melalui variabel lingkungan:
main.py akan memuat seluruh aplikasi: endpoint teks, endpoint gambar, dan koneksi MongoDB.
FastAPI akan memuat ini saat aplikasi mulai berjalan, menjaga konfigurasi terpisah dari kode.
Menerapkan Pencarian Teks
Dengan proyek FastAPI siap, kita bisa mulai membangun alur kerja pencarian teks. Bagian ini memperkenalkan ide inti di balik vector search: Kita membuat embedding untuk teks, menyimpannya di MongoDB, dan melakukan query menggunakan indeks vektor yang kita buat sebelumnya.
Kita akan membaginya menjadi dua langkah kecil agar semuanya mudah diuji dan di-debug seiring berjalannya proses.
a. Tambahkan teks dan buat embedding
Endpoint pertama akan menerima judul dan konten teks. Kita akan menggabungkan kedua bidang menjadi satu string, membuat embedding menggunakan SentenceTransformers, dan menyimpan dokumen bersama vektor embedding-nya.
Berikut tampilan kodenya:
Cara menguji endpoint ini
cURL, Postman, dan alat pengujian API serupa dapat digunakan untuk menguji. Untuk tutorial ini, kita akan menguji menggunakan Postman.
Kita juga perlu mengekspos endpoint FastAPI kita ke internet agar bisa diuji menggunakan Postman di web. Kita akan menggunakan Ngrok untuk ini. Jika Anda baru dengan Ngrok, kunjungi dokumentasinya.U ntuk menguji, jalankan dulu kode FastAPI menggunakan perintah di bawah:
Lalu, terowongkan
localhostAnda ke internet menggunakan perintah Ngrok di bawah:Ini akan menghasilkan URL untuk diuji, seperti pada gambar di bawah:
Kirim permintaan
POSTmenggunakan Postman ke endpointadd-text. Gambar di bawah menggambarkan lebih lanjut proses pengiriman permintaan dan respons yang diharapkan.Respons yang diharapkan:
Ini mengonfirmasi model embedding Anda dimuat dengan benar, dan MongoDB menyimpan vektornya. Jika ini berhasil, pipa teks Anda berfungsi.
b. Menelusuri teks menggunakan vector search
Sekarang kita bisa menambahkan teks, langkah berikutnya adalah menelusurinya menggunakan tahapan $vectorSearch MongoDB. Di sini, kita:
Tambahkan endpoint berikut ke
main.py:> Parameter numCandidates menentukan berapa banyak kandidat yang dievaluasi sebelum mengembalikan hasil teratas.
> Nilai yang lebih tinggi meningkatkan akurasi tetapi menambah waktu kueri. Aturan praktis yang baik adalah 10-20x dari limit Anda.
Cara menguji pencarian teks
Setelah menambahkan satu atau lebih dokumen, lakukan permintaan POST ke endpoint
/search-textmelalui Postman menggunakan tautan yang dihasilkan Ngrok, seperti pada gambar di bawah:Keluaran yang diharapkan:
Jika Anda melihat hasil dengan skor kemiripan, maka pipa vector search teks Anda berfungsi dari ujung ke ujung. Setelah bagian ini berfungsi andal, kita siap beralih ke alur kerja gambar.
Menerapkan Pencarian Gambar
Setelah alur kerja teks berjalan lancar, kita bisa memperluas gagasan yang sama ke gambar. Alur keseluruhannya mirip—perbedaan utama adalah cara kita membuat embedding. Alih-alih SentenceTransformers, kita akan menggunakan model berbasis CLIP, yang dirancang untuk mengonversi gambar menjadi vektor 512 dimensi.
Sama seperti sebelumnya, kita akan menerapkannya selangkah demi selangkah agar mudah diuji dan di-debug.
a. Tambahkan gambar dan buat embedding
Endpoint ini menerima berkas gambar yang diunggah, mengonversinya menjadi tensor yang dapat dipahami CLIP, membuat embedding 512 dimensi, dan menyimpannya di MongoDB.
Berikut tampilannya:
Mengapa normalisasi penting
Embedding CLIP bekerja paling baik dengan cosine similarity. Untuk membuat perbandingan akurat dan stabil, kita menormalisasi vektornya:
Ini memastikan bahwa jarak cosine mencerminkan kemiripan yang sebenarnya.
Uji endpoint unggah gambar
Untuk menguji fitur ini di Postman, buat permintaan
POSTke endpoint/add-image. Kirim form-data sebagai body permintaan dengan gambar jenis.jpgatau.png. Gambar di bawah memperlihatkan prosesnya.Jika semuanya berfungsi, Anda akan mendapatkan sesuatu seperti:
Pada titik ini, embedding gambar Anda berhasil disimpan di MongoDB.
b. Menelusuri gambar menggunakan vector search
Sekarang, kita bisa membangun endpoint yang menerima gambar kueri yang diunggah, mengonversinya menjadi embedding, dan menemukan gambar tersimpan yang paling dekat menggunakan indeks vektor gambar kita.
Tambahkan ini ke
main.py:Uji endpoint pencarian gambar
Untuk menguji fitur ini di Postman, buat permintaan
POSTke endpoint/search-image. Kirim form data sebagai body permintaan dengan gambar apa pun yang mirip dengan yang Anda simpan sebelumnya. Gambar di bawah memperlihatkan prosesnya.Keluaran yang diharapkan terlihat seperti:
Skor 1,0 berarti cocok dengan gambar yang persis sama. Nilai yang mendekati (0,7–0,9) menunjukkan kemiripan visual yang kuat.
Jika Anda melihat array dengan hasil, vector search gambar Anda kini berfungsi.
Pada titik ini, jika semuanya berfungsi, kita memiliki sistem pencarian semantik lengkap yang bekerja untuk teks dan gambar.
Kesimpulan
Dalam tutorial ini, kita membangun alur kerja pencarian semantik lengkap menggunakan FastAPI dan MongoDB Atlas. Kita membuat embedding teks dengan SentenceTransformers, membuat embedding gambar dengan model CLIP, menyimpan semuanya di MongoDB, dan melakukan query menggunakan Vector Search MongoDB dan Postman. Pola ini menjadi fondasi bagi aplikasi seperti pencarian dokumen semantik, alat kemiripan gambar, sistem rekomendasi, dan fitur AI multimodal.
Yang membuat arsitektur ini kuat adalah fleksibilitasnya: MongoDB tidak mengunci Anda pada model tertentu. Selama embedding berupa vektor numerik dan dimensinya sesuai dengan konfigurasi indeks Anda, Anda dapat memasangkan model embedding teks, gambar, atau multimodal apa pun yang diperlukan kasus penggunaan Anda.
Dengan fondasi ini, Anda dapat memperluas proyek lebih jauh—menyimpan metadata, membangun logika pemeringkatan, atau mengintegrasikannya dengan aplikasi untuk pengguna. Alur kerja yang sama juga dapat diskalakan dengan mudah menggunakan layanan terkelola sepenuhnya dari MongoDB Atlas.
Anda dapat menemukan proyek lengkap yang berfungsi di GitHub.