基于关键词的搜索在简单查询中表现不错,但当我们更关心“含义”而非“措辞”时就会失效。如果一篇文档提到“提升响应时间”,另一篇谈到“改进性能”,传统搜索引擎会将它们视为不相关,尽管它们描述的是同一个想法。仅仅因为措辞不同,我们就失去了语义联系。
向量搜索通过将文本和图像表示为 嵌入向量(embeddings) 来解决这一限制:它们是由机器学习模型生成的数值向量,能够捕捉上下文、意图和语义相似性。一旦我们将这些嵌入向量存入 MongoDB,就可以查询它们以找到真正相关的项,而不受具体用词的限制。
在本教程中,我们将使用 FastAPI 和 MongoDB Atlas Vector Search 构建一个端到端的实用示例。我们将用 SentenceTransformers 生成文本嵌入向量,用基于 CLIP 的模型生成图像嵌入向量,将二者都存入 MongoDB,并在其上运行相似度搜索。到最后,您将拥有一个可用于语义文章搜索、产品推荐、视觉相似度工具以及众多真实场景的工作基础。
话不多说,我们开始吧。
先决条件
在动手之前,我们需要准备一些东西。本教程假设您对 Python、FastAPI 和 MongoDB 有基础了解,但不会依赖高级知识——我们会在过程中逐步介绍所用到的一切。
我们需要:
Python 3.10+ 启用 Vector Search 的 MongoDB Atlas 集群 FastAPI 运行环境 Postman 或 cURL 可联网以下载与使用嵌入模型
我们将使用的 Python 库
我们会在设置过程中安装以下库:
FastAPI :Web 框架 uvicorn :开发服务器 pymongo :MongoDB 驱动 sentence-transformers :文本嵌入模型 open_clip :基于 CLIP 的图像嵌入模型 torch :CLIP 与 SentenceTransformers 依赖 Pillow :图像处理支持(PIL)
这些工具为我们提供了生成嵌入向量、将其存入 MongoDB,并使用向量搜索高效查询的一切所需。
理解向量搜索
在开始写代码前,先了解流程背后发生了什么会有所帮助。向量搜索 并不复杂,把它分解开来就更容易。本质理解清楚后,后续教程会更易于跟进。
什么是嵌入向量?
所谓 嵌入(embedding) ,就是用一串数字(一个向量)来表示一段数据的含义。
对文本而言,嵌入向量捕捉上下文与意图;对图像而言,它捕捉视觉模式与特征。
一个高度简化的嵌入示例如下:
[ 0.21 , - 0.17 , 0.89 , . . . ] 技术支持 语义相近的两样东西——比如描述相同想法的两句话,或包含相似目标物的两张图像——最终会得到在数学上彼此接近的向量。向量搜索的原理就是衡量这种“接近程度”。
MongoDB 如何使用嵌入向量
MongoDB 本身 不 生成嵌入向量。它专注于自己最擅长的事情:
存储嵌入向量 使用 向量索引 为其建立索引 高效检索最近邻
换句话说, 由我们的模型生成嵌入向量,MongoDB 负责搜索。
这种清晰的分工让系统既灵活又可扩展。
嵌入模型的类型
只要能输出数值向量,我们可以选择任何偏好的嵌入模型。不同模型擅长处理不同类型的数据:
数据类型
示例模型
说明
文本
all-MiniLM-L6-v2
轻量,广泛用于 NLP
图像
CLIP/OpenCLIP
将图像转换为语义向量
多模态
Multimodal
同时处理文本与图像
这就是我们将用 FastAPI 和 MongoDB Atlas 实现的工作流。
设置完成后,我们就能按“含义”来搜索文本和图像——这是传统关键词搜索做不到的。
设置 MongoDB Atlas
在开始构建 FastAPI 应用之前,我们需要一个地方来存储和查询嵌入向量。 MongoDB Atlas 使这一过程变得简单,创建向量索引只需几分钟。
1. 创建集群
如果您还没有,可以在 MongoDB Atlas 中创建一个新集群。免费层(M0)集群完全适用于本教程。有关 如何创建集群 的更多详情,请访问 MongoDB 文档。
2. 创建数据库和集合
在集群内:
创建数据库。我们将其命名为 vector_db。有关更多详情,请参阅 文档 。 在其中创建两个集合:
texts :用于存储文本文档及其嵌入向量 images :用于存储图像文件名和图像嵌入向量
有关 如何创建集合 ,请参阅文档。
我们将图像集合与文本集合分开,是因为它们依赖不同的嵌入模型和不同的向量维度。
3. 创建向量索引
MongoDB 需要向量索引来运行快速的相似度搜索。我们将为文本嵌入向量和图像嵌入向量各创建一个索引。
您可以在 Atlas → Collections → Search Indexes 中创建。我们先为文本集合进行设置。
下面的图片更直观地解释了流程。
在下一屏,点击 Vector Search ->JSON Editor -> Next 。下图可帮助您更好地理解流程。
文本向量索引 在向量搜索索引中,修改 JSON 文本以匹配我们的代码。
我们使用 all-MiniLM-L6-v2 文本模型,它会生成 384 维 的嵌入向量。
以下是 JSON 定义:
{
"fields" : [
{
"type" : "vector" ,
"path" : "embedding" ,
"numDimensions" : 384 ,
"similarity" : "cosine"
}
]
} 技术支持 给该索引命名为: vector_texts_search 并保存。
这使 MongoDB 能够在文本嵌入向量间执行余弦相似度搜索。下图更详细地展示了该过程。
图像向量索引 对于图像,我们使用基于 CLIP 的模型,输出 512 维 的向量,因此图像索引需要匹配该维度。JSON 定义应与下方代码一致。除此之外,其余流程相同。
{
"fields" : [
{
"type" : "vector" ,
"path" : "embedding" ,
"numDimensions" : 512 ,
"similarity" : "cosine"
}
]
} 技术支持 将该索引命名为: vector_images_search 。
当两个索引都变为激活状态后,MongoDB Atlas 即可处理向量搜索查询。
设置 FastAPI 项目
既然我们的 MongoDB Atlas 集群和向量索引都已就绪,就可以设置 FastAPI 应用来生成嵌入向量并将其存入 MongoDB。我们会保持项目结构小而精,重点在于理解工作流,而不是构建完整的生产服务。
1. 安装所需依赖
我们将安装 FastAPI、Uvicorn、MongoDB 的 Python 驱动,以及用于生成文本与图像嵌入向量的库。运行:
pip install fastapi uvicorn pymongo python- dotenv sentence- transformers torch pillow open_clip_torch python- multipart技术支持 简单说明这些库的用途:
fastapi ——我们的 API 框架 uvicorn ——用于运行 FastAPI 的 ASGI 服务器 pymongo ——MongoDB 驱动 python-dotenv ——从 .env 加载环境变量 sentence-transformers ——文本嵌入模型 torch ——嵌入模型依赖 pillow ——基础图像处理 open_clip_torch ——基于 CLIP 的图像嵌入模型 python-multipart ——通过 FastAPI 上传文件所需
安装完成后,我们就可以开始规划项目了。
2. 项目结构
我们将把所有内容放在一个 Python 文件中,配置通过环境变量管理:
fastapi-mongodb-vector-search/
│── main.py
│── .env
│── venv/技术支持
main.py 将包含整个应用:文本端点、图像端点以及 MongoDB 连接。
MONGODB_URI="your connection string"
DB_NAME="vector_db"
TEXT_COLLECTION="texts"
IMAGE_COLLECTION="images"技术支持
MONGODB_URI ——您集群的 Atlas URI DB_NAME ——我们创建的数据库 TEXT_COLLECTION ——存储文本及其嵌入向量的位置 IMAGE_COLLECTION ——存储图像嵌入向量的位置
FastAPI 在应用启动时会加载这些变量,使配置与代码分离。
实现文本搜索
FastAPI 项目就绪后,我们先构建文本搜索流程。这部分体现了向量搜索的核心思想:为文本生成嵌入向量,将其存入 MongoDB,并使用之前创建的向量索引进行查询。
我们分两小步来实现,便于一路测试和调试。
a. 添加文本并生成嵌入向量
第一个端点将接收标题和正文内容。我们会将两者合并为一个字符串,使用 SentenceTransformers 生成嵌入向量,并将文档与向量一同保存。
代码如下:
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from pymongo import MongoClient
from sentence_transformers import SentenceTransformer
from dotenv import load_dotenv
import os
load_dotenv( )
app = FastAPI( )
client = MongoClient( os. getenv( "MONGODB_URI" ) )
db = client[ os. getenv( "DB_NAME" ) ]
texts_coll = db[ os. getenv( "TEXT_COLLECTION" ) ]
Images_coll = db[ os. getenv( "IMAGE_COLLECTION" ) ]
MODEL_NAME = "all-MiniLM-L6-v2"
text_model = SentenceTransformer( MODEL_NAME)
class AddTextRequest ( BaseModel) :
title: str
content: str
@app. post ( "/add-text" )
def add_text ( payload: AddTextRequest) :
try :
text = f" { payload. title} \n\n { payload. content} " = text_model. encode( text) . tolist( )
doc = {
"title" : payload. title,
"content" : payload. content,
"embedding" : embedding,
"model" : MODEL_NAME,
}
result = texts_coll. insert_one( doc)
return {
"inserted_id" : str ( result. inserted_id) ,
"title" : payload. title
}
except Exception as e:
raise HTTPException( status_code= 500 , detail= str ( e) ) 技术支持 如何测试该端点
可以使用 cURL、Postman 等 API 测试工具。在本教程中,我们将使用 Postman 测试。
我们还需要将 FastAPI 端点暴露到公网,以便通过 Web 版 Postman 测试。这里使用 Ngrok。如果您是 Ngrok 新手,请 查看文档 。测试前,先用下方命令运行 FastAPI 代码:
uvicorn main:app --reload技术支持 然后,使用以下 Ngrok 命令将 localhost 隧道到公网:
Ngrok http 8000 技术支持 这会生成一个可用于测试的 URL,如下图所示:
使用 Postman 向 add-text 端点发送 POST 请求。下图进一步展示了发送请求及期望响应的过程。
期望的响应:
{
  "inserted_id": "65f...",
  "title": "Why FastAPI is great."
}技术支持
这表明您的嵌入模型已正确加载,MongoDB 也已存储了向量。如果上述步骤成功,文本处理链路就正常运行了。
b. 使用向量搜索检索文本
现在我们可以添加文本了,下一步是使用 MongoDB 的 $vectorSearch 阶段进行搜索。 这里我们会:
将用户查询转换为嵌入向量。 让 MongoDB 检索最近向量。 返回最相似的文档。
将以下端点添加到 main.py 中:
class SearchTextRequest ( BaseModel) :
query: str
limit: int = 5
@app. post ( "/search-text" )
def search_text ( payload: SearchTextRequest) :
try :
query_vector = text_model. encode( payload. query) . tolist( )
pipeline = [
{
"$vectorSearch" : {
"queryVector" : query_vector,
"path" : "embedding" ,
"numCandidates" : 100 ,
"limit" : payload. limit,
"index" : "vector_texts_search"
}
} ,
{
"$project" : {
"title" : 1 ,
"content" : 1 ,
"score" : { "$meta" : "vectorSearchScore" } ,
"_id" : 0
}
}
]
results = list ( texts_coll. aggregate( pipeline) )
return { "results" : results}
except Exception as e:
raise HTTPException( status_code= 500 , detail= str ( e) ) 技术支持 > numCandidates 参数决定在返回最优结果前要评估多少潜在匹配项。
> 值越大准确率越高,但查询时间也越长。一个经验法则是设置为 limit 的 10–20 倍。
如何测试文本搜索
添加一条或多条文档后,通过 Postman 使用 Ngrok 生成的链接向 /search-text 端点发送 POST 请求,如下图所示:
期望的输出:
{
  "results": [
    {
      "title": "Why FastAPI is great",
      "content": "FastAPI makes building APIs simple and fast.",
      "score": 0.85
    }
  ]
}技术支持
如果您看到带有相似度分数的结果,说明文本向量搜索链路端到端已正常工作。该部分稳定后,我们就可以继续图像流程。
实现图像搜索
文本流程稳定运行后,我们可以将相同思路扩展到图像。整体流程类似——主要区别在于嵌入向量的生成方式。我们将使用基于 CLIP 的模型来将图像转换为 512 维向量,而非使用 SentenceTransformers。
同样地,我们会一步一步实现,方便测试与调试。
a. 添加图像并生成嵌入向量
该端点接收上传的图像文件,将其转换为 CLIP 可理解的张量,生成 512 维嵌入向量,并将其存入 MongoDB。
实现如下:
import torch
import open_clip
from PIL import Image
import io
from fastapi import UploadFile, File
clip_model, _, preprocess = open_clip. create_model_and_transforms(
"ViT-B-32" ,
pretrained= "openai"
)
device = "cuda" if torch. cuda. is_available( ) else "cpu"
clip_model. to( device)
@app. post ( "/add-image" )
async def add_image ( file : UploadFile = File( . . . ) ) :
"""
Upload an image, generate its CLIP embedding, and store in MongoDB.
"""
try :
image_bytes = await file . read( )
image = Image. open ( io. BytesIO( image_bytes) ) . convert( "RGB" )
image_tensor = preprocess( image) . unsqueeze( 0 ) . to( device)
with torch. no_grad( ) :
image_embedding = clip_model. encode_image( image_tensor)
image_embedding /= image_embedding. norm( dim= - 1 , keepdim= True )
vector = image_embedding. cpu( ) . numpy( ) . flatten( ) . tolist( )
doc = {
"filename" : file . filename,
"embedding" : vector
}
result = images_coll. insert_one( doc)
return {
"inserted_id" : str ( result. inserted_id) ,
"filename" : file . filename
}
except Exception as e:
raise HTTPException( status_code= 500 , detail= str ( e) ) 技术支持 为何归一化很重要
CLIP 嵌入向量最适合用余弦相似度。为了让比较更加准确稳定,我们对向量进行归一化 :
image_embedding /= image_embedding.norm(dim=-1, keepdim=True)技术支持 这样可以确保余弦距离能够反映真实的相似度。
测试图像上传端点
在 Postman 中,向 /add-image 端点发起 POST 请求。请求体使用 form-data,上传任意 .jpg 或 .png 图像。如下图所示:
如果一切正常,您应能得到类似如下的结果:
{
  "inserted_id": "692454f6156fbb762ed865a0",
  "filename": "file-name.png"
}技术支持
至此,您的图像嵌入向量已成功存入 MongoDB。
b. 使用向量搜索检索图像
现在,我们来构建一个端点:接收上传的查询图像,将其转换为嵌入向量,并使用图像向量索引找到最接近的已存图像。
将以下内容添加到 main.py :
@app. post ( "/search-image" )
async def search_image ( file : UploadFile = File( . . . ) ) :
"""
Upload an image and find the most visually similar images in MongoDB.
"""
try :
image_bytes = await file . read( )
image = Image. open ( io. BytesIO( image_bytes) ) . convert( "RGB" )
image_tensor = preprocess( image) . unsqueeze( 0 ) . to( device)
with torch. no_grad( ) :
query_embedding = clip_model. encode_image( image_tensor)
query_embedding /= query_embedding. norm( dim= - 1 , keepdim= True )
query_vector = query_embedding. cpu( ) . numpy( ) . flatten( ) . tolist( )
pipeline = [
{
"$vectorSearch" : {
"queryVector" : query_vector,
"path" : "embedding" ,
"numCandidates" : 100 ,
"limit" : 5 ,
"index" : "vector_images_search"
}
} ,
{
"$project" : {
"filename" : 1 ,
"score" : { "$meta" : "vectorSearchScore" } ,
"_id" : 0
}
}
]
results = list ( images_coll. aggregate( pipeline) )
return { "results" : results}
except Exception as e:
raise HTTPException( status_code= 500 , detail= str ( e) ) 技术支持 测试图像搜索端点
在 Postman 中,向 /search-image 端点发起 POST 请求。请求体使用 form-data,上传与之前存储内容相似的图像。如下图所示:
期望的输出如下:
{
"results" : [
{
"filename" : "image1.png" ,
"score" : 1.0
} ,
{
"filename" : "image2.png" ,
"score" : 0.81
}
]
} 技术支持 分数为 1.0 表示与同一图像完全匹配。接近(0.7–0.9)则说明视觉相似度很高。
如果您看到了包含结果的数组,说明图像向量搜索已正常工作。
至此,如果一切顺利,我们就构建了一个同时支持文本与图像的完整语义搜索系统。
总结 在本教程中,我们使用 FastAPI 和 MongoDB Atlas 构建了完整的语义搜索工作流:用 SentenceTransformers 生成文本嵌入向量,用 CLIP 模型创建图像嵌入向量,将一切存入 MongoDB,并借助 MongoDB 的 Vector Search 与 Postman 进行查询。该模式是语义文档搜索、图像相似度工具、推荐系统以及多模态 AI 功能等应用的基石。
这种架构的强大之处在于其灵活性:MongoDB 不会将您锁定在特定模型上。只要嵌入向量是数值向量,且维度与索引配置匹配,您就可以按需接入任何文本、图像或多模态嵌入模型。
在此基础上,您可以进一步扩展项目——存储元数据、构建排序逻辑,或集成到面向用户的应用中。同样的工作流也能借助 MongoDB Atlas 的全托管服务轻松扩展。
您可以在 GitHub 上找到完整可运行的项目。


基于关键词的搜索在简单查询中表现不错,但当我们更关心“含义”而非“措辞”时就会失效。如果一篇文档提到“提升响应时间”,另一篇谈到“改进性能”,传统搜索引擎会将它们视为不相关,尽管它们描述的是同一个想法。仅仅因为措辞不同,我们就失去了语义联系。
向量搜索通过将文本和图像表示为嵌入向量(embeddings)来解决这一限制:它们是由机器学习模型生成的数值向量,能够捕捉上下文、意图和语义相似性。一旦我们将这些嵌入向量存入 MongoDB,就可以查询它们以找到真正相关的项,而不受具体用词的限制。
在本教程中,我们将使用FastAPI 和MongoDB Atlas Vector Search 构建一个端到端的实用示例。我们将用 SentenceTransformers 生成文本嵌入向量,用基于 CLIP 的模型生成图像嵌入向量,将二者都存入 MongoDB,并在其上运行相似度搜索。到最后,您将拥有一个可用于语义文章搜索、产品推荐、视觉相似度工具以及众多真实场景的工作基础。
话不多说,我们开始吧。
先决条件
在动手之前,我们需要准备一些东西。本教程假设您对 Python、FastAPI 和 MongoDB 有基础了解,但不会依赖高级知识——我们会在过程中逐步介绍所用到的一切。
我们需要:
我们将使用的 Python 库
我们会在设置过程中安装以下库:
这些工具为我们提供了生成嵌入向量、将其存入 MongoDB,并使用向量搜索高效查询的一切所需。
理解向量搜索
在开始写代码前,先了解流程背后发生了什么会有所帮助。向量搜索并不复杂,把它分解开来就更容易。本质理解清楚后,后续教程会更易于跟进。
什么是嵌入向量?
所谓嵌入(embedding),就是用一串数字(一个向量)来表示一段数据的含义。
对文本而言,嵌入向量捕捉上下文与意图;对图像而言,它捕捉视觉模式与特征。
一个高度简化的嵌入示例如下:
语义相近的两样东西——比如描述相同想法的两句话,或包含相似目标物的两张图像——最终会得到在数学上彼此接近的向量。向量搜索的原理就是衡量这种“接近程度”。
MongoDB 如何使用嵌入向量
MongoDB 本身不生成嵌入向量。它专注于自己最擅长的事情:
换句话说,由我们的模型生成嵌入向量,MongoDB 负责搜索。
这种清晰的分工让系统既灵活又可扩展。
嵌入模型的类型
只要能输出数值向量,我们可以选择任何偏好的嵌入模型。不同模型擅长处理不同类型的数据:
数据类型
示例模型
说明
文本
all-MiniLM-L6-v2轻量,广泛用于 NLP
图像
CLIP/OpenCLIP
将图像转换为语义向量
多模态
Multimodal
同时处理文本与图像
这就是我们将用 FastAPI 和 MongoDB Atlas 实现的工作流。
设置完成后,我们就能按“含义”来搜索文本和图像——这是传统关键词搜索做不到的。
设置 MongoDB Atlas
在开始构建 FastAPI 应用之前,我们需要一个地方来存储和查询嵌入向量。MongoDB Atlas 使这一过程变得简单,创建向量索引只需几分钟。
1. 创建集群
如果您还没有,可以在 MongoDB Atlas 中创建一个新集群。免费层(M0)集群完全适用于本教程。有关如何创建集群的更多详情,请访问 MongoDB 文档。
2. 创建数据库和集合
在集群内:
vector_db。有关更多详情,请参阅文档。texts:用于存储文本文档及其嵌入向量images:用于存储图像文件名和图像嵌入向量有关如何创建集合,请参阅文档。
我们将图像集合与文本集合分开,是因为它们依赖不同的嵌入模型和不同的向量维度。
3. 创建向量索引
MongoDB 需要向量索引来运行快速的相似度搜索。我们将为文本嵌入向量和图像嵌入向量各创建一个索引。
您可以在Atlas → Collections → Search Indexes 中创建。我们先为文本集合进行设置。
下面的图片更直观地解释了流程。
在下一屏,点击Vector Search ->JSON Editor -> Next。下图可帮助您更好地理解流程。
文本向量索引
在向量搜索索引中,修改 JSON 文本以匹配我们的代码。
我们使用
all-MiniLM-L6-v2文本模型,它会生成384 维的嵌入向量。以下是 JSON 定义:
给该索引命名为:
vector_texts_search并保存。这使 MongoDB 能够在文本嵌入向量间执行余弦相似度搜索。下图更详细地展示了该过程。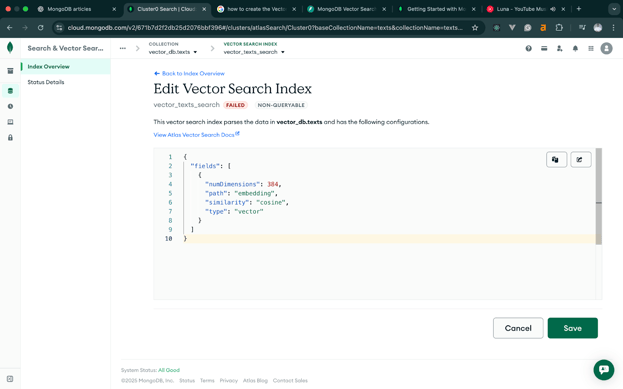
图像向量索引
对于图像,我们使用基于 CLIP 的模型,输出512 维的向量,因此图像索引需要匹配该维度。JSON 定义应与下方代码一致。除此之外,其余流程相同。
将该索引命名为:
vector_images_search。当两个索引都变为激活状态后,MongoDB Atlas 即可处理向量搜索查询。
设置 FastAPI 项目
既然我们的 MongoDB Atlas 集群和向量索引都已就绪,就可以设置 FastAPI 应用来生成嵌入向量并将其存入 MongoDB。我们会保持项目结构小而精,重点在于理解工作流,而不是构建完整的生产服务。
1. 安装所需依赖
我们将安装 FastAPI、Uvicorn、MongoDB 的 Python 驱动,以及用于生成文本与图像嵌入向量的库。运行:
简单说明这些库的用途:
.env加载环境变量安装完成后,我们就可以开始规划项目了。
2. 项目结构
我们将把所有内容放在一个 Python 文件中,配置通过环境变量管理:
main.py 将包含整个应用:文本端点、图像端点以及 MongoDB 连接。
FastAPI 在应用启动时会加载这些变量,使配置与代码分离。
实现文本搜索
FastAPI 项目就绪后,我们先构建文本搜索流程。这部分体现了向量搜索的核心思想:为文本生成嵌入向量,将其存入 MongoDB,并使用之前创建的向量索引进行查询。
我们分两小步来实现,便于一路测试和调试。
a. 添加文本并生成嵌入向量
第一个端点将接收标题和正文内容。我们会将两者合并为一个字符串,使用 SentenceTransformers 生成嵌入向量,并将文档与向量一同保存。
代码如下:
如何测试该端点
可以使用 cURL、Postman 等 API 测试工具。在本教程中,我们将使用 Postman 测试。
我们还需要将 FastAPI 端点暴露到公网,以便通过 Web 版 Postman 测试。这里使用 Ngrok。如果您是 Ngrok 新手,请查看文档。测试前,先用下方命令运行 FastAPI 代码:
然后,使用以下 Ngrok 命令将
localhost隧道到公网:这会生成一个可用于测试的 URL,如下图所示:
使用 Postman 向
add-text端点发送POST请求。下图进一步展示了发送请求及期望响应的过程。期望的响应:
这表明您的嵌入模型已正确加载,MongoDB 也已存储了向量。如果上述步骤成功,文本处理链路就正常运行了。
b. 使用向量搜索检索文本
现在我们可以添加文本了,下一步是使用 MongoDB 的$vectorSearch 阶段进行搜索。这里我们会:
将以下端点添加到
main.py中:> numCandidates 参数决定在返回最优结果前要评估多少潜在匹配项。
> 值越大准确率越高,但查询时间也越长。一个经验法则是设置为 limit 的 10–20 倍。
如何测试文本搜索
添加一条或多条文档后,通过 Postman 使用 Ngrok 生成的链接向
/search-text端点发送 POST 请求,如下图所示:期望的输出:
如果您看到带有相似度分数的结果,说明文本向量搜索链路端到端已正常工作。该部分稳定后,我们就可以继续图像流程。
实现图像搜索
文本流程稳定运行后,我们可以将相同思路扩展到图像。整体流程类似——主要区别在于嵌入向量的生成方式。我们将使用基于 CLIP 的模型来将图像转换为 512 维向量,而非使用 SentenceTransformers。
同样地,我们会一步一步实现,方便测试与调试。
a. 添加图像并生成嵌入向量
该端点接收上传的图像文件,将其转换为 CLIP 可理解的张量,生成 512 维嵌入向量,并将其存入 MongoDB。
实现如下:
为何归一化很重要
CLIP 嵌入向量最适合用余弦相似度。为了让比较更加准确稳定,我们对向量进行归一化:
这样可以确保余弦距离能够反映真实的相似度。
测试图像上传端点
在 Postman 中,向
/add-image端点发起POST请求。请求体使用 form-data,上传任意.jpg或.png图像。如下图所示:如果一切正常,您应能得到类似如下的结果:
至此,您的图像嵌入向量已成功存入 MongoDB。
b. 使用向量搜索检索图像
现在,我们来构建一个端点:接收上传的查询图像,将其转换为嵌入向量,并使用图像向量索引找到最接近的已存图像。
将以下内容添加到
main.py:测试图像搜索端点
在 Postman 中,向
/search-image端点发起POST请求。请求体使用 form-data,上传与之前存储内容相似的图像。如下图所示:期望的输出如下:
分数为1.0 表示与同一图像完全匹配。接近(0.7–0.9)则说明视觉相似度很高。
如果您看到了包含结果的数组,说明图像向量搜索已正常工作。
至此,如果一切顺利,我们就构建了一个同时支持文本与图像的完整语义搜索系统。
总结
在本教程中,我们使用 FastAPI 和 MongoDB Atlas 构建了完整的语义搜索工作流:用 SentenceTransformers 生成文本嵌入向量,用 CLIP 模型创建图像嵌入向量,将一切存入 MongoDB,并借助 MongoDB 的 Vector Search 与 Postman 进行查询。该模式是语义文档搜索、图像相似度工具、推荐系统以及多模态 AI 功能等应用的基石。
这种架构的强大之处在于其灵活性:MongoDB 不会将您锁定在特定模型上。只要嵌入向量是数值向量,且维度与索引配置匹配,您就可以按需接入任何文本、图像或多模态嵌入模型。
在此基础上,您可以进一步扩展项目——存储元数据、构建排序逻辑,或集成到面向用户的应用中。同样的工作流也能借助 MongoDB Atlas 的全托管服务轻松扩展。
您可以在GitHub 上找到完整可运行的项目。