MongoDB Vektör Arama ve FastAPI ile Görselleri ve Metinleri Nasıl Ararsınız
FastAPI ve MongoDB Atlas ile uçtan uca bir vektör arama uygulaması oluşturun. Bu uygulamalı eğitimde metin ve görsel gömme (embedding) üretmeyi, depolamayı ve sorgulamayı öğrenin.
Anahtar sözcük tabanlı arama basit sorgularda iyi iş görür, ancak tam sözcük eşleşmesinden ziyade anlamla ilgilendiğimizde hızla yetersiz kalır. Bir belgede “yanıt sürelerini artırma” ve diğerinde “performansı iyileştirme” geçiyorsa, geleneksel bir arama motoru bunları ilgisiz kabul eder; oysa aslında aynı fikri tanımlarlar. Yalnızca ifade farklı olduğu için anlamsal ilişkileri kaybederiz.
Vektör arama, metin ve görselleri gömmeler olarak temsil ederek bu sınırlamayı çözer: bağlamı, niyeti ve anlamsal benzerliği yakalayan, makine öğrenimi modelleri tarafından üretilen sayısal vektörler. Bu gömmeleri MongoDB’ye kaydettikten sonra, kullanılan terimlerden bağımsız olarak gerçekten ilişkili öğeleri bulmak için sorgulayabiliriz.
Bu eğitimde, FastAPI ve MongoDB Atlas Vector Search kullanarak bu iş akışının uçtan uca pratik bir örneğini geliştireceğiz. Metin gömmelerini SentenceTransformers ile, görsel gömmelerini CLIP tabanlı bir modelle üretecek, her ikisini de MongoDB’ye kaydedecek ve bunlar üzerinde benzerlik aramaları çalıştıracağız. Sonunda, anlamsal makale araması, ürün önerileri, görsel benzerlik araçları ve daha pek çok gerçek dünya uygulamasını destekleyebilecek çalışan bir temel elde edeceğiz.
Hazırsanız başlayalım.
Önkoşullar
Başlamadan önce birkaç şeye ihtiyacımız olacak. Bu eğitim, Python, FastAPI ve MongoDB’ye temel düzeyde aşinalık varsayar; ancak ileri düzey bilgilere dayanmayacağız—kullandığımız her şeyi ilerledikçe tanıtacağız.
İhtiyacımız olanlar:
Python 3.10+
Etkin Vector Search özelliğine sahip bir MongoDB Atlas kümesi
FastAPI ortamı
Postman veya cURL
Modelleri indirmek ve gömmek için internet erişimi
Kullanacağımız Python kütüphaneleri
Kurulumun bir parçası olarak bunları yükleyeceğiz:
FastAPI: web çatımız
uvicorn: geliştirme sunucusu
pymongo: MongoDB sürücüsü
sentence-transformers: metin gömme modeli
open_clip: CLIP tabanlı görsel gömme modeli
torch: CLIP ve SentenceTransformers için gereklidir
Pillow: görsel işleme desteği (PIL)
Bu araçlar, gömmeler üretmek, bunları MongoDB’de depolamak ve vektör aramayla verimli şekilde sorgulamak için ihtiyacımız olan her şeyi sağlar.
Vektör Aramayı Anlamak
Koda geçmeden önce, iş akışının altında neler olduğuna dair bir fikir edinmek faydalı olur. Vektör arama parçalara böldüğümüzde karmaşık değildir ve temelleri bilmek, geri kalanını takip etmeyi çok daha kolaylaştırır.
Gömme (embedding) nedir?
Bir gömme, bir verinin anlamını temsil eden sayı listesidir (bir vektör).
Metinde gömme, bağlam ve niyet gibi unsurları yakalar. Görsellerde ise görsel desenleri ve özellikleri yakalar.
Bir gömmenin çok basitleştirilmiş bir örneği şöyledir:
Anlamsal olarak benzer iki şey—örneğin aynı fikri tanımlayan iki cümle veya benzer nesneler içeren iki görsel—matematiksel olarak birbirine yakın vektörlere sahip olur. Vektör arama, bu yakınlığı ölçerek çalışır.
MongoDB gömmeleri nasıl kullanır
MongoDB, gömmeleri üretmez. Bunun yerine en iyi yaptığı işe odaklanır:
Gömme vektörlerini depolamak
Bunları bir vektör indeksi ile dizinlemek
En yakın komşuları verimli şekilde getirmek
Başka bir deyişle, gömmeleri modellerimiz üretir, aramayı MongoDB üstlenir.
Bu net ayrım, sistemi hem esnek hem de ölçeklenebilir kılar.
Gömme modeli türleri
Sayısal bir vektör çıktısı verdiği sürece istediğimiz gömme modelini seçebiliriz. Farklı modeller, farklı veri türlerinde uzmanlaşır:
Veri Türü
Örnek Model
Notlar
Metin
all-MiniLM-L6-v2
NLP için hafif ve yaygın kullanılır
Görsel
CLIP/OpenCLIP
Görselleri anlamsal vektörlere dönüştürür
Çok kipli
Multimodal
Metin ve görselleri birlikte işler
FastAPI ve MongoDB Atlas kullanarak uygulayacağımız iş akışı budur.
Kurulumdan sonra, metin ve görselleri anlamlarına göre arayabileceğiz—bu, geleneksel anahtar sözcük aramasının yapamadığı bir şeydir.
MongoDB Atlas’ı Kurma
FastAPI uygulamasını oluşturmadan önce, gömmelerimizi depolayıp sorgulayabileceğimiz bir ortama ihtiyacımız var. MongoDB Atlas bunu kolaylaştırır ve vektör indeksleri kurmak yalnızca birkaç dakika alır.
1. Bir küme (cluster) oluşturun
Henüz yoksa, MongoDB Atlas’ta yeni bir küme oluşturun. Ücretsiz katman (M0) bu eğitim için gayet yeterlidir. Küme nasıl oluşturulur konusunda daha fazla bilgi için MongoDB belgelerine bakın.
2. Bir veritabanı ve koleksiyonlar oluşturun
Küme içinde:
Bir veritabanı oluşturun. vector_dbolarak adlandıracağız. Bununla ilgili daha fazla ayrıntı için belgelere göz atın.
İçinde iki koleksiyon oluşturun:
texts: metin belgelerini ve gömmelerini saklayacağımız yer
images: görsel dosya adlarını ve görsel gömmelerini saklayacağımız yer
Bir koleksiyon nasıl oluşturulur belgelerine bakın.
Görsel koleksiyonla metin koleksiyonunu ayrı tuttuk; çünkü farklı gömme modellerine ve farklı vektör boyutlarına dayanırlar.
3. Vektör indeksleri oluşturun
MongoDB’nin hızlı benzerlik aramaları yapabilmesi için bir vektör indeksine ihtiyacı var. Metin gömmeleri için bir, görsel gömmeleri için bir indeks oluşturacağız.
Bunları Atlas → Collections → Search Indexes bölümünden oluşturabilirsiniz. Önce metin koleksiyonu için ayarlayalım.
Aşağıdaki görsel süreç hakkında daha iyi bir açıklama sunar.
Sonraki ekranda Vector Search ->JSON Editor -> Next seçeneklerine tıklayın. Aşağıdaki görsel süreci daha iyi anlamanıza yardımcı olacaktır
Metin için vektör indeksi
Vektör arama indeksinde, JSON metnini kodumuzla eşleşecek şekilde düzenleyin.
Metin için all-MiniLM-L6-v2 modelini kullanıyoruz ve bu model 384 boyutlu gömmeler üretir.
Bu indekse şu adı verin: vector_texts_searchve kaydedin.
Bu, MongoDB’nin metin gömmeleri üzerinde kosinüs benzerliği aramaları yapmasını sağlar. Aşağıdaki görsel süreç hakkında daha ayrıntılı bir açıklama sunar.
Görseller için vektör indeksi
Görseller için, 512 boyutlu vektörler üreten CLIP tabanlı bir model kullanıyoruz; dolayısıyla görsel indeksi bu boyutla eşleşmeli. JSON tanımı aşağıdaki kodla eşleşmelidir. Bunun dışında akışın geri kalanı aynıdır.
Bu indeksi şöyle adlandırın: vector_images_search.
Her iki indeks de etkin hale geldiğinde, MongoDB Atlas vektör arama sorguları için hazır olacaktır.
FastAPI Projesini Kurma
Artık MongoDB Atlas kümemiz ve vektör indekslerimiz hazır olduğuna göre, gömmeler üretecek ve bunları MongoDB’ye kaydedecek FastAPI uygulamasını kurabiliriz. Bu eğitim, bir üretim hizmeti inşa etmekten ziyade iş akışını anlamakla ilgili olduğundan proje yapısını küçük ve odaklı tutacağız.
1. Gerekli bağımlılıkları yükleyin
FastAPI, Uvicorn, MongoDB’nin Python sürücüsü ve metin ile görsel gömmelerini üretmek için gereken kütüphaneleri yükleyeceğiz. Şunu çalıştırın:
TEXT_COLLECTION—metin + gömmelerin saklanacağı yer
IMAGE_COLLECTION—görsel gömmelerin kaydedileceği yer
FastAPI, uygulama başladığında bunları yükleyecek ve yapılandırmayı koddan ayrı tutacaktır.
Metin Aramayı Uygulama
FastAPI projemizi kurduğumuza göre, metin arama iş akışını oluşturarak başlayabiliriz. Bu bölüm, vektör aramanın temel fikrini tanıtır: Metnimiz için gömme üretir, bunları MongoDB’ye kaydeder ve biraz önce oluşturduğumuz vektör indeksini kullanarak sorgularız.
Her şeyin adım adım kolay test edilip ayıklanabilmesi için bunu iki küçük adımda ele alacağız.
a. Metin ekleyin ve gömme üretin
İlk uç nokta bir başlık ve metin içeriği kabul edecek. Her iki alanı tek bir dizede birleştirip SentenceTransformers ile bir gömme üretecek ve belgeyi gömme vektörüyle birlikte kaydedeceğiz.
Kodda şöyle görünecek:
# main.py (excerpt)from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from pymongo import MongoClient
from sentence_transformers import SentenceTransformer
from dotenv import load_dotenv
import os
load_dotenv()
app = FastAPI()# --- DB setup ---
client = MongoClient(os.getenv("MONGODB_URI"))
db = client[os.getenv("DB_NAME")]
texts_coll = db[os.getenv("TEXT_COLLECTION")]
Images_coll = db[os.getenv("IMAGE_COLLECTION")]# --- text embedding model ---
MODEL_NAME ="all-MiniLM-L6-v2"
text_model = SentenceTransformer(MODEL_NAME)# --- request schema ---classAddTextRequest(BaseModel):
title:str
content:str@app.post("/add-text")defadd_text(payload: AddTextRequest):try:# Combine fields for richer embeddings
text =f"{payload.title}\n\n{payload.content}"# Generate text embedding
embedding = text_model.encode(text).tolist()# Store document in MongoDB
doc ={"title": payload.title,"content": payload.content,"embedding": embedding,"model": MODEL_NAME,}
result = texts_coll.insert_one(doc)return{"inserted_id":str(result.inserted_id),"title": payload.title
}except Exception as e:raise HTTPException(status_code=500, detail=str(e))Altyapı:
Bu uç nokta nasıl test edilir
Test için cURL, Postman ve benzeri API test araçları kullanılabilir. Bu eğitimde Postman ile test edeceğiz.
Ayrıca, webdeki Postman ile test edebilmek için FastAPI uç noktamızı internete açmamız gerekiyor. Bunun için Ngrok kullanacağız. Ngrok’a yeniyseniz belgelere göz atın. Test için önce aşağıdaki komutla FastAPI kodunu çalıştırın:
Bu, aşağıdaki görseldeki gibi test etmek için bir URL oluşturacaktır:
add-text uç noktasına Postman ile bir POST isteği gönderin. Aşağıdaki görsel, isteğin gönderilmesi ve almanız gereken beklenen yanıt sürecini daha ayrıntılı gösterir.
Beklenen yanıt:
{
  "inserted_id": "65f...",
  "title": "Why FastAPI is great."
}Altyapı:
Bu, gömme modelinizin doğru yüklendiğini ve MongoDB’nin vektörü kaydettiğini doğrular. Bu çalışıyorsa, metin hattınız (pipeline) düzgün çalışıyor demektir.
b. Metni vektör aramayla arayın
Artık metin ekleyebildiğimize göre, sıradaki adım MongoDB’nin $vectorSearch aşamasını kullanarak arama yapmak. Burada şunları yaparız:
Kullanıcının sorgusunu bir gömmeye dönüştürmek.
MongoDB’den en yakın vektörleri getirmesini istemek.
En benzer belgeleri döndürmek.
Şu uç noktayı main.py dosyasına ekleyin:
classSearchTextRequest(BaseModel):
query:str
limit:int=5@app.post("/search-text")defsearch_text(payload: SearchTextRequest):try:# Convert search query to embedding
query_vector = text_model.encode(payload.query).tolist()# Vector search pipeline
pipeline =[{"$vectorSearch":{"queryVector": query_vector,"path":"embedding","numCandidates":100,"limit": payload.limit,"index":"vector_texts_search"# field MUST match the index name in Atlas exactly}},{"$project":{"title":1,"content":1,"score":{"$meta":"vectorSearchScore"},"_id":0}}]
results =list(texts_coll.aggregate(pipeline))return{"results": results}except Exception as e:raise HTTPException(status_code=500, detail=str(e))Altyapı:
> numCandidates parametresi, en iyi sonuçlar döndürülmeden önce kaç potansiyel eşleşmenin değerlendirileceğini belirler.
> Daha yüksek değerler doğruluğu artırır ancak sorgu süresini uzatır. İyi bir kural, limitinizin 10–20 katıdır.
Metin araması nasıl test edilir
Bir veya daha fazla belge ekledikten sonra, Ngrok ile oluşturduğumuz bağlantıyı kullanarak Postman üzerinden /search-text uç noktasına bir POST isteği yapın; aşağıdaki görselde olduğu gibi:
Beklenen çıktı:
{
  "results": [
    {
      "title": "Why FastAPI is great",
      "content": "FastAPI makes building APIs simple and fast.",
      "score": 0.85
    }
  ]
}Altyapı:
Benzerlik puanlı bir sonuç görüyorsanız, metin vektör arama hattınız uçtan uca çalışıyor demektir. Bu kısım güvenilir şekilde çalıştığında, görsel iş akışına geçmeye hazırız.
Görsel Aramayı Uygulama
Metin iş akışımız sorunsuz çalıştığına göre, aynı fikri görsellere genişletebiliriz. Genel akış benzerdir—tek büyük fark, gömmeleri nasıl ürettiğimizdir. SentenceTransformers yerine, görselleri 512 boyutlu vektörlere dönüştürmek için tasarlanmış CLIP tabanlı bir model kullanacağız.
Yine, ilerledikçe test etmeyi ve ayıklamayı kolaylaştırmak için bunu adım adım uygulayacağız.
a. Görsel ekleyin ve gömme üretin
Bu uç nokta, yüklenen bir görsel dosyasını kabul eder, CLIP’in anlayacağı tensöre dönüştürür, 512 boyutlu bir gömme üretir ve bunu MongoDB’ye kaydeder.
Şöyle görünür:
# --- CLIP model setup ---import torch
import open_clip
from PIL import Image
import io
from fastapi import UploadFile, File
# Load CLIP model once when the app starts
clip_model, _, preprocess = open_clip.create_model_and_transforms("ViT-B-32",
pretrained="openai")
device ="cuda"if torch.cuda.is_available()else"cpu"
clip_model.to(device)@app.post("/add-image")asyncdefadd_image(file: UploadFile = File(...)):"""
Upload an image, generate its CLIP embedding, and store in MongoDB.
"""try:# Read file contents
image_bytes =awaitfile.read()
image = Image.open(io.BytesIO(image_bytes)).convert("RGB")# Preprocess for CLIP and encode
image_tensor = preprocess(image).unsqueeze(0).to(device)with torch.no_grad():
image_embedding = clip_model.encode_image(image_tensor)# Normalize the embedding (important for cosine similarity)
image_embedding /= image_embedding.norm(dim=-1, keepdim=True)
vector = image_embedding.cpu().numpy().flatten().tolist()# Store in MongoDB
doc ={"filename":file.filename,"embedding": vector
}
result = images_coll.insert_one(doc)return{"inserted_id":str(result.inserted_id),"filename":file.filename
}except Exception as e:raise HTTPException(status_code=500, detail=str(e))Altyapı:
Normalleştirmenin önemi
CLIP gömmeleri, kosinüs benzerliği ile en iyi sonucu verir. Karşılaştırmaların doğru ve kararlı olması için vektörleri normalleştiririz:
Bu, kosinüs uzaklığının gerçek benzerliği yansıtmasını sağlar.
Görsel yükleme uç noktasını test edin
Bu özelliği Postman’de test etmek için /add-image uç noktasına bir POST isteği gönderin. İstekte gövde olarak form-data gönderin ve herhangi bir .jpg veya .png görsel ekleyin. Aşağıdaki görsel süreçte size yol gösterecektir.
Her şey çalışıyorsa, şöylesi bir yanıt almalısınız:
Bu aşamada görsel gömmeleriniz başarıyla MongoDB’ye kaydedilmiştir.
b. Görselleri vektör aramayla arayın
Şimdi, yüklenen bir sorgu görselini alıp gömmeye dönüştüren ve görsel vektör indeksimizi kullanarak en yakın kayıtlı görselleri bulan uç noktayı oluşturabiliriz.
@app.post("/search-image")asyncdefsearch_image(file: UploadFile = File(...)):"""
Upload an image and find the most visually similar images in MongoDB.
"""try:# Read the uploaded file
image_bytes =awaitfile.read()
image = Image.open(io.BytesIO(image_bytes)).convert("RGB")# Generate embedding for the query image
image_tensor = preprocess(image).unsqueeze(0).to(device)with torch.no_grad():
query_embedding = clip_model.encode_image(image_tensor)
query_embedding /= query_embedding.norm(dim=-1, keepdim=True)
query_vector = query_embedding.cpu().numpy().flatten().tolist()# Vector search pipeline
pipeline =[{"$vectorSearch":{"queryVector": query_vector,"path":"embedding","numCandidates":100,"limit":5,"index":"vector_images_search"}},{"$project":{"filename":1,"score":{"$meta":"vectorSearchScore"},"_id":0}}]
results =list(images_coll.aggregate(pipeline))return{"results": results}except Exception as e:raise HTTPException(status_code=500, detail=str(e))Altyapı:
Görsel arama uç noktasını test edin
Bu özelliği Postman’de test etmek için /search-image uç noktasına bir POST isteği gönderin. Daha önce kaydettiğinize benzer bir görseli isteğin gövdesinde form-data olarak gönderin. Aşağıdaki görsel süreçte size yol gösterecektir.
1.0 puanı, tam olarak aynı görselle eşleştiği anlamına gelir. 0.7–0.9 arası değerler güçlü görsel benzerliğe işaret eder.
Bir sonuç dizisi görüyorsanız, görsel vektör aramanız artık çalışıyor demektir.
Bu noktada her şey çalışıyorsa, hem metin hem de görsel için çalışan eksiksiz bir anlamsal arama sistemimiz var demektir.
Sonuç
Bu eğitimde, FastAPI ve MongoDB Atlas kullanarak eksiksiz bir anlamsal arama iş akışı kurduk. Metin gömmelerini SentenceTransformers ile, görsel gömmelerini bir CLIP modeliyle ürettik; her şeyi MongoDB’ye kaydettik ve MongoDB’nin Vector Search özelliği ile Postman üzerinden sorguladık. Bu yapı, anlamsal belge araması, görsel benzerlik araçları, öneri sistemleri ve çok kipli yapay zekâ özellikleri gibi uygulamalar için temel oluşturur.
Bu mimariyi güçlü kılan şey esnekliğidir: MongoDB sizi belirli modellere kilitlemez. Gömmeler sayısal vektör olduğu ve boyutlar indeks yapılandırmanızla eşleştiği sürece, kullanım senaryonuzun gerektirdiği herhangi bir metin, görsel veya çok kipli gömme modelini takıp kullanabilirsiniz.
Bu temelle, projeyi daha da genişletebilir—meta veriler saklayabilir, sıralama mantığı kurabilir veya son kullanıcı uygulamalarıyla entegre edebilirsiniz. Aynı iş akışı, MongoDB Atlas’ın tamamen yönetilen hizmetleri sayesinde zahmetsizce ölçeklenir.
Tam çalışan projeyi GitHub üzerinde bulabilirsiniz.
Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!



 Abid Ali Awan · 14 min

 Dario Radečić · 15 min

 Kurtis Pykes · 8 min


Anahtar sözcük tabanlı arama basit sorgularda iyi iş görür, ancak tam sözcük eşleşmesinden ziyade anlamla ilgilendiğimizde hızla yetersiz kalır. Bir belgede “yanıt sürelerini artırma” ve diğerinde “performansı iyileştirme” geçiyorsa, geleneksel bir arama motoru bunları ilgisiz kabul eder; oysa aslında aynı fikri tanımlarlar. Yalnızca ifade farklı olduğu için anlamsal ilişkileri kaybederiz.
Vektör arama, metin ve görselleri gömmeler olarak temsil ederek bu sınırlamayı çözer: bağlamı, niyeti ve anlamsal benzerliği yakalayan, makine öğrenimi modelleri tarafından üretilen sayısal vektörler. Bu gömmeleri MongoDB’ye kaydettikten sonra, kullanılan terimlerden bağımsız olarak gerçekten ilişkili öğeleri bulmak için sorgulayabiliriz.
Bu eğitimde, FastAPI ve MongoDB Atlas Vector Search kullanarak bu iş akışının uçtan uca pratik bir örneğini geliştireceğiz. Metin gömmelerini SentenceTransformers ile, görsel gömmelerini CLIP tabanlı bir modelle üretecek, her ikisini de MongoDB’ye kaydedecek ve bunlar üzerinde benzerlik aramaları çalıştıracağız. Sonunda, anlamsal makale araması, ürün önerileri, görsel benzerlik araçları ve daha pek çok gerçek dünya uygulamasını destekleyebilecek çalışan bir temel elde edeceğiz.
Hazırsanız başlayalım.
Önkoşullar
Başlamadan önce birkaç şeye ihtiyacımız olacak. Bu eğitim, Python, FastAPI ve MongoDB’ye temel düzeyde aşinalık varsayar; ancak ileri düzey bilgilere dayanmayacağız—kullandığımız her şeyi ilerledikçe tanıtacağız.
İhtiyacımız olanlar:
Kullanacağımız Python kütüphaneleri
Kurulumun bir parçası olarak bunları yükleyeceğiz:
Bu araçlar, gömmeler üretmek, bunları MongoDB’de depolamak ve vektör aramayla verimli şekilde sorgulamak için ihtiyacımız olan her şeyi sağlar.
Vektör Aramayı Anlamak
Koda geçmeden önce, iş akışının altında neler olduğuna dair bir fikir edinmek faydalı olur. Vektör arama parçalara böldüğümüzde karmaşık değildir ve temelleri bilmek, geri kalanını takip etmeyi çok daha kolaylaştırır.
Gömme (embedding) nedir?
Bir gömme, bir verinin anlamını temsil eden sayı listesidir (bir vektör).
Metinde gömme, bağlam ve niyet gibi unsurları yakalar. Görsellerde ise görsel desenleri ve özellikleri yakalar.
Bir gömmenin çok basitleştirilmiş bir örneği şöyledir:
Anlamsal olarak benzer iki şey—örneğin aynı fikri tanımlayan iki cümle veya benzer nesneler içeren iki görsel—matematiksel olarak birbirine yakın vektörlere sahip olur. Vektör arama, bu yakınlığı ölçerek çalışır.
MongoDB gömmeleri nasıl kullanır
MongoDB, gömmeleri üretmez. Bunun yerine en iyi yaptığı işe odaklanır:
Başka bir deyişle, gömmeleri modellerimiz üretir, aramayı MongoDB üstlenir.
Bu net ayrım, sistemi hem esnek hem de ölçeklenebilir kılar.
Gömme modeli türleri
Sayısal bir vektör çıktısı verdiği sürece istediğimiz gömme modelini seçebiliriz. Farklı modeller, farklı veri türlerinde uzmanlaşır:
Veri Türü
Örnek Model
Notlar
Metin
all-MiniLM-L6-v2NLP için hafif ve yaygın kullanılır
Görsel
CLIP/OpenCLIP
Görselleri anlamsal vektörlere dönüştürür
Çok kipli
Multimodal
Metin ve görselleri birlikte işler
FastAPI ve MongoDB Atlas kullanarak uygulayacağımız iş akışı budur.
Kurulumdan sonra, metin ve görselleri anlamlarına göre arayabileceğiz—bu, geleneksel anahtar sözcük aramasının yapamadığı bir şeydir.
MongoDB Atlas’ı Kurma
FastAPI uygulamasını oluşturmadan önce, gömmelerimizi depolayıp sorgulayabileceğimiz bir ortama ihtiyacımız var. MongoDB Atlas bunu kolaylaştırır ve vektör indeksleri kurmak yalnızca birkaç dakika alır.
1. Bir küme (cluster) oluşturun
Henüz yoksa, MongoDB Atlas’ta yeni bir küme oluşturun. Ücretsiz katman (M0) bu eğitim için gayet yeterlidir. Küme nasıl oluşturulur konusunda daha fazla bilgi için MongoDB belgelerine bakın.
2. Bir veritabanı ve koleksiyonlar oluşturun
Küme içinde:
vector_dbolarak adlandıracağız. Bununla ilgili daha fazla ayrıntı için belgelere göz atın.texts: metin belgelerini ve gömmelerini saklayacağımız yerimages: görsel dosya adlarını ve görsel gömmelerini saklayacağımız yerBir koleksiyon nasıl oluşturulur belgelerine bakın.
Görsel koleksiyonla metin koleksiyonunu ayrı tuttuk; çünkü farklı gömme modellerine ve farklı vektör boyutlarına dayanırlar.
3. Vektör indeksleri oluşturun
MongoDB’nin hızlı benzerlik aramaları yapabilmesi için bir vektör indeksine ihtiyacı var. Metin gömmeleri için bir, görsel gömmeleri için bir indeks oluşturacağız.
Bunları Atlas → Collections → Search Indexes bölümünden oluşturabilirsiniz. Önce metin koleksiyonu için ayarlayalım.
Aşağıdaki görsel süreç hakkında daha iyi bir açıklama sunar.
Sonraki ekranda Vector Search ->JSON Editor -> Next seçeneklerine tıklayın. Aşağıdaki görsel süreci daha iyi anlamanıza yardımcı olacaktır
Metin için vektör indeksi
Vektör arama indeksinde, JSON metnini kodumuzla eşleşecek şekilde düzenleyin.
Metin için
all-MiniLM-L6-v2modelini kullanıyoruz ve bu model 384 boyutlu gömmeler üretir.JSON tanımı şöyle:
Bu indekse şu adı verin:
vector_texts_searchve kaydedin.Bu, MongoDB’nin metin gömmeleri üzerinde kosinüs benzerliği aramaları yapmasını sağlar. Aşağıdaki görsel süreç hakkında daha ayrıntılı bir açıklama sunar.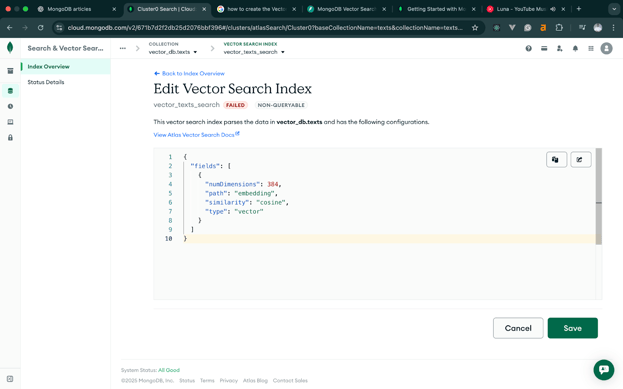
Görseller için vektör indeksi
Görseller için, 512 boyutlu vektörler üreten CLIP tabanlı bir model kullanıyoruz; dolayısıyla görsel indeksi bu boyutla eşleşmeli. JSON tanımı aşağıdaki kodla eşleşmelidir. Bunun dışında akışın geri kalanı aynıdır.
Bu indeksi şöyle adlandırın:
vector_images_search.Her iki indeks de etkin hale geldiğinde, MongoDB Atlas vektör arama sorguları için hazır olacaktır.
FastAPI Projesini Kurma
Artık MongoDB Atlas kümemiz ve vektör indekslerimiz hazır olduğuna göre, gömmeler üretecek ve bunları MongoDB’ye kaydedecek FastAPI uygulamasını kurabiliriz. Bu eğitim, bir üretim hizmeti inşa etmekten ziyade iş akışını anlamakla ilgili olduğundan proje yapısını küçük ve odaklı tutacağız.
1. Gerekli bağımlılıkları yükleyin
FastAPI, Uvicorn, MongoDB’nin Python sürücüsü ve metin ile görsel gömmelerini üretmek için gereken kütüphaneleri yükleyeceğiz. Şunu çalıştırın:
Bunlara neden ihtiyacımız olduğuna hızlı bir bakış:
.envdosyasından ortam değişkenlerini yüklerKurulum tamamlandığında, projeyi düzenlemeye hazırız.
2. Proje yapısı
Her şeyi tek bir Python dosyasında tutacak, yapılandırmayı ise ortam değişkenleriyle yöneteceğiz:
main.py; metin uç noktalarını, görsel uç noktalarını ve MongoDB bağlantısını içeren tüm uygulamayı barındıracaktır.
FastAPI, uygulama başladığında bunları yükleyecek ve yapılandırmayı koddan ayrı tutacaktır.
Metin Aramayı Uygulama
FastAPI projemizi kurduğumuza göre, metin arama iş akışını oluşturarak başlayabiliriz. Bu bölüm, vektör aramanın temel fikrini tanıtır: Metnimiz için gömme üretir, bunları MongoDB’ye kaydeder ve biraz önce oluşturduğumuz vektör indeksini kullanarak sorgularız.
Her şeyin adım adım kolay test edilip ayıklanabilmesi için bunu iki küçük adımda ele alacağız.
a. Metin ekleyin ve gömme üretin
İlk uç nokta bir başlık ve metin içeriği kabul edecek. Her iki alanı tek bir dizede birleştirip SentenceTransformers ile bir gömme üretecek ve belgeyi gömme vektörüyle birlikte kaydedeceğiz.
Kodda şöyle görünecek:
Bu uç nokta nasıl test edilir
Test için cURL, Postman ve benzeri API test araçları kullanılabilir. Bu eğitimde Postman ile test edeceğiz.
Ayrıca, webdeki Postman ile test edebilmek için FastAPI uç noktamızı internete açmamız gerekiyor. Bunun için Ngrok kullanacağız. Ngrok’a yeniyseniz belgelere göz atın. Test için önce aşağıdaki komutla FastAPI kodunu çalıştırın:
Ardından aşağıdaki Ngrok komutunu kullanarak
localhostadresinizi internete tünelleyin:Bu, aşağıdaki görseldeki gibi test etmek için bir URL oluşturacaktır:
add-textuç noktasına Postman ile birPOSTisteği gönderin. Aşağıdaki görsel, isteğin gönderilmesi ve almanız gereken beklenen yanıt sürecini daha ayrıntılı gösterir.Beklenen yanıt:
Bu, gömme modelinizin doğru yüklendiğini ve MongoDB’nin vektörü kaydettiğini doğrular. Bu çalışıyorsa, metin hattınız (pipeline) düzgün çalışıyor demektir.
b. Metni vektör aramayla arayın
Artık metin ekleyebildiğimize göre, sıradaki adım MongoDB’nin $vectorSearch aşamasını kullanarak arama yapmak. Burada şunları yaparız:
Şu uç noktayı
main.pydosyasına ekleyin:> numCandidates parametresi, en iyi sonuçlar döndürülmeden önce kaç potansiyel eşleşmenin değerlendirileceğini belirler.
> Daha yüksek değerler doğruluğu artırır ancak sorgu süresini uzatır. İyi bir kural, limitinizin 10–20 katıdır.
Metin araması nasıl test edilir
Bir veya daha fazla belge ekledikten sonra, Ngrok ile oluşturduğumuz bağlantıyı kullanarak Postman üzerinden
/search-textuç noktasına bir POST isteği yapın; aşağıdaki görselde olduğu gibi:Beklenen çıktı:
Benzerlik puanlı bir sonuç görüyorsanız, metin vektör arama hattınız uçtan uca çalışıyor demektir. Bu kısım güvenilir şekilde çalıştığında, görsel iş akışına geçmeye hazırız.
Görsel Aramayı Uygulama
Metin iş akışımız sorunsuz çalıştığına göre, aynı fikri görsellere genişletebiliriz. Genel akış benzerdir—tek büyük fark, gömmeleri nasıl ürettiğimizdir. SentenceTransformers yerine, görselleri 512 boyutlu vektörlere dönüştürmek için tasarlanmış CLIP tabanlı bir model kullanacağız.
Yine, ilerledikçe test etmeyi ve ayıklamayı kolaylaştırmak için bunu adım adım uygulayacağız.
a. Görsel ekleyin ve gömme üretin
Bu uç nokta, yüklenen bir görsel dosyasını kabul eder, CLIP’in anlayacağı tensöre dönüştürür, 512 boyutlu bir gömme üretir ve bunu MongoDB’ye kaydeder.
Şöyle görünür:
Normalleştirmenin önemi
CLIP gömmeleri, kosinüs benzerliği ile en iyi sonucu verir. Karşılaştırmaların doğru ve kararlı olması için vektörleri normalleştiririz:
Bu, kosinüs uzaklığının gerçek benzerliği yansıtmasını sağlar.
Görsel yükleme uç noktasını test edin
Bu özelliği Postman’de test etmek için
/add-imageuç noktasına birPOSTisteği gönderin. İstekte gövde olarak form-data gönderin ve herhangi bir.jpgveya.pnggörsel ekleyin. Aşağıdaki görsel süreçte size yol gösterecektir.Her şey çalışıyorsa, şöylesi bir yanıt almalısınız:
Bu aşamada görsel gömmeleriniz başarıyla MongoDB’ye kaydedilmiştir.
b. Görselleri vektör aramayla arayın
Şimdi, yüklenen bir sorgu görselini alıp gömmeye dönüştüren ve görsel vektör indeksimizi kullanarak en yakın kayıtlı görselleri bulan uç noktayı oluşturabiliriz.
Bunu
main.pydosyasına ekleyin:Görsel arama uç noktasını test edin
Bu özelliği Postman’de test etmek için
/search-imageuç noktasına birPOSTisteği gönderin. Daha önce kaydettiğinize benzer bir görseli isteğin gövdesinde form-data olarak gönderin. Aşağıdaki görsel süreçte size yol gösterecektir.Beklenen çıktı şu şekilde olmalıdır:
1.0 puanı, tam olarak aynı görselle eşleştiği anlamına gelir. 0.7–0.9 arası değerler güçlü görsel benzerliğe işaret eder.
Bir sonuç dizisi görüyorsanız, görsel vektör aramanız artık çalışıyor demektir.
Bu noktada her şey çalışıyorsa, hem metin hem de görsel için çalışan eksiksiz bir anlamsal arama sistemimiz var demektir.
Sonuç
Bu eğitimde, FastAPI ve MongoDB Atlas kullanarak eksiksiz bir anlamsal arama iş akışı kurduk. Metin gömmelerini SentenceTransformers ile, görsel gömmelerini bir CLIP modeliyle ürettik; her şeyi MongoDB’ye kaydettik ve MongoDB’nin Vector Search özelliği ile Postman üzerinden sorguladık. Bu yapı, anlamsal belge araması, görsel benzerlik araçları, öneri sistemleri ve çok kipli yapay zekâ özellikleri gibi uygulamalar için temel oluşturur.
Bu mimariyi güçlü kılan şey esnekliğidir: MongoDB sizi belirli modellere kilitlemez. Gömmeler sayısal vektör olduğu ve boyutlar indeks yapılandırmanızla eşleştiği sürece, kullanım senaryonuzun gerektirdiği herhangi bir metin, görsel veya çok kipli gömme modelini takıp kullanabilirsiniz.
Bu temelle, projeyi daha da genişletebilir—meta veriler saklayabilir, sıralama mantığı kurabilir veya son kullanıcı uygulamalarıyla entegre edebilirsiniz. Aynı iş akışı, MongoDB Atlas’ın tamamen yönetilen hizmetleri sayesinde zahmetsizce ölçeklenir.
Tam çalışan projeyi GitHub üzerinde bulabilirsiniz.