Cách tìm kiếm hình ảnh và văn bản bằng MongoDB Vector Search với FastAPI
Xây dựng ứng dụng vector search end-to-end với FastAPI và MongoDB Atlas. Học cách tạo, lưu trữ và truy vấn embedding cho văn bản và hình ảnh trong hướng dẫn thực hành này.
Tìm kiếm dựa trên từ khóa hoạt động tốt cho các tra cứu đơn giản, nhưng nhanh chóng bộc lộ hạn chế khi chúng ta quan tâm đến ý nghĩa thay vì câu chữ chính xác. Nếu một tài liệu đề cập đến “tăng tốc thời gian phản hồi” và tài liệu khác nói về “cải thiện hiệu năng”, công cụ tìm kiếm truyền thống sẽ coi chúng không liên quan, dù thực chất mô tả cùng một ý tưởng. Chúng ta đánh mất mối quan hệ ngữ nghĩa chỉ vì cách diễn đạt khác nhau.
Vector search giải quyết hạn chế này bằng cách biểu diễn văn bản và hình ảnh dưới dạng embedding: các vector số được tạo bởi mô hình học máy, nắm bắt bối cảnh, ý định và độ tương đồng ngữ nghĩa. Khi đã lưu embedding trong MongoDB, chúng ta có thể truy vấn để tìm các mục thực sự liên quan, bất kể những thuật ngữ chính xác được dùng là gì.
Trong bài hướng dẫn này, chúng ta sẽ xây dựng một ví dụ thực tiễn end-to-end cho quy trình này bằng FastAPI và MongoDB Atlas Vector Search. Chúng ta sẽ tạo embedding văn bản bằng SentenceTransformers và embedding hình ảnh bằng mô hình dựa trên CLIP, lưu cả hai vào MongoDB và thực hiện tìm kiếm theo độ tương đồng. Kết thúc, bạn sẽ có một nền tảng hoạt động được để hỗ trợ tìm kiếm bài viết theo ngữ nghĩa, gợi ý sản phẩm, công cụ tìm hình tương tự và nhiều ứng dụng thực tế khác.
Vậy thì, hãy bắt đầu.
Yêu cầu tiên quyết
Trước khi bắt tay xây dựng, chúng ta cần chuẩn bị một vài thứ. Hướng dẫn này giả định bạn quen thuộc cơ bản với Python, FastAPI và MongoDB, nhưng sẽ không dựa vào kiến thức nâng cao—mọi thứ cần dùng đều sẽ được giới thiệu dần.
open_clip: mô hình embedding hình ảnh dựa trên CLIP
torch: yêu cầu bởi CLIP và SentenceTransformers
Pillow: hỗ trợ xử lý ảnh (PIL)
Những công cụ này cung cấp mọi thứ cần thiết để tạo embedding, lưu vào MongoDB và truy vấn hiệu quả bằng vector search.
Tìm hiểu Vector Search
Trước khi viết mã, sẽ hữu ích nếu hiểu rõ điều gì diễn ra bên dưới quy trình. Vector search không phức tạp khi ta tách nhỏ ra, và nắm được nền tảng sẽ giúp phần còn lại dễ theo dõi hơn nhiều.
Embedding là gì?
Một embedding đơn giản là một danh sách số (một vector) đại diện cho ý nghĩa của một dữ liệu.
Với văn bản, embedding nắm bắt các yếu tố như bối cảnh và ý định. Với hình ảnh, nó nắm bắt các mẫu và đặc trưng thị giác.
Một ví dụ đơn giản hóa về embedding trông như sau:
Hai thứ tương đồng về ngữ nghĩa—ví dụ, hai câu mô tả cùng một ý, hoặc hai hình có đối tượng tương tự—sẽ tạo ra các vector gần nhau về mặt toán học. Vector search hoạt động bằng cách đo lường mức độ gần này.
MongoDB sử dụng embedding như thế nào
Bản thân MongoDB không tạo embedding. Thay vào đó, nó tập trung vào thế mạnh:
Lưu trữ các vector embedding
Đánh chỉ mục bằng vector index
Truy xuất láng giềng gần nhất một cách hiệu quả
Nói cách khác, mô hình của chúng ta tạo embedding, còn MongoDB đảm trách phần tìm kiếm.
Sự tách bạch rõ ràng này giúp hệ thống linh hoạt và dễ mở rộng.
Các loại mô hình embedding
Chúng ta có thể chọn bất kỳ mô hình embedding nào miễn là đầu ra là vector số. Các mô hình khác nhau chuyên biệt cho từng loại dữ liệu:
Loại dữ liệu
Mô hình ví dụ
Ghi chú
Văn bản
all-MiniLM-L6-v2
Nhẹ và được dùng rộng rãi cho NLP
Hình ảnh
CLIP/OpenCLIP
Chuyển đổi hình ảnh thành vector ngữ nghĩa
Đa phương thức
Multimodal
Xử lý cả văn bản và hình ảnh cùng nhau
Đây là quy trình chúng ta sẽ triển khai bằng FastAPI và MongoDB Atlas.
Khi thiết lập xong, chúng ta có thể tìm kiếm văn bản và hình ảnh theo ý nghĩa—điều mà tìm kiếm từ khóa truyền thống không làm được.
Thiết lập MongoDB Atlas
Trước khi xây dựng ứng dụng FastAPI, chúng ta cần nơi để lưu trữ và truy vấn embedding. MongoDB Atlas giúp việc này đơn giản, và tạo vector index chỉ mất vài phút.
1. Tạo cụm
Nếu bạn chưa có, hãy tạo cụm mới trong MongoDB Atlas. Cụm miễn phí (M0) là đủ cho hướng dẫn này. Truy cập tài liệu MongoDB để biết thêm chi tiết về cách tạo cụm.
2. Tạo cơ sở dữ liệu và collection
Bên trong cụm:
Tạo cơ sở dữ liệu. Chúng ta sẽ gọi là vector_db. Để biết thêm chi tiết, xem tài liệu.
Tạo hai collection bên trong:
texts: nơi lưu tài liệu văn bản và embedding của chúng
Chúng ta tách riêng collection hình ảnh và văn bản vì chúng dùng các mô hình embedding và số chiều vector khác nhau.
3. Tạo vector index
MongoDB cần vector index để thực hiện tìm kiếm độ tương đồng nhanh. Chúng ta sẽ tạo một index cho embedding văn bản và một cho embedding hình ảnh.
Bạn có thể tạo trong Atlas → Collections → Search Indexes. Hãy bắt đầu thiết lập cho collection văn bản.
Hình ảnh sau giải thích rõ hơn quy trình.
Ở màn tiếp theo, nhấp Vector Search ->JSON Editor -> Next. Hình dưới sẽ giúp bạn hiểu quy trình hơn
Vector index cho văn bản
Trong vector search index, chỉnh sửa JSON để khớp với mã của chúng ta.
Chúng ta dùng mô hình all-MiniLM-L6-v2 cho văn bản, tạo ra embedding 384 chiều.
Đây là định nghĩa JSON:
{"fields":[{"type":"vector","path":"embedding","numDimensions":384,"similarity":"cosine"}]}Được hỗ trợ bởi
Đặt tên index này: vector_texts_searchvà lưu.
Điều này cho phép MongoDB thực hiện tìm kiếm theo cosine similarity trên embedding văn bản. Hình bên dưới minh họa chi tiết hơn.
Vector index cho hình ảnh
Với hình ảnh, chúng ta dùng mô hình dựa trên CLIP cho ra vector 512 chiều, vì vậy index hình ảnh cần khớp số chiều đó. Định nghĩa JSON cần giống đoạn mã dưới đây. Ngoài ra, phần còn lại của luồng là như nhau.
{"fields":[{"type":"vector","path":"embedding","numDimensions":512,"similarity":"cosine"}]}Được hỗ trợ bởi
Đặt tên index này: vector_images_search.
Khi cả hai index hoạt động, MongoDB Atlas đã sẵn sàng cho các truy vấn vector search.
Thiết lập dự án FastAPI
Khi cụm MongoDB Atlas và vector index đã sẵn sàng, chúng ta có thể thiết lập ứng dụng FastAPI để tạo embedding và lưu vào MongoDB. Chúng ta sẽ giữ cấu trúc dự án gọn nhẹ, tập trung vào quy trình thay vì xây dựng dịch vụ sản xuất hoàn chỉnh.
1. Cài đặt các phụ thuộc cần thiết
Chúng ta sẽ cài FastAPI, Uvicorn, driver Python của MongoDB và các thư viện để tạo embedding văn bản và hình ảnh. Chạy:
open_clip_torch—mô hình embedding hình ảnh dựa trên CLIP
python-multipart—cần cho tải tệp qua FastAPI
Sau khi cài xong, chúng ta sẵn sàng bố trí dự án.
2. Cấu trúc dự án
Chúng ta sẽ để mọi thứ trong một tệp Python, cấu hình thông qua biến môi trường:
fastapi-mongodb-vector-search/
│── main.py
│── .env
│── venv/Được hỗ trợ bởi
main.py sẽ chứa toàn bộ ứng dụng: các endpoint cho văn bản, hình ảnh và kết nối MongoDB.
MONGODB_URI="your connection string"
DB_NAME="vector_db"
TEXT_COLLECTION="texts"
IMAGE_COLLECTION="images"Được hỗ trợ bởi
MONGODB_URI—URI Atlas cho cụm của bạn
DB_NAME—cơ sở dữ liệu chúng ta đã tạo
TEXT_COLLECTION—nơi lưu văn bản + embedding
IMAGE_COLLECTION—nơi lưu embedding hình ảnh
FastAPI sẽ tải các giá trị này khi ứng dụng khởi động, tách biệt cấu hình khỏi mã nguồn.
Triển khai tìm kiếm văn bản
Với dự án FastAPI đã sẵn sàng, chúng ta bắt đầu với quy trình tìm kiếm văn bản. Phần này giới thiệu ý tưởng cốt lõi của vector search: Tạo embedding cho văn bản, lưu vào MongoDB và truy vấn bằng vector index đã tạo trước đó.
Chúng ta sẽ chia thành hai bước nhỏ để dễ kiểm thử và gỡ lỗi.
a. Thêm văn bản và tạo embedding
Endpoint đầu tiên sẽ nhận tiêu đề và nội dung. Chúng ta sẽ gộp hai trường thành một chuỗi, tạo embedding bằng SentenceTransformers và lưu tài liệu kèm vector embedding.
Mã minh họa:
# main.py (excerpt)from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from pymongo import MongoClient
from sentence_transformers import SentenceTransformer
from dotenv import load_dotenv
import os
load_dotenv()
app = FastAPI()# --- DB setup ---
client = MongoClient(os.getenv("MONGODB_URI"))
db = client[os.getenv("DB_NAME")]
texts_coll = db[os.getenv("TEXT_COLLECTION")]
Images_coll = db[os.getenv("IMAGE_COLLECTION")]# --- text embedding model ---
MODEL_NAME ="all-MiniLM-L6-v2"
text_model = SentenceTransformer(MODEL_NAME)# --- request schema ---classAddTextRequest(BaseModel):
title:str
content:str@app.post("/add-text")defadd_text(payload: AddTextRequest):try:# Combine fields for richer embeddings
text =f"{payload.title}\n\n{payload.content}"# Generate text embedding
embedding = text_model.encode(text).tolist()# Store document in MongoDB
doc ={"title": payload.title,"content": payload.content,"embedding": embedding,"model": MODEL_NAME,}
result = texts_coll.insert_one(doc)return{"inserted_id":str(result.inserted_id),"title": payload.title
}except Exception as e:raise HTTPException(status_code=500, detail=str(e))Được hỗ trợ bởi
Cách kiểm thử endpoint này
Có thể dùng cURL, Postman hoặc các công cụ kiểm thử API tương tự. Trong hướng dẫn này, chúng ta sẽ kiểm thử bằng Postman.
Chúng ta cũng cần mở endpoint FastAPI ra Internet để kiểm thử bằng Postman trên web. Sẽ dùng Ngrok cho việc này. Nếu bạn mới dùng Ngrok, truy cập tài liệu. Để kiểm thử, trước tiên chạy mã FastAPI bằng lệnh dưới đây:
Gửi yêu cầu POST bằng Postman tới endpoint add-text. Hình dưới minh họa quy trình gửi yêu cầu và phản hồi mong đợi.
Phản hồi kỳ vọng:
{
  "inserted_id": "65f...",
  "title": "Why FastAPI is great."
}Được hỗ trợ bởi
Điều này xác nhận mô hình embedding đã tải đúng và MongoDB đã lưu vector. Nếu chạy được, pipeline văn bản của bạn đang hoạt động.
b. Tìm kiếm văn bản bằng vector search
Giờ khi đã thêm được văn bản, bước tiếp theo là tìm kiếm bằng $vectorSearch của MongoDB. Ở đây, chúng ta:
Chuyển truy vấn của người dùng thành embedding.
Yêu cầu MongoDB truy xuất các vector gần nhất.
Trả về các tài liệu tương tự nhất.
Thêm endpoint sau vào main.py:
classSearchTextRequest(BaseModel):
query:str
limit:int=5@app.post("/search-text")defsearch_text(payload: SearchTextRequest):try:# Convert search query to embedding
query_vector = text_model.encode(payload.query).tolist()# Vector search pipeline
pipeline =[{"$vectorSearch":{"queryVector": query_vector,"path":"embedding","numCandidates":100,"limit": payload.limit,"index":"vector_texts_search"# field MUST match the index name in Atlas exactly}},{"$project":{"title":1,"content":1,"score":{"$meta":"vectorSearchScore"},"_id":0}}]
results =list(texts_coll.aggregate(pipeline))return{"results": results}except Exception as e:raise HTTPException(status_code=500, detail=str(e))Được hỗ trợ bởi
> Tham số numCandidates xác định có bao nhiêu ứng viên được đánh giá trước khi trả về kết quả hàng đầu.
> Giá trị cao hơn cải thiện độ chính xác nhưng tăng thời gian truy vấn. Kinh nghiệm: đặt khoảng 10–20 lần giới hạn trả về.
Cách kiểm thử tìm kiếm văn bản
Sau khi thêm một hoặc nhiều tài liệu, gửi yêu cầu POST tới endpoint /search-text qua Postman dùng liên kết Ngrok đã tạo, như hình dưới:
Đầu ra kỳ vọng:
{
  "results": [
    {
      "title": "Why FastAPI is great",
      "content": "FastAPI makes building APIs simple and fast.",
      "score": 0.85
    }
  ]
}Được hỗ trợ bởi
Nếu bạn thấy kết quả có điểm tương đồng, pipeline vector search cho văn bản đã hoạt động end-to-end. Khi phần này ổn định, chúng ta sẵn sàng chuyển sang quy trình hình ảnh.
Triển khai tìm kiếm hình ảnh
Khi quy trình văn bản đã chạy trơn tru, chúng ta mở rộng cùng ý tưởng cho hình ảnh. Luồng tổng thể tương tự—điểm khác biệt lớn là cách tạo embedding. Thay vì SentenceTransformers, ta dùng mô hình dựa trên CLIP, được thiết kế để chuyển ảnh thành vector 512 chiều.
Giống như trước, ta sẽ triển khai từng bước để dễ kiểm thử và gỡ lỗi.
a. Thêm hình ảnh và tạo embedding
Endpoint này nhận tệp ảnh tải lên, chuyển thành tensor mà CLIP hiểu được, tạo embedding 512 chiều và lưu vào MongoDB.
Mã minh họa:
# --- CLIP model setup ---import torch
import open_clip
from PIL import Image
import io
from fastapi import UploadFile, File
# Load CLIP model once when the app starts
clip_model, _, preprocess = open_clip.create_model_and_transforms("ViT-B-32",
pretrained="openai")
device ="cuda"if torch.cuda.is_available()else"cpu"
clip_model.to(device)@app.post("/add-image")asyncdefadd_image(file: UploadFile = File(...)):"""
Upload an image, generate its CLIP embedding, and store in MongoDB.
"""try:# Read file contents
image_bytes =awaitfile.read()
image = Image.open(io.BytesIO(image_bytes)).convert("RGB")# Preprocess for CLIP and encode
image_tensor = preprocess(image).unsqueeze(0).to(device)with torch.no_grad():
image_embedding = clip_model.encode_image(image_tensor)# Normalize the embedding (important for cosine similarity)
image_embedding /= image_embedding.norm(dim=-1, keepdim=True)
vector = image_embedding.cpu().numpy().flatten().tolist()# Store in MongoDB
doc ={"filename":file.filename,"embedding": vector
}
result = images_coll.insert_one(doc)return{"inserted_id":str(result.inserted_id),"filename":file.filename
}except Exception as e:raise HTTPException(status_code=500, detail=str(e))Được hỗ trợ bởi
Vì sao chuẩn hóa quan trọng
Embedding của CLIP hoạt động tốt nhất với cosine similarity. Để so sánh chính xác và ổn định, chúng ta chuẩn hóa vector:
image_embedding /= image_embedding.norm(dim=-1, keepdim=True)Được hỗ trợ bởi
Việc này đảm bảo khoảng cách cosine phản ánh đúng độ tương đồng.
Kiểm thử endpoint tải ảnh
Để kiểm thử trong Postman, gửi yêu cầu POST tới endpoint /add-image. Gửi form-data trong phần thân yêu cầu kèm bất kỳ ảnh .jpg hoặc .png. Hình dưới minh họa thêm.
Nếu mọi thứ hoạt động, bạn sẽ nhận được:
{
  "inserted_id": "692454f6156fbb762ed865a0",
  "filename": "file-name.png"
}Được hỗ trợ bởi
Lúc này embedding hình ảnh của bạn đã được lưu thành công vào MongoDB.
b. Tìm kiếm hình ảnh bằng vector search
Giờ chúng ta xây dựng endpoint nhận ảnh truy vấn được tải lên, chuyển thành embedding và tìm các ảnh lưu trữ gần nhất bằng vector index cho ảnh.
@app.post("/search-image")asyncdefsearch_image(file: UploadFile = File(...)):"""
Upload an image and find the most visually similar images in MongoDB.
"""try:# Read the uploaded file
image_bytes =awaitfile.read()
image = Image.open(io.BytesIO(image_bytes)).convert("RGB")# Generate embedding for the query image
image_tensor = preprocess(image).unsqueeze(0).to(device)with torch.no_grad():
query_embedding = clip_model.encode_image(image_tensor)
query_embedding /= query_embedding.norm(dim=-1, keepdim=True)
query_vector = query_embedding.cpu().numpy().flatten().tolist()# Vector search pipeline
pipeline =[{"$vectorSearch":{"queryVector": query_vector,"path":"embedding","numCandidates":100,"limit":5,"index":"vector_images_search"}},{"$project":{"filename":1,"score":{"$meta":"vectorSearchScore"},"_id":0}}]
results =list(images_coll.aggregate(pipeline))return{"results": results}except Exception as e:raise HTTPException(status_code=500, detail=str(e))Được hỗ trợ bởi
Kiểm thử endpoint tìm kiếm ảnh
Để kiểm thử trong Postman, gửi yêu cầu POST tới endpoint /search-image. Gửi form-data trong phần thân với ảnh tương tự những gì bạn đã lưu trước đó. Hình dưới minh họa thêm.
Đầu ra kỳ vọng như sau:
{"results":[{"filename":"image1.png","score":1.0},{"filename":"image2.png","score":0.81}]}Được hỗ trợ bởi
Điểm 1.0 nghĩa là trùng khớp chính xác cùng ảnh. Bất kỳ giá trị gần (0,7–0,9) cho thấy độ tương đồng thị giác cao.
Nếu bạn thấy một mảng kết quả, tìm kiếm vector cho hình ảnh của bạn đã hoạt động.
Tại thời điểm này, nếu mọi thứ chạy tốt, chúng ta đã có hệ thống tìm kiếm ngữ nghĩa hoàn chỉnh cho cả văn bản lẫn hình ảnh.
Kết luận
Trong hướng dẫn này, chúng ta đã xây dựng quy trình tìm kiếm ngữ nghĩa hoàn chỉnh bằng FastAPI và MongoDB Atlas. Chúng ta tạo embedding văn bản với SentenceTransformers, tạo embedding hình ảnh bằng mô hình CLIP, lưu mọi thứ vào MongoDB và truy vấn bằng Vector Search của MongoDB và Postman. Mẫu này là nền tảng cho các ứng dụng như tìm kiếm tài liệu theo ngữ nghĩa, công cụ tìm ảnh tương tự, hệ thống gợi ý và tính năng AI đa phương thức.
Điều làm cho kiến trúc này mạnh mẽ là tính linh hoạt: MongoDB không khóa bạn vào các mô hình cụ thể. Miễn là embedding là vector số và số chiều khớp cấu hình index, bạn có thể cắm bất kỳ mô hình embedding văn bản, hình ảnh hoặc đa phương thức nào phù hợp với bài toán.
Với nền tảng này, bạn có thể mở rộng dự án—lưu metadata, xây dựng logic xếp hạng, hoặc tích hợp với ứng dụng hướng người dùng. Quy trình tương tự cũng mở rộng dễ dàng nhờ dịch vụ quản lý toàn phần của MongoDB Atlas.
Bạn có thể tìm dự án hoàn chỉnh hoạt động trên GitHub.


 Matt Crabtree · 10 min
Tìm kiếm dựa trên từ khóa hoạt động tốt cho các tra cứu đơn giản, nhưng nhanh chóng bộc lộ hạn chế khi chúng ta quan tâm đến ý nghĩa thay vì câu chữ chính xác. Nếu một tài liệu đề cập đến “tăng tốc thời gian phản hồi” và tài liệu khác nói về “cải thiện hiệu năng”, công cụ tìm kiếm truyền thống sẽ coi chúng không liên quan, dù thực chất mô tả cùng một ý tưởng. Chúng ta đánh mất mối quan hệ ngữ nghĩa chỉ vì cách diễn đạt khác nhau.
Vector search giải quyết hạn chế này bằng cách biểu diễn văn bản và hình ảnh dưới dạng embedding: các vector số được tạo bởi mô hình học máy, nắm bắt bối cảnh, ý định và độ tương đồng ngữ nghĩa. Khi đã lưu embedding trong MongoDB, chúng ta có thể truy vấn để tìm các mục thực sự liên quan, bất kể những thuật ngữ chính xác được dùng là gì.
Trong bài hướng dẫn này, chúng ta sẽ xây dựng một ví dụ thực tiễn end-to-end cho quy trình này bằng FastAPI và MongoDB Atlas Vector Search. Chúng ta sẽ tạo embedding văn bản bằng SentenceTransformers và embedding hình ảnh bằng mô hình dựa trên CLIP, lưu cả hai vào MongoDB và thực hiện tìm kiếm theo độ tương đồng. Kết thúc, bạn sẽ có một nền tảng hoạt động được để hỗ trợ tìm kiếm bài viết theo ngữ nghĩa, gợi ý sản phẩm, công cụ tìm hình tương tự và nhiều ứng dụng thực tế khác.
Vậy thì, hãy bắt đầu.
Yêu cầu tiên quyết
Trước khi bắt tay xây dựng, chúng ta cần chuẩn bị một vài thứ. Hướng dẫn này giả định bạn quen thuộc cơ bản với Python, FastAPI và MongoDB, nhưng sẽ không dựa vào kiến thức nâng cao—mọi thứ cần dùng đều sẽ được giới thiệu dần.
Những gì cần có:
Thư viện Python sẽ dùng
Chúng ta sẽ cài trong phần thiết lập:
Những công cụ này cung cấp mọi thứ cần thiết để tạo embedding, lưu vào MongoDB và truy vấn hiệu quả bằng vector search.
Tìm hiểu Vector Search
Trước khi viết mã, sẽ hữu ích nếu hiểu rõ điều gì diễn ra bên dưới quy trình. Vector search không phức tạp khi ta tách nhỏ ra, và nắm được nền tảng sẽ giúp phần còn lại dễ theo dõi hơn nhiều.
Embedding là gì?
Một embedding đơn giản là một danh sách số (một vector) đại diện cho ý nghĩa của một dữ liệu.
Với văn bản, embedding nắm bắt các yếu tố như bối cảnh và ý định. Với hình ảnh, nó nắm bắt các mẫu và đặc trưng thị giác.
Một ví dụ đơn giản hóa về embedding trông như sau:
Hai thứ tương đồng về ngữ nghĩa—ví dụ, hai câu mô tả cùng một ý, hoặc hai hình có đối tượng tương tự—sẽ tạo ra các vector gần nhau về mặt toán học. Vector search hoạt động bằng cách đo lường mức độ gần này.
MongoDB sử dụng embedding như thế nào
Bản thân MongoDB không tạo embedding. Thay vào đó, nó tập trung vào thế mạnh:
Nói cách khác, mô hình của chúng ta tạo embedding, còn MongoDB đảm trách phần tìm kiếm.
Sự tách bạch rõ ràng này giúp hệ thống linh hoạt và dễ mở rộng.
Các loại mô hình embedding
Chúng ta có thể chọn bất kỳ mô hình embedding nào miễn là đầu ra là vector số. Các mô hình khác nhau chuyên biệt cho từng loại dữ liệu:
Loại dữ liệu
Mô hình ví dụ
Ghi chú
Văn bản
all-MiniLM-L6-v2Nhẹ và được dùng rộng rãi cho NLP
Hình ảnh
CLIP/OpenCLIP
Chuyển đổi hình ảnh thành vector ngữ nghĩa
Đa phương thức
Multimodal
Xử lý cả văn bản và hình ảnh cùng nhau
Đây là quy trình chúng ta sẽ triển khai bằng FastAPI và MongoDB Atlas.
Khi thiết lập xong, chúng ta có thể tìm kiếm văn bản và hình ảnh theo ý nghĩa—điều mà tìm kiếm từ khóa truyền thống không làm được.
Thiết lập MongoDB Atlas
Trước khi xây dựng ứng dụng FastAPI, chúng ta cần nơi để lưu trữ và truy vấn embedding. MongoDB Atlas giúp việc này đơn giản, và tạo vector index chỉ mất vài phút.
1. Tạo cụm
Nếu bạn chưa có, hãy tạo cụm mới trong MongoDB Atlas. Cụm miễn phí (M0) là đủ cho hướng dẫn này. Truy cập tài liệu MongoDB để biết thêm chi tiết về cách tạo cụm.
2. Tạo cơ sở dữ liệu và collection
Bên trong cụm:
vector_db. Để biết thêm chi tiết, xem tài liệu.texts: nơi lưu tài liệu văn bản và embedding của chúngimages: nơi lưu tên tệp ảnh và embedding ảnhTruy cập tài liệu để biết thêm chi tiết về cách tạo collection.
Chúng ta tách riêng collection hình ảnh và văn bản vì chúng dùng các mô hình embedding và số chiều vector khác nhau.
3. Tạo vector index
MongoDB cần vector index để thực hiện tìm kiếm độ tương đồng nhanh. Chúng ta sẽ tạo một index cho embedding văn bản và một cho embedding hình ảnh.
Bạn có thể tạo trong Atlas → Collections → Search Indexes. Hãy bắt đầu thiết lập cho collection văn bản.
Hình ảnh sau giải thích rõ hơn quy trình.
Ở màn tiếp theo, nhấp Vector Search ->JSON Editor -> Next. Hình dưới sẽ giúp bạn hiểu quy trình hơn
Vector index cho văn bản
Trong vector search index, chỉnh sửa JSON để khớp với mã của chúng ta.
Chúng ta dùng mô hình
all-MiniLM-L6-v2cho văn bản, tạo ra embedding 384 chiều.Đây là định nghĩa JSON:
Đặt tên index này:
vector_texts_searchvà lưu.Điều này cho phép MongoDB thực hiện tìm kiếm theo cosine similarity trên embedding văn bản. Hình bên dưới minh họa chi tiết hơn.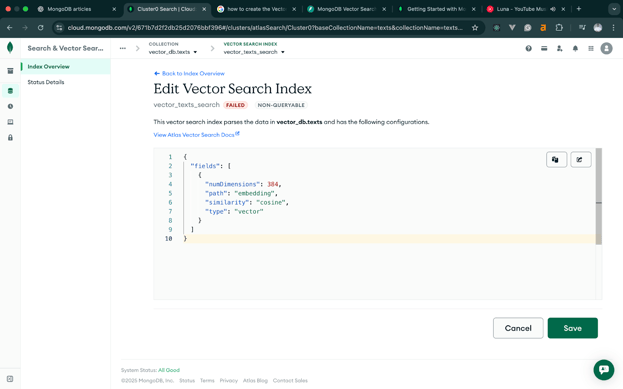
Vector index cho hình ảnh
Với hình ảnh, chúng ta dùng mô hình dựa trên CLIP cho ra vector 512 chiều, vì vậy index hình ảnh cần khớp số chiều đó. Định nghĩa JSON cần giống đoạn mã dưới đây. Ngoài ra, phần còn lại của luồng là như nhau.
Đặt tên index này:
vector_images_search.Khi cả hai index hoạt động, MongoDB Atlas đã sẵn sàng cho các truy vấn vector search.
Thiết lập dự án FastAPI
Khi cụm MongoDB Atlas và vector index đã sẵn sàng, chúng ta có thể thiết lập ứng dụng FastAPI để tạo embedding và lưu vào MongoDB. Chúng ta sẽ giữ cấu trúc dự án gọn nhẹ, tập trung vào quy trình thay vì xây dựng dịch vụ sản xuất hoàn chỉnh.
1. Cài đặt các phụ thuộc cần thiết
Chúng ta sẽ cài FastAPI, Uvicorn, driver Python của MongoDB và các thư viện để tạo embedding văn bản và hình ảnh. Chạy:
Giải thích nhanh vì sao cần các gói này:
.envSau khi cài xong, chúng ta sẵn sàng bố trí dự án.
2. Cấu trúc dự án
Chúng ta sẽ để mọi thứ trong một tệp Python, cấu hình thông qua biến môi trường:
main.py sẽ chứa toàn bộ ứng dụng: các endpoint cho văn bản, hình ảnh và kết nối MongoDB.
FastAPI sẽ tải các giá trị này khi ứng dụng khởi động, tách biệt cấu hình khỏi mã nguồn.
Triển khai tìm kiếm văn bản
Với dự án FastAPI đã sẵn sàng, chúng ta bắt đầu với quy trình tìm kiếm văn bản. Phần này giới thiệu ý tưởng cốt lõi của vector search: Tạo embedding cho văn bản, lưu vào MongoDB và truy vấn bằng vector index đã tạo trước đó.
Chúng ta sẽ chia thành hai bước nhỏ để dễ kiểm thử và gỡ lỗi.
a. Thêm văn bản và tạo embedding
Endpoint đầu tiên sẽ nhận tiêu đề và nội dung. Chúng ta sẽ gộp hai trường thành một chuỗi, tạo embedding bằng SentenceTransformers và lưu tài liệu kèm vector embedding.
Mã minh họa:
Cách kiểm thử endpoint này
Có thể dùng cURL, Postman hoặc các công cụ kiểm thử API tương tự. Trong hướng dẫn này, chúng ta sẽ kiểm thử bằng Postman.
Chúng ta cũng cần mở endpoint FastAPI ra Internet để kiểm thử bằng Postman trên web. Sẽ dùng Ngrok cho việc này. Nếu bạn mới dùng Ngrok, truy cập tài liệu. Để kiểm thử, trước tiên chạy mã FastAPI bằng lệnh dưới đây:
Sau đó, tạo đường hầm từ
localhostra Internet bằng lệnh Ngrok sau:Lệnh này sẽ tạo URL để kiểm thử, như hình dưới:
Gửi yêu cầu
POSTbằng Postman tới endpointadd-text. Hình dưới minh họa quy trình gửi yêu cầu và phản hồi mong đợi.Phản hồi kỳ vọng:
Điều này xác nhận mô hình embedding đã tải đúng và MongoDB đã lưu vector. Nếu chạy được, pipeline văn bản của bạn đang hoạt động.
b. Tìm kiếm văn bản bằng vector search
Giờ khi đã thêm được văn bản, bước tiếp theo là tìm kiếm bằng $vectorSearch của MongoDB. Ở đây, chúng ta:
Thêm endpoint sau vào
main.py:> Tham số numCandidates xác định có bao nhiêu ứng viên được đánh giá trước khi trả về kết quả hàng đầu.
> Giá trị cao hơn cải thiện độ chính xác nhưng tăng thời gian truy vấn. Kinh nghiệm: đặt khoảng 10–20 lần giới hạn trả về.
Cách kiểm thử tìm kiếm văn bản
Sau khi thêm một hoặc nhiều tài liệu, gửi yêu cầu POST tới endpoint
/search-textqua Postman dùng liên kết Ngrok đã tạo, như hình dưới:Đầu ra kỳ vọng:
Nếu bạn thấy kết quả có điểm tương đồng, pipeline vector search cho văn bản đã hoạt động end-to-end. Khi phần này ổn định, chúng ta sẵn sàng chuyển sang quy trình hình ảnh.
Triển khai tìm kiếm hình ảnh
Khi quy trình văn bản đã chạy trơn tru, chúng ta mở rộng cùng ý tưởng cho hình ảnh. Luồng tổng thể tương tự—điểm khác biệt lớn là cách tạo embedding. Thay vì SentenceTransformers, ta dùng mô hình dựa trên CLIP, được thiết kế để chuyển ảnh thành vector 512 chiều.
Giống như trước, ta sẽ triển khai từng bước để dễ kiểm thử và gỡ lỗi.
a. Thêm hình ảnh và tạo embedding
Endpoint này nhận tệp ảnh tải lên, chuyển thành tensor mà CLIP hiểu được, tạo embedding 512 chiều và lưu vào MongoDB.
Mã minh họa:
Vì sao chuẩn hóa quan trọng
Embedding của CLIP hoạt động tốt nhất với cosine similarity. Để so sánh chính xác và ổn định, chúng ta chuẩn hóa vector:
Việc này đảm bảo khoảng cách cosine phản ánh đúng độ tương đồng.
Kiểm thử endpoint tải ảnh
Để kiểm thử trong Postman, gửi yêu cầu
POSTtới endpoint/add-image. Gửi form-data trong phần thân yêu cầu kèm bất kỳ ảnh.jpghoặc.png. Hình dưới minh họa thêm.Nếu mọi thứ hoạt động, bạn sẽ nhận được:
Lúc này embedding hình ảnh của bạn đã được lưu thành công vào MongoDB.
b. Tìm kiếm hình ảnh bằng vector search
Giờ chúng ta xây dựng endpoint nhận ảnh truy vấn được tải lên, chuyển thành embedding và tìm các ảnh lưu trữ gần nhất bằng vector index cho ảnh.
Thêm vào
main.py:Kiểm thử endpoint tìm kiếm ảnh
Để kiểm thử trong Postman, gửi yêu cầu
POSTtới endpoint/search-image. Gửi form-data trong phần thân với ảnh tương tự những gì bạn đã lưu trước đó. Hình dưới minh họa thêm.Đầu ra kỳ vọng như sau:
Điểm 1.0 nghĩa là trùng khớp chính xác cùng ảnh. Bất kỳ giá trị gần (0,7–0,9) cho thấy độ tương đồng thị giác cao.
Nếu bạn thấy một mảng kết quả, tìm kiếm vector cho hình ảnh của bạn đã hoạt động.
Tại thời điểm này, nếu mọi thứ chạy tốt, chúng ta đã có hệ thống tìm kiếm ngữ nghĩa hoàn chỉnh cho cả văn bản lẫn hình ảnh.
Kết luận
Trong hướng dẫn này, chúng ta đã xây dựng quy trình tìm kiếm ngữ nghĩa hoàn chỉnh bằng FastAPI và MongoDB Atlas. Chúng ta tạo embedding văn bản với SentenceTransformers, tạo embedding hình ảnh bằng mô hình CLIP, lưu mọi thứ vào MongoDB và truy vấn bằng Vector Search của MongoDB và Postman. Mẫu này là nền tảng cho các ứng dụng như tìm kiếm tài liệu theo ngữ nghĩa, công cụ tìm ảnh tương tự, hệ thống gợi ý và tính năng AI đa phương thức.
Điều làm cho kiến trúc này mạnh mẽ là tính linh hoạt: MongoDB không khóa bạn vào các mô hình cụ thể. Miễn là embedding là vector số và số chiều khớp cấu hình index, bạn có thể cắm bất kỳ mô hình embedding văn bản, hình ảnh hoặc đa phương thức nào phù hợp với bài toán.
Với nền tảng này, bạn có thể mở rộng dự án—lưu metadata, xây dựng logic xếp hạng, hoặc tích hợp với ứng dụng hướng người dùng. Quy trình tương tự cũng mở rộng dễ dàng nhờ dịch vụ quản lý toàn phần của MongoDB Atlas.
Bạn có thể tìm dự án hoàn chỉnh hoạt động trên GitHub.