50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Zoeken op trefwoorden werkt prima voor simpele opzoekopdrachten, maar schiet al snel tekort zodra betekenis belangrijker is dan exacte bewoording. Als het ene document het heeft over “reactietijden verbeteren” en een ander over “prestaties verhogen”, behandelt een traditionele zoekmachine ze als losstaand, terwijl ze in feite hetzelfde idee beschrijven. We verliezen de semantische samenhang simpelweg doordat de formulering anders is.
Vector search lost deze beperking op door tekst en beelden te representeren als embeddings: numerieke vectoren die door machinelearningmodellen worden gegenereerd en die context, intentie en semantische gelijkenis vastleggen. Zodra we deze embeddings in MongoDB opslaan, kunnen we ze bevragen om items te vinden die inhoudelijk echt verwant zijn, ongeacht de exacte termen die gebruikt zijn.
In deze tutorial bouwen we een praktisch end-to-end voorbeeld van deze workflow met FastAPI en MongoDB Atlas Vector Search. We genereren tekste mbeddings met SentenceTransformers en afbeeldingsembeddings met een op CLIP gebaseerd model, slaan beide op in MongoDB en voeren er gelijkeniszoekacties op uit. Aan het einde heb je een werkende basis die semantische artikelzoekopdrachten, productaanbevelingen, tools voor visuele gelijkenis en veel andere toepassingen in de praktijk kan ondersteunen.
Laten we aan de slag gaan.
Voor we gaan bouwen, hebben we een paar dingen nodig. Deze tutorial gaat uit van basiskennis van Python, FastAPI en MongoDB, maar we gebruiken niets geavanceerds—alles wat we inzetten lichten we gaandeweg toe.
Dit heb je nodig:
Die installeren we tijdens de setup:
Met deze tools kunnen we embeddings genereren, ze in MongoDB opslaan en ze efficiënt bevragen met vector search.
Voor we code schrijven, is het handig om te begrijpen wat er onder de motorkap gebeurt. Vector search is niet ingewikkeld als je het opdeelt, en met de basiskennis is de rest van de tutorial makkelijker te volgen.
Een embedding is simpelweg een lijst met getallen (een vector) die de betekenis van een stukje data representeert.
Voor tekst legt de embedding dingen vast als context en intentie. Voor afbeeldingen gaat het om visuele patronen en kenmerken.
Een sterk vereenvoudigd voorbeeld van een embedding ziet er zo uit:
[0.21, -0.17, 0.89, ...]Twee dingen die semantisch vergelijkbaar zijn—bijvoorbeeld twee zinnen die hetzelfde idee beschrijven, of twee afbeeldingen met vergelijkbare objecten—zullen vectoren krijgen die wiskundig dicht bij elkaar liggen. Vector search werkt door deze nabijheid te meten.
MongoDB genereert zelf geen embeddings. In plaats daarvan doet het waar het goed in is:
Met andere woorden: onze modellen genereren de embeddings, en MongoDB verzorgt het zoeken.
Deze duidelijke scheiding maakt het systeem zowel flexibel als schaalbaar.
We kunnen elk embeddingmodel kiezen zolang het een numerieke vector oplevert. Verschillende modellen zijn gespecialiseerd in verschillende typen data:
|
Datatype |
Voorbeeldmodel |
Opmerkingen |
|
Tekst |
|
Lichtgewicht en veelgebruikt voor NLP |
|
Afbeelding |
CLIP/OpenCLIP |
Zet afbeeldingen om in semantische vectoren |
|
Multimodaal |
Multimodaal |
Verwerkt tekst en afbeeldingen samen |
Dit is de workflow die we implementeren met FastAPI en MongoDB Atlas.
Eenmaal opgezet, kun je zoeken in tekst en beelden op betekenis—iets wat traditioneel trefwoordzoeken niet kan.
Voordat we de FastAPI-app bouwen, hebben we een plek nodig om onze embeddings op te slaan en te bevragen. MongoDB Atlas maakt dit eenvoudig, en het instellen van vectorindexen kost maar een paar minuten.
Als je er nog geen hebt, maak dan een nieuw cluster in MongoDB Atlas. Een gratis M0-cluster is voor deze tutorial prima. Raadpleeg de MongoDB-documentatie voor meer details over hoe je een cluster maakt.
In het cluster:
vector_db. Voor meer details, zie de documentatie.texts: hier slaan we tekstdocumenten en hun embeddings opimages: hier bewaren we bestandsnamen en afbeeldingsembeddingsBekijk de documentatie voor meer details over hoe je een collectie maakt.
We houden de afbeeldingencollectie en de tekstcollectie gescheiden omdat ze verschillende embeddingmodellen en verschillende vectordimensies gebruiken.
MongoDB heeft een vectorindex nodig voor snelle gelijkeniszoekacties. We maken één index voor tekste mbeddings en één voor afbeeldingsembeddings.
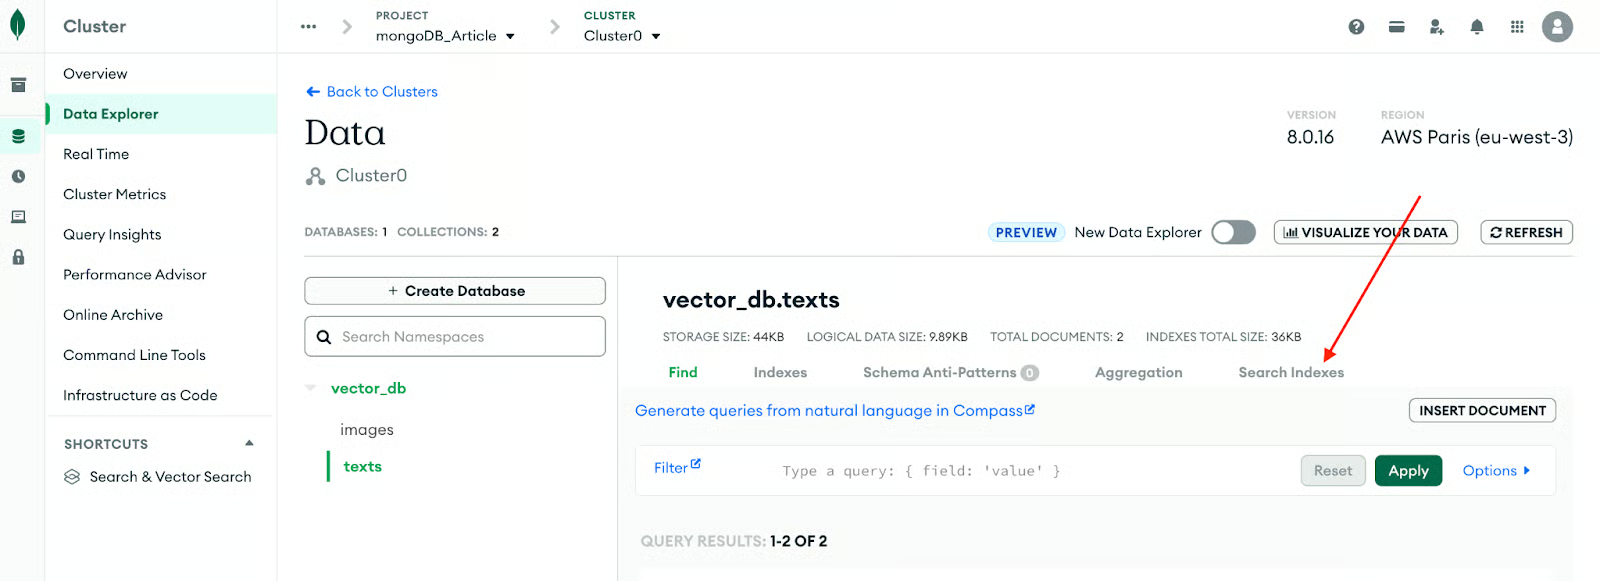
Je kunt deze maken in Atlas → Collections → Search Indexes. Laten we beginnen met de tekstcollectie.
De onderstaande afbeelding verduidelijkt het proces.
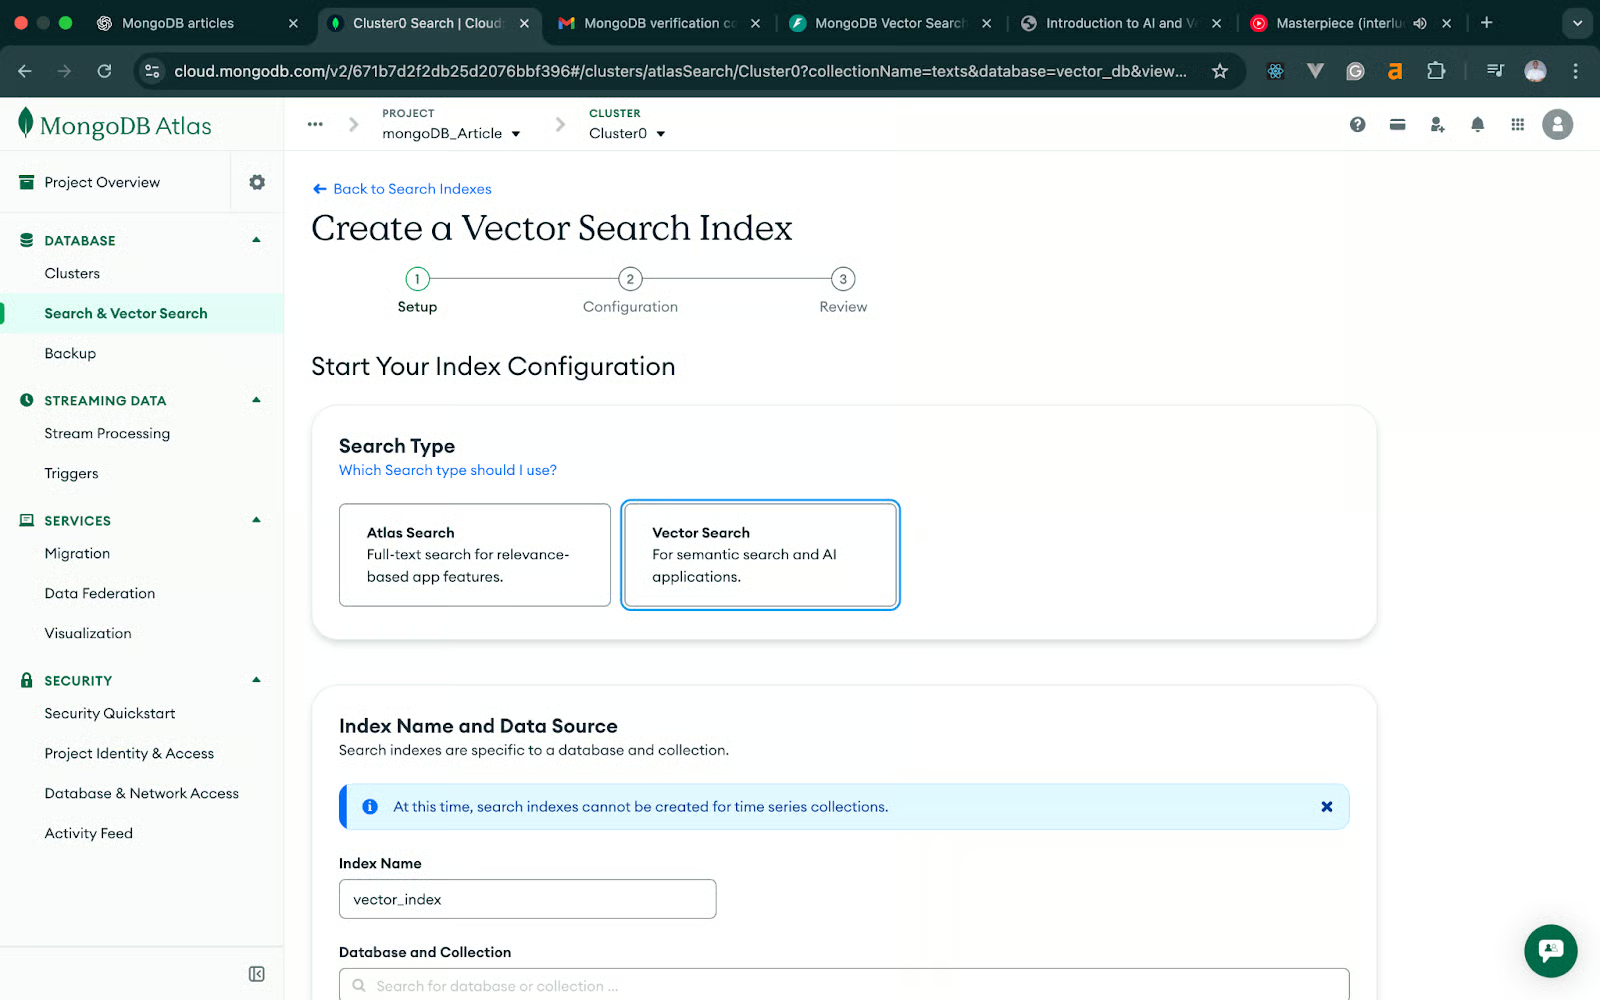
Klik op het volgende scherm op Vector Search -> JSON Editor -> Next. De volgende afbeelding helpt je het proces beter te begrijpen
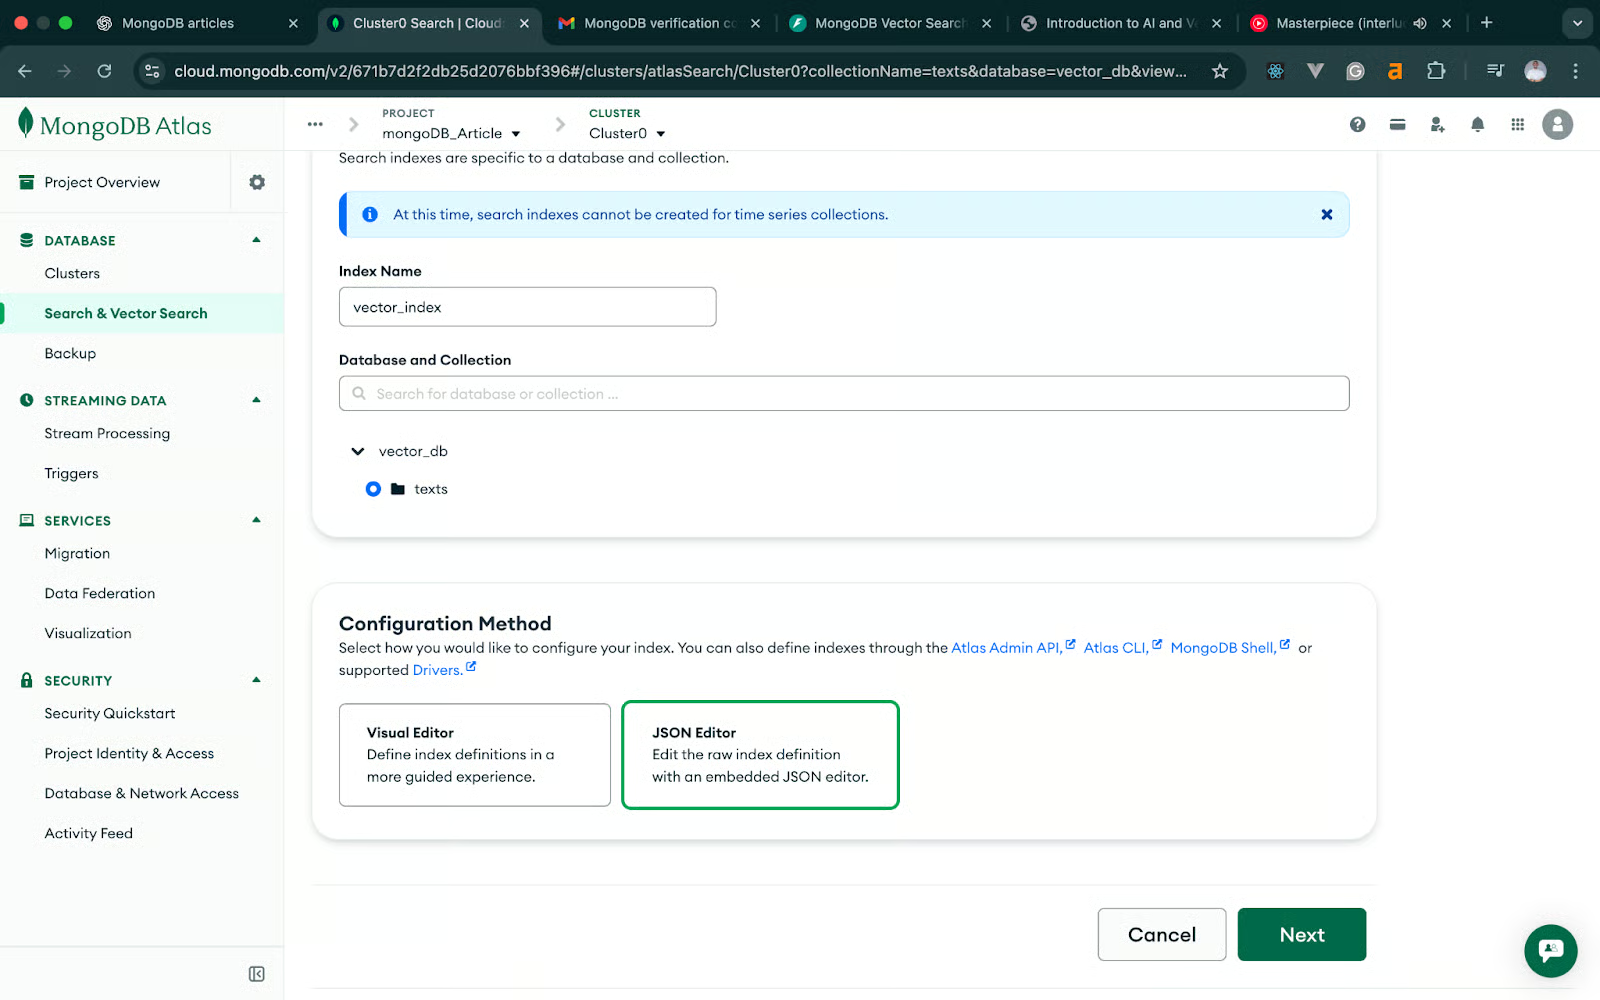
Pas in de vectorzoekindex de JSON-tekst aan zodat die overeenkomt met onze code.
We gebruiken het model all-MiniLM-L6-v2 voor tekst, dat 384-dimensionale embeddings oplevert.
Hier is de JSON-definitie:
{
  "fields": [
    {
      "type": "vector",
      "path": "embedding",
      "numDimensions": 384,
      "similarity": "cosine"
    }
  ]
}
Geef deze index de naam: vector_texts_search en sla op.
Dit stelt MongoDB in staat om cosinusgelijkenis te gebruiken voor tekste mbeddings. De afbeelding hieronder licht het proces verder toe.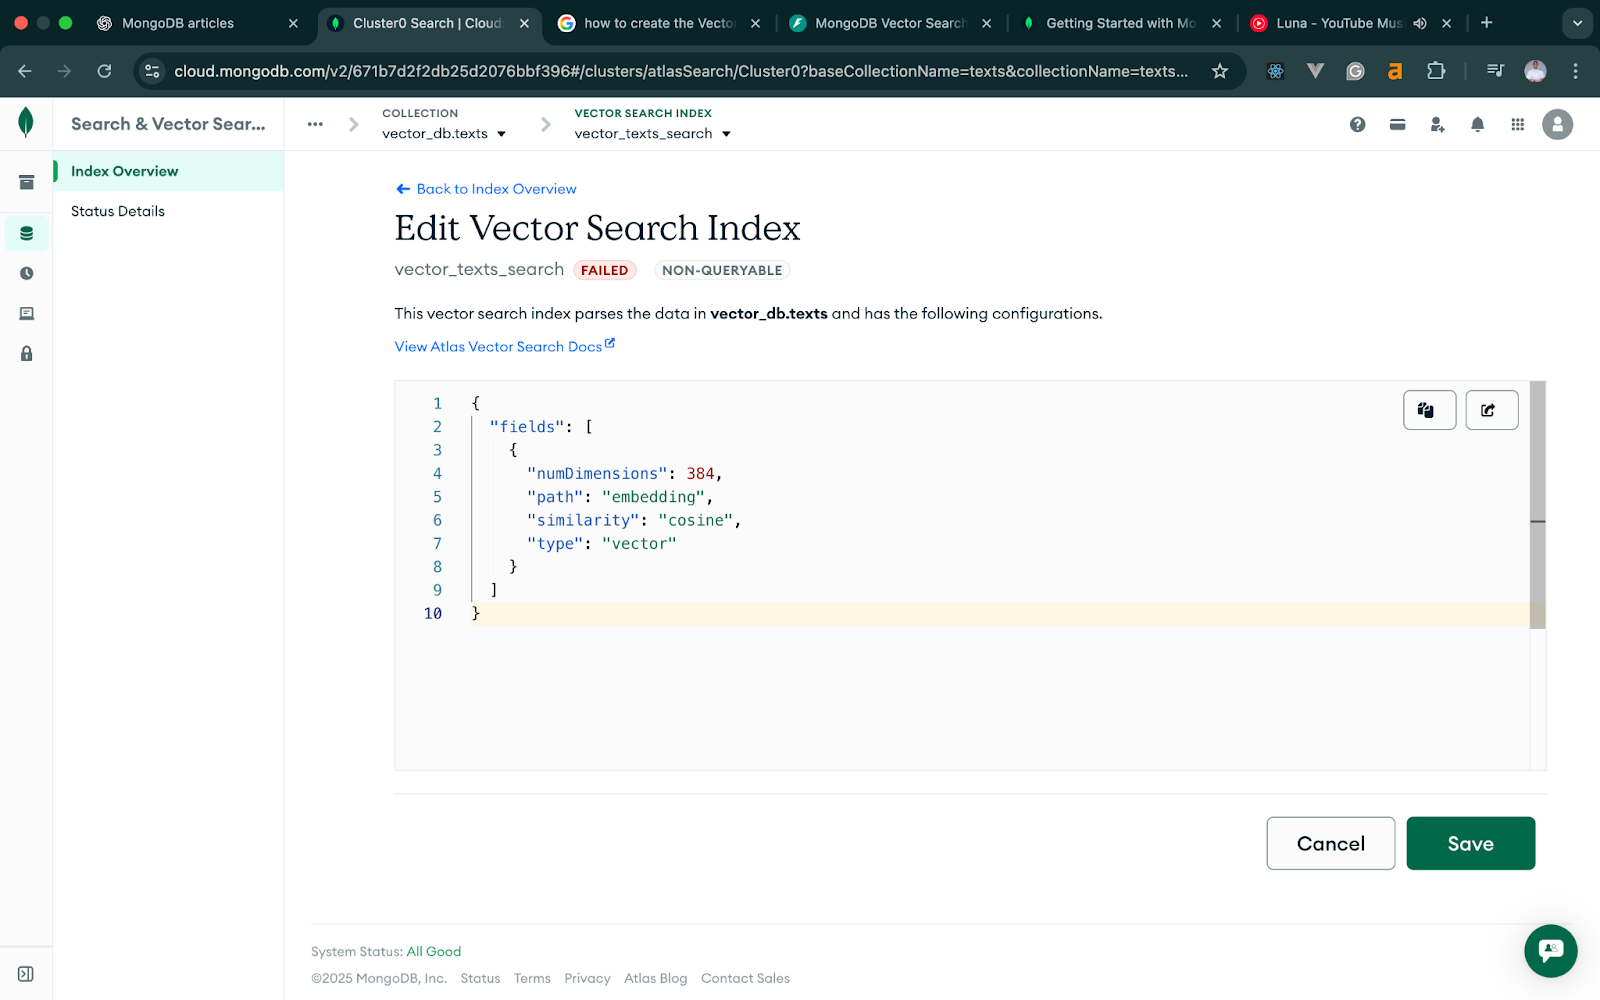
Voor afbeeldingen gebruiken we een CLIP-gebaseerd model dat 512-dimensionale vectoren oplevert, dus de afbeeldingindex moet die dimensie volgen. De JSON-definitie moet overeenkomen met de onderstaande code. Afgezien daarvan is de rest van de flow hetzelfde.
{
  "fields": [
    {
      "type": "vector",
      "path": "embedding",
      "numDimensions": 512,
      "similarity": "cosine"
    }
  ]
}
Noem deze index: vector_images_search.
Zodra beide indexen actief zijn, is MongoDB Atlas klaar voor vectorzoekopdrachten.
Nu ons MongoDB Atlas-cluster en de vectorindexen klaar zijn, kunnen we de FastAPI-app opzetten die embeddings genereert en ze in MongoDB opslaat. We houden de projectstructuur klein en gefocust, omdat deze tutorial draait om de workflow begrijpen en niet om een volledige productie-service te bouwen.
We installeren FastAPI, Uvicorn, de Python-driver voor MongoDB en de libraries die nodig zijn om tekst- en afbeeldingsembeddings te genereren. Voer uit:
pip install fastapi uvicorn pymongo python-dotenv sentence-transformers torch pillow open_clip_torch python-multipartKort waarom we deze nodig hebben:
.envNa installatie kunnen we de projectindeling neerzetten.
We houden alles in één Python-bestand, met configuratie via omgevingsvariabelen:
fastapi-mongodb-vector-search/
│── main.py
│── .env
│── venv/
main.py bevat de hele applicatie: de tekst-endpoints, de afbeelding-endpoints en de MongoDB-verbinding.
MONGODB_URI="your connection string"
DB_NAME="vector_db"
TEXT_COLLECTION="texts"
IMAGE_COLLECTION="images"FastAPI laadt deze bij het starten van de app, zodat de configuratie gescheiden blijft van de code.
Met ons FastAPI-project klaar, beginnen we met de tekstzoek-workflow. Dit deel introduceert de kern van vector search: we genereren embeddings voor onze tekst, slaan ze op in MongoDB en bevragen ze via de vectorindex die we eerder maakten.
We doen dit in twee kleine stappen zodat alles makkelijk te testen en debuggen is.
Het eerste endpoint accepteert een titel en wat tekstinhoud. We combineren beide velden tot één string, genereren een embedding met SentenceTransformers en slaan het document samen met de embeddingvector op.
Zo ziet dat eruit in code:
# main.py (excerpt)

from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from pymongo import MongoClient
from sentence_transformers import SentenceTransformer
from dotenv import load_dotenv
import os

load_dotenv()

app = FastAPI()

# --- DB setup ---
client = MongoClient(os.getenv("MONGODB_URI"))
db = client[os.getenv("DB_NAME")]
texts_coll = db[os.getenv("TEXT_COLLECTION")]
Images_coll = db[os.getenv("IMAGE_COLLECTION")]


# --- text embedding model ---
MODEL_NAME = "all-MiniLM-L6-v2"
text_model = SentenceTransformer(MODEL_NAME)

# --- request schema ---
class AddTextRequest(BaseModel):
    title: str
    content: str

@app.post("/add-text")
def add_text(payload: AddTextRequest):
    try:
        # Combine fields for richer embeddings
        text = f"{payload.title}\n\n{payload.content}"

        # Generate text embedding
        embedding = text_model.encode(text).tolist()

        # Store document in MongoDB
        doc = {
            "title": payload.title,
            "content": payload.content,
            "embedding": embedding,
            "model": MODEL_NAME,
        }

        result = texts_coll.insert_one(doc)

        return {
            "inserted_id": str(result.inserted_id),
            "title": payload.title
        }
    except Exception as e:
raise HTTPException(status_code=500, detail=str(e))Je kunt cURL, Postman en vergelijkbare API-testtools gebruiken. Voor deze tutorial testen we met Postman.
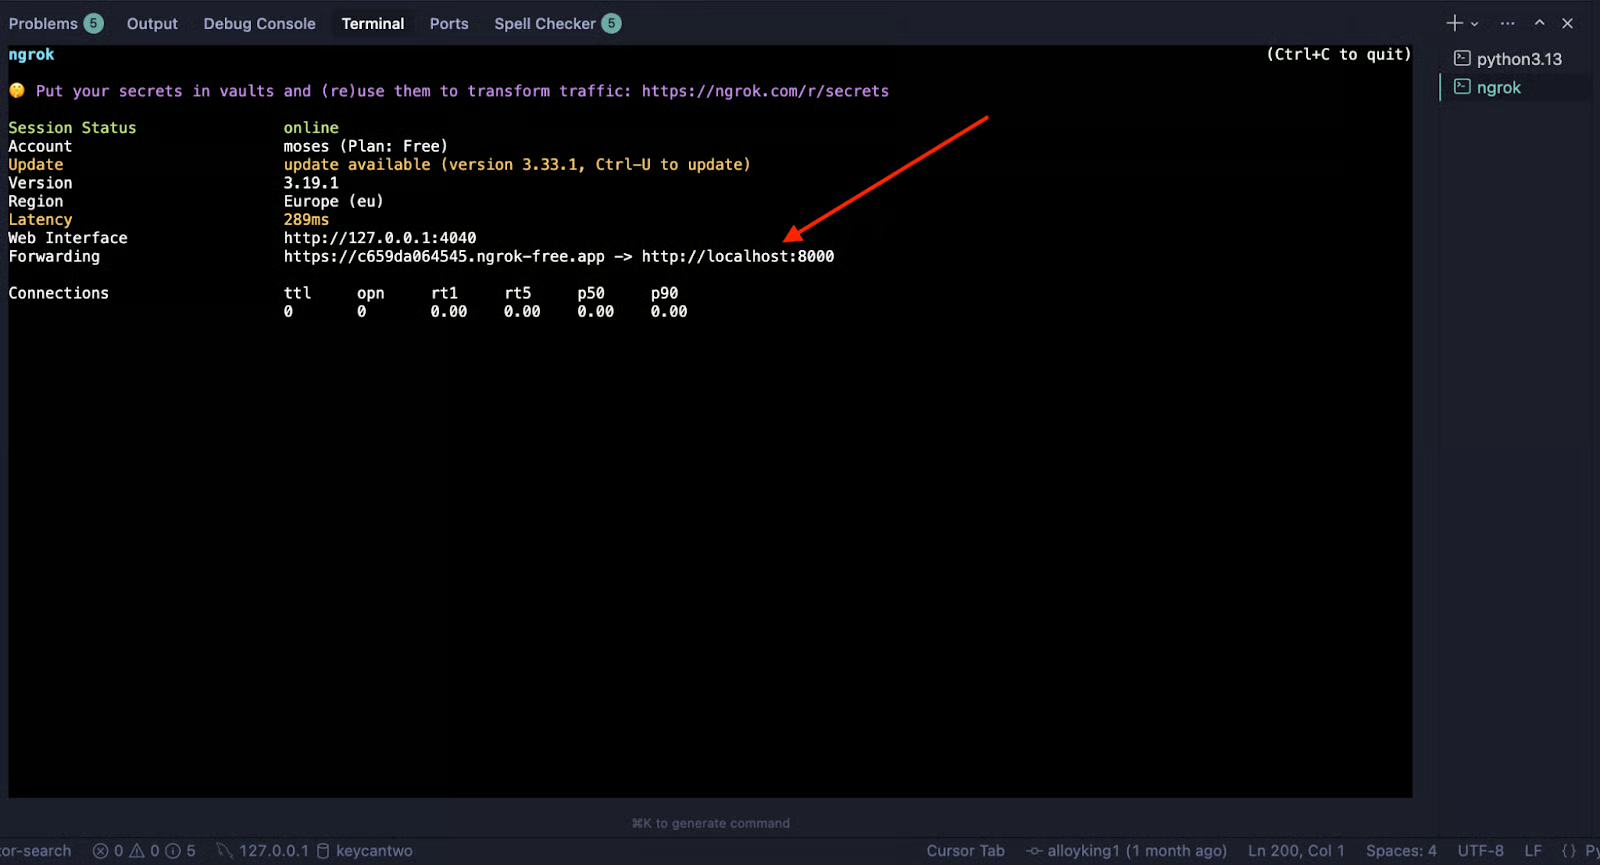
We moeten ons FastAPI-endpoint ook blootstellen aan het internet zodat we via Postman in de browser kunnen testen. Daarvoor gebruiken we Ngrok. Ben je nieuw met Ngrok, bekijk de documentatie. Om te testen, voer eerst de FastAPI-code uit met onderstaand commando:
uvicorn main:app --reloadTunnel vervolgens je localhost naar het internet met het onderstaande Ngrok-commando:
Ngrok http 8000Hiermee krijg je een URL om mee te testen, zoals in de onderstaande afbeelding:
Stuur een POST-request via Postman naar het add-text-endpoint. De onderstaande afbeelding laat zien hoe je de request verstuurt en de verwachte response.
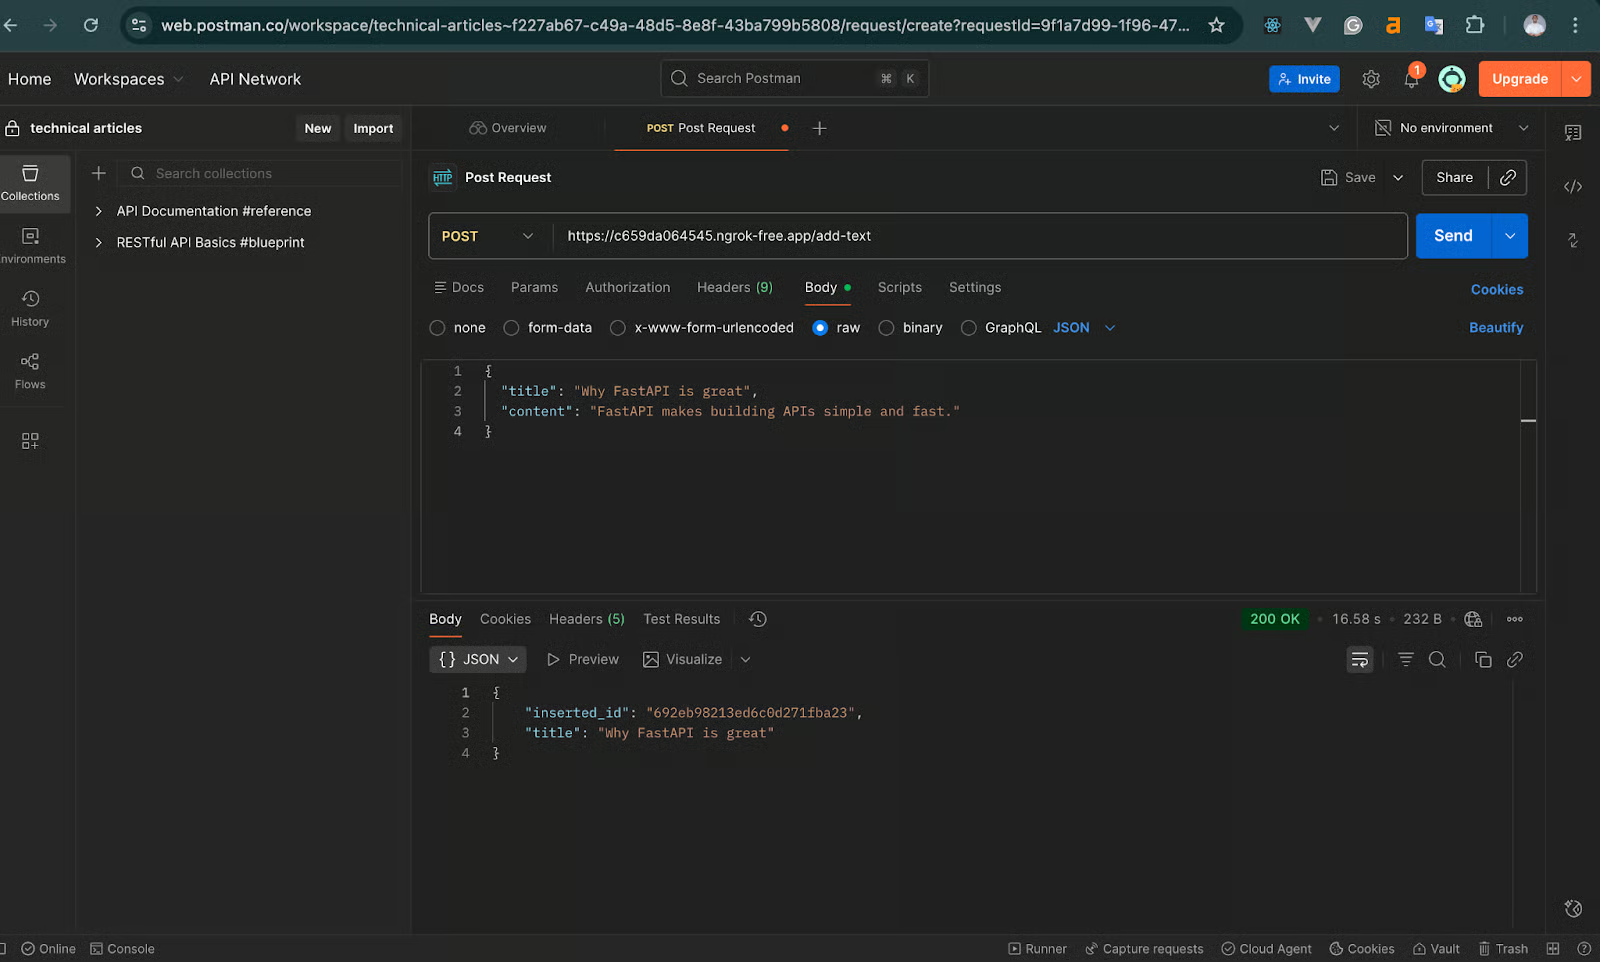
Verwachte response:
{
  "inserted_id": "65f...",
  "title": "Why FastAPI is great."
}
Dit bevestigt dat je embeddingmodel correct is geladen en dat MongoDB de vector heeft opgeslagen. Als dit werkt, functioneert je tekstpipeline.
Nu we tekst kunnen toevoegen, is de volgende stap zoeken met MongoDB’s $vectorSearch-fase. Hierbij:
Voeg het volgende endpoint toe aan main.py:
class SearchTextRequest(BaseModel):
    query: str
    limit: int = 5

@app.post("/search-text")
def search_text(payload: SearchTextRequest):
    try:
        # Convert search query to embedding
        query_vector = text_model.encode(payload.query).tolist()

        # Vector search pipeline
        pipeline = [
            {
                "$vectorSearch": {
                    "queryVector": query_vector,
                    "path": "embedding",
                    "numCandidates": 100,
                    "limit": payload.limit,
                    "index": "vector_texts_search" # field MUST match the index name in Atlas exactly


                }
            },
            {
                "$project": {
                    "title": 1,
                    "content": 1,
                    "score": {"$meta": "vectorSearchScore"},
                    "_id": 0
                }
            }
        ]

        results = list(texts_coll.aggregate(pipeline))
        return {"results": results}

    except Exception as e:
        raise HTTPException(status_code=500, detail=str(e))
> De parameter numCandidates bepaalt hoeveel potentiële matches worden geëvalueerd voordat de beste resultaten worden teruggegeven.
> Hogere waarden verbeteren de nauwkeurigheid maar vergroten de querytijd. Een goede vuistregel is 10-20x je limit.
Nadat je een of meer documenten hebt toegevoegd, doe je een POST-request naar het /search-text-endpoint via Postman met onze Ngrok-link, zoals in de afbeelding hieronder:
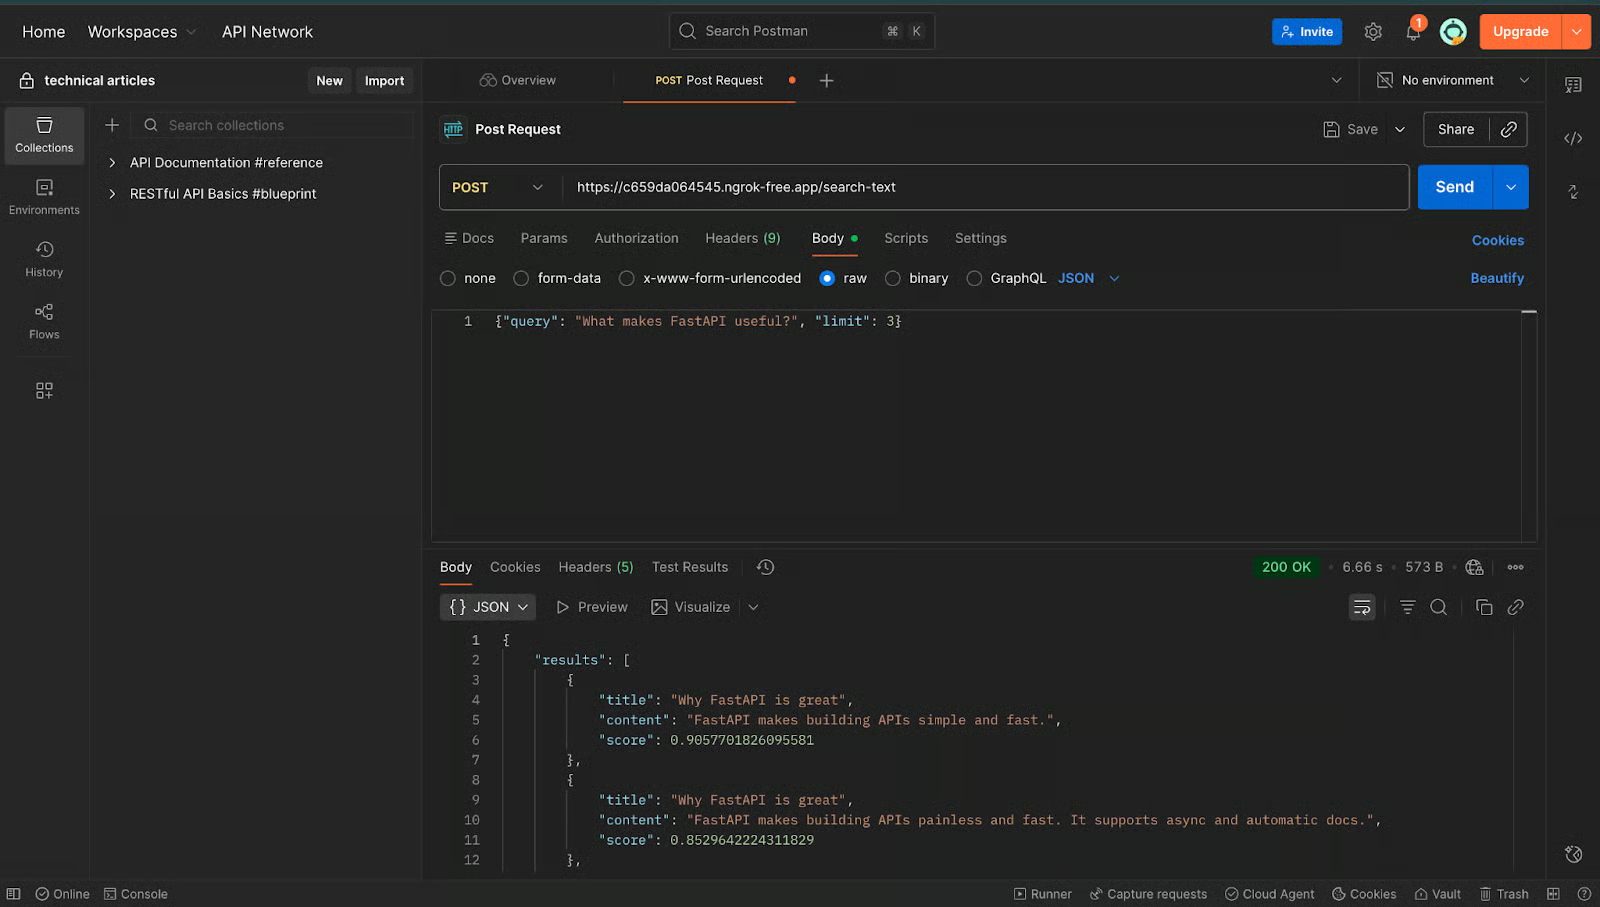
Verwachte output:
{
  "results": [
    {
      "title": "Why FastAPI is great",
      "content": "FastAPI makes building APIs simple and fast.",
      "score": 0.85
    }
  ]
}
Als je een resultaat met een gelijkenisscore ziet, werkt je tekstvectorzoekpipeline end-to-end. Als dit stabiel werkt, kunnen we door naar de afbeeldingsworkflow.
Nu de tekstworkflow soepel draait, kunnen we hetzelfde idee uitbreiden naar afbeeldingen. De algemene flow is vergelijkbaar—het enige grote verschil is hoe we embeddings genereren. In plaats van SentenceTransformers gebruiken we een CLIP-gebaseerd model, dat is ontworpen om afbeeldingen om te zetten in 512-dimensionale vectoren.
Net als eerder implementeren we dit stap voor stap, zodat het makkelijk te testen en debuggen is.
Dit endpoint accepteert een geüpload afbeeldingsbestand, zet het om naar een tensor die CLIP begrijpt, genereert een 512-dimensionale embedding en slaat die op in MongoDB.
Zo ziet dat eruit:
# --- CLIP model setup ---
import torch
import open_clip
from PIL import Image
import io
from fastapi import UploadFile, File

# Load CLIP model once when the app starts
clip_model, _, preprocess = open_clip.create_model_and_transforms(
    "ViT-B-32",
    pretrained="openai"
)
device = "cuda" if torch.cuda.is_available() else "cpu"
clip_model.to(device)

@app.post("/add-image")
async def add_image(file: UploadFile = File(...)):
    """
    Upload an image, generate its CLIP embedding, and store in MongoDB.
    """
    try:
        # Read file contents
        image_bytes = await file.read()
        image = Image.open(io.BytesIO(image_bytes)).convert("RGB")

        # Preprocess for CLIP and encode
        image_tensor = preprocess(image).unsqueeze(0).to(device)
        with torch.no_grad():
            image_embedding = clip_model.encode_image(image_tensor)

        # Normalize the embedding (important for cosine similarity)
        image_embedding /= image_embedding.norm(dim=-1, keepdim=True)
        vector = image_embedding.cpu().numpy().flatten().tolist()

        # Store in MongoDB
        doc = {
            "filename": file.filename,
            "embedding": vector
        }
        result = images_coll.insert_one(doc)

        return {
            "inserted_id": str(result.inserted_id),
            "filename": file.filename
        }

    except Exception as e:
raise HTTPException(status_code=500, detail=str(e))CLIP-embeddings werken het best met cosinusgelijkenis. Om vergelijkingen nauwkeurig en stabiel te maken, normaliseren we de vectoren:
image_embedding /= image_embedding.norm(dim=-1, keepdim=True)Dit zorgt ervoor dat cosinusafstand echte gelijkenis weerspiegelt.
Om deze feature in Postman te testen, doe je een POST-request naar het /add-image-endpoint. Verstuur als body form-data met een .jpg- of .png-afbeelding. De onderstaande afbeelding laat het proces zien.
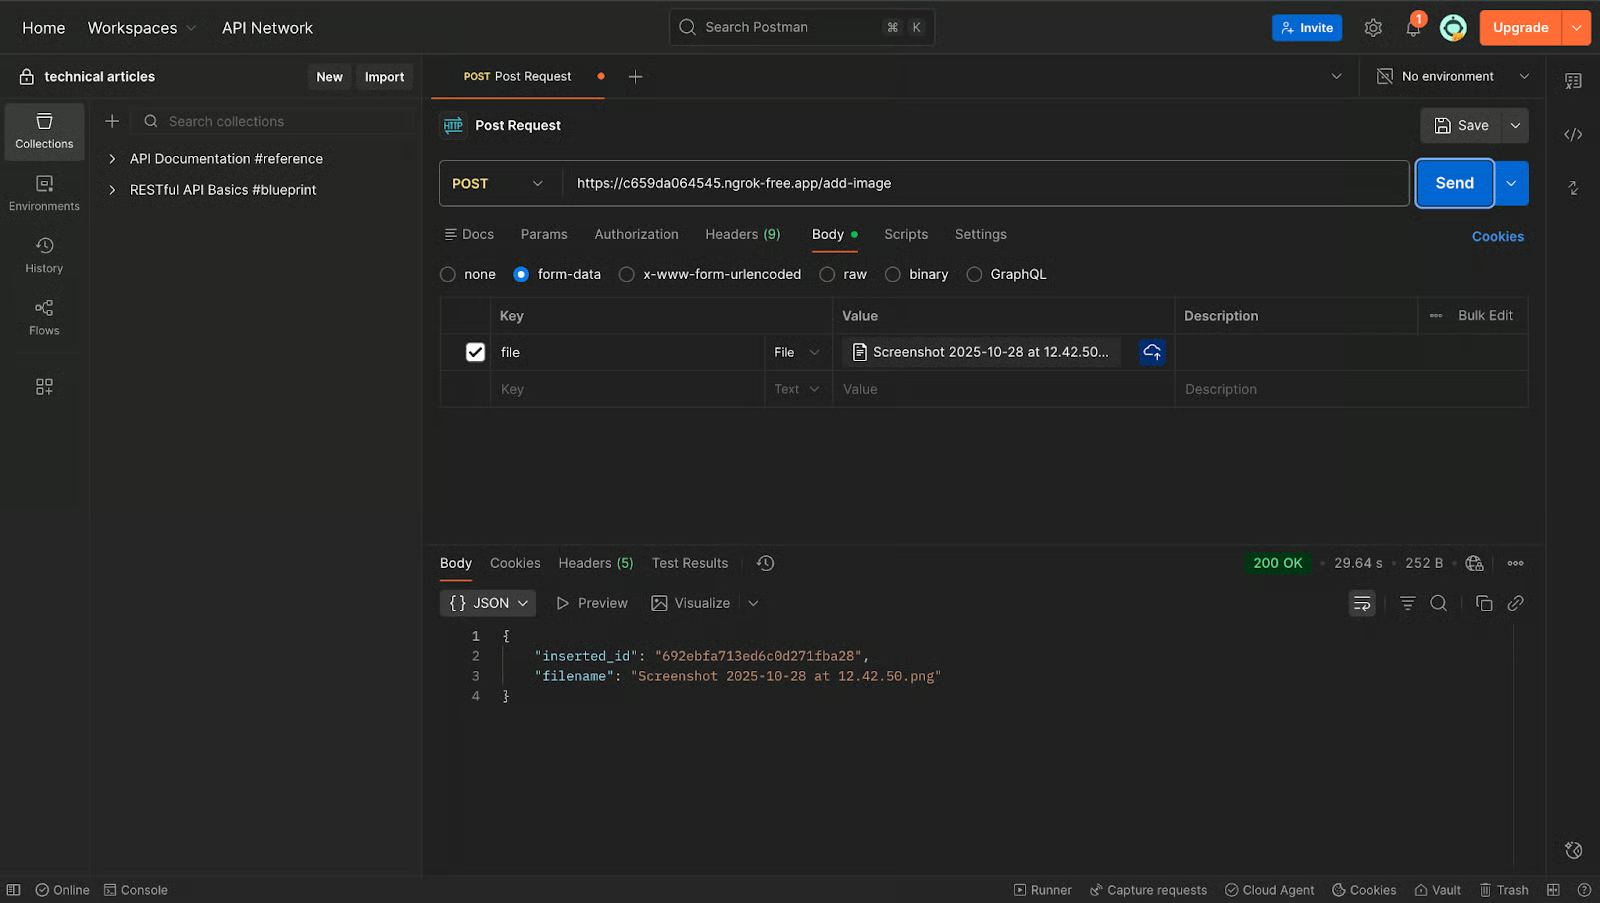
Als alles werkt, krijg je ongeveer dit terug:
{
  "inserted_id": "692454f6156fbb762ed865a0",
  "filename": "file-name.png"
}
Op dit punt zijn je afbeeldingsembeddings succesvol opgeslagen in MongoDB.
Nu kunnen we het endpoint bouwen dat een geüploade query-afbeelding omzet in een embedding en de dichtstbijzijnde opgeslagen afbeeldingen vindt met onze afbeeldingvectorindex.
Voeg dit toe aan main.py:
@app.post("/search-image")
async def search_image(file: UploadFile = File(...)):
    """
    Upload an image and find the most visually similar images in MongoDB.
    """
    try:
        # Read the uploaded file
        image_bytes = await file.read()
        image = Image.open(io.BytesIO(image_bytes)).convert("RGB")

        # Generate embedding for the query image
        image_tensor = preprocess(image).unsqueeze(0).to(device)
        with torch.no_grad():
            query_embedding = clip_model.encode_image(image_tensor)

        query_embedding /= query_embedding.norm(dim=-1, keepdim=True)
        query_vector = query_embedding.cpu().numpy().flatten().tolist()

        # Vector search pipeline
        pipeline = [
            {
                "$vectorSearch": {
                    "queryVector": query_vector,
                    "path": "embedding",
                    "numCandidates": 100,
                    "limit": 5,
                    "index": "vector_images_search"
                }
            },
            {
                "$project": {
                    "filename": 1,
                    "score": {"$meta": "vectorSearchScore"},
                    "_id": 0
                }
            }
        ]

        results = list(images_coll.aggregate(pipeline))
        return {"results": results}

    except Exception as e:
raise HTTPException(status_code=500, detail=str(e))Om deze feature in Postman te testen, doe je een POST-request naar het /search-image-endpoint. Verstuur als body form-data met een afbeelding die lijkt op wat je eerder hebt opgeslagen. De onderstaande afbeelding laat het proces zien.
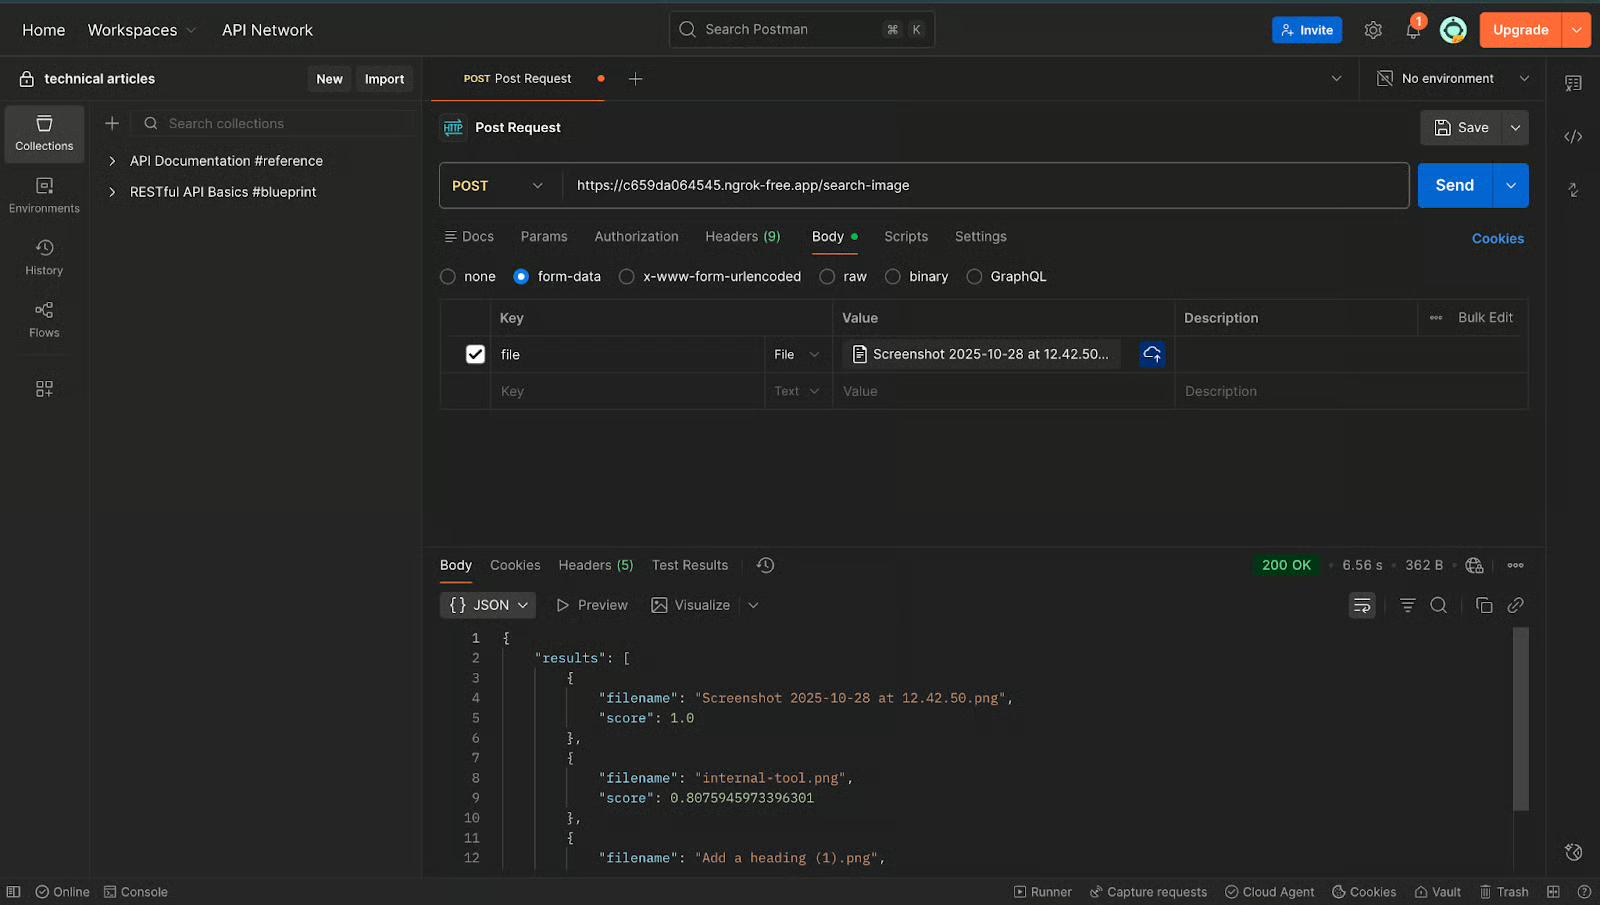
De verwachte output ziet er zo uit:
{
  "results": [
    {
      "filename": "image1.png",
      "score": 1.0
    },
    {
      "filename": "image2.png",
      "score": 0.81
    }
  ]
}
Een score van 1,0 betekent dat exact dezelfde afbeelding matcht. Alles in de buurt (0,7–0,9) duidt op sterke visuele gelijkenis.
Als je een array met resultaten ziet, werkt je beeldvectorzoekopdracht nu.
Als alles werkt, hebben we nu een compleet semantisch zoeksysteem voor zowel tekst als afbeeldingen.
In deze tutorial hebben we een complete semantische zoekworkflow gebouwd met FastAPI en MongoDB Atlas. We hebben tekste mbeddings gegenereerd met SentenceTransformers, afbeeldingsembeddings met een CLIP-model, alles opgeslagen in MongoDB en bevragingen uitgevoerd met MongoDB’s Vector Search en Postman. Dit patroon vormt de basis voor toepassingen zoals semantische documentzoekopdrachten, tools voor afbeeldingsgelijkenis, aanbevelingssystemen en multimodale AI-features.
Wat deze architectuur krachtig maakt, is de flexibiliteit: MongoDB legt je geen specifieke modellen op. Zolang de embeddings numerieke vectoren zijn en de dimensies overeenkomen met je indexconfiguratie, kun je elk tekst-, beeld- of multimodaal embeddingmodel gebruiken dat jouw usecase vereist.
Met deze basis kun je het project verder uitbreiden—metadata opslaan, rangschiklogica bouwen of integreren met gebruikersapps. Dezelfde workflow schaalt ook moeiteloos mee met de volledig beheerde services van MongoDB Atlas.
Je vindt het complete werkende project op GitHub.
Topcursussen op DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min