{count, plural, one {कोर्स} other {कोर्स}}
Python में MongoDB परिचय
{hours} घंटा
24.4K
कीवर्ड-आधारित खोज साधारण लुकअप के लिए ठीक काम करती है, लेकिन जैसे ही हम सटीक शब्दों से अधिक अर्थ की परवाह करते हैं, यह जल्दी सीमित हो जाती है। यदि एक दस्तावेज़ में “response times बढ़ाने” का उल्लेख है और दूसरा “प्रदर्शन सुधारने” की बात करता है, तो पारंपरिक सर्च इंजन उन्हें असंबंधित मानेगा—हालाँकि विचार एक ही है। केवल अभिव्यक्ति अलग होने के कारण हम सार्थक रिश्ते खो देते हैं।
वेक्टर सर्च इस सीमा को एम्बेडिंग्स के रूप में टेक्स्ट और छवियों का निरूपण करके हल करता है: मशीन लर्निंग मॉडल द्वारा जनरेट किए गए संख्यात्मक वेक्टर जो संदर्भ, इरादा और सैमांटिक समानता को कैप्चर करते हैं। एक बार जब हम इन एम्बेडिंग्स को MongoDB में स्टोर कर लेते हैं, तो हम उन्हें क्वेरी करके वास्तविक रूप से संबंधित आइटम ढूँढ सकते हैं—चाहे सटीक शब्द कोई भी हों।
इस ट्यूटोरियल में, हम FastAPI और MongoDB Atlas Vector Search का उपयोग करके इस वर्कफ़्लो का एक व्यावहारिक एंड-टू-एंड उदाहरण बनाएँगे। हम SentenceTransformers से टेक्स्ट एम्बेडिंग्स और एक CLIP-आधारित मॉडल से इमेज एम्बेडिंग्स जनरेट करेंगे, दोनों को MongoDB में स्टोर करेंगे, और उन पर समानता सर्च चलाएंगे। अंत तक, हमारे पास एक काम करने वाली नींव होगी जो सैमांटिक आर्टिकल सर्च, प्रोडक्ट रिकमेंडेशन, विज़ुअल सिमिलैरिटी टूल्स और कई वास्तविक-world अनुप्रयोगों को सपोर्ट कर सकती है।
तो चलिए शुरू करते हैं।
बिल्ड शुरू करने से पहले, हमें कुछ चीज़ें तैयार रखनी होंगी। यह ट्यूटोरियल मानता है कि आपको Python, FastAPI और MongoDB की बुनियादी समझ है। हम किसी एडवांस्ड चीज़ पर निर्भर नहीं होंगे—जो भी उपयोग करेंगे, उसे रास्ते में ही समझाएँगे।
हमें यह चाहिए होगा:
हम इन्हें सेटअप के हिस्से के रूप में इंस्टॉल करेंगे:
ये टूल हमें एम्बेडिंग्स जनरेट करने, उन्हें MongoDB में स्टोर करने और वेक्टर सर्च के जरिए कुशलतापूर्वक क्वेरी करने के लिए सब कुछ प्रदान करते हैं।
कोड लिखने से पहले, यह समझना फायदेमंद है कि इस वर्कफ़्लो के नीचे वास्तव में क्या हो रहा है। Vector search को हिस्सों में बाँटें तो यह जटिल नहीं है, और बुनियादी बातें जान लेने से आगे का ट्यूटोरियल आसानी से समझ आता है।
एक एम्बेडिंग संख्याओं की एक सूची (एक वेक्टर) है जो किसी डेटा के अर्थ का प्रतिनिधित्व करती है।
टेक्स्ट के लिए, एम्बेडिंग संदर्भ और इरादे जैसी चीज़ें कैप्चर करती है। इमेज के लिए, यह दृश्य पैटर्न और फीचर्स को कैप्चर करती है।
एम्बेडिंग का एक अत्यंत सरल उदाहरण इस तरह दिखता है:
[0.21, -0.17, 0.89, ...]दो सैमांटिक रूप से समान चीज़ें—जैसे एक ही विचार का वर्णन करने वाले दो वाक्य, या समान ऑब्जेक्ट वाली दो छवियाँ—ऐसे वेक्टर देंगी जो गणितीय रूप से एक-दूसरे के काफ़ी पास हों। वेक्टर सर्च इसी “निकटता” को मापकर काम करता है।
MongoDB स्वयं एम्बेडिंग्स जनरेट नहीं करता। इसके बजाय, यह अपने मुख्य काम पर फोकस करता है:
अर्थात, मॉडल एम्बेडिंग्स जनरेट करते हैं, और MongoDB सर्च संभालता है।
यह क्लीन सेपरेशन सिस्टम को लचीला और स्केलेबल बनाता है।
हम कोई भी एम्बेडिंग मॉडल चुन सकते हैं, बशर्ते वह संख्यात्मक वेक्टर आउटपुट करे। अलग-अलग मॉडल अलग-अलग प्रकार के डेटा में विशेषज्ञ होते हैं:
|
डेटा प्रकार |
उदाहरण मॉडल |
टिप्पणी |
|
टेक्स्ट |
|
हल्का और NLP के लिए व्यापक रूप से उपयोगी |
|
इमेज |
CLIP/OpenCLIP |
छवियों को सैमांटिक वेक्टर में बदलता है |
|
मल्टीमॉडल |
Multimodal |
टेक्स्ट और इमेज—दोनों को साथ संभालता है |
यही वर्कफ़्लो हम FastAPI और MongoDB Atlas के साथ लागू करेंगे।
एक बार सेटअप होने पर, हम अर्थ के आधार पर टेक्स्ट और छवियों की खोज कर पाएँगे—जो पारंपरिक कीवर्ड सर्च नहीं कर पाती।
FastAPI एप्लिकेशन बनाने से पहले, हमें एम्बेडिंग्स स्टोर और क्वेरी करने के लिए एक जगह चाहिए। MongoDB Atlas यह काम आसान बनाता है, और वेक्टर इंडेक्स सेटअप करने में कुछ ही मिनट लगते हैं।
यदि आपके पास पहले से नहीं है, तो MongoDB Atlas में एक नया क्लस्टर बनाएं। फ्री-टियर (M0) क्लस्टर इस ट्यूटोरियल के लिए पर्याप्त है। अधिक जानकारी के लिए क्लस्टर कैसे बनाएं देखें।
क्लस्टर के अंदर:
vector_db. कहेंगे। अधिक जानकारी के लिए डॉक्यूमेंटेशन देखें।texts: जहाँ हम टेक्स्ट डॉक्यूमेंट और उनकी एम्बेडिंग्स स्टोर करेंगेimages: जहाँ हम इमेज फ़ाइलनाम और इमेज एम्बेडिंग्स स्टोर करेंगेकलेक्शन कैसे बनाएँ इस पर अधिक जानकारी के लिए डॉक्यूमेंटेशन देखें।
हमने इमेज और टेक्स्ट कलेक्शन अलग रखे हैं क्योंकि वे अलग-अलग एम्बेडिंग मॉडल और अलग वेक्टर डाइमेंशंस पर निर्भर करते हैं।
MongoDB को तेज़ समानता खोज के लिए एक वेक्टर इंडेक्स चाहिए। हम टेक्स्ट एम्बेडिंग्स के लिए एक इंडेक्स और इमेज एम्बेडिंग्स के लिए एक इंडेक्स बनाएंगे।
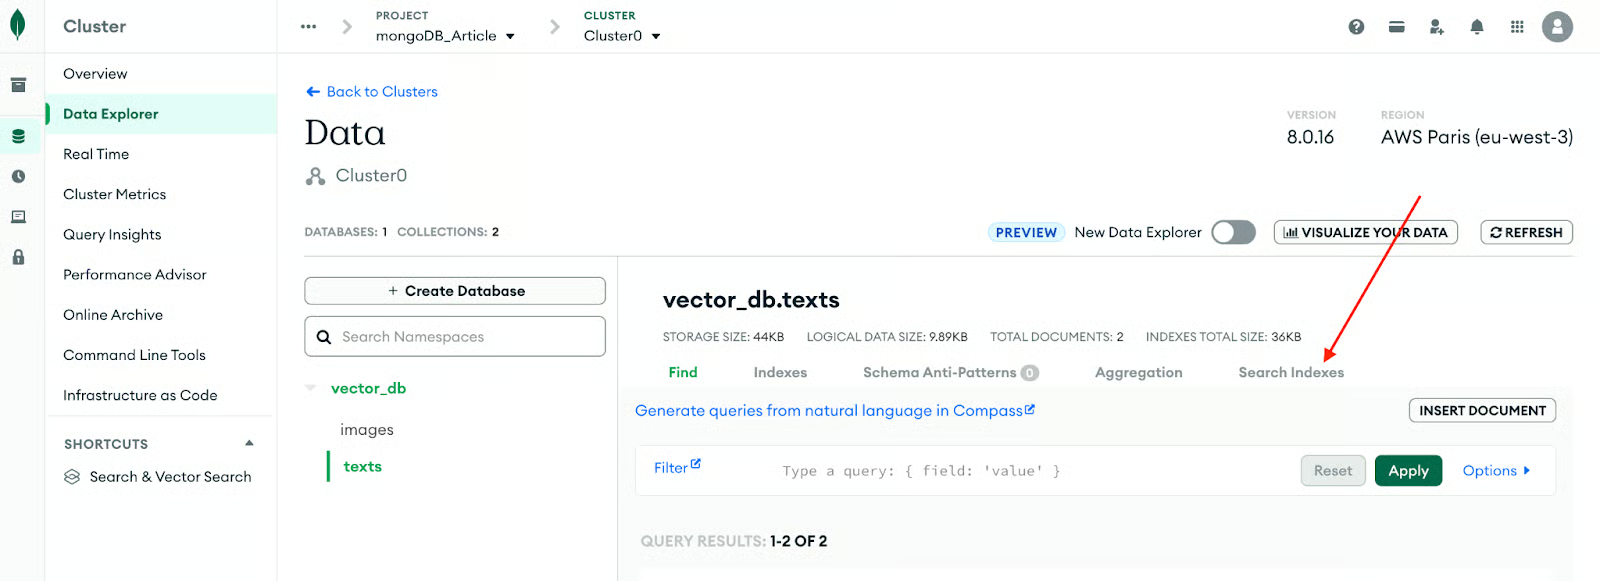
आप इन्हें Atlas → Collections → Search Indexes में बना सकते हैं। आइए टेक्स्ट कलेक्शन के लिए सेट करना शुरू करें।
निम्न छवि इस प्रक्रिया को बेहतर ढंग से समझाती है।
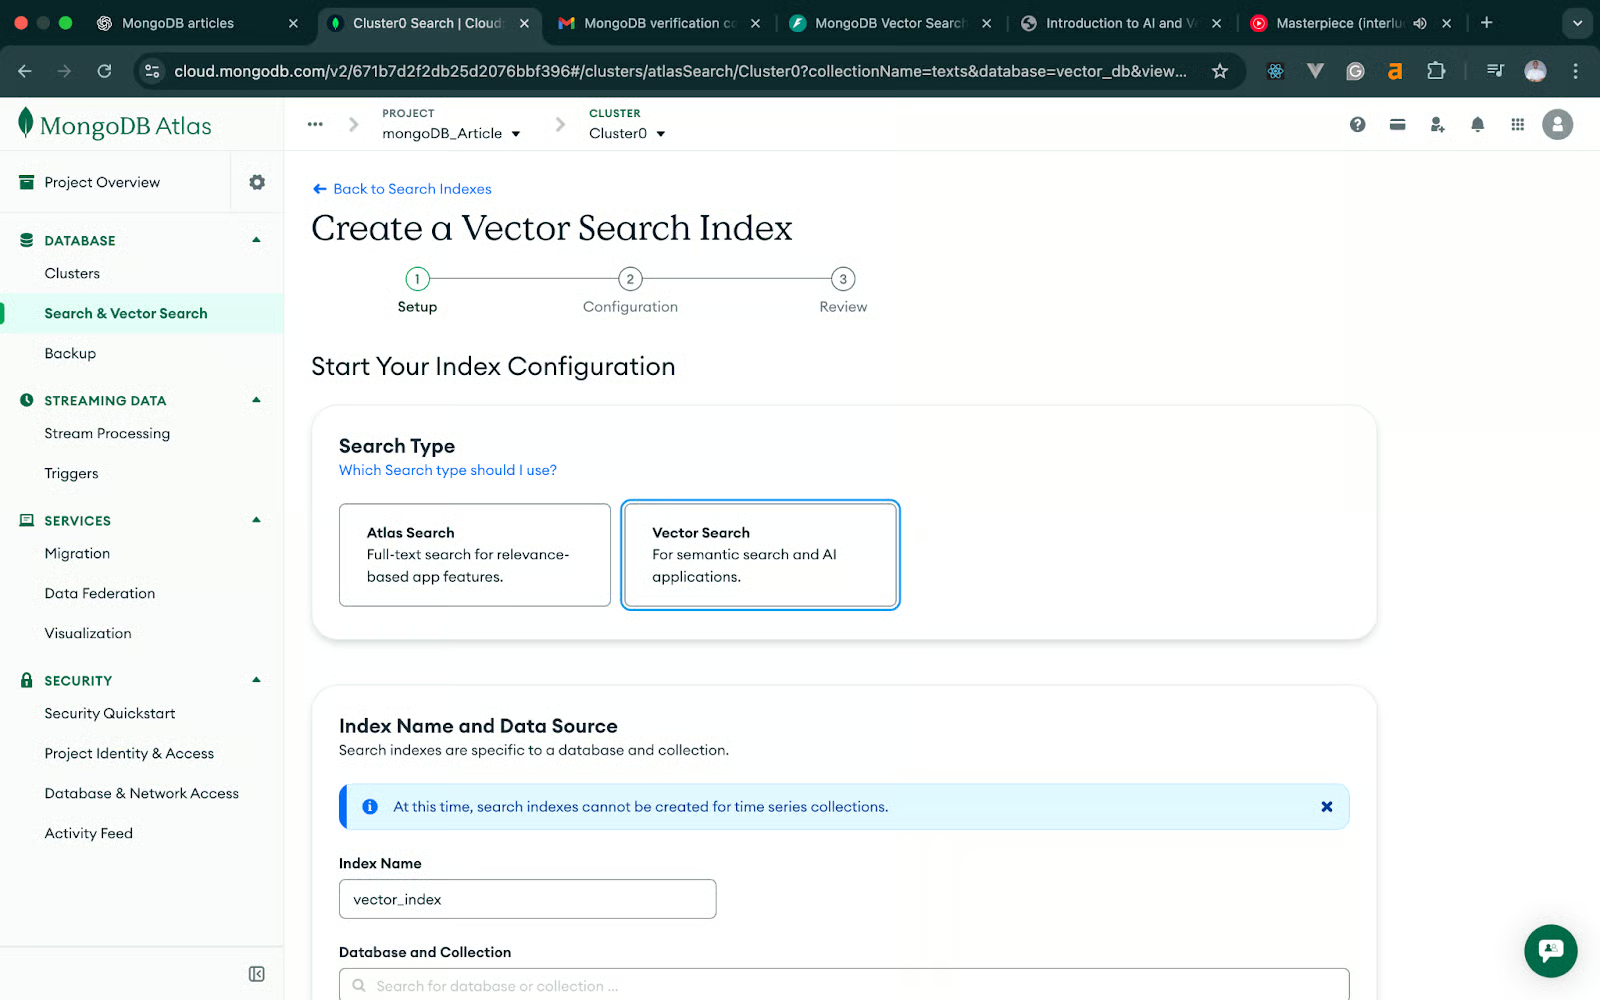
अगली स्क्रीन पर, Vector Search ->JSON Editor -> Next पर क्लिक करें। नीचे दी गई छवि प्रक्रिया को और स्पष्ट करेगी।
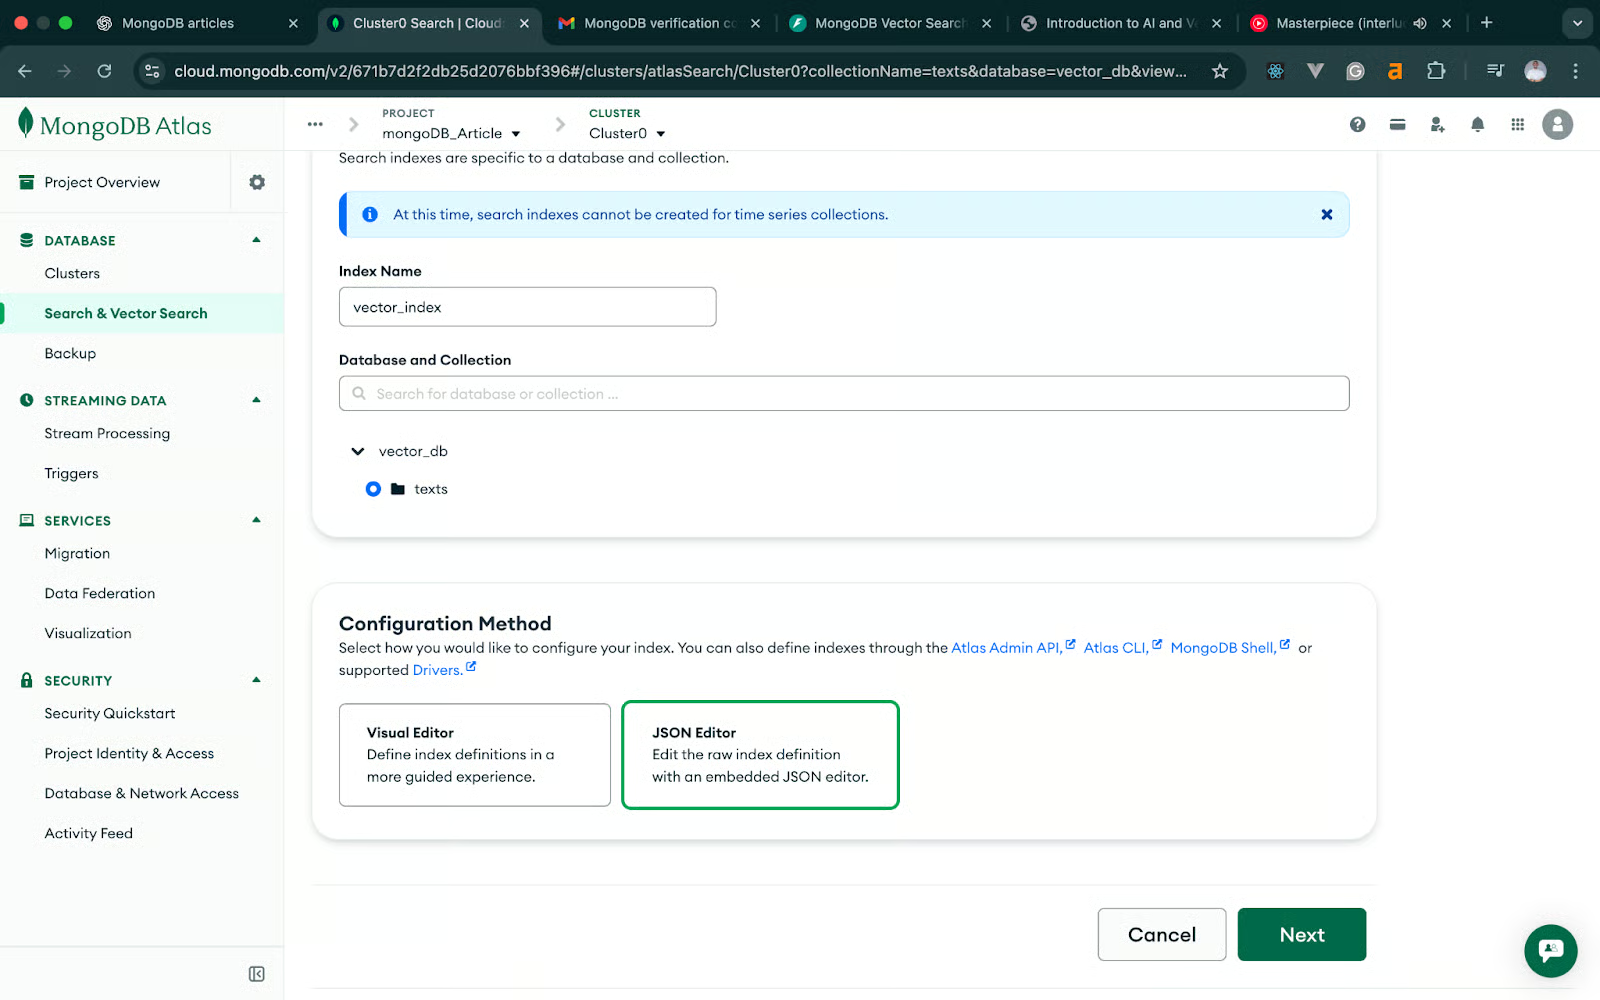
वेक्टर सर्च इंडेक्स में, JSON टेक्स्ट को हमारे कोड से मिलाने के लिए संशोधित करें।
हम टेक्स्ट के लिए all-MiniLM-L6-v2 मॉडल उपयोग कर रहे हैं, जो 384-डायमेंशनल एम्बेडिंग्स बनाता है।
यह रहा JSON डिफिनिशन:
{
  "fields": [
    {
      "type": "vector",
      "path": "embedding",
      "numDimensions": 384,
      "similarity": "cosine"
    }
  ]
}
इस इंडेक्स को नाम दें: vector_texts_search और सेव करें।
यह MongoDB को टेक्स्ट एम्बेडिंग्स पर cosine similarity सर्च करने देता है। नीचे की छवि इस प्रक्रिया को और विस्तार से दिखाती है।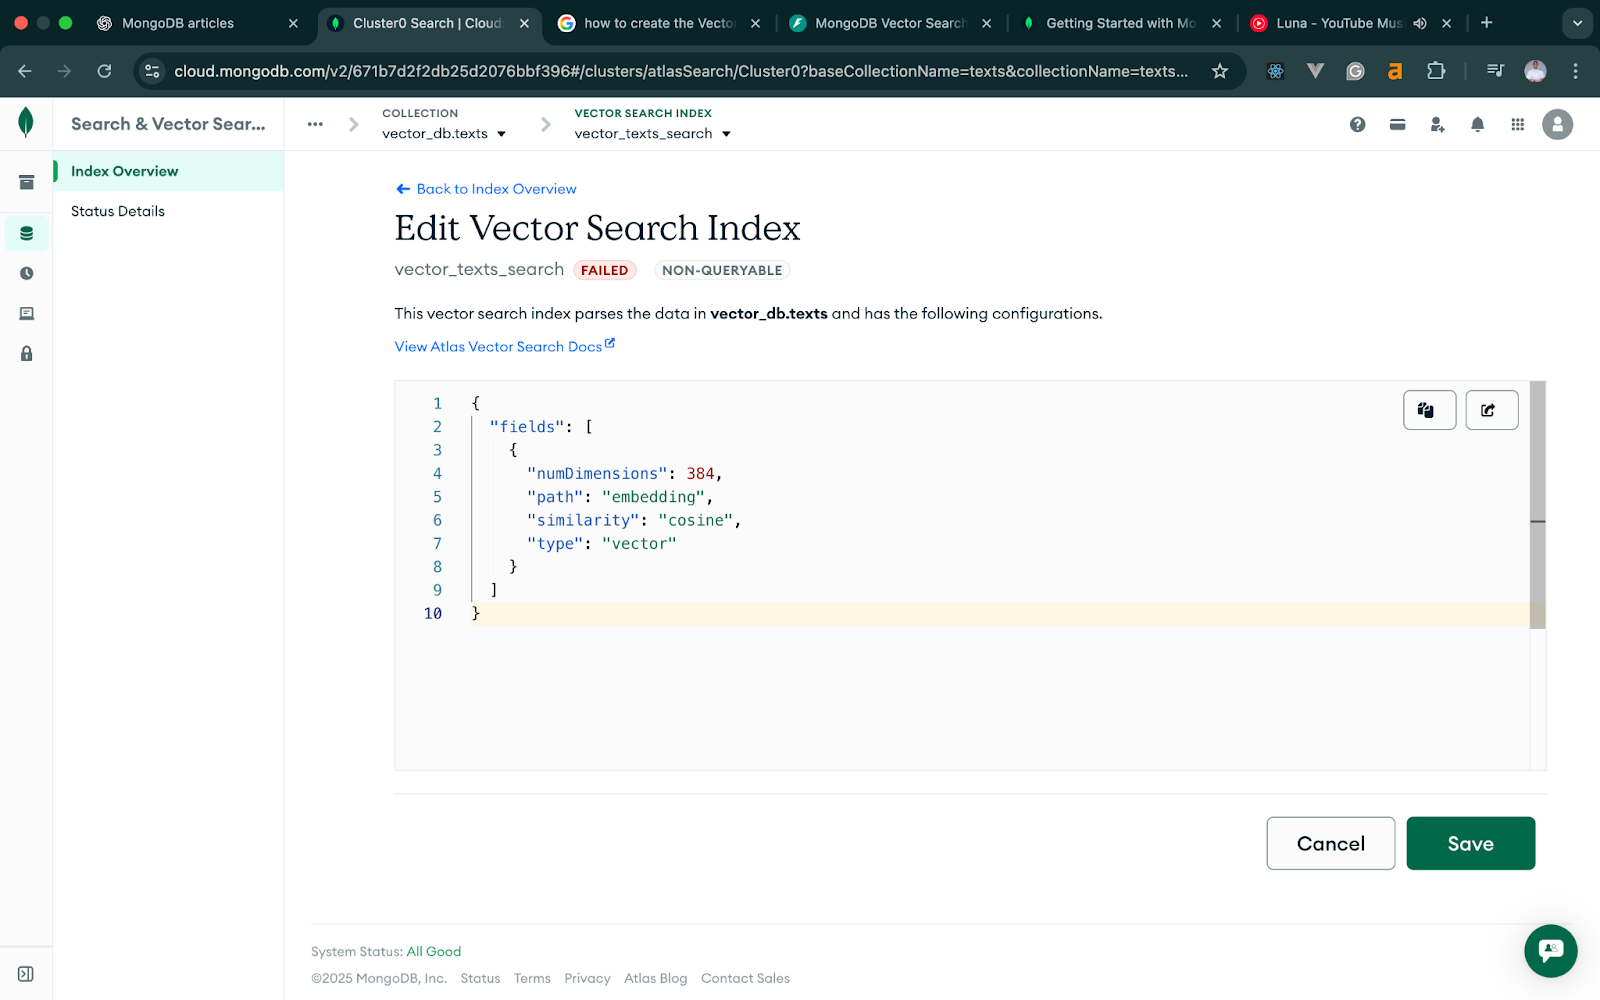
इमेज के लिए हम एक CLIP-आधारित मॉडल उपयोग कर रहे हैं जो 512-डायमेंशनल वेक्टर देता है, इसलिए इमेज इंडेक्स को उसी डायमेंशन से मेल खाना चाहिए। JSON डिफिनिशन नीचे दिए कोड से मेल खाना चाहिए। इसके अलावा, बाकी फ्लो समान है।
{
  "fields": [
    {
      "type": "vector",
      "path": "embedding",
      "numDimensions": 512,
      "similarity": "cosine"
    }
  ]
}
इस इंडेक्स को नाम दें: vector_images_search.
दोनों इंडेक्स सक्रिय होते ही, MongoDB Atlas वेक्टर सर्च क्वेरी के लिए तैयार है।
अब जब हमारा MongoDB Atlas क्लस्टर और वेक्टर इंडेक्स तैयार हैं, हम FastAPI ऐप सेट करेंगे जो एम्बेडिंग्स जनरेट करेगा और उन्हें MongoDB में स्टोर करेगा। हम प्रोजेक्ट संरचना को छोटा और फ़ोकस्ड रखेंगे, क्योंकि यह ट्यूटोरियल वर्कफ़्लो को समझने पर केंद्रित है, न कि एक पूर्ण प्रोडक्शन सर्विस बनाने पर।
हम FastAPI, Uvicorn, MongoDB का Python ड्राइवर, और टेक्स्ट व इमेज एम्बेडिंग्स जनरेट करने के लिए आवश्यक लाइब्रेरियाँ इंस्टॉल करेंगे। चलाएँ:
pip install fastapi uvicorn pymongo python-dotenv sentence-transformers torch pillow open_clip_torch python-multipartक्यों जरूरत है—इसका एक संक्षिप्त विवरण:
.env से environment variables लोड करता हैइंस्टॉल होने के बाद, हम प्रोजेक्ट का लेआउट तैयार करेंगे।
हम सब कुछ एक ही Python फ़ाइल में रखेंगे, और कॉन्फ़िगरेशन environment variables से संभालेंगे:
fastapi-mongodb-vector-search/
│── main.py
│── .env
│── venv/
main.py में पूरा एप्लिकेशन होगा: टेक्स्ट एंडपॉइंट्स, इमेज एंडपॉइंट्स और MongoDB कनेक्शन।
MONGODB_URI="your connection string"
DB_NAME="vector_db"
TEXT_COLLECTION="texts"
IMAGE_COLLECTION="images"एप्लिकेशन स्टार्ट होने पर FastAPI इन्हें लोड करेगा, जिससे कॉन्फ़िगरेशन कोड से अलग रहेगा।
FastAPI प्रोजेक्ट सेट होने के साथ, हम टेक्स्ट-सर्च वर्कफ़्लो बनाना शुरू कर सकते हैं। यही भाग वेक्टर सर्च का मुख्य विचार प्रस्तुत करता है: हम अपने टेक्स्ट के लिए एम्बेडिंग्स जनरेट करते हैं, उन्हें MongoDB में स्टोर करते हैं, और पहले बनाए गए वेक्टर इंडेक्स से क्वेरी करते हैं।
हम इसे दो छोटे चरणों में लेंगे ताकि रास्ते में टेस्ट और डिबग करना आसान रहे।
पहला एंडपॉइंट एक शीर्षक और कुछ टेक्स्ट कंटेंट स्वीकार करेगा। हम दोनों फ़ील्ड्स को एक स्ट्रिंग में मिलाएँगे, SentenceTransformers की मदद से एम्बेडिंग जनरेट करेंगे, और डॉक्यूमेंट को एम्बेडिंग वेक्टर के साथ सेव करेंगे।
कोड में यह इस तरह दिखता है:
# main.py (excerpt)

from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from pymongo import MongoClient
from sentence_transformers import SentenceTransformer
from dotenv import load_dotenv
import os

load_dotenv()

app = FastAPI()

# --- DB setup ---
client = MongoClient(os.getenv("MONGODB_URI"))
db = client[os.getenv("DB_NAME")]
texts_coll = db[os.getenv("TEXT_COLLECTION")]
Images_coll = db[os.getenv("IMAGE_COLLECTION")]


# --- text embedding model ---
MODEL_NAME = "all-MiniLM-L6-v2"
text_model = SentenceTransformer(MODEL_NAME)

# --- request schema ---
class AddTextRequest(BaseModel):
    title: str
    content: str

@app.post("/add-text")
def add_text(payload: AddTextRequest):
    try:
        # Combine fields for richer embeddings
        text = f"{payload.title}\n\n{payload.content}"

        # Generate text embedding
        embedding = text_model.encode(text).tolist()

        # Store document in MongoDB
        doc = {
            "title": payload.title,
            "content": payload.content,
            "embedding": embedding,
            "model": MODEL_NAME,
        }

        result = texts_coll.insert_one(doc)

        return {
            "inserted_id": str(result.inserted_id),
            "title": payload.title
        }
    except Exception as e:
raise HTTPException(status_code=500, detail=str(e))टेस्टिंग के लिए cURL, Postman और अन्य समान API टूल्स का उपयोग किया जा सकता है। इस ट्यूटोरियल में, हम Postman से टेस्ट करेंगे।
हमें अपना FastAPI एंडपॉइंट इंटरनेट पर एक्सपोज़ भी करना होगा ताकि वेब पर Postman से टेस्ट कर सकें। इसके लिए हम Ngrok का उपयोग करेंगे। यदि आप Ngrok में नए हैं, डॉक्यूमेंटेशन देखें।टेस्ट करने के लिए, पहले नीचे दिए कमांड से FastAPI को चलाएँ:
uvicorn main:app --reloadफिर, नीचे दिए गए Ngrok कमांड से अपने localhost को इंटरनेट पर टनल करें:
Ngrok http 8000यह टेस्ट करने के लिए एक URL जनरेट करेगा, जैसा कि नीचे की छवि में है:
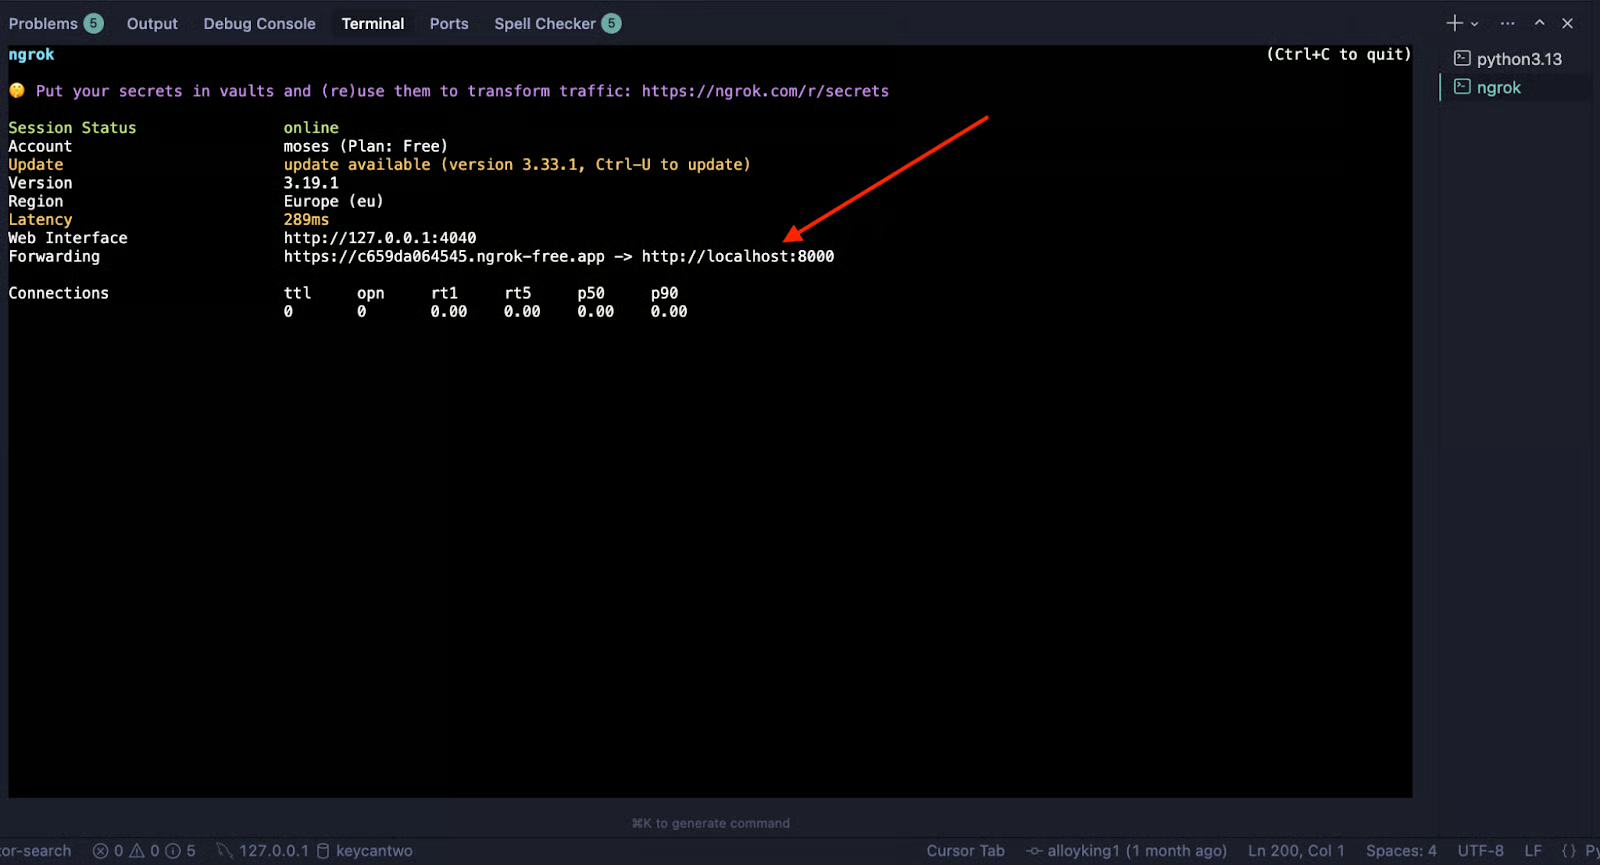
Postman से add-text एंडपॉइंट पर POST रिक्वेस्ट भेजें। नीचे की छवि रिक्वेस्ट भेजने और अपेक्षित रिस्पॉन्स को और स्पष्ट करती है।
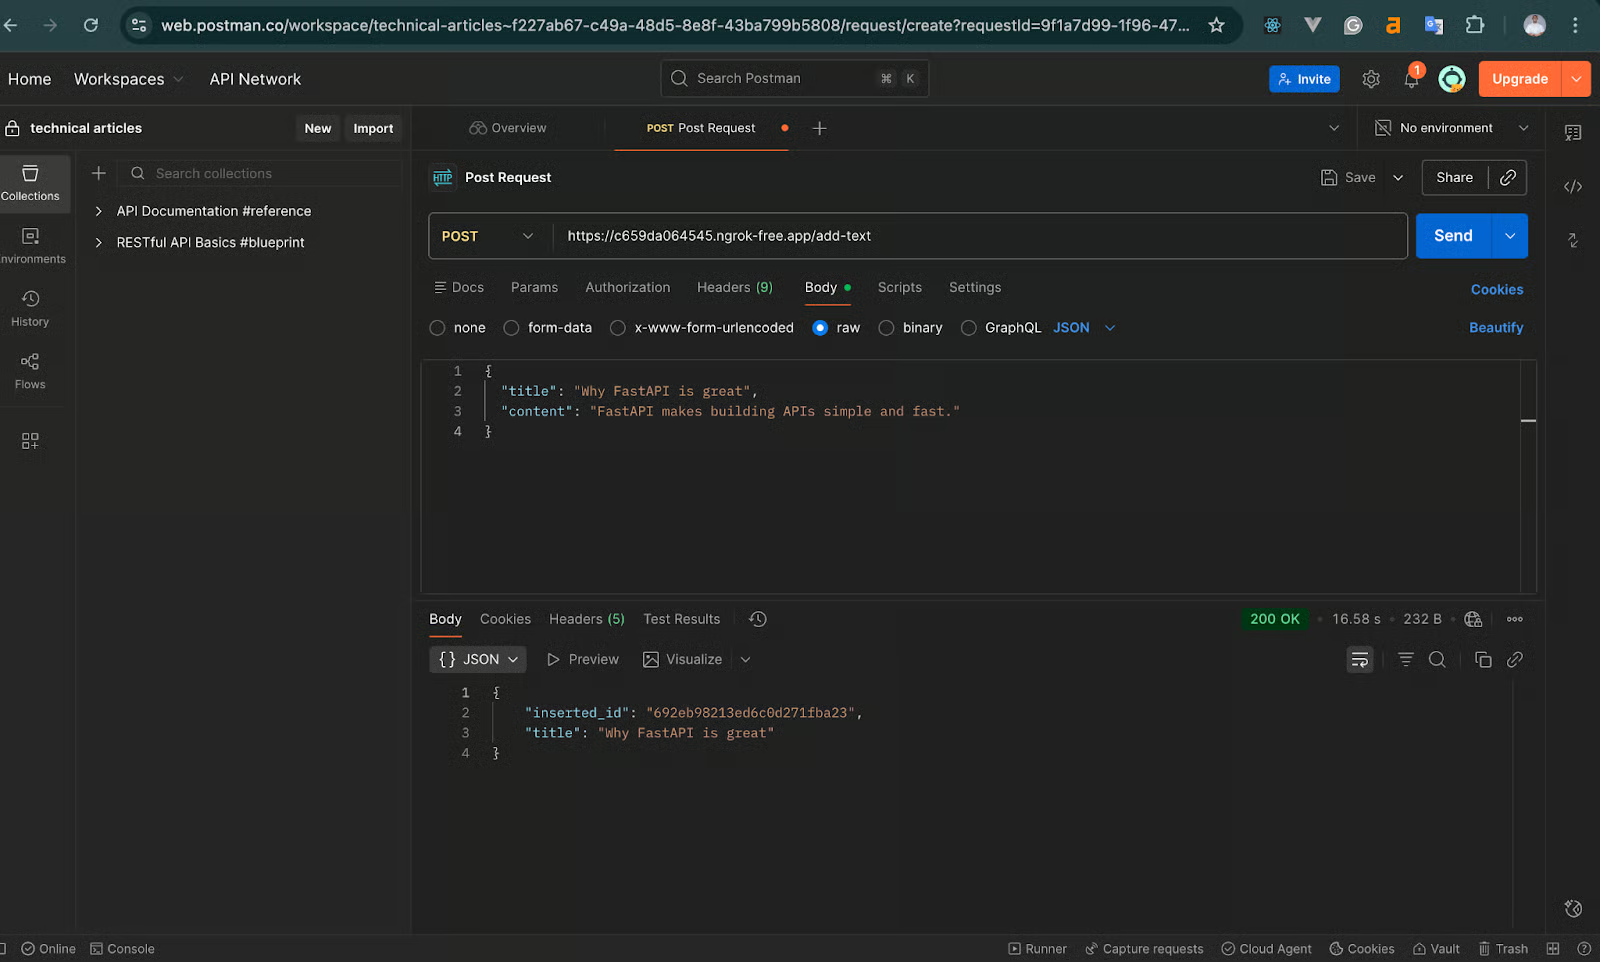
अपेक्षित रिस्पॉन्स:
{
  "inserted_id": "65f...",
  "title": "Why FastAPI is great."
}
यह पुष्टि करता है कि आपका एम्बेडिंग मॉडल सही से लोड हुआ, और MongoDB ने वेक्टर स्टोर कर लिया। यदि यह काम करता है, तो आपका टेक्स्ट पाइपलाइन चल रही है।
अब जब हम टेक्स्ट जोड़ सकते हैं, अगला कदम MongoDB के $vectorSearch स्टेज का उपयोग करके उसे खोजना है। यहाँ हम:
निम्नलिखित एंडपॉइंट main.py में जोड़ें:
class SearchTextRequest(BaseModel):
    query: str
    limit: int = 5

@app.post("/search-text")
def search_text(payload: SearchTextRequest):
    try:
        # Convert search query to embedding
        query_vector = text_model.encode(payload.query).tolist()

        # Vector search pipeline
        pipeline = [
            {
                "$vectorSearch": {
                    "queryVector": query_vector,
                    "path": "embedding",
                    "numCandidates": 100,
                    "limit": payload.limit,
                    "index": "vector_texts_search" # field MUST match the index name in Atlas exactly


                }
            },
            {
                "$project": {
                    "title": 1,
                    "content": 1,
                    "score": {"$meta": "vectorSearchScore"},
                    "_id": 0
                }
            }
        ]

        results = list(texts_coll.aggregate(pipeline))
        return {"results": results}

    except Exception as e:
        raise HTTPException(status_code=500, detail=str(e))
> numCandidates पैरामीटर यह निर्धारित करता है कि टॉप रिज़ल्ट लौटाने से पहले कितने संभावित मैचों का मूल्यांकन किया जाए।
> अधिक मान सटीकता बढ़ाते हैं लेकिन क्वेरी समय भी बढ़ाते हैं। सामान्य नियम: आपकी limit का 10–20x।
एक या अधिक डॉक्यूमेंट जोड़ने के बाद, हमारे Ngrok-जनरेटेड लिंक का उपयोग करते हुए Postman से /search-text एंडपॉइंट पर POST रिक्वेस्ट करें, जैसा कि नीचे की छवि में है:
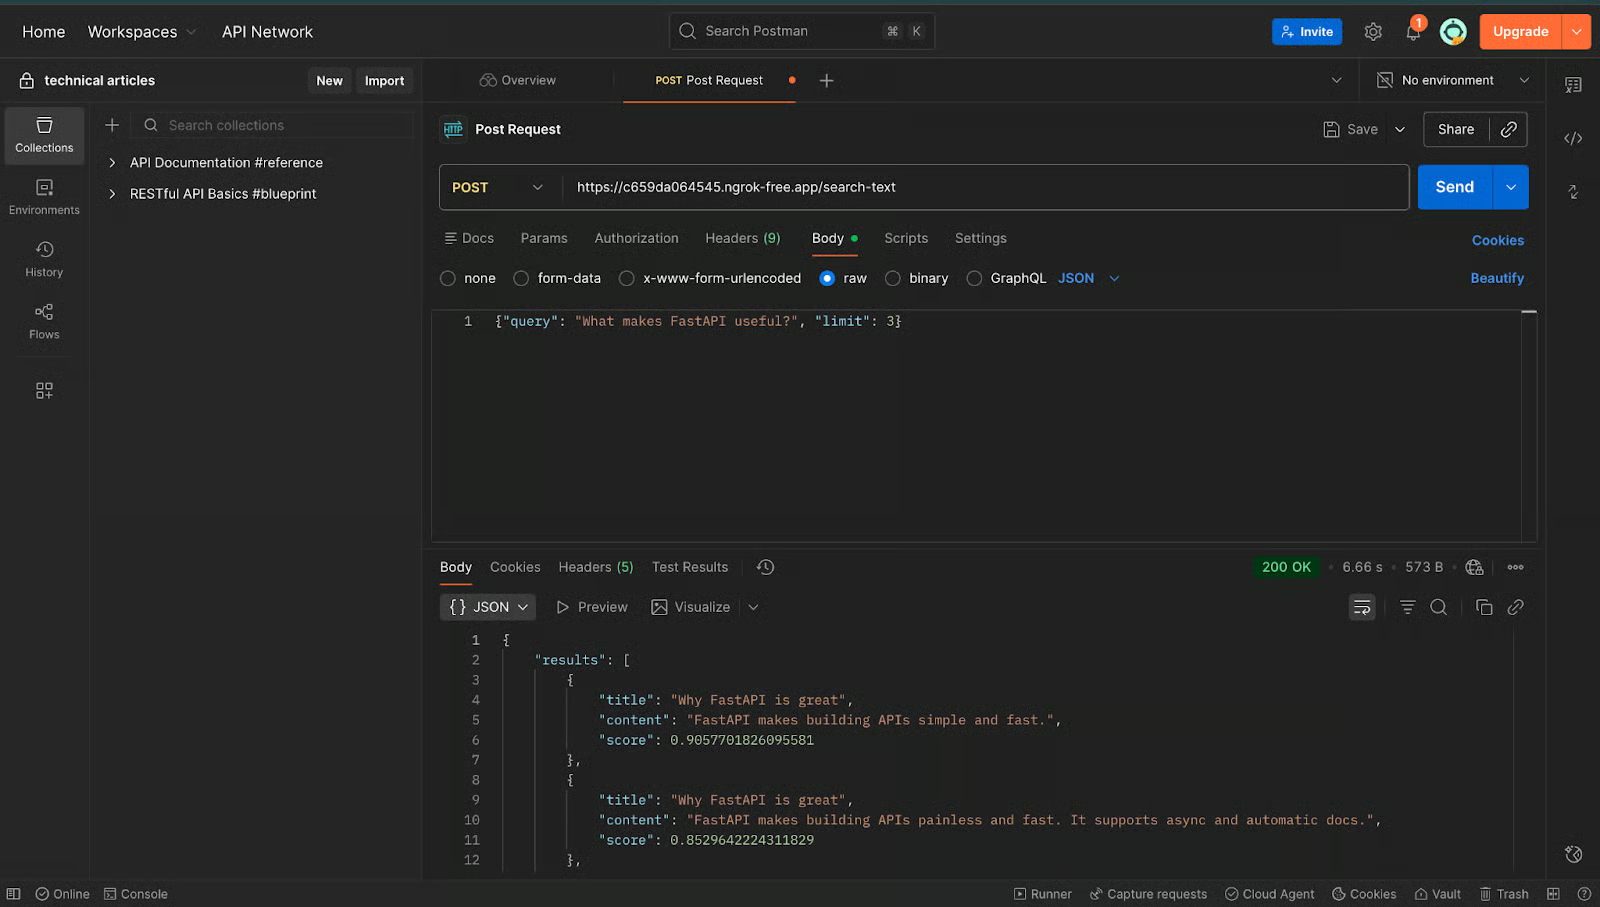
अपेक्षित आउटपुट:
{
  "results": [
    {
      "title": "Why FastAPI is great",
      "content": "FastAPI makes building APIs simple and fast.",
      "score": 0.85
    }
  ]
}
यदि आपको similarity स्कोर के साथ कोई परिणाम दिखता है, तो आपका टेक्स्ट वेक्टर सर्च पाइपलाइन एंड-टू-एंड काम कर रही है। जब यह भाग स्थिरता से काम करने लगे, तो हम इमेज वर्कफ़्लो पर बढ़ेंगे।
अब जबकि हमारा टेक्स्ट वर्कफ़्लो सुचारू रूप से चल रहा है, हम इसी विचार को इमेज पर बढ़ाएँगे। समग्र प्रवाह समान है—मुख्य अंतर एम्बेडिंग्स जनरेट करने के तरीके में है। SentenceTransformers के बजाय, हम एक CLIP-आधारित मॉडल का उपयोग करेंगे, जो छवियों को 512-डायमेंशनल वेक्टर में बदलने के लिए डिज़ाइन किया गया है।
पहले की तरह, हम इसे चरण-दर-चरण लागू करेंगे ताकि टेस्ट और डिबग करना आसान रहे।
यह एंडपॉइंट अपलोड की गई इमेज फ़ाइल स्वीकार करता है, उसे CLIP के अनुकूल टेन्सर में बदलता है, 512-डायमेंशनल एम्बेडिंग जनरेट करता है, और MongoDB में स्टोर करता है।
यह इस तरह दिखता है:
# --- CLIP model setup ---
import torch
import open_clip
from PIL import Image
import io
from fastapi import UploadFile, File

# Load CLIP model once when the app starts
clip_model, _, preprocess = open_clip.create_model_and_transforms(
    "ViT-B-32",
    pretrained="openai"
)
device = "cuda" if torch.cuda.is_available() else "cpu"
clip_model.to(device)

@app.post("/add-image")
async def add_image(file: UploadFile = File(...)):
    """
    Upload an image, generate its CLIP embedding, and store in MongoDB.
    """
    try:
        # Read file contents
        image_bytes = await file.read()
        image = Image.open(io.BytesIO(image_bytes)).convert("RGB")

        # Preprocess for CLIP and encode
        image_tensor = preprocess(image).unsqueeze(0).to(device)
        with torch.no_grad():
            image_embedding = clip_model.encode_image(image_tensor)

        # Normalize the embedding (important for cosine similarity)
        image_embedding /= image_embedding.norm(dim=-1, keepdim=True)
        vector = image_embedding.cpu().numpy().flatten().tolist()

        # Store in MongoDB
        doc = {
            "filename": file.filename,
            "embedding": vector
        }
        result = images_coll.insert_one(doc)

        return {
            "inserted_id": str(result.inserted_id),
            "filename": file.filename
        }

    except Exception as e:
raise HTTPException(status_code=500, detail=str(e))CLIP एम्बेडिंग्स cosine similarity के साथ सबसे अच्छा काम करती हैं। तुलना को सटीक और स्थिर बनाने के लिए, हम वेक्टर को normalize करते हैं:
image_embedding /= image_embedding.norm(dim=-1, keepdim=True)इससे cosine distance वास्तविक समानता को प्रतिबिंबित करती है।
इस फ़ीचर को Postman में टेस्ट करने के लिए /add-image एंडपॉइंट पर POST रिक्वेस्ट करें। रिक्वेस्ट के बॉडी में form-data भेजें और कोई भी .jpg या .png इमेज अटैच करें। नीचे की छवि प्रक्रिया को दर्शाती है।
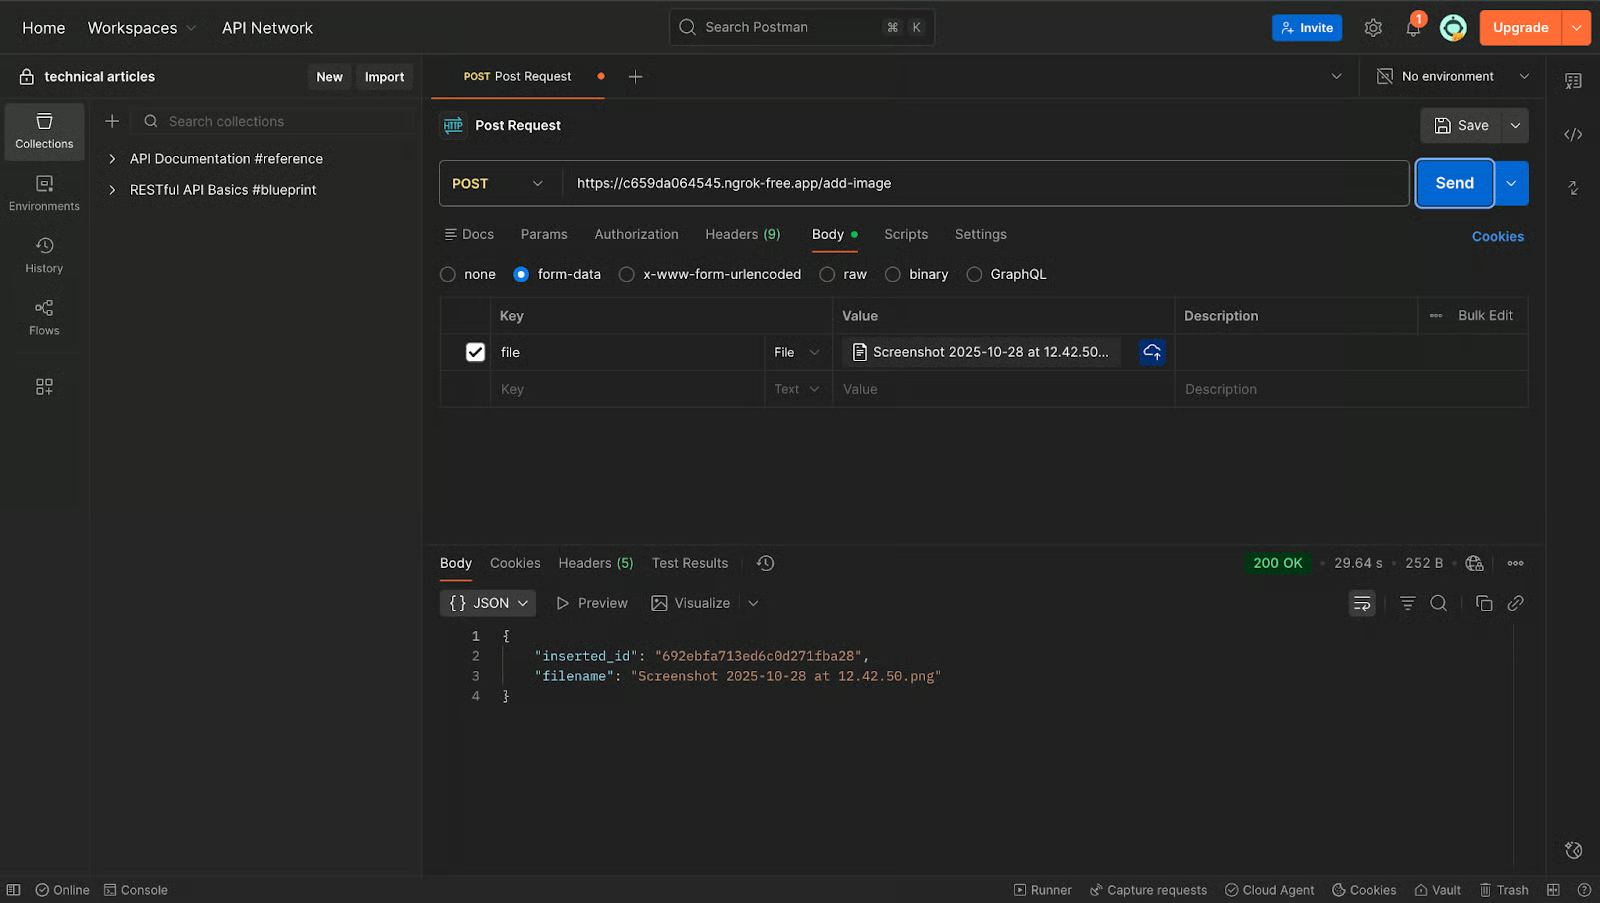
सब कुछ सही होने पर, आपको इस तरह का रिस्पॉन्स मिलेगा:
{
  "inserted_id": "692454f6156fbb762ed865a0",
  "filename": "file-name.png"
}
इस बिंदु पर, आपकी इमेज एम्बेडिंग्स सफलतापूर्वक MongoDB में स्टोर हो चुकी हैं।
अब हम वह एंडपॉइंट बनाएँगे जो अपलोड की गई क्वेरी इमेज लेता है, उसे एम्बेडिंग में बदलता है, और हमारे इमेज वेक्टर इंडेक्स के जरिए सबसे निकट की स्टोर की गई छवियाँ ढूँढता है।
इसे main.py में जोड़ें:
@app.post("/search-image")
async def search_image(file: UploadFile = File(...)):
    """
    Upload an image and find the most visually similar images in MongoDB.
    """
    try:
        # Read the uploaded file
        image_bytes = await file.read()
        image = Image.open(io.BytesIO(image_bytes)).convert("RGB")

        # Generate embedding for the query image
        image_tensor = preprocess(image).unsqueeze(0).to(device)
        with torch.no_grad():
            query_embedding = clip_model.encode_image(image_tensor)

        query_embedding /= query_embedding.norm(dim=-1, keepdim=True)
        query_vector = query_embedding.cpu().numpy().flatten().tolist()

        # Vector search pipeline
        pipeline = [
            {
                "$vectorSearch": {
                    "queryVector": query_vector,
                    "path": "embedding",
                    "numCandidates": 100,
                    "limit": 5,
                    "index": "vector_images_search"
                }
            },
            {
                "$project": {
                    "filename": 1,
                    "score": {"$meta": "vectorSearchScore"},
                    "_id": 0
                }
            }
        ]

        results = list(images_coll.aggregate(pipeline))
        return {"results": results}

    except Exception as e:
raise HTTPException(status_code=500, detail=str(e))इस फ़ीचर को Postman में टेस्ट करने के लिए /search-image एंडपॉइंट पर POST रिक्वेस्ट करें। रिक्वेस्ट के बॉडी में form-data भेजें और पहले स्टोर की गई इमेज जैसी कोई इमेज भेजें। नीचे की छवि प्रक्रिया को दर्शाती है।
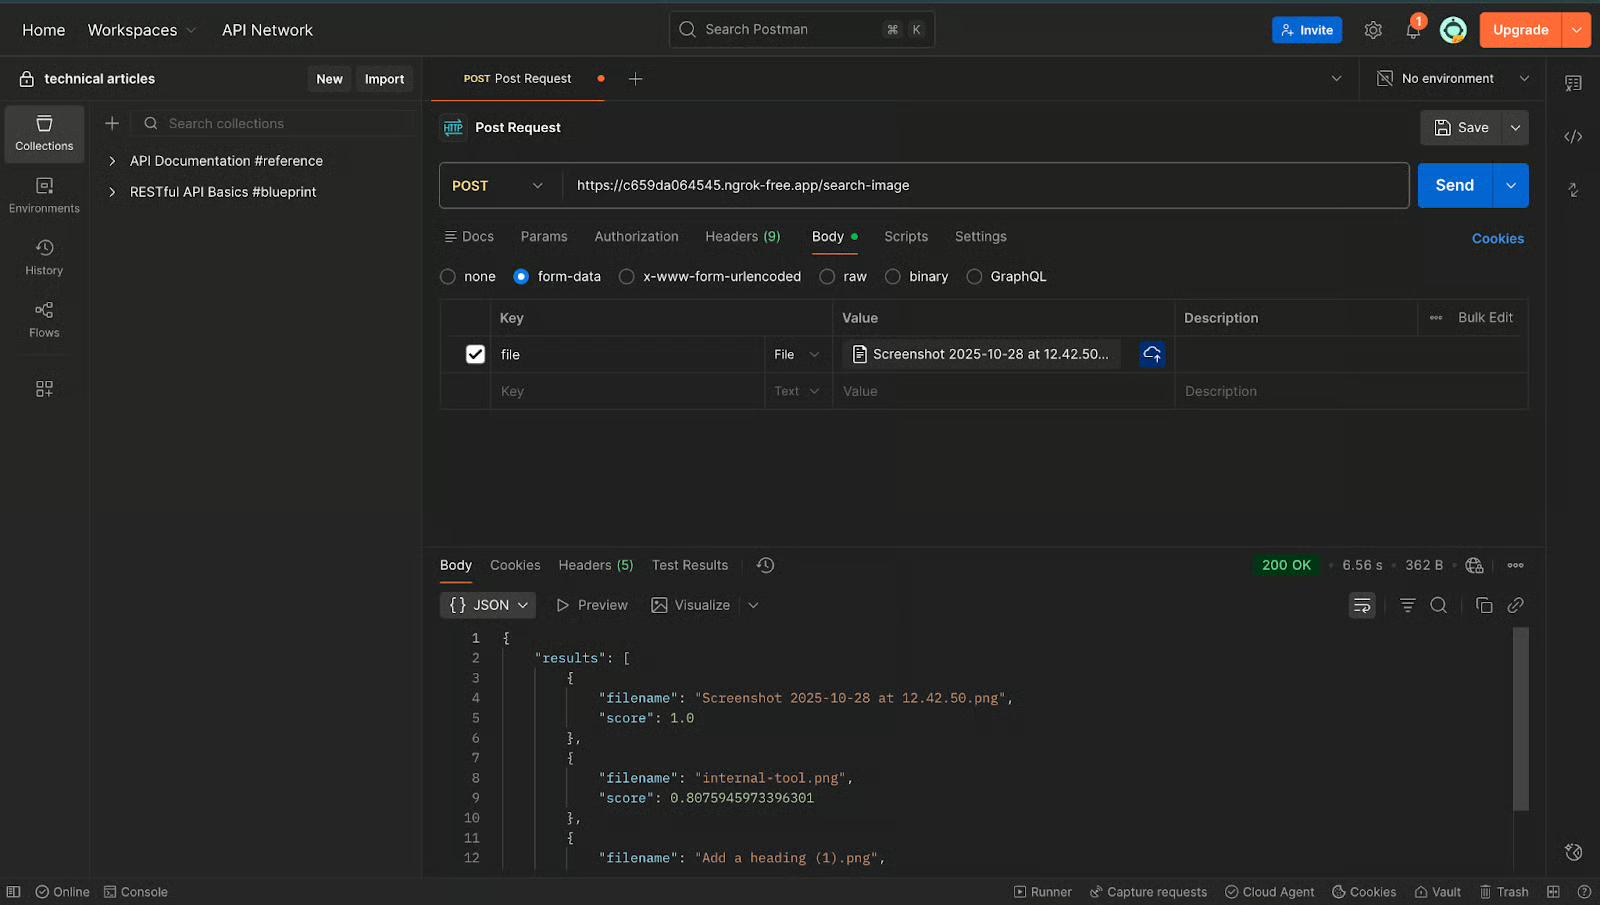
अपेक्षित आउटपुट इस तरह दिखना चाहिए:
{
  "results": [
    {
      "filename": "image1.png",
      "score": 1.0
    },
    {
      "filename": "image2.png",
      "score": 0.81
    }
  ]
}
स्कोर 1.0 का मतलब है कि वही सटीक इमेज मैच हुई। 0.7–0.9 के क़रीब कुछ भी मजबूत दृश्य समानता दर्शाता है।
यदि आपको परिणामों वाली एक array दिखती है, तो आपकी इमेज वेक्टर सर्च अब काम कर रही है।
इस बिंदु पर, यदि सब कुछ काम कर रहा है, तो हमारे पास टेक्स्ट और इमेज—दोनों के लिए एक पूर्ण सैमांटिक सर्च सिस्टम है।
इस ट्यूटोरियल में, हमने FastAPI और MongoDB Atlas का उपयोग करके एक संपूर्ण सैमांटिक सर्च वर्कफ़्लो बनाया। हमने SentenceTransformers से टेक्स्ट एम्बेडिंग्स जनरेट कीं, CLIP मॉडल से इमेज एम्बेडिंग्स बनाईं, सब कुछ MongoDB में स्टोर किया, और MongoDB के Vector Search तथा Postman से उन्हें क्वेरी किया। यह पैटर्न सैमांटिक डॉक्यूमेंट सर्च, इमेज सिमिलैरिटी टूल्स, रिकमेंडेशन सिस्टम और मल्टीमॉडल AI फीचर्स जैसे अनुप्रयोगों की नींव बनता है।
इस आर्किटेक्चर की ताकत इसकी लचीलापन है: MongoDB आपको किसी विशिष्ट मॉडल में बाँधता नहीं है। जब तक एम्बेडिंग्स संख्यात्मक वेक्टर हैं और उनके डायमेंशंस आपके इंडेक्स कॉन्फ़िगरेशन से मेल खाते हैं, आप अपने उपयोग-मामले के अनुरूप कोई भी टेक्स्ट, इमेज या मल्टीमॉडल एम्बेडिंग मॉडल प्लग-इन कर सकते हैं।
इस नींव के साथ, आप प्रोजेक्ट को आगे बढ़ा सकते हैं—मेटाडेटा स्टोर करें, रैंकिंग लॉजिक बनाएँ, या यूज़र-फेसिंग ऐप्स से इंटीग्रेट करें। यही वर्कफ़्लो MongoDB Atlas की पूरी तरह प्रबंधित सेवाओं का उपयोग करके सहजता से स्केल भी करता है।
आप पूरा काम करने वाला प्रोजेक्ट GitHub पर पा सकते हैं।
टॉप DataCamp Courses
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}