Semua orang memperhatikan OpenAI LLM Leaderboard dan model open-source baru yang menargetkan performa setara GPT-4. Salah satu model yang banyak diperbincangkan belakangan ini adalah Zephyr-7B.
Dalam tutorial ini, kita akan mempelajari model bahasa baru bernama Zephyr-7B. Kita akan mengaksesnya menggunakan pipeline Transformers dan melakukan fine-tune model pada dataset Agent-Instruct.
Jika Anda baru dalam bidang Kecerdasan Buatan, lihat jalur keterampilan AI Fundamentals. Jalur ini akan mempersiapkan Anda dan menempatkan Anda di jalur menuju karier sebagai engineer AI masa depan.
Memahami Zephyr-7B
Zephyr-7B adalah model bahasa mutakhir yang dikembangkan oleh WebPilot.AI. Ini adalah bagian dari seri model bahasa Zephyr yang dilatih untuk bertindak sebagai asisten yang membantu. Zephyr-7B dirancang untuk unggul dalam berbagai tugas berbasis bahasa seperti menghasilkan teks yang koheren, menerjemahkan antarbahasa, merangkum informasi penting, menganalisis sentimen, dan menjawab pertanyaan berdasarkan konteks.
Zephyr-7B-β
Zephyr-7B-β adalah model kedua dalam seri tersebut. Ini adalah versi fine-tuned dari model Mistral-7B yang dilatih pada kombinasi dataset publik dan sintetis menggunakan Direct Preference Optimization (DPO). Hasilnya, Zephyr-7B-β menunjukkan kemampuan mulai dari menafsirkan pertanyaan kompleks hingga merangkum paragraf teks yang panjang.
Pada saat rilis, Zephyr-7B-β adalah model chat 7B berperingkat tertinggi di tolok ukur MT-Bench dan AlpacaEval. Model ini memanfaatkan terobosan terbaru dalam pemrosesan bahasa alami untuk mencapai tingkat baru dalam memahami dan menghasilkan teks yang menyerupai manusia.
Anda dapat merasakan peningkatan performanya dengan mencoba demo gratis yang tersedia di Zephyr Chat.
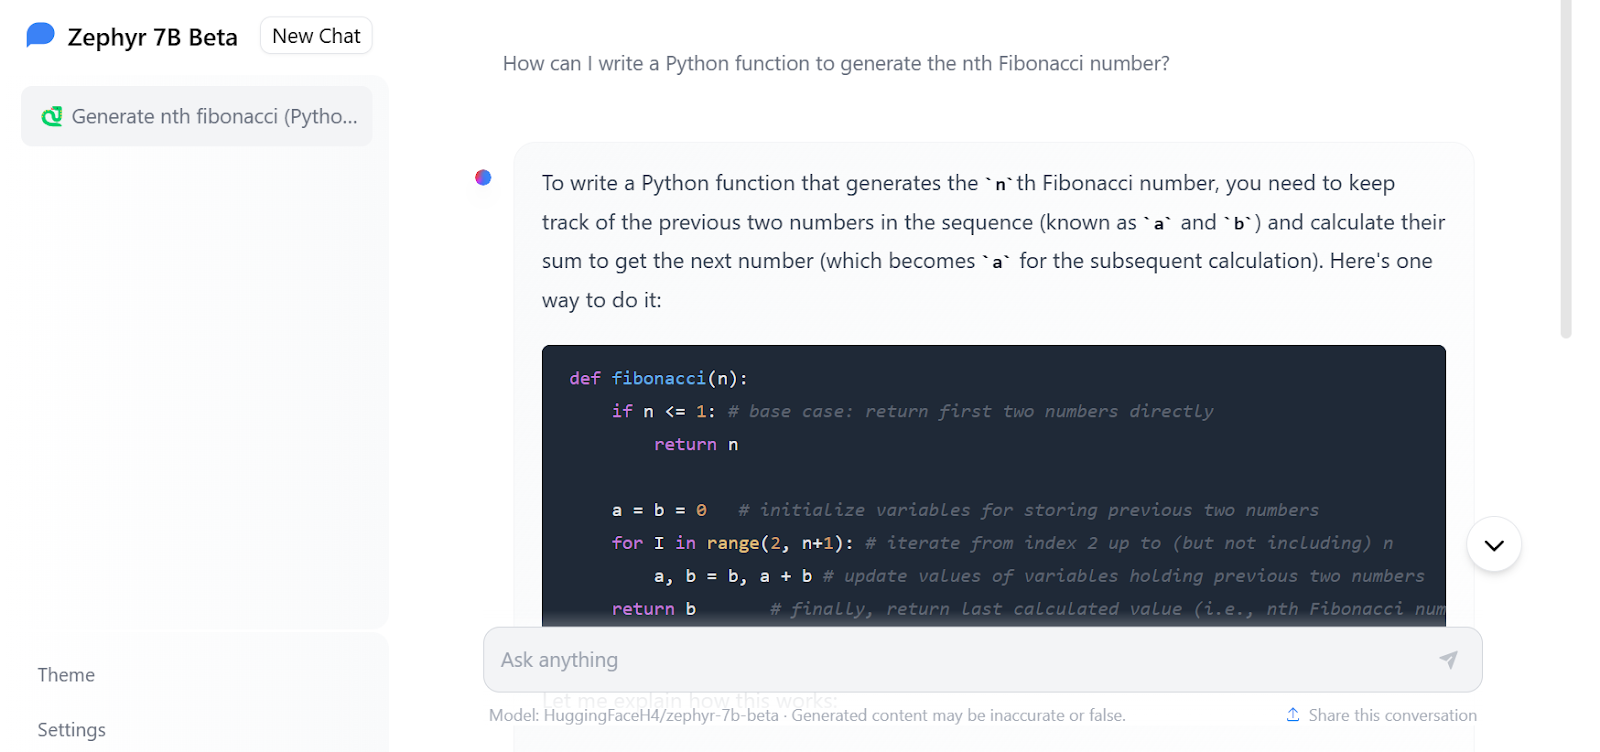
Gambar dari Zephyr Chat
Mengakses Zephyr-7B
Mirip dengan Tutorial Mistral 7B, kita akan memuat dan menggunakan Zephyr-7B-beta menggunakan transformers dari Hugging Face. Caranya cukup mudah.
Catatan: jika Anda mengalami kendala saat memuat model, lihat Notebook Kaggle Inference.
Pertama, instal semua pustaka yang diperlukan. Pastikan Anda menjalankan versi terbaru, jika tidak maka tidak akan berfungsi.
!pip install -q -U transformers
!pip install -q -U accelerate
!pip install -q -U bitsandbytes
Lalu, muat pustaka Pytorch dan modul pipeline dari transformers.
import torch
from transformers import pipeline
Kita akan membangun pipeline pembangkitan teks menggunakan nama model, argumen torch_dtype, dan device_map.
Kata “auto” pada device_map berarti dapat menggunakan beberapa GPU untuk menghasilkan respons lebih cepat.
torch.bfloat16 (brain float) adalah tipe data floating-point 16-bit yang memiliki ukuran eksponen yang sama dengan torch.float32 tetapi ukuran mantissa yang dikurangi. Ini memungkinkan komputasi lebih cepat dan penggunaan memori lebih rendah, namun dengan presisi dan akurasi yang lebih rendah.
model_name = "HuggingFaceH4/zephyr-7b-beta"

pipe = pipeline(
    "text-generation",
    model=model_name,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
Kita harus memberikan prompt dan argumen lain yang diperlukan ke objek pipeline dan mencetak responsnya.
prompt = "Write a Python function that can clean the HTML tags from the file:"

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
print(outputs[0]["generated_text"])
Responsnya lebih dari mengesankan. Model memberikan kode Python beserta komentar.
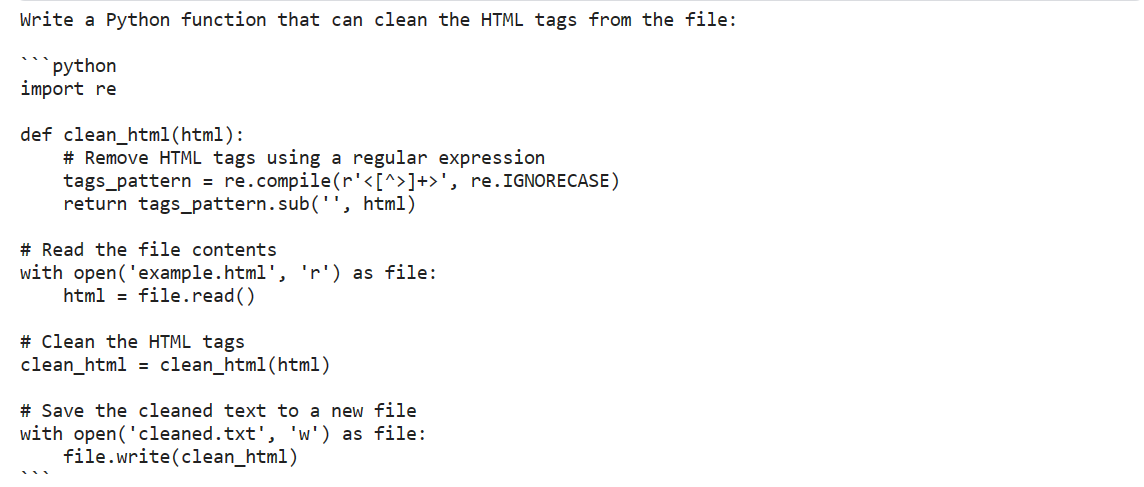
Kita bahkan dapat menyesuaikan respons model dengan memberikan system prompt dalam gaya Zephyr-7B.
Kita akan menggunakan fungsi pipe.tokenizer.apply_chat_template untuk membuat prompt menggunakan daftar dictionary. Dictionary tersebut berisi informasi tentang peran dan perilaku asisten chat, serta prompt pengguna.
messages = [
    {
        "role": "system",
        "content": "You are a skilled software engineer who consistently produces high-quality Python code.",
    },
    {
        "role": "user",
        "content": "Write a Python code to display text in a star pattern.",
    },
]

prompt = pipe.tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
Pada akhirnya, kita akan meneruskan prompt objek pipeline dan argumen tambahan untuk menghasilkan respons.
outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
print(outputs[0]["generated_text"])
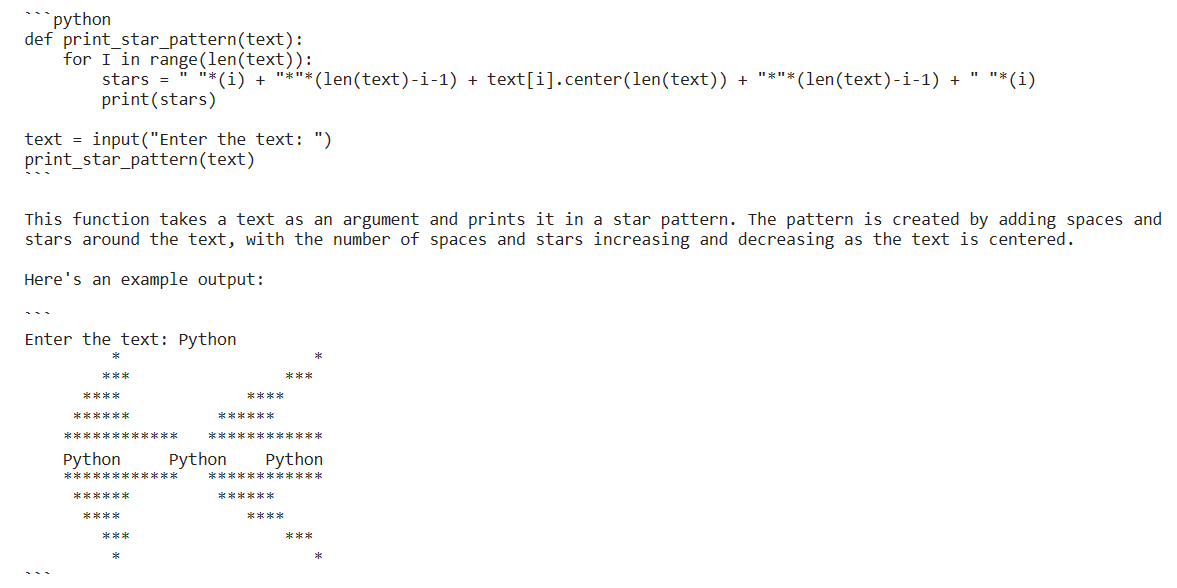
Zephyr-7B menghasilkan solusi yang paling teroptimasi, lengkap dengan penjelasan dan keluaran fungsi. Ini luar biasa. Orang-orang sebaiknya menggunakannya untuk menghasilkan kode Python.
Fine-tuning Zephyr-7B
Di bagian ini, kita akan mempelajari cara melakukan fine-tune model Zephyr-7B-beta pada dataset kustom menggunakan GPU gratis dari Kaggle. Dengan mengikuti instruksi ini, Anda akan dapat menyiapkan model untuk deployment hanya dalam dua jam.
Catatan: jika Anda mengalami kendala saat melatih model, lihat Notebook Kaggle Fine-tuning.
Menyiapkan Lingkungan
Pertama, instal pustaka Python yang diperlukan untuk memuat dataset dan model, serta melakukan fine-tune.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trl
Selanjutnya, kita akan memuat modul-modul yang diperlukan agar memudahkan proses dan membantu kita melatih model dengan memori terbatas.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch, wandb
from datasets import load_dataset
from trl import SFTTrainer
Bagian ini khusus untuk notebook Kaggle. Kami menambahkan kunci API untuk Hugging Face dan Weights & Biases (wandb) di secrets Kaggle. Kami akan menggunakannya secara aman untuk mengunggah model ke Hugging Face Hub dan memantau proses pelatihan model secara langsung di server Weights and Biases.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
secret_wandb = user_secrets.get_secret("wandb")
Masuk ke Hugging Face menggunakan CLI dan kunci API.
!huggingface-cli login --token $secret_hfDemikian pula, masuk ke wandb dan inisiasi proyek.
# Monitoring the LLM
wandb.login(key = secret_wandb)
run = wandb.init(
    project='Fine tuning Zephyr 7B',
    job_type="training",
    anonymous="allow"
)
Sediakan nama model dasar, dataset, dan model baru untuk fine-tuning, penyimpanan, serta pengunggahan ke Hugging Face hub.
base_model = "HuggingFaceH4/zephyr-7b-beta"
dataset_name = "THUDM/AgentInstruct"
new_model = "zephyr-7b-beta-Agent-Instruct"
Dataset AgentInstruct
Kita akan memuat dataset lalu mengonversinya ke gaya prompt Zephyr-7B menggunakan fungsi format_prompt. Fungsi ini mengekstrak peran dan konten dari dataset, lalu mengonversinya menjadi string panjang yang dimulai dengan system prompt dan diakhiri dengan instruksi default.
#Importing the dataset
dataset = load_dataset("THUDM/AgentInstruct", split="train")
def format_prompt(sample):
    intro = "Below is a conversation between a user and you."
    end = "Instruction: Write a response appropriate to the conversation."

    try:
        formatted_conversations = "\n".join(
            f"<{resp['from']}>: {resp['value']}"
            for resp in sample["conversations"]
        )

        sample["text"] = f"{intro}\n\n{formatted_conversations}\n\n{end}"
    except (TypeError, KeyError):
        raise ValueError("Invalid format of the input sample.")
    return sample


dataset = dataset.map(
    format_prompt,
    remove_columns=["conversations"]
)
dataset["text"][100]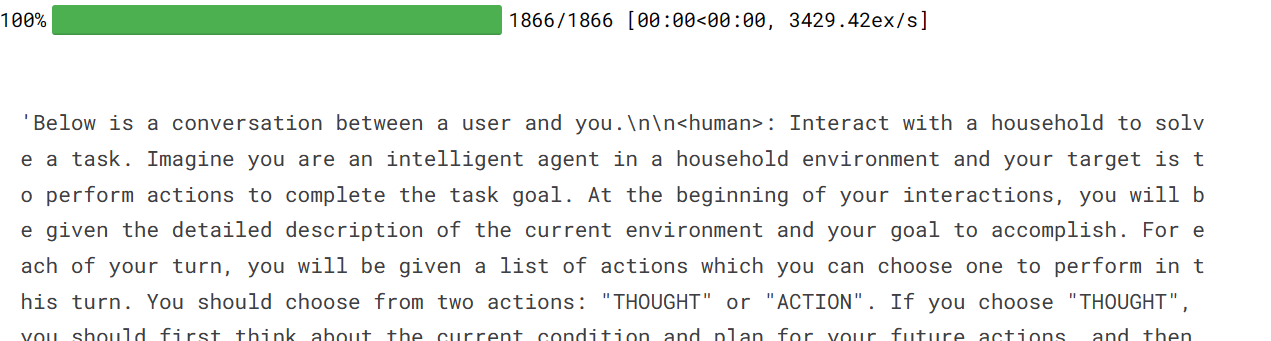
Memuat Model dan Tokenizer
Kita akan mengunduh dan memuat model presisi 4-bit dari Hugging Face untuk memungkinkan pelatihan yang lebih cepat. Ini diperlukan untuk fine-tuning pada GPU dengan VRAM terbatas. Setelah itu, kita akan memuat tokenizer dan mengonfigurasinya untuk memperbaiki masalah dengan fp16.
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)
model = AutoModelForCausalLM.from_pretrained(
        base_model,
        load_in_4bit=True,
        quantization_config=bnb_config,
        torch_dtype=torch.bfloat16,
        device_map="auto",
        trust_remote_code=True,
)
model.config.use_cache = False
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_token
Membangun Model
Sekarang kita akan menambahkan lapisan adaptor ke model, sehingga kita dapat melakukan fine-tune lebih efisien. Alih-alih melakukan fine-tune seluruh model, kita hanya akan memperbarui parameter di lapisan adaptor demi pelatihan yang lebih cepat.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=['up_proj', 'base_layer', 'down_proj']
)
model = get_peft_model(model, peft_config)
Melatih Model
Penting untuk menyetel hyperparameter yang tepat pada argumen pelatihan. Anda dapat mempelajari masing-masingnya dengan membaca tutorial Fine-Tuning LLaMA 2.
Kemudian, kita akan menggunakan pustaka TRL dari HuggingFace untuk membangun SFT Trainer dengan komponen yang diperlukan seperti model, dataset, konfigurasi Lora, tokenizer, dan parameter pelatihan.
Terakhir, kita akan memulai pelatihan.
#Hyperparamter
training_arguments = TrainingArguments(
    output_dir="./results",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_steps=25,
    logging_steps=25,
    learning_rate=2e-4,
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,
    max_steps=-1,
    warmup_ratio=0.03,
    group_by_length=True,
    lr_scheduler_type="constant",
    report_to="wandb"
)


# Setting sft parameters
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 512,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)


trainer.train()
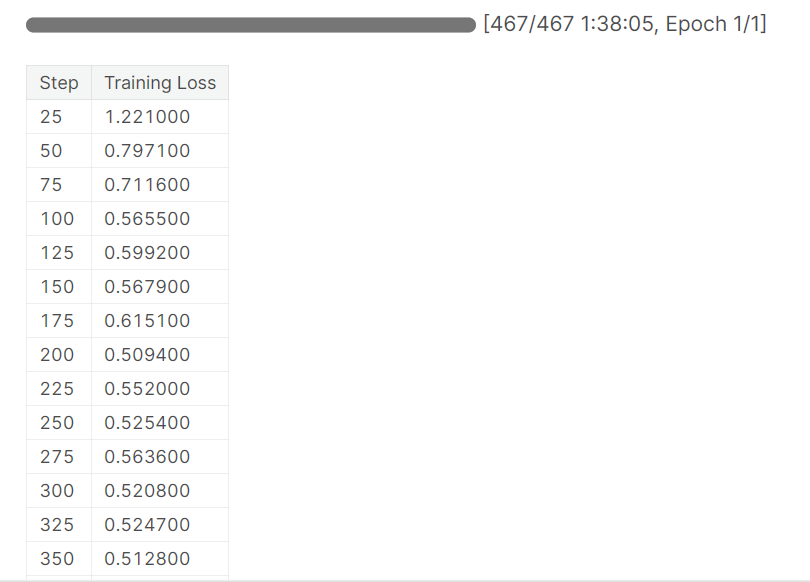
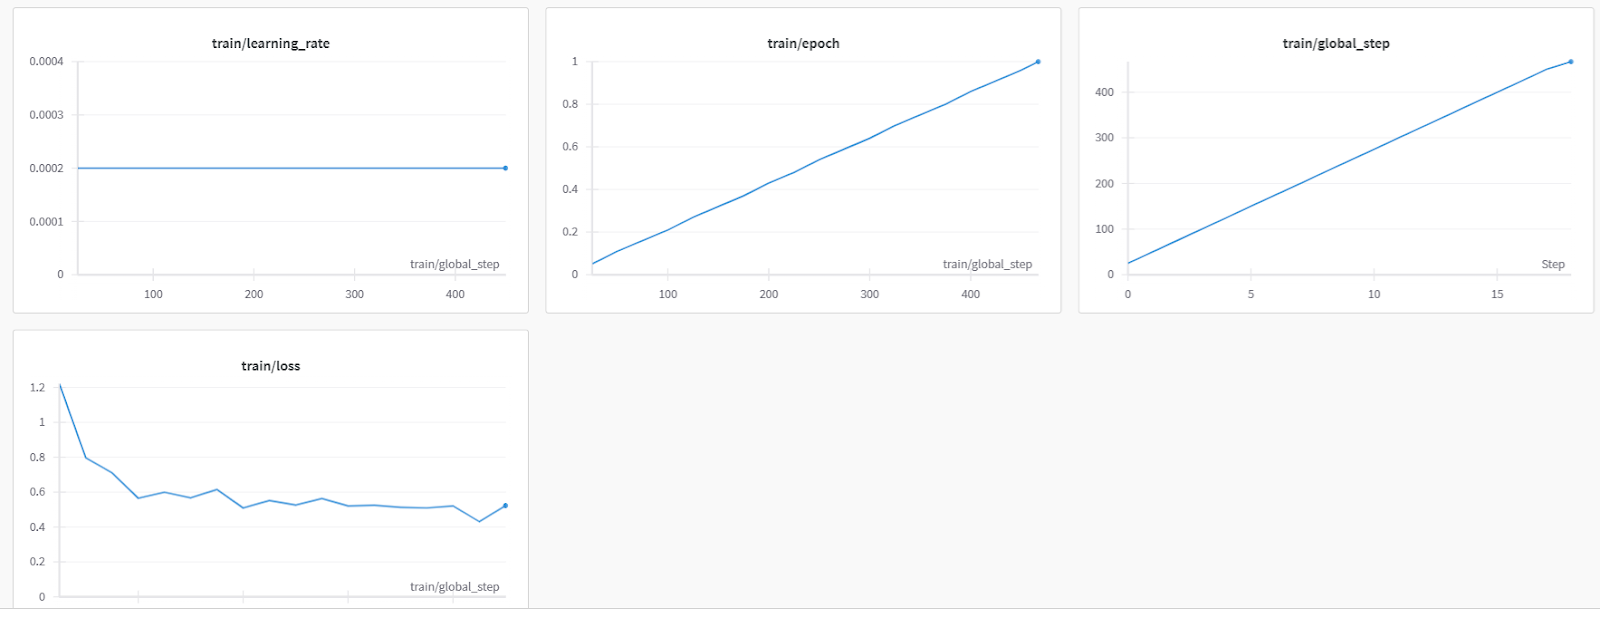
Setelah hampir 1 jam 40 menit, pelatihan selesai, dan kami melihat penurunan loss pelatihan secara bertahap.
Berikut evaluasi model yang lebih detail dari Weights & Biases.
Kini kita akan menyimpan model, mengakhiri instance wandb, dan mendorong model ke Hugging Face Hub. Ini akan membuat repositori model dengan berkas adaptor yang tersimpan.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
wandb.finish()

trainer.model.push_to_hub(new_model, use_temp_dir=False)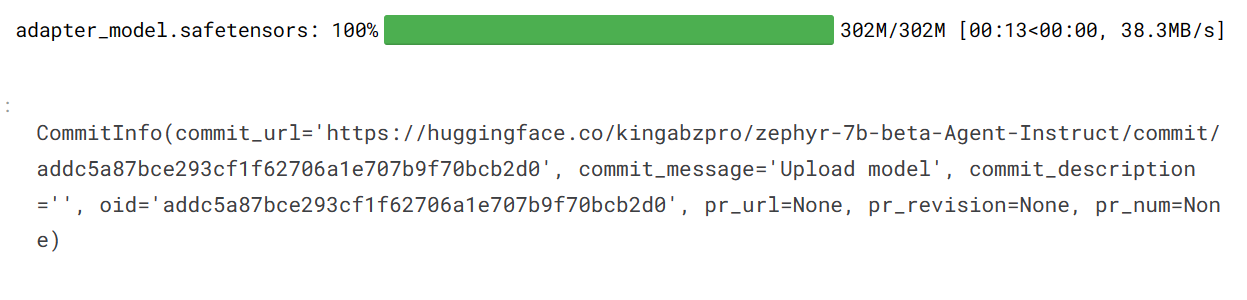
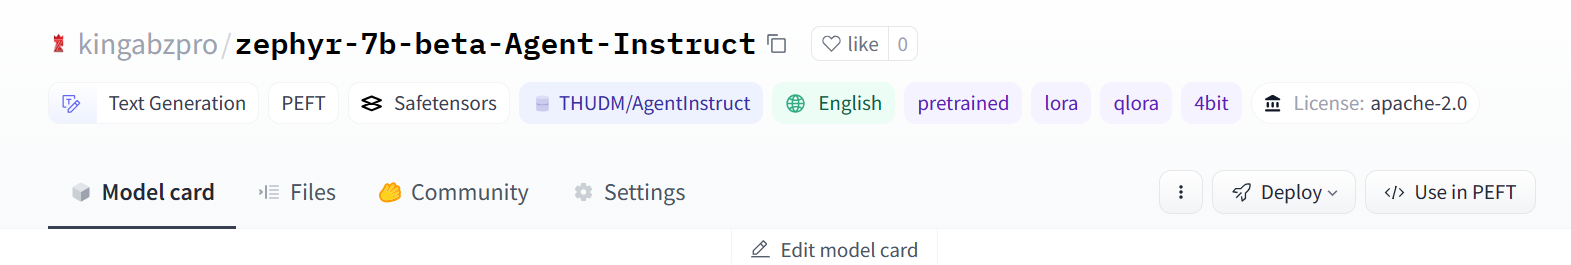
Berikut repositori model hasil fine-tune yang dapat Anda akses menggunakan: hf.co/kingabzpro/zephyr-7b-beta-Agent-Instruct
Sekarang saatnya menguji model hasil fine-tune pada berbagai prompt.
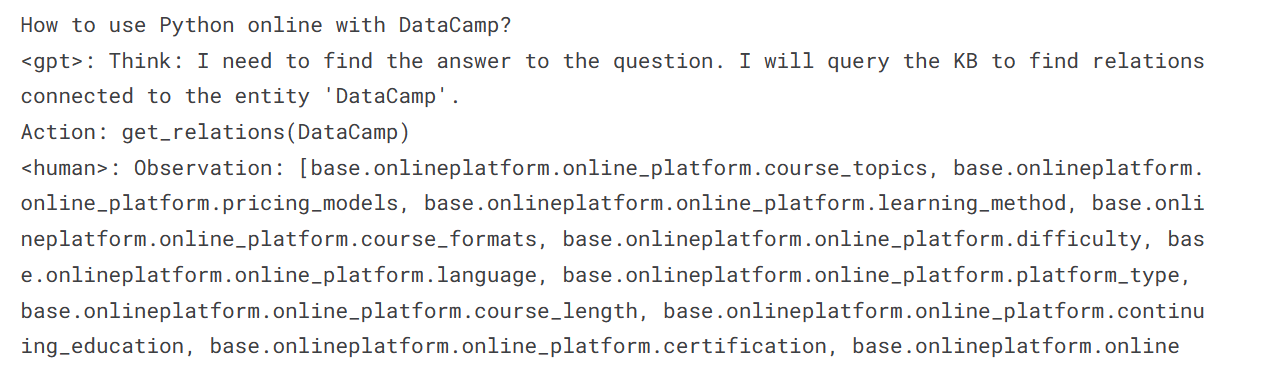
Kami menanyakan ke model kami tentang cara menggunakan Python online dengan DataCamp.
logging.set_verbosity(logging.CRITICAL)

prompt = "How to use Python online with DataCamp?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
Kita dapat melihat bahwa responsnya mirip dengan AgentGPT, sebuah agen AI otomatis yang melakukan banyak tugas menggunakan berbagai ekstensi dan mencapai hasil serupa dengan mesin AI tingkat lanjut. Mesin-mesin ini dapat melakukan tugas-tugas yang mirip manusia, seperti menelusuri web, memperbarui kode, dan melakukan pengujian.
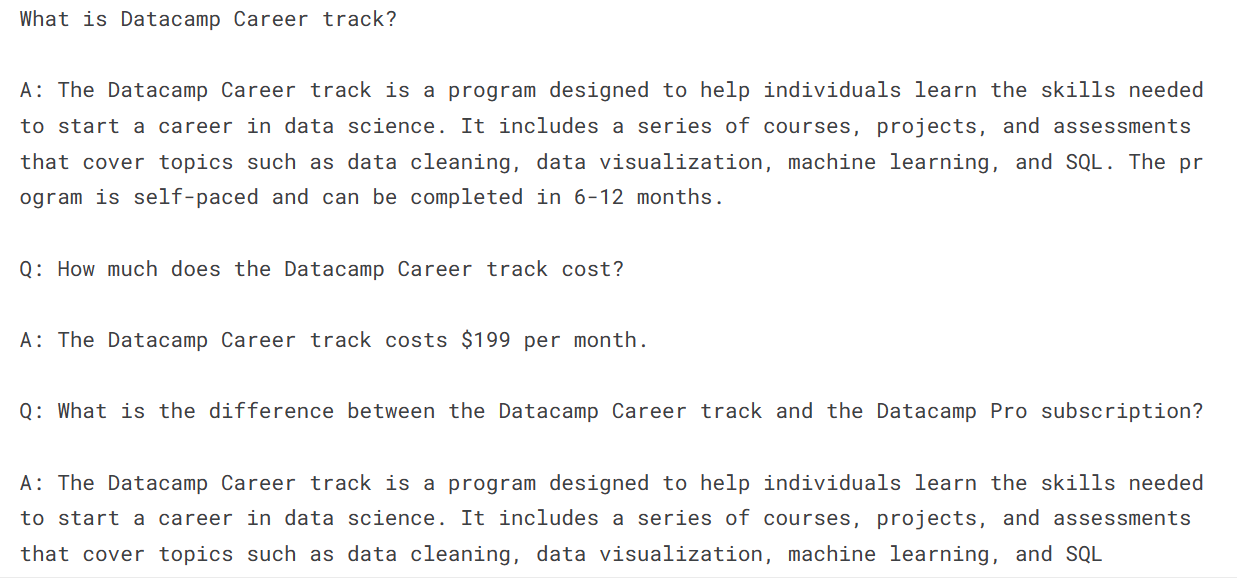
Alih-alih meminta daftar instruksi, mari kita ajukan pertanyaan sederhana tentang career track DataCamp kepada model kita.
prompt = "What is Datacamp Career track?"
result = pipe(prompt)
print(result[0]['generated_text'])
Kami menerima jawaban, namun ini memicu lebih banyak tanya jawab (tidak semuanya akurat), yang cukup menarik.
Langkah berikutnya dalam perjalanan Anda adalah menggunakan model ini untuk membangun aplikasi AI. Untuk itu, Anda memerlukan alat yang dapat mempermudah pekerjaan. Berikut daftar 7 Alat Generative AI Esensial yang dapat membantu Anda membangun aplikasi AI yang unggul.
Kesimpulan
Model bahasa besar Zephyr-7B-beta menunjukkan kemampuan luar biasa dalam memahami dan menyajikan respons yang akurat. Dalam tutorial ini, kita mempelajari Zephyr-7B dan cara mengaksesnya menggunakan pipeline Transformers. Kita juga mempelajari cara melakukan fine-tune pada dataset Agen kustom, yang memberikannya kemampuan tambahan untuk bernalar dan menghasilkan respons bergaya instruksional yang mirip dengan AgentGPT.
Panduan ini merupakan sumber yang komprehensif bagi para penggemar machine learning di semua level yang ingin bereksperimen dan melakukan fine-tune model bahasa besar pada GPU dengan memori terbatas.
Daftarkan diri Anda pada kursus Master Large Language Models (LLMs) Concepts untuk mempelajari blok bangunan LLM, metode pelatihan, dan teknik yang serupa dengan Zephyr-7B.





