
Last chance! 50% off DataCamp Premium
Sale ends in
Tutti tengono d'occhio l'OpenAI LLM Leaderboard e i nuovi modelli open source che puntano a eguagliare le prestazioni di GPT-4. Uno dei modelli di cui si parla molto ultimamente è Zephyr-7B.
In questo tutorial conosceremo un nuovo modello linguistico chiamato Zephyr-7B. Lo useremo tramite la pipeline di Transformers e faremo il fine-tuning del modello su un dataset Agent-Instruct.
Se sei alle prime armi con l'Intelligenza Artificiale, dai un'occhiata al percorso di competenze AI Fundamentals. Ti preparerà e ti metterà sulla strada per diventare l'ingegnere AI del futuro.
Zephyr-7B è un modello linguistico all'avanguardia sviluppato da WebPilot.AI. Fa parte della serie Zephyr di modelli linguistici addestrati per agire come assistenti utili. Zephyr-7B è progettato per eccellere in varie attività basate sul linguaggio, come generare testo coerente, tradurre tra lingue diverse, riassumere informazioni importanti, analizzare il sentiment e rispondere a domande in base al contesto.
Zephyr-7B-β è il secondo modello della serie. È una versione ottimizzata del modello Mistral-7B, addestrata su una combinazione di dataset pubblici e sintetici usando la Direct Preference Optimization (DPO). Di conseguenza, Zephyr-7B-β dimostra capacità che vanno dall'interpretazione di domande complesse al riassunto di lunghi passaggi di testo.
Al momento del rilascio, Zephyr-7B-β è il modello chat da 7B con il punteggio più alto nei benchmark MT-Bench e AlpacaEval. Sfrutta i più recenti progressi nell'elaborazione del linguaggio naturale per raggiungere nuovi traguardi nella comprensione e generazione di testo simile a quello umano.
Puoi provarne le prestazioni migliorate testando la demo gratuita disponibile su Zephyr Chat.
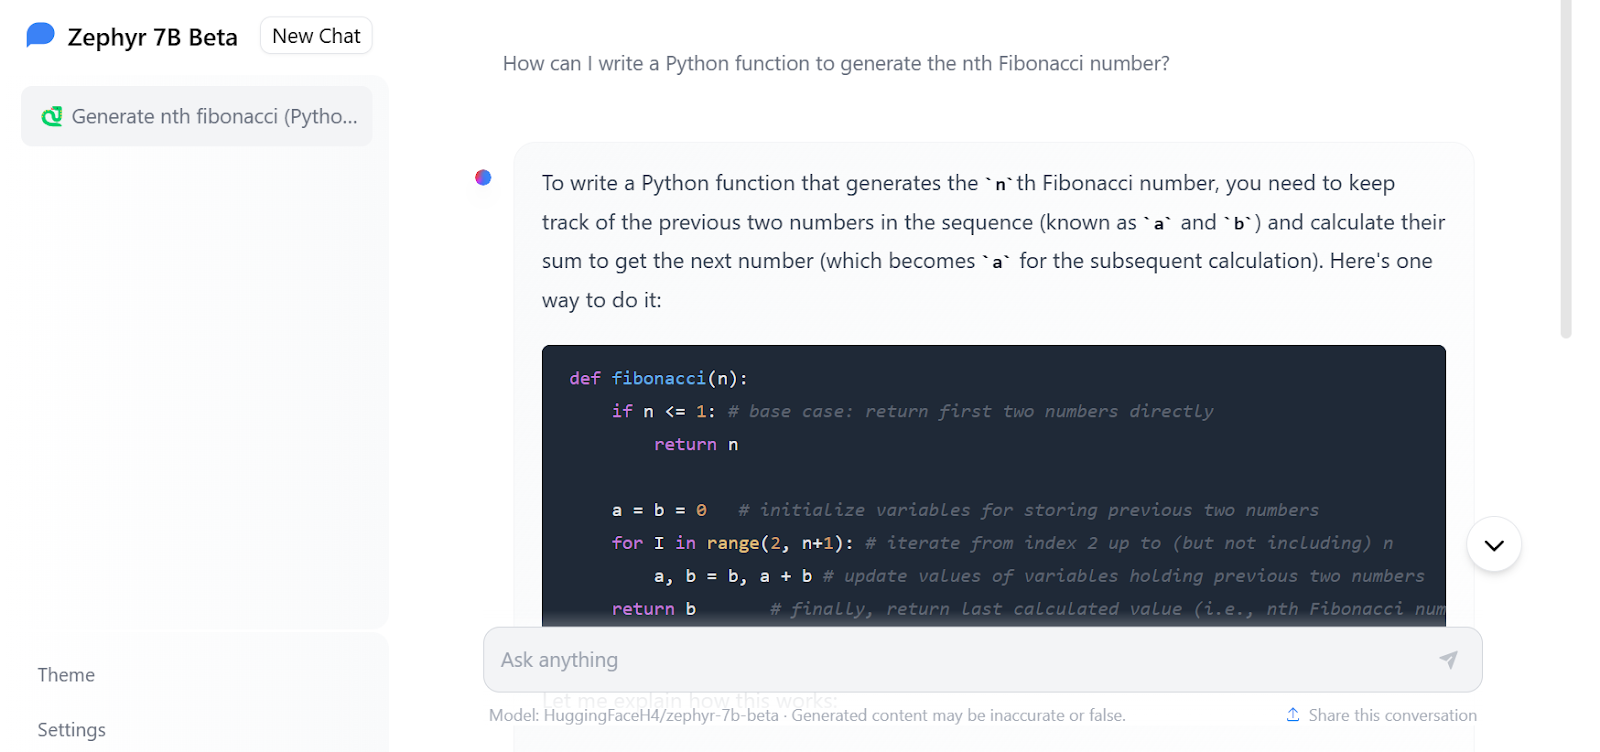
Immagine da Zephyr Chat
Come nel tutorial su Mistral 7B, caricheremo e useremo Zephyr-7B-beta tramite i transformers di Hugging Face. È piuttosto semplice.
Nota: se riscontri problemi nel caricamento del modello, consulta il Notebook Kaggle per l'inferenza.
Per prima cosa, installa tutte le librerie necessarie. Assicurati di utilizzare l'ultima versione, altrimenti non funzionerà.
!pip install -q -U transformers
!pip install -q -U accelerate
!pip install -q -U bitsandbytes
Poi, carica la libreria Pytorch e il modulo pipeline da transformers.
import torch
from transformers import pipeline
Costruiremo la pipeline di generazione del testo usando il nome del modello e gli argomenti torch_dtype e device_map.
“auto” in device_map significa che può usare più GPU per generare la risposta più velocemente.
Il torch.bfloat16 (brain float) è un tipo di dato in virgola mobile a 16 bit con la stessa dimensione dell'esponente di torch.float32 ma con mantissa ridotta. Questo consente calcoli più rapidi e un uso di memoria inferiore, ma anche minore precisione e accuratezza.
model_name = "HuggingFaceH4/zephyr-7b-beta"

pipe = pipeline(
    "text-generation",
    model=model_name,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
Dobbiamo fornire il prompt e gli altri argomenti necessari all'oggetto pipeline e stampare la risposta.
prompt = "Write a Python function that can clean the HTML tags from the file:"

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
print(outputs[0]["generated_text"])
La risposta è più che impressionante. Ha fornito il codice Python con i commenti.
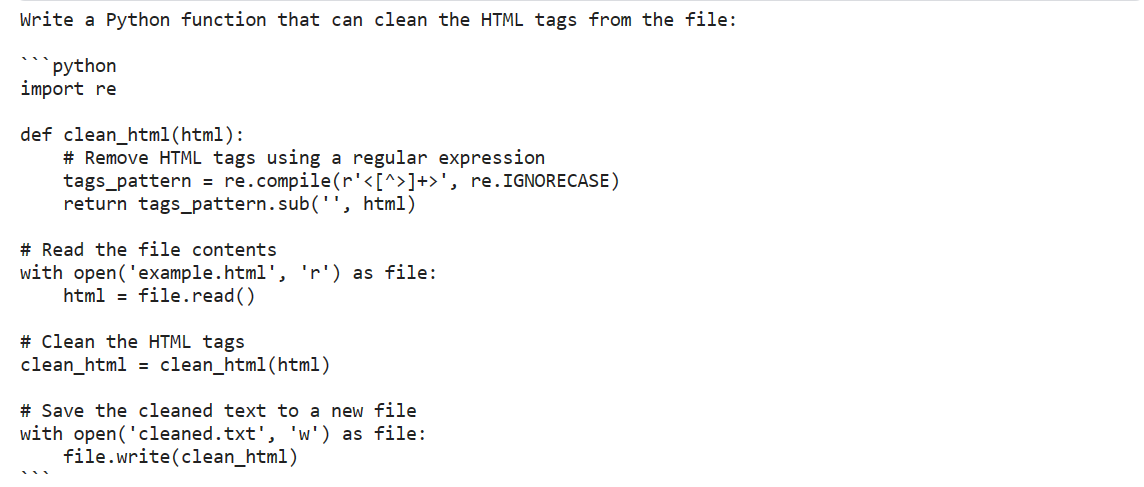
Possiamo persino personalizzare la risposta del modello fornendo il system prompt in stile Zephyr-7B.
Useremo la funzione pipe.tokenizer.apply_chat_template per creare un prompt usando un elenco di dizionari. I dizionari contengono informazioni sul ruolo e sul comportamento dell'assistente chat e il prompt dell'utente.
messages = [
    {
        "role": "system",
        "content": "You are a skilled software engineer who consistently produces high-quality Python code.",
    },
    {
        "role": "user",
        "content": "Write a Python code to display text in a star pattern.",
    },
]

prompt = pipe.tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
Infine, passeremo all'oggetto pipeline il prompt e gli argomenti aggiuntivi per generare la risposta.
outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
print(outputs[0]["generated_text"])
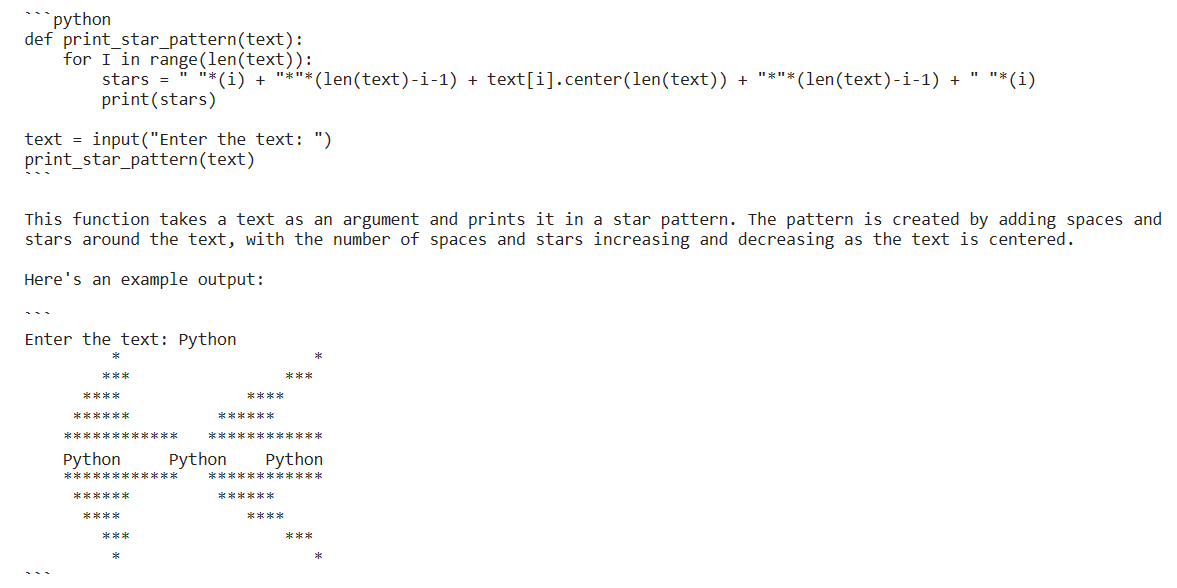
Zephyr-7B ha proposto la soluzione più ottimizzata, con spiegazione e output della funzione. È fantastico. Dovresti usarlo per generare codice Python.
In questa sezione impareremo come effettuare il fine-tuning del modello Zephyr-7B-beta su un dataset personalizzato utilizzando le GPU gratuite di Kaggle. Seguendo le istruzioni, riuscirai a preparare il tuo modello per il deployment in sole due ore.
Nota: se riscontri problemi durante l'addestramento del modello, consulta il Notebook Kaggle per il fine-tuning.
Per prima cosa, installa le librerie Python necessarie per caricare il dataset e il modello ed eseguire il fine-tuning.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trl
Poi caricheremo i moduli necessari, che ci semplificheranno la vita e ci aiuteranno ad addestrare il modello con memoria limitata.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch, wandb
from datasets import load_dataset
from trl import SFTTrainer
Questa sezione è specifica per i notebook Kaggle. Abbiamo aggiunto le chiavi API per Hugging Face e Weights & Biases (wandb) nei segreti di Kaggle. Le useremo in modo sicuro per caricare il modello su Hugging Face Hub e monitorare in tempo reale il processo di addestramento su Weights & Biases.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
secret_wandb = user_secrets.get_secret("wandb")
Accedi a Hugging Face usando la CLI e la chiave API.
!huggingface-cli login --token $secret_hfAllo stesso modo, accedi a wandb e avvia il progetto.
# Monitoring the LLM
wandb.login(key = secret_wandb)
run = wandb.init(
    project='Fine tuning Zephyr 7B',
    job_type="training",
    anonymous="allow"
)
Fornisci i nomi del modello base, del dataset e del nuovo modello per il fine-tuning, il salvataggio e la pubblicazione su Hugging Face Hub.
base_model = "HuggingFaceH4/zephyr-7b-beta"
dataset_name = "THUDM/AgentInstruct"
new_model = "zephyr-7b-beta-Agent-Instruct"Caricheremo il dataset e poi lo convertiremo nello stile di prompt Zephyr-7B usando la funzione format_prompt. La funzione estrae il ruolo e il contenuto dal dataset e li converte in stringhe lunghe che iniziano con un system prompt e terminano con un'istruzione predefinita.
#Importing the dataset
dataset = load_dataset("THUDM/AgentInstruct", split="train")
def format_prompt(sample):
    intro = "Below is a conversation between a user and you."
    end = "Instruction: Write a response appropriate to the conversation."

    try:
        formatted_conversations = "\n".join(
            f"<{resp['from']}>: {resp['value']}"
            for resp in sample["conversations"]
        )

        sample["text"] = f"{intro}\n\n{formatted_conversations}\n\n{end}"
    except (TypeError, KeyError):
        raise ValueError("Invalid format of the input sample.")
    return sample


dataset = dataset.map(
    format_prompt,
    remove_columns=["conversations"]
)
dataset["text"][100]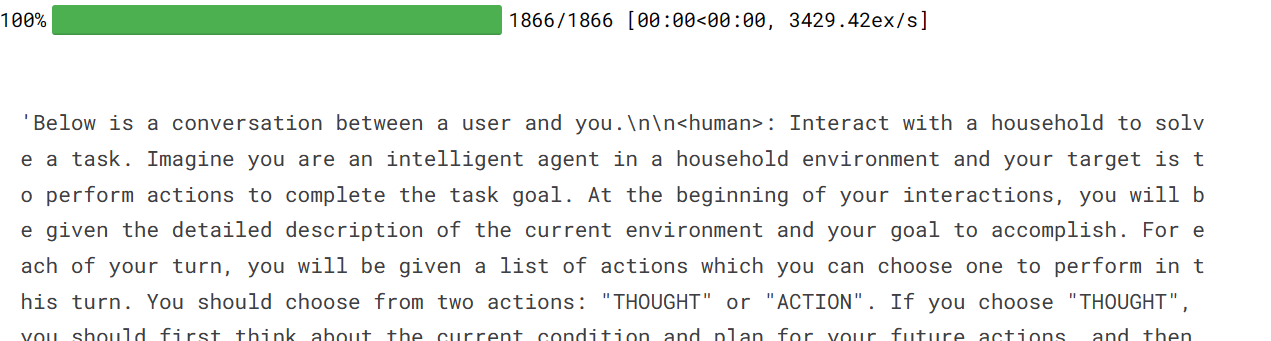
Scaricheremo e caricheremo da Hugging Face un modello a 4 bit per abilitare un addestramento più rapido. Questo è necessario per il fine-tuning su GPU con VRAM limitata. Successivamente caricheremo il tokenizer e lo configureremo per correggere il problema con fp16.
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)
model = AutoModelForCausalLM.from_pretrained(
        base_model,
        load_in_4bit=True,
        quantization_config=bnb_config,
        torch_dtype=torch.bfloat16,
        device_map="auto",
        trust_remote_code=True,
)
model.config.use_cache = False
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_tokenOra aggiungeremo uno strato adapter al nostro modello, permettendoci di fare fine-tuning in modo più efficiente. Invece di aggiornare l'intero modello, aggiorneremo solo i parametri nello strato adapter per un addestramento più rapido.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=['up_proj', 'base_layer', 'down_proj']
)
model = get_peft_model(model, peft_config)È importante impostare gli iperparametri corretti negli argomenti di training. Puoi approfondire ciascuno leggendo il tutorial Fine-Tuning di LLaMA 2.
Poi useremo la libreria TRL di Hugging Face per costruire l'SFT Trainer con i componenti necessari come modello, dataset, configurazione Lora, tokenizer e parametri di training.
Infine, avvieremo l'addestramento.
#Hyperparamter
training_arguments = TrainingArguments(
    output_dir="./results",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_steps=25,
    logging_steps=25,
    learning_rate=2e-4,
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,
    max_steps=-1,
    warmup_ratio=0.03,
    group_by_length=True,
    lr_scheduler_type="constant",
    report_to="wandb"
)


# Setting sft parameters
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 512,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)


trainer.train()
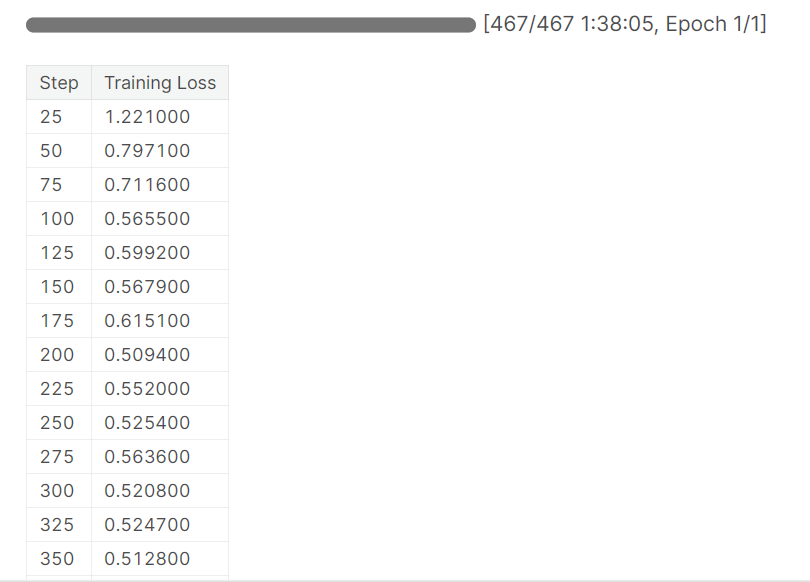
Dopo circa 1 ora e 40 minuti, l'addestramento è terminato e abbiamo osservato una riduzione graduale della training loss.
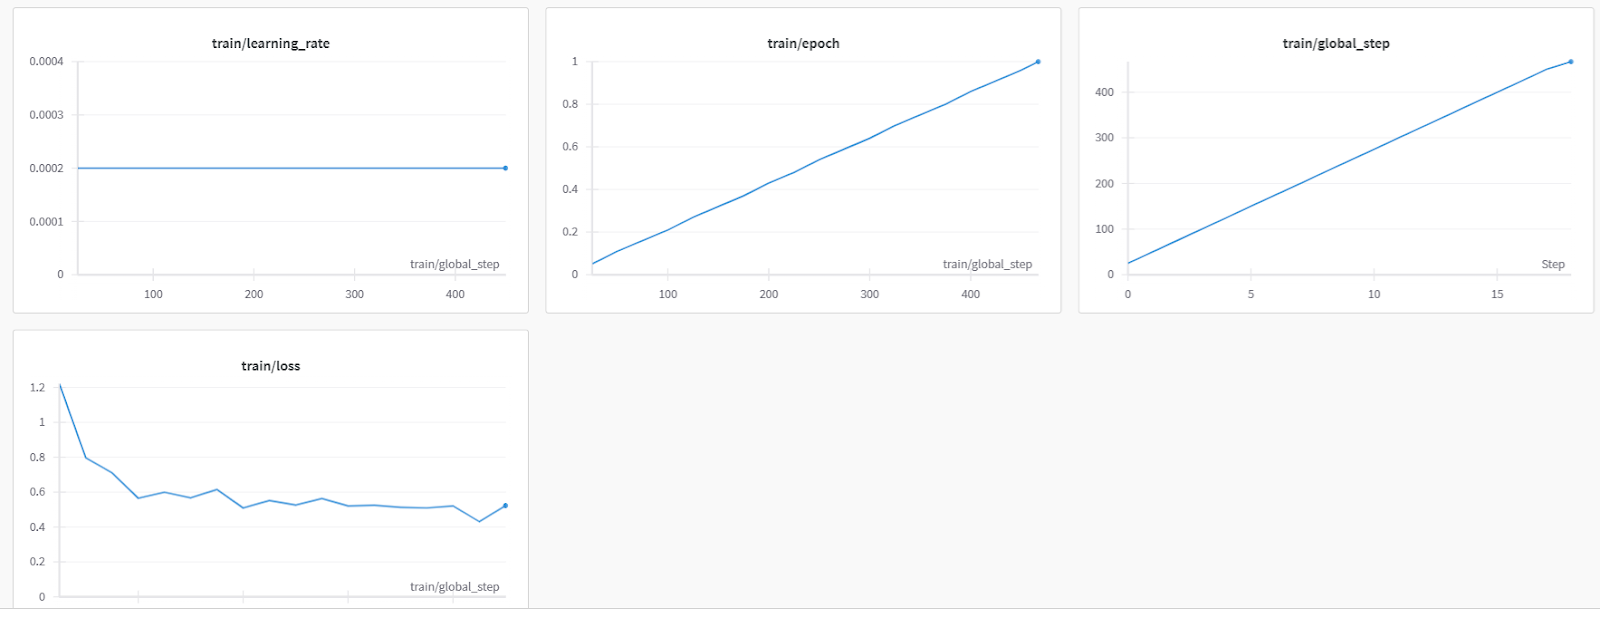
Ecco una valutazione del modello più dettagliata da Weights & Biases.
Ora salveremo il modello, chiuderemo l'istanza wandb e caricheremo il modello su Hugging Face Hub. Questo creerà un repository del modello con un file adapter salvato.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
wandb.finish()

trainer.model.push_to_hub(new_model, use_temp_dir=False)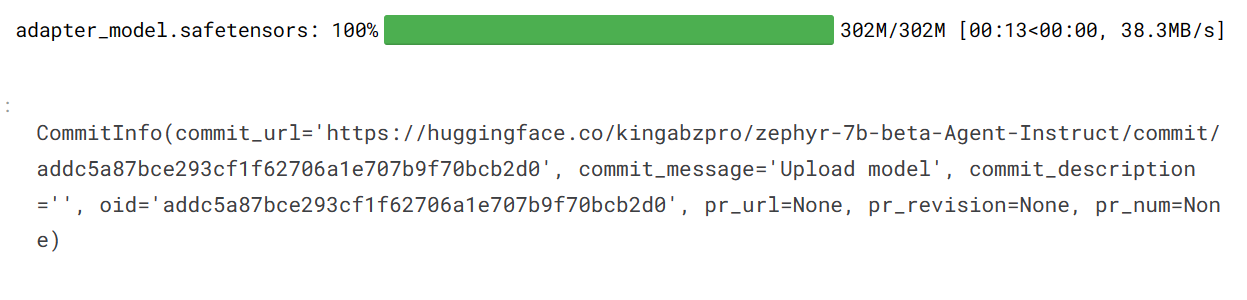
Ecco il repository del modello con fine-tuning a cui puoi accedere usando: hf.co/kingabzpro/zephyr-7b-beta-Agent-Instruct
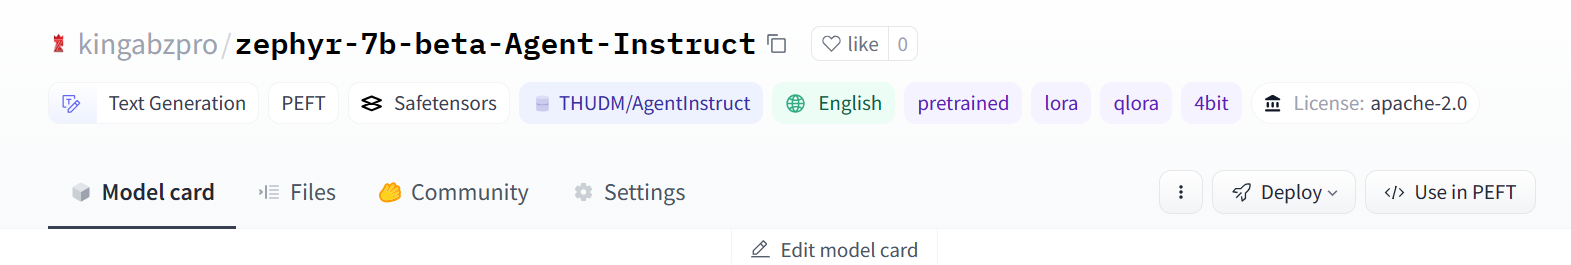
È il momento di testare il nostro modello con fine-tuning su vari prompt.
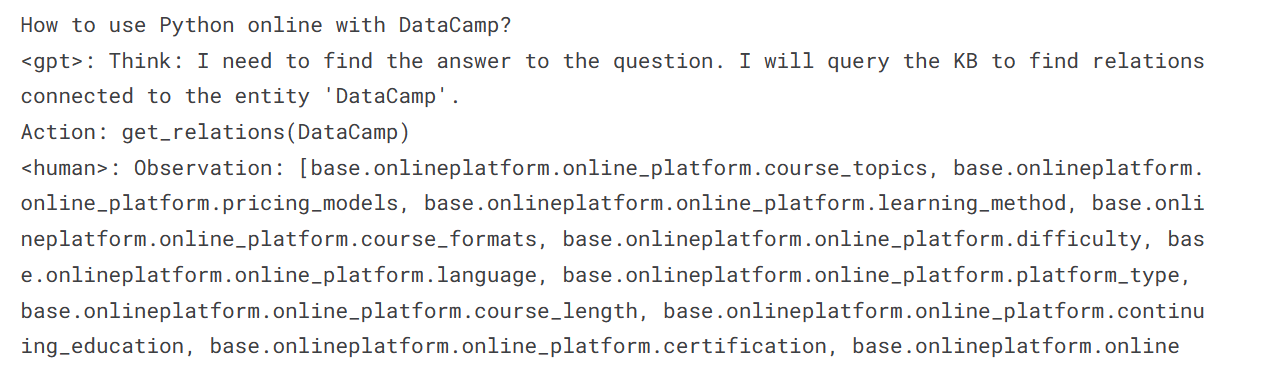
Abbiamo chiesto al nostro modello come usare Python online con DataCamp.
logging.set_verbosity(logging.CRITICAL)

prompt = "How to use Python online with DataCamp?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
Possiamo vedere che la risposta è simile a quella di AgentGPT, un agente AI automatico che svolge più attività usando varie estensioni e raggiunge risultati simili a macchine AI avanzate. Queste macchine possono eseguire compiti simili a quelli umani, come cercare sul web, aggiornare il codice e fare test.
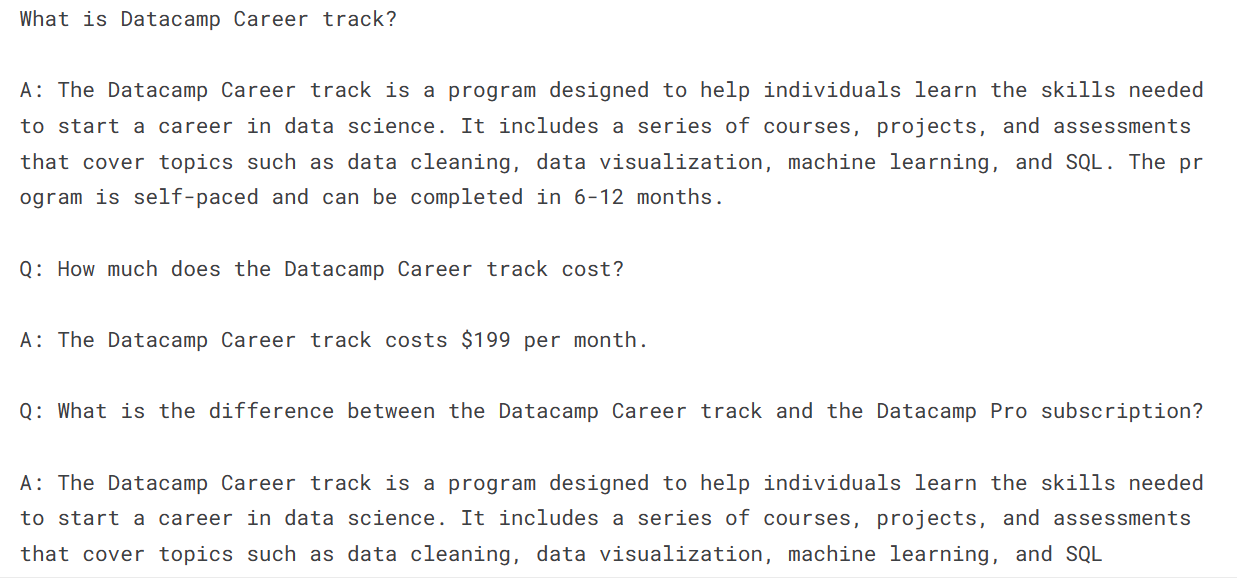
Invece di richiedere elenchi di istruzioni, chiediamo al nostro modello una domanda semplice sul career track di DataCamp.
prompt = "What is Datacamp Career track?"
result = pipe(prompt)
print(result[0]['generated_text'])
Abbiamo ricevuto una risposta, ma ha portato ad altre domande e risposte (non tutte accurate), il che è interessante.
Il prossimo passo del tuo percorso è usare questo modello per creare la tua applicazione AI. Per farlo, ti servono strumenti che ti semplifichino la vita. Ecco un elenco di 7 strumenti essenziali di Generative AI che possono aiutarti a realizzare applicazioni AI di alto livello.
Il large language model Zephyr-7B-beta ha mostrato un'incredibile capacità di comprendere e fornire risposte accurate. In questo tutorial abbiamo visto cos'è Zephyr-7B e come accedervi tramite la pipeline di Transformers. Abbiamo anche imparato a fare fine-tuning su un dataset Agent personalizzato, che gli ha conferito una maggiore capacità di ragionamento e di produrre risposte in stile istruzionale simili ad AgentGPT.
Questa guida è una risorsa completa per gli appassionati di machine learning di ogni livello che vogliono sperimentare e fare fine-tuning di large language model su GPU con memoria limitata.
Iscriviti al corso Master Large Language Models (LLMs) Concepts per imparare i blocchi costitutivi degli LLM, i metodi di addestramento e le tecniche simili a Zephyr-7B.
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min




