Todo mundo está de olho no OpenAI LLM Leaderboard e nos novos modelos open source que buscam alcançar o desempenho do GPT-4. Um dos modelos que mais vem chamando atenção é o Zephyr-7B.
Neste tutorial, você vai conhecer o Zephyr-7B, um novo modelo de linguagem. Vamos acessá-lo usando o pipeline do Transformers e fazer fine-tuning do modelo em um dataset Agent-Instruct.
Se você está começando em Inteligência artificial, confira a trilha de habilidades AI Fundamentals. Ela vai preparar você e colocar seu aprendizado no caminho para se tornar o engenheiro de IA do futuro.
Entendendo o Zephyr-7B
O Zephyr-7B é um modelo de linguagem de última geração desenvolvido pela WebPilot.AI. Ele faz parte da família Zephyr de modelos treinados para agir como assistentes úteis. O Zephyr-7B foi projetado para se destacar em várias tarefas baseadas em linguagem, como gerar texto coerente, traduzir entre idiomas, resumir informações importantes, analisar sentimento e responder perguntas com base em contexto.
Zephyr-7B-β
O Zephyr-7B-β é o segundo modelo da série. Ele é uma versão do Mistral-7B com fine-tuning, treinada em uma combinação de datasets públicos e sintéticos usando Direct Preference Optimization (DPO). Como resultado, o Zephyr-7B-β demonstra capacidades que vão desde interpretar perguntas complexas até resumir textos longos.
No lançamento, o Zephyr-7B-β é o modelo de chat 7B mais bem posicionado nos benchmarks MT-Bench e AlpacaEval. Ele aproveita os avanços mais recentes em processamento de linguagem natural para alcançar novos patamares na compreensão e geração de texto com qualidade humana.
Você pode experimentar esse desempenho aprimorado em um demo gratuito no Zephyr Chat.
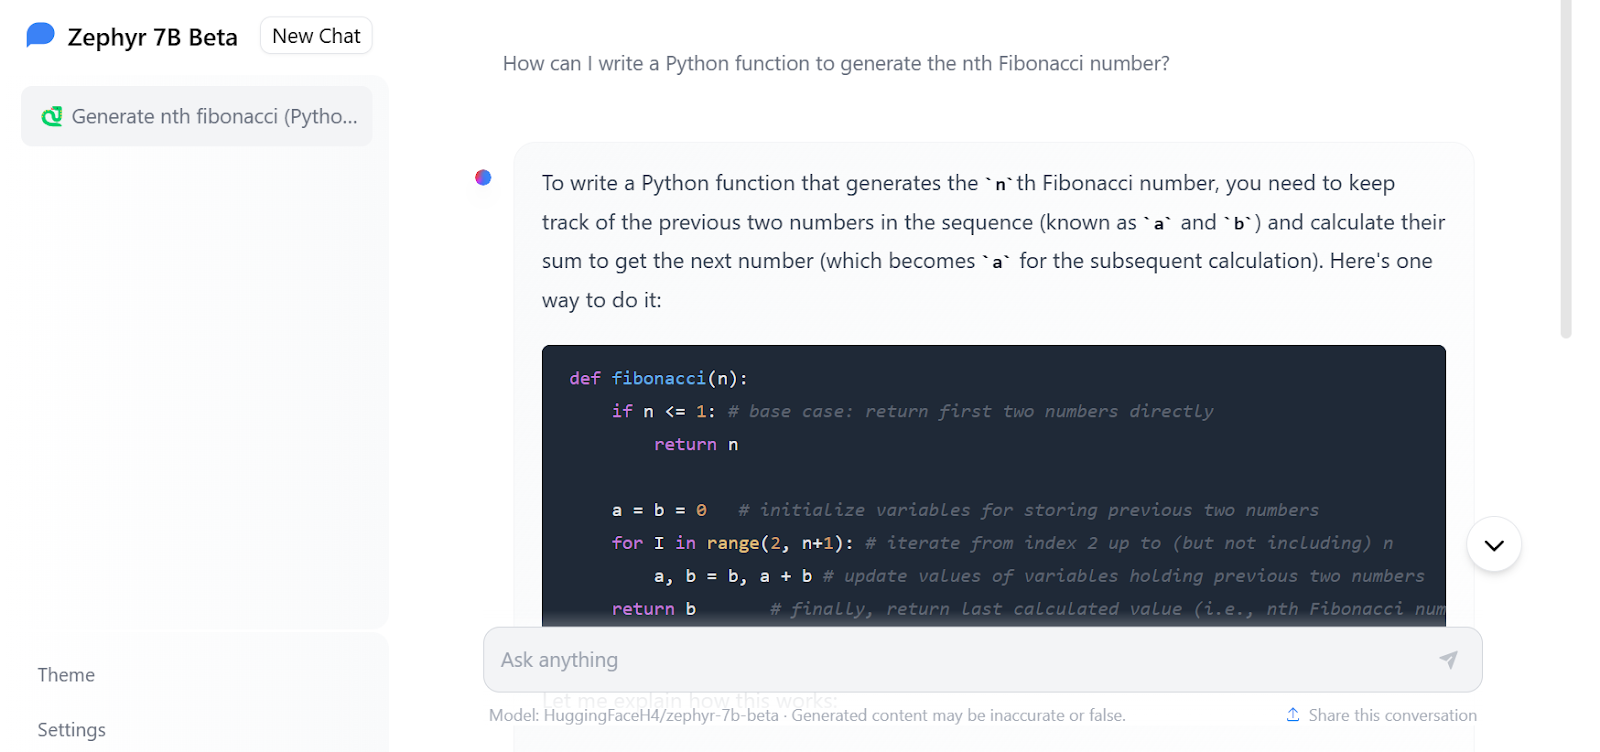
Imagem do Zephyr Chat
Acessando o Zephyr-7B
Assim como no tutorial do Mistral 7B, vamos carregar e usar o Zephyr-7B-beta com o transformers do Hugging Face. É bem direto.
Observação: se você estiver com problemas para carregar o modelo, confira o notebook de inferência no Kaggle.
Primeiro, instale todas as bibliotecas necessárias. Certifique-se de estar usando a versão mais recente, caso contrário não vai funcionar.
!pip install -q -U transformers
!pip install -q -U accelerate
!pip install -q -U bitsandbytes
Depois, carregue a biblioteca Pytorch e o módulo pipeline do transformers.
import torch
from transformers import pipeline
Vamos construir o pipeline de geração de texto usando o nome do modelo, os argumentos torch_dtype e device_map.
O "auto" em device_map indica que ele pode usar várias GPUs para gerar a resposta mais rápido.
O torch.bfloat16 (brain float) é um tipo de ponto flutuante de 16 bits que tem o mesmo tamanho de expoente do torch.float32, mas uma mantissa reduzida. Isso permite computação mais rápida e menor uso de memória, com menor precisão.
model_name = "HuggingFaceH4/zephyr-7b-beta"

pipe = pipeline(
    "text-generation",
    model=model_name,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
Precisamos fornecer o prompt e outros argumentos necessários para o objeto pipeline e imprimir a resposta.
prompt = "Write a Python function that can clean the HTML tags from the file:"

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
print(outputs[0]["generated_text"])
A resposta é muito boa. Ele forneceu o código em Python com comentários.
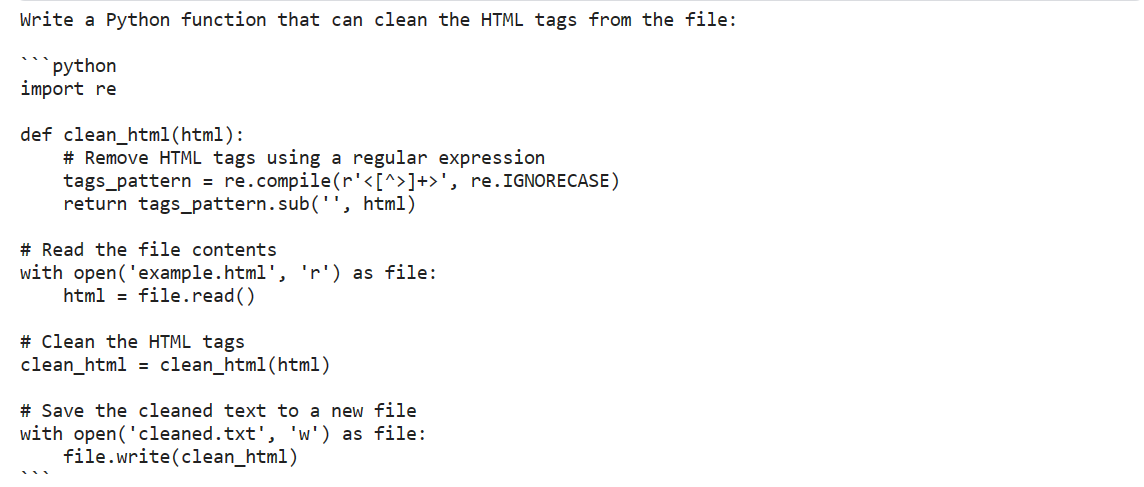
Também dá para personalizar a resposta do modelo fornecendo um system prompt no estilo do Zephyr-7B.
Vamos usar a função pipe.tokenizer.apply_chat_template para criar um prompt usando uma lista de dicionários. Os dicionários trazem informações sobre o papel e o comportamento do assistente de chat e o prompt do usuário.
messages = [
    {
        "role": "system",
        "content": "You are a skilled software engineer who consistently produces high-quality Python code.",
    },
    {
        "role": "user",
        "content": "Write a Python code to display text in a star pattern.",
    },
]

prompt = pipe.tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
Por fim, vamos passar o prompt e os argumentos adicionais para o pipeline para gerar a resposta.
outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
print(outputs[0]["generated_text"])
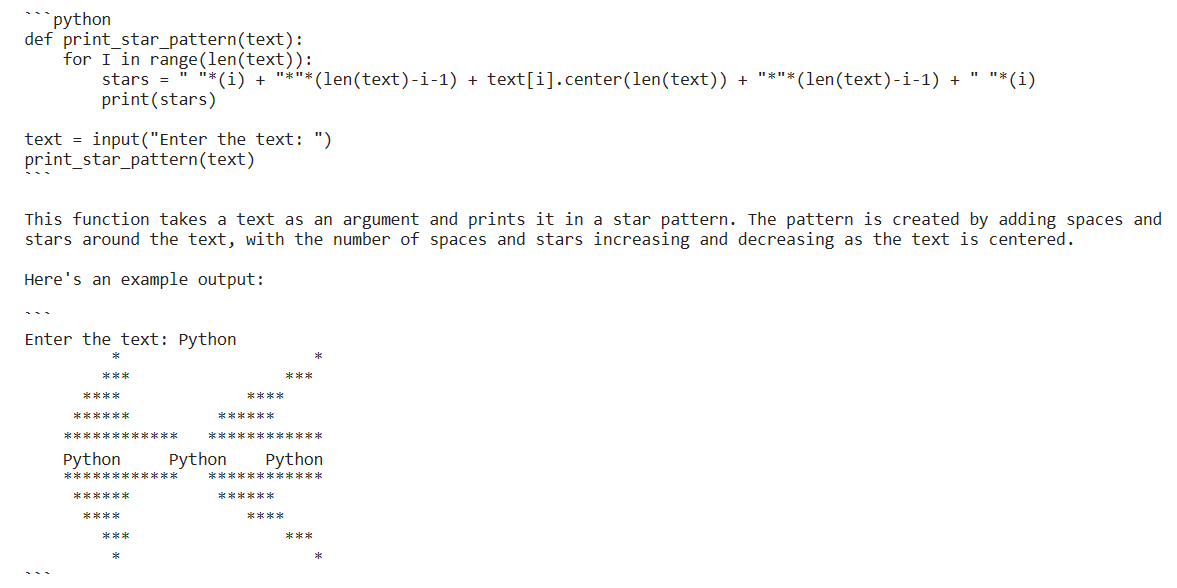
O Zephyr-7B chegou à solução mais otimizada, com explicação e o output da função. Incrível. Vale a pena usar para gerar código Python.
Fazendo fine-tuning do Zephyr-7B
Nesta seção, você vai aprender a fazer fine-tuning do Zephyr-7B-beta em um dataset personalizado usando as GPUs gratuitas do Kaggle. Seguindo as instruções, você consegue preparar seu modelo para deploy em apenas duas horas.
Observação: se você estiver com problemas para treinar o modelo, confira o notebook de fine-tuning no Kaggle.
Configuração inicial
Primeiro, instale as bibliotecas Python necessárias para carregar o dataset e o modelo e fazer o fine-tuning.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trl
Depois, vamos carregar os módulos necessários que facilitam nossa vida e ajudam a treinar o modelo com memória limitada.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch, wandb
from datasets import load_dataset
from trl import SFTTrainer
Esta parte é específica para notebooks do Kaggle. Adicionamos as chaves de API do Hugging Face e do Weights & Biases (wandb) nos segredos do Kaggle. Vamos usá-las com segurança para enviar o modelo ao Hugging Face Hub e monitorar o treinamento ao vivo no servidor do Weights & Biases.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
secret_wandb = user_secrets.get_secret("wandb")
Faça login no Hugging Face usando a CLI e a chave de API.
!huggingface-cli login --token $secret_hfDa mesma forma, faça login no wandb e inicie o projeto.
# Monitoring the LLM
wandb.login(key = secret_wandb)
run = wandb.init(
    project='Fine tuning Zephyr 7B',
    job_type="training",
    anonymous="allow"
)
Informe os nomes do modelo base, do dataset e do novo modelo para fazer o fine-tuning, salvar e enviar ao Hugging Face Hub.
base_model = "HuggingFaceH4/zephyr-7b-beta"
dataset_name = "THUDM/AgentInstruct"
new_model = "zephyr-7b-beta-Agent-Instruct"
Dataset AgentInstruct
Vamos carregar o dataset e convertê-lo para o estilo de prompt do Zephyr-7B usando a função format_prompt. A função extrai o papel e o conteúdo do dataset e os converte em strings longas que começam com o system prompt e terminam com uma instrução padrão.
#Importing the dataset
dataset = load_dataset("THUDM/AgentInstruct", split="train")
def format_prompt(sample):
    intro = "Below is a conversation between a user and you."
    end = "Instruction: Write a response appropriate to the conversation."

    try:
        formatted_conversations = "\n".join(
            f"<{resp['from']}>: {resp['value']}"
            for resp in sample["conversations"]
        )

        sample["text"] = f"{intro}\n\n{formatted_conversations}\n\n{end}"
    except (TypeError, KeyError):
        raise ValueError("Invalid format of the input sample.")
    return sample


dataset = dataset.map(
    format_prompt,
    remove_columns=["conversations"]
)
dataset["text"][100]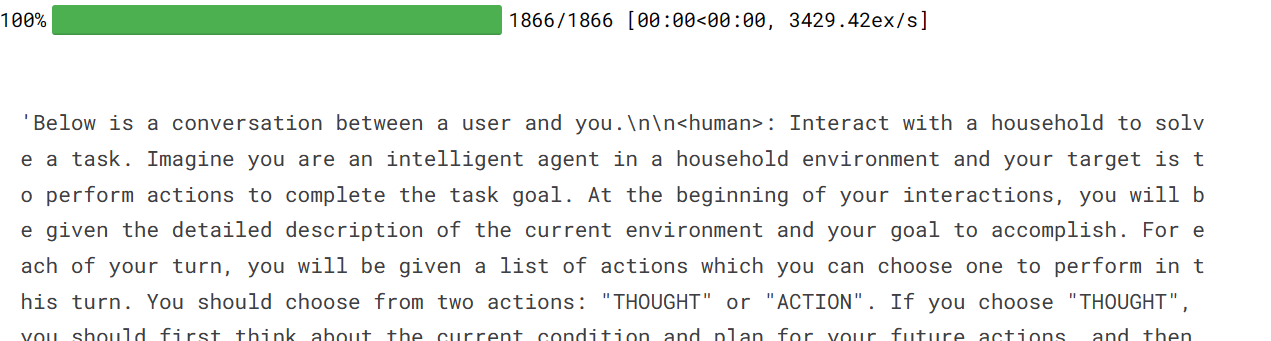
Carregando o modelo e o tokenizer
Vamos baixar e carregar um modelo em precisão de 4 bits do Hugging Face para permitir um treinamento mais rápido. Isso é necessário para fine-tuning em GPUs com VRAM limitada. Depois, vamos carregar o tokenizer e configurá-lo para corrigir o problema com fp16.
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)
model = AutoModelForCausalLM.from_pretrained(
        base_model,
        load_in_4bit=True,
        quantization_config=bnb_config,
        torch_dtype=torch.bfloat16,
        device_map="auto",
        trust_remote_code=True,
)
model.config.use_cache = False
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_token
Montando o modelo
Agora vamos adicionar uma camada adaptadora ao nosso modelo, permitindo fazer fine-tuning com mais eficiência. Em vez de ajustar o modelo inteiro, vamos atualizar apenas os parâmetros da camada adaptadora para treinar mais rápido.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=['up_proj', 'base_layer', 'down_proj']
)
model = get_peft_model(model, peft_config)
Treinando o modelo
É importante definir os hiperparâmetros corretos nos argumentos de treinamento. Você pode saber mais sobre cada um lendo o tutorial Fine-Tuning do LLaMA 2.
Em seguida, vamos usar a biblioteca TRL do Hugging Face para construir o SFT Trainer com os componentes necessários, como modelo, dataset, configuração Lora, tokenizer e parâmetros de treinamento.
Por fim, vamos iniciar o treinamento.
#Hyperparamter
training_arguments = TrainingArguments(
    output_dir="./results",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_steps=25,
    logging_steps=25,
    learning_rate=2e-4,
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,
    max_steps=-1,
    warmup_ratio=0.03,
    group_by_length=True,
    lr_scheduler_type="constant",
    report_to="wandb"
)


# Setting sft parameters
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 512,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)


trainer.train()
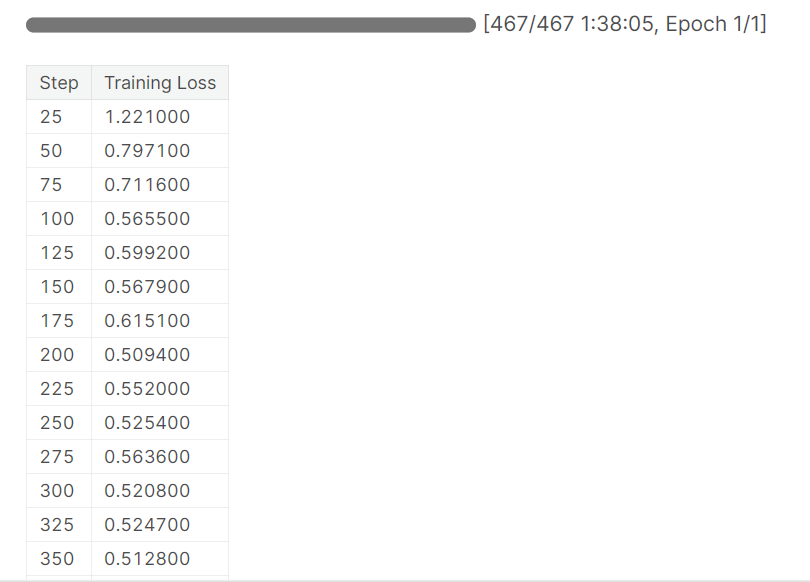
Após cerca de 1 hora e 40 minutos, o treinamento terminou e observamos uma redução gradual da loss de treinamento.
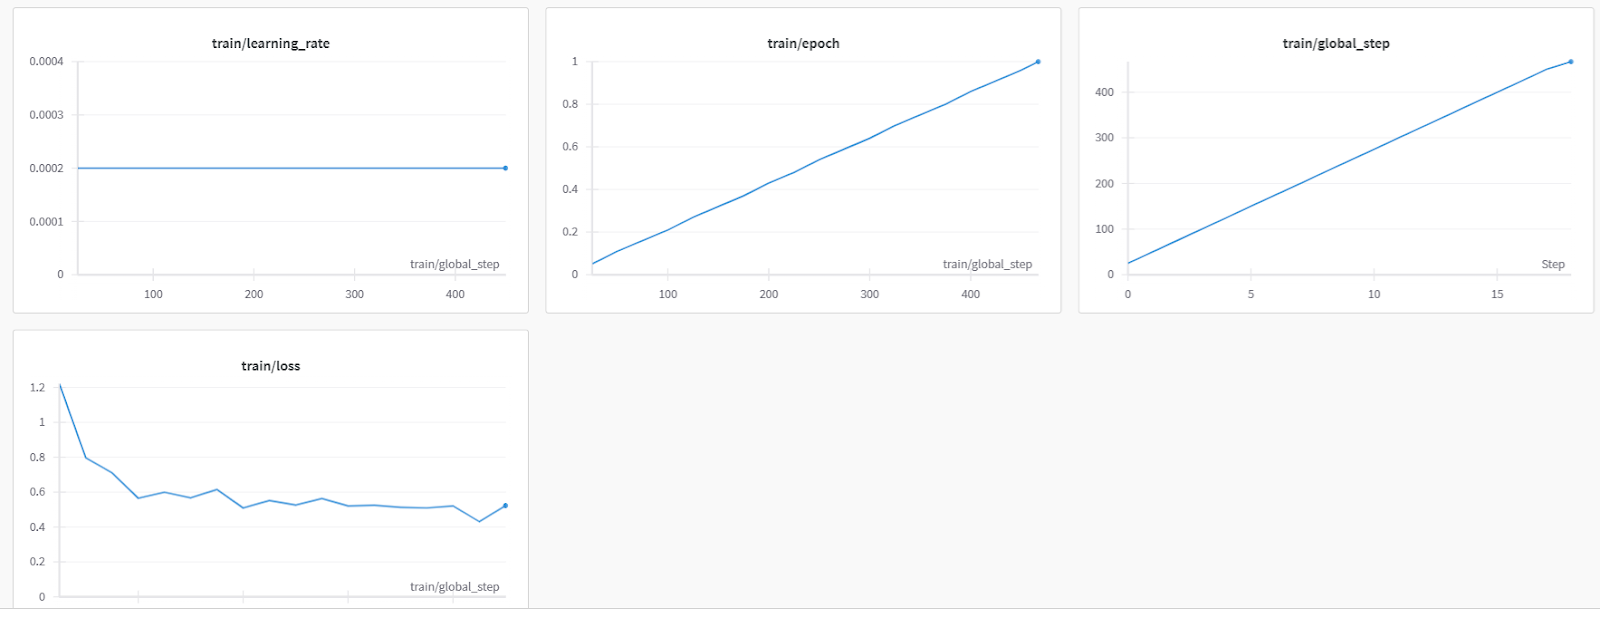
Aqui está uma avaliação mais detalhada do modelo no Weights & Biases.
Agora vamos salvar o modelo, finalizar a instância do wandb e enviar o modelo para o Hugging Face Hub. Isso vai criar um repositório com o arquivo do adaptador salvo.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
wandb.finish()

trainer.model.push_to_hub(new_model, use_temp_dir=False)
Aqui está o repositório do modelo com fine-tuning, que você pode acessar em: hf.co/kingabzpro/zephyr-7b-beta-Agent-Instruct
Hora de testar nosso modelo com fine-tuning em vários prompts.
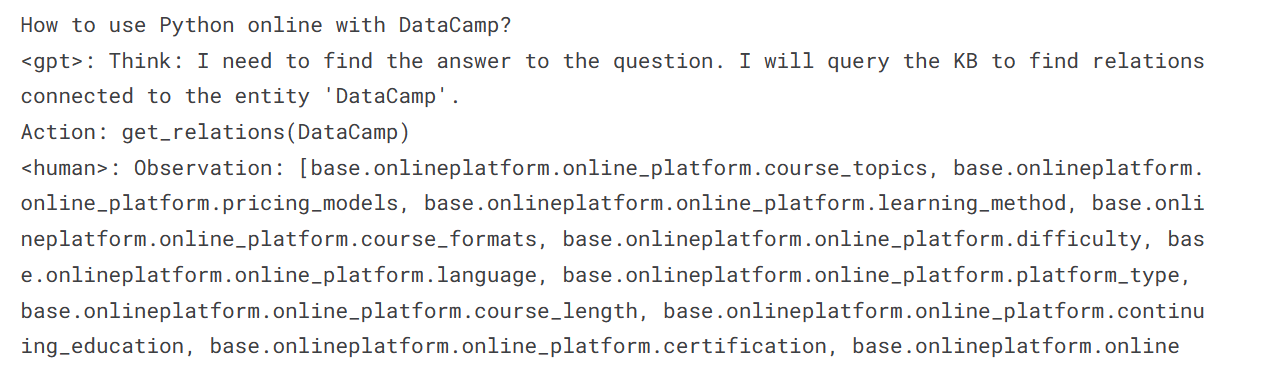
Perguntamos ao nosso modelo como usar Python online com a DataCamp.
logging.set_verbosity(logging.CRITICAL)

prompt = "How to use Python online with DataCamp?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
Percebemos que a resposta é semelhante à do AgentGPT, um agente de IA automático que executa várias tarefas usando extensões e alcança resultados comparáveis a sistemas de IA avançados. Esses sistemas conseguem realizar tarefas semelhantes às humanas, como pesquisar na web, atualizar código e testar.
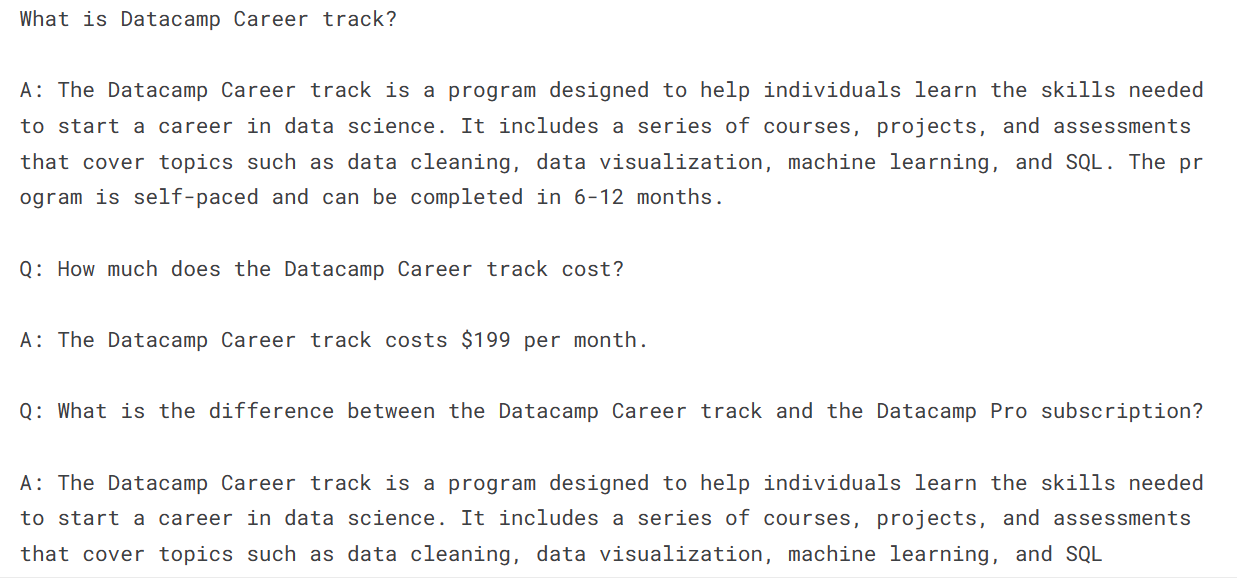
Em vez de solicitar listas de instruções, vamos fazer uma pergunta simples sobre a trilha de carreira da DataCamp.
prompt = "What is Datacamp Career track?"
result = pipe(prompt)
print(result[0]['generated_text'])
Recebemos uma resposta, mas ela gerou mais perguntas e respostas (nem todas precisas), o que é curioso.
O próximo passo da sua jornada é usar este modelo para construir sua aplicação de IA. Para isso, você precisa de ferramentas que facilitem sua vida. Confira esta lista de 7 ferramentas essenciais de IA generativa que podem ajudar você a criar aplicações de IA de alto nível.
Conclusão
O large language model Zephyr-7B-beta mostrou uma capacidade impressionante de entender e apresentar respostas consistentes. Neste tutorial, vimos o que é o Zephyr-7B e como acessá-lo pelo pipeline do Transformers. Também aprendemos como fazer fine-tuning em um dataset Agent personalizado, o que deu a ele mais capacidade de raciocínio e respostas no estilo instrucional, semelhantes ao AgentGPT.
Este guia é um recurso completo para entusiastas de machine learning de todos os níveis que querem experimentar e fazer fine-tuning de large language models em GPUs com memória limitada.
Inscreva-se no curso Master Large Language Models (LLMs) Concepts para aprender sobre os blocos de construção de LLMs, métodos de treinamento e técnicas semelhantes às do Zephyr-7B.

Série Code Along: Torne-se um desenvolvedor de IA
Crie sistemas de IA e desenvolva aplicativos de IA usando OpenAI, LangChain, Pinecone e Hugging Face!