Herkes OpenAI LLM Liderlik Tablosunu ve GPT-4 performansına yaklaşmayı hedefleyen yeni açık kaynak modelleri yakından takip ediyor. Son zamanlarda çokça konuşulan modellerden biri de Zephyr-7B.
Bu eğitimde, Zephyr-7B adlı yeni bir dil modelini ele alacağız. Transformers pipeline’ını kullanarak ona erişecek ve modeli bir Agent-Instruct veri kümesi üzerinde ince ayar yapacağız.
Yapay Zekâda yeniyseniz, AI Fundamentals yetkinlik yoluna göz atın. Geleceğin yapay zekâ mühendisi olma yolunda sizi hazırlayacaktır.
Zephyr-7B’yi Anlamak
Zephyr-7B, WebPilot.AI tarafından geliştirilen ileri düzey bir dil modelidir. Yardımcı asistanlar gibi davranacak şekilde eğitilen Zephyr serisinin bir parçasıdır. Zephyr-7B; tutarlı metin üretme, farklı diller arasında çeviri yapma, önemli bilgileri özetleme, duygu analizi ve bağlama dayalı soruları yanıtlama gibi çeşitli dil tabanlı görevlerde üstün performans gösterecek şekilde tasarlanmıştır.
Zephyr-7B-β
Zephyr-7B-β serideki ikinci modeldir. Mistral-7B modelinin, kamusal ve sentetik veri kümelerinin bir kombinasyonu üzerinde Doğrudan Tercih Optimizasyonu (DPO) kullanılarak ince ayar yapılmış sürümüdür. Sonuç olarak, Zephyr-7B-β karmaşık soruları yorumlamaktan uzun metin pasajlarını özetlemeye kadar uzanan yetenekler sergiler.
Yayınlandığı tarihte Zephyr-7B-β, MT-Bench ve AlpacaEval kıyaslamalarında en yüksek sıralamaya sahip 7B sohbet modelidir. İnsan benzeri metni anlama ve üretmede yeni seviyelere ulaşmak için doğal dil işlemedeki en son gelişmelerden yararlanır.
Geliştirilmiş performansını Zephyr Chat üzerindeki ücretsiz demoyu deneyerek görebilirsiniz.
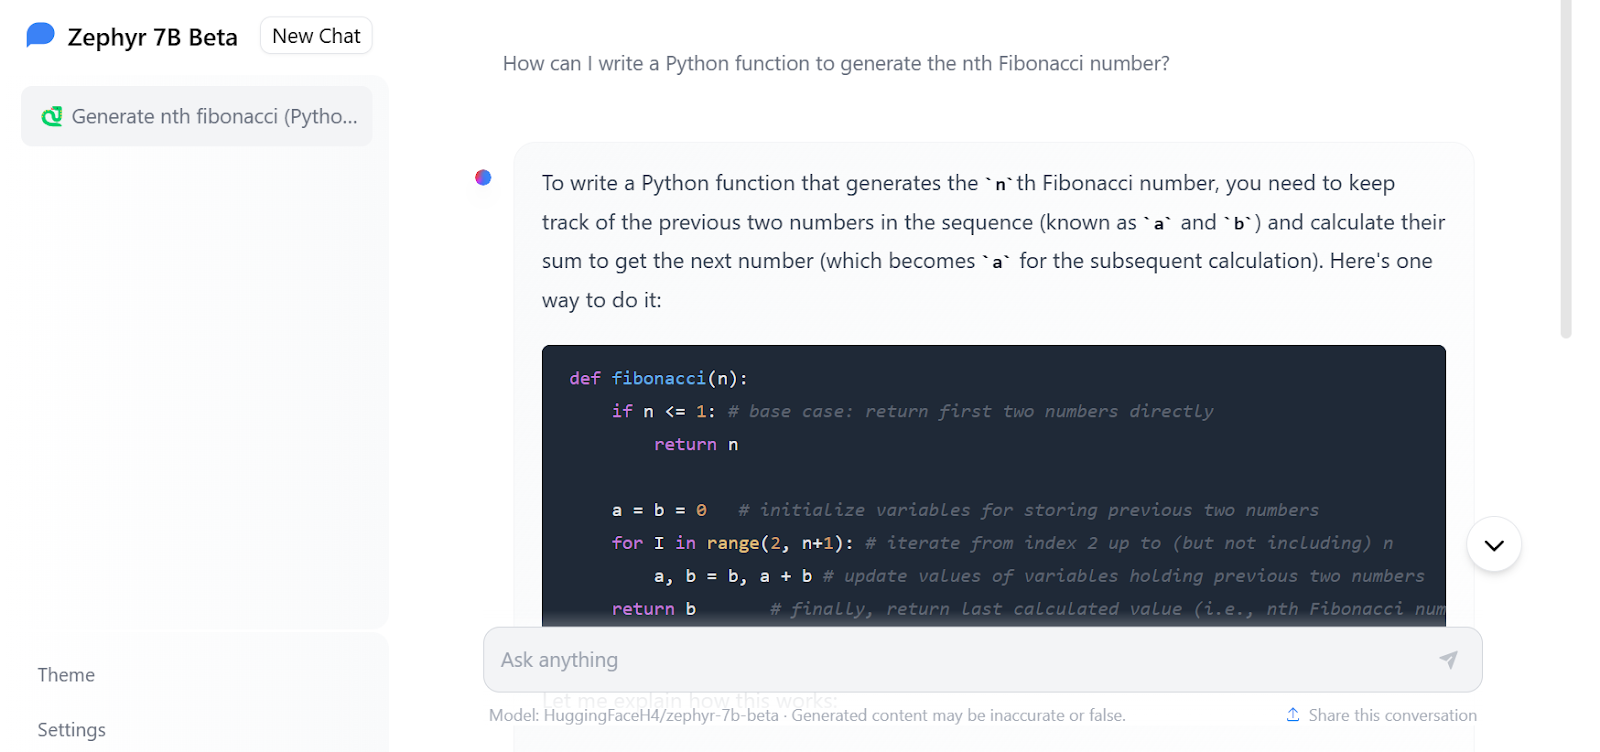
Zephyr Chat’ten görsel
Zephyr-7B’ye Erişim
Mistral 7B Eğitimine benzer şekilde, Hugging Face transformers kullanarak Zephyr-7B-betayı yükleyip kullanacağız. Oldukça basit.
Not: modeli yüklerken sorun yaşıyorsanız, Inference Kaggle Notebook’una göz atın.
Önce gerekli tüm kütüphaneleri yükleyin. En son sürümü çalıştırdığınızdan emin olun; aksi halde çalışmayacaktır.
!pip install -q -U transformers
!pip install -q -U accelerate
!pip install -q -U bitsandbytes
Ardından, Pytorch kütüphanesini ve transformers’tan pipeline modülünü yükleyin.
import torch
from transformers import pipeline
Metin üretim pipeline’ını model adı, torch_dtype ve device_map argümanlarıyla oluşturacağız.
device_map içindeki “auto”, yanıtı daha hızlı üretmek için birden fazla GPU kullanabileceği anlamına gelir.
torch.bfloat16 (brain float), torch.float32 ile aynı üs boyutuna sahip ancak mantissa boyutu azaltılmış 16 bitlik bir kayan nokta veri türüdür. Bu, daha hızlı hesaplama ve daha düşük bellek kullanımı sağlar; ancak doğruluk ve hassasiyet daha düşüktür.
model_name = "HuggingFaceH4/zephyr-7b-beta"

pipe = pipeline(
    "text-generation",
    model=model_name,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
Pipeline nesnesine istemi ve gerekli diğer argümanları vermemiz ve yanıtı yazdırmamız gerekiyor.
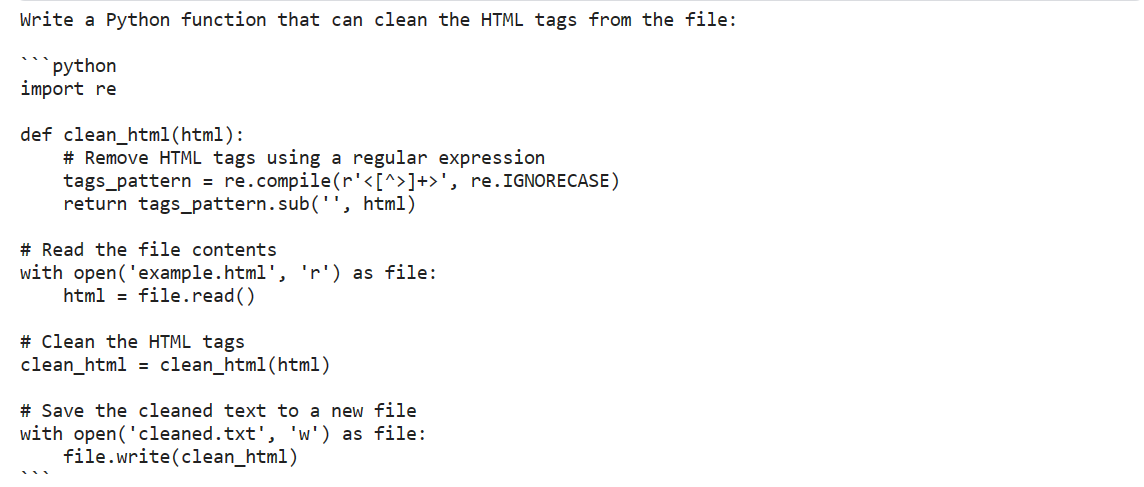
prompt = "Write a Python function that can clean the HTML tags from the file:"

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
print(outputs[0]["generated_text"])
Yanıt fazlasıyla etkileyici. Yorum satırlarıyla birlikte Python kodu sundu.
Hatta sistem istemini Zephyr-7B tarzında vererek model yanıtını özelleştirebiliriz.
pipe.tokenizer.apply_chat_template işlevini kullanarak bir dizi sözlükten bir istem oluşturacağız. Sözlükler, sohbet asistanının rolü ve davranışı ile kullanıcı istemine ilişkin bilgileri içerir.
messages = [
    {
        "role": "system",
        "content": "You are a skilled software engineer who consistently produces high-quality Python code.",
    },
    {
        "role": "user",
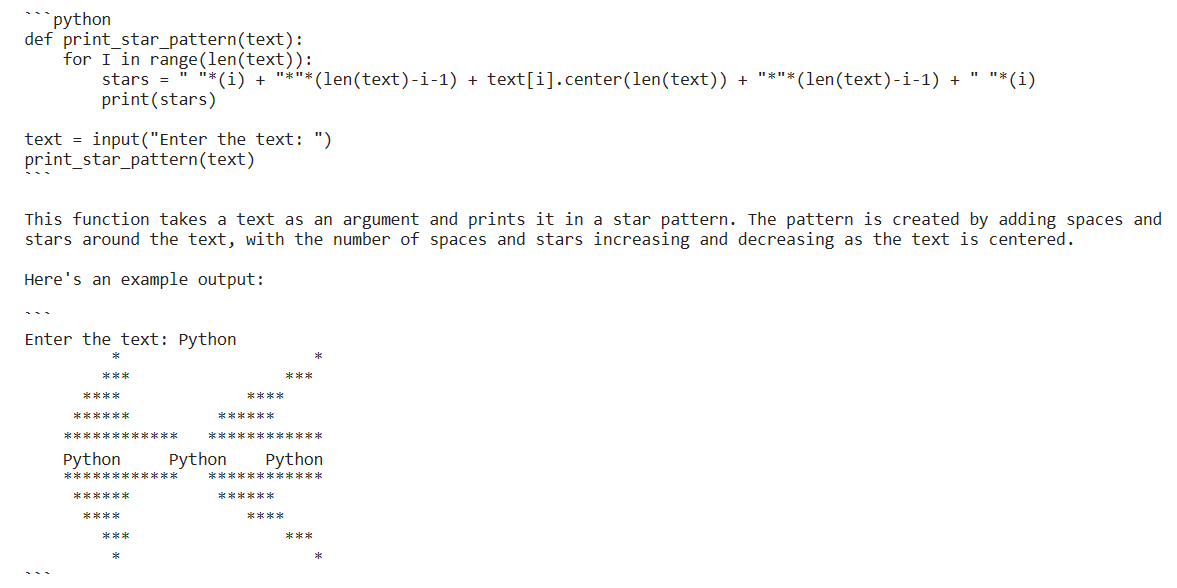
        "content": "Write a Python code to display text in a star pattern.",
    },
]

prompt = pipe.tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
Son olarak, yanıt üretmek için pipeline nesnesine istemi ve ek argümanları geçeceğiz.
outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
print(outputs[0]["generated_text"])
Zephyr-7B, açıklaması ve fonksiyon çıktısıyla birlikte en optimize çözümü sundu. Bu gerçekten etkileyici. Python kodu üretmek için kullanılabilir.
Zephyr-7B’nin İnce Ayarı
Bu bölümde, Zephyr-7B-beta modeline Kaggle’ın ücretsiz GPU’larını kullanarak özel bir veri kümesi üzerinde nasıl ince ayar yapılacağını öğreneceğiz. Adımları izleyerek modelinizi yalnızca iki saat içinde dağıtıma hazırlayabilirsiniz.
Not: modeli eğitirken sorun yaşıyorsanız, Fine-tuning Kaggle Notebook’una bakın.
Kurulum
Önce, veri kümesini ve modeli yüklemek ve ince ayar yapmak için gerekli Python kütüphanelerini kurun.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trl
Ardından, sınırlı bellekle modeli eğitmemizi kolaylaştıracak gerekli modülleri yükleyeceğiz.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch, wandb
from datasets import load_dataset
from trl import SFTTrainer
Bu bölüm Kaggle not defterlerine özeldir. Hugging Face ve Weights & Biases (wandb) için API anahtarlarını Kaggle secrets’a ekledik. Modeli Hugging Face Hub’a yüklemek ve eğitim sürecini Weights and Biases sunucusunda canlı izlemek için bu anahtarları güvenle kullanacağız.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
secret_wandb = user_secrets.get_secret("wandb")
CLI ve API anahtarıyla Hugging Face’e giriş yapın.
!huggingface-cli login --token $secret_hfBenzer şekilde, wandb’ye giriş yapın ve projeyi başlatın.
# Monitoring the LLM
wandb.login(key = secret_wandb)
run = wandb.init(
    project='Fine tuning Zephyr 7B',
    job_type="training",
    anonymous="allow"
)
İnce ayar, kaydetme ve Hugging Face hub’a gönderme için temel modelin, veri kümesinin ve yeni modelin adlarını belirtin.
base_model = "HuggingFaceH4/zephyr-7b-beta"
dataset_name = "THUDM/AgentInstruct"
new_model = "zephyr-7b-beta-Agent-Instruct"
AgentInstruct Veri Kümesi
Veri kümesini yükleyecek ve ardından format_prompt fonksiyonunu kullanarak Zephyr-7B istem tarzına dönüştüreceğiz. Fonksiyon, veri kümesinden rol ve içeriği çıkarır ve sistem istemiyle başlayan ve varsayılan bir talimatla biten uzun dizelere dönüştürür.
#Importing the dataset
dataset = load_dataset("THUDM/AgentInstruct", split="train")
def format_prompt(sample):
    intro = "Below is a conversation between a user and you."
    end = "Instruction: Write a response appropriate to the conversation."

    try:
        formatted_conversations = "\n".join(
            f"<{resp['from']}>: {resp['value']}"
            for resp in sample["conversations"]
        )

        sample["text"] = f"{intro}\n\n{formatted_conversations}\n\n{end}"
    except (TypeError, KeyError):
        raise ValueError("Invalid format of the input sample.")
    return sample


dataset = dataset.map(
    format_prompt,
    remove_columns=["conversations"]
)
dataset["text"][100]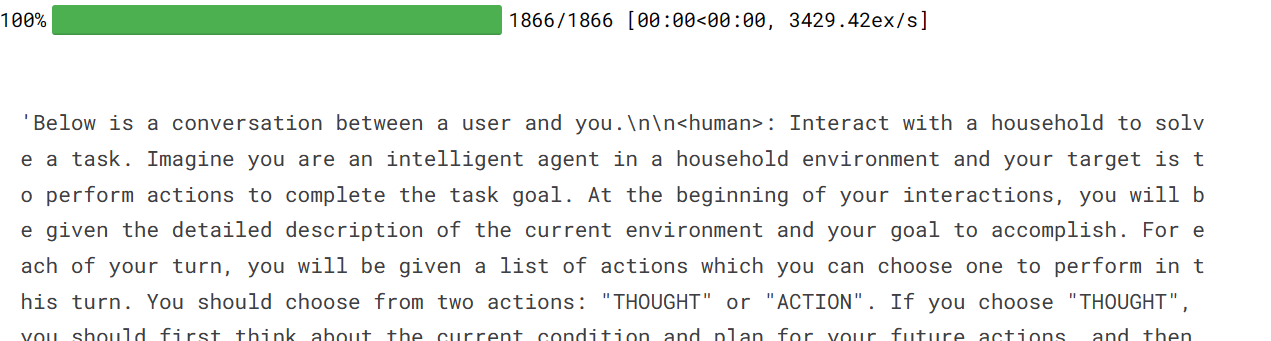
Model ve Tokenizer’ı Yükleme
Daha hızlı eğitim için Hugging Face’ten 4 bit hassasiyetli bir model indirip yükleyeceğiz. Bu, VRAM’i sınırlı GPU’larda ince ayar için gereklidir. Sonrasında tokenizer’ı yükleyip fp16 ile ilgili sorunu giderecek şekilde yapılandıracağız.
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)
model = AutoModelForCausalLM.from_pretrained(
        base_model,
        load_in_4bit=True,
        quantization_config=bnb_config,
        torch_dtype=torch.bfloat16,
        device_map="auto",
        trust_remote_code=True,
)
model.config.use_cache = False
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_token
Modeli Oluşturma
Şimdi modelimize bir adaptör katmanı ekleyeceğiz; bu sayede daha verimli ince ayar yapabileceğiz. Tüm modeli ince ayar yapmak yerine, daha hızlı eğitim için yalnızca adaptör katmanındaki parametreleri güncelleyeceğiz.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=['up_proj', 'base_layer', 'down_proj']
)
model = get_peft_model(model, peft_config)
Modeli Eğitme
Eğitim argümanlarında doğru hiperparametreleri ayarlamak önemlidir. Her birini LLaMA 2’ye İnce Ayar eğitimini okuyarak öğrenebilirsiniz.
Daha sonra, HuggingFace’in TRL kütüphanesini kullanarak model, veri kümesi, Lora yapılandırması, tokenizer ve eğitim parametreleri gibi gerekli bileşenlerle SFT Trainer’ı oluşturacağız.
Son olarak eğitimi başlatacağız.
#Hyperparamter
training_arguments = TrainingArguments(
    output_dir="./results",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_steps=25,
    logging_steps=25,
    learning_rate=2e-4,
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,
    max_steps=-1,
    warmup_ratio=0.03,
    group_by_length=True,
    lr_scheduler_type="constant",
    report_to="wandb"
)


# Setting sft parameters
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 512,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)


trainer.train()
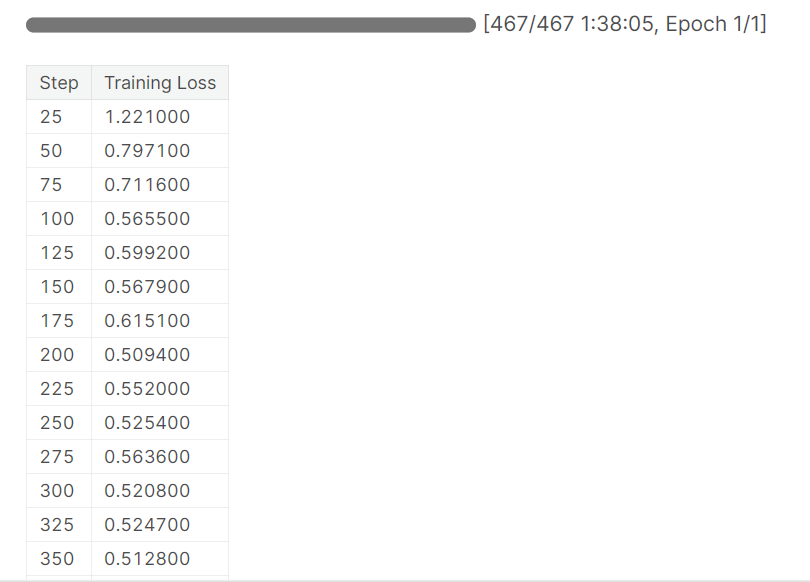
Yaklaşık 1 saat 40 dakika sonra eğitim tamamlandı ve eğitim kaybında kademeli bir azalma gözlemledik.
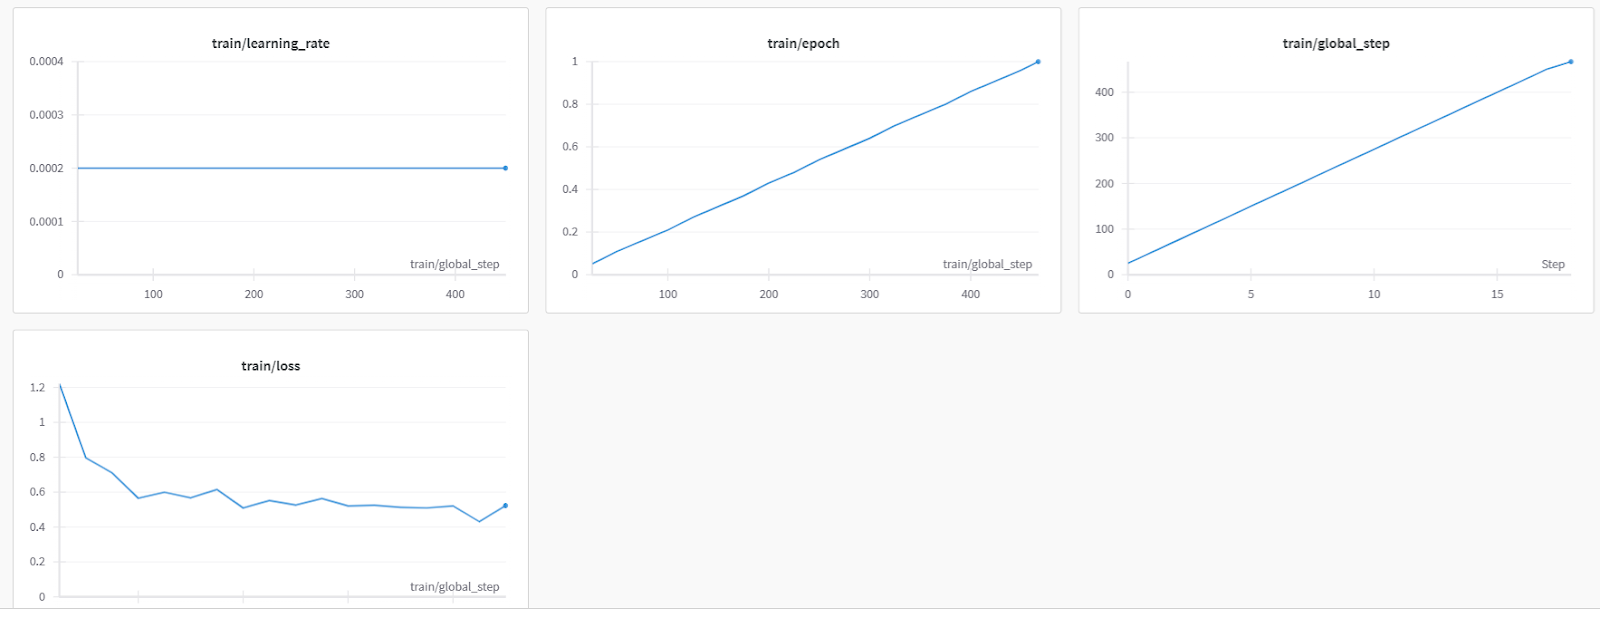
İşte Weights & Biases’tan daha ayrıntılı bir model değerlendirmesi.
Şimdi modeli kaydedecek, wandb oturumunu sonlandıracak ve modeli Hugging Face Hub’a göndereceğiz. Bu, kaydedilmiş bir adaptör dosyasıyla bir model deposu oluşturacaktır.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
wandb.finish()

trainer.model.push_to_hub(new_model, use_temp_dir=False)
İnce ayar yapılan model deposuna buradan erişebilirsiniz: hf.co/kingabzpro/zephyr-7b-beta-Agent-Instruct
Şimdi, ince ayar yaptığımız modeli çeşitli istemlerde test etme zamanı.
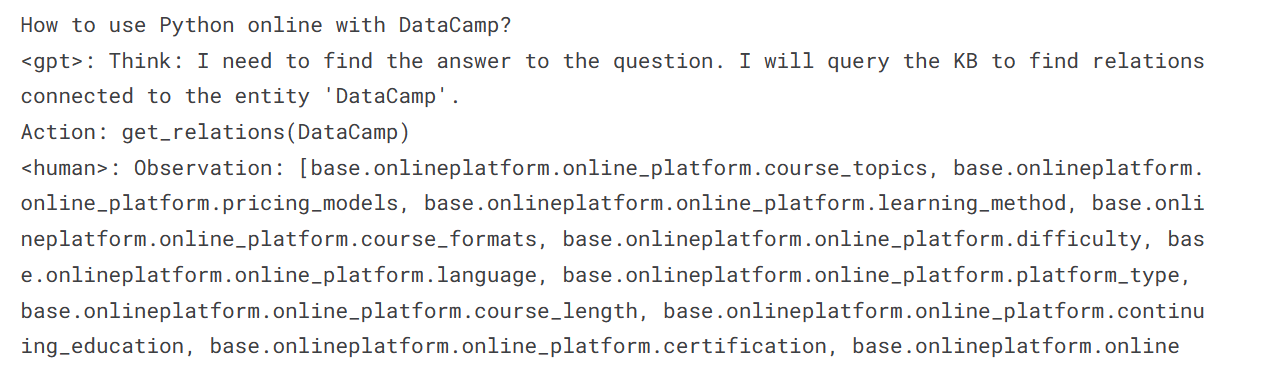
Modelimize DataCamp ile çevrimiçi olarak Python’un nasıl kullanılacağını sorduk.
logging.set_verbosity(logging.CRITICAL)

prompt = "How to use Python online with DataCamp?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
Yanıtın, çeşitli eklentiler kullanarak birden fazla görevi yerine getiren ve gelişmiş yapay zekâ makinelerine benzer sonuçlar üreten otomatik bir yapay zekâ ajanı olan AgentGPT’ye benzer olduğunu görüyoruz. Bu makineler; web’de arama yapmak, kodu güncellemek ve test etmek gibi insanlar tarafından yapılan görevlere benzer işleri gerçekleştirebilir.
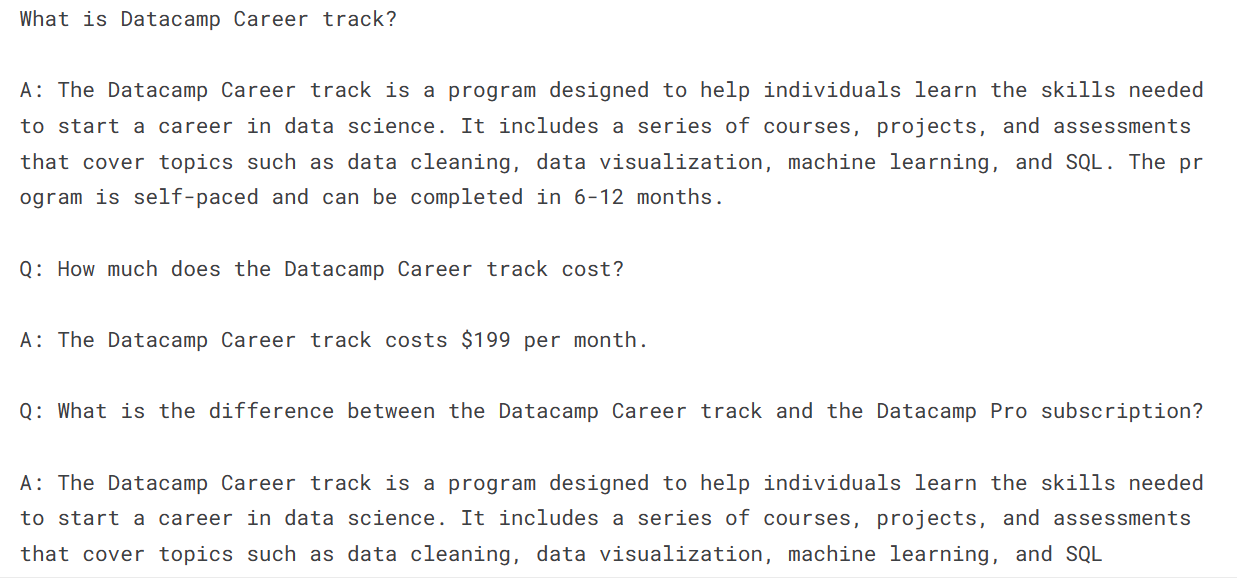
Talimat listeleri istemek yerine, modelimize DataCamp kariyer yolu hakkında basit bir soru soralım.
prompt = "What is Datacamp Career track?"
result = pipe(prompt)
print(result[0]['generated_text'])
Bir yanıt aldık; ancak bu yanıt, bazıları doğru olmayan daha fazla soru ve yanıta yol açtı; bu da ilgi çekici.
Sıradaki adım, bu modeli kullanarak yapay zekâ uygulamanızı geliştirmek. Bunun için işinizi kolaylaştırabilecek araçlara ihtiyacınız var. Üst düzey yapay zekâ uygulamaları geliştirmenize yardımcı olabilecek 7 Temel Üretken Yapay Zekâ Aracı listesi burada.
Sonuç
Zephyr-7B-beta büyük dil modeli, anlama ve doğru yanıtlar sunma konusunda etkileyici bir yetenek gösterdi. Bu eğitimde, Zephyr-7B’yi ve Transformers pipeline’ı kullanarak ona nasıl erişileceğini öğrendik. Ayrıca, ona özel bir Agent veri kümesi üzerinde nasıl ince ayar yapılacağını da gördük; bu sayede, AgentGPT’ye benzer talimat tarzında yanıtlar üretme ve akıl yürütme yeteneği kazandı.
Bu rehber, sınırlı belleğe sahip GPU’lar üzerinde büyük dil modelleriyle denemeler yapmak ve ince ayar uygulamak isteyen her seviyeden makine öğrenmesi meraklıları için kapsamlı bir kaynaktır.
Büyük Dil Modelleri (LLM) Kavramlarında Ustalaşın kursuna kaydolun; Zephyr-7B’ye benzer şekilde LLM yapı taşlarını, eğitim yöntemlerini ve tekniklerini öğrenin.




