Todo el mundo sigue de cerca el OpenAI LLM Leaderboard y los nuevos modelos de código abierto que aspiran a acercarse al rendimiento de GPT-4. Uno de los que más está dando que hablar últimamente es Zephyr-7B.
En este tutorial, conoceremos un nuevo modelo de lenguaje llamado Zephyr-7B. Lo usaremos con el pipeline de Transformers y afinaremos el modelo con un dataset Agent-Instruct.
Si te inicias en la inteligencia artificial, echa un vistazo al itinerario de habilidades AI Fundamentals. Te preparará y te pondrá en camino para convertirte en el ingeniero o ingeniera de IA del futuro.
Qué es Zephyr-7B
Zephyr-7B es un modelo de lenguaje de vanguardia desarrollado por WebPilot.AI. Forma parte de la serie Zephyr de modelos entrenados para actuar como asistentes útiles. Zephyr-7B está diseñado para destacar en tareas lingüísticas como generar texto coherente, traducir entre idiomas, resumir información clave, analizar sentimiento y responder preguntas a partir de contexto.
Zephyr-7B-β
Zephyr-7B-β es el segundo modelo de la serie. Es una versión afinada de Mistral-7B, entrenada con una combinación de datasets públicos y sintéticos mediante Direct Preference Optimization (DPO). Como resultado, Zephyr-7B-β demuestra capacidades que van desde interpretar preguntas complejas hasta resumir textos largos.
En el momento de su lanzamiento, Zephyr-7B-β es el modelo conversacional de 7B mejor posicionado en los benchmarks MT-Bench y AlpacaEval. Se apoya en los últimos avances en procesamiento del lenguaje natural para alcanzar nuevas cotas en la comprensión y generación de texto similar al humano.
Puedes comprobar su mejora de rendimiento probando la demo gratuita disponible en Zephyr Chat.
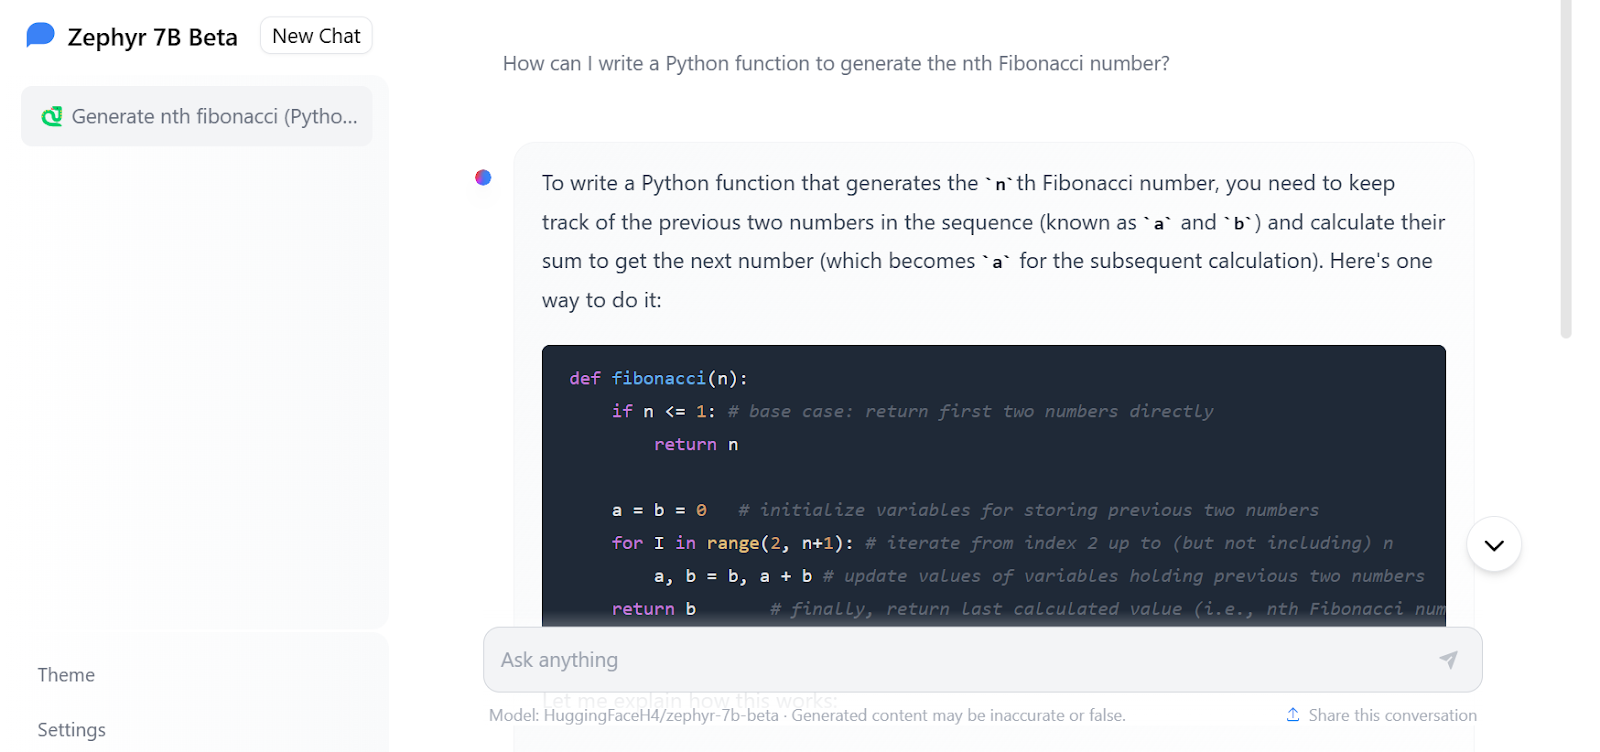
Imagen de Zephyr Chat
Cómo acceder a Zephyr-7B
Al igual que en el tutorial de Mistral 7B, vamos a cargar y usar Zephyr-7B-beta con transformers de Hugging Face. Es bastante directo.
Nota: si tienes problemas al cargar el modelo, consulta el notebook de inferencia en Kaggle.
Primero, instala todas las librerías necesarias. Asegúrate de tener la última versión; de lo contrario, no funcionará.
!pip install -q -U transformers
!pip install -q -U accelerate
!pip install -q -U bitsandbytes
Después, carga la librería Pytorch y el módulo pipeline de transformers.
import torch
from transformers import pipeline
Construiremos el pipeline de generación de texto indicando el nombre del modelo y los argumentos torch_dtype y device_map.
El "auto" en device_map significa que puede usar varias GPUs para generar la respuesta más rápido.
El tipo torch.bfloat16 (brain float) es un formato de coma flotante de 16 bits con el mismo tamaño de exponente que torch.float32 pero una mantisa reducida. Permite cálculos más rápidos y menor uso de memoria, a costa de algo de precisión.
model_name = "HuggingFaceH4/zephyr-7b-beta"

pipe = pipeline(
    "text-generation",
    model=model_name,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)
Tenemos que proporcionar el prompt y otros argumentos necesarios al objeto pipeline e imprimir la respuesta.
prompt = "Write a Python function that can clean the HTML tags from the file:"

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
print(outputs[0]["generated_text"])
La respuesta es más que impresionante. Ha proporcionado el código en Python con comentarios.
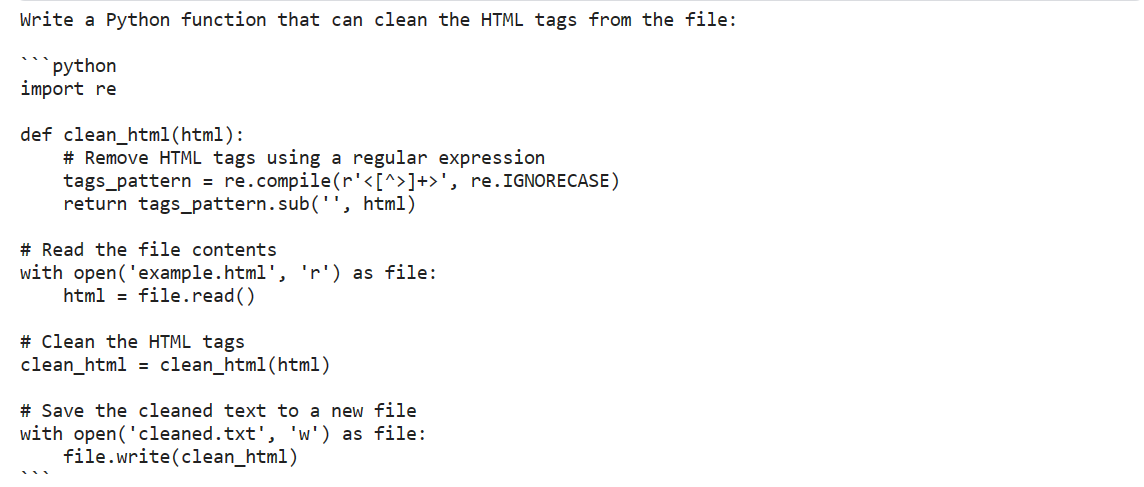
Incluso podemos personalizar la respuesta del modelo proporcionando un system prompt al estilo Zephyr-7B.
Usaremos la función pipe.tokenizer.apply_chat_template para crear un prompt a partir de una lista de diccionarios. Los diccionarios indican el rol y el comportamiento del asistente, y el prompt del usuario.
messages = [
    {
        "role": "system",
        "content": "You are a skilled software engineer who consistently produces high-quality Python code.",
    },
    {
        "role": "user",
        "content": "Write a Python code to display text in a star pattern.",
    },
]

prompt = pipe.tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
Por último, pasaremos el prompt al objeto pipeline con argumentos adicionales para generar la respuesta.
outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
print(outputs[0]["generated_text"])
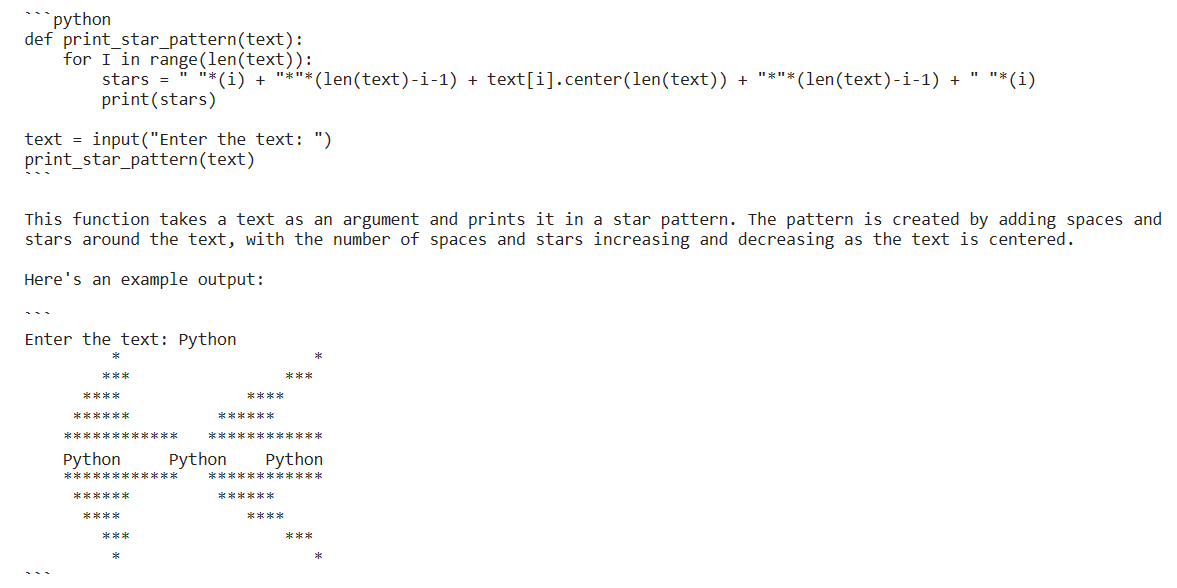
Zephyr-7B ha propuesto la solución más optimizada, con explicación y salida de la función. Es fantástico. Deberías usarlo para generar código en Python.
Ajuste fino de Zephyr-7B
En esta sección aprenderás a afinar el modelo Zephyr-7B-beta con un dataset personalizado usando las GPUs gratuitas de Kaggle. Siguiendo las instrucciones, podrás dejar tu modelo listo para desplegar en tan solo dos horas.
Nota: si tienes problemas durante el entrenamiento, consulta el notebook de ajuste fino en Kaggle.
Puesta en marcha
Primero, instala las librerías de Python necesarias para cargar el dataset y el modelo, y afinarlos.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trl
Luego cargaremos los módulos necesarios que nos facilitarán la vida y nos ayudarán a entrenar el modelo con memoria limitada.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch, wandb
from datasets import load_dataset
from trl import SFTTrainer
Esta parte es específica de los notebooks de Kaggle. Hemos añadido las claves de API de Hugging Face y Weights & Biases (wandb) en los secretos de Kaggle. Las usaremos de forma segura para subir el modelo a Hugging Face Hub y monitorizar el entrenamiento en tiempo real en el servidor de Weights & Biases.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
secret_wandb = user_secrets.get_secret("wandb")
Inicia sesión en Hugging Face usando la CLI y la clave de API.
!huggingface-cli login --token $secret_hfDe forma similar, inicia sesión en wandb y crea el proyecto.
# Monitoring the LLM
wandb.login(key = secret_wandb)
run = wandb.init(
    project='Fine tuning Zephyr 7B',
    job_type="training",
    anonymous="allow"
)
Indica los nombres del modelo base, el dataset y el nuevo modelo para afinar, guardar y subir a Hugging Face Hub.
base_model = "HuggingFaceH4/zephyr-7b-beta"
dataset_name = "THUDM/AgentInstruct"
new_model = "zephyr-7b-beta-Agent-Instruct"
Dataset AgentInstruct
Cargaremos el dataset y luego lo convertiremos al estilo de prompt de Zephyr-7B usando la función format_prompt. La función extrae el rol y el contenido del dataset y los convierte en cadenas largas que empiezan con un system prompt y terminan con una instrucción por defecto.
#Importing the dataset
dataset = load_dataset("THUDM/AgentInstruct", split="train")
def format_prompt(sample):
    intro = "Below is a conversation between a user and you."
    end = "Instruction: Write a response appropriate to the conversation."

    try:
        formatted_conversations = "\n".join(
            f"<{resp['from']}>: {resp['value']}"
            for resp in sample["conversations"]
        )

        sample["text"] = f"{intro}\n\n{formatted_conversations}\n\n{end}"
    except (TypeError, KeyError):
        raise ValueError("Invalid format of the input sample.")
    return sample


dataset = dataset.map(
    format_prompt,
    remove_columns=["conversations"]
)
dataset["text"][100]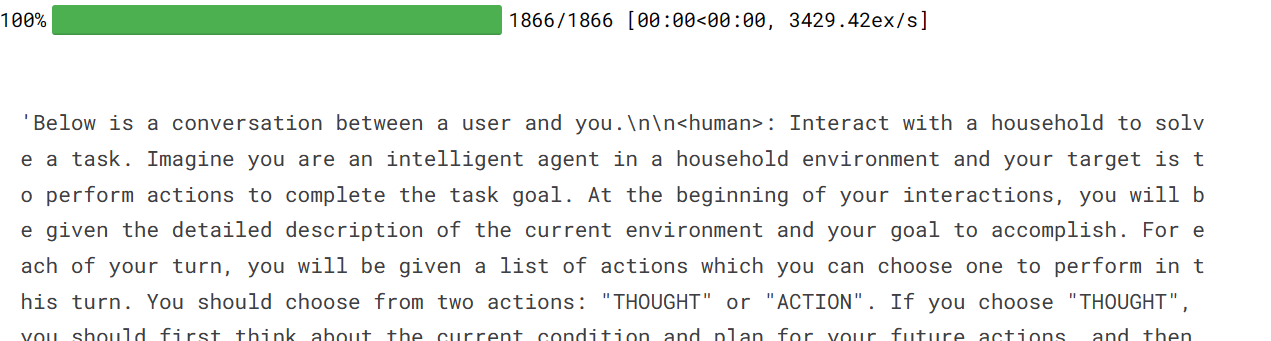
Cargar el modelo y el tokenizer
Descargaremos y cargaremos un modelo en precisión de 4 bits desde Hugging Face para acelerar el entrenamiento. Esto es necesario para afinar con GPUs con VRAM limitada. Después, cargaremos el tokenizer y lo configuraremos para corregir el problema con fp16.
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)
model = AutoModelForCausalLM.from_pretrained(
        base_model,
        load_in_4bit=True,
        quantization_config=bnb_config,
        torch_dtype=torch.bfloat16,
        device_map="auto",
        trust_remote_code=True,
)
model.config.use_cache = False
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_token
Construir el modelo
Ahora añadiremos una capa adaptadora a nuestro modelo, lo que nos permitirá afinarlo de forma más eficiente. En lugar de ajustar todo el modelo, actualizaremos solo los parámetros de la capa adaptadora para entrenar más rápido.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=['up_proj', 'base_layer', 'down_proj']
)
model = get_peft_model(model, peft_config)
Entrenar el modelo
Es importante definir correctamente los hiperparámetros en los argumentos de entrenamiento. Puedes aprender sobre cada uno en el tutorial Fine-Tuning LLaMA 2.
Luego usaremos la librería TRL de Hugging Face para crear el SFT Trainer con los componentes necesarios: modelo, dataset, configuración Lora, tokenizer y parámetros de entrenamiento.
Por último, iniciaremos el entrenamiento.
#Hyperparamter
training_arguments = TrainingArguments(
    output_dir="./results",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_steps=25,
    logging_steps=25,
    learning_rate=2e-4,
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,
    max_steps=-1,
    warmup_ratio=0.03,
    group_by_length=True,
    lr_scheduler_type="constant",
    report_to="wandb"
)


# Setting sft parameters
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 512,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)


trainer.train()
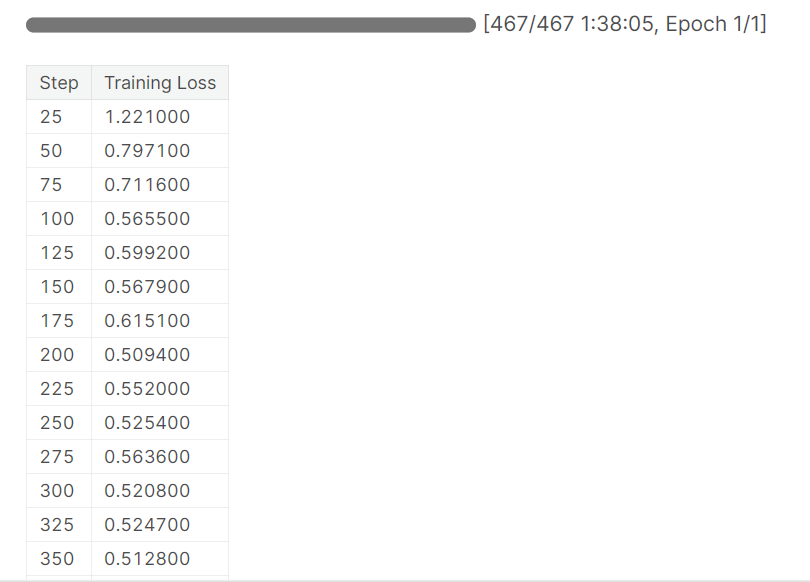
Tras casi 1 hora y 40 minutos, el entrenamiento terminó y observamos una reducción gradual de la pérdida.
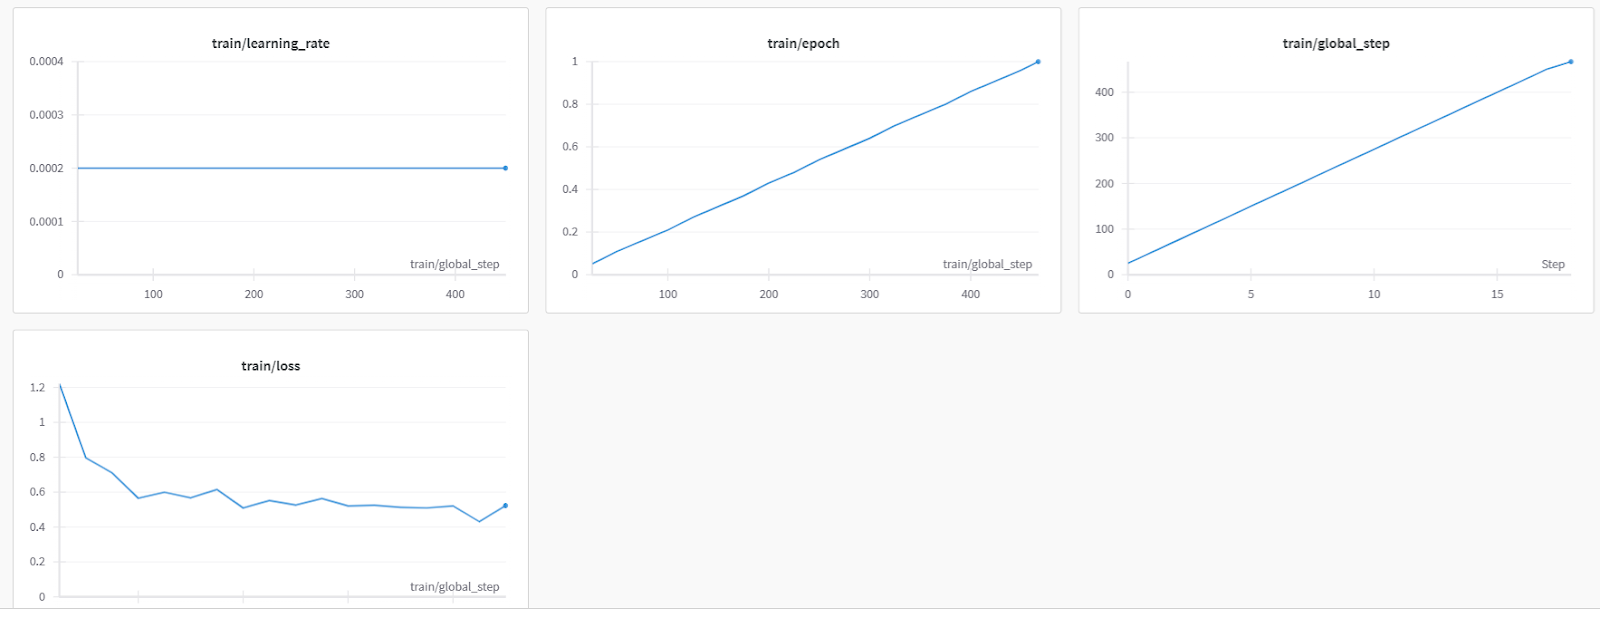
Aquí tienes una evaluación más detallada del modelo desde Weights & Biases.
Ahora guardaremos el modelo, cerraremos la instancia de wandb y subiremos el modelo a Hugging Face Hub. Esto creará un repositorio del modelo con el archivo del adaptador guardado.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
wandb.finish()

trainer.model.push_to_hub(new_model, use_temp_dir=False)
Aquí tienes el repositorio del modelo afinado al que puedes acceder con: hf.co/kingabzpro/zephyr-7b-beta-Agent-Instruct
Es el momento de probar nuestro modelo afinado con distintos prompts.
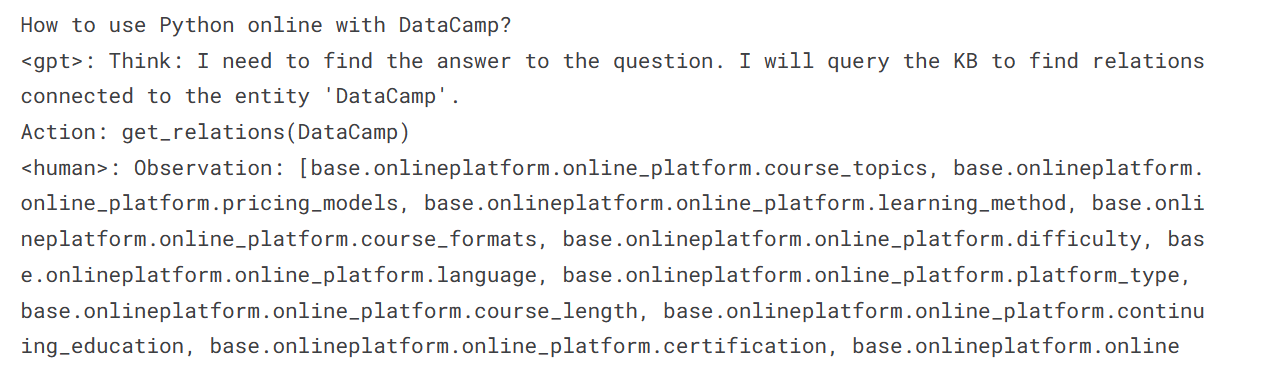
Le hemos preguntado a nuestro modelo cómo usar Python online con DataCamp.
logging.set_verbosity(logging.CRITICAL)

prompt = "How to use Python online with DataCamp?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
Podemos ver que la respuesta se parece a la de AgentGPT, un agente de IA automático que realiza múltiples tareas con varias extensiones y logra resultados similares a máquinas de IA avanzadas. Estas máquinas pueden realizar tareas propias de las personas, como buscar en la web, actualizar código y hacer pruebas.
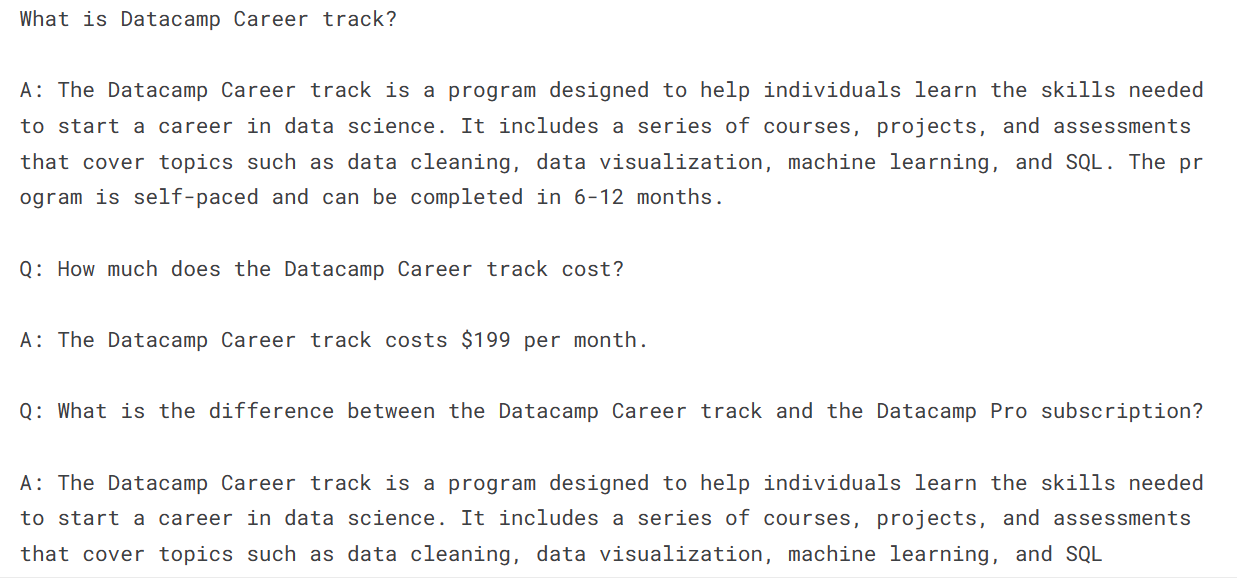
En lugar de pedir listas de instrucciones, preguntemos algo sencillo sobre el itinerario profesional de DataCamp.
prompt = "What is Datacamp Career track?"
result = pipe(prompt)
print(result[0]['generated_text'])
Recibimos una respuesta, pero derivó en más preguntas y respuestas (no todas exactas), lo cual resulta curioso.
El siguiente paso en tu camino es usar este modelo para crear tu aplicación de IA. Para ello, necesitas herramientas que te faciliten el trabajo. Aquí tienes una lista de 7 herramientas esenciales de IA generativa que te ayudarán a construir aplicaciones de IA de primer nivel.
Conclusión
El modelo de lenguaje Zephyr-7B-beta ha demostrado una capacidad asombrosa para comprender y ofrecer respuestas precisas. En este tutorial hemos visto qué es Zephyr-7B y cómo acceder a él con el pipeline de Transformers. También hemos aprendido a afinarlo con un dataset de agentes personalizado, lo que le aporta más capacidad de razonamiento y respuestas de tipo instructivo similares a AgentGPT.
Esta guía es un recurso completo para entusiastas del aprendizaje automático de todos los niveles que quieran experimentar y afinar modelos de lenguaje grandes en GPUs con memoria limitada.
Apúntate al curso Master Large Language Models (LLMs) Concepts para aprender los bloques de construcción, métodos de entrenamiento y técnicas de modelos como Zephyr-7B.

Serie Code Along: Conviértete en desarrollador de IA
¡Construye sistemas de IA y desarrolla aplicaciones de IA utilizando OpenAI, LangChain, Pinecone y Hugging Face!