
Last chance! 50% off DataCamp Premium
Sale ends in
Setelah peluncuran versi pertama LLaMA oleh Meta, muncul perlombaan baru untuk membangun Large Language Model (LLM) yang lebih baik dan dapat menyaingi model seperti GPT-3.5 (ChatGPT). Komunitas open-source dengan cepat merilis model yang semakin kuat. Rasanya seperti Natal bagi para penggemar AI, dengan perkembangan baru yang diumumkan secara berkala.
Namun, kemajuan ini hadir dengan sisi negatif. Sebagian besar model open-source memiliki lisensi terbatas, yang berarti hanya boleh digunakan untuk keperluan riset. Kedua, hanya perusahaan besar atau institusi riset dengan anggaran besar yang mampu melakukan fine-tuning atau melatih model. Terakhir, penerapan dan pemeliharaan model besar mutakhir sangat mahal.
Versi baru model LLaMA bertujuan mengatasi masalah ini. Model ini memiliki lisensi komersial, sehingga dapat diakses oleh lebih banyak organisasi. Selain itu, metodologi baru kini memungkinkan fine-tuning pada GPU konsumen dengan memori terbatas.
Demokratisasi AI ini krusial untuk adopsi yang luas. Dengan menyingkirkan hambatan masuk, bahkan perusahaan kecil dapat membangun model yang disesuaikan dengan kebutuhan dan anggaran mereka.
Dalam tutorial ini, kita akan mengeksplorasi Llama-2 dan menunjukkan cara melakukan fine-tuning pada dataset baru menggunakan Google Colab. Selain itu, kita akan membahas metodologi dan teknik fine-tuning baru yang dapat membantu mengurangi penggunaan memori dan mempercepat proses pelatihan.
Gambar dibuat oleh Penulis menggunakan DALL-E 3
transformers, peft, trl, bitsandbytes)Llama 2 adalah kumpulan LLM open-source generasi kedua dari Meta yang hadir dengan lisensi komersial. Model ini dirancang untuk menangani beragam tugas pemrosesan bahasa alami, dengan skala model mulai dari 7 miliar hingga 70 miliar parameter. Pelajari lebih lanjut tentang model LLaMA dengan membaca artikel kami, Pengenalan LLaMA dari Meta AI: Mendorong Inovasi AI.
Llama-2-Chat, yang dioptimalkan untuk dialog, menunjukkan performa serupa dengan model populer berlisensi tertutup seperti ChatGPT dan PaLM. Kita bahkan dapat meningkatkan performa model dengan melakukan fine-tuning pada dataset percakapan berkualitas tinggi.
Fine-tuning dalam machine learning adalah proses menyesuaikan bobot dan parameter model terlatih awal pada data baru untuk meningkatkan kinerjanya pada tugas tertentu. Ini melibatkan pelatihan model pada dataset baru yang spesifik untuk tugas tersebut sambil memperbarui bobot model agar beradaptasi dengan data baru. Baca lebih lanjut tentang fine-tuning melalui panduan fine-tuning GPT 3.5 kami.
Fine-tuning LLM pada perangkat keras konsumen menantang karena keterbatasan VRAM dan daya komputasi. Namun, dalam tutorial ini, kita akan mengatasi tantangan memori dan komputasi tersebut dan melatih model menggunakan versi gratis Google Colab Notebook.
Di bagian ini, kita akan mempelajari semua langkah yang diperlukan untuk melakukan fine-tuning model Llama 2 dengan 7 miliar parameter pada GPU T4. Anda dapat menggunakan GPU gratis di Google Colab atau Kaggle. Kode dapat berjalan di kedua platform.
GPU Colab T4 memiliki VRAM terbatas 16 GB. Itu nyaris cukup untuk menyimpan bobot Llama 2–7b, yang berarti fine-tuning penuh tidak memungkinkan, dan kita perlu menggunakan teknik fine-tuning hemat parameter seperti LoRA atau QLoRA.
Kita akan menggunakan teknik QLoRA untuk melakukan fine-tuning model dalam presisi 4-bit dan mengoptimalkan penggunaan VRAM. Untuk itu, kita akan menggunakan ekosistem pustaka LLM Hugging Face: transformers, accelerate, peft, trl, dan bitsandbytes.
Kita akan mulai dengan memasang pustaka yang diperlukan.
%%capture
%pip install accelerate peft bitsandbytes transformers trl
Setelah itu, kita akan memuat modul yang diperlukan dari pustaka ini.
import os
import torch
from datasets import load_dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import LoraConfig
from trl import SFTTrainerAnda dapat mengakses model resmi Llama-2 dari Meta di Hugging Face, tetapi Anda harus mengajukan permohonan dan menunggu beberapa hari untuk mendapatkan konfirmasi. Alih-alih menunggu, kita akan menggunakan Llama-2-7b-chat-hf dari NousResearch sebagai model dasar. Ini sama seperti aslinya tetapi lebih mudah diakses.
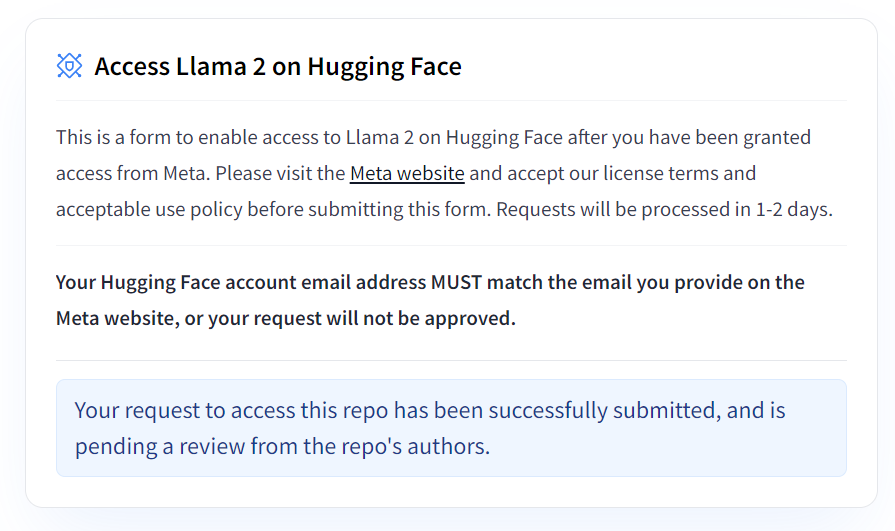
Gambar dari Hugging Face
Kita akan melakukan fine-tuning model dasar menggunakan dataset yang lebih kecil bernama mlabonne/guanaco-llama2-1k dan menuliskan nama untuk model hasil fine-tuning.
# Model from Hugging Face hub
base_model = "NousResearch/Llama-2-7b-chat-hf"

# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"

# Fine-tuned model
new_model = "llama-2-7b-chat-guanaco"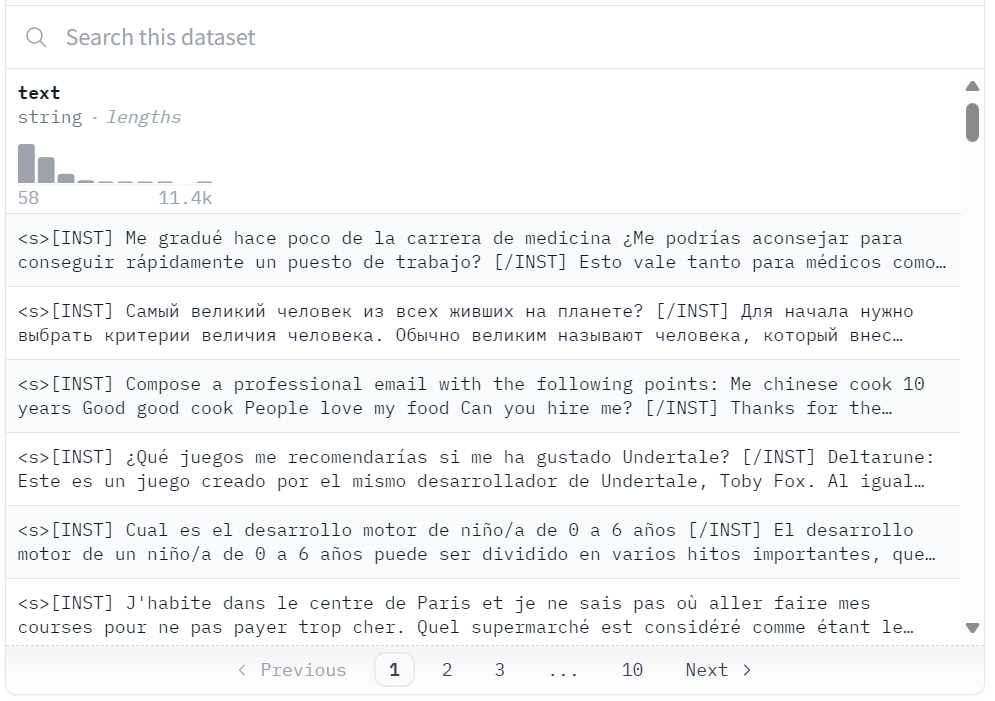
Dataset di Hugging Face
Kita akan memuat dataset “guanaco-llama2-1k” dari Hugging Face hub. Dataset ini berisi 1000 sampel dan telah diproses agar sesuai dengan format prompt Llama 2, serta merupakan subset dari dataset timdettmers/openassistant-guanaco yang sangat baik.
dataset = load_dataset(guanaco_dataset, split="train")Dataset parquet downloaded and prepared to /root/.cache/huggingface/datasets/parquet/mlabonne--guanaco-llama2-1k-f1f1134768f90029/0.0.0/0b6d5799bb726b24ad7fc7be720c170d8e497f575d02d47537de9a5bac074901. Subsequent calls will reuse this data.Kuantisasi 4-bit melalui QLoRA memungkinkan fine-tuning efisien untuk LLM raksasa pada perangkat keras konsumen sambil mempertahankan kinerja tinggi. Ini secara dramatis meningkatkan aksesibilitas dan kegunaan untuk aplikasi dunia nyata.
QLoRA mengkuantisasi model bahasa terlatih awal menjadi 4-bit dan membekukan parameternya. Sejumlah kecil lapisan Low-Rank Adapter yang dapat dilatih kemudian ditambahkan ke model.
Selama fine-tuning, gradien dibawa mundur melalui model yang dibekukan dan dikuantisasi 4-bit hanya ke lapisan Low-Rank Adapter. Jadi, seluruh model pralatih tetap tetap pada 4-bit sementara hanya adaptor yang diperbarui. Selain itu, kuantisasi 4-bit tidak merusak kinerja model.
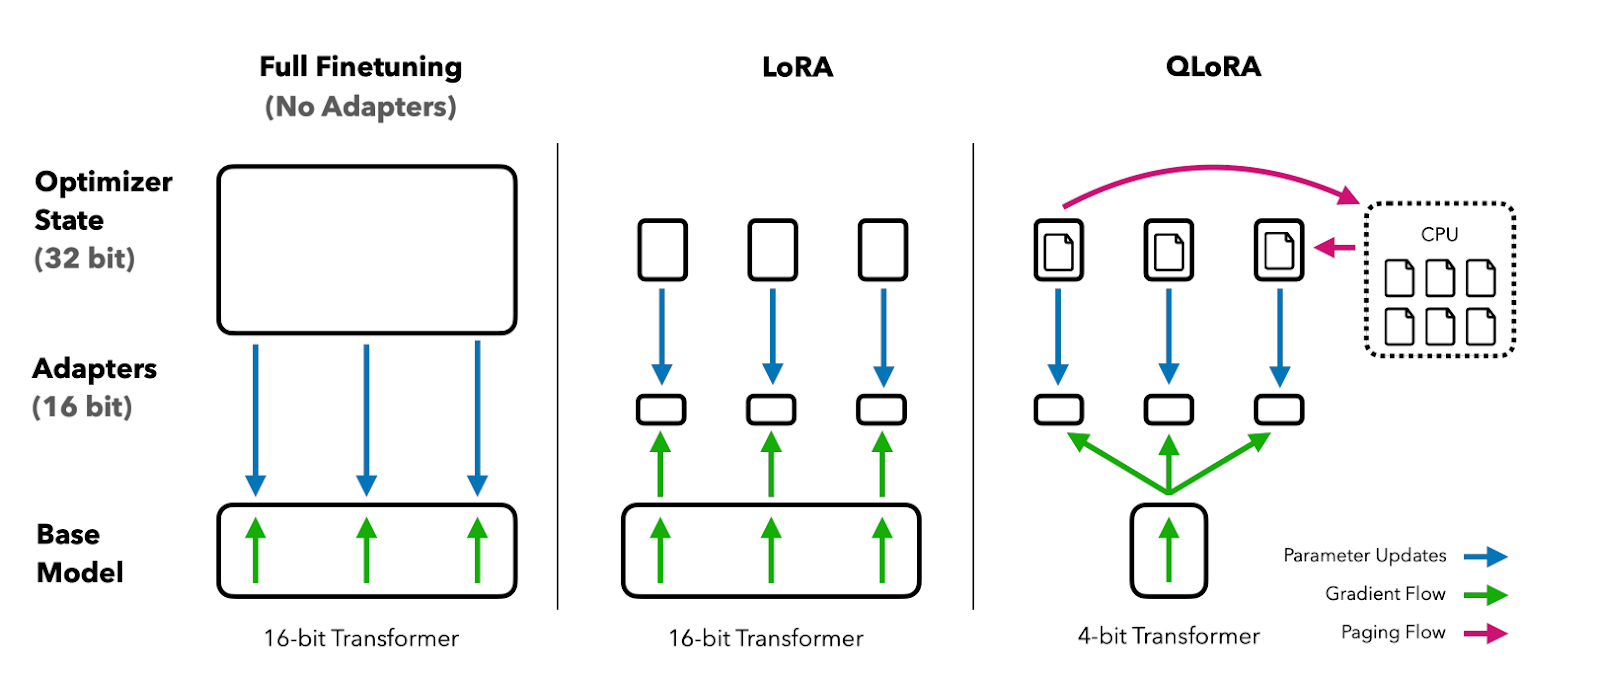
Gambar dari makalah QLoRA
Anda dapat membaca makalahnya untuk memahaminya lebih baik.
| Fitur | Fine-Tuning Penuh | LoRA | QLoRA |
|---|---|---|---|
| Parameter yang diperbarui | Semua parameter model | Matriks adaptor kecil (~0,1–1%) | Matriks adaptor kecil (~0,1–1%) |
| Presisi model dasar | FP16 / BF16 | FP16 / BF16 | 4-bit (NF4) |
| VRAM untuk model 7B | ~60+ GB | ~16 GB | ~6–8 GB |
| Kompatibel GPU konsumen | Tidak | Terbatas | Ya (T4, RTX 3060+) |
| Kualitas vs fine-tuning penuh | Baseline | ~98–99% | ~96–98% |
| Kecepatan pelatihan | Paling lambat | Cepat | Cepat |
Dalam kasus kita, kita membuat kuantisasi 4-bit dengan konfigurasi tipe NF4 menggunakan BitsAndBytes.
compute_dtype = getattr(torch, "float16")

quant_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)Sekarang kita akan memuat model menggunakan presisi 4-bit dengan compute dtype "float16" dari Hugging Face untuk pelatihan yang lebih cepat.
model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=quant_config,
    device_map={"": 0}
)
model.config.use_cache = False
model.config.pretraining_tp = 1Selanjutnya, kita akan memuat tokenizer dari Hugging Face dan menyetel padding_side ke "right" untuk memperbaiki masalah dengan fp16.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"Fine-tuning tradisional pada pre-trained language model (PLM) mengharuskan memperbarui semua parameter model, yang mahal secara komputasi dan memerlukan data dalam jumlah besar.
Parameter-Efficient Fine-Tuning (PEFT) bekerja dengan hanya memperbarui subset kecil dari parameter model yang paling berpengaruh, sehingga jauh lebih efisien. Pelajari tentang parameter dengan membaca dokumentasi resmi PEFT.
peft_params = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
)Di bawah ini adalah daftar hyperparameter yang dapat digunakan untuk mengoptimalkan proses pelatihan:
training_params = TrainingArguments(
    output_dir="./results",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_steps=25,
    logging_steps=25,
    learning_rate=2e-4,
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,
    max_steps=-1,
    warmup_ratio=0.03,
    group_by_length=True,
    lr_scheduler_type="constant",
    report_to="tensorboard"
)Supervised fine-tuning (SFT) adalah langkah kunci dalam reinforcement learning from human feedback (RLHF). Pustaka TRL dari HuggingFace menyediakan API yang mudah digunakan untuk membuat model SFT dan melatihnya pada dataset Anda hanya dengan beberapa baris kode. Pustaka ini dilengkapi dengan alat untuk melatih model bahasa menggunakan reinforcement learning, dimulai dari supervised fine-tuning, lalu reward modeling, dan akhirnya proximal policy optimization (PPO).
Kita akan memberikan ke SFT Trainer model, dataset, konfigurasi Lora, tokenizer, dan parameter pelatihan.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_params,
    dataset_text_field="text",
    max_seq_length=None,
    tokenizer=tokenizer,
    args=training_params,
    packing=False,
)
Kita akan menggunakan .train() untuk melakukan fine-tuning model Llama 2 pada dataset baru. Butuh satu setengah jam bagi model untuk menyelesaikan 1 epoch.
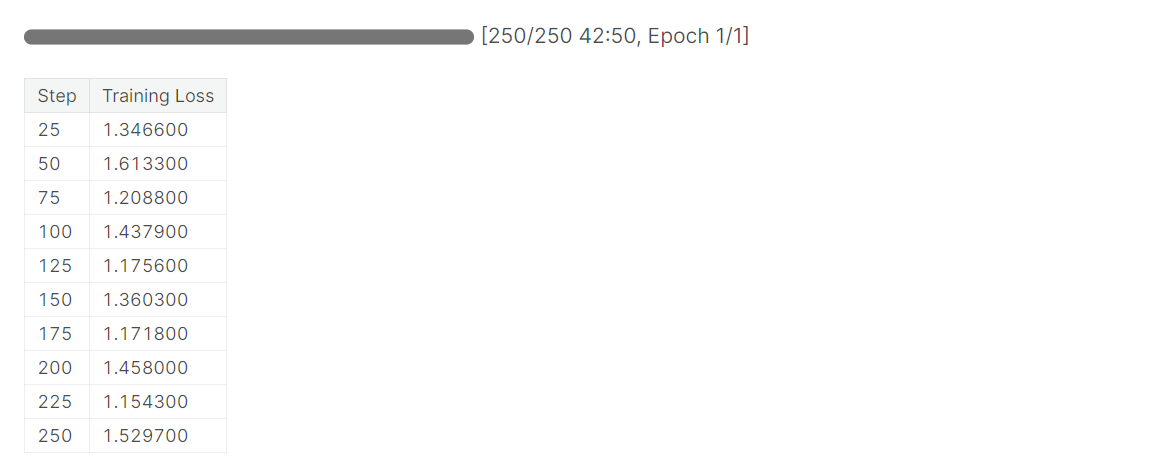
Setelah melatih model, kita akan menyimpan adaptor model dan tokenizer. Anda juga dapat mengunggah model ke Hugging Face menggunakan API serupa.
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
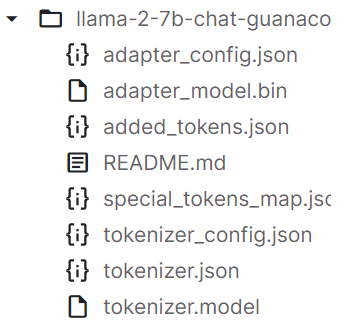
Kini kita dapat meninjau hasil pelatihan dalam sesi interaktif Tensorboard.
from tensorboard import notebook
log_dir = "results/runs"
notebook.start("--logdir {} --port 4000".format(log_dir))
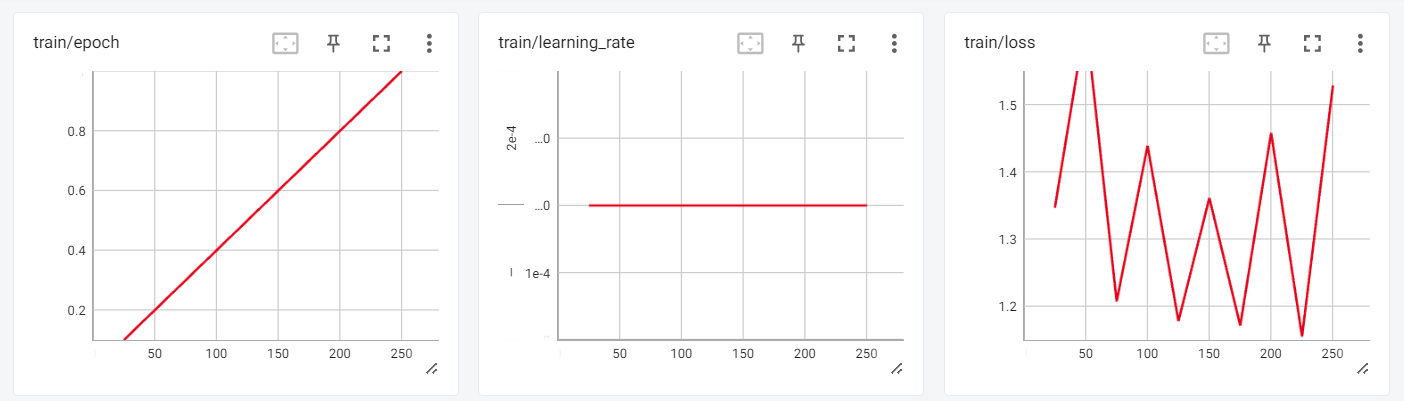
Untuk menguji model yang telah di-fine-tune, kita akan menggunakan pipeline pembangkitan teks transformers dan mengajukan pertanyaan sederhana seperti “Siapa Leonardo Da Vinci?”
logging.set_verbosity(logging.CRITICAL)

prompt = "Who is Leonardo Da Vinci?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Keluaran:
Model menghasilkan respons yang koheren dan terperinci.
<s>[INST] Who is Leonardo Da Vinci? [/INST] Leonardo da Vinci (1452-1519) was an Italian polymath, artist, inventor, and engineer.

Da Vinci is widely considered one of the greatest painters of all time, and his works include the famous Mona Lisa. He was also an accomplished engineer, inventor, and anatomist, and his designs for machines and flight were centuries ahead of his time.

Da Vinci was born in the town of Vinci, Italy, and he was the illegitimate son of a local notary. Despite his humble origins, he was able to study art and engineering in Florence, and he became a renowned artist and inventor.

Da Vinci's work had a profound impact on the Renaissance, and his legacy continues to inspire artists, engineers, and inventors to this day. He
Mari ajukan pertanyaan lain.
prompt = "What is DataCamp Career track?"
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Keluaran:
Guanaco adalah dataset berkualitas tinggi yang telah digunakan untuk melakukan fine-tuning LLM mutakhir di masa lalu. Seluruh dataset Guanaco tersedia di Hugging Face dan berpotensi mencapai performa yang lebih baik lagi pada berbagai tugas bahasa alami.
<s>[INST] What is Datacamp Career track? [/INST] DataCamp Career Track is a program that offers a comprehensive learning experience to help you build your skills and prepare for a career in data science.

The program includes a range of courses, projects, and assessments that are designed to help you build your skills in data science. You will learn how to work with data, create visualizations, and build predictive models.

In addition to the technical skills, you will also learn how to communicate your findings to stakeholders and how to work with a team to solve complex problems.

The program is designed to be flexible, so you can learn at your own pace and on your own schedule. You will also have access to a community of learners and mentors who can provide support and guidance throughout the program.

Overall, DataCamp Career Track is a great way to build your skills and prepare for a career in
Berikut adalah Notebook Colab berisi kode dan keluaran untuk membantu Anda dalam perjalanan pengkodean.
Selanjutnya, Anda dapat menggunakan LlamaIndex dan membangun aplikasi AI Anda sendiri menggunakan model hasil pelatihan baru dengan mengikuti tutorial LlamaIndex: Menambahkan Data Pribadi ke LLM. Anda bisa mendapatkan inspirasi proyek dengan melihat 5 Proyek yang Dibangun dengan Model Generatif dan Alat Open Source.
Sejak rilis Llama 2 pada Juli 2023, Meta telah merilis beberapa model yang lebih baru dengan peningkatan besar. Llama 3 (April 2024) memperkenalkan kosakata 128K token yang lebih besar dan grouped query attention (GQA) di semua ukuran model. Llama 3.1 (Juli 2024) memperluas panjang konteks menjadi 128K token dan menambahkan varian 405B parameter. Llama 3.2 (September 2024) menghadirkan kemampuan multimodal dan model ringan 1B/3B yang dioptimalkan untuk perangkat edge.
Ekosistem fine-tuning juga berkembang pesat. Alat seperti Unsloth menawarkan pelatihan 2x lebih cepat dan penggunaan memori 60% lebih sedikit dibandingkan PEFT standar dari Hugging Face, dan alat berbasis GUI seperti LLaMA-Factory membuat fine-tuning dapat diakses tanpa menulis kode. Konsep inti QLoRA dan PEFT yang dibahas dalam tutorial ini tetap mendasar — kami merekomendasikan untuk mengeksplorasi tutorial kami tentang fine-tuning Llama 3.1 dan fine-tuning Llama 3.2 untuk pendekatan terbaru.
Dalam tutorial ini, kita membahas cara melakukan fine-tuning model LLaMA 2 menggunakan teknik seperti QLoRA, PEFT, dan SFT untuk mengatasi keterbatasan memori dan komputasi. Dengan memanfaatkan pustaka Hugging Face seperti transformers, accelerate, peft, trl, dan bitsandbytes, kita berhasil melakukan fine-tuning model LLaMA 2 dengan 7B parameter pada GPU konsumen.
Secara keseluruhan, tutorial ini mencontohkan bagaimana kemajuan terbaru memungkinkan demokratisasi dan aksesibilitas large language model, sehingga bahkan penggemar pun dapat membangun AI mutakhir dengan sumber daya terbatas.
Untuk terus belajar, ikuti kursus Fine-Tuning dengan Llama 3 untuk praktik langsung dengan model yang lebih baru, atau perdalam pemahaman Anda tentang ekosistem yang digunakan dalam tutorial ini melalui kursus Bekerja dengan Hugging Face. Untuk pengetahuan dasar, mulailah dengan Pengantar LLM di Python atau kursus Konsep Large Language Models (LLMs), dan jelajahi jalur keterampilan AI Fundamentals.
Mulai Perjalanan AI Anda Hari Ini!
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt





