
Che cos'è Pandas AI?
Pandas AI è una libreria Python che usa modelli di AI generativa per potenziare le capacità di pandas. È stata creata per integrare la libreria pandas, uno strumento ampiamente utilizzato per l'analisi e la manipolazione dei dati.
Gli utenti possono riassumere i dati dei data frame di pandas usando il linguaggio naturale. Inoltre, puoi usarla per tracciare visualizzazioni complesse, manipolare i dataframe e generare insight di business.
Immagine da Pandas-AI
Pandas AI è adatta ai principianti; anche chi ha poca esperienza tecnica può usarla per svolgere attività complesse di analisi dei dati. La sua utilità aiuta ad analizzare i dati più velocemente e a trarre conclusioni significative.
Come iniziare con Pandas AI
In questa sezione vedremo come installare e configurare Pandas AI per l'analisi dei dati.
Per prima cosa installeremo Pandas AI con pip.
pip install pandasaiInstallazione opzionale: possiamo anche installare la dipendenza Google PaLM usando il seguente comando.
pip install pandasai[google]In secondo luogo, dobbiamo ottenere una chiave API di OpenAI e salvarla come variabile d'ambiente seguendo il tutorial Usare GPT-3.5 e GPT-4 tramite l'API di OpenAI in Python.
Infine, dobbiamo importare le funzioni essenziali, impostare la chiave OpenAI nel wrapper dell'API LLM e istanziare un oggetto PandasAI. Useremo questo oggetto per eseguire prompt su uno o più dataframe di pandas.
import os
from pandasai import PandasAI
from pandasai.llm.openai import OpenAI


openai_api_key = os.environ["OPENAI_API_KEY"]

llm = OpenAI(api_token=openai_api_key)

pandas_ai = PandasAI(llm)
Oltre a OpenAI GPT-3.5, puoi usare il wrapper LLM API per Google PALM (Bison) o anche modelli open source disponibili su HuggingFace, come Starcoder e Falcon.
from pandasai.llm.starcoder import Starcoder
from pandasai.llm.falcon import Falcon
from pandasai.llm.google_palm import GooglePalm

# GooglePalm
llm = GooglePalm(api_token="YOUR_Google_API_KEY")

# Starcoder
llm = Starcoder(api_token="YOUR_HF_API_KEY")

# Falcon
llm = Falcon(api_token="YOUR_HF_API_KEY")
Puoi anche configurare un file .env ed evitare di impostare api_token. Per farlo, devi aggiungere le chiavi API al file .env usando il seguente template:
HUGGINGFACE_API_KEY=
OPENAI_API_KEY=
Utilizzi di base di Pandas AI
In questo caso d'uso di base, caricheremo i dati dei film su Netflix usando la libreria pandas. Il dataset è composto da più di 8.500 film e serie TV disponibili su Netflix.
import pandas as pd

df = pd.read_csv("netflix_dataset.csv", index_col=0)
df.head(3)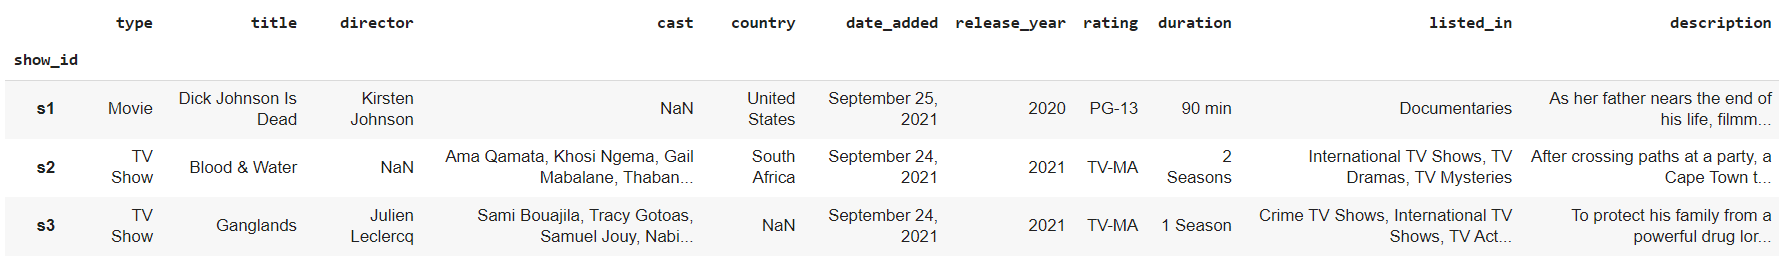
Segui il nostro tutorial su pandas in Python per imparare tutto quello che puoi fare con la libreria pandas.
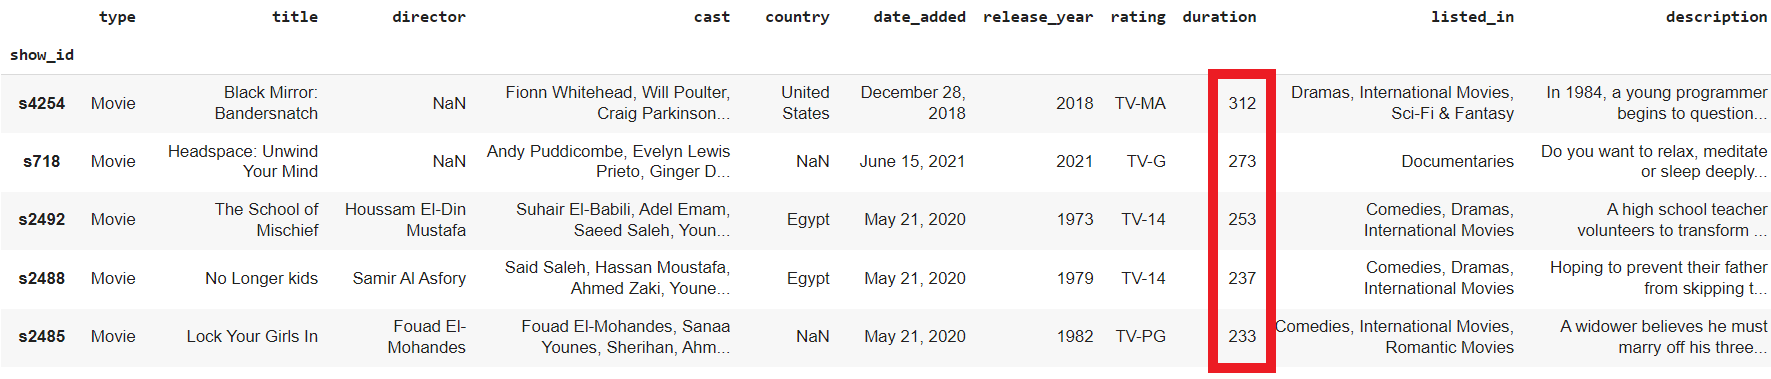
Passando un dataframe e un prompt, possiamo far generare a Pandas AI analisi e manipolazioni del dataset. Nel nostro caso, chiederemo a Pandas AI di mostrare i record dei cinque film con la durata più lunga.
pandas_ai.run(df, prompt='What are 5 longest duration movies?')Come possiamo vedere, il film con la durata più lunga è Black Mirror, con 312 minuti.
Chiediamogli di mostrare solo i nomi dei cinque film più lunghi.
pandas_ai.run(df, prompt='List the names of the 5 longest duration movies.')['Black Mirror: Bandersnatch', 'Headspace: Unwind Your Mind', 'The School of Mischief', 'No Longer kids', 'Lock Your Girls In']Nota: se vuoi rafforzare ulteriormente la tua privacy, puoi istanziare PandasAI con enforce_privacy = True, che non invierà le intestazioni del dataset (ma solo i nomi delle colonne) all'LLM.
Possiamo persino chiedere a Pandas AI di eseguire operazioni complesse come raggruppamenti, ordinamenti e combinazioni.
pandas_ai.run(df, prompt='What is the average duration of tv shows based on country? Make sure the output is sorted.')country
Denmark, Singapore, Canada, United States 10.0
United States, Mexico, Colombia 7.0
Canada, United States, France 5.5
United Kingdom, Ireland 5.0
Canada, United Kingdom 5.0
...
Spain, Cuba 1.0
Germany, France, Russia 1.0Nota: alcuni prompt tecnici potrebbero non funzionare, soprattutto quando chiedi di raggruppare colonne.
Utilizzi avanzati di Pandas AI
Un caso d'uso avanzato per Pandas AI è la generazione di visualizzazioni dati complesse e analisi di business usando più data frame.
Nel primo esempio, potremmo scrivere un prompt per generare un grafico a barre che mostri il numero di titoli per anno, suddivisi per tipologia.
pandas_ai.run(df, prompt='Plot the bar chart of type of media for each year release, using different colors.')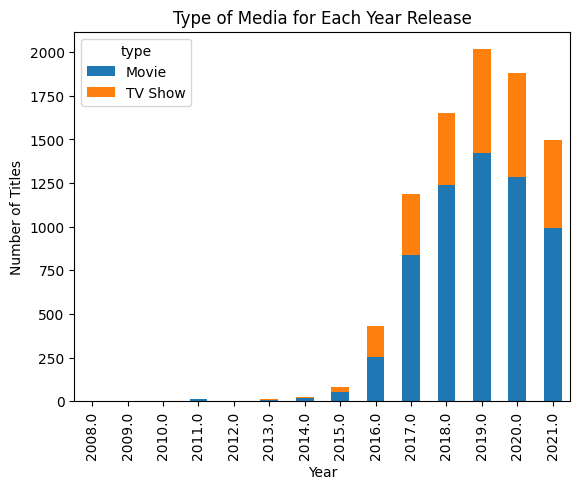
Nota: puoi salvare qualsiasi grafico generato da Pandas AI impostando il parametro save_charts su True. Ad esempio, PandasAI(llm, save_charts=True). I grafici verranno salvati nella directory ./pandasai/exports/charts.
In un secondo esempio, creeremo tre data frame e useremo tutti e tre i data frame per generare un'analisi con Pandas AI.
Pandas AI unirà prima df1 con df2 in base a "store" e df2 con df3 su "location". Quindi elaborerà il dataset combinato e produrrà un risultato in pochi secondi. A un data scientist sarebbero serviti almeno 10 minuti per comprendere i dati e ideare una soluzione.
# DataFrame 1
df1 = pd.DataFrame({
    'sales': [100, 200, 300],
    'store': ['Walmart', 'Target', 'Walmart']
    })

# DataFrame 2
df2 = pd.DataFrame({
    'revenue': [400, 500, 600],
    'store': ['Walmart', 'Target', 'Walmart'],
    'location': ['North', 'South', 'West']})

# DataFrame 3
df3 = pd.DataFrame({
    'profit': [700, 800, 900],
    'location': ['North', 'South', 'West'],
    'employees': [20, 25, 30]})

pandas_ai.run([df1,df2,df3], prompt='How many employees work at Walmart?')50Puoi anche svolgere compiti complessi di analisi dei dati seguendo il corso Data Manipulation with pandas.
Interfaccia a riga di comando (CLI) di Pandas AI
La CLI di Pandas AI è uno strumento sperimentale e puoi installarla clonando il repository e spostandoti direttamente nel progetto.
!git clone https://github.com/gventuri/pandas-ai.git
%cd pandas-ai
Dopodiché, useremo poetry per creare e attivare un ambiente virtuale.
!poetry shellNota: se poetry non è installato sul tuo sistema, puoi installarlo usando curl -sSL https://install.python-poetry.org | python3 -
Usa il seguente comando per installare le dipendenze all'interno dell'ambiente attivato.
!poetry installInfine, apri un terminale e usa lo strumento CLI di Pandas AI. Devi fornire un dataset, il nome del modello e il prompt. Se non viene fornito alcun token, pai recupererà il token dal file .env.
!pai -d "netflix_dataset.csv" -m "openai" -p "What are 5 longest duration movies?"- -d, --dataset: Il percorso del file del dataset.
- -t, --token: Il tuo token API di HuggingFace o OpenAI.
- -m, --model: Il modello LLM da usare. Le opzioni sono:
openai,open-assistant,starcoder, falcon,azure-openaiogoogle-palm. - -p, --prompt: Il prompt che PandasAI deve eseguire.
Leggi la documentazione di Pandas AI per scoprire altre funzioni e funzionalità che possono semplificare il tuo flusso di lavoro.
Conclusione
Pandas AI ha il potenziale per rivoluzionare l'analisi dei dati sfruttando i large language model per generare insight dai dataset.
Mentre i data scientist di solito trascorrono molto tempo a pulire, esplorare e visualizzare i dati, Pandas AI automatizza molte di queste attività ripetitive.
Tuttavia, come tutti gli strumenti di AI, anche Pandas AI ha dei limiti e non può sostituire completamente gli esseri umani. I risultati analizzati richiedono spesso una verifica umana per garantirne l'accuratezza e individuare eventuali casi limite.
In questo post, abbiamo visto come installare, configurare e usare Pandas AI per l'analisi dei dati. Abbiamo utilizzato Pandas AI per eseguire attività di analisi, generare visualizzazioni e sfruttare più dataframe per ottenere insight di business. Se vuoi migliorare i tuoi prompt per ottenere risultati migliori, valuta di completare un corso di Introduzione a ChatGPT o di consultare il Cheat Sheet di ChatGPT per la Data Science.




