
Last chance! 50% off DataCamp Premium
Sale ends in
Pandas AI एक Python लाइब्रेरी है जो जनरेटिव AI मॉडलों का उपयोग करके pandas की क्षमताओं को और सशक्त बनाती है। इसे व्यापक रूप से प्रयुक्त डेटा विश्लेषण और मैनिपुलेशन टूल pandas लाइब्रेरी के पूरक के रूप में बनाया गया है।
उपयोगकर्ता प्राकृतिक भाषा का उपयोग करके pandas डेटा फ्रेम्स के डेटा का सार प्रस्तुत कर सकते हैं। इसके अलावा, आप इसका उपयोग जटिल विज़ुअलाइज़ेशन प्लॉट करने, डेटा फ्रेम्स को मैनिपुलेट करने और व्यावसायिक इनसाइट्स उत्पन्न करने के लिए कर सकते हैं।
Pandas-AI से छवि
Pandas AI शुरुआती-अनुकूल है; सीमित तकनीकी पृष्ठभूमि वाला व्यक्ति भी इसका उपयोग करके जटिल डेटा एनालिटिक्स कार्य कर सकता है। इसकी उपयोगिता डेटा को तेजी से विश्लेषित करने और सार्थक निष्कर्ष निकालने में मदद करती है।
इस खंड में, हम डेटा विश्लेषण के लिए Pandas AI को इंस्टॉल और सेट अप करना सीखेंगे।
पहले, हम pip का उपयोग करके Pandas AI इंस्टॉल करेंगे।
pip install pandasaiवैकल्पिक इंस्टॉल: हम निम्नलिखित कोड का उपयोग करके Google PaLM डिपेंडेंसी भी इंस्टॉल कर सकते हैं।
pip install pandasai[google]दूसरा, हमें OpenAI API कुंजी प्राप्त करनी होगी और इसे एनवायरनमेंट वेरिएबल के रूप में स्टोर करना होगा। इसके लिए इस ट्यूटोरियल का अनुसरण करें: Using GPT-3.5 and GPT-4 via the OpenAI API in Python।
अंत में, हमें आवश्यक फ़ंक्शंस इम्पोर्ट करने हैं, LLM API रैपर में OpenAI कुंजी सेट करनी है, और एक PandasAI ऑब्जेक्ट इंस्टैंशिएट करना है। हम इस ऑब्जेक्ट का उपयोग एक या एकाधिक pandas डेटा फ्रेम्स पर प्रॉम्प्ट चलाने के लिए करेंगे।
import os
from pandasai import PandasAI
from pandasai.llm.openai import OpenAI


openai_api_key = os.environ["OPENAI_API_KEY"]

llm = OpenAI(api_token=openai_api_key)

pandas_ai = PandasAI(llm)
OpenAI GPT-3.5 के अतिरिक्त, आप Google PALM (Bison) के लिए LLM API रैपर या HuggingFace पर उपलब्ध Starcoder और Falcon जैसे ओपन-सोर्स मॉडलों का भी उपयोग कर सकते हैं।
from pandasai.llm.starcoder import Starcoder
from pandasai.llm.falcon import Falcon
from pandasai.llm.google_palm import GooglePalm

# GooglePalm
llm = GooglePalm(api_token="YOUR_Google_API_KEY")

# Starcoder
llm = Starcoder(api_token="YOUR_HF_API_KEY")

# Falcon
llm = Falcon(api_token="YOUR_HF_API_KEY")
आप .env फ़ाइल सेट करके api_token सेट करने से भी बच सकते हैं। इसके लिए आपको निम्नलिखित टेम्पलेट का उपयोग करके .env फ़ाइल में API कुंजियाँ जोड़नी होंगी:
HUGGINGFACE_API_KEY=
OPENAI_API_KEY=
इस बुनियादी उदाहरण में, हम pandas लाइब्रेरी का उपयोग करके Netflix Movie Data लोड करेंगे। इस डेटासेट में Netflix पर उपलब्ध 8,500 से अधिक फ़िल्में और टीवी शो शामिल हैं।
import pandas as pd

df = pd.read_csv("netflix_dataset.csv", index_col=0)
df.head(3)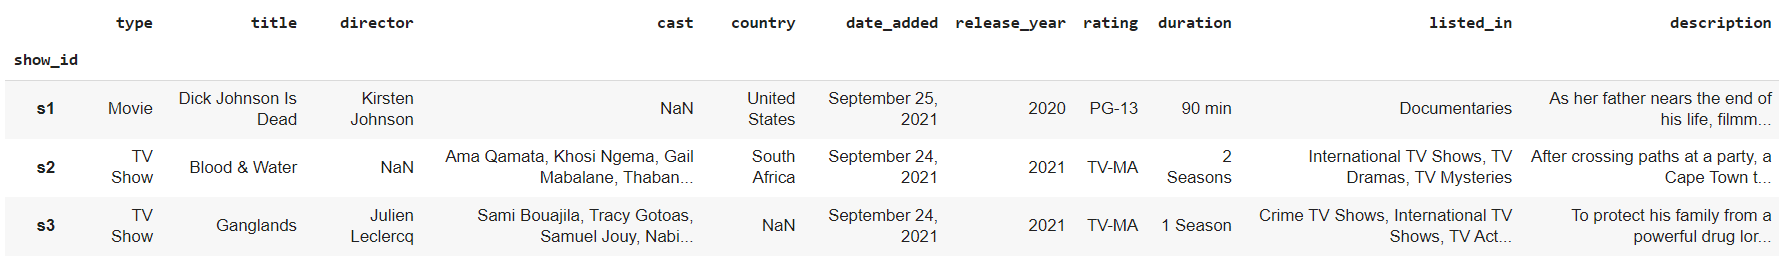
pandas Python लाइब्रेरी से आप क्या-क्या कर सकते हैं यह जानने के लिए हमारा Python pandas ट्यूटोरियल देखें।
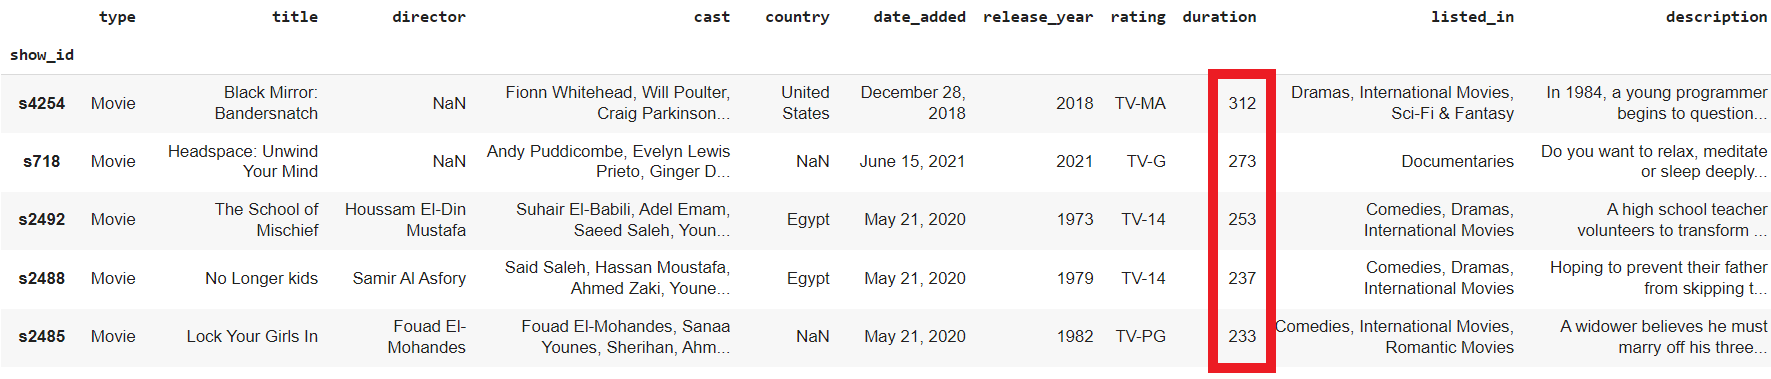
एक डेटा फ्रेम और प्रॉम्प्ट पास करके, हम Pandas AI से विश्लेषण जनरेट कराने और डेटासेट मैनिपुलेट कराने के लिए कह सकते हैं। हमारे मामले में, हम Pandas AI को सबसे अधिक अवधि वाली पाँच फ़िल्मों के रिकॉर्ड दिखाने के लिए प्रॉम्प्ट करेंगे।
pandas_ai.run(df, prompt='What are 5 longest duration movies?')जैसा कि हम देख सकते हैं, सबसे लंबी अवधि वाली फ़िल्म Black Mirror है, 312 मिनट के साथ।
आइए इसे केवल सबसे लंबी अवधि वाली पाँच फ़िल्मों के नाम दिखाने को कहें।
pandas_ai.run(df, prompt='List the names of the 5 longest duration movies.')['Black Mirror: Bandersnatch', 'Headspace: Unwind Your Mind', 'The School of Mischief', 'No Longer kids', 'Lock Your Girls In']नोट: यदि आप अपनी गोपनीयता को और सुदृढ़ करना चाहते हैं, तो आप enforce_privacy = True के साथ PandasAI इंस्टैंशिएट कर सकते हैं, जो LLM को डेटासेट हेडर्स नहीं भेजेगा (सिर्फ कॉलम नाम भेजे जाएंगे)।
हम Pandas AI से ग्रुपिंग, सॉर्टिंग और कॉम्बिनिंग जैसे जटिल कार्य भी करवाने के लिए कह सकते हैं।
pandas_ai.run(df, prompt='What is the average duration of tv shows based on country? Make sure the output is sorted.')country
Denmark, Singapore, Canada, United States 10.0
United States, Mexico, Colombia 7.0
Canada, United States, France 5.5
United Kingdom, Ireland 5.0
Canada, United Kingdom 5.0
...
Spain, Cuba 1.0
Germany, France, Russia 1.0नोट: कुछ तकनीकी प्रॉम्प्ट काम न करें, विशेषकर जब आप कॉलम्स को ग्रुप करने के लिए कहते हैं।
Pandas AI का एक उन्नत उपयोग मामला यह है कि यह अनेक डेटा फ्रेम्स का उपयोग करके जटिल डेटा विज़ुअलाइज़ेशन और व्यावसायिक विश्लेषण जनरेट करे।
पहले उदाहरण में, हम एक प्रॉम्प्ट लिख सकते हैं जो वर्ष के अनुसार, प्रकार के आधार पर वर्गीकृत शीर्षकों की संख्या दर्शाने वाला बार चार्ट बनाए।
pandas_ai.run(df, prompt='Plot the bar chart of type of media for each year release, using different colors.')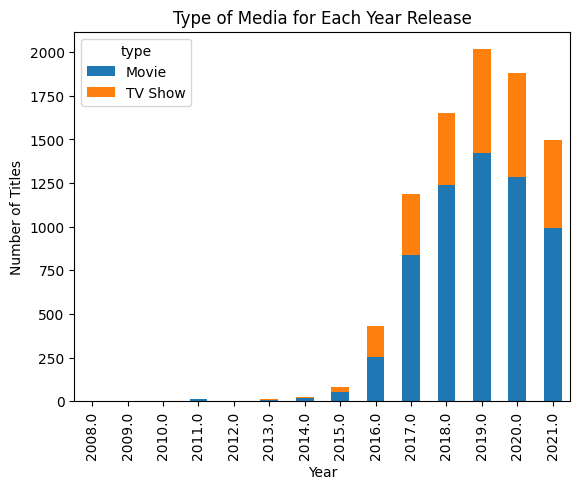
नोट: आप Pandas AI द्वारा जनरेट किए गए किसी भी चार्ट को save_charts पैरामीटर को True सेट करके सहेज सकते हैं। उदाहरण के लिए, PandasAI(llm, save_charts=True)। चार्ट्स ./pandasai/exports/charts directory में सहेजे जाएंगे।
दूसरे उदाहरण में, हम तीन डेटा फ्रेम्स बनाएंगे और सभी तीन डेटा फ्रेम्स का उपयोग करके Pandas AI से विश्लेषण जनरेट कराएंगे।
Pandas AI पहले df1 को "store" के आधार पर df2 से जोड़ेगा और फिर "location" पर df2 को df3 से जोड़ेगा। उसके बाद यह संयोजित डेटासेट को प्रोसेस करेगा और कुछ ही सेकंड में परिणाम देगा। किसी डेटा साइंटिस्ट को डेटा समझने और समाधान निकालने में कम से कम 10 मिनट लगते।
# DataFrame 1
df1 = pd.DataFrame({
    'sales': [100, 200, 300],
    'store': ['Walmart', 'Target', 'Walmart']
    })

# DataFrame 2
df2 = pd.DataFrame({
    'revenue': [400, 500, 600],
    'store': ['Walmart', 'Target', 'Walmart'],
    'location': ['North', 'South', 'West']})

# DataFrame 3
df3 = pd.DataFrame({
    'profit': [700, 800, 900],
    'location': ['North', 'South', 'West'],
    'employees': [20, 25, 30]})

pandas_ai.run([df1,df2,df3], prompt='How many employees work at Walmart?')50आप जटिल डेटा विश्लेषण कार्य भी कर सकते हैं—इसके लिए Data Manipulation with pandas कोर्स करें।
Pandas AI CLI एक प्रायोगिक टूल है, और आप रेपो क्लोन करके तथा सीधे प्रोजेक्ट में जाकर इसे इंस्टॉल कर सकते हैं।
!git clone https://github.com/gventuri/pandas-ai.git
%cd pandas-ai
उसके बाद, हम poetry का उपयोग करके एक वर्चुअल एनवायरनमेंट बनाएंगे और सक्रिय करेंगे।
!poetry shellनोट: यदि आपके सिस्टम में poetry इंस्टॉल नहीं है, तो आप इसे curl से इंस्टॉल कर सकते हैं: -sSL https://install.python-poetry.org | python3 -
सक्रिय किए गए एनवायरनमेंट के अंदर डिपेंडेंसीज़ इंस्टॉल करने के लिए निम्न कोड का उपयोग करें।
!poetry installअंत में, टर्मिनल खोलें और Pandas AI CLI टूल का उपयोग करें। आपको डेटासेट, मॉडल का नाम और प्रॉम्प्ट प्रदान करना होगा। यदि कोई टोकन प्रदान नहीं किया गया है, तो pai .env फ़ाइल से टोकन प्राप्त करेगा।
!pai -d "netflix_dataset.csv" -m "openai" -p "What are 5 longest duration movies?"openai, open-assistant, starcoder, falcon, azure-openai, या google-palm।अपने वर्कफ़्लो को सरल बनाने वाली और भी फ़ंक्शंस व फीचर्स जानने के लिए Pandas AI की दस्तावेज़ीकरण पढ़ें।
Pandas AI में यह क्षमता है कि वह बड़े भाषा मॉडलों का लाभ उठाकर डेटासेट्स से इनसाइट्स जनरेट करके डेटा विश्लेषण में बदलाव ला सके।
जहाँ डेटा साइंटिस्ट आमतौर पर डेटा की सफाई, खोज और विज़ुअलाइज़ेशन में काफी समय लगाते हैं, वहीं Pandas AI इन दोहराए जाने वाले कार्यों में से कई को स्वचालित कर देता है।
हालाँकि, अन्य सभी AI टूल्स की तरह, Pandas AI की भी सीमाएँ हैं और यह पूरी तरह मनुष्यों की जगह नहीं ले सकता। विश्लेषित परिणामों की सटीकता सुनिश्चित करने और किसी भी एज केस की पहचान करने के लिए अक्सर मानवीय सत्यापन आवश्यक होता है।
इस पोस्ट में, हमने डेटा विश्लेषण के लिए Pandas AI को कैसे इंस्टॉल, सेट अप और उपयोग करना सीखा। हमने Pandas AI का उपयोग करके डेटा विश्लेषण कार्य किए, डेटा विज़ुअलाइज़ेशन जनरेट किए, और व्यावसायिक इनसाइट्स प्राप्त करने के लिए अनेक डेटा फ्रेम्स का लाभ उठाया। यदि आप बेहतर परिणामों के लिए अपने प्रॉम्प्ट्स को सुधारना चाहते हैं, तो Introduction to ChatGPT कोर्स पूरा करने या ChatGPT Cheat Sheet for Data Science देखने पर विचार करें।
