Pandas AI là gì?
Pandas AI là một thư viện Python sử dụng các mô hình AI tạo sinh để tăng cường khả năng của pandas. Nó được tạo ra để bổ trợ cho thư viện pandas, một công cụ được sử dụng rộng rãi cho phân tích và thao tác dữ liệu.
Người dùng có thể tóm tắt dữ liệu trong data frame của pandas bằng ngôn ngữ tự nhiên. Ngoài ra, bạn có thể dùng nó để vẽ các trực quan hóa phức tạp, thao tác data frame và tạo ra các insight kinh doanh.
Hình ảnh từ Pandas-AI
Pandas AI thân thiện với người mới bắt đầu; ngay cả người có ít nền tảng kỹ thuật cũng có thể dùng để thực hiện các tác vụ phân tích dữ liệu phức tạp. Tính hữu dụng của nó giúp phân tích dữ liệu nhanh hơn và rút ra kết luận có ý nghĩa.
Bắt đầu với Pandas AI
Trong phần này, chúng ta sẽ học cách cài đặt và thiết lập Pandas AI cho phân tích dữ liệu.
Đầu tiên, chúng ta sẽ cài đặt Pandas AI bằng pip.
pip install pandasaiCài đặt tùy chọn: Chúng ta cũng có thể cài đặt phụ thuộc Google PaLM bằng đoạn mã sau.
pip install pandasai[google]Tiếp theo, chúng ta cần lấy khóa API OpenAI và lưu nó như một biến môi trường bằng cách làm theo hướng dẫn Sử dụng GPT-3.5 và GPT-4 qua OpenAI API trong Python.
Cuối cùng, chúng ta phải import các hàm cần thiết, thiết lập khóa OpenAI vào lớp bọc API LLM và khởi tạo một đối tượng PandasAI. Chúng ta sẽ dùng đối tượng này để chạy prompt trên một hoặc nhiều dataframe của pandas.
import os
from pandasai import PandasAI
from pandasai.llm.openai import OpenAI


openai_api_key = os.environ["OPENAI_API_KEY"]

llm = OpenAI(api_token=openai_api_key)

pandas_ai = PandasAI(llm)
Ngoài OpenAI GPT-3.5, bạn có thể sử dụng lớp bọc API LLM cho Google PALM (Bison) hoặc thậm chí các mô hình mã nguồn mở có sẵn trên HuggingFace, như Starcoder và Falcon.
from pandasai.llm.starcoder import Starcoder
from pandasai.llm.falcon import Falcon
from pandasai.llm.google_palm import GooglePalm

# GooglePalm
llm = GooglePalm(api_token="YOUR_Google_API_KEY")

# Starcoder
llm = Starcoder(api_token="YOUR_HF_API_KEY")

# Falcon
llm = Falcon(api_token="YOUR_HF_API_KEY")
Bạn cũng có thể thiết lập tệp .env và tránh việc thiết lập api_token. Để làm vậy, bạn phải thêm khóa API vào tệp .env theo mẫu sau:
HUGGINGFACE_API_KEY=
OPENAI_API_KEY=
Các cách dùng cơ bản của Pandas AI
Trong tình huống cơ bản này, chúng ta sẽ tải Dữ liệu Phim Netflix bằng thư viện pandas. Bộ dữ liệu gồm hơn 8.500 phim và chương trình truyền hình có trên Netflix.
import pandas as pd

df = pd.read_csv("netflix_dataset.csv", index_col=0)
df.head(3)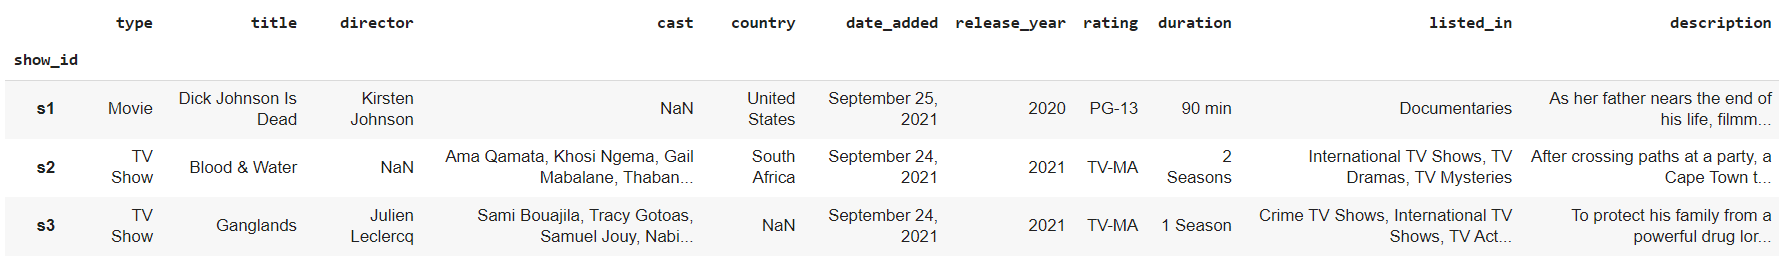
Làm theo hướng dẫn pandas bằng Python của chúng tôi để học mọi thứ bạn có thể làm với thư viện pandas.
Bằng cách truyền vào một dataframe và prompt, chúng ta có thể để Pandas AI tạo phân tích và thao tác với bộ dữ liệu. Trong trường hợp này, chúng ta sẽ yêu cầu Pandas AI hiển thị các bản ghi của năm phim có thời lượng dài nhất.
pandas_ai.run(df, prompt='What are 5 longest duration movies?')Như chúng ta thấy, phim có thời lượng dài nhất là Black Mirror, với 312 phút.
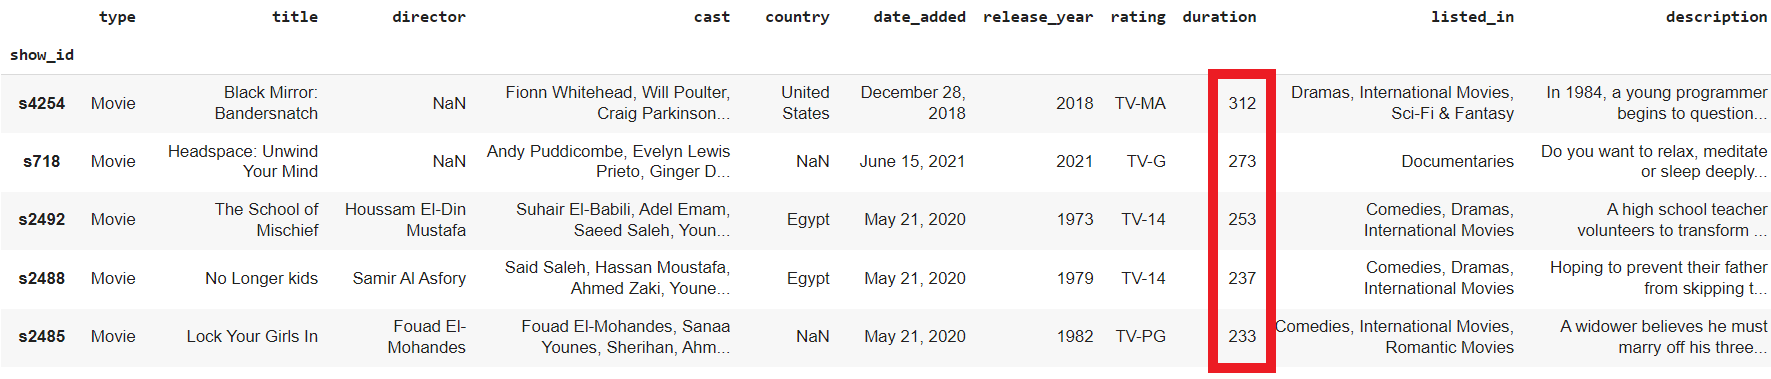
Hãy yêu cầu nó chỉ hiển thị tên của năm phim có thời lượng dài nhất.
pandas_ai.run(df, prompt='List the names of the 5 longest duration movies.')['Black Mirror: Bandersnatch', 'Headspace: Unwind Your Mind', 'The School of Mischief', 'No Longer kids', 'Lock Your Girls In']Lưu ý: nếu bạn muốn tăng cường quyền riêng tư, bạn có thể khởi tạo PandasAI với enforce_privacy = True, khi đó dữ liệu sẽ không gửi header của bộ dữ liệu (chỉ gửi tên cột) tới LLM.
Chúng ta thậm chí có thể yêu cầu Pandas AI thực hiện các tác vụ phức tạp như nhóm, sắp xếp và kết hợp.
pandas_ai.run(df, prompt='What is the average duration of tv shows based on country? Make sure the output is sorted.')country
Denmark, Singapore, Canada, United States 10.0
United States, Mexico, Colombia 7.0
Canada, United States, France 5.5
United Kingdom, Ireland 5.0
Canada, United Kingdom 5.0
...
Spain, Cuba 1.0
Germany, France, Russia 1.0Lưu ý: một số prompt kỹ thuật có thể không hoạt động, đặc biệt khi bạn yêu cầu nhóm cột.
Các cách dùng nâng cao của Pandas AI
Một tình huống nâng cao cho Pandas AI là tạo các trực quan hóa dữ liệu phức tạp và phân tích kinh doanh bằng cách sử dụng nhiều data frame.
Trong ví dụ đầu tiên, chúng ta có thể viết một prompt để tạo biểu đồ cột hiển thị số lượng tựa phim theo năm, được phân loại theo loại nội dung.
pandas_ai.run(df, prompt='Plot the bar chart of type of media for each year release, using different colors.')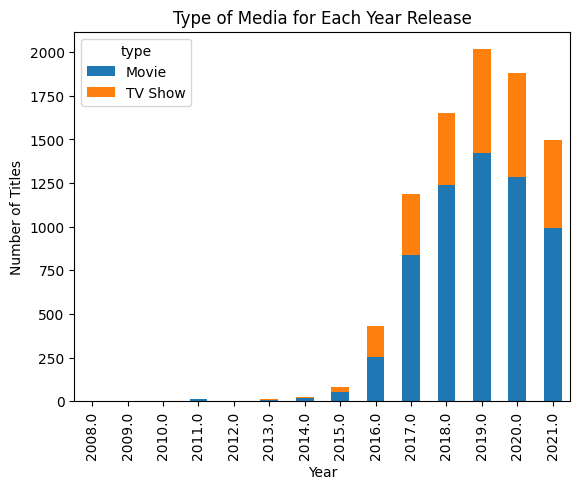
Lưu ý: Bạn có thể lưu bất kỳ biểu đồ nào do Pandas AI tạo ra bằng cách đặt tham số save_charts thành True. Ví dụ, PandasAI(llm, save_charts=True). Các biểu đồ sẽ được lưu trong ./pandasai/exports/charts directory.
Ở ví dụ thứ hai, chúng ta sẽ tạo ba data frame và dùng cả ba để tạo phân tích với Pandas AI.
Pandas AI sẽ trước hết nối df1 với df2 dựa trên "store" và df2 với df3 dựa trên "location." Sau đó, nó sẽ xử lý bộ dữ liệu đã kết hợp và đưa ra kết quả trong vài giây. Một nhà khoa học dữ liệu sẽ mất ít nhất 10 phút để hiểu dữ liệu và đưa ra giải pháp.
# DataFrame 1
df1 = pd.DataFrame({
    'sales': [100, 200, 300],
    'store': ['Walmart', 'Target', 'Walmart']
    })

# DataFrame 2
df2 = pd.DataFrame({
    'revenue': [400, 500, 600],
    'store': ['Walmart', 'Target', 'Walmart'],
    'location': ['North', 'South', 'West']})

# DataFrame 3
df3 = pd.DataFrame({
    'profit': [700, 800, 900],
    'location': ['North', 'South', 'West'],
    'employees': [20, 25, 30]})

pandas_ai.run([df1,df2,df3], prompt='How many employees work at Walmart?')50Bạn cũng có thể thực hiện các tác vụ phân tích dữ liệu phức tạp bằng cách tham gia khóa học Xử lý dữ liệu với pandas.
Giao diện dòng lệnh (CLI) của Pandas AI
Pandas AI CLI là một công cụ thử nghiệm, và bạn có thể cài đặt nó bằng cách nhân bản kho lưu trữ và chuyển vào thư mục dự án.
!git clone https://github.com/gventuri/pandas-ai.git
%cd pandas-ai
Sau đó, chúng ta sẽ dùng poetry để tạo và kích hoạt môi trường ảo.
!poetry shellLưu ý: nếu poetry chưa được cài đặt trên hệ thống của bạn, bạn có thể cài đặt bằng curl -sSL https://install.python-poetry.org | python3 -
Sử dụng đoạn mã sau để cài đặt các phụ thuộc trong môi trường đã kích hoạt.
!poetry installCuối cùng, mở terminal và sử dụng công cụ Pandas AI CLI. Bạn phải cung cấp bộ dữ liệu, tên mô hình và prompt. Nếu không cung cấp token, pai sẽ lấy token từ tệp .env.
!pai -d "netflix_dataset.csv" -m "openai" -p "What are 5 longest duration movies?"- -d, --dataset: Đường dẫn tệp tới bộ dữ liệu.
- -t, --token: Token API của HuggingFace hoặc OpenAI của bạn.
- -m, --model: Mô hình LLM sẽ dùng. Các tùy chọn gồm:
openai,open-assistant,starcoder, falcon,azure-openai, hoặcgoogle-palm. - -p, --prompt: Prompt để PandasAI thực thi.
Đọc tài liệu của Pandas AI để tìm hiểu thêm các chức năng và tính năng có thể đơn giản hóa quy trình làm việc của bạn.
Kết luận
Pandas AI có tiềm năng cách mạng hóa phân tích dữ liệu bằng cách tận dụng các mô hình ngôn ngữ lớn để tạo insight từ bộ dữ liệu.
Trong khi các nhà khoa học dữ liệu thường dành nhiều thời gian để làm sạch, khám phá và trực quan hóa dữ liệu, Pandas AI tự động hóa nhiều tác vụ lặp đi lặp lại này.
Tuy nhiên, giống như mọi công cụ AI, Pandas AI vẫn có hạn chế và không thể thay thế hoàn toàn con người. Kết quả phân tích thường cần xác minh bởi con người để đảm bảo độ chính xác và phát hiện các trường hợp biên.
Trong bài viết này, chúng ta đã học cách cài đặt, thiết lập và sử dụng Pandas AI cho phân tích dữ liệu. Chúng ta đã tận dụng Pandas AI để thực hiện các tác vụ phân tích dữ liệu, tạo trực quan hóa và khai thác nhiều dataframe để rút ra insight kinh doanh. Nếu bạn muốn cải thiện prompt để có kết quả tốt hơn, hãy cân nhắc hoàn thành khóa học Giới thiệu về ChatGPT hoặc tham khảo Tờ phao ChatGPT cho Khoa học Dữ liệu.

