

Programma
Fondamenti della ChatGPT
3 ore
Pratica and corso your progress.
Continua Con GoogleGPT-4o mini deriva dal più grande modello GPT-4o tramite un processo di distillazione. Questo processo consiste nell'addestrare un modello più piccolo a imitare il comportamento e le prestazioni del modello più grande e complesso, ottenendo così una versione economica ma altamente capace dell'originale.
GPT-4o mini compete con modelli come Llama 3 8B, Gemini 1.5 Flash e Claude Haiku, oltre al GPT-3.5 Turbo di OpenAI. Questi modelli offrono funzionalità simili ma spesso a costi più elevati o con metriche di prestazione meno avanzate.
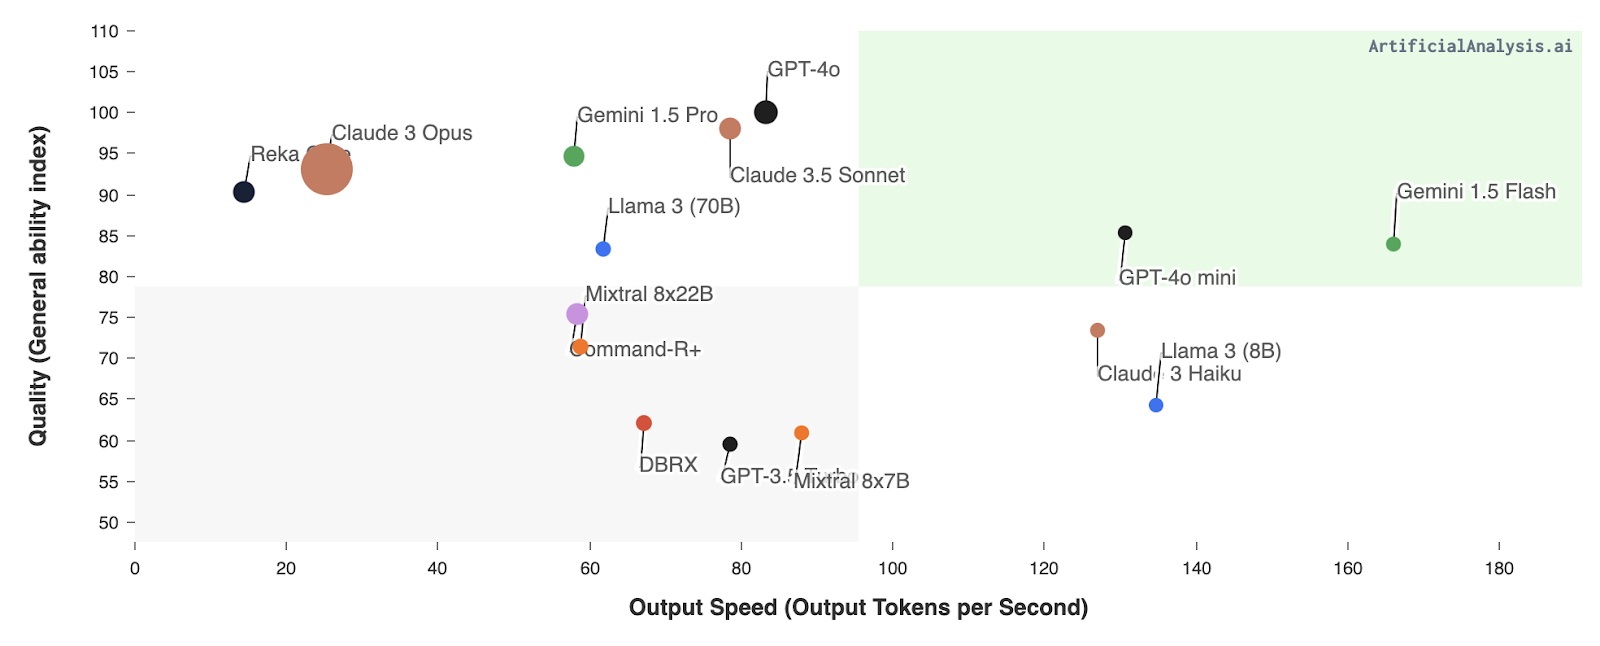
Fonte: Artificial Analysis
GPT-4o mini raggiunge il suo equilibrio tra prestazioni ed efficienza grazie a un processo noto come distillazione del modello. In sostanza, si tratta di addestrare un modello più piccolo e snello (lo "studente") a imitare il comportamento e le conoscenze di un modello più grande e complesso (l'"insegnante").
Il modello più grande, in questo caso GPT-4o, è stato pre-addestrato su enormi quantità di dati e possiede una profonda comprensione dei pattern linguistici, della semantica e persino di abilità di ragionamento. Tuttavia, le sue dimensioni lo rendono costoso in termini computazionali e meno adatto a certe applicazioni.
La distillazione del modello affronta questo problema trasferendo le conoscenze e le capacità del più grande GPT-4o al più piccolo GPT-4o mini. In genere, ciò avviene facendo apprendere al modello più piccolo a predire gli output del modello più grande su un set eterogeneo di dati in input. Attraverso questo processo, GPT-4o mini "distilla" efficacemente le conoscenze e le abilità più importanti dal suo omologo più grande.
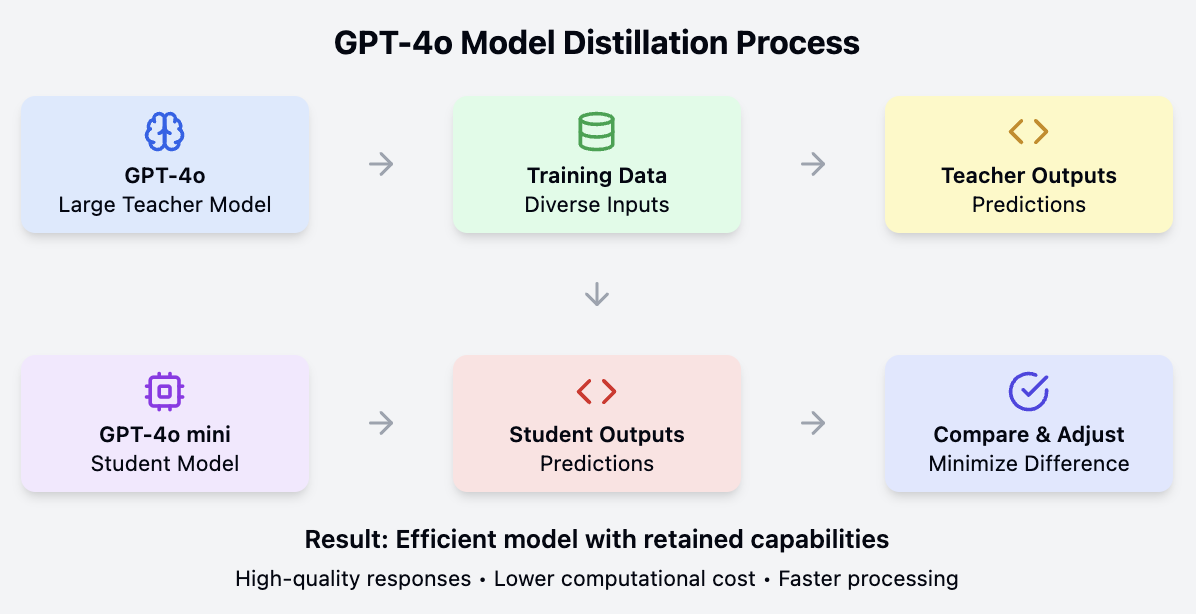
Il risultato è un modello che, pur essendo più piccolo ed efficiente, conserva gran parte delle prestazioni e delle capacità dell'originale. GPT-4o mini può gestire compiti linguistici complessi, comprendere il contesto e generare risposte di alta qualità, consumando al contempo meno risorse computazionali. Questo lo rende una soluzione pratica e conveniente per un'ampia gamma di applicazioni, soprattutto dove velocità ed economicità sono importanti.
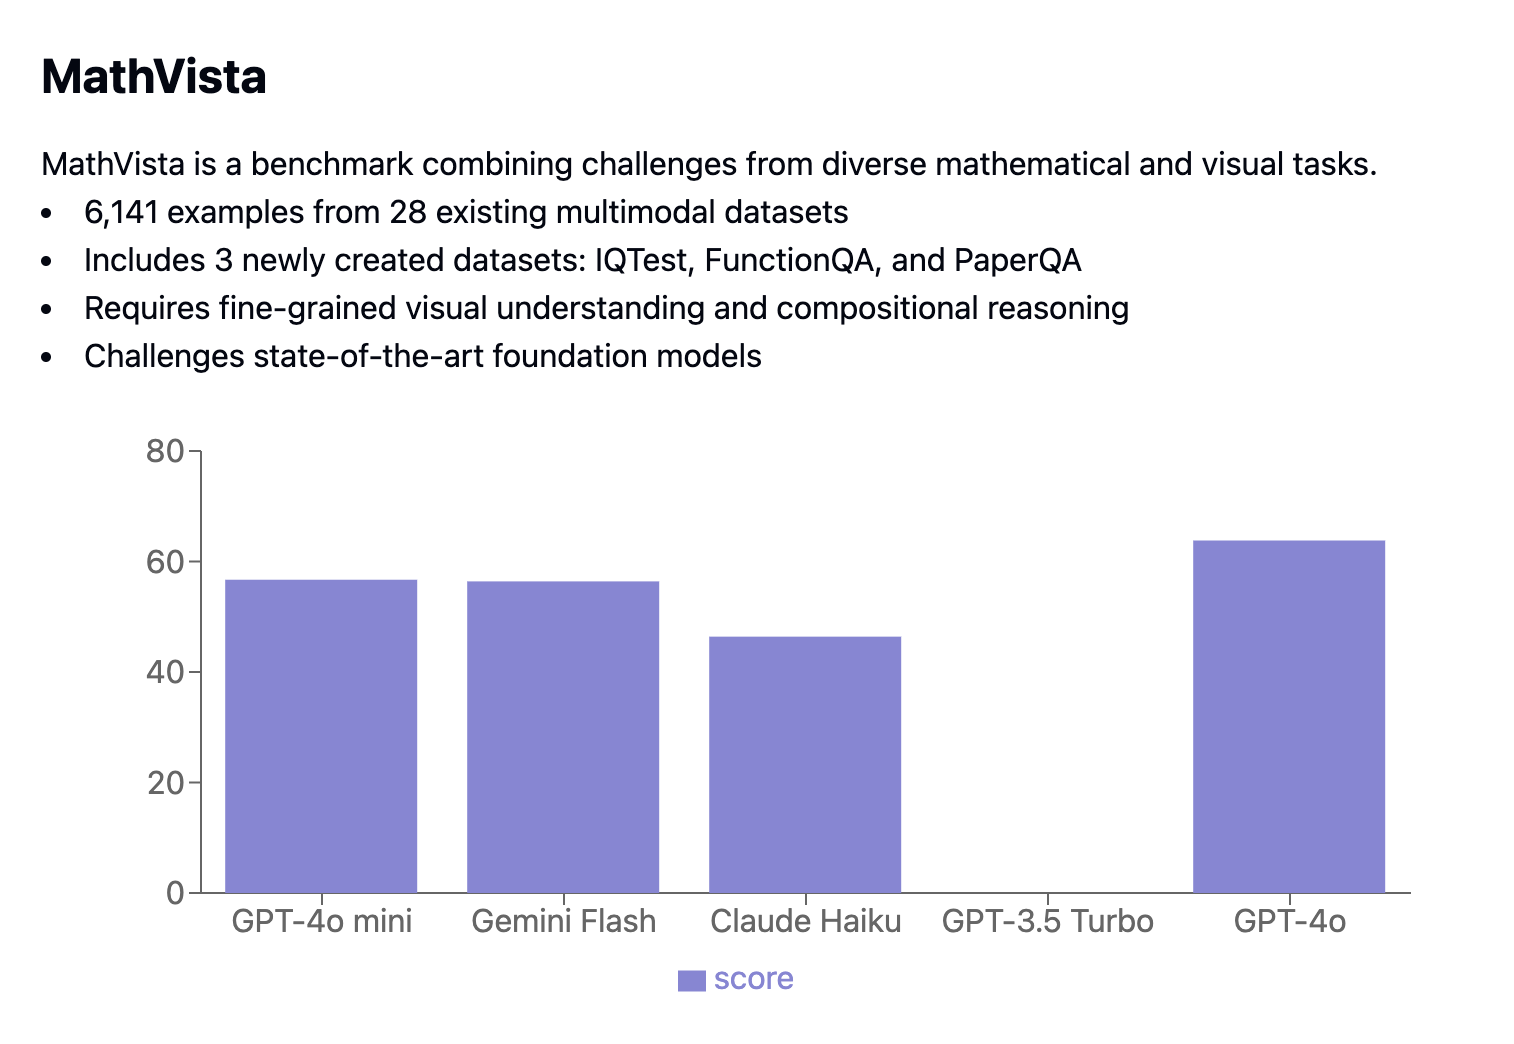
GPT-4o mini mostra prestazioni notevoli su vari benchmark. Ho creato Claude Artifacts per ciascun benchmark per spiegare cosa misura ogni benchmark per LLM.
Per i compiti di ragionamento, abbiamo valutato GPT-4o mini sui seguenti:
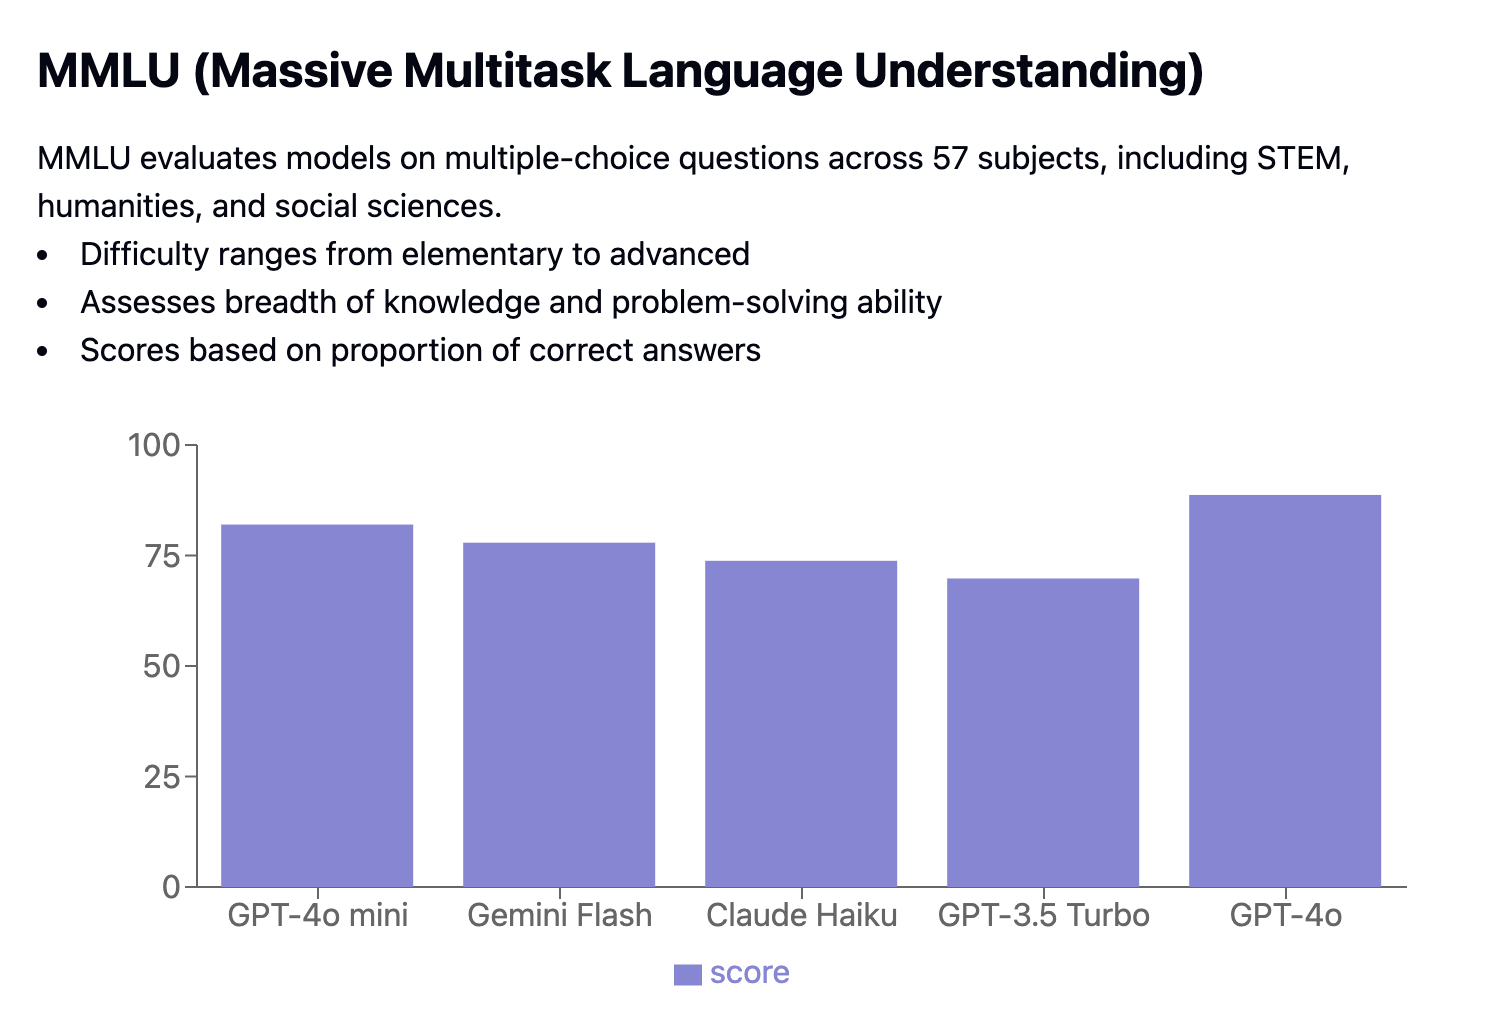
MMLU (Massive Multitask Language Understanding) è un benchmark che testa i modelli con domande a scelta multipla su 57 materie diverse, tra cui STEM, scienze umane e scienze sociali. Le domande variano per difficoltà, da base ad avanzata. Misura quante risposte sono corrette e richiedono corrispondenze esatte. GPT-4o Mini ha ottenuto l'82,0%, superando concorrenti come Gemini Flash (77,9%) e Claude Haiku (73,8%).
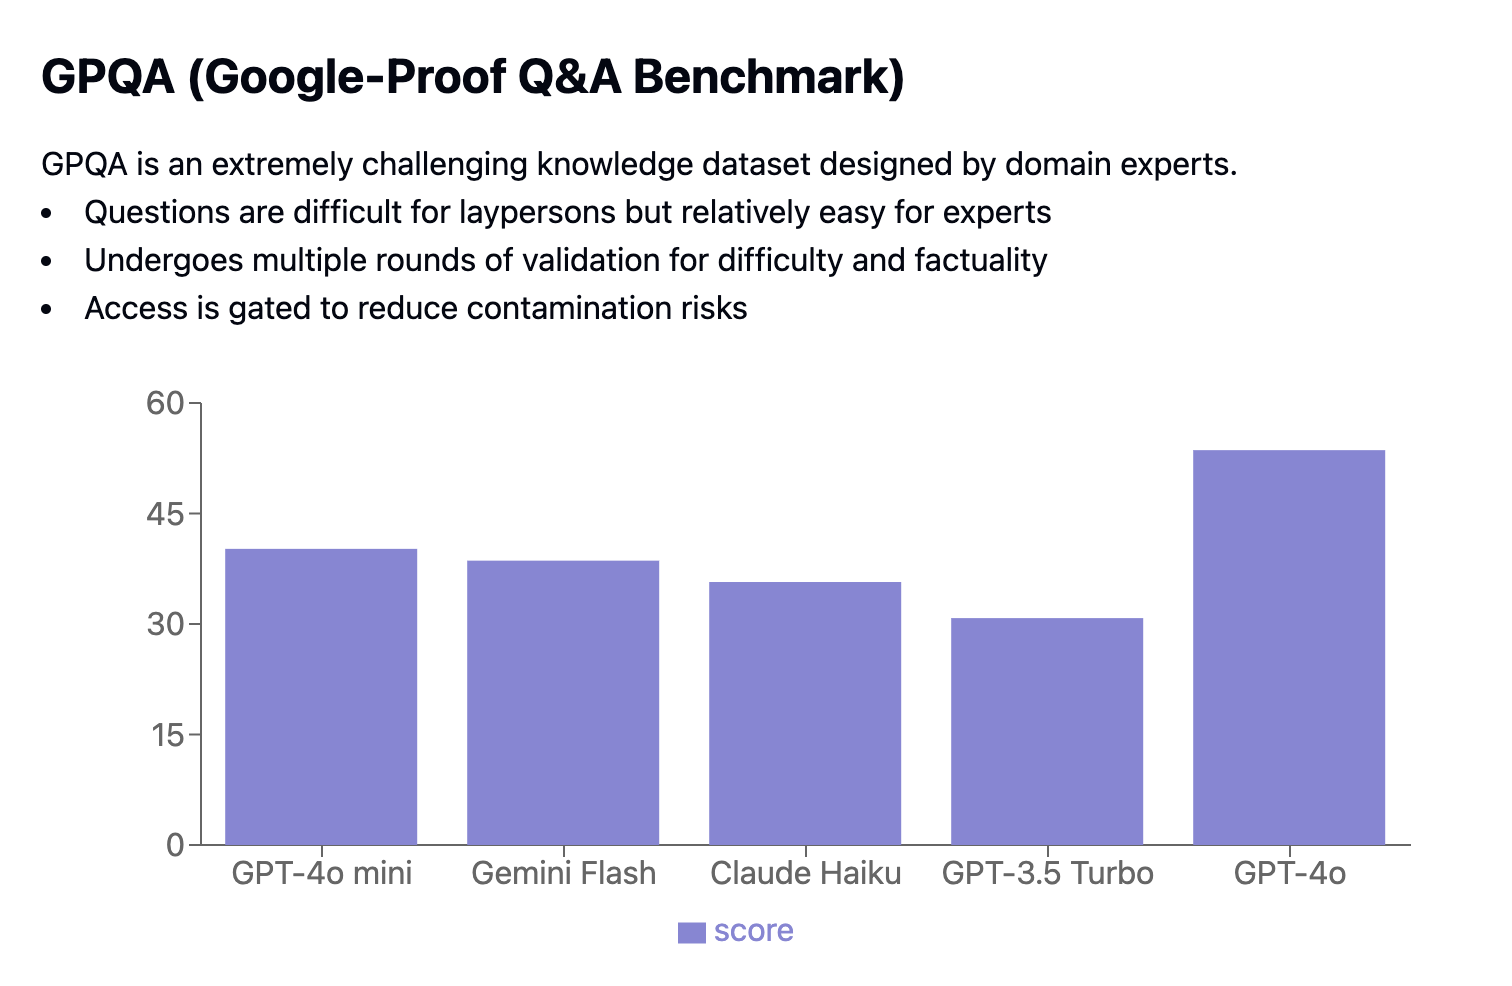
GPQA (Google-Proof Q&A Benchmark) è un dataset impegnativo con domande create da esperti per mettere in difficoltà i non esperti pur rimanendo gestibili per gli specialisti. Le domande sono validate con cura per difficoltà e accuratezza tramite più round per ridurre i rischi di contaminazione.
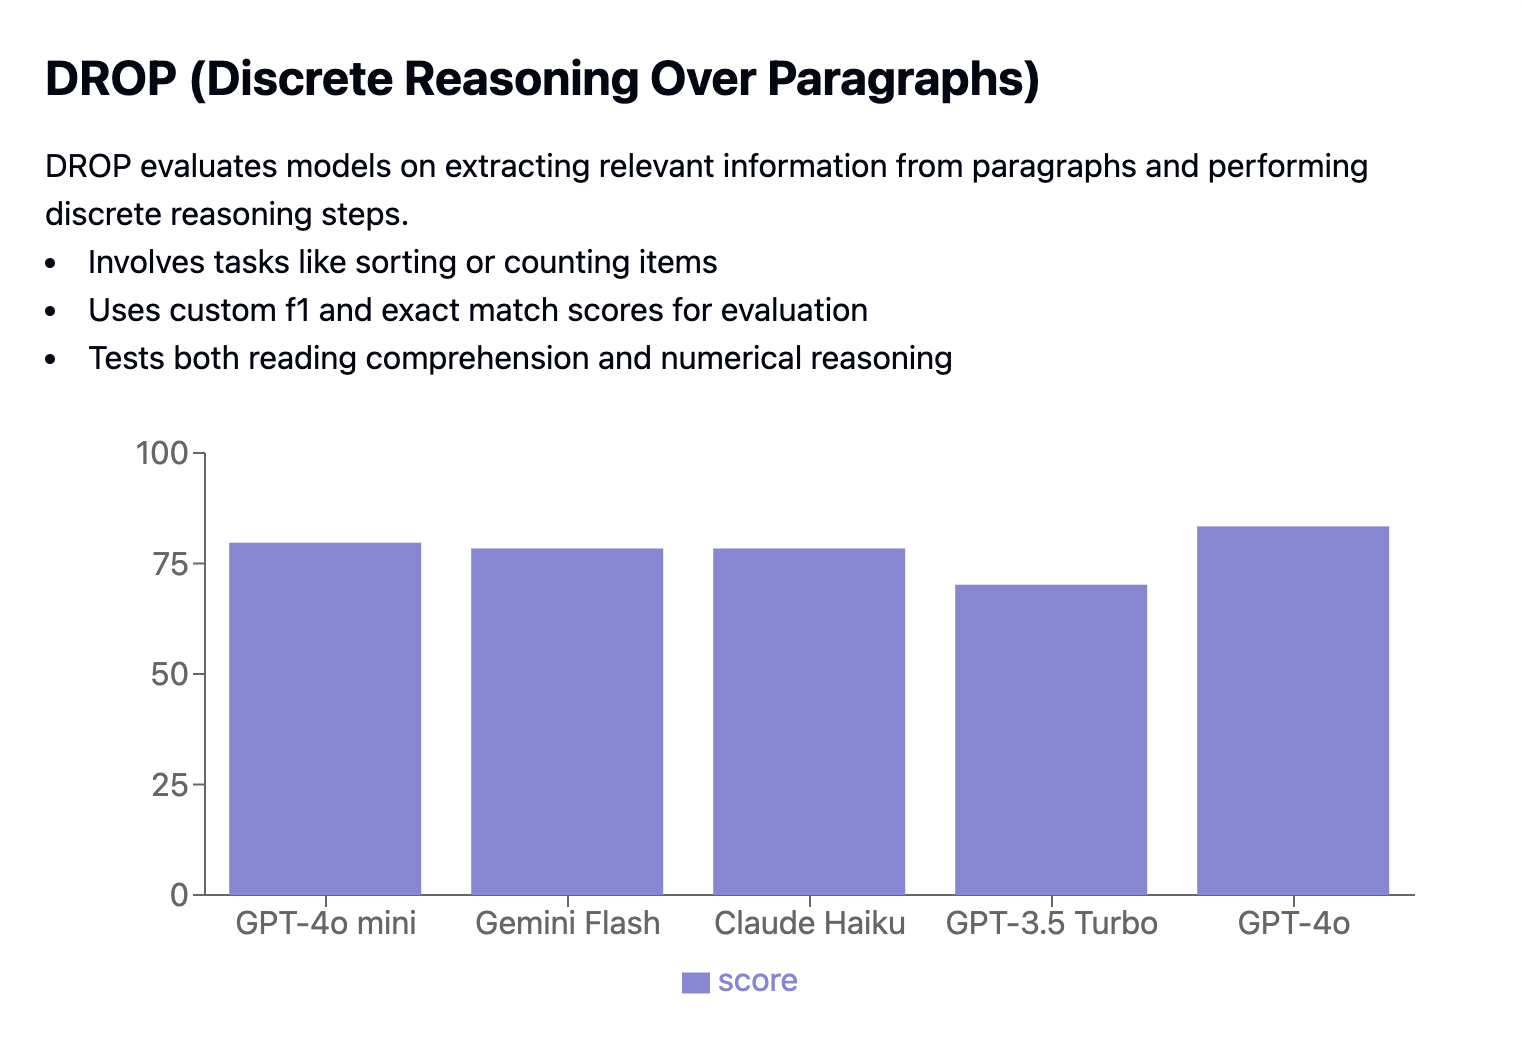
DROP (Discrete Reasoning Over Paragraphs) testa quanto bene i modelli sanno estrarre informazioni rilevanti dai paragrafi ed eseguire compiti di ragionamento come ordinamento o conteggio. Le prestazioni sono valutate con punteggi F1 personalizzati e corrispondenza esatta.
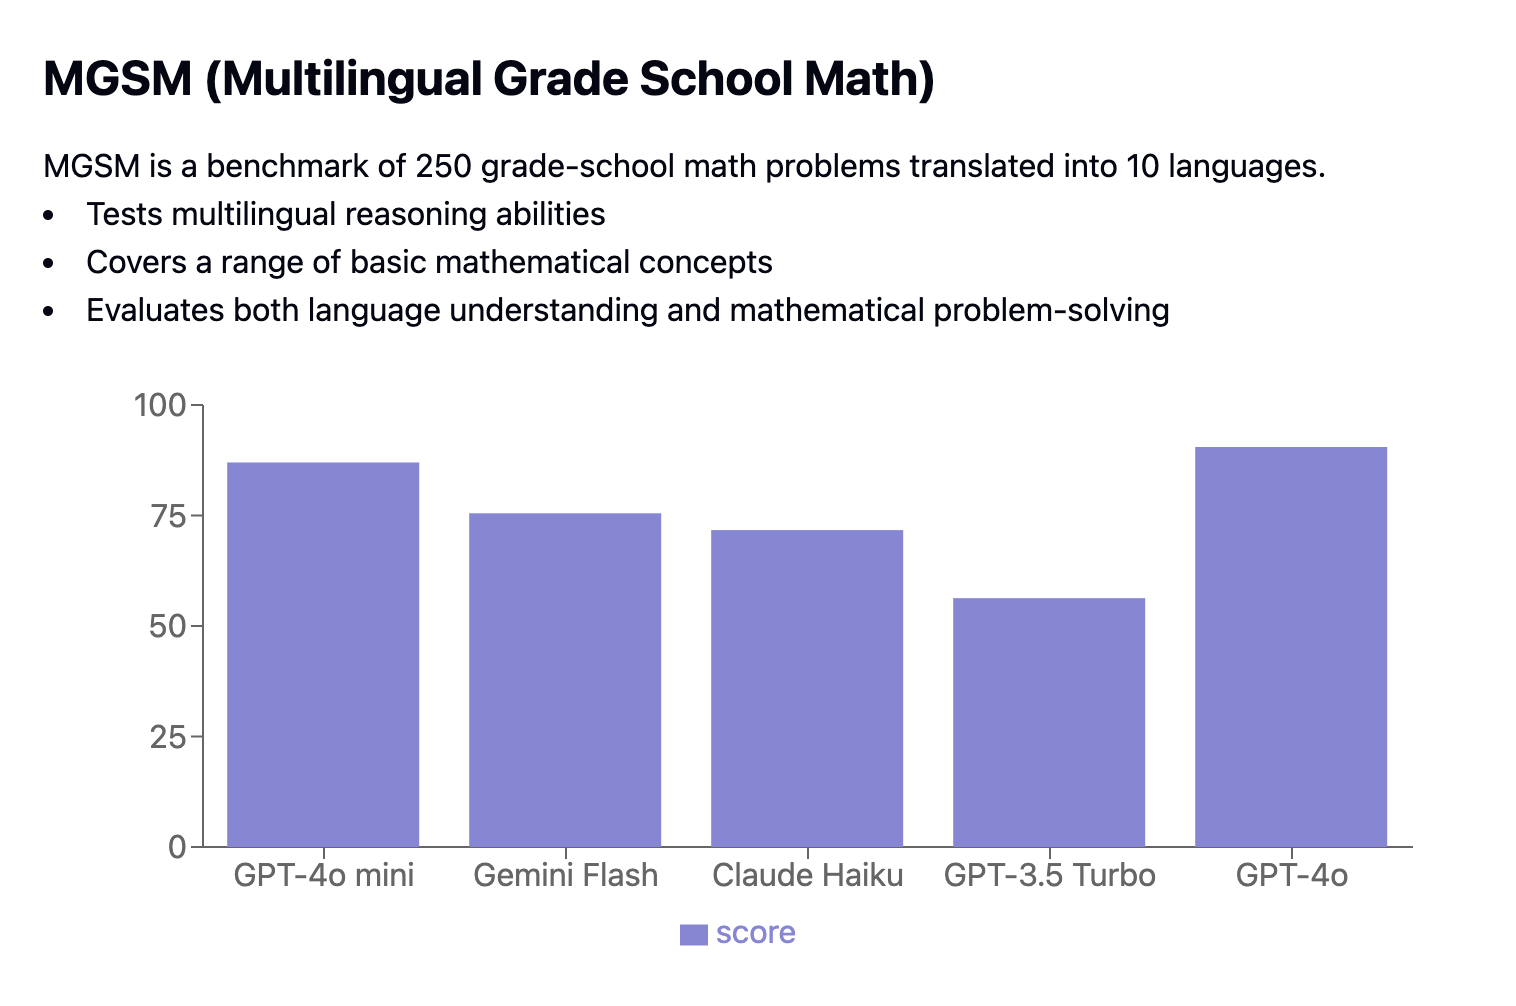
Il benchmark MGSM include 250 problemi di matematica a livello di scuola primaria tradotti in 10 lingue, testando le capacità di ragionamento multilingue.
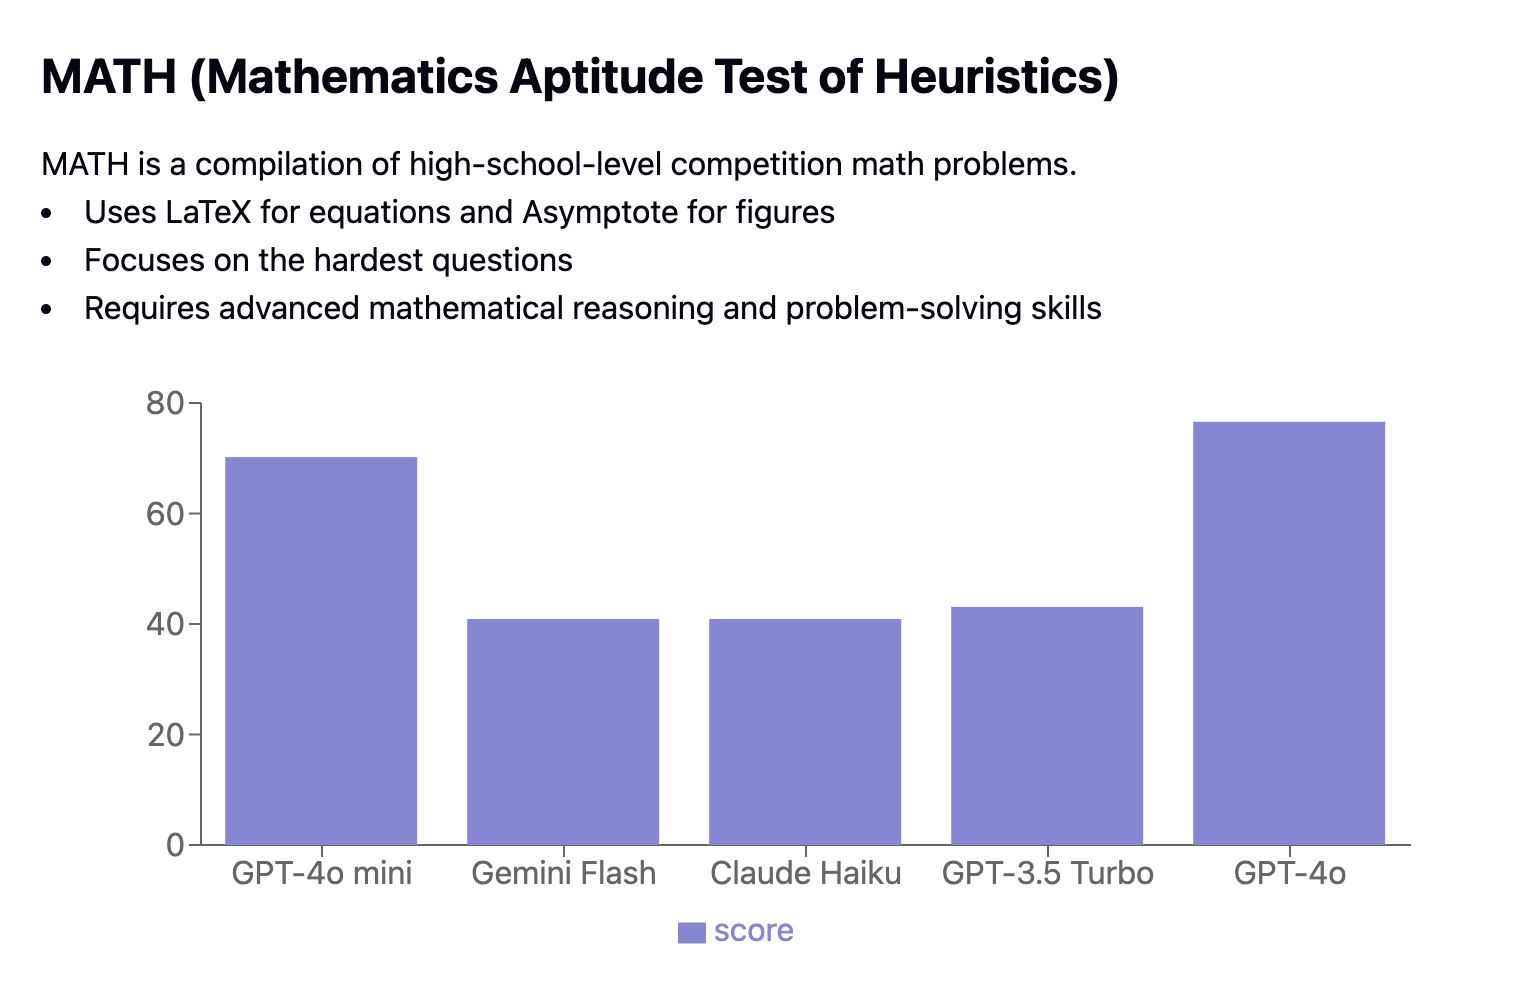
Il Mathematics Aptitude Test of Heuristics (MATH) presenta problemi da competizione a livello liceale. Valuta i modelli sulla loro capacità di risolvere problemi matematici complessi formattati in Latex e Asymptote, concentrandosi sulle domande più impegnative.
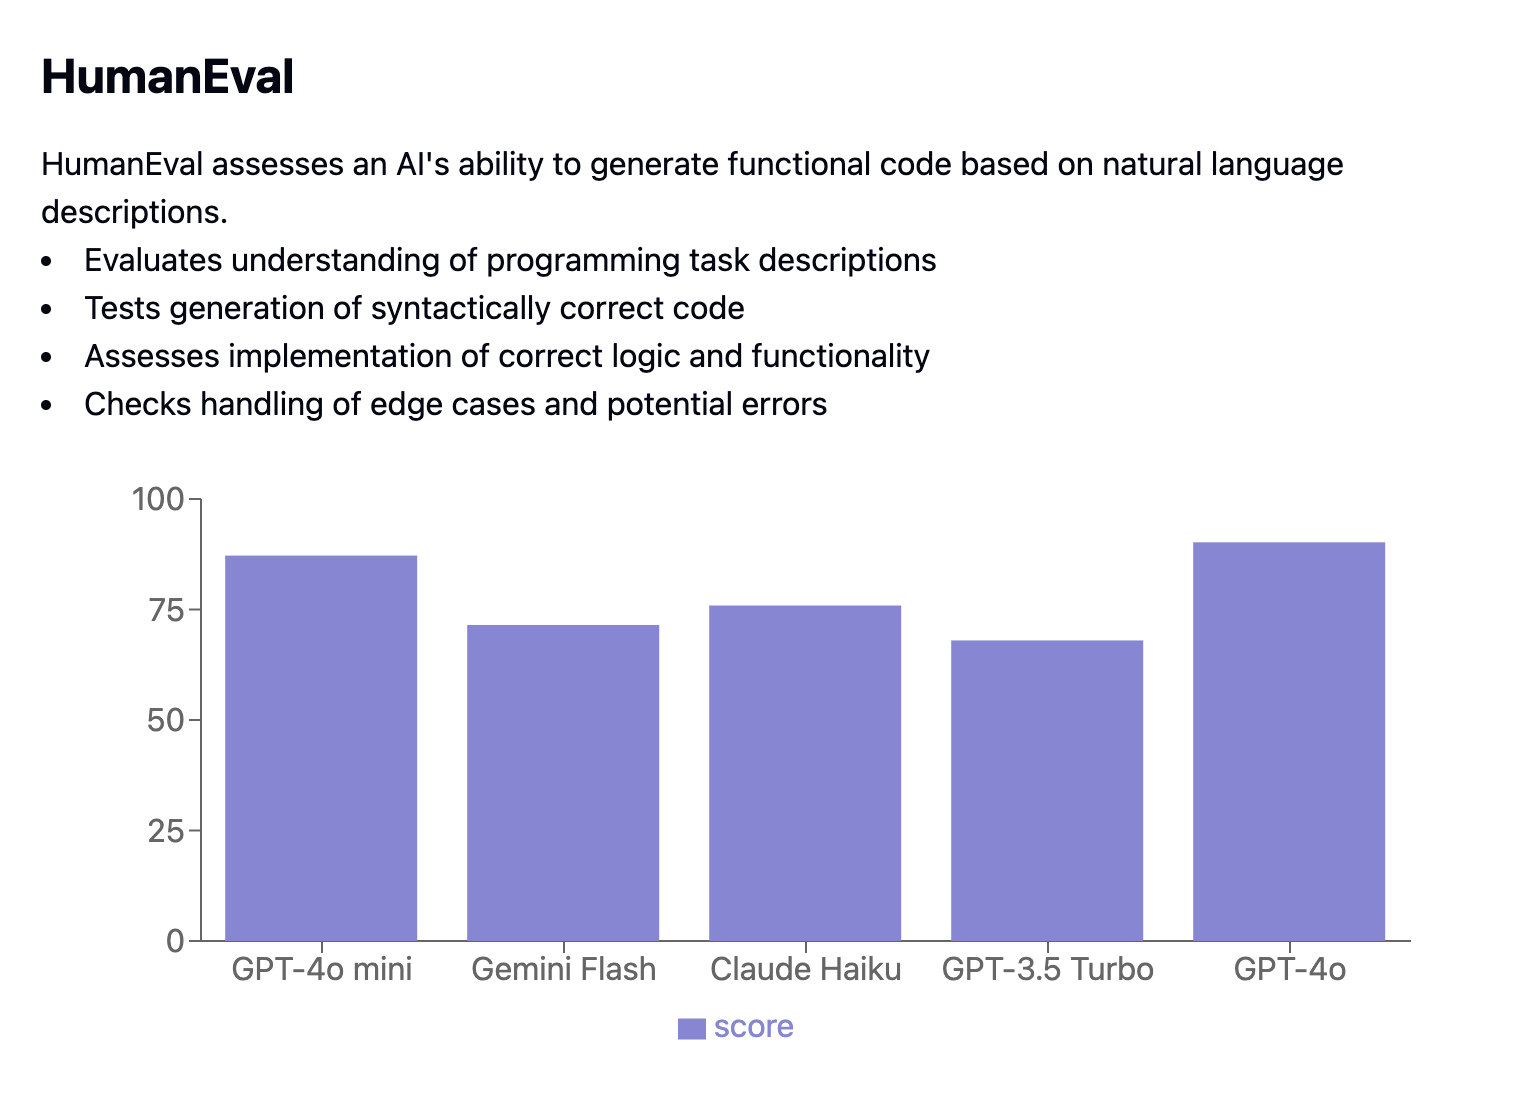
Il benchmark HumanEval misura le prestazioni nella generazione di codice valutando se il codice generato supera specifici unit test. Utilizza la metrica pass@k per determinare la probabilità che almeno una delle k soluzioni a un problema di coding superi i test.
Il benchmark Massive Multitask Language Understanding (MMLU) testa l'ampiezza delle conoscenze di un modello, la profondità della comprensione del linguaggio naturale e le capacità di problem solving. Presenta oltre 15.000 domande a scelta multipla che coprono 57 materie, dalla cultura generale a campi specialistici. MMLU valuta i modelli in modalità few-shot e zero-shot, misurando l'accuratezza tra le materie e facendo una media dei risultati per un punteggio finale.
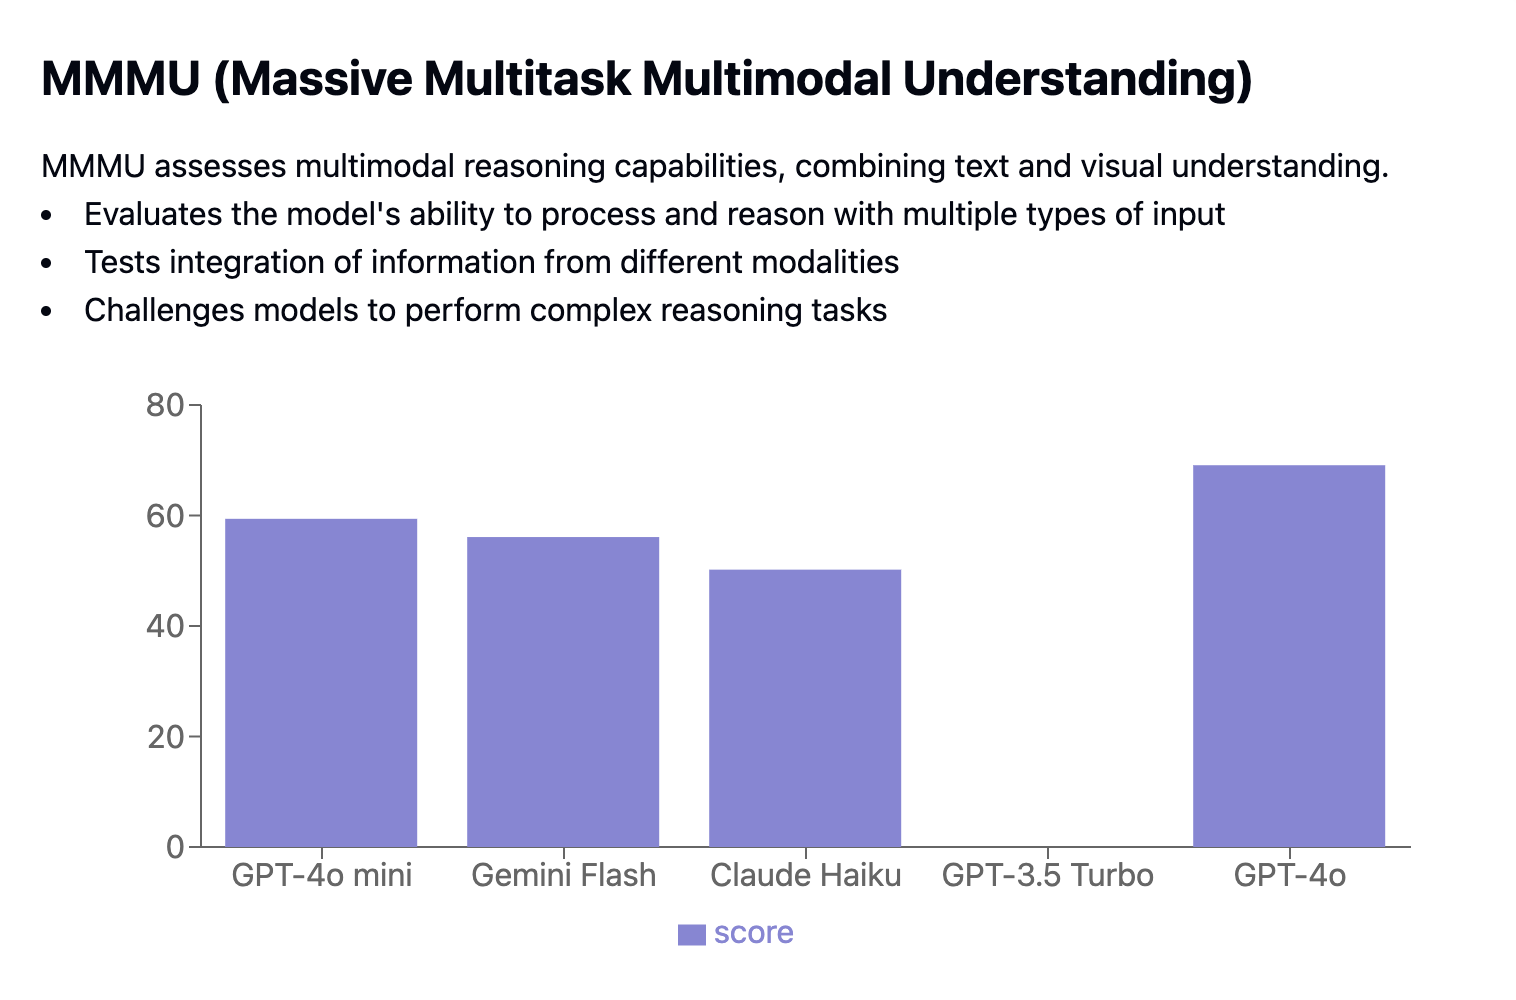
Il benchmark MathVista combina compiti matematici e visivi, con 6.141 esempi tratti da 28 dataset multimodali esistenti e 3 dataset creati ex novo (IQTest, FunctionQA e PaperQA). Mette alla prova i modelli con compiti che richiedono comprensione visiva avanzata e ragionamento composizionale complesso.
Le dimensioni ridotte, il basso costo e le buone prestazioni di GPT-4o mini lo rendono perfetto per l'uso su dispositivi personali, per prototipazione rapida e in contesti con risorse limitate. Inoltre, la sua capacità di risposta in tempo reale migliora le applicazioni interattive. Ecco come usare al meglio GPT-4o mini:
|
Categoria d'uso |
Vantaggi |
Applicazioni di esempio |
|
Le dimensioni ridotte consentono l'elaborazione locale su laptop, smartphone e server edge, riducendo la latenza e migliorando la privacy. |
App per l'apprendimento delle lingue, assistenti personali, strumenti di traduzione offline |
|
|
Prototipazione rapida |
Iterazioni più veloci e costi inferiori permettono sperimentazione e affinamento prima di passare a modelli più grandi. |
Test di nuove idee di chatbot, sviluppo di prototipi basati sull'IA, sperimentazione di diverse funzionalità di IA in modo economico |
|
Applicazioni in tempo reale |
Tempi di risposta rapidi migliorano le esperienze interattive. |
Chatbot, assistenti virtuali, traduzione linguistica in tempo reale, storytelling interattivo in giochi e realtà virtuale |
|
Uso educativo |
Economico e accessibile per le istituzioni educative, offrendo esperienza pratica con l'IA. |
Sistemi di tutoraggio basati sull'IA, piattaforme per l'apprendimento delle lingue, strumenti di pratica di coding |
Puoi usare GPT-4o Mini tramite la OpenAI API, che include opzioni come Assistants API, Chat Completions API e Batch API. Ecco una semplice guida su come usare GPT-4o Mini con l'API di OpenAI.
Per prima cosa dovrai autenticarti usando la tua chiave API: sostituisci your_api_key_here con la tua chiave API effettiva. Una volta configurato, puoi iniziare a generare testo con GPT-4o Mini:
from openai import OpenAI
MODEL="gpt-4o-mini"
## Set the API key
client = OpenAI(api_key="your_api_key_here")
completion = client.chat.completions.create(
  model=MODEL,
  messages=[
    {"role": "system", "content": "You are a helpful assistant that helps me with my math homework!"},
    {"role": "user", "content": "Hello! Could you solve 20 x 5?"}
  ]
)
Per maggiori dettagli sulla configurazione e l'uso dell'API di OpenAI, dai un'occhiata al tutorial sull'API GPT-4o.
Scopri di più su GPT!
Programma
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



