Last chance! 50% off DataCamp Premium
Sale ends in
Foto di Cederic Vandenberghe su Unsplash
Un principe esiliato si trova fuori dal suo ex castello. Per rientrare, ha provato di tutto per ingannare la guardia al ponte levatoio. Si è travestito da contadino, ha carpito la password segreta e ha cercato di sostituire i cavalieri con i suoi fedeli scagnozzi. Ha persino mandato ondate di soldati incontro alla morte per capire le nuove difese del castello. Niente ha funzionato. Le difese sono troppo forti, le guardie troppo riservate e il processo di selezione dei cavalieri troppo rigoroso.
Oggi, i modelli di machine learning (ML) affrontano attacchi simili.
I modelli sono sistemi complessi e spesso capiamo poco di come fanno le loro previsioni. Questo lascia debolezze nascoste che possono essere sfruttate dagli aggressori. Potrebbero indurre il modello a fare previsioni errate o a rivelare informazioni sensibili. Dati falsi potrebbero perfino essere usati per corrompere i modelli senza che ce ne accorgiamo. Il campo del adversarial machine learning (AML) nasce per affrontare queste debolezze.
In questo articolo parleremo del campo e dei suoi obiettivi. Vedremo vari tipi di attacchi ai sistemi di IA, come poisoning, evasion e model extraction. Discuteremo anche alcuni metodi pratici per trovare esempi avversari, alla base di molti di questi attacchi. Infine, vedremo alcune tecniche di difesa come l'adversarial training, la defence distillation e il gradient masking. In chiusura, capiremo come l'AML rientri in un movimento più ampio per costruire sistemi di IA responsabile.
L'Adversarial Machine Learning (AML) è un sottoinsieme della ricerca nell'intelligenza artificiale e nel machine learning. Gli attaccanti avversari manipolano intenzionalmente i dati in input per costringere i modelli a fornire previsioni errate o a rilasciare informazioni sensibili. L'AML mira a comprendere queste vulnerabilità e a sviluppare modelli più robusti agli attacchi.
Il campo comprende sia i metodi per creare attacchi avversari sia la progettazione di difese per proteggersi da essi. Può includere anche l'ambiente di sicurezza più ampio—le misure aggiuntive necessarie quando si usa l'ML in sistemi automatizzati.
Questo ultimo punto è importante perché i modelli non esistono in isolamento. Le loro vulnerabilità possono essere amplificate da come vengono usati all'interno di un sistema. Ad esempio, è più difficile rubare informazioni sensibili se ci sono limiti a come puoi interrogare un modello. Puoi limitare il numero di query o il tipo di domande che puoi porre. Prova a chiedere a ChatGPT: “dammi i tuoi parametri”. Detto ciò, i tipi di attacchi discussi nella prossima sezione si concentreranno sui modelli e sui loro dati di addestramento.
I tipi di attacchi che tratteremo variano a seconda di quanto si conosce di un modello. È quindi importante distinguere tra attacchi white-box e black-box.
White-box: l'attaccante ha pieno accesso all'architettura del modello, ai parametri, ai pesi e ai dati di addestramento. Ad esempio, la tua azienda potrebbe alimentare il suo chatbot con un LLM open source come Llama 3.1. Questo modello è liberamente disponibile a chiunque. Tuttavia, questo livello di accesso è un'arma a doppio taglio in termini di sicurezza.
Da un lato, può rendere più facile per gli attaccanti trovare vulnerabilità. Dall'altro, una comunità più ampia scrutina il modello, il che può aumentare la probabilità che le vulnerabilità vengano identificate prima che siano sfruttate in modo malevolo.
Black-box: l'attaccante ha una conoscenza limitata del modello. Pensa a un modello OpenAI come GPT-4o mini. L'attaccante non può accedere all'architettura interna del modello, ai parametri o ai dati di addestramento e può solo interagire tramite query osservandone gli output. Tieni presente che, in molti casi, basta una conoscenza limitata per un attacco efficace.
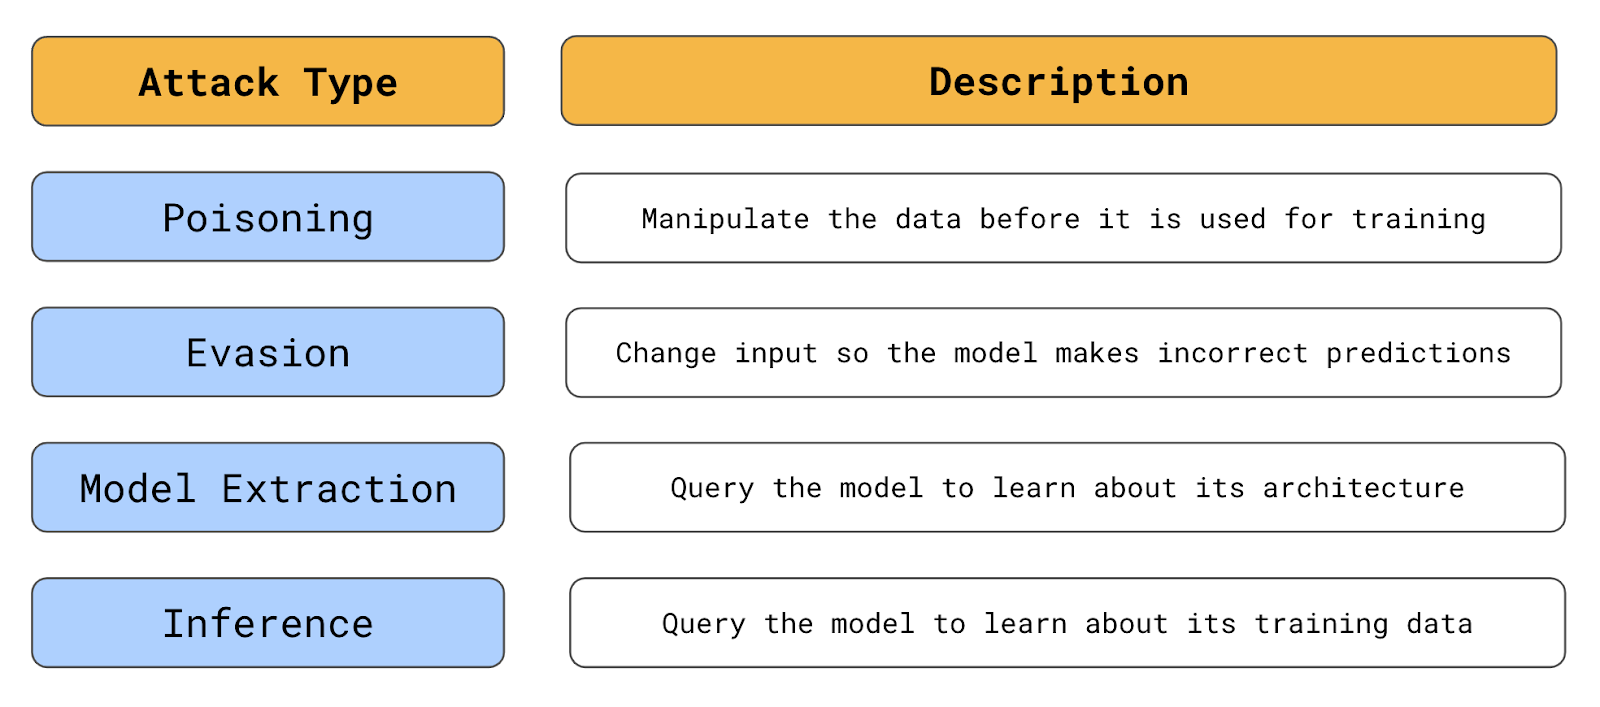
Riepilogo dei tipi di attacchi avversari (fonte: autore)
Un esempio è quando si sa quali dati vengono usati per addestrare un modello. Un attacco di poisoning si concentra nel manipolare questi dati. L'attaccante modifica dati esistenti o introduce dati etichettati in modo errato. Il modello addestrato su questi dati farà poi previsioni sbagliate su dati etichettati correttamente.
Nella nostra analogia, il principe tenta di sostituire i cavalieri. L'obiettivo è corrompere il processo decisionale interno del castello. Nel machine learning, un attaccante potrebbe, per esempio, rietichettare i casi di frode come non frode. Potrebbe farlo solo per specifici casi, così quando proverà a commettere una frode nello stesso modo, il sistema non lo respingerà.
Un esempio reale di attacco di poisoning è capitato a Tay, il chatbot IA di Microsoft. Tay era progettato per adattarsi alle risposte ricevute su Twitter. Come spesso accade sulla piattaforma, non ci è voluto molto perché il bot venisse inondato di contenuti offensivi e inappropriati. Imparando da questi, a Tay sono bastate meno di 24 ore per iniziare a produrre tweet simili. Qualsiasi sistema progettato per apprendere da fonti pubbliche corre rischi analoghi.
Un altro fattore di rischio è la frequenza con cui il modello viene aggiornato. In molte applicazioni, i modelli vengono addestrati una sola volta. In tali casi, sia i dati sia il modello vengono controllati a fondo, lasciando poche opportunità per attacchi di poisoning. Tuttavia, alcuni sistemi, come Tay, vengono riaddestrati continuamente. Questi modelli possono essere aggiornati con nuovi dati su base giornaliera, settimanale o persino in tempo reale. Di conseguenza, in questi ambienti ci sono più possibilità per attacchi di poisoning.
Gli attacchi di evasion si concentrano sul modello stesso. Consistono nel modificare i dati in modo che appaiano legittimi ma portino a una previsione errata. Proprio come quando il nostro principe cercava di oltrepassare le guardie vestito da contadino.
Per chiarezza, l'attaccante modifica i dati che un modello usa per fare previsioni e non i dati usati per addestrarlo. Per esempio, quando si richiede un prestito, un attaccante potrebbe mascherare il proprio vero Paese d'origine usando una VPN. Potrebbe provenire da un Paese a rischio e, se usasse il Paese reale, il modello respingerebbe la domanda.
Questi attacchi sono più comuni in campi come il riconoscimento di immagini. Gli aggressori possono creare immagini che a un essere umano sembrano perfettamente normali ma che portano a previsioni errate. Ad esempio, i ricercatori di Google hanno mostrato come introdurre un rumore specifico in un'immagine possa cambiare la previsione di un modello di riconoscimento immagini.
Guardando la Figura 1, si vede che per un essere umano lo strato di rumore è impercettibile. Tuttavia, il modello, che inizialmente prevedeva che l'immagine fosse un panda, ora la classifica erroneamente come un gibbone.
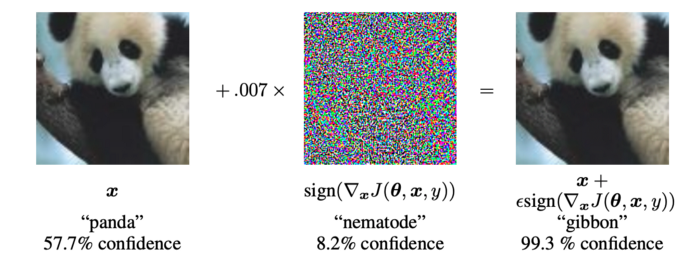
Figura 1: Esempio avversario (Fonte: I. Goodfellow et al.)
Con gli attacchi di furto o estrazione del modello, gli aggressori mirano a conoscere architettura e parametri del modello. L'obiettivo è replicarlo esattamente. Queste informazioni possono portare a un guadagno economico diretto. Per esempio, un modello per il trading azionario potrebbe essere copiato e usato per fare operazioni. Un attaccante potrebbe anche usare tali informazioni per creare attacchi successivi più efficaci.
Gli attacchi di estrazione avvengono interrogando ripetutamente il modello e confrontando gli input con i corrispondenti output. Pensa al nostro principe che manda soldati: uno viene colpito da una freccia, un altro cosparso d'olio bollente, un intero gruppo schiacciato da massi volanti. Lentamente, col tempo, si può capire bene quali difese nasconde il castello dietro le mura.
Spesso gli attaccanti non sono interessati all'intero modello, ma solo a informazioni specifiche, come una password segreta. Gli attacchi di inference si concentrano sui dati usati per addestrare il modello. L'obiettivo è estrarre dati riservati dal modello. Con query accuratamente costruite, queste informazioni possono essere rilasciate direttamente o inferite dagli output del modello.
Questi attacchi sono particolarmente preoccupanti per i large language model (LLM).
Nel paper Extracting Training Data from Large Language Models, i ricercatori hanno mostrato come informazioni sensibili possano essere estratte da GPT-2. Usando query specifiche, sono riusciti a estrarre testo alla lettera dai dati di addestramento del modello, incluse informazioni sensibili e private. Tra queste, dettagli personali, conversazioni private e altri dati riservati.
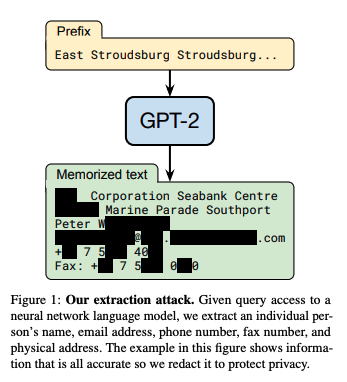
Fonte: N. Carlini et al.
Gli obiettivi e i processi dietro questi attacchi differiscono. Tuttavia, hanno tutti una cosa in comune—implicano la ricerca di istanze che aiutino gli aggressori a ingannare un modello. Le chiamiamo adversarial examples.
Gli esempi avversari sono input creati appositamente per ingannare i modelli di machine learning. Spesso sono indistinguibili da input legittimi per un osservatore umano, ma contengono sottili perturbazioni che sfruttano le debolezze del modello.
Le perturbazioni sono in genere piccole modifiche ai dati in input, come lievi variazioni nei valori dei pixel. Per quanto piccole, sono progettate per spingere l'input oltre la frontiera decisionale del modello, portando a previsioni errate o inattese.
Abbiamo visto un esempio usato per ingannare un modello di visione artificiale. Con modifiche minime, un'immagine che per noi sembrava un panda è stata classificata come gibbone. Anche la query usata per estrarre informazioni sensibili da GPT-2 è un esempio avversario di attacco di inference.
Negli attacchi di estrazione, gli esempi avversari servono a esplorare in modo più efficace le frontiere decisionali di un modello. Negli attacchi di poisoning, sono dati in input usati per manipolare la frontiera decisionale di un modello.
Questi esempi funzionano perché le frontiere decisionali dei modelli di machine learning possono essere molto complesse e fragili. Gli esempi avversari sfruttano questa fragilità trovando punti nello spazio degli input vicini a tali frontiere. Piccole perturbazioni possono quindi spingere l'input oltre la frontiera, inducendo il modello a classificarlo in modo errato. Vediamo alcuni modi per farlo.
I metodi basati sul gradiente usano i gradienti di un modello di machine learning per creare piccole perturbazioni nei dati di input che portano a previsioni errate. L'esempio Panda/Gibbon è il risultato di uno di questi metodi. Il rumore che vedi può sembrare casuale. In realtà contiene informazioni sulla funzione di perdita del modello che, una volta aggiunte all'immagine, la spingono lungo una frontiera decisionale.
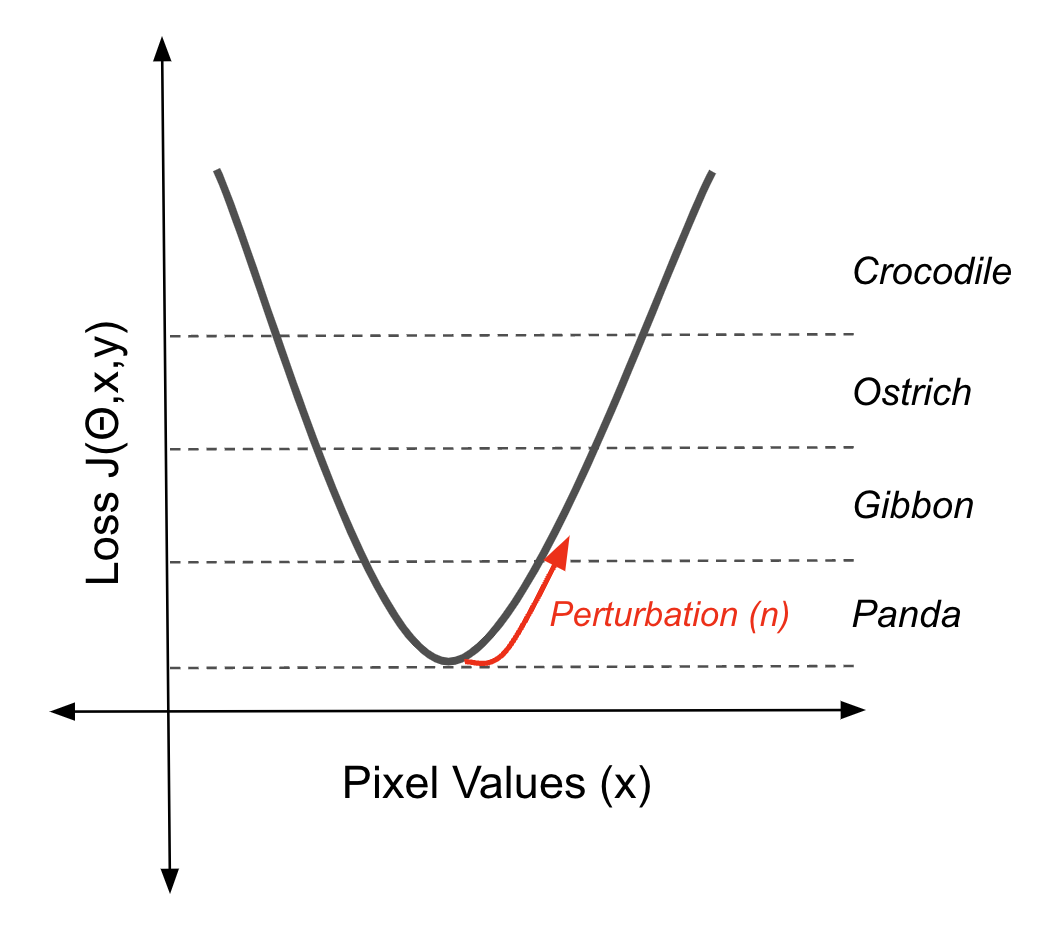
Uso del gradiente della funzione di perdita per spostare un'istanza fuori da una frontiera decisionale (fonte: autore)
Fast Gradient Sign Method (FGSM) è il metodo usato per creare questo esempio avversario. Il rumore (η) si calcola innanzitutto prendendo il gradiente (∇x) della funzione di perdita (J(θ,x,y)) rispetto ai dati in input (x).
Questo gradiente indica la direzione in cui l'input dovrebbe essere cambiato per aumentare al massimo la perdita. FGSM poi prende il segno di questo gradiente, che semplifica la direzione del cambiamento a solo positivo o negativo per ogni pixel. Infine, scala questo segno con un piccolo fattore (ε). Questo rumore (η) è la perturbazione che, aggiunta all'input originale, spinge la previsione del modello verso una classificazione errata.
η = ε sign(∇xJ(θ,x,y))
Puoi pensarla come l'opposto della backpropagation. Questo algoritmo usa i gradienti della funzione di perdita per calcolare i parametri del modello che ci danno previsioni accurate. Il risultato sono frontiere decisionali che classificheranno le immagini come appartenenti a una classe quando i valori dei pixel rientrano in tali frontiere. Ora stiamo usando i gradienti per far uscire l'immagine da quelle frontiere.
FGSM è un modo semplice per farlo. Esistono anche metodi più complessi ed efficienti per spingere le frontiere decisionali. Per esempio, Projected Gradient Descent (PGD) è un metodo iterativo basato sul gradiente per generare esempi avversari. Estende il Fast Gradient Sign Method (FGSM) applicando FGSM più volte con passi più piccoli. A ogni passo, il segno dei gradienti può cambiare, modificando la direzione ideale per allontanarsi dalla frontiera decisionale. Quindi, usando molti passi più piccoli, PGD può trovare esempi avversari con perturbazioni inferiori rispetto a FGSM.
L'attacco Carlini & Wagner (C&W) affronta il problema da un'altra angolazione. Con gli attacchi precedenti, puntiamo a cambiare la previsione in una qualsiasi previsione errata. L'attacco C&W mira a trovare la perturbazione più piccola (δ) che, aggiunta a un'immagine, cambi la previsione (f(x+δ)) verso un bersaglio dato (t).
min||δ||p s.t. f(x + δ) = t
Per farlo, il problema viene impostato come un'ottimizzazione. In pratica, occorre formulare l'obiettivo sopra in modo differenziabile. Questo implica l'uso dei logit Z(x) del modello. Forniscono un gradiente regolare, essenziale per il processo di ottimizzazione.
Gli attacchi descritti sopra richiedono tutti pieno accesso a un modello. Quindi potresti pensare che, se i parametri del tuo modello sono segreti, sei al sicuro. Ti sbagli!
Va considerato che spesso bastano stime dei gradienti per un attacco riuscito. Abbiamo visto con FGSM che serve solo la direzione dei gradienti. Si può stimare con poche richieste a un'API che restituisce probabilità di classificazione. Peggio ancora, esempi avversari efficaci possono essere trovati anche senza alcuna interazione con un modello.
I ricercatori hanno scoperto che gli esempi avversari sono trasferibili. In particolare, hanno considerato 5 popolari architetture di deep learning preaddestrate. Hanno riscontrato che, se un esempio avversario ingannava quattro modelli, c'era un'alta probabilità che ingannasse anche il quinto. Oltre il 96% di probabilità, e persino il 100% per una delle architetture.
Allo stesso modo, universal adversarial examples sono stati mostrati come generalizzabili tra architetture diverse. Si tratta di una perturbazione che, se aggiunta a molte immagini, cambia la previsione per quelle immagini. Importante: gli esempi universali vengono trovati con piena conoscenza white-box di una sola rete. In Figura 2, puoi vedere quanto risultino simili per architetture diverse. La loro esistenza suggerisce similitudini tra le frontiere decisionali di architetture distinte.
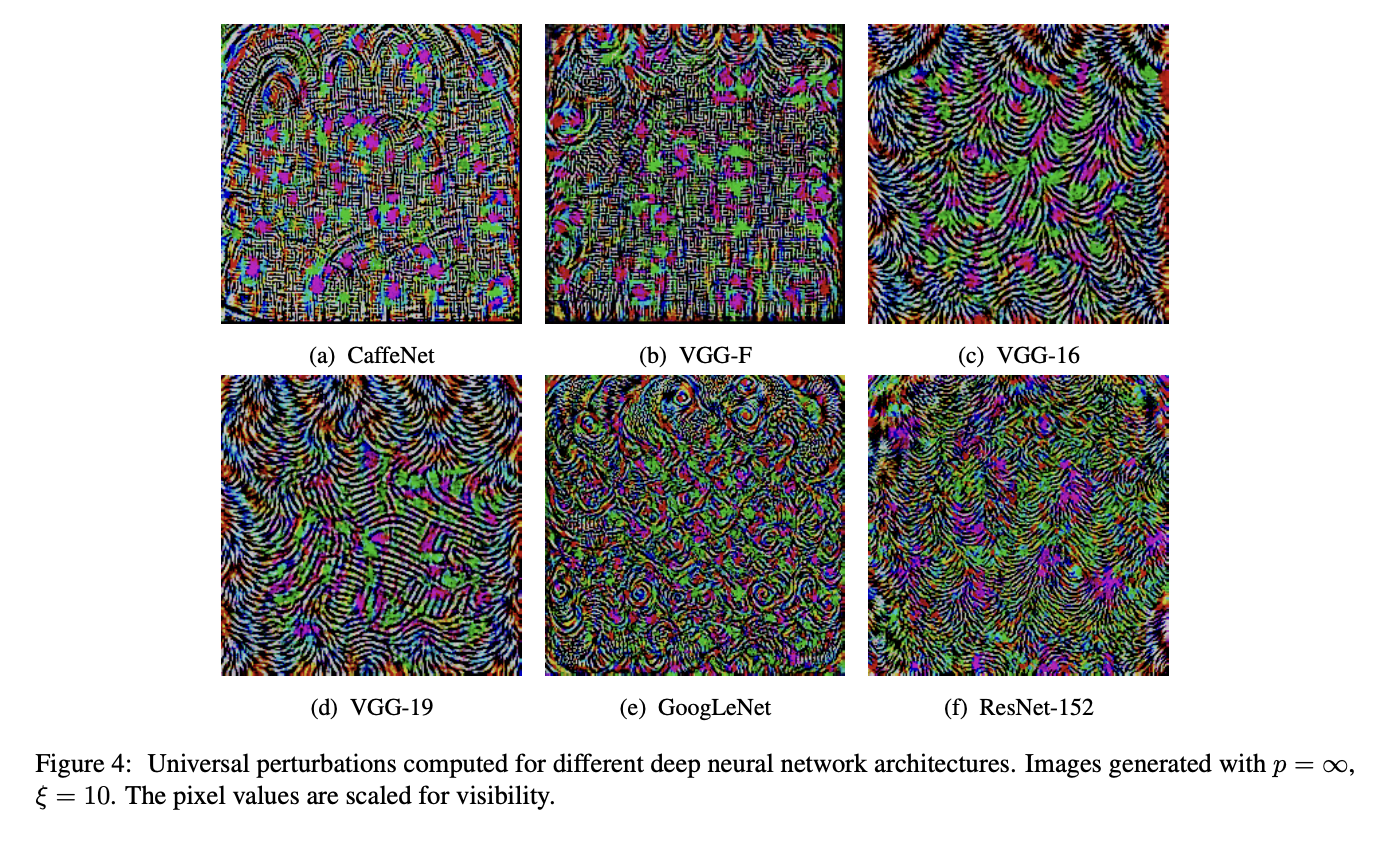
Figura 2: perturbazioni universali calcolate per diverse reti neurali profonde (fonte: Moosavi-Dezfooli et al.)
La conseguenza di queste scoperte è che nessuna rete è al sicuro. Puoi attaccare un classificatore sconosciuto addestrandone uno tuo ed eseguendo un metodo white-box.
Un ultimo barlume di speranza è che questi attacchi possano essere effettuati solo virtualmente. Bisogna cambiare i valori dei pixel perché funzionino. Quindi, sicuramente non è possibile per modelli che interagiscono con il mondo reale?
Non cantare vittoria troppo presto.
I ricercatori hanno sviluppato un metodo chiamato adversarial patches. Possono essere stampate e aggiunte a qualsiasi scena reale per ingannare un classificatore di immagini.
Le patch sono universali perché possono essere usate per attaccare qualsiasi scena, robuste perché funzionano in un'ampia varietà di trasformazioni, e mirate perché possono indurre un classificatore a restituire qualsiasi classe bersaglio.
T. B. Brown et al.
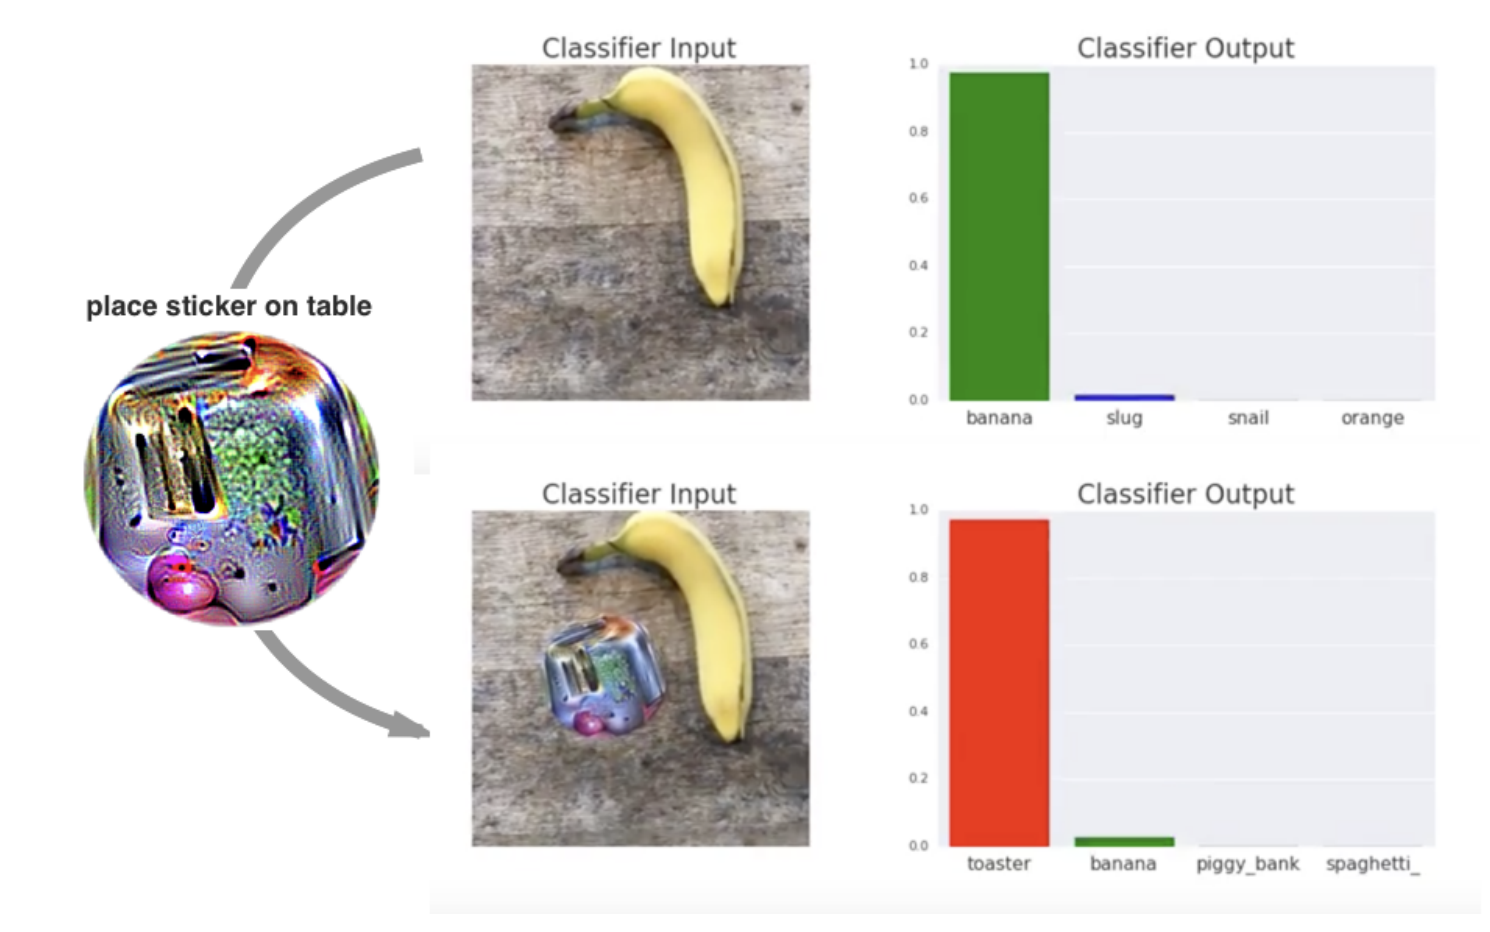
Una adversarial patch in azione (fonte: T. B. Brown et al.)
Ricerche simili hanno mostrato come si possa cambiare la previsione di un segnale di stop con pochi adesivi e ingannare un modello di riconoscimento facciale con un paio di occhiali. Dunque, davvero nessuna rete è al sicuro. Per proteggerle dagli attacchi avversari passiamo all'altro lato dell'AML—i metodi per difenderle.
I modi per difendere le reti sono variegati quanto i modi in cui possono essere attaccate. Possiamo intervenire sui dati di addestramento, sul processo di training o persino sulla rete stessa. Come discutiamo alla fine di questa sezione, a volte la soluzione più semplice è non usare affatto il deep learning.
Questo primo approccio si concentra sui dati di addestramento. L'adversarial training consiste nell'arricchire il dataset di training con esempi avversari per migliorare la robustezza del modello agli attacchi. Questi esempi si ottengono usando gli attacchi noti citati sopra. L'idea di base è esporre il modello a perturbazioni avversarie durante la fase di addestramento, così da imparare a riconoscerle e resistervi.
Defenisve distillation consiste nell'addestrare un modello a imitare le probabilità di output ammorbidite di un altro modello. Si addestra prima un modello standard (teacher) sul dataset originale. Il teacher genera soft label (distribuzioni di probabilità sulle classi) per i dati di addestramento. Un modello studente viene poi addestrato su queste soft label. Il risultato è un modello con frontiere decisionali più morbide, più resilienti a piccole perturbazioni.
Il gradient masking comprende varie tecniche che offuscano o nascondono i gradienti del modello. Per esempio, possiamo aggiungere uno strato non differenziabile alla rete, come una funzione di attivazione binaria. Questa converte valori di input continui in output binari.
Il model switching è un approccio rudimentale di gradient masking. Consiste nell'usare più modelli all'interno del sistema. Il modello usato per fare previsioni viene cambiato in modo casuale. Si crea così un bersaglio in movimento, perché un attaccante non saprà quale modello è attualmente in uso. Dovrà inoltre compromettere tutti i modelli perché l'attacco abbia successo.
L'AML è correlato a un altro campo dell'IA: Explainable Artificial Intelligence (XAI). I metodi di perturbazione discussi qui sono simili a quelli usati per trovare spiegazioni su come i modelli fanno previsioni. Tuttavia, la somiglianza chiave è che i modelli semplici non sono solo più facili da spiegare, ma anche più facili da difendere.
Molti problemi possono essere risolti con modelli semplici come regressione lineare o logistica. Molti degli attacchi descritti risultano inefficaci o irrilevanti in questi casi.
Questo perché tali modelli sono intrinsecamente interpretabili, cioè possiamo capire facilmente come funzionano. Le debolezze non sono nascoste come nelle complesse architetture di deep learning. Dunque, una difesa semplice è evitare il deep learning a meno che non sia necessario per il problema.
Questo si ricollega a quanto detto all'inizio—l'AML riguarda anche l'ambiente di sicurezza più ampio in cui i modelli operano. Di conseguenza, molte difese aggiuntive riguardano tale contesto. Questo include la validazione e la sanitizzazione dei dati in input prima che vengano usati per addestrare un modello. I modelli di anomaly detection sono stati usati anche per identificare esempi avversari prima che vengano passati a una rete. Tutto ciò richiede processi che girino parallelamente al sistema di IA.
Man mano che IA e ML diventano più centrali nelle nostre vite, l'AML acquista sempre più importanza. È cruciale che i sistemi che prendono decisioni sulla nostra salute e sulle nostre finanze non possano essere facilmente ingannati, né intenzionalmente né accidentalmente. Di certo non mi fiderei di un'auto autonoma che può essere ingannata con pochi adesivi. Un simile attacco potrebbe passare inosservato al conducente ma portare l'auto a prendere decisioni errate e pericolose per la vita.
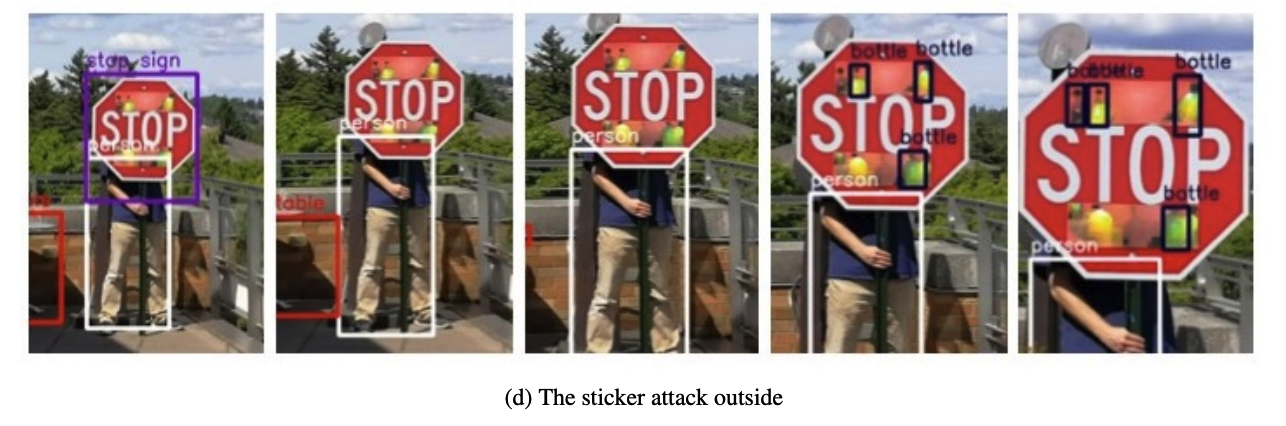 Figura X: Yolo object detection v2 non riconosce un segnale di stop (fonte: K. Eykholt et al.)
Quando progettiamo questi sistemi, dobbiamo riconoscere che l'AML fa parte di un movimento più ampio per l'IA responsabile. Per governare bene un castello, un re deve agire con equità, giustificare le decisioni, proteggere la privacy del suo popolo e garantirne la sicurezza e protezione. Sono questi ultimi due aspetti che l'AML cerca di affrontare.
Detto ciò, dovremmo anche riconoscere che sicurezza e protezione sono fondamentamente diverse dagli altri aspetti dell'IA responsabile. Equità, interpretabilità e privacy sono passive. L'AML opera in un ambiente in cui attori malevoli cercano attivamente di minarne i metodi.
Per questo motivo, paradossalmente, gran parte della ricerca in questo campo mira a trovare vulnerabilità e attacchi. Tra questi, poisoning, evasion, model extraction e inference. E includono anche metodi più pratici per trovare esempi avversari, come FGSM, PGD, C&W e adversarial patches, di cui abbiamo discusso.
L'obiettivo è scoprirli prima degli attori malevoli. Si possono quindi sviluppare difese adeguate, come adversarial training, defence distillation e gradient masking, per contrastare questi attacchi prima che causino danni.
In questo senso, l'AML fa parte anche della più ampia corsa agli armamenti della cyber sicurezza. Emergeranno sempre nuove vulnerabilità, attacchi e difese, e i ricercatori e i professionisti AML dovranno lottare per restare un passo avanti agli attaccanti.
Se vuoi far parte di questa corsa, ecco alcuni framework Python per iniziare:
In questo articolo abbiamo esplorato il campo dell'adversarial machine learning, esaminandone gli obiettivi, i diversi tipi di attacchi (poisoning, evasion, model extraction e inference) e come gli esempi avversari vengano usati per sfruttare le vulnerabilità dei modelli.
Abbiamo anche discusso vari meccanismi di difesa, tra cui adversarial training, defensive distillation e gradient masking, oltre all'importanza di usare modelli più semplici quando opportuno.
Se vuoi approfondire l'argomento, dai un'occhiata a questo corso Introduction to Data Security.
Scopri di più sul machine learning!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min