
Qu'est-ce que GPT-4o mini ?
GPT-4o mini est dérivé du modèle GPT-4o, plus volumineux, via un processus de distillation. Il s'agit d'entraîner un modèle plus petit à imiter le comportement et les performances du modèle d'origine, plus complexe, afin d'obtenir une version très capable mais bien plus économique.
Fonctionnalités clés
- Grande fenêtre de contexte : GPT-4o mini conserve la fenêtre de 128 k tokens de GPT-4o, ce qui lui permet de traiter efficacement de longs textes. Idéal pour analyser de gros documents ou maintenir l'historique d'une conversation.
- Capacités multimodales : le modèle traite les entrées texte et image, avec un support vidéo et audio prévu à l'avenir (en entrée et en sortie). Cette polyvalence convient à de nombreux cas d'usage, de l'analyse de texte à la reconnaissance d'images.
- Coût réduit : GPT-4o mini est nettement plus abordable que ses prédécesseurs. Il coûte 0,15 $ par million de tokens en entrée et 0,60 $ par million de tokens en sortie, contre 5,00 $ et 15,00 $ pour GPT-4o. Par rapport à GPT-3.5 Turbo, GPT-4o mini est plus de 60 % moins cher.
- Sécurité renforcée : le modèle embarque les mêmes mécanismes de sécurité que GPT-4o et c'est le premier de l'API à utiliser la méthode d'hiérarchie des instructions. Il résiste mieux aux jailbreaks, aux attaques par injection de prompts et à l'extraction du prompt système, ce qui en renforce la sûreté d'usage.
La concurrence de GPT-4o mini
GPT-4o mini se mesure à des modèles comme Llama 3 8B, Gemini 1.5 Flash et Claude Haiku, ainsi que GPT-3.5 Turbo d'OpenAI. Ces modèles offrent des fonctionnalités proches, mais souvent à un coût supérieur ou avec des performances moins avancées.
- Gemini 1.5 Flash : bien que Gemini 1.5 Flash affiche une vitesse de sortie légèrement supérieure, GPT-4o mini se distingue par sa qualité, ce qui en fait un choix plus équilibré quand il faut allier vitesse et précision.
- Claude 3 Haiku et Llama 3 (8B) : GPT-4o mini dépasse ces modèles en qualité comme en vitesse de génération, démontrant son efficacité.
- GPT-3.5 Turbo : GPT-4o mini surpasse GPT-3.5 Turbo en vitesse de sortie et en qualité globale, et propose des capacités de vision dont GPT-3.5 Turbo ne dispose pas.
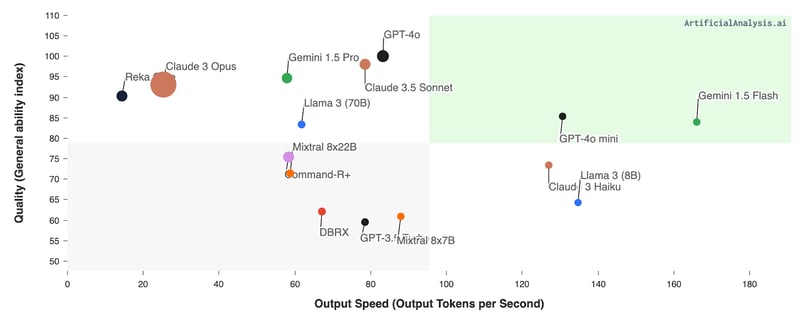
Source : Artificial Analysis
Comment fonctionne GPT-4o mini : les mécanismes de la distillation
GPT-4o mini atteint son équilibre entre performance et efficience grâce à un processus appelé distillation de modèle. Concrètement, il s'agit d'entraîner un modèle plus petit et plus épuré (l'« élève ») à reproduire le comportement et les connaissances d'un modèle plus grand et plus complexe (le « professeur »).
Le grand modèle, ici GPT-4o, a été pré-entraîné sur d'immenses volumes de données et possède une compréhension fine des structures linguistiques, de la sémantique et même des capacités de raisonnement. Mais sa taille le rend coûteux en calcul et moins adapté à certains usages.
La distillation permet de transférer les connaissances et capacités du grand GPT-4o vers le plus petit GPT-4o mini. Le plus souvent, on entraîne le modèle réduit à prédire les sorties du modèle maître sur un ensemble varié d'entrées. Ce faisant, GPT-4o mini « distille » l'essentiel des savoirs et compétences de son homologue plus grand.
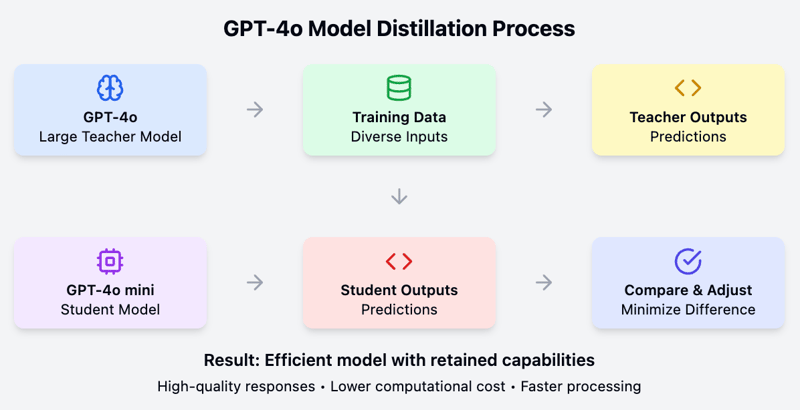
On obtient ainsi un modèle plus compact et plus efficient, qui conserve une grande partie des performances et capacités de l'original. GPT-4o mini gère des tâches linguistiques complexes, comprend le contexte et génère des réponses de grande qualité, tout en consommant moins de ressources de calcul. C'est une solution pratique et abordable pour de nombreux scénarios, en particulier quand vitesse et coût sont déterminants.
Performances de GPT-4o mini
GPT-4o mini affiche des performances remarquables sur divers benchmarks. J'ai créé des Claude Artifacts pour expliquer chaque benchmark LLM et ce qu'il mesure.
Tâches de raisonnement
Pour les tâches de raisonnement, nous avons évalué GPT-4o mini sur les éléments suivants :
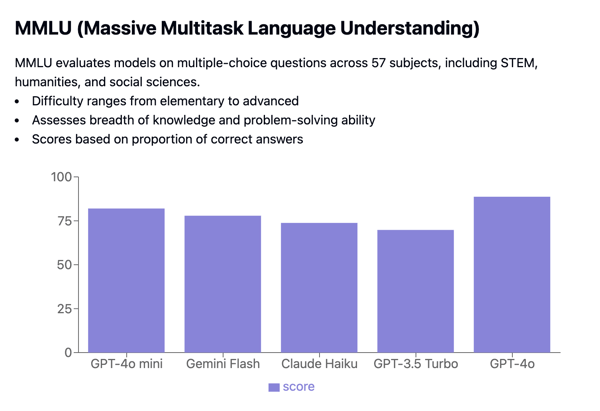
MMLU (Massive Multitask Language Understanding) est un benchmark qui évalue les modèles via des QCM couvrant 57 disciplines, des STEM aux sciences humaines et sociales. Les questions vont du niveau basique à avancé. Il mesure le taux de réponses correctes avec correspondance exacte. GPT-4o mini a obtenu 82,0 %, surpassant des concurrents comme Gemini Flash (77,9 %) et Claude Haiku (73,8 %).
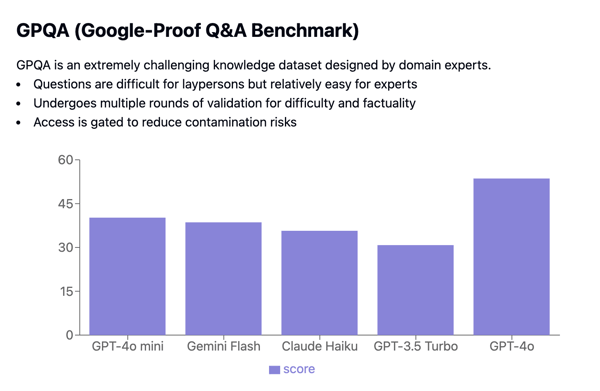
GPQA (Google-Proof Q&A Benchmark) est un jeu de données exigeant, avec des questions rédigées par des experts pour mettre en difficulté les non-spécialistes tout en restant abordables pour des spécialistes. Les questions sont rigoureusement validées pour la difficulté et l'exactitude via plusieurs itérations afin de réduire les risques de contamination.
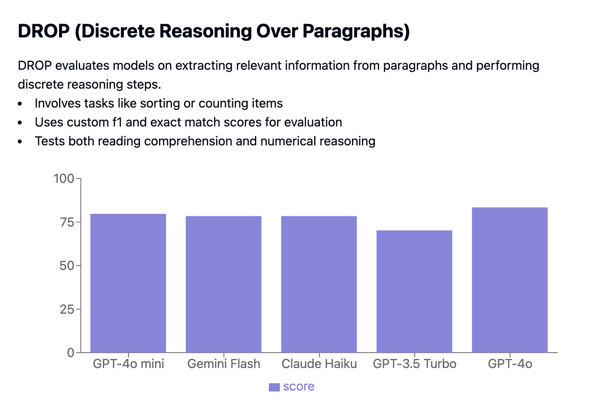
DROP (Discrete Reasoning Over Paragraphs) mesure la capacité des modèles à extraire des informations pertinentes de paragraphes et à effectuer des raisonnements comme trier ou compter. Les performances sont évaluées avec des scores F1 et exact match personnalisés.
Mathématiques et code
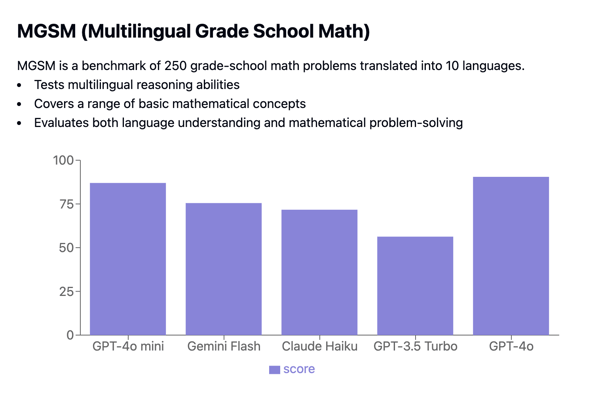
Le benchmark MGSM comprend 250 problèmes de mathématiques de niveau primaire traduits en 10 langues, pour évaluer le raisonnement multilingue.
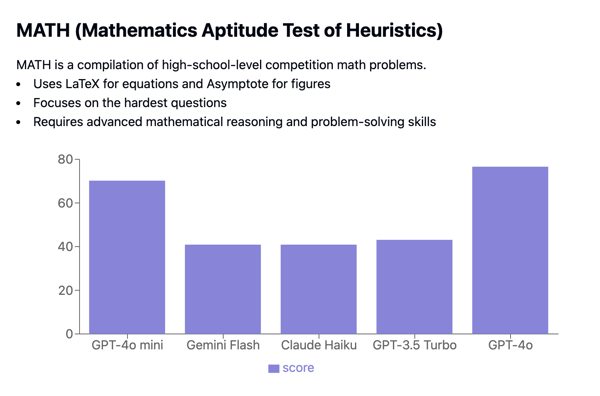
Le Mathematics Aptitude Test of Heuristics (MATH) regroupe des problèmes de concours de niveau lycée. Il évalue la capacité des modèles à résoudre des problèmes complexes formatés en LaTeX et Asymptote, en se concentrant sur les questions les plus ardues.
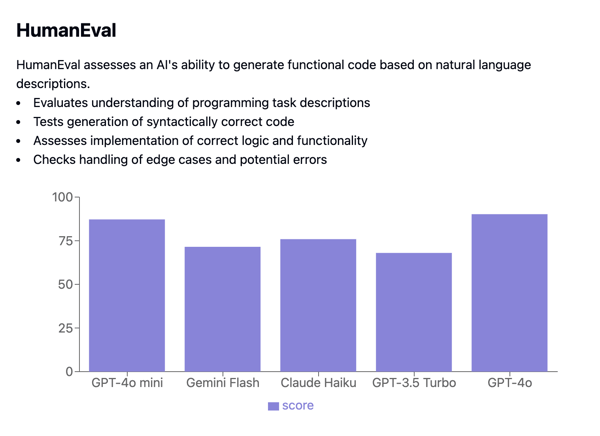
Le benchmark HumanEval mesure la génération de code en vérifiant si le code produit réussit des tests unitaires définis. Il utilise la métrique pass@k, qui estime la probabilité qu'au moins une des k solutions proposées pour un problème passe les tests.
Raisonnement multimodal
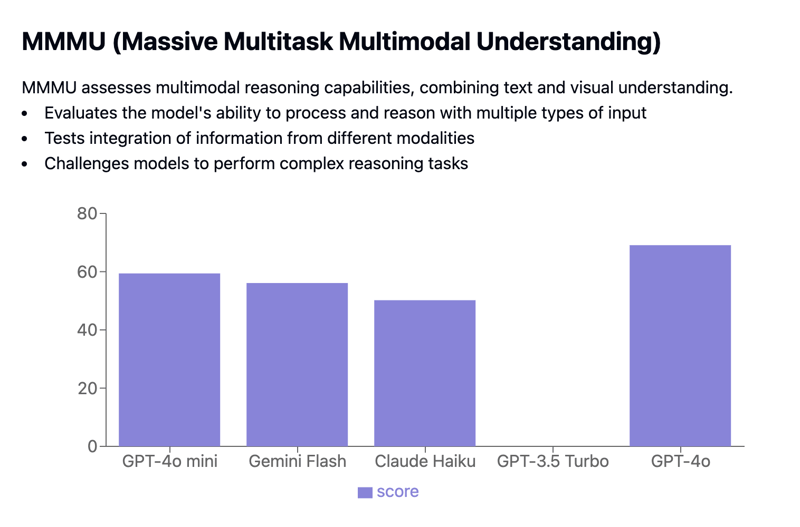
Le benchmark Massive Multitask Language Understanding (MMLU) évalue l'étendue des connaissances d'un modèle, la profondeur de sa compréhension du langage naturel et ses capacités de résolution de problèmes. Il comprend plus de 15 000 QCM couvrant 57 matières, des connaissances générales aux domaines spécialisés. MMLU évalue en few-shot et zero-shot, puis mesure l'exactitude par matière pour produire un score moyen final.
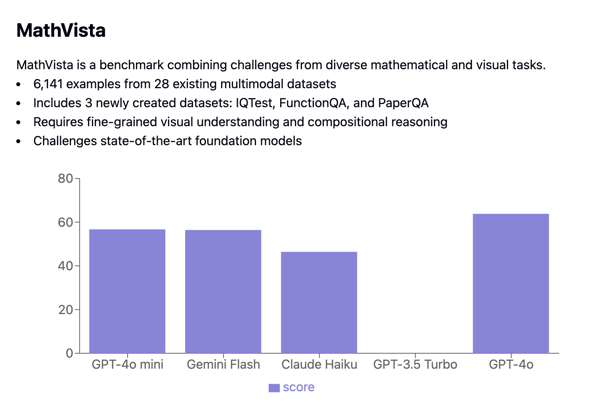
Le benchmark MathVista combine tâches mathématiques et visuelles, avec 6 141 exemples issus de 28 jeux de données multimodaux existants et 3 nouveaux (IQTest, FunctionQA et PaperQA). Il met les modèles au défi avec des tâches nécessitant une compréhension visuelle avancée et un raisonnement compositionnel complexe.
Cas d'usage de GPT-4o mini
La compacité, le faible coût et les bonnes performances de GPT-4o mini le rendent idéal pour un usage sur appareils personnels, le prototypage rapide et les environnements contraints en ressources. De plus, sa capacité de réponse en temps réel améliore les expériences interactives. Voici comment exploiter GPT-4o mini efficacement :
|
Catégorie d'usage |
Bénéfices |
Applications exemples |
|
La petite taille permet un traitement local sur ordinateurs portables, smartphones et serveurs en périphérie, réduisant la latence et améliorant la confidentialité. |
Applications d'apprentissage des langues, assistants personnels, outils de traduction hors ligne | |
|
Prototypage rapide |
Des itérations plus rapides et des coûts réduits favorisent l'expérimentation et l'affinage avant le passage à des modèles plus grands. |
Tester de nouvelles idées de chatbots, développer des prototypes dopés à l'IA, expérimenter différentes fonctionnalités d'IA à moindre coût |
|
Applications temps réel |
Un temps de réponse court améliore l'interactivité. |
Chatbots, assistants virtuels, traduction instantanée, narration interactive dans les jeux et la réalité virtuelle |
|
Éducation |
Abordable et accessible pour les établissements, pour une initiation concrète à l'IA. |
Systèmes de tutorat basés sur l'IA, plateformes d'apprentissage des langues, outils d'entraînement au code |
Accéder à GPT-4o mini
Vous pouvez utiliser GPT-4o mini via l'API OpenAI, notamment via les Assistants API, Chat Completions API et Batch API. Voici un guide simple pour utiliser GPT-4o mini avec l'API OpenAI.
Commencez par vous authentifier avec votre clé d'API — remplacez your_api_key_here par votre clé réelle. Une fois prêt, vous pouvez générer du texte avec GPT-4o mini :
from openai import OpenAI
MODEL="gpt-4o-mini"
## Set the API key
client = OpenAI(api_key="your_api_key_here")
completion = client.chat.completions.create(
model=MODEL,
messages=[
{"role": "system", "content": "You are a helpful assistant that helps me with my math homework!"},
{"role": "user", "content": "Hello! Could you solve 20 x 5?"}
]
)Pour plus de détails sur la configuration et l'utilisation de l'API OpenAI, consultez le tutoriel sur l'API GPT-4o.
Conclusion
GPT-4o mini s'impose comme un modèle d'IA puissant et économique, qui trouve un bel équilibre entre performances et accessibilité.
Issu par distillation du modèle GPT-4o, il associe grande fenêtre de contexte, capacités multimodales et sécurité renforcée, ce qui en fait une option polyvalente et accessible pour un large éventail d'applications.
À mesure que la demande pour des solutions d'IA efficaces et abordables augmente, GPT-4o mini est bien placé pour contribuer à démocratiser ces technologies.
FAQs
Quelle est la différence clé entre GPT-4o et GPT-4o mini ?
La principale différence tient à la taille et au coût. GPT-4o est un modèle plus grand et plus puissant, mais aussi plus onéreux. GPT-4o mini est une version distillée de GPT-4o : plus compacte, plus abordable et plus rapide sur certains usages.
GPT-4o mini peut-il traiter des images, de la vidéo et de l'audio ?
Actuellement, GPT-4o mini prend en charge les entrées texte et image, avec un support pour la vidéo et l'audio prévu ultérieurement.
Comment les performances de GPT-4o mini se comparent-elles aux autres modèles ?
GPT-4o mini surpasse plusieurs modèles similaires, dont Llama 3 (8B), Claude 3 Haiku et GPT-3.5 Turbo, en qualité comme en vitesse. Même si Gemini 1.5 Flash peut avoir un léger avantage en vitesse de sortie, GPT-4o mini excelle en qualité globale.
GPT-4o mini convient-il aux applications en temps réel ?
Oui, son traitement rapide et sa faible latence le rendent idéal pour les applications temps réel comme les chatbots, les assistants virtuels et les expériences de jeu interactives.
Comment accéder à GPT-4o mini ?
Vous pouvez accéder à GPT-4o mini via l'API OpenAI, qui propose différentes options comme les Assistants API, Chat Completions API et Batch API.

Ryan est un data scientist de premier plan spécialisé dans la création d'applications d'IA utilisant des LLM. Il est candidat au doctorat en traitement du langage naturel et graphes de connaissances à l'Imperial College de Londres, où il a également obtenu une maîtrise en informatique. En dehors de la science des données, il rédige une lettre d'information hebdomadaire Substack, The Limitless Playbook, dans laquelle il partage une idée exploitable provenant des plus grands penseurs du monde et écrit occasionnellement sur les concepts fondamentaux de l'IA.








OpenAI a lancé GPT-4o mini, une version plus accessible du puissant GPT-4o. Ce nouveau modèle vise à concilier performances et efficience économique, pour répondre aux besoins des entreprises et des développeurs qui cherchent des solutions d'IA performantes à moindre coût.
En 2024, le récit autour de l'IA évolue : on passe des modèles toujours plus grands à des options plus économiques, en particulier pour les usages B2B. On observe aussi un mouvement de l'IA dans le cloud vers l'IA locale, ce qui rend les modèles plus petits d'autant plus stratégiques.
Jusqu'ici, depuis GPT-3.5, OpenAI manquait d'un candidat solide sur ce segment. GPT-4o mini change la donne en rendant une IA puissante accessible et abordable pour une intégration dans toutes les applications et sur tous les sites web.
Dans cet article, nous passons en revue les principales fonctionnalités de GPT-4o mini, sa comparaison avec d'autres LLM similaires, et ce que ce lancement signifie pour l'évolution de l'IA.