
Last chance! 50% off DataCamp Premium
Sale ends in
Llama 3 è un’IA per la generazione di testo. Cioè, in modo simile ai modelli GPT di OpenAI e Claude di Anthropic, tu scrivi un prompt di testo e lui genera una risposta testuale. I modelli più recenti promettono prestazioni migliori, in particolare per quanto riguarda la comprensione del contesto e il ragionamento logico. I modelli Llama alimentano Meta AI, un assistente intelligente incluso in Instagram, WhatsApp, Messenger e Facebook.
Llama 3 è un modello a "pesi aperti". Significa che il modello in sé è open source, offrendo una certa trasparenza su come effettua i calcoli. Tuttavia, i dettagli completi per ricrearlo, come i dataset utilizzati per l’addestramento, non sono disponibili pubblicamente.
Un’immagine di 3 lama realizzata con Midjourney. Prompt usato: “A cartoon of 3 llamas happily frolicking in a field”
Llama 3 è disponibile in due dimensioni: un modello da 8 miliardi di parametri e uno da 70 miliardi. In generale, più parametri comportano una qualità di output migliore ma rendono il modello più lento e costoso da eseguire. 70 miliardi di parametri sono paragonabili a molti modelli concorrenti, anche se esistono modelli con dimensioni ancora maggiori. Un terzo modello, più grande, da 400 miliardi di parametri è stato annunciato come in fase di sviluppo.
La finestra di contesto—la quantità di testo che può essere presa in considerazione contemporaneamente—è stata raddoppiata da 4096 a 8192 token. Un token si riferisce a una singola parola o segno di punteggiatura, anche se alcune parole vengono suddivise in più token. In inglese, quattro token corrispondono a circa tre parole, quindi la nuova finestra di contesto equivale a circa 15 pagine di testo (a 400 parole per pagina). Sebbene l’aumento sia positivo, resta lontano dallo stato dell’arte: i modelli Claude 3 offrono una finestra di contesto di 200.000 token.
Altre caratteristiche del modello non sono state descritte nell’articolo di annuncio. Molta attenzione è stata invece dedicata all’ecosistema di software circostante.
Insieme all’annuncio di Llama3, Meta ha presentato una suite di strumenti per rendere il lavoro con Llama più semplice e sicuro. Ecco una panoramica.
Llama Guard 2 è uno strumento LLM per classificare il testo come "sicuro" o "non sicuro". Può essere utilizzato sia per i prompt sia per le risposte. Ad esempio, può rilevare se un testo contiene descrizioni di violenza, discorsi d’odio o altri contenuti sgradevoli.
Un caso d’uso tipico è un chatbot. Puoi controllare ogni prompt e, se il contenuto è segnalato come non sicuro, fornire un avviso o adottare altri metodi per gestire il contenuto problematico. Allo stesso modo, se il chatbot genera una risposta segnalata come non sicura, puoi intercettarla e riprovare prima che l’utente la veda.
Oltre al flag sicuro/non sicuro, le risposte di Llama Guard 2 sono etichettate con un’indicazione di sicurezza—una delle undici categorie di contenuti sgradevoli della tassonomia MLCommons AI Safety.
Llama Code Shield classifica il codice come sicuro o insicuro. Con molti sviluppatori che utilizzano gli LLM per farsi assistere nella scrittura del codice, c’è il rischio che venga generato codice insicuro e finisca in produzione. Lo strumento è pensato per essere incorporato negli assistenti di coding basati su IA e integrato in altri tool come VSCode e DataLab.
CyberSec Eval 2 ti consente di valutare quanto sia sicuro un LLM. La versione originale permetteva di valutare la sicurezza della generazione di codice e la protezione dagli attacchi informatici. L’ultima versione amplia queste funzionalità, con strumenti per valutare la suscettibilità alle prompt injection, le capacità offensive automatizzate in ambito cybersecurity e la propensione ad abusare di un interprete di codice.
torchtune è un pacchetto Python che lavora insieme al framework di deep learning PyTorch per facilitare lo sviluppo di LLM personalizzati. Offre strumenti per quattro attività.
torchtune è integrato con piattaforme di machine learning popolari come Hugging Face, Weights & Biases, EleutherAI ed Executorch.
I casi d’uso di Llama 3 sono gli stessi di Llama 2 e di altri LLM. Gli utilizzi più comuni includono i seguenti.
L’annuncio di Meta mostra i risultati dei benchmark per le versioni di Llama 3 da otto miliardi (8B) e settanta miliardi (70B) di parametri confrontate con altri due modelli.
Sono stati utilizzati i seguenti benchmark.
Il modello Llama 3 8B è stato confrontato con Gemma 7B It di Google e Mistral 7B Instruct. Si tratta di LLM di dimensioni comparabili (numero di parametri simile), modelli a pesi aperti disponibili sulla piattaforma Hugging Face e destinati a casi d’uso analoghi. I risultati sono mostrati nella Figura 1.
Llama 3 8B supera agevolmente gli altri due modelli in tutti e cinque i benchmark.
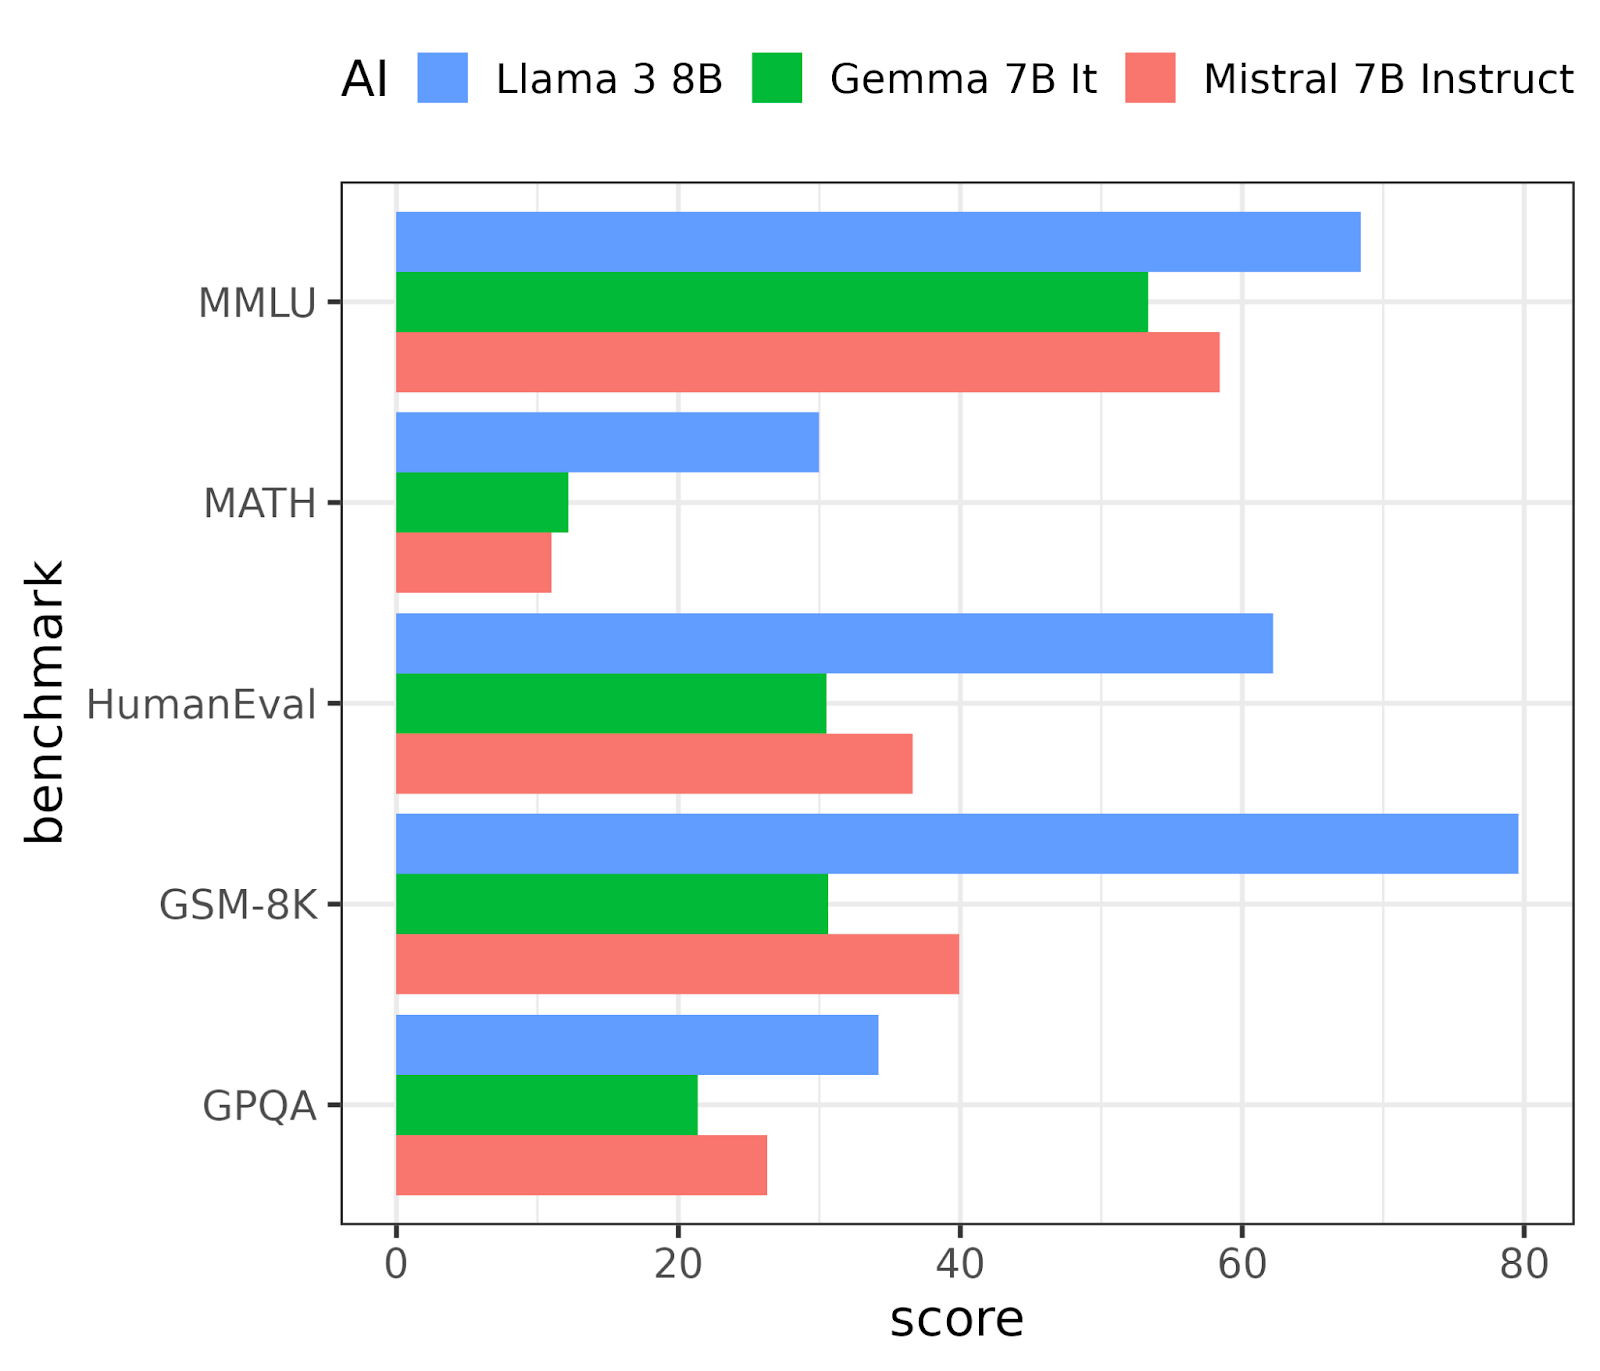
Figura 1. Le prestazioni di Llama 3 8B rispetto a due modelli comparabili su 5 benchmark per LLM.
Llama 3 70B è stato confrontato con Gemini Pro 1.5 di Google DeepMind e Claude 3 Sonnet di Anthropic. Si tratta di modelli vicini allo stato dell’arte, anche se non i più performanti disponibili (il primato passa attualmente tra GPT-4 Turbo di OpenAI e Claude 3 Opus di Anthropic). I risultati sono mostrati nella Figura 2.
Qui le prestazioni sono sostanzialmente alla pari su tre benchmark. Llama 3 80B vince sul benchmark HumanEval per la generazione di codice ed è secondo dopo Gemini Pro 1.5 sul benchmark MATH.
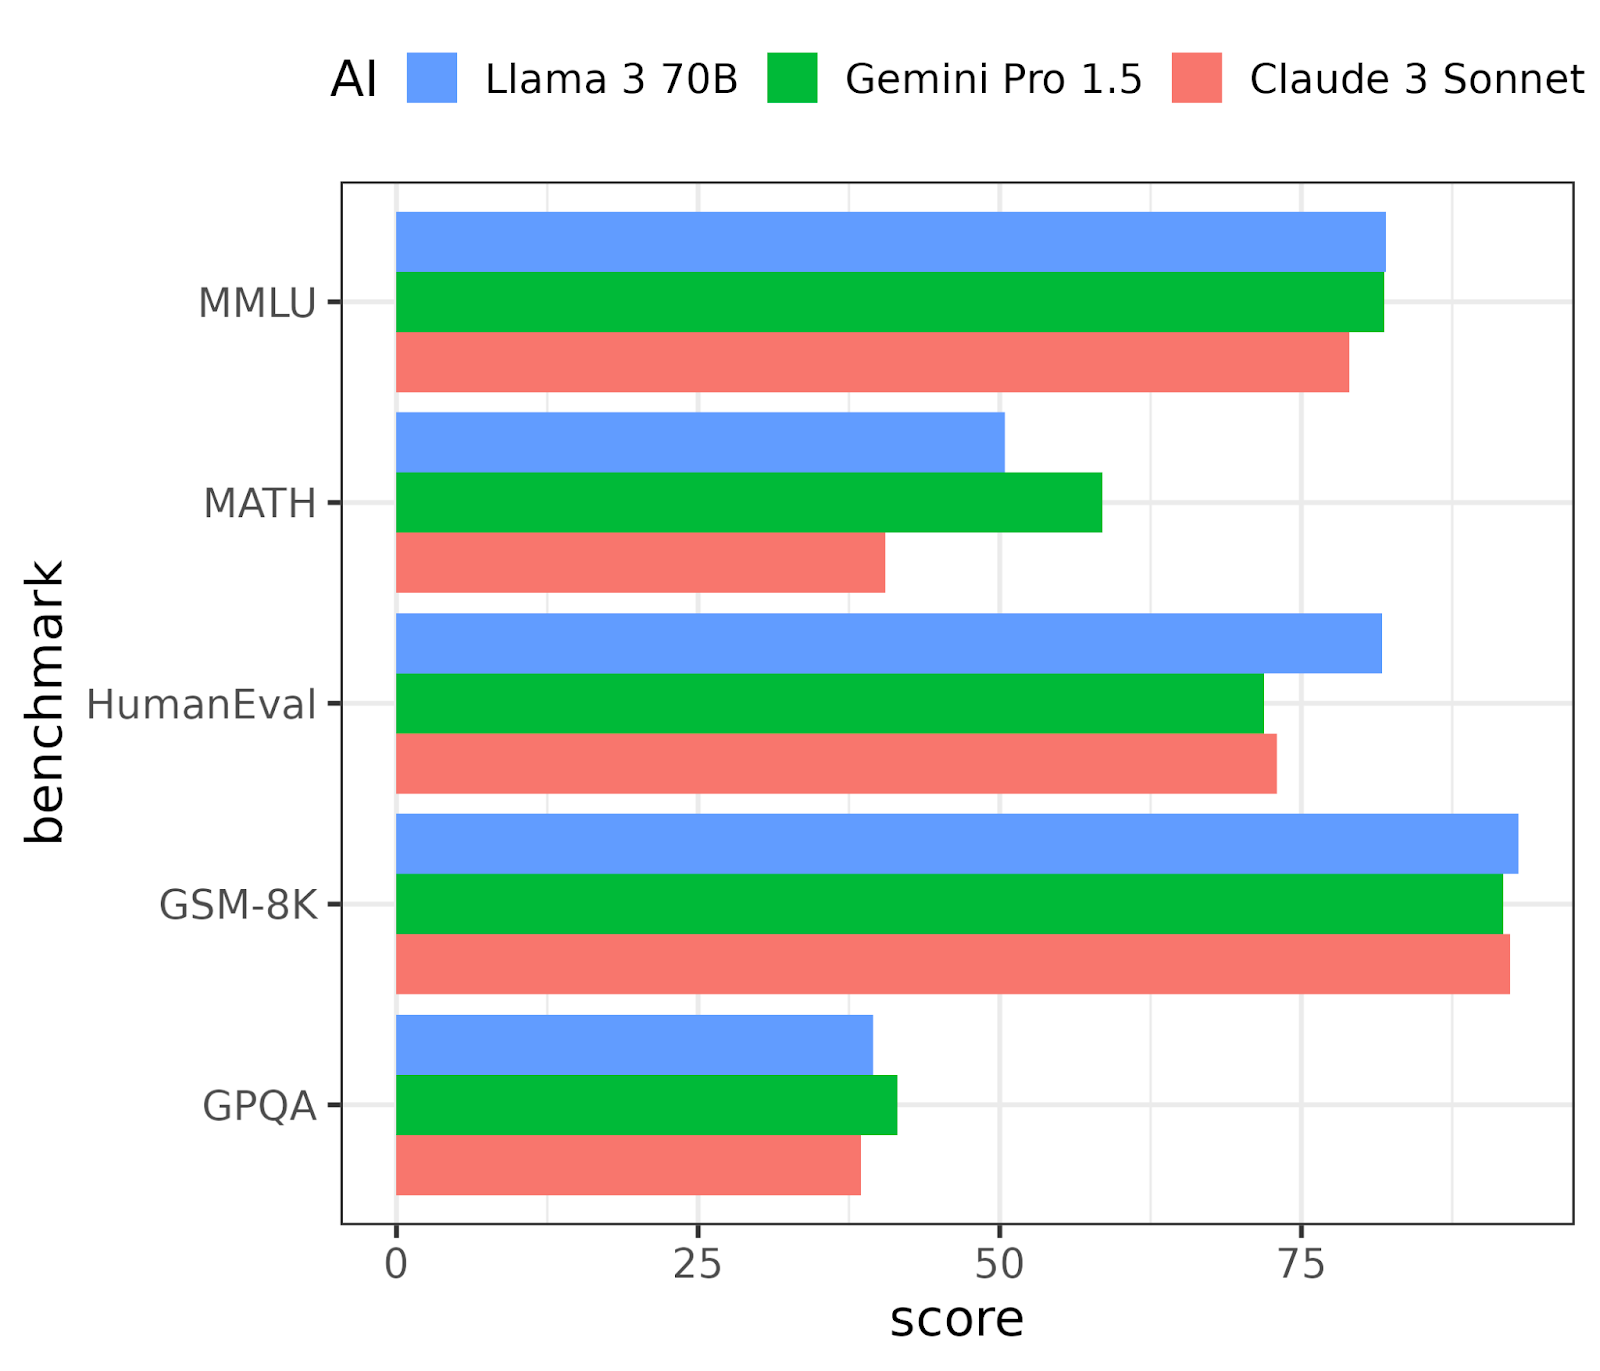
Figura 2. Le prestazioni di Llama 3 70B rispetto a due modelli comparabili su 5 benchmark per LLM.
I benchmark sono più di cinque: Llama 3 è stato valutato su 15 di essi, ma nell’annuncio sono stati mostrati solo i risultati per cinque. Allo stesso modo, esistono molte più scelte di LLM con cui confrontarsi. Non è chiaro quanto Meta abbia selezionato i dati più favorevoli nella presentazione dei risultati.
In secondo luogo, la qualità dell’output è solo una misura della performance. Anche tempo e costo per generare le risposte sono importanti e non sono trattati nell’annuncio.
In terzo luogo, le prestazioni variano sempre in base al caso d’uso, quindi devi provarlo sui tuoi problemi e con il tuo hardware per ottenere risultati accurati per le tue esigenze.
Nei giorni successivi all’annuncio di Meta, le prestazioni di Llama 3 sono comparse nella LMSYS Chatbot Arena Leaderboard, una classifica pubblica degli LLM. Llama 3 70B è attualmente al 6° posto, il piazzamento più alto tra tutti gli LLM a pesi aperti. (È dietro a varie versioni di OpenAI GPT-4, Anthropic Claude 3 Opus e Google Gemini Pro.) Nel frattempo, Llama 3 8B è al 14° posto.
Si tratta di balzi di classifica notevoli, ed è interessante esplorare cosa sia cambiato rispetto a Llama 2.
Llama 3 utilizza un’architettura transformer solo decoder, come i suoi predecessori e la serie di modelli GPT. È l’architettura più comune per i modelli che generano testo. (Il tipo opposto, le architetture solo encoder, sono usate per comprendere o classificare il testo fornito dall’utente.)
Nell’annuncio di Llama 3 non si descrivono cambiamenti radicali alla struttura del modello o al processo di addestramento. Piuttosto, ci sono molte ottimizzazioni attorno ai compromessi tra qualità delle risposte, velocità e sviluppo.
Un nuovo tokenizer, utilizzato per convertire il testo in token, è più efficiente: prompt e risposte occupano il 15% di token in meno, il che significa che nel contesto entra più testo.
Un nuovo meccanismo di attenzione—la tecnica che gli LLM usano per decidere quali parole o frasi sono essenziali per generare l’output—chiamato grouped query attention, offre un compromesso migliore tra qualità dell’output e velocità di generazione rispetto ai meccanismi precedenti.
Il dataset di addestramento è sette volte più grande di quello usato per Llama 2 e contiene una quantità di codice quattro volte superiore. In generale, avere più codice nei dati di addestramento rende gli LLM migliori nella generazione di codice.
Interessante notare che il modello Llama 2 è stato usato per valutare e classificare i dati da includere nel set di addestramento di Llama 3. L’uso dell’IA per creare un’IA ancora migliore è un tema classico della fantascienza (è un elemento della trama in Guida galattica per autostoppisti) ed è ora messo in pratica.
Anche il processo di post-addestramento è stato ottimizzato. Dopo la creazione di un LLM, quel LLM "grezzo" può essere messo a punto per migliorarne le prestazioni. Meta osserva che il processo di Llama 3 include le seguenti tecniche.
Ci sono state alcune assenze degne di nota in questo rilascio.
ChatGPT di OpenAI combina l’IA testuale GPT-4 con l’IA per le immagini DALL∙E 3. Cioè, è "multimodale". L’annuncio di Meta suggerisce che rendere Llama 3 multimodale è un obiettivo per il prossimo futuro.
Il dataset di Llama 3 è descritto come composto per il 95% da testi in inglese. Ciò significa che le prestazioni per altre lingue dovrebbero essere molto più deboli. Come per l’IA multimodale, una versione multilingue di Llama 3 è nella roadmap.
Una tecnica non menzionata nell’annuncio è l’uso di un’architettura a mixture of experts. Con questa tecnica, un LLM è composto da diversi LLM più piccoli specializzati in compiti più ristretti (ad esempio, un LLM per la generazione di codice, uno per la sintesi di documenti e uno per il dialogo). È stata popolarizzata dai modelli Mixtral di Mistral AI e si dice sia alla base di GPT-4 di OpenAI, offrendo migliori prestazioni per parametro. In altre parole, con questa tecnica si può ottenere la stessa performance con un modello più piccolo (e quindi più economico e veloce). Poiché Meta non menziona questa tecnica (e non ce n’è traccia nel repository GitHub di Llama 3), possiamo presumere che non sia stata utilizzata.
Yann LeCun, Chief AI Scientist di Meta, è un forte sostenitore dei world model, in cui l’IA sviluppa un modello interno di come funziona il mondo per imparare più rapidamente, svolgere compiti complessi e adattarsi a situazioni sconosciute. Non c’è stato alcun riferimento a questa architettura radicale nell’annuncio, quindi sembra non essere presente in Llama 3.
Llama 3 è disponibile per il download dal suo sito web e dal suo repository GitHub. Sta già alimentando l’assistente Meta AI su Facebook, Instagram, WhatsApp e Messenger, quindi puoi provare implicitamente Llama 3 usando Meta AI su queste piattaforme.
Sono previste integrazioni con AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM e Snowflake, annunciate come "disponibili a breve", che ti permetteranno di accedere a Llama 3 tramite queste piattaforme.
Nel segmento di fascia alta, la storia recente del panorama dei modelli linguistici di grandi dimensioni è stata una sfida tra GPT-4 di OpenAI e Claude 3 Opus di Anthropic per la supremazia, con Google Gemini Pro e Command R+ di Cohere all’inseguimento. Resta da vedere se la versione di Llama 3 di dimensioni maggiori, attualmente in sviluppo, potrà competere per il primato ma, nel frattempo, Meta ha ottenuto miglioramenti sostanziali delle prestazioni con Llama 3.
Negli ultimi anni, i modelli chiusi (in cui i dettagli del modello non sono disponibili al pubblico) hanno superato i modelli più aperti. Il fatto che Llama 3 si sia piazzato al 6° posto in classifica è, quindi, significativo.
L’obiettivo principale a breve termine di Meta per Llama è semplicemente alimentare l’assistente intelligente Meta AI per le sue piattaforme social. È un modello di business molto diverso da quello di OpenAI, Anthropic o Cohere, che vogliono vendere i loro LLM per essere utilizzati nei prodotti IA di altre aziende. In quest’ottica, i benchmark di performance per la generazione di codice o la risoluzione di problemi matematici potrebbero non avere grande peso per l’azienda.
Meta dispone di un dataset di addestramento unico, fatto dei post social creati da miliardi di utenti e—al di là dell’orgoglio competitivo—l’unica metrica di performance che conta è: "Llama 3 soddisfa a sufficienza le esigenze degli utenti dei social media?"
Inoltre, l’approccio a pesi aperti significa che Llama 3 è potenzialmente più economico da eseguire rispetto alla concorrenza. Offrendo di fatto l’IA gratuitamente, esercita una pressione al ribasso sui prezzi che i concorrenti possono applicare per le loro API. Questo è importante, perché l’entusiasmo del 2023 e i sogni di performance sempre crescenti della generative AI hanno lasciato spazio a un 2024 più sobrio, in cui i dirigenti hanno iniziato a notare quanto siano costose le funzionalità basate su LLM, e il rapporto prestazioni/costo è diventato una priorità.
I modelli a pesi aperti sono inoltre importanti in situazioni in cui la riservatezza dei dati è fondamentale, ad esempio con dati finanziari, sanitari o informazioni personali identificabili. Inviare dati così sensibili a un LLM ospitato da un’altra azienda (come avviene con GPT e altri modelli chiusi) comporta un rischio aziendale che la maggior parte delle imprese non è disposta a correre. Ciò implica l’adozione di un’architettura più complessa per un chatbot o un’altra funzionalità di IA, in modo da separare i dati sensibili dall’LLM. Un modello a pesi aperti come Llama 3 può essere ospitato ovunque l’organizzazione preferisca, facilitando la creazione di prodotti e funzionalità di IA mantenendo la privacy dei dati.
Llama 3 sembra essere un miglioramento iterativo rispetto a Llama 2. Non sono stati annunciati cambiamenti significativi all’architettura, né grandi novità tra le funzionalità.
L’attenzione ai compromessi tra costo e prestazioni suggerisce che Meta punti a un’IA eseguibile a basso costo su larga scala. Le notizie più interessanti riguardano i prodotti dell’ecosistema: aiutare altri sviluppatori a creare LLM di alta qualità in modo più efficiente è uno dei vantaggi più importanti dell’approccio aperto di Meta.
Se non vedi l’ora di entrare nel mondo dell’IA generativa, il nostro percorso di competenze AI Fundamentals ti aiuterà a metterti in pari con machine learning, deep learning, NLP, modelli generativi e altro ancora. Puoi anche leggere le nostre guide su come effettuare il fine-tuning di Llama 3, Llama 3.1 e Llama 3.2.
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



