
Programma
Sviluppare modelli linguistici di grandi dimensioni
16 ore
Molte applicazioni di AI usano grandi modelli linguistici per attività che in realtà non richiedono generazione di testo.
Un agente potrebbe semplicemente dover decidere quale strumento chiamare, se un documento è rilevante, quanto è urgente una richiesta o se un'azione va escalata.
Jev di TypeSafe AI affronta queste attività in modo diverso. Invece di generare una risposta token per token, prende lo stato dell'applicazione e domande strutturate e restituisce decisioni tipizzate come scelte, punteggi, giudizi sì/no e probabilità. Guardalo in azione nel nostro tutorial sull'API di Jev
TypeSafe AI descrive questo come un approccio System One Model: usare l'AI come livello decisionale rapido piuttosto che come generatore di testo generico.
La sfida è che sappiamo ancora relativamente poco su come Jev funzioni internamente.
TypeSafe AI ha condiviso alcuni dettagli sul suo approccio di decisione parallela e sul metodo di training, ma l'architettura completa, i pesi del modello, i dati e l'intera ricetta di addestramento non sono pubblici.
Questo rende difficile ispezionare, riprodurre o adattare Jev stesso.
Progetti open source stanno esplorando la stessa idea usando architetture che possiamo effettivamente esaminare ed eseguire in locale.
Alcuni usano piccoli modelli bidirezionali, altri adattano Qwen con teste decisionali specializzate, mentre altri estraggono direttamente le probabilità da modelli linguistici esistenti.
Poiché controlli l'intero stack, puoi anche ottimizzare dimensione del modello, quantizzazione, batching, caching, hardware e serving per costruire un livello decisionale più veloce ed economico per il tuo carico di lavoro.
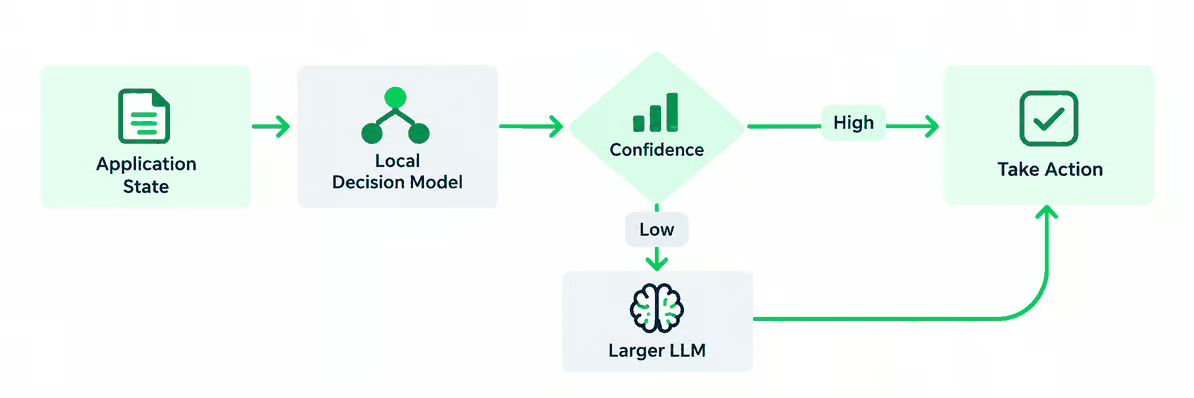
In questo blog confronterò sette alternative open source a Jev, tra cui Laya, Nimble, Kev, SemIf, Rizzo Flow, Von e NanoJev, analizzando come funzionano, quanto seguono l'approccio di Jev, dove si distinguono e come eseguirle in locale.
Disclaimer: i progetti trattati in questa guida sono molto nuovi e in rapida evoluzione. Gli esempi di codice si basano sulla loro documentazione ufficiale e sui repository, ma non tutti gli esempi sono stati testati in modo indipendente end-to-end.
Laya è un modello decisionale non autoregressivo costruito ad hoc basato su ModernBERT-large, con un checkpoint mmBERT separato per carichi multilingue.
Invece di generare testo, elabora insieme lo stato, la domanda e le opzioni disponibili e valuta direttamente le possibili risposte in un singolo forward pass. Supporta decisioni in stile Jev choice, score e noul, con checkpoint dedicati per inglese, multilingue e carichi di lavoro con decisioni tipizzate.
Questo rende Laya una delle alternative architetturali più vicine a Jev, perché entrambe sono progettate specificamente per decisioni probabilistiche piuttosto che per la generazione di testo.
Laya si distingue per i suoi modelli relativamente piccoli da 322M–421M, il supporto multilingue in oltre 100 lingue e la capacità di valutare più domande in modo efficiente senza eseguire un modello generativo da miliardi di parametri.
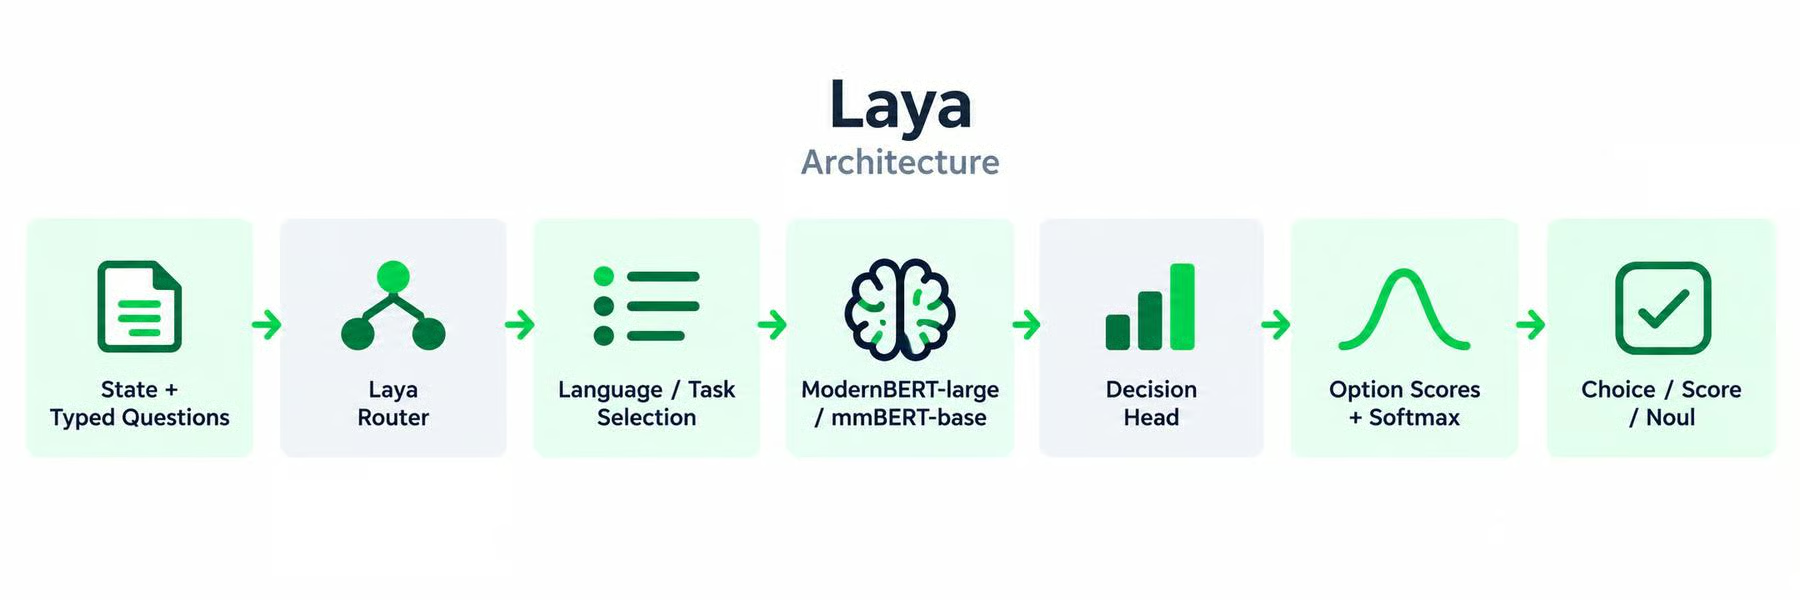
Laya prende uno stato come un'email, un ticket di supporto, un documento o un oggetto JSON, insieme a domande tipizzate come choice, score o noul.
Il suo router seleziona il checkpoint più adatto alla richiesta, ad esempio ModernBERT-large per l'inglese o mmBERT-base per input multilingue.
Il modello selezionato elabora stato e domande in un singolo forward pass, quindi una decision head valuta le opzioni disponibili e le converte in probabilità.
Questo crea un flusso diretto dall'input, attraverso il routing e l'encoding, fino alla decisione tipizzata finale.
 Per iniziare con Laya
Laya è disponibile come pacchetto Python:
pip install layaQuesto comando installa la libreria Laya e le sue dipendenze, ma non include i pesi del modello all'interno del pacchetto.
I modelli sono ospitati su Hugging Face.
Quando crei il router con preload=True, Laya scarica e carica subito i checkpoint disponibili così sono pronti prima della prima richiesta.
I pesi scaricati vengono memorizzati nella cache locale, quindi non devono essere riscaricati ogni volta che esegui l'applicazione.
from laya import Router

router = Router(preload=True)

state = {
    "subject": "Duplicate charge",
    "body": "I was charged twice. Please refund this today."
}

questions = {
    "department": {
        "type": "choice",
        "instructions": "Which department should handle this?",
        "criteria": {
            "billing": "Payments and refunds",
            "technical": "Errors and outages",
            "sales": "Pricing and purchases"
        }
    }
}

result = router.predict(state, questions)

print(result["answers"]["department"]["choice"])
Qui, Router(preload=True) è la parte importante.
Al primo avvio, Laya recupera i file modello necessari dal suo repository Hugging Face e li carica in memoria. Le esecuzioni successive possono riutilizzare le copie in cache locale.
Se invece usi:
router = Router()Laya usa il lazy loading. Attende finché non è richiesto un determinato checkpoint e lo scarica/costruisce al primo utilizzo.
Bespoke Nimble usa Qwen3.5-9B come backbone e lo affina con una LoRA di rank 16 specifica per decisioni tipizzate.
Fornisci del testo insieme a uno schema piatto contenente domande booleane o enum e Nimble restituisce la risposta selezionata più le probabilità per ogni opzione consentita.
Invece di decodificare una risposta token per token, training e inferenza operano direttamente sui logits dei candidati.
Come Jev, Nimble è costruito attorno all'idea di stato in input, decisioni probabilistiche tipizzate in output, ma la sua implementazione mostra come quel comportamento possa essere aggiunto a un LLM open esistente invece di richiedere un'architettura decisionale proprietaria.
Il suo punto di forza principale è la trasparenza dell'intero processo: Bespoke Labs ha rilasciato il modello, la ricetta di training, il setup di valutazione e la pipeline di cura dei dati, rendendo Nimble particolarmente utile per gli sviluppatori che vogliono addestrare o studiare modelli in stile Jev propri.
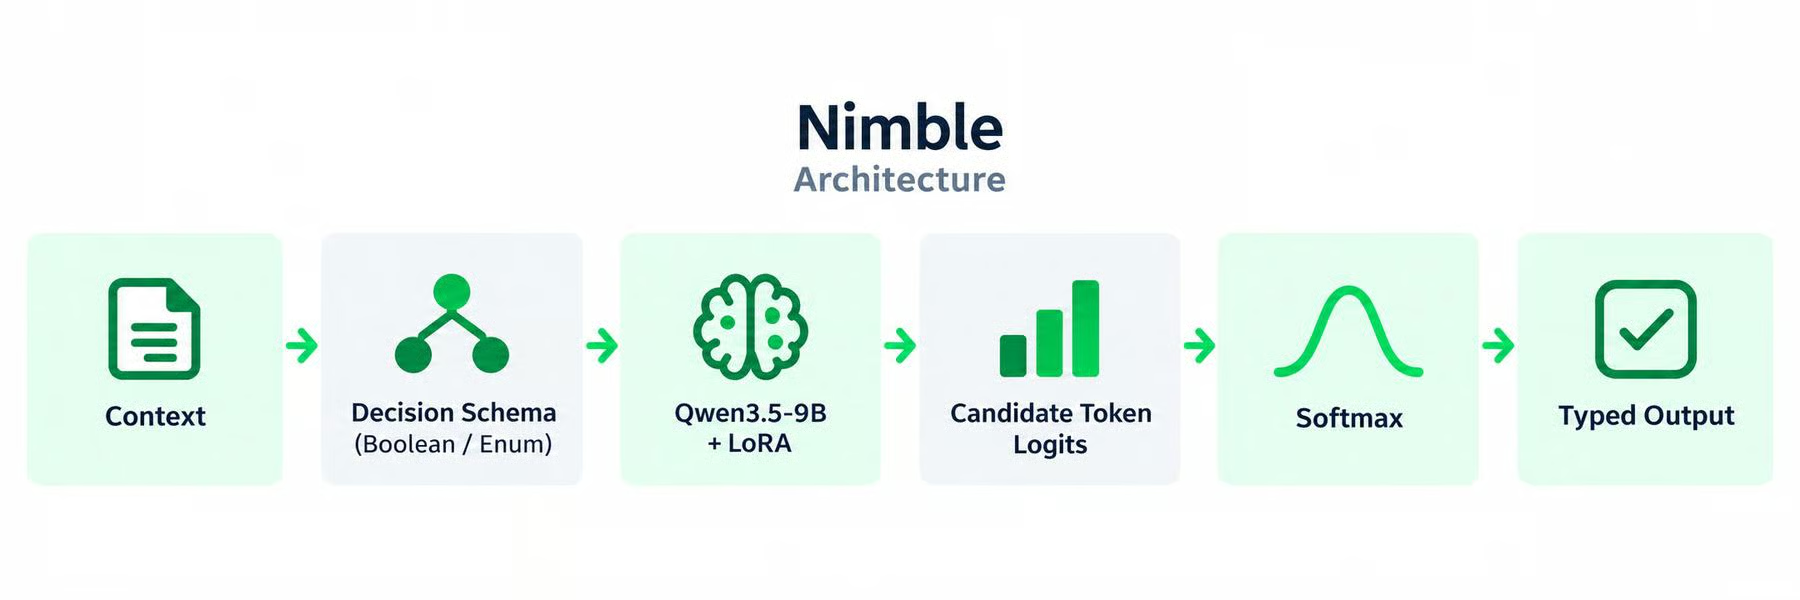
Nimble parte da un contesto e da uno schema decisionale che definisce gli output consentiti, come un booleano o un valore da un enum.
Usa Qwen3.5-9B con LoRA per elaborare contesto e schema, quindi legge i logits per i token candidati consentiti invece di generare una risposta completa.
Quei logits vengono passati attraverso softmax per produrre probabilità, che sono restituite come output strutturato e tipizzato.
 Per iniziare con Nimble
Nimble richiede Python 3.12 e usa il checkpoint Bespoke-Nimble-9B. Inizia clonando il repository e installando le dipendenze:
git clone https://github.com/bespokelabsai/nimble.git nimble
cd nimble

python3.12 -m venv .cache/venvs/nimble
source .cache/venvs/nimble/bin/activate

python -m pip install torch==2.8.0 -r requirements/training.txt
Poi scarica e prepara il modello. Il passaggio di preparazione ufficiale scarica bespokelabs/Bespoke-Nimble-9B da Hugging Face e, quando necessario, unisce il suo adapter LoRA con il modello base Qwen3.5 fissato. Quindi crea .cache/nimble-model.json.
import json
from pathlib import Path
from huggingface_hub import snapshot_download

repo = "bespokelabs/Bespoke-Nimble-9B"

snapshot = Path(
    snapshot_download(
        repo,
        cache_dir=".cache/huggingface/hub"
    )
)

config = {
    "model_path": str(snapshot.resolve()),
    "model_id": repo,
    "revision": snapshot.name,
    "max_input_tokens": 2048,
}

Path(".cache/nimble-model.json").write_text(
    json.dumps(config, indent=2)
)
Se la release scaricata è un adapter LoRA, usa il blocco di preparazione completo di Nimble dal quickstart ufficiale così da poter unire l'adapter con il suo modello base fissato prima dell'inferenza.
Su una GPU NVIDIA, carica il modello preparato:
import json
from pathlib import Path
from nimble.scoring.cuda_scorer import CudaCandidateScorer

config = json.loads(
    Path(".cache/nimble-model.json").read_text()
)

scorer = CudaCandidateScorer(**config)
Then make a typed decision:
schema = {
    "priority": {
        "type": "enum",
        "choices": ["HIGH", "LOW"],
        "description": "Urgency based on current business impact."
    },
    "requires_review": {
        "type": "boolean",
        "description": "Whether a human should review this incident."
    }
}

result = scorer.score(
    "The payment service is down for all customers.",
    schema
)

print(result["output"])
print(result["fields"]["priority"]["scores"])
Nimble restituisce i valori selezionati insieme alla probabilità assegnata a ciascun candidato invece di generare una risposta testuale.
Kev è una famiglia di modelli decisionali ispirati a Jev, costruiti su Qwen3.5, con varianti da 0.8B, 4B e 9B.
Aggiunge un adapter LoRA di rank 16 e una piccola pointer head che confronta ogni rappresentazione delle opzioni con la rappresentazione decisionale della domanda.
Più domande possono condividere lo stesso stato, mentre Kev mantiene isolate le domande e restituisce le loro distribuzioni di probabilità senza generare testo.
Kev è particolarmente vicino a Jev perché la sua architettura si basa esplicitamente su una ricostruzione pubblica di Jev e il suo server implementa il contratto API /v1/systemone di TypeSafe.
Supporta gli stessi stili di domanda noul, choice e score, perciò il codice degli SDK TypeSafe esistenti può essere reindirizzato a un server Kev locale.
Il suo principale vantaggio è questa combinazione di comportamento simile a Jev, pesi aperti, multiple dimensioni di modello e pipeline di training aperta.
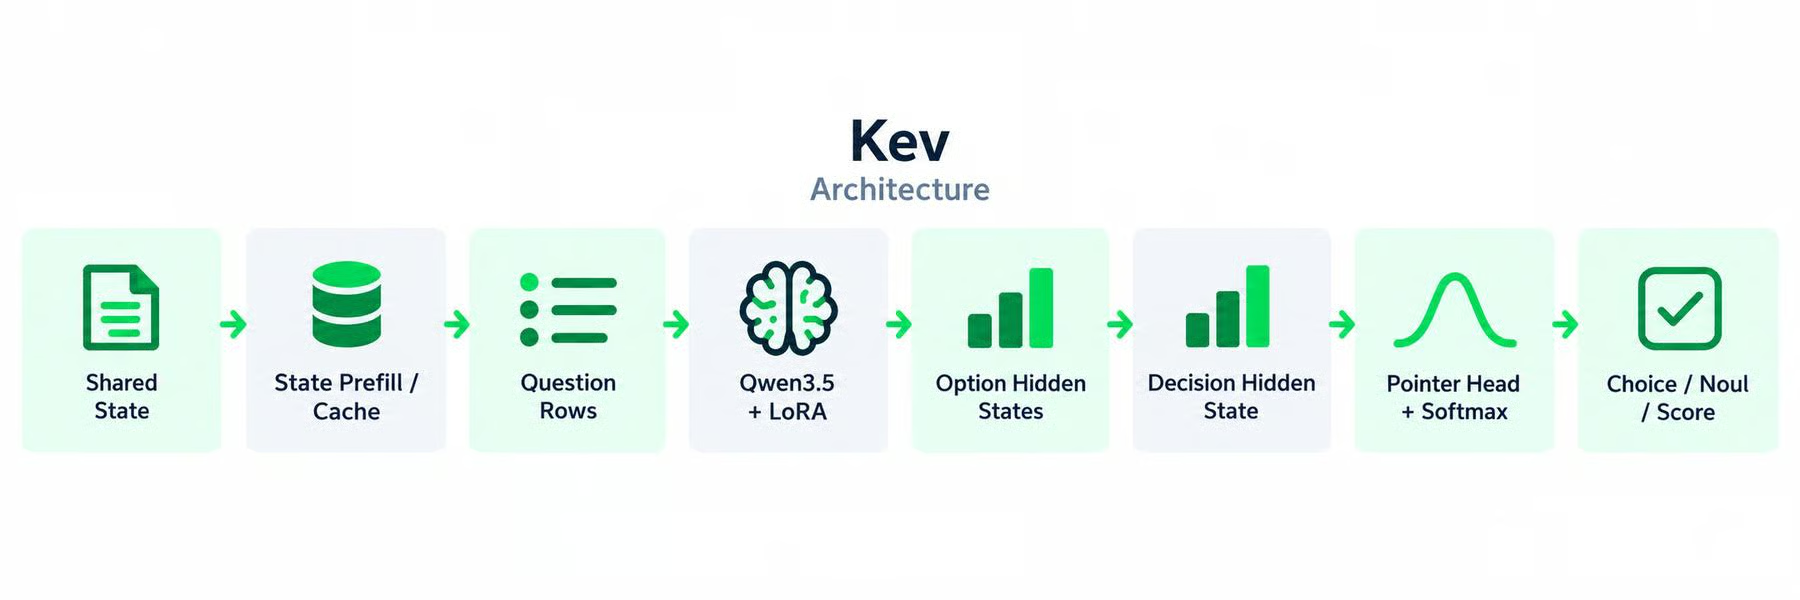
Kev usa un modello base Qwen con un adapter LoRA e una piccola pointer head.
Lo stato condiviso viene elaborato una volta e riutilizzato su più domande, così il modello non deve elaborare ripetutamente lo stesso contesto.
Per ogni domanda, Kev crea rappresentazioni nascoste per le opzioni e il token decisionale, poi la pointer head le confronta e produce i punteggi delle opzioni.
Softmax converte quei punteggi in probabilità per la choice, noul o score finale.
 Per iniziare con Kev
Kev viene eseguito come server System One locale.
Inizia clonando il progetto e installando le sue dipendenze di serving:
git clone https://github.com/jaredpalmer/kev.git
cd kev

uv sync --extra serve
Questo installa Kev, ma non necessariamente tutti i pesi del modello.
Avvia Kev-4B con:
KEV_DTYPE=bf16 \
uv run --extra serve python -m kev.serve \
    --run jaredpalmer/kev-4b \
    --port 8009
Al primo avvio, Kev scarica automaticamente sia l'adapter/checkpoint di Kev che il suo modello base Qwen da Hugging Face.
Gli avvii successivi riutilizzano i file modello in cache invece di scaricarli di nuovo.
Una volta che il server è in esecuzione, puoi usare l'SDK TypeSafe contro di esso:
from typesafe_sdk import Choice, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)

response = client.system_one(
    state="I was charged twice.",
    questions={
        "team": Choice(
            instructions="Which team owns this?",
            criteria={
                "billing": None,
                "technical": None,
            },
        )
    },
)

print(response.choices["team"].choice)
Quindi, con Kev, il comando del server funge anche da step di caricamento del modello: il primo avvio scarica automaticamente i pesi richiesti.
SemIf adotta un approccio più semplice: non addestra affatto un nuovo modello decisionale.
Invece, usa modelli open esistenti come Qwen3.5-4B e legge direttamente i logits assegnati alle risposte consentite.
Lo stato, i criteri e le opzioni tipizzate vengono passati al modello, e SemIf converte i logits nativi delle opzioni in probabilità senza campionare o generare una risposta.
Questo riproduce una delle proprietà pratiche più importanti di Jev, prendere decisioni senza output autoregressivo, evitando al contempo la necessità di un checkpoint specializzato.
SemIf si distingue per la sua flessibilità: puoi usare diversi modelli open sottostanti, riutilizzare uno stato lungo su molte domande ed esperimentare con scoring diretto su CUDA, Apple Silicon o modelli quantizzati nel browser.
È particolarmente utile quando vuoi testare l'idea System One senza addestrare prima un modello dedicato.
SemIf prende uno stato non strutturato, criteri runtime e un set di opzioni consentite e li passa attraverso un modello open esistente.
Invece di chiedere al modello di generare una risposta, legge direttamente i logits assegnati a quelle opzioni predefinite.
Questi logits sono convertiti in una distribuzione di probabilità, consentendo all'applicazione di prendere una decisione tipizzata senza generare testo o effettuare il parsing successivo di una risposta.
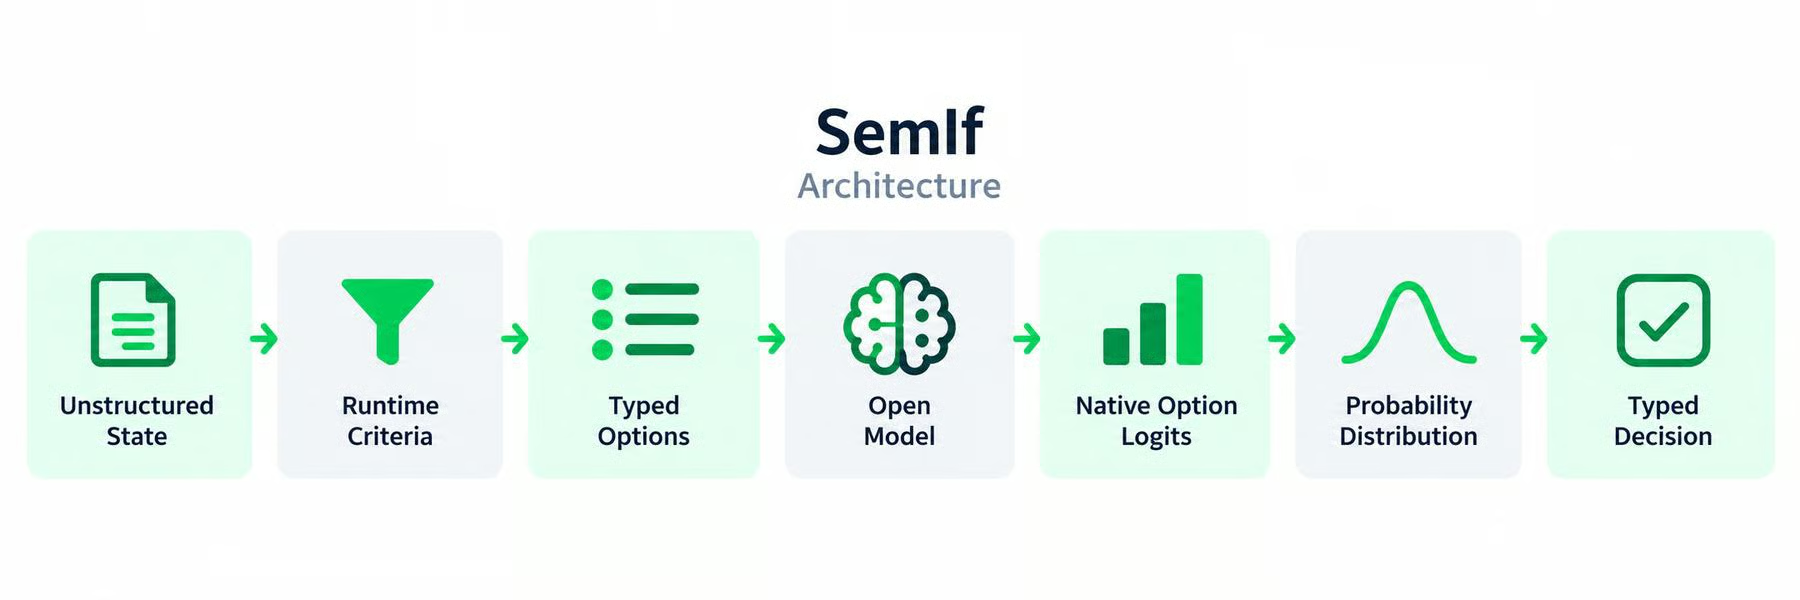 Per iniziare con SemIf
SemIf non ha un proprio checkpoint di foundation model dedicato. Invece, esegue lo scoring decisionale su un modello open esistente.
Clonalo e installalo:
git clone https://github.com/TheoLeeCJ/SemIf.git
cd SemIf

python -m venv .venv
source .venv/bin/activate

pip install -e '.[test]'
Questo installa SemIf, ma non scarica ancora Qwen.
Esegui lo scorer:
CUDA_VISIBLE_DEVICES=0 semif-score \
    --mode direct \
    --model Qwen/Qwen3.5-4B \
    --revision 851bf6e806efd8d0a36b00ddf55e13ccb7b8cd0a \
    --input examples/decisions.jsonl \
    --output results.jsonl
Al primo avvio, il modello Qwen selezionato viene scaricato da Hugging Face e archiviato nella cache di Hugging Face. La documentazione di SemIf consiglia persino di impostare HF_HOME su un drive capiente, perché i file del modello possono occupare molto spazio.
Ad esempio:
export HF_HOME=/path/to/large-drive/huggingfaceDopo che il modello è stato messo in cache, le esecuzioni successive possono riutilizzare la copia locale.
Quindi SemIf di per sé è relativamente piccolo. La maggior parte delle dimensioni di download deriva dal modello open che scegli di eseguire sotto di esso.
Rizzo Flow è un sistema di inferenza in stile Jev, local-first, costruito attorno ai modelli open Spark-X2.5 e al serving basato su llama.cpp.
Invece di generare una risposta JSON, converte ogni decisione in un set vincolato di possibili token di risposta, legge i logits assegnati a quei token e li trasforma in probabilità.
Lo stato può essere elaborato una volta e riutilizzato su più domande, riducendo il calcolo ripetuto.
Come Jev, Rizzo Flow accetta uno stato non strutturato e restituisce decisioni tipizzate come giudizi sì/no, scelte, punteggi e output numerici.
Rispecchia anche l'interfaccia HTTP di TypeSafe, rendendo relativamente facile sostituire una chiamata hosted con un endpoint locale.
Rizzo Flow si distingue in particolare per il deployment locale e la flessibilità hardware, combinando modelli open, quantizzazione e un'API familiare invece di tentare di riprodurre l'architettura di training proprietaria di Jev.
Rizzo Flow elabora lo stato una volta e memorizza il risultato nella KV cache del modello.
Più domande possono poi riutilizzare quello stato in cache invece di elaborare di nuovo l'intero contesto. Ogni domanda viene convertita in un problema a scelta multipla, con risposte candidate rappresentate da lettere come A, B o C.
Rizzo Flow legge solo i logits per quelle lettere di risposta, applica softmax e converte le probabilità risultanti in output tipizzati come booleano, scelta, punteggio o numero.
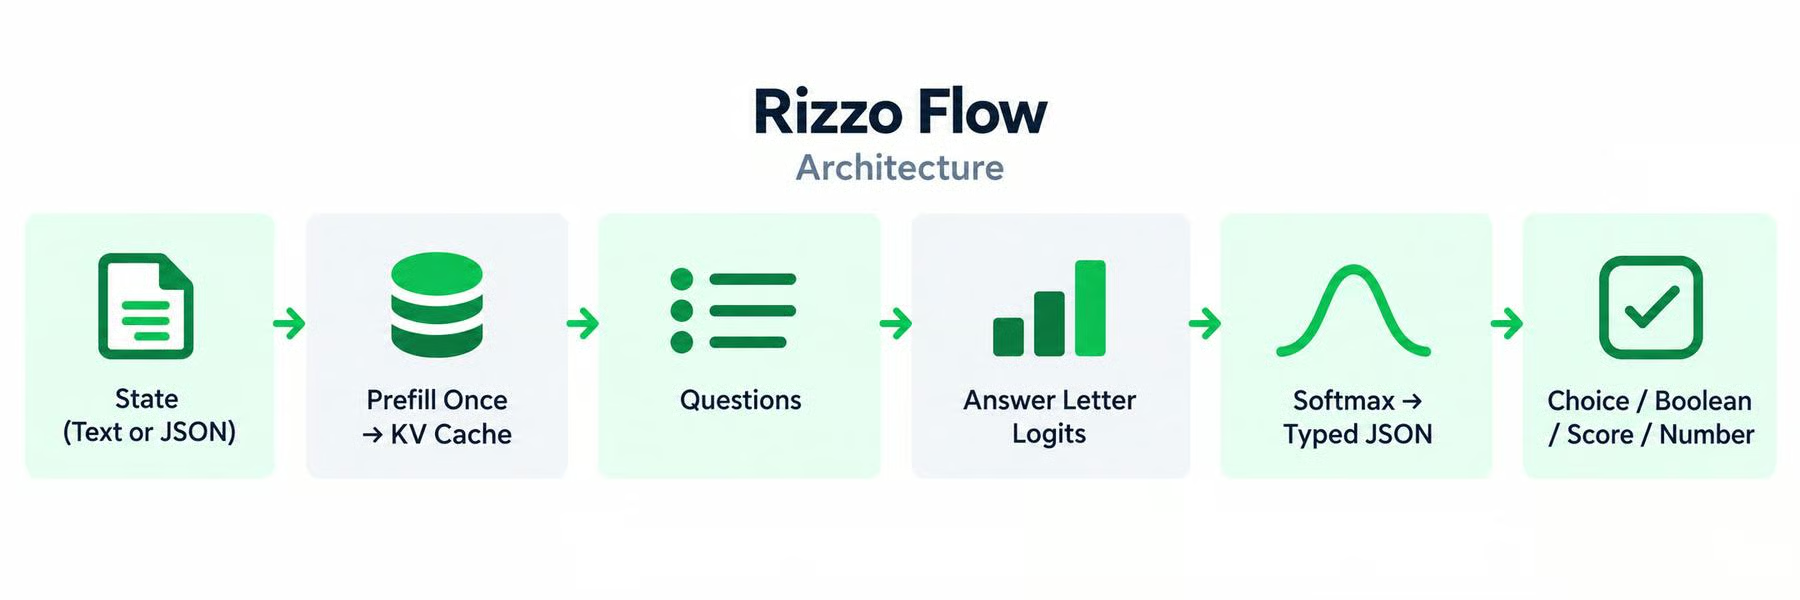
Rizzo Flow richiede Python 3.11+, Git e uv.
In fase di installazione, seleziona il backend di calcolo per la tua macchina. Ad esempio, su Linux con GPU NVIDIA:
git clone https://github.com/Rizzo-AI-Academy/rizzo-flow
cd rizzo-flow

uv sync --locked --extra cuda
source .venv/bin/activate
Per Apple Silicon, usa --extra mlx; i sistemi solo CPU possono usare --extra cpu.
Poi scarica il modello Spark-X2.5 predefinito e il suo runtime locale:
rizzo downloadQuindi avvia il server:
rizzo serveIl modello ora è in esecuzione in locale su http://127.0.0.1:8017.
Puoi testare l'endpoint compatibile con Jev con una decisione reale:
curl http://127.0.0.1:8017/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
    "state": "My payouts have been failing for three days.",
    "model": "rizzo-latest",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "Does this convey urgency?"
      },
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing": "Payments and refunds",
          "technical": "Bugs and outages",
          "sales": null
        }
      }
    }
  }'
Rizzo Flow restituisce direttamente la risposta e la distribuzione di probabilità, senza generare un output token per token.
Von è un modello System One costruito ad hoc basato su un'architettura ModernBERT bidirezionale da 395M di parametri.
Invece di decodificare testo, valuta insieme stato e criteri candidati usando rappresentazioni OptionMarker, quindi produce direttamente logits per decisioni Choice, Noul e Score.
Applica anche una calibrazione post-training affinché le distribuzioni di probabilità risultanti possano essere usate direttamente dalla logica applicativa.
Von è molto simile a Jev a livello di interfaccia: è non autoregressivo, supporta le stesse tre primitive decisionali di base, valuta più domande in un forward pass e implementa il protocollo /v1/systemone.
Il suo punto di forza principale è il piccolo ingombro e il design per inferenza locale: il modello ha centinaia di milioni, non miliardi, di parametri e supporta esecuzione su CUDA, ROCm, Apple Silicon e CPU.
von usa un modello compatto basato su ModernBERT bidirezionale per elaborare insieme stato, domanda e criteri candidati.
Il suo meccanismo Option-Marker crea rappresentazioni per le possibili risposte, che vengono convertite in logits dei candidati.
Viene poi applicato il temperature scaling per migliorare la distribuzione di probabilità prima che von restituisca la choice, noul o score finale.
La stessa architettura può anche valutare più domande in un singolo forward pass.
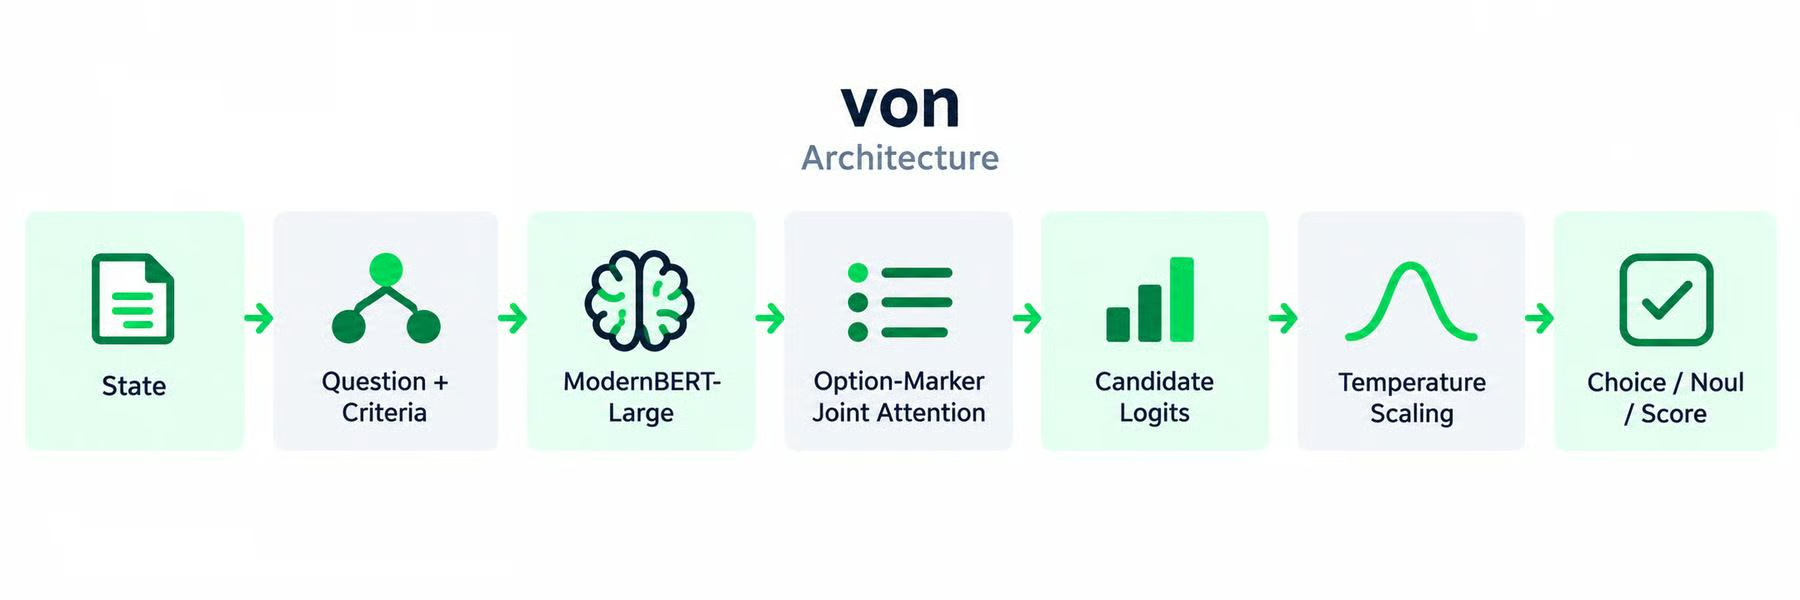
Von ha una delle interfacce più semplici.
Installa l'SDK Python:
pip install von-sdkQuesto installa il software Von. Il modello vero e proprio è pubblicato separatamente come wfzyx/von-1.0 su Hugging Face.
Quando il modello viene caricato per la prima volta, il suo checkpoint ModernBERT viene scaricato e messo in cache in locale tramite il sistema di caricamento modelli di Hugging Face/Transformers.
Una volta in cache, le inferenze successive possono usare la copia locale invece di riscaricare i pesi.
Puoi quindi prendere una decisione con:
import von

result = von.decide(
    state="Database replication lag exceeded 45 seconds.",
    choices={
        "infrastructure": "Database or network failures",
        "billing": "Payments and invoices",
        "feature": "Requests for new functionality",
    },
    instructions="Classify the root cause.",
)

print(result.choice)
print(result.confidence)
For a binary decision:
p_blocking = von.judge(
    state="Requests are timing out.",
    instructions="Is this actively blocking customers?"
)

print(p_blocking)
Quindi la prima chiamata può richiedere più tempo perché il modello deve essere scaricato e inizializzato. Dopodiché, l'inferenza vera e propria avviene in locale.
NanoJev è una replica di Jev da 0,6B costruita su Qwen3-0.6B con teste decisionali dedicate per output strutturati.
Ogni richiesta contiene uno stato, una domanda e un set di candidati, che vengono passati attraverso il backbone prima che teste condivise producano distribuzioni di probabilità complete.
Choice usa set attention e una testa scalare, le decisioni booleane usano una sigmoid e Score valuta livelli ordinati producendo sia una distribuzione sia un punteggio atteso.
NanoJev segue molto da vicino il design di Jev: supporta decisioni parallele, set di candidati dinamici, distribuzioni di probabilità complete e zero decodifica in output.
Dove si distingue è il suo backbone molto piccolo e una pipeline di training esplicita end-to-end.
Può batchare più stati, domande e percorsi di candidati in un unico forward pass del backbone, rendendolo un'opzione interessante per sviluppatori che vogliono sperimentare un'architettura compatta e addestrabile in stile Jev invece di adattare un LLM generale più grande.
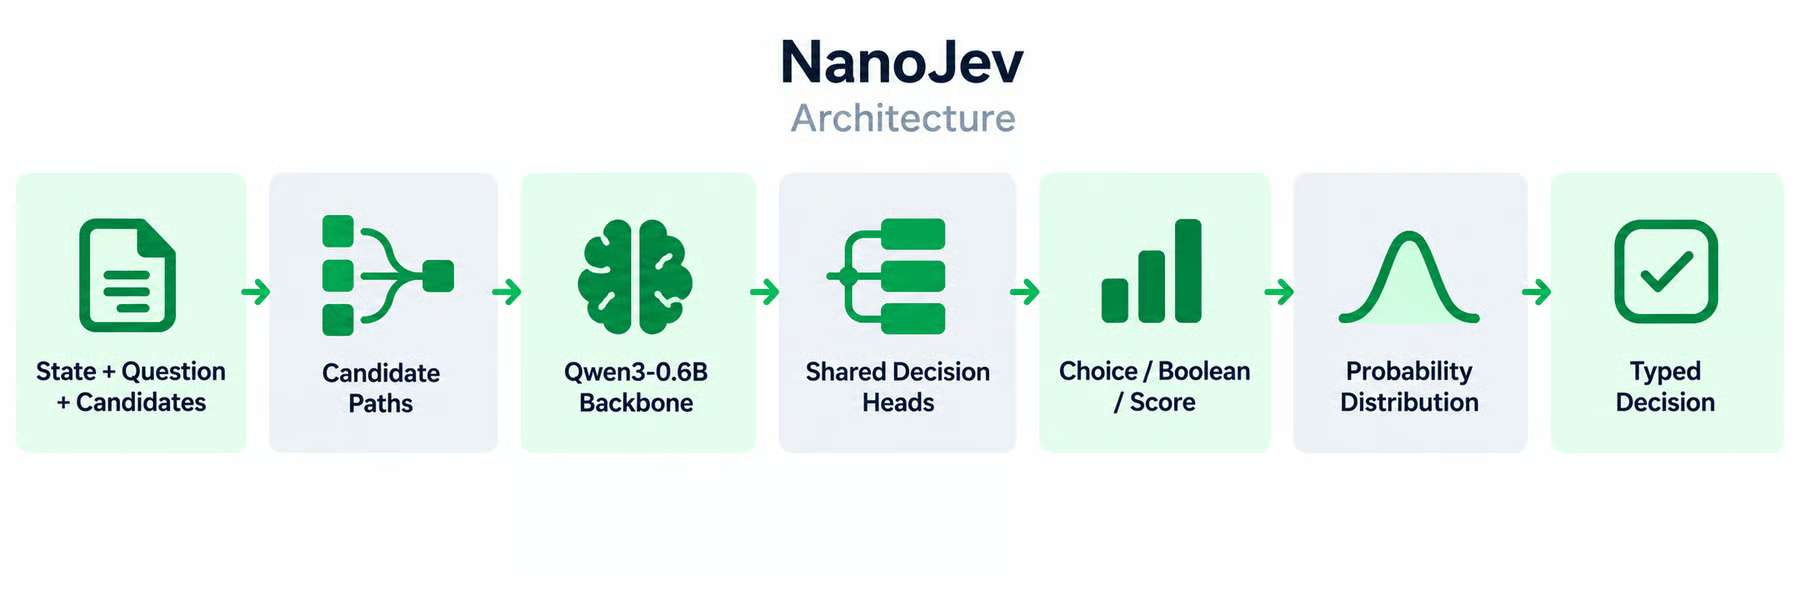
NanoJev prende uno stato, una domanda e le risposte candidate tra cui il modello è autorizzato a scegliere.
Ogni candidato è combinato con l'input pertinente e passato attraverso un backbone Qwen3-0.6B condiviso.
NanoJev usa quindi teste decisionali dedicate per valutare direttamente i candidati: Choice usa set attention e softmax, Boolean usa una sigmoid, e Score produce una distribuzione di probabilità su livelli ordinati.
Poiché legge queste probabilità direttamente dal forward pass, può restituire distribuzioni tipizzate complete senza generare token di output.
NanoJev mantiene separato il download del modello dall'installazione del repository.
Inizia installando il progetto:
git clone https://github.com/TianyuCodings/NanoJev.git
cd NanoJev

python -m pip install \
    -r requirements-toy.txt \
    huggingface_hub
Poi scarica il checkpoint pubblico fissato:
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="C-Tianyu/NanoJev",
    revision="unified-games-v1",
    local_dir="checkpoints/NanoJev-unified",
    allow_patterns=[
        "best.safetensors",
        "config.json",
        "tokenizer/*",
        "backbone_config/*",
    ],
)
Avvia il server di inferenza locale:
CUDA_VISIBLE_DEVICES=0 python scripts/serve_decisions.py \
    --checkpoint-dir checkpoints/NanoJev-unified \
    --web-root web \
    --host 127.0.0.1 \
    --port 8765 \
    --precision bf16
Crea una richiesta:
cat > data/request.json <<'JSON'
{
  "states": [{
    "id": "living_room",
    "state": "The living room is 29 degrees. The target is 24 degrees. The window is closed and someone is home.",
    "questions": {
      "action": {
        "type": "choice",
        "instructions": "Choose the action that most directly lowers the room temperature.",
        "criteria": {
          "cool": "Turn on air conditioning",
          "light": "Turn on the lights",
          "wait": "Keep the current settings"
        }
      },
      "occupied": {
        "type": "boolean",
        "instructions": "Someone is home."
      }
    }
  }]
}
JSON
Quindi inviala a NanoJev:
curl http://127.0.0.1:8765/api/evaluate \
  -H 'Content-Type: application/json' \
  --data-binary @data/request.json
Il server mantiene il checkpoint caricato e restituisce la distribuzione di probabilità per ogni domanda. NanoJev può anche batchare più stati e domande nella stessa richiesta.
La differenza principale è come ciascun progetto produce la decisione.
Laya e Von usano piccoli encoder bidirezionali costruiti specificamente per lo scoring delle opzioni.
Kev, Nimble e NanoJev adattano modelli Qwen con training specializzato o teste decisionali.
SemIf e Rizzo Flow adottano un approccio più leggero estraendo direttamente le probabilità da modelli generativi esistenti.
|
Project |
Architecture |
Size |
Jev-style decisions |
Best suited for |
|
Laya |
ModernBERT/mmBERT + decision head |
322M–421M |
Yes |
Small multilingual decisions |
|
Nimble |
Qwen3.5 + LoRA candidate scoring |
9B |
Similar |
Training and research |
|
Kev |
Qwen + LoRA + pointer head |
0.8B–9B |
Yes |
Jev-like local deployment |
|
SemIf |
Direct logits from open LLMs |
Model-dependent |
Similar |
Direct-logit experiments |
|
Rizzo Flow |
Spark + direct option scoring |
1.7B–4B |
Yes |
Easy local serving |
|
Von |
ModernBERT + OptionMarker |
~395M |
Yes |
Compact decision inference |
|
NanoJev |
Qwen3 + shared decision heads |
0.6B |
Yes |
Small trainable Jev replica |
In pratica, gli encoder dedicati privilegiano velocità ed efficienza, i modelli Qwen adattati mantengono maggiore capacità linguistica generale e i metodi a logit diretto sono più semplici da sperimentare perché richiedono meno training specializzato.
Per modelli decisionali piccoli e specializzati, Laya, Von e NanoJev sono tra le opzioni più interessanti, con un range da circa 322M a 600M di parametri.
Se ti serve decision-making multilingue, Laya si distingue con un checkpoint dedicato basato su mmBERT che copre oltre 100 lingue.
Per applicazioni costruite attorno alla TypeSafe System One API, Kev e Von offrono percorsi di integrazione particolarmente vicini, mentre Rizzo Flow rispecchia la stessa interfaccia HTTP per il serving locale.
Per training e sperimentazione, Nimble pubblica la sua ricetta di data curation e fine-tuning LoRA, mentre NanoJev fornisce una pipeline completa che copre generazione dati, training, valutazione e serving.
Se vuoi sperimentare senza addestrare un modello decisionale specializzato, SemIf è un utile baseline: legge le probabilità delle opzioni direttamente da modelli open esistenti come Qwen invece di generare una risposta.
L'architettura esatta di Jev potrebbe essere nuova, ma l'idea di fondo non lo è.
I classificatori NLI zero-shot valutano etichette candidate arbitrarie dai logits del modello da anni, molto prima di Jev.
Ciò che TypeSafe AI aggiunge è un'architettura costruita ad hoc, output paralleli, probabilità calibrate e un'API pulita per trasformare quell'idea in un livello decisionale programmabile.
L'ecosistema open source dimostra che non hai bisogno di un servizio chiuso per costruire qualcosa di simile.
Progetti come Kev, Von e Rizzo Flow possono essere eseguiti in locale ed esporre interfacce in stile Jev, mentre altri ti permettono di scaricare i pesi, quantizzarli o usare runtime come llama.cpp.
Il vero punto non è che Jev abbia inventato il decision-making in AI, ma che abbia riportato l'attenzione su un'idea importante: se la tua applicazione ha bisogno solo di una decisione, potresti non aver bisogno affatto della generazione di testo.
I migliori corsi DataCamp
Programma
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



