
Corso
Concetti di IA generativa
2 ore
121.3K
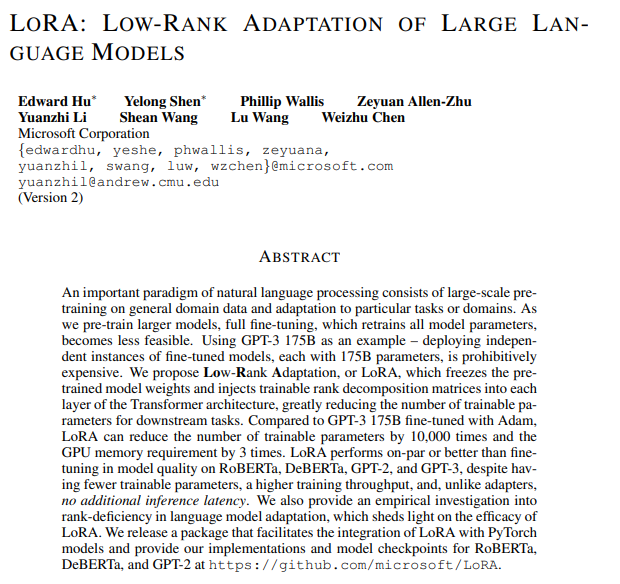
LoRA: Low-Rank Adaptation of Large Language Models
Il campo del machine learning e dell’elaborazione del linguaggio naturale (NLP) ha vissuto un progresso straordinario con l’introduzione dei Large Language Model (LLM) come GPT, LLaMa, Claude 2, ecc. Questi modelli hanno mostrato capacità eccezionali in varie applicazioni, dalla generazione di testo alla comprensione del linguaggio.
Tuttavia, l’uso pratico in produzione e il fine-tuning di questi modelli presentano sfide significative, principalmente a causa delle loro dimensioni e complessità.
Qui entra in gioco la Low-Rank Adaptation (LoRA), offrendo una soluzione efficace a queste sfide.
L’obiettivo di questo tutorial è costruire una comprensione teorica e pratica di cos’è LoRA e di come puoi trarne vantaggio.
L’ideazione di LoRA risale ai primi mesi del 2021, dopo il rilascio di GPT-3. Microsoft, in collaborazione con OpenAI, si è trovata di fronte alla sfida di rendere commercialmente sostenibili modelli di grandi dimensioni come GPT-3.
Hanno scoperto che il one-shot prompting da solo non era sufficiente per ottenere prestazioni ottimali in produzione, soprattutto per compiti complessi come la traduzione del linguaggio naturale in codice. Questo ha portato a esplorare metodi di fine-tuning che fossero al contempo economici ed efficienti.
L’invenzione di LoRA nasce dall’esigenza di prodotto di abilitare un fine-tuning dei large language model rapido, efficiente e conveniente per favorire la specificità di dominio, il cambio di task efficiente o il cambio utente a runtime.
Il paper di ricerca su LoRA è stato pubblicato nell’ottobre 2021 da un team di ricercatori di Microsoft.
Capiremo prima il problema, ancor prima di chiarire cos’è LoRA e come lo risolve.
I large language model come GPT-4, Claude 2, LLaMA 70b, ecc. sono ottimi, ma sono molto generici e molto grandi. Per adottare questi modelli per domini specifici come la sanità o la banca, o per compiti specifici come convertire testo in codice, abbiamo bisogno di qualcosa chiamato fine-tuning.
Il fine-tuning è il processo di addestrare un modello pre-addestrato su un dataset specifico e più piccolo per specializzarne le prestazioni su un particolare task o dominio. Man mano che i modelli crescono (ad esempio, GPT-3 ha 175 miliardi di parametri), il fine-tuning completo, che riaddestra tutti i parametri del modello, diventa sempre meno fattibile a causa di tempi, costi e risorse.
LoRA è una tecnica utilizzata per il fine-tuning di modelli di grandi dimensioni.
A livello alto, ecco come funziona LoRA:
Mantiene invariato il modello originale e aggiunge piccole parti modificabili a ciascun livello del modello. Questo riduce significativamente i parametri addestrabili del modello e diminuisce il fabbisogno di memoria GPU per il processo di training, che è un’altra sfida importante nel fine-tuning o nell’addestramento di modelli grandi.
Per esempio, il fine-tuning completo del modello GPT-3 richiederebbe di addestrare 175 miliardi di parametri. Con LoRA, i parametri addestrabili per GPT-3 vengono ridotti all’incirca di 10.000 volte e il fabbisogno di memoria GPU di tre volte.
In sostanza, LoRA risolve questi problemi:
Prima di entrare nei dettagli di LoRA, capiamo il concetto di matrici a rango inferiore.
Le matrici a rango inferiore sono un concetto matematico, in particolare nell’algebra lineare. In parole semplici, il rango di una matrice è una misura del "contenuto informativo" o della "dimensionalità" dei dati rappresentati dalla matrice. Vediamolo nel dettaglio:
Esempio:
Considera una matrice 3 x 3:
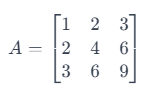
Qui, la seconda riga è semplicemente la prima riga moltiplicata per 2, e la terza riga è la prima riga moltiplicata per 3. Questo significa che le righe non sono linearmente indipendenti. Il rango di questa matrice è 1 (poiché solo la prima riga è indipendente), che è inferiore al rango massimo possibile per una 3x3, cioè 3. Quindi, questa è una matrice a rango inferiore.
Le matrici a rango inferiore sono importanti in varie applicazioni come la compressione dei dati, dove ridurre il rango di una matrice aiuta a comprimere i dati preservando quante più informazioni possibili.
Il concetto di rango in una matrice si applica in egual misura a righe e colonne. Il punto cruciale da capire è che il rango di una matrice è lo stesso che lo si calcoli sulle righe o sulle colonne. Questo per via di una proprietà fondamentale dell’algebra lineare nota come Teorema di Rango-Nullicità.
In termini più semplici, il teorema afferma che le dimensioni dello spazio delle righe (lo spazio generato dalle righe) e dello spazio delle colonne (lo spazio generato dalle colonne) di una matrice sono uguali. Questa dimensione comune è ciò che chiamiamo rango della matrice.
Quindi, nell’esempio sopra della matrice 3 x 3, il rango è 1, il che significa che c’è una sola riga linearmente indipendente e una sola colonna linearmente indipendente.
In parole molto semplici, LoRA sfrutta il concetto di matrici a rango inferiore per rendere il processo di training del modello estremamente efficiente e veloce.
I modelli di grandi dimensioni hanno moltissimi parametri. Per esempio, GPT-3 ha 175 miliardi di parametri. Questi parametri sono solo numeri memorizzati in matrici. Memorizzarli richiede molto spazio.
Il fine-tuning completo implica che tutti i parametri vengano addestrati, e questo richiederà una quantità straordinaria di risorse di calcolo che può facilmente costare milioni di dollari per un modello delle dimensioni di GPT.
A differenza del fine-tuning tradizionale, che richiede di modificare l’intero modello, LoRA si concentra sulla modifica di un sottoinsieme più piccolo di parametri (matrici a rango inferiore), riducendo così l’onere computazionale e di memoria.
LoRA si basa sulla comprensione che i modelli di grandi dimensioni possiedono intrinsecamente una struttura a bassa dimensionalità. Sfruttando matrici a basso rango, LoRA adatta efficacemente questi modelli. Questo metodo si fonda sul concetto chiave che cambiamenti significativi del modello possono essere rappresentati con meno parametri, rendendo quindi il processo di adattamento più efficiente.
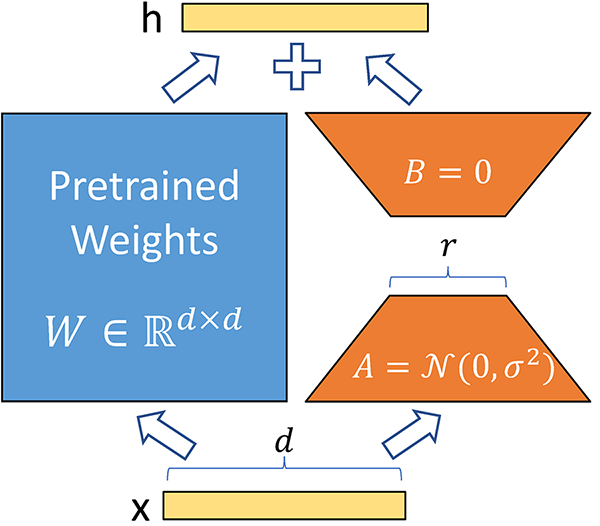
Fonte: Fine-Tuning LLMs: LoRA or Full-Parameter? An in-depth Analysis with Llama 2
Per prima cosa, scomponiamo le grandi matrici di pesi in matrici più piccole usando la tecnica delle matrici a rango inferiore, come spiegato sopra. Questo riduce drasticamente il numero di parametri addestrabili. Per un modello come GPT-3, i parametri addestrabili vengono ridotti di 10.000 volte. Ciò significa che invece di addestrare 175 miliardi di parametri, applicando LoRA ne alleni solo 17,5 milioni.
Non modifichiamo alcun parametro del modello pre-addestrato. Invece, addestriamo solo le matrici a rango inferiore, il che avviene relativamente molto rapidamente grazie al numero ridotto di parametri.
I pesi sono additivi. Questo significa che in inferenza sommiamo semplicemente i pesi delle matrici a rango inferiore ai pesi pre-addestrati senza latenza aggiuntiva. Le matrici a rango inferiore sono anche molto piccole, quindi è molto semplice caricarle e scaricarle per task diversi e utenti diversi.
Ci sono diversi vantaggi nell’usare LoRA per il fine-tuning:
LoRA riduce il carico computazionale, consentendo un adattamento più rapido dei modelli. Richiedendo meno parametri addestrabili, LoRA rende possibile effettuare il fine-tuning di modelli grandi anche su hardware meno potente.
Nonostante il minor numero di parametri, LoRA mantiene la qualità originale del modello e la velocità in inferenza.
LoRA riduce drasticamente la dimensione dei checkpoint del modello. Ad esempio, su GPT-3, la dimensione del checkpoint è passata da 1 TB a soli 25 MB.
LoRA non introduce alcuna latenza aggiuntiva durante l’inferenza. Sebbene le matrici a basso rango vengano utilizzate durante l’addestramento, in inferenza vengono fuse con i parametri originali, garantendo nessun rallentamento. Questo abilita il cambio rapido di modello a runtime senza latenza aggiuntiva in inferenza.
LoRA è applicabile a qualsiasi modello che utilizzi la moltiplicazione di matrici (come una support vector machine), rendendola una tecnica ampiamente applicabile in molti altri casi d’uso. In effetti, LoRA è ampiamente utilizzata nei modelli di Stable Diffusion per incorporare lo stile nei grandi modelli di immagini.
La tecnica LoRA è ampiamente adottata anche nei modelli di immagini come Stable Diffusion.
L’idea è sostanzialmente la stessa dei modelli linguistici. Invece di effettuare il fine-tuning completo di modelli grandi come Stable Diffusion, alleniamo solo matrici a rango inferiore su piccoli dataset.
Nel caso dei modelli linguistici, l’obiettivo è la specificità di dominio. Per i modelli di immagini, il caso d’uso più evidente è adottare uno stile o un personaggio coerente nella generazione di immagini.
Queste matrici a rango inferiore sono note come adapter; sono molto piccole e su internet ce ne sono migliaia che puoi scaricare e sovrapporre al tuo modello base di Stable Diffusion per generare immagini specifiche per stile.
Alcuni usi comuni dei modelli LoRA per Stable Diffusion sono:
Puoi combinare più LoRA per ottenere output che riflettano più specializzazioni.
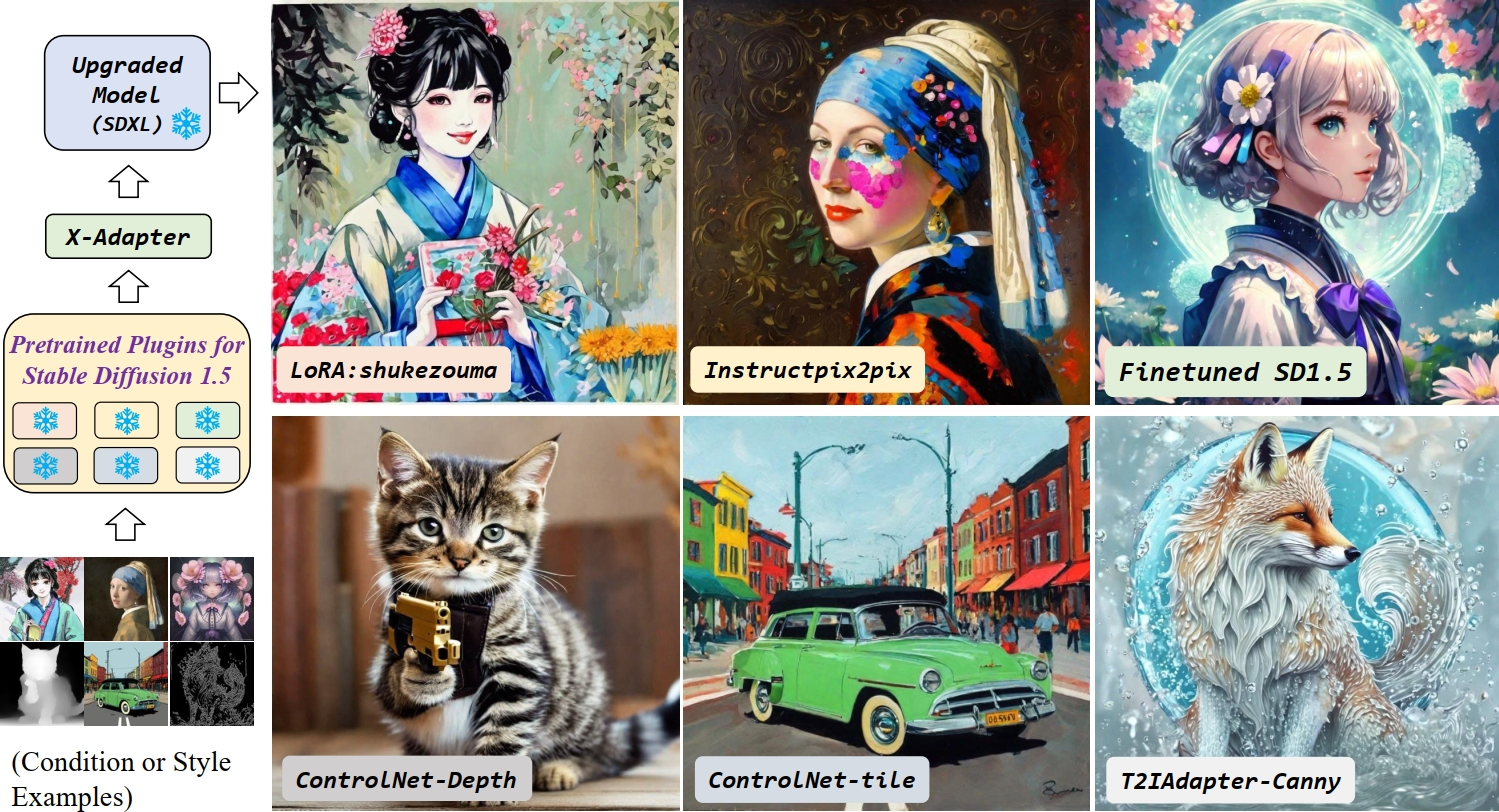
Diversi adapter per i modelli di Stable Diffusion (Fonte immagine)
Se vuoi imparare come eseguire con successo il fine-tuning di Stable Diffusion XL su foto personali, dai un’occhiata al blog su Fine-tuning di Stable Diffusion XL con DreamBooth e LoRA su Datacamp.
Il prefix tuning è un metodo leggero in cui vettori continui chiamati "prefissi" vengono ottimizzati e aggiunti all’input di ogni livello del Transformer. Il modello è addestrato in modalità prefix-stripped, concentrandosi solo su questi vettori.
LoRA e il prefix tuning possono essere combinati all’interno del framework PEFT (Parameter Efficient Fine-Tuning):
Per implementare LoRA, puoi usare la libreria Loralib di Microsoft. Per installarla:
pip install loralib
Il modo in cui normalmente alleni la tua rete neurale non cambia molto con l’adozione di LoRA.
# ===== Before =====
# layer = nn.Linear(in_features, out_features)

# ===== After ======
import loralib as lora
# Add a pair of low-rank adaptation matrices with rank r=16
layer = lora.Linear(in_features, out_features, r=16)
Prima dell’inizio del loop di training, devi semplicemente aggiungere:
import loralib as lora

model = YourNeuralNetwork()

# This sets requires_grad to False for all parameters
lora.mark_only_lora_as_trainable(model)

# Training loop
for batch in dataloader:
   ...
Quando salvi un checkpoint, puoi generare uno state_dic che contiene solo i parametri di LoRA.
# ===== Before =====
# torch.save(model.state_dict(), checkpoint_path)

# ===== After =====
torch.save(lora.lora_state_dict(model), checkpoint_path)
Se non conosci abbastanza bene le reti neurali, non preoccuparti. Dai un’occhiata al blog How to Train a LLM with PyTorch per padroneggiare il processo di training dei large language model con PyTorch, dall’impostazione iniziale all’implementazione finale.
Crediti: l’esempio di codice è stato riprodotto dal GitHub Microsoft/LoRA.
LoRA emerge come una tecnica indispensabile per affrontare le notevoli sfide poste dalle dimensioni e dalla complessità dei modelli grandi.
Sfruttando le matrici a rango inferiore, LoRA offre un approccio più efficiente e conveniente all’adattamento dei modelli, riducendo in modo significativo i parametri addestrabili e i requisiti di memoria GPU, abilitando così training più veloce ed efficienza della memoria.
L’applicazione di LoRA si estende oltre i modelli linguistici, trovando utilità in modelli di immagini come Stable Diffusion, dove facilita la specializzazione di stile e la coerenza dei personaggi nella generazione di immagini.
Se sei curioso e vuoi saperne di più su cosa puoi costruire con queste tecnologie, consulta la nostra guida 5 progetti che puoi realizzare con i modelli di IA generativa per approfondire.
Inizia oggi il tuo percorso nell’IA!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



